

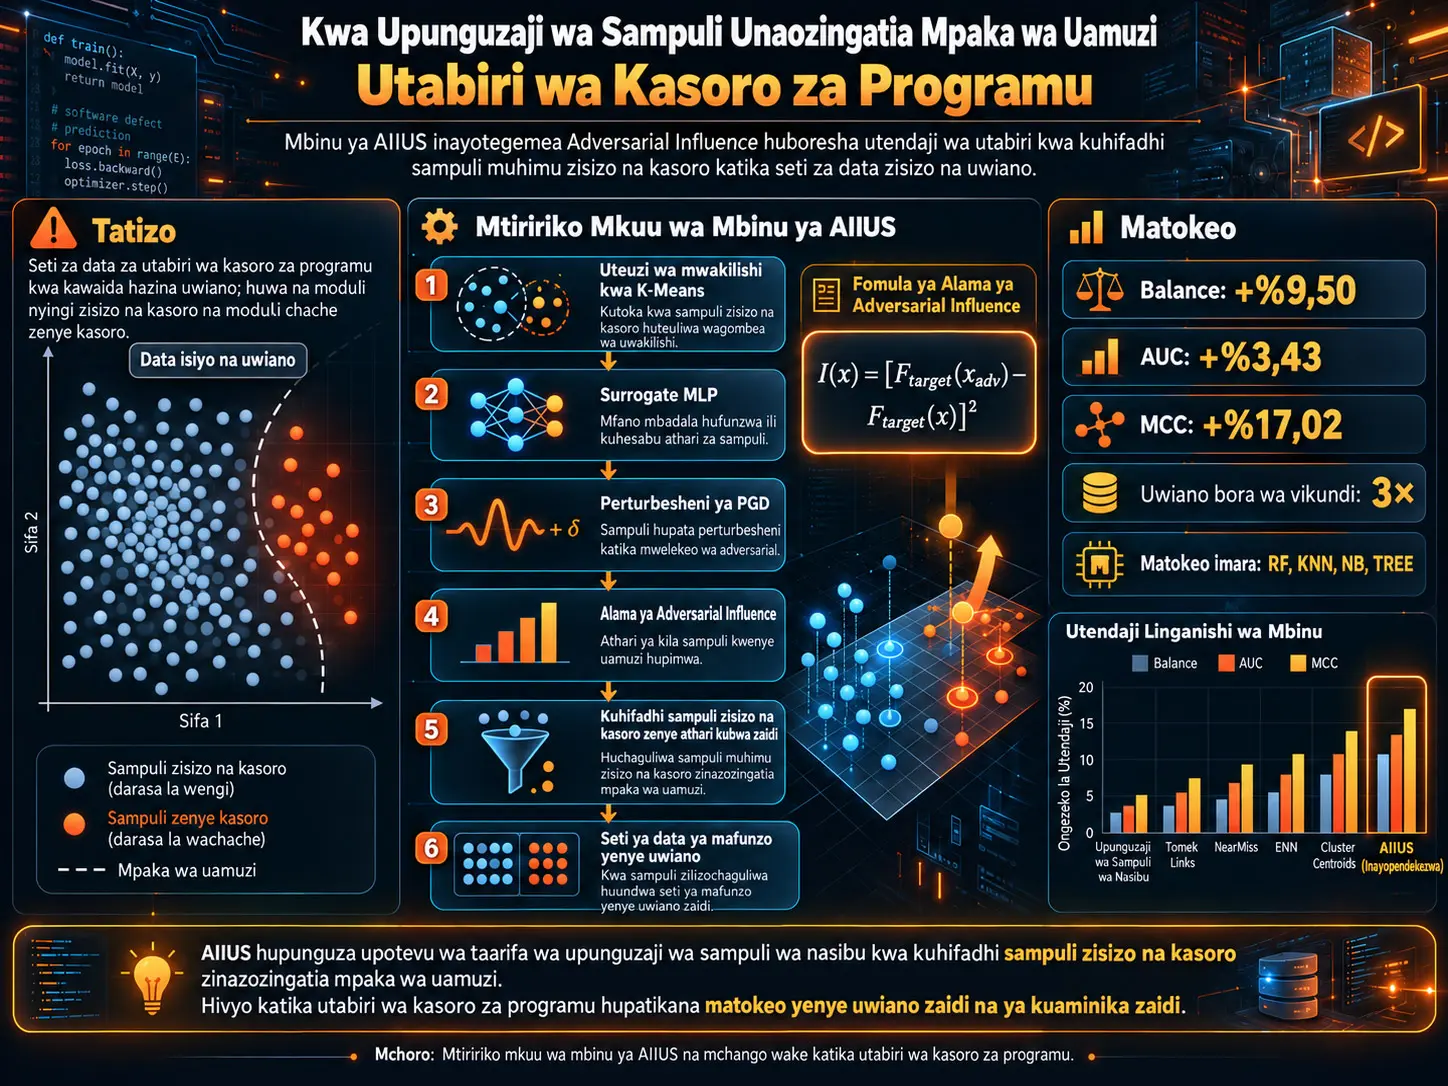
Mifumo ya utabiri wa kasoro za programu inaweza kusaidia kutumia kwa ufanisi zaidi rasilimali za upimaji na ukaguzi kwa kubaini ni moduli zipi za msimbo zilizo na uwezekano mkubwa wa kuwa na kasoro. Hata hivyo, katika seti halisi za data za programu, moduli zisizo na kasoro kwa kawaida huwa nyingi zaidi kuliko moduli zenye kasoro. Kutokuwiana huku kwa madarasa kunaweza kusababisha kiainishaji, licha ya kuonekana kuwa na usahihi wa jumla wa juu, kukosa sampuli zenye kasoro au kutoa tahadhari nyingi za uongo.
Utafiti huu unapendekeza mbinu ya Adversarial Influence-Based Intelligent Undersampling (AIIUS) inayolenga kuhifadhi sampuli zinazoonekana kuwa muhimu zaidi kwa mtazamo wa mpaka wa uamuzi badala ya kupunguza kwa nasibu sampuli zisizo na kasoro za darasa la wengi. Ubunifu mkuu wa mbinu hiyo, Adversarial Influence, hupima ni kwa kiasi gani utabiri wa uwezekano wa kasoro wa kiainishaji lengwa hubadilika wakati perturbation ndogo na iliyolengwa inapotumika kwa sampuli. Sampuli za darasa la wengi zenye mabadiliko makubwa ya utabiri hupewa kipaumbele kama wagombea wenye taarifa zaidi kuhusu tabia ya uamuzi ya modeli.
AIIUS ina hatua tatu kuu. Kwanza, sampuli zisizo na kasoro huwekwa katika makundi kwa K-Means ili kuunda hifadhi ndogo ya wagombea inayowakilisha usambazaji wa data. Kisha perturbations za PGD hutengenezwa kwenye surrogate MLP inayoweza kutofautishwa, na sampuli hizi asilia/adversarial hupelekwa kwa kiainishaji lengwa cha black-box ili kuhesabu Adversarial Influence. Katika hatua ya mwisho, wagombea hupangwa kulingana na influence score na huhifadhiwa sampuli zisizo na kasoro zenye athari ya juu zaidi kwa idadi sawa na sampuli zenye kasoro.
Mbinu hiyo inalinganishwa na mbinu sita za resampling kwenye seti 18 za data za kasoro za programu zinazopatikana kwa umma na viainishaji vitano tofauti. Chanzo kinaripoti, kwa wastani dhidi ya baseline wakilishi, maboresho ya %9,50 katika Balance, %3,43 katika AUC na %17,02 katika MCC. Hata hivyo, AIIUS haitoi matokeo ya juu zaidi katika kila kiainishaji na kila kipimo; faida yake inaonekana zaidi katika vipimo vinavyostahimili kutokuwiana kwa madarasa, kama MCC na Balance.
Kwa nini kutokuwiana kwa madarasa ni tatizo katika utabiri wa kasoro za programu?
Sehemu kubwa ya moduli katika mradi wa programu inaweza kuwa haina kasoro. Katika hali hii, darasa la wengi katika data ya mafunzo, yaani sampuli zisizo na kasoro, linaweza kuzidi idadi ya sampuli zenye kasoro kwa mara kadhaa au hata makumi ya mara.
Katika seti za data zilizochunguzwa kwenye chanzo, uwiano wa kutokuwiana hufafanuliwa kwa
\[ IR=\frac{N_{\mathrm{maj}}}{N_{\mathrm{min}}} \]
Hapa \(N_{\mathrm{maj}}\) ni idadi ya sampuli zisizo na kasoro za darasa la wengi, na \(N_{\mathrm{min}}\) ni idadi ya sampuli zenye kasoro za darasa la wachache.
Katika seti 18 za data za utafiti, uwiano huu hutofautiana takriban kati ya 3,50 na 25,08.
Katika usambazaji wa aina hii, modeli inayoboresha usahihi wa jumla pekee inaweza kuonyesha mafanikio ya juu kwa mwonekano kwa kuchagua darasa la wengi mara nyingi sana. Lakini kwa mtazamo wa kiutendaji, makosa mawili ni muhimu:
- Kukubali moduli yenye kasoro kuwa haina kasoro, yaani false negative, kunaweza kusababisha kasoro halisi kutogunduliwa.
- Kutangaza moduli isiyo na kasoro kuwa ina kasoro, yaani false positive, kunaweza kusababisha gharama zisizo za lazima za upimaji na ukaguzi.
Tofauti kati ya oversampling na undersampling
Oversampling hujaribu kuongeza darasa la wachache. Mbinu kama SMOTE hutengeneza nukta sintetiki kati ya sampuli zilizopo zenye kasoro. Mbinu hii inaweza kusawazisha uwiano wa madarasa, lakini kuna hatari kwamba sampuli sintetiki zitaongeza kelele au mwingiliano wa madarasa.
Undersampling, kwa upande mwingine, huondoa baadhi ya sampuli kutoka darasa la wengi. Faida yake ni kwamba haitengenezi sampuli sintetiki zenye kasoro; hata hivyo, ni muhimu sana kujua ni sampuli zipi za darasa la wengi zinazoondolewa.
Undersampling ya nasibu inaweza pia kuondoa sampuli muhimu zisizo na kasoro zinazofafanua mpaka wa uamuzi. Hapa ndipo AIIUS inapoanzia: si sampuli zote za darasa la wengi ambazo hazihitajiki kwa kiwango sawa.
Adversarial Influence hupima nini?
Adversarial Influence ni alama ya umuhimu wa sampuli inayotegemea mwitikio wa modeli na hupima ni kwa kiasi gani uwezekano wa utabiri wa kiainishaji lengwa hubadilika baada ya perturbation ndogo iliyolengwa. Lengo ni kutumia mwitikio wa modeli kwa mabadiliko ya eneo badala ya kuangalia tu jiometri ya data au kutokuwa na uhakika kwa kiainishaji katika nukta moja.
Kwa sampuli isiyo na kasoro \(x\) na mwenzake adversarial \(x_{\mathrm{adv}}\):
\[ \boxed{ I(x)= \left( F_{\mathrm{target}}(x_{\mathrm{adv}}) - F_{\mathrm{target}}(x) \right)^2 } \]
hufafanuliwa.
Hapa:
- \(F_{\mathrm{target}}(x)\): uwezekano wa kasoro unaotolewa na kiainishaji lengwa kwa sampuli asilia,
- \(F_{\mathrm{target}}(x_{\mathrm{adv}})\): uwezekano unaotolewa kwa sampuli iliyowekewa perturbation,
- \(I(x)\): ni thamani ya Adversarial Influence inayofafanuliwa kwa mraba wa mabadiliko ya utabiri.
Kadiri thamani inavyoongezeka, ndivyo inavyoeleweka kuwa modeli lengwa ni nyeti zaidi kwa perturbation katika eneo la karibu la sampuli hiyo. Utafiti hutumia unyeti huu kama ishara mbadala ya umuhimu wa sampuli kwa mtazamo wa mpaka wa uamuzi.
Inatofautianaje na kipimo cha kutokuwa na uhakika?
Mbinu ya kawaida ya uncertainty mara nyingi huangalia jinsi utabiri wa sasa wa kiainishaji ulivyo karibu na kizingiti cha uamuzi kama 0,5.
Adversarial Influence huuliza swali tofauti:
“Nikifanya mabadiliko madogo na yaliyoelekezwa katika nukta hii, utabiri wa modeli unasogea kwa kiasi gani?”
Kwa hiyo kipimo kinategemea tabia ya mwitikio wa eneo ya modeli badala ya uwezekano tuli wa utabiri.
Kikomo muhimu cha tafsiri
Adversarial Influence si umbali wa moja kwa moja wa kihisabati hadi mpaka wa uamuzi, wala haihesabu moja kwa moja ni kwa kiasi gani mpaka wa modeli iliyofunzwa upya utabadilika sampuli ikiondolewa kwenye seti ya data. Utafiti huu huitumia kama kipimo cha instance-importance kinachotokana na unyeti wa eneo wa tabia ya uamuzi.
Mbinu na Matokeo ya Utafiti
Hatua tatu za AIIUS
| Hatua | Mchakato | Lengo |
|---|---|---|
| 1 | Uteuzi wa wawakilishi kwa K-Means | Kujaribu kuhifadhi usambazaji wa jumla huku ukipunguza ziada katika darasa la wengi |
| 2 | PGD inayotegemea surrogate na Adversarial Influence | Kupima unyeti wa uamuzi wa eneo wa kila mgombea kwa modeli lengwa |
| 3 | Influence-guided undersampling | Kuunda data iliyosawazishwa kwa kuhifadhi sampuli zisizo na kasoro zenye influence ya juu zaidi |
Hatua ya kwanza: hifadhi ya wagombea kwa K-Means
Darasa la wengi lisilo na kasoro
\[ S_{\mathrm{maj}} \]
hutumiwa K-Means.
Idadi ya makundi:
\[ K=\lambda|S_{\mathrm{min}}| \]
huamuliwa.
Katika majaribio makuu:
\[ \lambda=3 \]
hutumiwa.
Sampuli halisi isiyo na kasoro iliyo karibu zaidi na centroid ya kila kundi huchaguliwa. Hivyo hifadhi ya wagombea wa darasa la wengi yenye ukubwa wa takriban
\[ 3|S_{\mathrm{min}}| \]
hupatikana.
Lengo la hatua hii si kufanya undersampling ya mwisho moja kwa moja. Hapa K-Means hutumiwa kupunguza idadi ya sampuli zitakazoingia katika tathmini ya adversarial huku ikihifadhi wawakilishi kutoka maeneo tofauti ya darasa la wengi.
Hatua ya pili: modeli surrogate
Katika modeli lengwa kama KNN na Random Forest, gradient za ingizo zinazohitajika huenda zisipatikane moja kwa moja. Kwa hiyo utafiti hufunza:
\[ F_{\mathrm{surrogate}} \]
MLP inayoweza kutofautishwa inayoonyeshwa kwa ishara hiyo.
Surrogate hutumiwa kuwakilisha kwa ukaribu tabia ya uamuzi ya modeli lengwa na kuamua mwelekeo ambao perturbation ya PGD itatengenezwa.
Hata hivyo, Adversarial Influence ya mwisho haikokotolewi kutokana na matokeo ya surrogate pekee. Sampuli asilia na adversarial hupelekwa tena kwa kiainishaji lengwa ili kupima mabadiliko halisi ya utabiri wa modeli lengwa.
Perturbation ya PGD
Kwa sampuli moja, mwanzo huchukuliwa kuwa:
\[ x_0=x \]
na iteresheni ya PGD hutekelezwa kama:
\[ x_{t+1} = \Pi_{\|\delta\|_\infty\leq\epsilon} \left[ x_t+ \alpha\, \mathrm{sign} \left( \nabla_x \mathcal L(F_{\mathrm{surrogate}}(x_t)) \right) \right] \]
kwa namna hiyo.
Hapa:
- \(\epsilon\): ukubwa wa juu wa perturbation,
- \(\alpha\): ukubwa wa hatua,
- \(T\): idadi ya iteresheni za PGD.
Badala ya kuwekwa kwa mkono, vigezo hivi vitatu huchaguliwa kwa Differential Evolution. Lengo la uboreshaji ni cross-validated MCC kwenye data ya mafunzo.
Hatua ya tatu: influence-guided selection
Baada ya alama za \(I(x)\) za sampuli zote wakilishi zisizo na kasoro kukokotolewa, sampuli hupangwa kuanzia kubwa hadi ndogo.
Sampuli zisizo na kasoro zenye influence ya juu zaidi kwa idadi ya
\[ |S_{\mathrm{min}}| \]
huchaguliwa:
\[ |\widetilde S_{\mathrm{maj}}| = |S_{\mathrm{min}}|. \]
Seti ya mwisho ya data iliyosawazishwa:
\[ D_{\mathrm{balance}} = \widetilde S_{\mathrm{maj}} \cup S_{\mathrm{min}} \]
huundwa kwa namna hiyo.
Muhtasari wa algoriti ya AIIUS
- Gawanya data katika madarasa yenye kasoro na yasiyo na kasoro.
- Amua \(K=\lambda|S_{\mathrm{min}}|\).
- Gawanya sampuli zisizo na kasoro katika makundi \(K\) kwa K-Means.
- Chagua sampuli halisi iliyo karibu zaidi na centroid ya kila kundi.
- Funza surrogate MLP.
- Amua vigezo vya PGD kwa Differential Evolution.
- Tengeneza sampuli adversarial kwa kila mwakilishi.
- Kokotoa Adversarial Influence kupitia Target classifier.
- Panga sampuli kulingana na influence score.
- Hifadhi sampuli zisizo na kasoro \(|S_{\mathrm{min}}|\) zenye alama za juu zaidi.
- Ziunganishe na sampuli zenye kasoro ili kuunda seti ya mafunzo iliyosawazishwa 1:1.
Seti za data za majaribio
Utafiti hutumia seti 18 za data kutoka vyanzo vinne vya data vilivyo wazi:
- AEEEM: JDT, LC, ML, PDE
- NASA: CM1, MW1, PC1, PC3, PC4
- PROMISE: ant-1.3, camel-1.0, synapse-1.0, xalan-2.4
- SOFTLAB: AR1, AR3, AR4, AR5, AR6
Idadi ya sifa hutofautiana takriban kati ya 20 na 61.
Uwiano wa juu zaidi wa kutokuwiana unaripotiwa katika seti ya data ya PROMISE camel-1.0:
\[ IR=25.08 \]
unaripotiwa.
Viainishaji vitano lengwa
- K-Nearest Neighbors (KNN)
- Random Forest (RF)
- Decision Tree (TREE)
- Logistic Regression (LR)
- Naive Bayes (NB)
Chanzo huzitumia kwa vigezo chaguo-msingi vya scikit-learn.
Baseline sita
- UFIDSF
- SB-GAN
- Cluster-based undersampling
- Random Undersampling
- Borderline-SMOTE
- SMOTE
Itifaki ya majaribio
Kwanza kila sifa ya namba:
\[ x_i^{(j)} \leftarrow \log(x_i^{(j)}+1) \]
hubadilishwa kwa mabadiliko hayo.
Kisha stratified 5-fold cross-validation hutumika. Resampling hufanywa kwenye fold ya mafunzo pekee. Fold ya majaribio hutathminiwa kwa usambazaji asilia wa madarasa.
Mchakato mzima hurudiwa kwa random initialization 10 tofauti na wastani wa matokeo huchukuliwa.
Vipimo vya utendaji vilivyotumika
Probability of Detection / Recall:
\[ PD= \frac{TP}{TP+FN} \]
Probability of False Alarm:
\[ PF= \frac{FP}{TN+FP} \]
Balance:
\[ Balance = 1- \frac{ \sqrt{ PF^2+(1-PD)^2 } }{ \sqrt2 } \]
Pia AUC na MCC hutumika.
MCC ni muhimu hasa katika uainishaji usio na uwiano kwa sababu huzingatia TP, TN, FP na FN zote kwa pamoja:
\[ MCC= \frac{ TP\times TN-FP\times FN }{ \sqrt{ (TP+FP)(TP+FN)(TN+FP)(TN+FN) } }. \]
AIIUS inatoa matokeo gani ikilinganishwa na mbinu nyingine za resampling?
Kwa mujibu wa muhtasari wa jumla wa chanzo, AIIUS hutoa kwa wastani faida ya %9,50 katika Balance, %3,43 katika AUC na %17,02 katika MCC dhidi ya mbinu wakilishi za baseline. Faida thabiti zaidi inaonekana kwenye MCC na Balance; hata hivyo, mbinu hii si ya kwanza katika kila mchanganyiko wa classifier-metric.
Matokeo ya Balance
| Kiainishaji | AIIUS Balance | Nafasi ya matokeo |
|---|---|---|
| KNN | 0,688 | Wastani wa juu zaidi |
| LR | 0,698 | Wastani wa juu zaidi |
| NB | 0,650 | Si wa juu zaidi |
| RF | 0,732 | Wastani wa juu zaidi |
| TREE | 0,662 | Wastani wa juu zaidi |
Kwa mfano, kwenye RF, ingawa thamani ya PD ya UFIDSF ni ya juu, thamani ya PF pia hupanda hadi 0,350. AIIUS hutoa PD=0,768 na PF=0,189, na kwa mchanganyiko huu hufikia Balance=0,732 ya juu zaidi.
Matokeo haya yanaonyesha kwamba AIIUS hailengi tu kupata kasoro nyingi zaidi, bali pia kusawazisha ugunduzi wa kasoro na tahadhari za uongo.
Matokeo ya AUC
Thamani za wastani za AUC za AIIUS:
- KNN: 0,723
- LR: 0,755
- NB: 0,691
- RF: 0,760
- TREE: 0,689
Kwenye RF na TREE, AIIUS hutoa wastani wa AUC wa juu zaidi. Kwenye KNN, LR na NB, baadhi ya baseline hupata thamani za juu zaidi.
Matokeo ya MCC
Thamani za wastani za MCC za AIIUS:
| Kiainishaji | AIIUS MCC |
|---|---|
| KNN | 0,316 |
| LR | 0,330 |
| NB | 0,299 |
| RF | 0,387 |
| TREE | 0,274 |
AIIUS hupata wastani wa MCC wa juu zaidi kwenye KNN, NB, RF na TREE. Kwenye LR, matokeo ya juu zaidi ni 0,338 ya SMOTE; AIIUS hubaki chini kidogo kwa 0,330.
Matokeo yanayovutia chini ya Random Forest
Wastani wa MCC kwa Random Forest:
| Mbinu | Wastani wa MCC |
|---|---|
| AIIUS | 0,387 |
| UFIDSF | 0,310 |
| SB-GAN | 0,323 |
| Cluster | 0,269 |
| RUS | 0,325 |
| Borderline-SMOTE | 0,335 |
| SMOTE | 0,337 |
Katika ulinganisho wa kiwango cha seti ya data na UFIDSF, AIIUS hupata matokeo ya 18/0/0 Win/Draw/Loss chini ya RF.
Kwa nini hatua ya K-Means ni muhimu?
K-Means haitumiki tu kupunguza gharama ya ukokotoaji. Hoja ya utafiti ni kwamba kuhifadhi tu sampuli zilizo karibu sana na mpaka wa uamuzi kunaweza kuacha maeneo salama na yenye msongamano wa darasa la wengi bila uwakilishi kabisa. Kuchukua kwanza wawakilishi kutoka maeneo mbalimbali ya usambazaji na kisha kufanya uteuzi unaotegemea influence kati yao kunajaribu kuunganisha malengo haya mawili.
Jaribio la clustering-ratio
Chanzo kinalinganisha mipangilio ifuatayo:
- No-cluster
- \(1\times|S_{\mathrm{min}}|\)
- \(2\times|S_{\mathrm{min}}|\)
- \(3\times|S_{\mathrm{min}}|\)
- \(3.5\times|S_{\mathrm{min}}|\)
Matokeo ya jumla:
\[ \boxed{\lambda=3} \]
mpangilio huu ndio chaguo lenye uwiano bora zaidi kati ya utendaji wa wastani na uthabiti kati ya seti za data.
Matokeo haya si ya mwelekeo mmoja kwa classifier zote. Kwa mfano, KNN inaweza kufanya vizuri zaidi katika baadhi ya wastani katika hali ya no-cluster; lakini mkengeuko sanifu wa juu unaonyesha kuwa mbinu inakuwa nyeti zaidi kwa mgawanyo wa data.
Uonyeshaji wa PCA
Katika mfano wa NASA PC4, chanzo kinawasilisha uonyeshaji wa PCA wa hatua tatu:
- Data asilia isiyo na uwiano,
- Sampuli wakilishi zisizo na kasoro baada ya K-Means,
- Data iliyosawazishwa baada ya uteuzi wa Adversarial Influence.
Uonyeshaji huu unaeleza kwamba AIIUS hutumia mkabala wa hatua mbili wa usambazaji + unyeti wa uamuzi badala ya “kukata darasa la wengi kwa nasibu”.
Je, modeli surrogate iliyo changamano zaidi huboresha AIIUS?
Katika chanzo, MLP ya kawaida inalinganishwa na usanifu surrogate wa Deep-MLP, CNN na ResNet. Matokeo yanaonyesha kuwa modeli surrogate zilizo changamano zaidi hazitoi ubora mkubwa na thabiti kwa upande wa MCC. Katika kiwango hiki cha data, MLP ya kawaida hutumiwa kama ukadiriaji wa kutosha wa kazi ya uamuzi.
| Kiainishaji | MLP | Deep-MLP | CNN | ResNet |
|---|---|---|---|---|
| KNN | 0,316 | 0,316 | 0,314 | 0,315 |
| LR | 0,330 | 0,298 | 0,316 | 0,311 |
| NB | 0,299 | 0,301 | 0,301 | 0,299 |
| RF | 0,387 | 0,390 | 0,382 | 0,385 |
| TREE | 0,274 | 0,279 | 0,281 | 0,275 |
Lengo hapa si surrogate kufanana kabisa na modeli lengwa; ni kuwakilisha kwa ukaribu wa kutosha tabia ya uamuzi ya modeli lengwa ili kutengeneza perturbation adversarial.
Gharama ya ukokotoaji ya AIIUS
Katika hatua ya kwanza K-Means ina gharama ya takriban:
\[ O( |S_{\mathrm{maj}}| K d I_{\mathrm{km}} ) \]
.
Mafunzo ya surrogate:
\[ O(ENd) \]
na sehemu ya PGD takriban:
\[ O(KT) \]
hutolewa hivyo.
Hoja za Target classifier:
\[ O(KC_{\mathrm{target}}) \]
na upangaji wa influence score:
\[ O(K\log K) \]
una gharama hiyo.
Chanzo, kikichukulia iteresheni za K-Means na ujifunzaji kama vidhibiti vidogo kwa vitendo, hufupisha muundo wa jumla kuwa takriban
\[ O\!\left( (|S_{\mathrm{maj}}||S_{\mathrm{min}}|+N)d \right) \]
.
Matokeo yanayoungwa mkono na utafiti
- Unyeti wa mpaka wa uamuzi unaweza kufanya kazi kama ishara inayoweza kutumiwa kuchagua sampuli za darasa la wengi.
- AIIUS imetoa matokeo yenye nguvu hasa kwenye MCC na Balance dhidi ya baseline nyingi katika seti 18 za data za SDP.
- Kuunda hifadhi ya wagombea ya ukubwa wa kati kwa K-Means kunaweza kuboresha utendaji na uthabiti kwa pamoja.
- Katika chanzo, uwiano wa clustering wa \(3\times\) kwa ujumla ndio sehemu ya kazi yenye uwiano bora zaidi.
- Surrogate MLP ya kawaida haikuwa mbaya kwa uthabiti kuliko usanifu surrogate ulio changamano zaidi katika majaribio haya.
- Katika viainishaji lengwa vya black-box, perturbations zinazotengenezwa kupitia surrogate zinaweza kutumiwa kwa madhumuni ya instance ranking.
Tafsiri zisizoungwa mkono na utafiti
- AIIUS si mbinu bora katika kila seti ya data, classifier na kipimo.
- Adversarial Influence haipimi umbali sahihi wa kijiometri hadi mpaka wa uamuzi.
- Influence ya juu haionyeshi moja kwa moja ni kwa kiasi gani kuondolewa kwa sampuli kutabadilisha mpaka wa uamuzi wa modeli iliyofunzwa upya.
- Utafiti haulengi kuendeleza shambulio la adversarial; perturbations hutumiwa kupima umuhimu wa sampuli.
- Matokeo hayawezi kujumlishwa kiotomatiki kwa matatizo yote ya uainishaji usio na uwiano.
- Haijaonyeshwa kwamba gharama ya ziada ya PGD na surrogate haina umuhimu katika mazingira makubwa zaidi au yenye mahitaji makali ya muda.
- Ikiwa modeli surrogate haiwezi kuwakilisha kwa kutosha tabia ya uamuzi ya modeli lengwa, ubora wa influence ranking unaweza kupungua.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Decision-Boundary Aware Undersampling via Adversarial Influence for Imbalanced Software Defect Prediction
Waandishi: Shuo Feng, Rongping Li, Jacky Keung, Xiao Yu, Yucheng Shi, Mingliang Xu.
Corresponding author: Yucheng Shi.
Taasisi: School of Computer Science and Artificial Intelligence, Zhengzhou University; Department of Computer Science, City University of Hong Kong; State Key Laboratory of Blockchain and Data Security, Zhejiang University.
Aina ya chanzo: Preprint ya utafiti wa majaribio katika uhandisi wa programu na ujifunzaji wa mashine.
Jukwaa: SSRN.
SSRN Abstract ID: 6963912.
DOI: 10.2139/ssrn.6963912.
Tarehe ya uchapishaji wa SSRN: 18 Juni 2026.
Hali ya mapitio ya rika: PDF ya chanzo inaeleza wazi kwamba ni preprint ambayo haijapitia mapitio ya rika.
Mkabala wa hakimiliki/leseni: Utafiti ulipakiwa SSRN mwezi Juni 2026. Maelezo ya leseni yaliyotolewa baadaye na SSRN yanasema kwamba kabla ya kuanzishwa kwa chaguo la leseni wazi, ulinzi wa chaguo-msingi ulikuwa all-rights-reserved. Kwa kuwa hakuna leseni wazi ya CC iliyoonyeshwa kwenye chanzo, maandishi ya Verianla yaliandaliwa kwa mkabala wa tahadhari wa matumizi tena; sentensi za chanzo na mipangilio asilia ya vielelezo haikuchapishwa tena.
Data: Seti 18 za data za software defect prediction zinazopatikana kwa umma; AEEEM, NASA, PROMISE na SOFTLAB.
Viainishaji: KNN, Random Forest, Decision Tree, Logistic Regression, Naive Bayes.
Mbinu za baseline: UFIDSF, SB-GAN, Cluster, Random Undersampling, Borderline-SMOTE ve SMOTE.
Tathmini: Stratified 5-fold cross-validation, majaribio 10 yaliyorudiwa, MCC, AUC, Balance, PD na PF.
Takwimu: Jaribio la Wilcoxon signed-rank, Cliff's delta na uchanganuzi wa Win/Draw/Loss.
Kikomo kikuu cha kimbinu: Adversarial Influence inategemea mabadiliko yanayosababishwa na perturbations zinazotengenezwa kupitia surrogate katika utabiri wa target classifier. Kwa hiyo ulinganifu wa kazi ya uamuzi ya surrogate-target ni mojawapo ya dhana msingi za mbinu.
Ujenzi upya wa taswira: Inafaa sana. Kwa mchoro asilia kabisa wa Verianla, inawezekana kuonyesha feature-space isiyo na uwiano, wawakilishi wa K-Means, mpaka wa uamuzi, mishale ya perturbation adversarial, influence ranking na seti ya mwisho ya data iliyosawazishwa.
Verianla Live / Live Figure: Inafaa. Jinsi sampuli zinavyopunguzwa katika nafasi ya uamuzi na jinsi sampuli za darasa la wengi zenye influence ya juu pekee zinavyohifadhiwa inaweza kuelezwa kwa uhuishaji kwenye seti ya data ya dhana yenye vigezo visivyobadilika.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *