

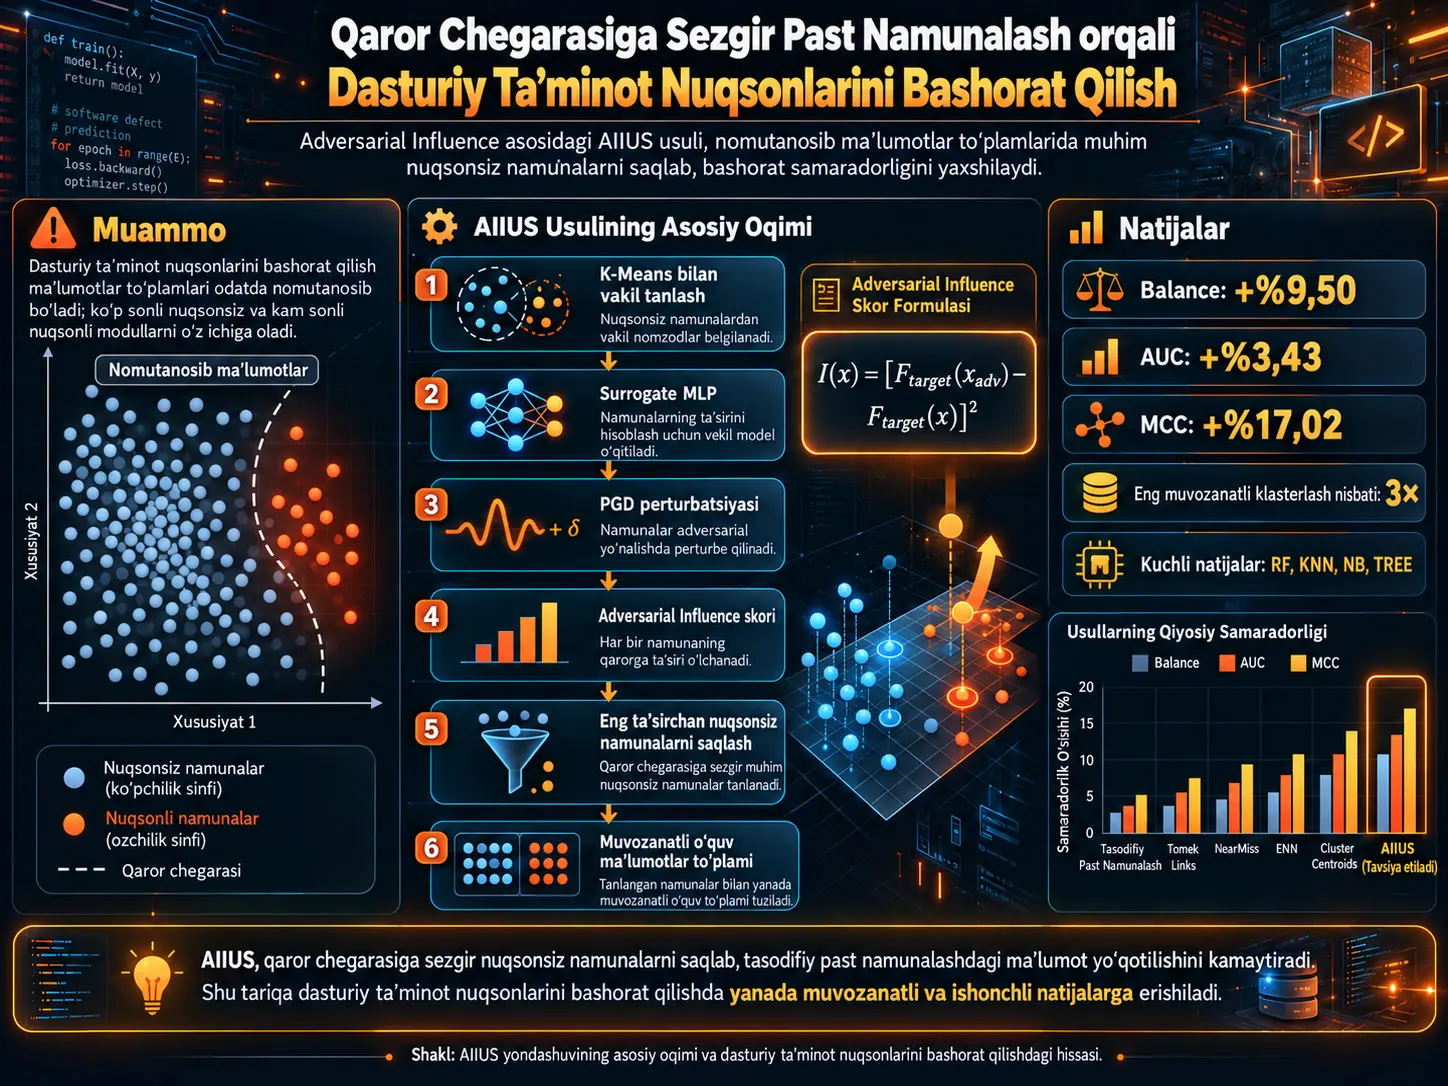
Dasturiy ta’minot nuqsonlarini bashorat qilish tizimlari qaysi kod modullarida nuqson bo‘lish ehtimoli yuqoriroq ekanini aniqlab, test va tekshiruv resurslaridan samaraliroq foydalanishga yordam berishi mumkin. Biroq haqiqiy dasturiy ta’minot ma’lumotlar to‘plamlarida nuqsonsiz modullar odatda nuqsonli modullarga qaraganda ancha ko‘p bo‘ladi. Bu sinf nomutanosibligi klassifikatorning umumiy aniqligi yuqori ko‘rinsa ham, nuqsonli namunalarni o‘tkazib yuborishiga yoki juda ko‘p yolg‘on signal berishiga olib kelishi mumkin.
Ushbu tadqiqot ko‘pchilik sinfidagi nuqsonsiz namunalarni tasodifiy kamaytirish o‘rniga qaror chegarasi nuqtai nazaridan muhimroq ko‘rinadigan namunalarni saqlashni maqsad qilgan Adversarial Influence-Based Intelligent Undersampling (AIIUS) usulini taklif qiladi. Usulning asosiy yangiligi bo‘lgan Adversarial Influence, namunaga kichik va yo‘naltirilgan perturbatsiya qo‘llanganda maqsad klassifikatorining nuqson ehtimoli prognozi qanchalik o‘zgarishini o‘lchaydi. Prognoz o‘zgarishi katta bo‘lgan ko‘pchilik namunalari modelning qaror xatti-harakati nuqtai nazaridan ko‘proq axborot beruvchi nomzodlar sifatida ustuvorlashtiriladi.
AIIUS uchta asosiy bosqichdan iborat. Avval nuqsonsiz namunalar K-Means yordamida klasterlanib, ma’lumotlar taqsimotini ifodalovchi kichikroq nomzodlar hovuzi yaratiladi. Keyin differensiallanuvchi surrogate MLP ustida PGD perturbatsiyalari hosil qilinadi va ushbu asl/adversarial namunalar maqsad black-box klassifikatoriga berilib, Adversarial Influence hisoblanadi. Oxirgi bosqichda nomzodlar influence balli bo‘yicha tartiblanadi va nuqsonli namunalar soniga teng miqdordagi eng yuqori ta’sirli nuqsonsiz namunalar saqlab qolinadi.
Usul 18 ta ochiq dasturiy ta’minot nuqsonlari ma’lumotlar to‘plami va besh xil klassifikator ustida oltita qayta namunalash usuli bilan taqqoslanadi. Manba vakillik qiluvchi baseline-larga nisbatan o‘rtacha Balance bo‘yicha %9,50, AUC bo‘yicha %3,43 va MCC bo‘yicha %17,02 yaxshilanishni qayd etadi. Shunga qaramay AIIUS barcha klassifikatorlar va barcha metrikalarda eng yuqori natijani bermaydi; ustunlik ayniqsa MCC va Balance kabi sinf nomutanosibligiga chidamliroq o‘lchovlarda yaqqol ko‘rinadi.
Dasturiy ta’minot nuqsonlarini bashorat qilishda sinf nomutanosibligi nega muammo tug‘diradi?
Dasturiy ta’minot loyihasidagi modullarning katta qismi nuqsonsiz bo‘lishi mumkin. Bunday holatda o‘quv ma’lumotlaridagi ko‘pchilik sinfi, ya’ni nuqsonsiz namunalar, nuqsonli namunalar sonidan bir necha baravar, hatto o‘nlab baravar ko‘p bo‘lishi mumkin.
Manbada ko‘rib chiqilgan ma’lumotlar to‘plamlarida nomutanosiblik nisbati
\[ IR=\frac{N_{\mathrm{maj}}}{N_{\mathrm{min}}} \]
bilan aniqlanadi. Bu yerda \(N_{\mathrm{maj}}\) nuqsonsiz ko‘pchilik namunalar sonini, \(N_{\mathrm{min}}\) esa nuqsonli ozchilik namunalar sonini bildiradi.
Tadqiqotdagi 18 ta ma’lumotlar to‘plamida bu nisbat taxminan 3,50 dan 25,08 gacha o‘zgaradi.
Bunday taqsimotda faqat umumiy aniqlikni optimallashtiradigan model ko‘pchilik sinfini juda tez-tez tanlab, tashqi ko‘rinishda yuqori natija ko‘rsatishi mumkin. Biroq amaliy nuqtai nazardan ikki xil xato muhim:
- Nuqsonli modulni nuqsonsiz deb qabul qilish, ya’ni false negative, haqiqiy nuqsonning ko‘zdan qochishiga sabab bo‘lishi mumkin.
- Nuqsonsiz modulni nuqsonli deb belgilash, ya’ni false positive, keraksiz test va tekshiruv xarajatlarini keltirib chiqarishi mumkin.
Oversampling va undersampling o‘rtasidagi farq
Oversampling ozchilik sinfini kattalashtirishga harakat qiladi. SMOTE kabi usullar mavjud nuqsonli namunalar orasida sintetik nuqtalar hosil qiladi. Bu usul sinflar nisbatini muvozanatlashtirishi mumkin, biroq sintetik namunalar shovqinni yoki sinflarning ustma-ust tushishini kuchaytirish xavfiga ega.
Undersampling esa ko‘pchilik sinfidan ayrim namunalarni olib tashlaydi. Uning afzalligi sintetik nuqsonli namuna yaratmasligidir; ammo qaysi ko‘pchilik namunalari o‘chirilishi kritik ahamiyat kasb etadi.
Tasodifiy undersampling qaror chegarasini belgilovchi muhim nuqsonsiz namunalarni ham olib tashlashi mumkin. AIIUS aynan shu nuqtadan kelib chiqadi: ko‘pchilik namunalarining hammasi bir xil darajada ortiqcha emas.
Adversarial Influence nimani o‘lchaydi?
Adversarial Influence — kichik va yo‘naltirilgan perturbatsiyadan so‘ng maqsad klassifikatorining prognoz ehtimoli qanchalik o‘zgarishini o‘lchaydigan, model reaksiyasiga asoslangan namuna muhimligi ballidir. Maqsad faqat ma’lumotlar geometriyasiga yoki klassifikatorning bitta nuqtadagi noaniqligiga qarash o‘rniga modelning lokal o‘zgarishga reaksiyasidan foydalanishdir.
Nuqsonsiz \(x\) namunasi va uning adversarial mosligi \(x_{\mathrm{adv}}\) uchun:
\[ \boxed{ I(x)= \left( F_{\mathrm{target}}(x_{\mathrm{adv}}) - F_{\mathrm{target}}(x) \right)^2 } \]
deb aniqlanadi.
Bu yerda:
- \(F_{\mathrm{target}}(x)\): maqsad klassifikatorining asl namuna uchun chiqargan nuqson ehtimoli,
- \(F_{\mathrm{target}}(x_{\mathrm{adv}})\): perturbatsiya qo‘llangan namuna uchun chiqarilgan ehtimol,
- \(I(x)\): prognoz o‘zgarishining kvadrati bilan aniqlanadigan Adversarial Influence qiymatidir.
Qiymat oshgani sari maqsad modelining ushbu namuna yaqinidagi perturbatsiyaga sezgirligi yuqoriroq ekani tushuniladi. Tadqiqot bu sezgirlikni qaror chegarasi nuqtai nazaridan namuna muhimligiga doir proksi signal sifatida ishlatadi.
Noaniqlik o‘lchovidan farqi nimada?
Standart uncertainty yondashuvi ko‘pincha klassifikatorning joriy prognozi 0,5 kabi qaror chegarasiga qanchalik yaqin ekaniga qaraydi.
Adversarial Influence esa boshqa savolni beradi:
“Bu nuqtaga kichik va yo‘naltirilgan o‘zgarish kiritsam, model prognozi qanchalik siljiydi?”
Shunday qilib, o‘lchov statik prognoz ehtimolidan ko‘ra modelning lokal reaksiya xatti-harakatiga tayanadi.
Muhim talqin chegarasi
Adversarial Influence to‘g‘ridan-to‘g‘ri matematik qaror-chegarasi masofasi emas va namuna ma’lumotlar to‘plamidan chiqarilganda qayta o‘qitilgan model chegarasi qanchalik o‘zgarishini bevosita hisoblamaydi. Tadqiqot uni qaror xatti-harakatiga lokal sezgirlikdan kelib chiqqan instance-importance o‘lchovi sifatida qo‘llaydi.
Tadqiqot Usuli va Natijalari
AIIUSning uch bosqichi
| Bosqich | Jarayon | Maqsad |
|---|---|---|
| 1 | K-Means bilan vakil tanlash | Ko‘pchilik sinfidagi ortiqchalikni kamaytirib, umumiy taqsimotni saqlashga harakat qilish |
| 2 | Surrogate asosidagi PGD va Adversarial Influence | Har bir nomzodning maqsad model nuqtai nazaridan lokal qaror sezgirligini o‘lchash |
| 3 | Influence-guided undersampling | Eng yuqori influence qiymatiga ega nuqsonsiz namunalarni saqlab, muvozanatli ma’lumotlar yaratish |
Birinchi bosqich: K-Means bilan nomzodlar hovuzi
Nuqsonsiz ko‘pchilik sinfi
\[ S_{\mathrm{maj}} \]
ustida K-Means qo‘llanadi.
Klasterlar soni:
\[ K=\lambda|S_{\mathrm{min}}| \]
deb belgilanadi.
Asosiy tajribalarda:
\[ \lambda=3 \]
ishlatiladi.
Har bir klaster sentroidiga eng yaqin haqiqiy nuqsonsiz namuna tanlanadi. Natijada taxminan
\[ 3|S_{\mathrm{min}}| \]
hajmdagi ko‘pchilik nomzodlar hovuzi olinadi.
Bu bosqichning maqsadi bevosita yakuniy undersamplingni bajarish emas. Bu yerda K-Means adversarial baholashga kiradigan namunalar sonini kamaytirish bilan birga ko‘pchilik sinfining turli hududlaridan vakillarni saqlashga xizmat qiladi.
Ikkinchi bosqich: surrogate model
KNN va Random Forest kabi maqsad modellarda kerakli kirish gradientlari bevosita mavjud bo‘lmasligi mumkin. Shu sababli tadqiqot:
\[ F_{\mathrm{surrogate}} \]
bilan ifodalangan differensiallanuvchi MLPni o‘qitadi.
Surrogate maqsad modelining qaror xatti-harakatini taxminiy ifodalash va PGD perturbatsiyasi qaysi yo‘nalishda hosil qilinishini aniqlash uchun ishlatiladi.
Biroq yakuniy Adversarial Influence faqat surrogate chiqishidan hisoblanmaydi. Asl va adversarial namunalar yana maqsad klassifikatoriga berilib, haqiqiy maqsad-model prognoz o‘zgarishi o‘lchanadi.
PGD perturbatsiyasi
Namuna uchun boshlang‘ich holat:
\[ x_0=x \]
deb olinadi va PGD iteratsiyasi:
\[ x_{t+1} = \Pi_{\|\delta\|_\infty\leq\epsilon} \left[ x_t+ \alpha\, \mathrm{sign} \left( \nabla_x \mathcal L(F_{\mathrm{surrogate}}(x_t)) \right) \right] \]
ko‘rinishida qo‘llanadi.
Bu yerda:
- \(\epsilon\): maksimal perturbatsiya kattaligi,
- \(\alpha\): qadam kattaligi,
- \(T\): PGD iteratsiyalari soni.
Bu uch parametr qo‘lda qat’iy belgilanmaydi, balki Differential Evolution yordamida tanlanadi. Optimallashtirish maqsadi o‘quv ma’lumotlari ustidagi cross-validated MCC hisoblanadi.
Uchinchi bosqich: influence-guided selection
Barcha vakil nuqsonsiz namunalarning \(I(x)\) ballari hisoblangach, namunalar kattadan kichikka tartiblanadi.
Eng yuqori influence qiymatiga ega
\[ |S_{\mathrm{min}}| \]
ta nuqsonsiz namuna tanlanadi:
\[ |\widetilde S_{\mathrm{maj}}| = |S_{\mathrm{min}}|. \]
Yakuniy muvozanatli ma’lumotlar to‘plami:
\[ D_{\mathrm{balance}} = \widetilde S_{\mathrm{maj}} \cup S_{\mathrm{min}} \]
ko‘rinishida tuziladi.
AIIUS algoritmining qisqacha bayoni
- Ma’lumotlarni nuqsonli va nuqsonsiz sinflarga ajrat.
- \(K=\lambda|S_{\mathrm{min}}|\) ni belgilab ol.
- Nuqsonsiz namunalarni K-Means bilan \(K\) klasterga ajrat.
- Har bir klaster sentroidiga eng yaqin haqiqiy namunani tanla.
- Surrogate MLPni o‘qit.
- PGD parametrlarini Differential Evolution bilan belgilab ol.
- Har bir vakil uchun adversarial namuna yarat.
- Target classifier orqali Adversarial Influence ni hisobla.
- Namunalarni influence balli bo‘yicha tartibla.
- Eng yuqori ballga ega \(|S_{\mathrm{min}}|\) ta nuqsonsiz namunani saqla.
- Nuqsonli namunalar bilan birlashtirib, 1:1 muvozanatli o‘quv to‘plamini yarat.
Tajriba ma’lumotlar to‘plamlari
Tadqiqot to‘rtta ochiq ma’lumot manbasidan 18 ta ma’lumotlar to‘plamidan foydalanadi:
- AEEEM: JDT, LC, ML, PDE
- NASA: CM1, MW1, PC1, PC3, PC4
- PROMISE: ant-1.3, camel-1.0, synapse-1.0, xalan-2.4
- SOFTLAB: AR1, AR3, AR4, AR5, AR6
Xususiyatlar soni taxminan 20 dan 61 gacha o‘zgaradi.
Eng yuqori nomutanosiblik nisbati PROMISE camel-1.0 ma’lumotlar to‘plamida:
\[ IR=25.08 \]
deb qayd etilgan.
Beshta maqsad klassifikatori
- K-Nearest Neighbors (KNN)
- Random Forest (RF)
- Decision Tree (TREE)
- Logistic Regression (LR)
- Naive Bayes (NB)
Manba ularni scikit-learn dagi standart parametrlar bilan ishlatadi.
Oltita baseline
- UFIDSF
- SB-GAN
- Cluster-based undersampling
- Random Undersampling
- Borderline-SMOTE
- SMOTE
Tajriba protokoli
Avval har bir sonli xususiyat:
\[ x_i^{(j)} \leftarrow \log(x_i^{(j)}+1) \]
o‘zgartirishidan o‘tkaziladi.
Keyin stratified 5-fold cross-validation qo‘llanadi. Resampling faqat o‘quv foldida bajariladi. Test foldi asl sinf taqsimoti bilan baholanadi.
Butun protsedura 10 xil random initialization bilan takrorlanadi va natijalar o‘rtachasi olinadi.
Qo‘llanilgan samaradorlik o‘lchovlari
Probability of Detection / Recall:
\[ PD= \frac{TP}{TP+FN} \]
Probability of False Alarm:
\[ PF= \frac{FP}{TN+FP} \]
Balance:
\[ Balance = 1- \frac{ \sqrt{ PF^2+(1-PD)^2 } }{ \sqrt2 } \]
Bundan tashqari AUC va MCC ham ishlatiladi.
MCC ayniqsa nomutanosib klassifikatsiyada foydalidir, chunki u TP, TN, FP va FNning barchasini birgalikda hisobga oladi:
\[ MCC= \frac{ TP\times TN-FP\times FN }{ \sqrt{ (TP+FP)(TP+FN)(TN+FP)(TN+FN) } }. \]
AIIUS boshqa qayta namunalash usullariga nisbatan qanday natija beradi?
Manbaning umumiy xulosasiga ko‘ra AIIUS vakillik qiluvchi baseline usullariga nisbatan o‘rtacha Balance bo‘yicha %9,50, AUC bo‘yicha %3,43 va MCC bo‘yicha %17,02 yutuq beradi. Eng izchil ustunlik MCC va Balance ko‘rsatkichlarida kuzatiladi; ammo usul har bir classifier-metric kombinatsiyasida birinchi emas.
Balance natijalari
| Klassifikator | AIIUS Balance | Natijaning o‘rni |
|---|---|---|
| KNN | 0,688 | Eng yuqori o‘rtacha |
| LR | 0,698 | Eng yuqori o‘rtacha |
| NB | 0,650 | Eng yuqori emas |
| RF | 0,732 | Eng yuqori o‘rtacha |
| TREE | 0,662 | Eng yuqori o‘rtacha |
Masalan, RFda UFIDSFning PD qiymati yuqori bo‘lsa-da, PF qiymati ham 0,350 gacha ko‘tariladi. AIIUS esa PD=0,768 va PF=0,189 kombinatsiyasi bilan yuqoriroq Balance=0,732 ni ta’minlaydi.
Bu natija AIIUS faqat ko‘proq nuqson topishni emas, nuqsonni aniqlash bilan yolg‘on signal o‘rtasidagi muvozanatni maqsad qilishini ko‘rsatadi.
AUC natijalari
AIIUSning o‘rtacha AUC qiymatlari:
- KNN: 0,723
- LR: 0,755
- NB: 0,691
- RF: 0,760
- TREE: 0,689
RF va TREEda AIIUS eng yuqori o‘rtacha AUCni beradi. KNN, LR va NBda esa ayrim baseline-lar yuqoriroq qiymat oladi.
MCC natijalari
AIIUSning o‘rtacha MCC qiymatlari:
| Klassifikator | AIIUS MCC |
|---|---|
| KNN | 0,316 |
| LR | 0,330 |
| NB | 0,299 |
| RF | 0,387 |
| TREE | 0,274 |
AIIUS KNN, NB, RF va TREEda eng yuqori o‘rtacha MCCni oladi. LRda eng yuqori natija SMOTEning 0,338 qiymati; AIIUS 0,330 bilan undan biroz pastda qoladi.
Random Forestdagi e’tiborga molik natija
Random Forest uchun o‘rtacha MCC:
| Usul | O‘rtacha MCC |
|---|---|
| AIIUS | 0,387 |
| UFIDSF | 0,310 |
| SB-GAN | 0,323 |
| Cluster | 0,269 |
| RUS | 0,325 |
| Borderline-SMOTE | 0,335 |
| SMOTE | 0,337 |
AIIUS, UFIDSF bilan ma’lumotlar-to‘plami asosidagi taqqoslashda RF ostida 18/0/0 Win/Draw/Loss natijasini oladi.
K-Means bosqichi nega kerak?
K-Means faqat hisoblash xarajatini kamaytirish uchun ishlatilmaydi. Tadqiqotga ko‘ra, faqat qaror chegarasiga juda yaqin namunalarni saqlash ko‘pchilik sinfining xavfsiz va zich hududlarini butunlay vakilliksiz qoldirishi mumkin. Avval taqsimotning turli hududlaridan vakillar olish, keyin ular orasidan influence asosida tanlash bu ikki maqsadni birlashtirishga urinadi.
Clustering-ratio tajribasi
Manba quyidagi sozlamalarni taqqoslaydi:
- No-cluster
- \(1\times|S_{\mathrm{min}}|\)
- \(2\times|S_{\mathrm{min}}|\)
- \(3\times|S_{\mathrm{min}}|\)
- \(3.5\times|S_{\mathrm{min}}|\)
Umumiy natija:
\[ \boxed{\lambda=3} \]
sozlamasi o‘rtacha samaradorlik bilan ma’lumotlar to‘plamlari orasidagi barqarorlik o‘rtasida eng muvozanatli tanlov ekanidir.
Bu natija barcha classifierlar uchun monoton emas. Masalan, KNN no-cluster holatida ayrim o‘rtacha ko‘rsatkichlarda yaxshiroq bo‘lishi mumkin; biroq standart og‘ishining yuqoriligi usulning ma’lumot bo‘linishiga sezgirroq bo‘lib qolganini ko‘rsatadi.
PCA vizuallashtirish
NASA PC4 misolida manba uch bosqichli PCA vizuallashtirishini taqdim etadi:
- Asl nomutanosib ma’lumotlar,
- K-Meansdan keyingi vakil nuqsonsiz namunalar,
- Adversarial Influence tanlovidan keyingi muvozanatli ma’lumotlar.
Bu vizual AIIUS “ko‘pchilik sinfini tasodifiy kesish” o‘rniga ikki bosqichli taqsimot + qaror-sezgirligi yondashuvidan foydalanishini ko‘rsatadi.
Murakkabroq surrogate model AIIUSni yaxshilaydimi?
Manbada standart MLP Deep-MLP, CNN va ResNet surrogate arxitekturalari bilan taqqoslanadi. Natijalar murakkabroq surrogate modellar MCC nuqtai nazaridan izchil va katta ustunlik bermasligini ko‘rsatadi. Ushbu ma’lumot miqyosida standart MLP yetarli qaror-funksiyasi yaqinlashuvi sifatida ishlatiladi.
| Klassifikator | MLP | Deep-MLP | CNN | ResNet |
|---|---|---|---|---|
| KNN | 0,316 | 0,316 | 0,314 | 0,315 |
| LR | 0,330 | 0,298 | 0,316 | 0,311 |
| NB | 0,299 | 0,301 | 0,301 | 0,299 |
| RF | 0,387 | 0,390 | 0,382 | 0,385 |
| TREE | 0,274 | 0,279 | 0,281 | 0,275 |
Bu yerda maqsad surrogate maqsad model bilan aynan bir xil bo‘lishi emas; adversarial perturbatsiya yaratish uchun maqsad qaror xatti-harakatini yetarlicha yaqin ifodalashdir.
AIIUSning hisoblash xarajati
Birinchi bosqichda K-Means taxminan:
\[ O( |S_{\mathrm{maj}}| K d I_{\mathrm{km}} ) \]
xarajatga ega.
Surrogate o‘qitish:
\[ O(ENd) \]
va PGD qismi taxminan:
\[ O(KT) \]
deb beriladi.
Target classifier so‘rovlari:
\[ O(KC_{\mathrm{target}}) \]
va influence ballarini tartiblash:
\[ O(K\log K) \]
xarajatga ega.
Manba K-Means va o‘rganish iteratsiyalarini amalda kichik konstantalar deb olib, umumiy tuzilmani taxminan
\[ O\!\left( (|S_{\mathrm{maj}}||S_{\mathrm{min}}|+N)d \right) \]
ko‘rinishida umumlashtiradi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Qaror chegarasi sezgirligi ko‘pchilik-sinfi namunalarini tanlash uchun foydalanish mumkin bo‘lgan signal sifatida ishlashi mumkin.
- AIIUS 18 SDP ma’lumotlar to‘plamida ko‘plab baseline-larga nisbatan ayniqsa MCC va Balance bo‘yicha kuchli natijalar ko‘rsatgan.
- K-Means bilan o‘rta hajmdagi nomzodlar hovuzini yaratish samaradorlik va barqarorlikni birgalikda yaxshilashi mumkin.
- Manbada \(3\times\) clustering nisbati umumiy holda eng muvozanatli ish nuqtasidir.
- Standart MLP surrogate ushbu tajribalarda murakkabroq surrogate arxitekturalaridan izchil ravishda yomon emas.
- Black-box maqsad klassifikatorlarida surrogate orqali yaratilgan perturbatsiyalar instance ranking maqsadida qo‘llanishi mumkin.
Tadqiqot qo‘llab-quvvatlamaydigan talqinlar
- AIIUS har bir ma’lumotlar to‘plami, classifier va metrikada eng yaxshi usul emas.
- Adversarial Influence qaror chegarasigacha bo‘lgan aniq geometrik masofani o‘lchamaydi.
- Yuqori influence namunani olib tashlash qayta o‘qitilgan qaror chegarasini aynan qanchalik o‘zgartirishini bevosita ko‘rsatmaydi.
- Tadqiqot adversarial hujum ishlab chiqishni maqsad qilmaydi; perturbatsiyalar namuna muhimligini o‘lchash uchun ishlatiladi.
- Natijalarni barcha nomutanosib klassifikatsiya muammolariga avtomatik umumlashtirib bo‘lmaydi.
- Kattaroq yoki vaqtga kritik ma’lumot muhitlarida qo‘shimcha PGD va surrogate xarajati ahamiyatsiz ekani ko‘rsatilmagan.
- Surrogate model maqsad qaror xatti-harakatini yetarlicha ifodalay olmasa, influence tartibining sifati pasayishi mumkin.
Manba va Usul Haqida Izoh
Asl sarlavha: Decision-Boundary Aware Undersampling via Adversarial Influence for Imbalanced Software Defect Prediction
Mualliflar: Shuo Feng, Rongping Li, Jacky Keung, Xiao Yu, Yucheng Shi, Mingliang Xu.
Corresponding author: Yucheng Shi.
Tashkilotlar: School of Computer Science and Artificial Intelligence, Zhengzhou University; Department of Computer Science, City University of Hong Kong; State Key Laboratory of Blockchain and Data Security, Zhejiang University.
Manba turi: Dasturiy injiniring va mashinani o‘rganish sohasidagi eksperimental tadqiqot preprinti.
Platforma: SSRN.
SSRN Abstract ID: 6963912.
DOI: 10.2139/ssrn.6963912.
SSRN nashr sanasi: 18 iyun 2026.
Taqriz holati: Manba PDF hujjati uning taqrizdan o‘tmagan preprint ekanini aniq bildiradi.
Mualliflik huquqi/litsenziya yondashuvi: Tadqiqot 2026-yil iyun oyida SSRNga yuklangan. SSRN keyinroq e’lon qilgan litsenziya izohi ochiq litsenziya varianti joriy etilishidan oldin standart himoya all-rights-reserved bo‘lganini bildiradi. Manbada ochiq CC litsenziyasi ko‘rsatilmagani sababli Verianla matni ehtiyotkor qayta-foydalanish yondashuvi bilan tayyorlangan; manba jumlalari va original figura tuzilmalari qayta nashr etilmagan.
Ma’lumotlar: 18 ta ochiq software defect prediction ma’lumotlar to‘plami; AEEEM, NASA, PROMISE va SOFTLAB.
Klassifikatorlar: KNN, Random Forest, Decision Tree, Logistic Regression, Naive Bayes.
Baseline usullari: UFIDSF, SB-GAN, Cluster, Random Undersampling, Borderline-SMOTE ve SMOTE.
Baholash: Stratified 5-fold cross-validation, 10 takrorli tajriba, MCC, AUC, Balance, PD va PF.
Statistika: Wilcoxon signed-rank testi, Cliff's delta va Win/Draw/Loss tahlili.
Asosiy uslubiy cheklov: Adversarial Influence surrogate orqali yaratilgan perturbatsiyalarning target classifier prognozida hosil qilgan o‘zgarishiga asoslanadi. Shu sababli surrogate-target qaror funksiyasi mosligi usulning asosiy farazlaridan biridir.
Vizual qayta qurish: Juda mos. Butunlay original Verianla sxemasi yordamida nomutanosib feature-space, K-Means vakillari, qaror chegarasi, adversarial perturbatsiya o‘qlari, influence ranking va yakuniy muvozanatli ma’lumotlar to‘plamini ko‘rsatish mumkin.
Verianla Live / Live Figure: Mos. Namunalar qaror fazosida qanday kamaytirilishi va faqat yuqori-influence ko‘pchilik namunalari qanday saqlanishi qat’iy konseptual ma’lumotlar to‘plami ustida animatsiya bilan tushuntirilishi mumkin.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan