

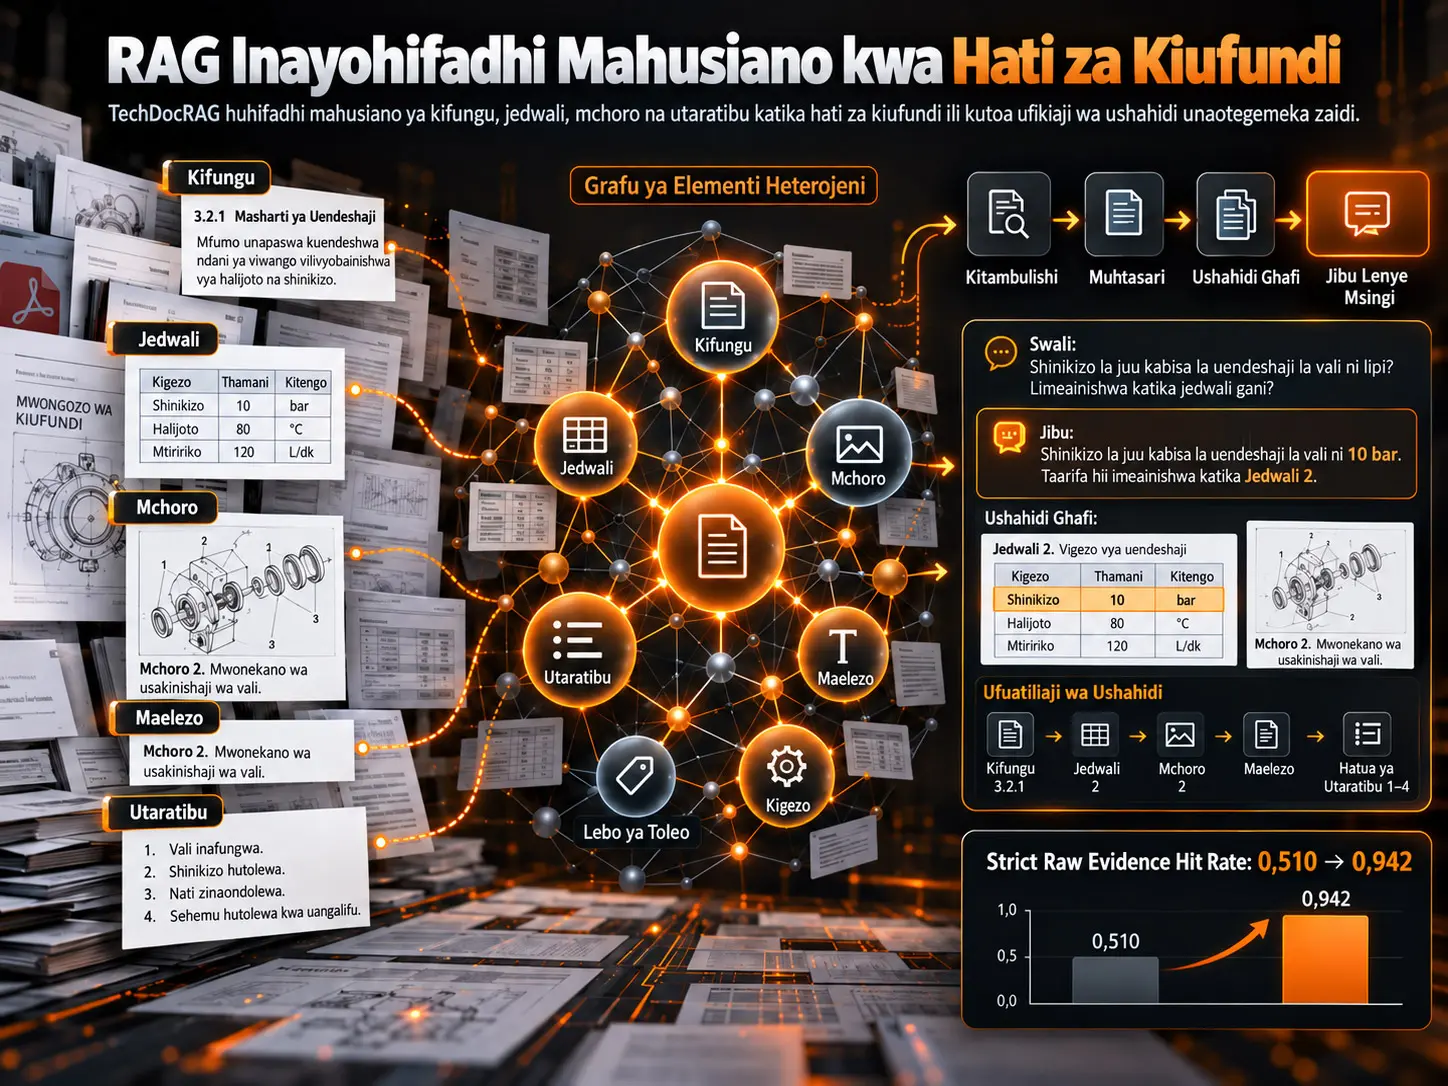
TechDocRAG ni mfumo wa retrieval-augmented generation (RAG) unaowakilisha hati za kiufundi si kama mkusanyiko tambarare wa vipande huru vya maandishi, bali kama grafu yenye aina tofauti za elementi inayohifadhi uhusiano kati ya vifungu, aya, majedwali, vielelezo, maelezo ya picha, sehemu na hatua za taratibu. Mfumo huweka kila elementi ya hati katika faharasa kwa mitazamo mitatu iliyolinganishwa: vitambulishi vya kiufundi, muhtasari wa kisemantiki na ushahidi ghafi. Wakati wa hoja, elementi zinazowezekana hupatikana kwanza kupitia vitambulishi vya kiufundi; kisha upanuzi hufanywa kupitia grafu kwenda kwenye elementi zinazohusiana kulingana na nia ya hoja, muhtasari wa kisemantiki hupangwa upya, na katika hatua ya mwisho vitu vya ushahidi ghafi vilivyounganishwa hutumwa kwa modeli zalishi ndani ya kifurushi kimoja cha muktadha.
Utafiti uliitathmini TechDocRAG kwenye benchmark nne—MPMQA, DesignQA, MMLongBench-Doc na LongDocURL—kwa zaidi ya jozi 7500 za maswali na majibu zilizosawazishwa. Katika majaribio yaliyotumia jenereta ileile ya majibu na bajeti za muktadha zinazolinganishwa, TechDocRAG ilifikia alama 68,5 kwenye MPMQA, 62,2 kwenye DesignQA, 58,4 kwenye MMLongBench-Doc na 55,2 kwenye LongDocURL. Kwa wastani wa benchmark nne, iliripotiwa kuwa juu kwa pointi 20,3 dhidi ya Hybrid Dense+BM25, ambayo ilikuwa njia yenye nguvu zaidi ya flat, na kwa pointi 9,3 dhidi ya VisRAG, ambayo ilikuwa njia yenye nguvu zaidi ya non-flat.
Tofauti ni wazi zaidi katika ufuatiliaji wa ushahidi. Katika tathmini kali zaidi ya Raw Evidence Hit Rate (REHR), inayotumia exact identifier matching, Hybrid RAG ilikuwa 0,510 ilhali TechDocRAG ilifikia 0,942. Majaribio ya ablation yanaonyesha kuwa kuondoa identifier-aware recall huathiri kwa kiasi kikubwa upatikanaji wa ushahidi ghafi, kuondoa relation edge huathiri muunganisho wa ushahidi, na kuondoa raw bundling huathiri kiwango ambacho madai yaliyozalishwa yanaungwa mkono na ushahidi ghafi.
Hata hivyo, mfumo unategemea ubora wa parsing ya hati za kiufundi. Hasa, uharibifu mkubwa wa vitambulishi vya kiufundi kama nambari ya kifungu, jina la parameta, au lebo ya kielelezo au jedwali unaweza kuangusha hatua ya kwanza ya retrieval. Kwa hiyo, matokeo hayapaswi kufasiriwa kama “kila RAG inayotumia grafu ni bora zaidi”; yanapaswa kufasiriwa kama ushahidi wa kimajaribio kwamba kuhifadhi uhusiano wa kimuundo na wa marejeleo ndani ya hati ni muhimu ili kufikia ushahidi sahihi katika hati za kiufundi.
Kwa nini RAG ya hati za kiufundi ni tofauti na RAG ya maandishi ya kawaida?
Vipimo vya kiufundi, miongozo ya matumizi, hati za matengenezo na viwango vya uhandisi kwa kawaida si simulizi moja endelevu. Ufafanuzi wa hitaji unaweza kuwa katika Sehemu 4.2, thamani ya kikomo katika Jedwali 7, mpangilio wa muunganisho katika Kielelezo 3, na onyo la hali maalum katika hatua inayofuata ya taratibu.
Kwa hiyo, kupata aya inayofanana kisemantiki pekee huenda kusiwe na kutosha kutoa jibu sahihi. Hata mfumo ukipata kifungu sahihi, ikiwa hauwezi kuleta jedwali, kielelezo au hatua ya taratibu iliyo jirani ambayo kifungu hicho kinarejelea, mlolongo wa ushahidi unabaki haujakamilika.
Hilo ndilo tatizo la msingi la TechDocRAG: kupata maandishi yanayohusiana na kupata ushahidi kamili na uliounganishwa unaounga mkono jibu si kazi moja.
TechDocRAG Inatofautianaje na RAG ya Kawaida?
RAG ya kawaida inayotegemea chunk hugawa hati hasa katika vipande vya maandishi vya urefu usiobadilika au vya kisemantiki na kushughulikia vipande hivyo kama vitengo huru vya retrieval. TechDocRAG, kwa upande mwingine, huhifadhi vitu asilia vya hati kama kifungu, jedwali, kielelezo, caption, hatua ya taratibu na taarifa ya toleo; na huhifadhi mahusiano kati yake kama table_ref, figure_ref, caption_of, step_next, version_of na mengine yanayofanana kama kingo za grafu. Kwa njia hii retrieval haijibu tu swali “ni maudhui gani yanafanana?”, bali pia “ushahidi huu unapaswa kusomwa pamoja na ushahidi gani mwingine?”.
Hati hubadilishwa kuwa grafu yenye aina tofauti za elementi
Hati ya kiufundi \(d\) inawakilishwa katika utafiti kwa grafu ifuatayo:
\[ G_d=(V_d,E_d) \]
Hapa \(V_d\) inawakilisha nodi za elementi katika hati, na \(E_d\) inawakilisha mahusiano kati ya elementi hizo.
Kila nodi hufafanuliwa kama:
\[ v=(\tau_v,r_v,k_v,s_v,m_v) \]
.
- \(\tau_v\): Aina ya elementi; kwa mfano kifungu, aya, jedwali, kielelezo, caption au hatua ya taratibu.
- \(r_v\): Kitu ghafi cha hati.
- \(k_v\): Vitambulishi vya kiufundi na maneno muhimu.
- \(s_v\): Muhtasari wa kisemantiki.
- \(m_v\): Metadata kama faharasa ya ukurasa, bounding box, njia ya sehemu, aina ya hati, toleo na normative label.
Muundo huu huhifadhi utambulisho wa hati ambao unaweza kupotea wakati wa flat chunking.
Kingo za grafu zinawakilisha mahusiano gani?
| Uhusiano | Maana |
|---|---|
| contains | Sehemu au elementi ya juu kuwa na elementi za chini |
| precedes | Elementi moja kutokea kabla ya nyingine katika mpangilio wa usomaji wa karibu |
| same_section | Kuwa ndani ya sehemu au sehemu ndogo ileile |
| step_next | Muunganisho wa mfululizo wa hatua za taratibu |
| clause_ref | Rejeleo la wazi kutoka kifungu kimoja kwenda kifungu kingine |
| table_ref | Rejeleo kutoka maandishi kwenda jedwali |
| figure_ref | Rejeleo kutoka maandishi kwenda kielelezo |
| caption_of | Muunganisho kati ya kielelezo au jedwali na caption |
| same_identifier | Kitambulishi kilekile cha kiufundi kutumiwa tena katika elementi tofauti |
| version_of / supersedes | Uhusiano kati ya matoleo tofauti ya hati |
Lengo la retrieval si tu “kipande kinachohusiana zaidi”
Utafiti unafafanua tatizo la retrieval kama tatizo la kupata subgrafu ya ushahidi iliyounganishwa:
\[ H_q^*=\arg\max_{H\subseteq G} \left[ Rel(q,H)+\lambda Conn(H)+\gamma Valid(q,H)-\mu Cost(H) \right] \]
Katika dhima hii ya lengo:
- \(Rel(q,H)\) inawakilisha ufaafu wa kileksia na kisemantiki kati ya hoja na subgrafu ya ushahidi;
- \(Conn(H)\) inaonyesha muunganisho na ukamilifu wa nodi za ushahidi;
- \(Valid(q,H)\) inaonyesha ulinganifu wa metadata kama toleo la hati au aina ya hati;
- \(Cost(H)\) inaonyesha gharama ya retrieval na uundaji wa muktadha
.
\(\lambda\), \(\gamma\) na \(\mu\) ni uzito wa vipengele hivi katika dhima ya lengo. Lengo la kihisabati si kukusanya tu nodi zinazofanana zaidi, bali kuunda subgrafu ya ushahidi iliyo na muunganisho wa kutosha na iliyo halali kwa upande wa metadata.
Subgrafu iliyochaguliwa kisha hupelekwa kwa jenereta ya jibu:
\[ (y_q,\Pi_q)=f_\theta(q,H_q^*) \]
Hapa \(y_q\) inawakilisha jibu lililozalishwa, na \(\Pi_q\) inawakilisha miunganisho ya provenance kutoka kwa madai yaliyozalishwa hadi nodi za ushahidi ghafi.
Muundo wa “Identifier–Summary–Raw” wa Sehemu Tatu Una Kazi Gani?
TechDocRAG huhifadhi kila elementi ya hati katika mitazamo mitatu ya retrieval iliyofungamanishwa na utambulisho mmoja: mtazamo wa identifier hutumiwa kupata nanga sahihi za kiufundi, mtazamo wa summary kutathmini ufaafu wa kisemantiki kwa hoja, na mtazamo wa raw evidence kupeleka kwa modeli zalishi maandishi, jedwali, kielelezo au utaratibu asilia ambao jibu la mwisho linategemea. Mgawanyo huu huzuia muhtasari wenye manufaa ya kisemantiki lakini usioweza kufuatiliwa moja kwa moja hadi kwenye chanzo kuchukua nafasi ya ushahidi ghafi.
Identifier na muhtasari huzalishwaje?
Kwa kila nodi, seti ya identifier za kiufundi na muhtasari wa kisemantiki hufafanuliwa kama:
\[ k_v=ExtractId(r_v,m_v), \qquad s_v=Summarize(r_v,N(v)) \]
.
\(N(v)\) ni ujirani wa karibu wa mahusiano wa nodi. Muhtasari unaweza kutumia si tu maudhui ghafi ya elementi yenyewe, bali pia muktadha wa hati ulio karibu unaosaidia kuipa maana.
Uwakilishi uliolinganishwa wa kila nodi ni:
\[ \phi(v)=\{k_v,s_v,r_v,m_v\} \]
.
Hifadhidata katika kiwango cha korpasi hufafanuliwa kama:
\[ D=(I_{id},I_{sum},R,G) \]
.
- \(I_{id}\): Faharasa ya identifier za kiufundi.
- \(I_{sum}\): Faharasa ya muhtasari wa kisemantiki.
- \(R\): Hifadhi ya ushahidi ghafi.
- \(G\): Grafu ya mahusiano.
Kwa nini faharasa ya Identifier ni muhimu?
Katika hati za kiufundi, “Section 4.2”, “Table 7”, “parameter Z”, “error E105”, amri ya API au lebo ya toleo inaweza kuwa nanga yenye nguvu zaidi kisemantiki kuliko neno la kawaida.
Kwa hiyo TechDocRAG huipa vitambulishi vya kiufundi uzito maalum katika safu ya kwanza ya retrieval. Katika jaribio la ablation, identifier-aware recall inapoondolewa, thamani ya REHR@10 hushuka kutoka 0,94 katika modeli kamili hadi 0,65. Hii inaonyesha kwamba moja ya vyanzo muhimu vya utendaji wa mfumo ni kupata nanga sahihi ya kiufundi katika hatua ya mapema.
Hoja huchanganuliwa kwanza
Kila hoja hugawanywa katika vipengele vitatu:
\[ (k_q,e_q,z_q)=Analyze(q) \]
- \(k_q\): Identifier za kiufundi na maneno muhimu katika hoja.
- \(e_q\): Uwakilishi wa kisemantiki wa hoja.
- \(z_q\): Nia ya hoja.
Aina za nia zinazotumiwa katika chanzo zinajumuisha utafutaji wa ufafanuzi/hitaji, utaratibu au troubleshooting, reasoning ya maandishi-jedwali, grounding ya maandishi-kielelezo, utatuzi wa cross-reference na hoja nyeti kwa toleo.
Sera ileile ya retrieval haitumiki kwa kila swali
| Aina ya hoja | Mahusiano yanayopewa kipaumbele | Hop ya juu zaidi | Lengo kuu |
|---|---|---|---|
| Ufafanuzi / hitaji | contains, same_identifier, clause_ref | 1-2 | Kifungu au aya |
| Utaratibu / troubleshooting | step_next, contains, same_section | 2 | Hatua za taratibu |
| Maandishi-jedwali | table_ref, caption_of, same_identifier | 2 | Mstari wa jedwali / njia ya kichwa |
| Maandishi-kielelezo | figure_ref, caption_of, same_section | 2 | Jozi ya kielelezo-caption |
| Cross-reference | clause_ref, table_ref, figure_ref | 2 | Elementi iliyorejelewa |
| Hoja nyeti kwa toleo | version_of, supersedes, same_identifier | 1 | Nodi za marekebisho yaliyo hai |
Mantiki ya sera hii ni kwamba mahusiano ya hati yanayohitajika na swali “Parameta ni nini?” si yale yale yanayohitajika na swali “Sensor Y inarekebishwaje upya?”.
TechDocRAG Inachakataje Hoja Hatua kwa Hatua?
Mnyororo wa online retrieval huanza na identifier-aware recall, unaendelea kwa upanuzi wa grafu kulingana na nia ya hoja, wagombea waliopanuliwa hupangwa upya katika nafasi ya muhtasari wa kisemantiki, nodi zilizochaguliwa hutatuliwa hadi kwenye vitu vya ushahidi ghafi, na ushahidi unaohusiana hupakiwa kuwa kifurushi kimoja ndani ya bajeti ya muktadha. Jibu la mwisho huzalishwa kwa kutumia kifurushi hiki pekee na madai huunganishwa na ushahidi ghafi kupitia miunganisho ya provenance.
1. Identifier-aware recall
Seti ya kwanza ya wagombea hufafanuliwa katika chanzo kama ifuatavyo:
\[ C_{id}= TopK_{v\in V} \left[ \lambda_1 BM25(q,k_v) +\lambda_2 IdMatch(k_q,k_v) +\lambda_3 MetaMatch(q,m_v) \right] \]
BM25 hutathmini ulinganifu wa kileksia, IdMatch ulinganifu wa identifier ya kiufundi, na MetaMatch ulinganifu wa metadata na hoja.
2. Upanuzi katika grafu ya mahusiano
Majirani wa wagombea wa kwanza wanaolingana na nia ya hoja huongezwa:
\[ C_{id}^{e}=C_{id}\cup Expand(C_{id},\Omega(z_q)) \]
\(\Omega(z_q)\) ni sera inayobainisha ni aina gani za mahusiano zitafuatwa kwa nia husika ya hoja.
3. Summary-level reranking
Elementi zilizopanuliwa hupangwa upya katika nafasi ya muhtasari wa kisemantiki:
\[ C_{sum}=TopL_{v\in C_{id}^{e}} \left[ \alpha \cos(e_q,e_v) +\beta RelScore(v,C_{id}) +\gamma TypePrior(z_q,\tau_v) \right] \]
Wazo kuu hapa ni kwamba safu ya kwanza hutoa recall ya juu kwa exact technical anchors; safu ya pili hufinya wagombea hawa kulingana na lengo halisi la kisemantiki la hoja.
4. Ufungashaji wa ushahidi ghafi
Nodi zilizopangwa upya hubadilishwa kuwa ushahidi ghafi:
\[ C_{raw}=\bigcup_{v\in C_{sum}}Bundle(v) \]
Bundle inaweza kuwa na zaidi ya kipande kimoja cha maandishi. Kwa mfano, kifungu + jedwali kinachorejelewa; au sehemu iliyokatwa ya kielelezo + caption + aya inayorejelea kielelezo vinaweza kuwekwa ndani ya kifurushi kilekile cha ushahidi.
5. Bajeti ya muktadha
Ushahidi ghafi hupakiwa chini ya bajeti ya muktadha \(B\):
\[ E_q=Pack(C_{raw},B) \]
Katika itifaki ya majaribio, bajeti ya muktadha ilisawazishwa kuwa tokeni 2048 za maandishi na visual region 10 kwa mbinu za multimodal.
6. Grounded generation na provenance
Jibu la mwisho huzalishwa kwa:
\[ (\hat{y}_q,\Pi_q)=g_\theta(q,E_q) \]
.
Provenance katika kiwango cha dai hufafanuliwa kama:
\[ \Pi_q=\{(c_i,U_i)\}_{i=1}^{M}, \qquad U_i\subseteq C_{raw} \]
. Hapa kila \(c_i\) ni dai lililozalishwa, na \(U_i\) ni vitu vya ushahidi ghafi vinavyounga mkono dai hilo.
Kielelezo 1 cha PDF kinaeleza nini?
Kielelezo 1 katika chanzo kinagawanya usanifu katika sehemu kuu mbili. Kwa upande wa Offline index construction, hati za kiufundi hu-parse na ku-canonicalize, grafu yenye aina tofauti za elementi huundwa, na identifier index, summary index, raw store pamoja na relation store hupangiliwa kwa pamoja. Kwa upande wa Online query-time, hoja ya mtumiaji huchanganuliwa, identifier-aware recall hufanywa, upanuzi wa mahusiano na summary reranking hutumika, kifurushi cha ushahidi ghafi huundwa na jibu lenye provenance huzalishwa.
Kielelezo 2 cha PDF kinaongeza nini?
Kielelezo 2 kinalenga hasa mtiririko wa maamuzi wa online. Kinaonyesha kwamba kugawa hoja katika vipengele vya identifier na nia huamua relation policy itakayochaguliwa, kwamba majirani waliounganishwa huchukuliwa baada ya retrieval, na kwamba modeli zalishi hutumiwa vifurushi vya ushahidi ghafi vilivyounganishwa badala ya fragment huru.
Je, Kuhifadhi Mahusiano Kuliimarisha Utendaji Kweli?
Katika majaribio ya chanzo, TechDocRAG ilitoa alama za juu zaidi za end-to-end kuliko mifumo iliyolinganishwa kwenye benchmark zote nne. Tofauti kubwa zaidi haikuonekana tu katika utafutaji rahisi wa vifungu, bali pia katika maswali ya taratibu, maandishi-jedwali, cross-reference na maswali nyeti kwa toleo. Muundo huu unaendana na nadharia kuu ya utafiti: thamani kubwa zaidi ya mahusiano ya kimuundo hujitokeza katika hoja ambazo jibu hutegemea vitu kadhaa vya hati vilivyounganishwa.
Benchmark nne
- MPMQA: Maswali na majibu ya multimodal katika miongozo ya bidhaa; korpasi ya PM209 ina miongozo 209 na jozi 22.021 za maswali na majibu zilizowekewa lebo na binadamu.
- DesignQA: Uelewa wa grounded juu ya kanuni za Formula SAE, picha za CAD na michoro ya uhandisi.
- MMLongBench-Doc: Maswali 1062 yaliyowekewa lebo na wataalamu kwenye PDF ndefu 130; urefu wa wastani wa hati ni kurasa 49,4.
- LongDocURL: Jozi 2325 za maswali na majibu zinazofunika zaidi ya kurasa 33.000; kazi za uelewa, reasoning na kutafuta eneo.
Tathmini iliyodhibitiwa ilitumia zaidi ya jozi 7500 za maswali na majibu zilizosawazishwa zilizochaguliwa kutoka benchmark hizi nne.
Mbinu za RAG zilizolinganishwa
TechDocRAG ililinganishwa na Dense Chunk RAG, Hybrid Dense+BM25, Self-RAG, CRAG, RAPTOR, GraphRAG, LightRAG, HippoRAG 2 na VisRAG.
Kwa ulinganisho wa haki, jenereta ileile ya majibu ilitumika kadiri ilivyowezekana katika mbinu zote: Gemini-3.1-Flash-Lite-Preview. Ufikiaji wa wavuti ya nje ulizimwa, CRAG ilizuiliwa kwa corpus-only retrieval na bajeti za muktadha zilisawazishwa.
Maelezo ya utekelezaji wa TechDocRAG
| Kipengele | Usanidi |
|---|---|
| Parser ya hati | Parser ya multimodal inayotegemea OCR na kutumia Layout segmentation, figure-caption alignment na typed element extraction |
| Identifier canonicalization | Usawazishaji wa rule-based kwa ID za vifungu, lebo za jedwali/kielelezo, majina ya parameta na lebo za toleo; fuzzy matching wakati wa hoja |
| Identifier index | BM25 juu ya identifier iliyosawazishwa, nambari ya kifungu, lebo na maneno muhimu ya kikoa |
| Summary vector index | all-MiniLM-L6-v2 |
| Query analyzer | TinyLlama-1.1B-Chat-v1.0; batch size 16 |
| Answer generator | Gemini-3.1-Flash-Lite-Preview |
| Relation extraction | Explicit cross-reference parsing + layout heuristics |
| Retrieval | Top-10 identifier recall, 2-hop graph expansion, top-5 summary reranking |
| Context budget | Tokeni 2048 za maandishi + 10 visual region |
| Vifaa | Single-GPU inference |
Mbinu na Matokeo ya Utafiti
Matokeo ya end-to-end
| Mbinu | MPMQA | DesignQA | MMLong | LongDoc |
|---|---|---|---|---|
| Dense Chunk RAG | 44,8 | 40,5 | 33,2 | 31,4 |
| Hybrid Dense+BM25 | 48,2 | 44,1 | 36,5 | 34,2 |
| Self-RAG | 51,8 | 47,5 | 39,8 | 37,5 |
| CRAG | 52,4 | 48,8 | 40,5 | 38,2 |
| RAPTOR | 50,5 | 46,2 | 41,4 | 38,8 |
| GraphRAG | 54,8 | 50,5 | 44,8 | 42,4 |
| LightRAG | 55,6 | 51,2 | 46,1 | 43,8 |
| HippoRAG 2 | 56,5 | 52,8 | 47,5 | 45,2 |
| VisRAG | 54,2 | 57,5 | 48,8 | 46,5 |
| TechDocRAG | 68,5 | 62,2 | 58,4 | 55,2 |
Chanzo kinaripoti tofauti ya pointi 20,3 dhidi ya Hybrid Dense+BM25 na pointi 9,3 dhidi ya VisRAG katika wastani wa benchmark nne. Hizi ni tofauti kamili za pointi za alama za benchmark; si mabadiliko ya asilimia.
Kwa nini Raw Evidence Hit Rate ni muhimu?
Raw Evidence Hit Rate (REHR) hupima ikiwa mfumo umeweza kunasa angalau nodi moja ya kweli ya gold-standard ya ushahidi ghafi ndani ya matokeo ya retrieval:
\[ REHR@K= \frac{1}{|Q|} \sum_{q\in Q} \mathbf{1} \left[ V_q^*\cap\hat{V}_q^{(K)}\neq\varnothing \right] \]
Matokeo katika kiwango cha L0 kinachohitaji exact identifier matching ni kama ifuatavyo:
| Mbinu | Strict REHR |
|---|---|
| Dense | 0,452 |
| Hybrid | 0,510 |
| TechDocRAG | 0,942 |
Kigezo kinapolegezwa hadi ujirani wa 1-hop, 2-hop, 3-hop na 4-hop, TechDocRAG REHR hufikia 0,965, 0,984, 0,992 na 1,000 mtawalia.
Metriki za grounding
Utafiti unafafanua metriki maalum za kutathmini mahusiano ya hati za kiufundi pamoja na Recall@10 na Mean Reciprocal Rank za kawaida.
Summary-to-Raw Trace Accuracy (SRTA) hupima ikiwa nodi ya muhtasari iliyorejeshwa inaweza kufuatiliwa hadi kwenye ushahidi ghafi sahihi.
Evidence Connectivity Recall (ECR):
\[ ECR= \frac{1}{|Q|} \sum_{q\in Q} \frac{|\hat{E}_q\cap E_q^*|}{|E_q^*|} \]
hupima ni kiasi gani cha relation edge zinazohitajika kilirejeshwa wakati wa retrieval.
Version Consistency Score (VCS) hutathmini uwiano wa madai yaliyozalishwa yanayotegemea toleo sahihi la hati linalohusiana na hoja.
Procedure Order Accuracy (POA) hupima uhifadhi wa mpangilio sahihi wa hatua katika maswali ya taratibu.
Claim Support Rate (CSR) hupima uwiano wa madai yaliyozalishwa yanayoungwa mkono na angalau kifurushi kimoja cha ushahidi ghafi.
| Mbinu | Recall@10 | MRR | REHR@10 | SRTA | ECR | CSR |
|---|---|---|---|---|---|---|
| Hybrid Dense+BM25 | 45,8 | 0,31 | 0,510 | 0,485 | 0,425 | 0,512 |
| HippoRAG 2 | 58,5 | 0,45 | 0,721 | 0,685 | 0,652 | 0,704 |
| VisRAG | 54,2 | 0,40 | 0,654 | 0,611 | 0,582 | 0,625 |
| TechDocRAG | 69,2 | 0,56 | 0,942 | 0,914 | 0,852 | 0,942 |
Utendaji kulingana na aina ya hoja
Faida ya TechDocRAG ni ndogo zaidi katika hoja rahisi za clause au parameter, lakini ni kubwa zaidi katika hoja zinazohitaji uhifadhi wa mahusiano ya hati.
| Aina ya hoja | Hybrid Chunk RAG | TechDocRAG |
|---|---|---|
| Clause | 52,1 | 65,8 |
| Parameter | 48,4 | 64,2 |
| Procedure | 35,2 | 62,1 |
| Text–Table | 31,4 | 60,5 |
| Text–Figure | 28,5 | 58,4 |
| Cross-Reference | 25,1 | 57,2 |
| Version | 22,4 | 54,1 |
| Macro Average | 34,7 | 60,3 |
Majaribio ya ablation yanaonyesha nini?
| Toleo | Main Score | REHR@10 | ECR | CSR | VCS | POA |
|---|---|---|---|---|---|---|
| Modeli kamili | 62,5 | 0,94 | 0,85 | 0,82 | 0,78 | 0,75 |
| Hakuna relation edge | 51,2 | 0,88 | 0,42 | 0,65 | 0,74 | 0,48 |
| Hakuna identifier recall | 54,8 | 0,65 | 0,72 | 0,75 | 0,68 | 0,65 |
| Hakuna summary routing | 56,4 | 0,91 | 0,81 | 0,78 | 0,72 | 0,70 |
| Hakuna raw bundling | 58,2 | 0,92 | 0,83 | 0,45 | 0,75 | 0,72 |
| Hakuna intent-aware expansion | 55,6 | 0,90 | 0,58 | 0,72 | 0,74 | 0,61 |
| Hakuna version metadata | 59,4 | 0,93 | 0,84 | 0,81 | 0,32 | 0,74 |
Jedwali hili linaonyesha kuwa vipengele vya mfumo vina kazi tofauti. Kuondoa relation edge hushusha ECR kutoka 0,85 hadi 0,42. Kuondoa identifier recall hushusha REHR kutoka 0,94 hadi 0,65. Raw bundling inapoondolewa, CSR hushuka kutoka 0,82 hadi 0,45. Version metadata inapoondolewa, VCS hushuka kutoka 0,78 hadi 0,32.
Kwa hiyo faida ya mfumo haitokani na kipengele kimoja; exact anchor finding, muunganisho wa kimuundo, upangaji upya wa kisemantiki, ufungashaji wa ushahidi ghafi na version metadata hulenga aina tofauti za makosa.
Je, utendaji unatokana na bajeti kubwa zaidi ya kompyuta?
Profiling katika chanzo haiungi mkono hili kama maelezo pekee.
| Mbinu | Offline indexing | Ukubwa wa faharasa | Wastani wa ucheleweshaji wa hoja | Kumbukumbu ya Peak GPU |
|---|---|---|---|---|
| Dense Chunk RAG | 2,5 s | 2,0 MB | 5,2 ms | ~150 MB |
| Hybrid Dense+BM25 | 3,8 s | 3,5 MB | 7,8 ms | ~180 MB |
| HippoRAG 2 | 12,4 s | 8,2 MB | 45,6 ms | ~450 MB |
| TechDocRAG | 6,36 s | 2,28 MB | 8,3 ms | 314,4 MB |
Uundaji wa faharasa ya offline wa TechDocRAG ni ghali zaidi kuliko Hybrid RAG kwa sababu grafu na uwakilishi wa sehemu tatu huundwa. Hata hivyo, wastani wa query latency ni 8,3 ms, karibu na thamani ya 7,8 ms ya Hybrid na chini sana kuliko 45,6 ms ya HippoRAG 2.
Ustahimilivu dhidi ya uharibifu wa Identifier
Katika jaribio la robustness la utafiti, uharibifu unaofanana na OCR uliingizwa katika nambari za vifungu, majina ya parameta na lebo za jedwali/kielelezo.
| Kiwango cha uharibifu / upotevu | REHR: identifier corruption | ECR: relation dropout |
|---|---|---|
| %0 | 1,0000 | 0,9875 |
| %5 | 1,0000 | 0,9825 |
| %10 | 1,0000 | 0,9725 |
| %20 | 0,0700 | 0,9525 |
| %30 | Haijaripotiwa | 0,9310 |
Matokeo ni yasiyolingana. Kupotea kwa sehemu ya relation edge hupunguza utendaji wa mfumo hatua kwa hatua, ilhali uharibifu mkubwa wa identifier za kiufundi husababisha kosa kali zaidi. Matokeo haya yanaonyesha kuwa mfumo una kiasi fulani cha redundancy katika mahusiano ya grafu lakini bado unategemea sana parsing sahihi ya nanga ya kwanza ya retrieval.
Mapungufu ya utafiti
- TechDocRAG inategemea ubora wa parser ya hati.
- Makosa ya table extraction, caption alignment na clause numbering yanaweza kuharibu relation graph.
- Cross-reference za wazi hushughulikiwa kwa kuaminika zaidi kuliko marejeleo yasiyo ya moja kwa moja.
- Layout isiyo ya kawaida na vihisishi vya kimuundo vinavyoeleweka kwa binadamu lakini visivyo wazi kwa mashine vinaweza kusababisha matatizo.
- Katika matoleo tofauti ya hati, identifier ileile inaweza kutumiwa tena chini ya masharti tofauti.
- Metriki za relation-aware grounding zinahitaji annotation ya ushahidi kwa mikono.
- Matokeo ya utendaji yalipatikana chini ya benchmark, usanidi wa retrieval na jenereta ya pamoja ya majibu zilizobainishwa.
- Majedwali makuu ya matokeo ya chanzo hayaripoti variance ya majaribio yanayorudiwa, confidence interval au jaribio la kawaida la umuhimu; kwa hiyo tofauti za alama hazipaswi kupanuliwa kuwa umuhimu wa kitakwimu.
Mapendekezo ya vitendo ya kupunguza makosa
Waandishi wanapendekeza kuweka alama kwenye kurasa za OCR zenye ubora mdogo kwa confidence-based filtering, ku-parse upya maeneo yenye matatizo kwa kuchagua, na kutumia uthibitishaji wa rule-based kwa ID za vifungu, lebo za jedwali, lebo za vielelezo na tag za matoleo.
Kwa upande wa gharama, pia inapendekezwa kuelekeza michakato ghali zaidi ya vision/OCR kwenye maeneo yenye confidence ya chini badala ya kuitumia kwenye kurasa zote. Ikiwa confidence bado ni ya chini, mfumo unaweza kurudi kwenye page-level au region-level retrieval na kuweka provenance kama isiyo na uhakika.
Utafiti unasema nini?
Mafanikio ya RAG katika hati za kiufundi hayawezi kuelezwa tu kwa kufanya retrieval ya vipande vingi zaidi vya maandishi. Kuhifadhi mahusiano kama jedwali linalorejelewa na kifungu, caption ya kielelezo, mpangilio wa hatua za taratibu au toleo sahihi la hati kunaweza kutoa ongezeko muhimu la utendaji katika answer grounding na evidence traceability.
Utafiti hausimi nini?
Haijaonyeshwa kwamba TechDocRAG ndiyo mbinu bora kabisa katika kazi zote za RAG. Matokeo hayawezi kuenezwa moja kwa moja kwa web QA ya jumla, utafutaji wa taarifa wa muundo huru au mikusanyiko ya maandishi isiyohusiana. Pia mfumo hautatui tatizo la OCR au parsing kamili; kinyume chake, jaribio la moja kwa moja linaonyesha kwamba utendaji wake hushuka kwa kasi katika uharibifu mkubwa wa identifier.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: TechDocRAG: Relation-Preserving Retrieval-Augmented Generation (RAG) for Technical Documents
Waandishi: Seungjoon Lee; Myungryul Choi.
Mwandishi anayewajibika: Myungryul Choi.
Taasisi: Department of EECI Engineering, Hanyang University; Division of Electrical Engineering, Hanyang University, Seoul, Republic of Korea.
Jarida: AI.
Mchapishaji: MDPI.
Rekodi ya bibliografia: AI 2026, 7(5), 161.
DOI: 10.3390/ai7050161
Aina ya chanzo: Makala ya utafiti.
Mchakato wa uchapishaji: Ilipokelewa 15 Machi 2026; ikarekebishwa 21 Aprili 2026; ikakubaliwa 27 Aprili 2026; ikachapishwa 6 Mei 2026.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Seti za data za benchmark zinazopatikana kwa umma zenye majina MPMQA, DesignQA, MMLongBench-Doc na LongDocURL zilitumika. Benchmark mpya ya kiwango kikubwa haikuundwa. Annotation zilizotokana, prompt na maelezo ya utekelezaji yanaweza kuombwa kutoka kwa mwandishi wa kwanza.
Mgongano wa maslahi: Waandishi hawaripoti mgongano wa maslahi.
Michango ya waandishi: Seungjoon Lee alifanya conceptualization, methodology, software, validation, formal analysis, investigation, resources, data curation, rasimu ya awali na visualization. Seungjoon Lee na Myungryul Choi walishiriki review na editing; Myungryul Choi aliwajibika kwa supervision na project administration.
Mbinu ya kulinganisha: Flat retrieval, adaptive/corrective RAG, hierarchical RAG, graph RAG, memory-oriented RAG na multimodal retrieval zililinganishwa. Kadiri ilivyowezekana, jenereta ileile ya majibu na bajeti sawa ya ushahidi zilitumika. CRAG ilitathminiwa katika hali ya corpus-only bila ufikiaji wa wavuti ya nje.
Kikomo kikuu cha kimetodolojia: Ripoti haikutoa vipimo vya kawaida vya umuhimu wa kitakwimu, confidence interval au run-to-run variance kwa alama za benchmark. Kwa hiyo majedwali ya utendaji yanapaswa kuchukuliwa kama matokeo ya kulinganisha ya benchmark yaliyoonekana chini ya itifaki ya utafiti.
Mbinu ya maudhui ya Verianla: Maandishi haya ya Kiswahili si tafsiri ya sentensi kwa sentensi ya makala chanzo. Ufafanuzi wa tatizo, grafu yenye aina tofauti za elementi, usanifu wa identifier-summary-raw, uundaji wa kihisabati wa retrieval, sera za query intent, mpangilio wa benchmark, metriki za evaluation, ablation, gharama ya rasilimali, majaribio ya robustness na mipaka ya kimetodolojia zimehifadhiwa huku maelezo huru ya kisayansi ya Kiswahili yakiundwa. Hakuna utendaji, takwimu au kipengele cha mfumo kisichokuwapo katika chanzo kilichoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *