

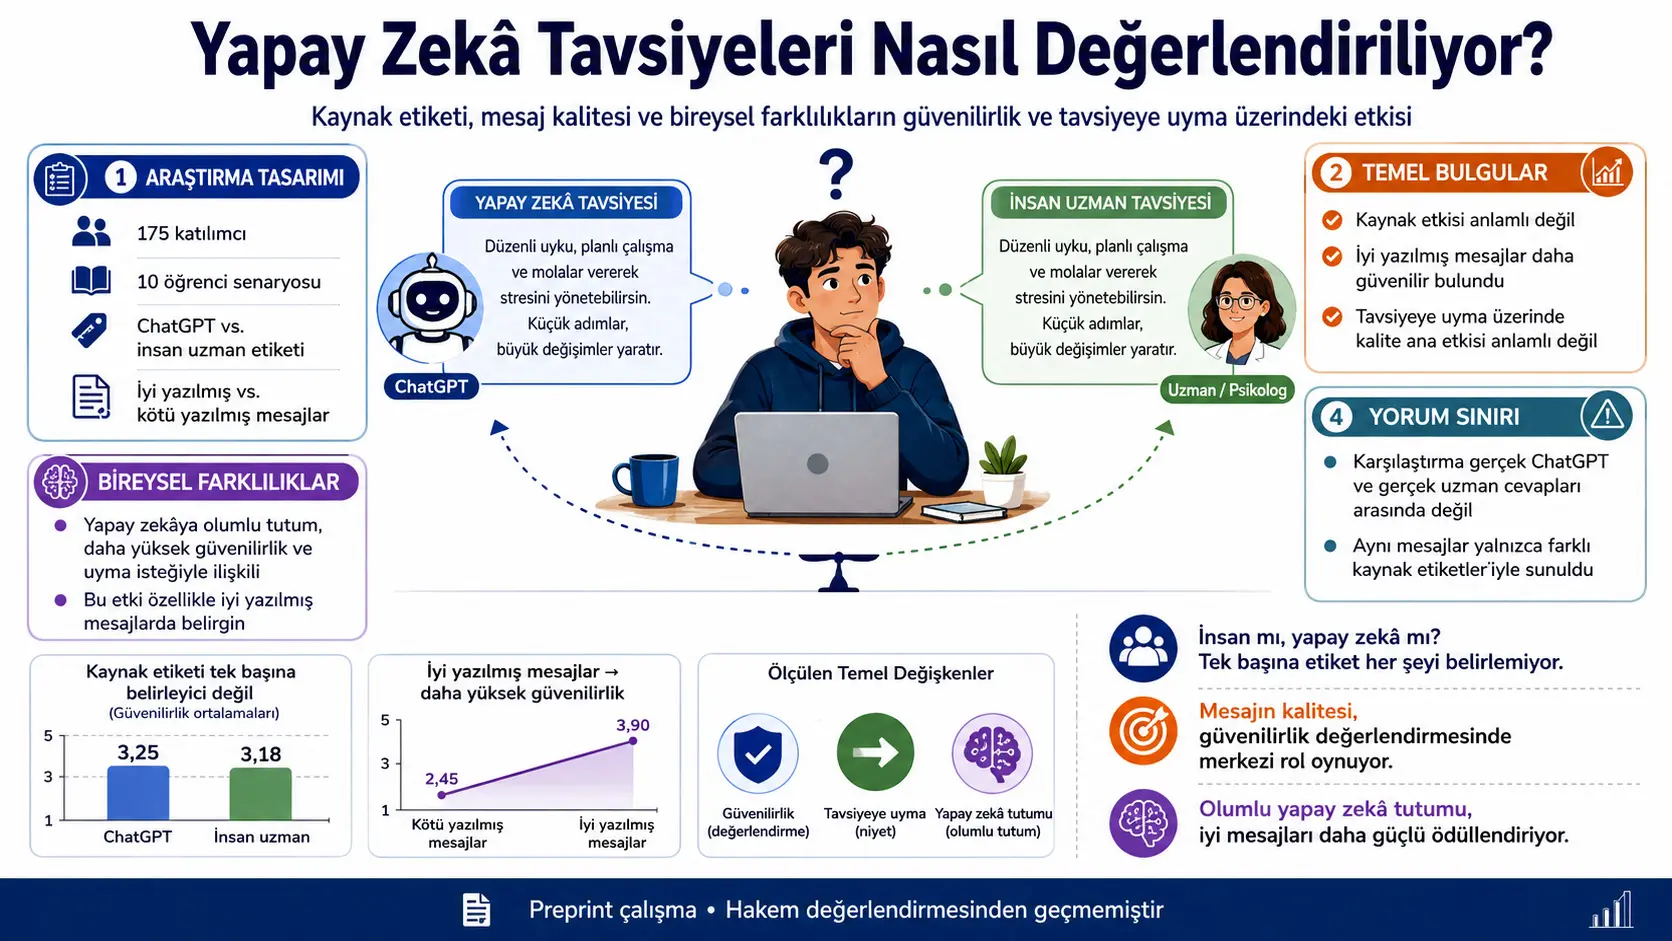
Utafiti huu umechunguza jinsi kuhusisha ushauri kuhusu maisha binafsi na maisha ya mwanafunzi na ChatGPT au mtaalamu binadamu, ubora wa uandishi wa ujumbe, na mitazamo ya washiriki kuhusu akili bandia kunavyoathiri uaminifu unaotambuliwa na utayari wa kufuata ushauri. Washiriki 175 ambao lugha yao ya kwanza ni Kifaransa walishiriki; kila mshiriki alitathmini jumla ya hali kumi za ushauri, tano zikiwa zimeandaliwa vizuri na tano zimeandaliwa vibaya. Modeli mchanganyiko za cumulative link zinazofaa muundo wa majibu ya mpangilio na vipimo vinavyorudiwa zilitumika. Matokeo yalionyesha kuwa kuhusisha ujumbe na ChatGPT au mtaalamu binadamu pekee hakukuwa na athari kubwa kwa uaminifu au kufuata ushauri; lakini ujumbe ulioandikwa vizuri uliongeza uaminifu kwa kiasi kikubwa. Athari kuu ya jumla ya ubora wa ujumbe katika kufuata ushauri haikuwa kubwa.
Washiriki waliokuwa na mtazamo chanya zaidi kuhusu akili bandia kwa ujumla waliiona ujumbe kuwa wa kuaminika zaidi na walionyesha utayari mkubwa wa kufuata ushauri. Hata hivyo mwenendo huu haukuwa tu kwa ujumbe wenye lebo ya ChatGPT; ulionekana pia kwenye ujumbe wenye lebo ya mtaalamu binadamu. Uchambuzi wa kiuchunguzi unaonyesha kwamba mtazamo chanya kuhusu akili bandia huimarisha hasa tathmini ya ujumbe ulioandikwa vizuri, lakini hautoi uaminifu wa kiotomatiki kwa ujumbe ulioandikwa vibaya. Unyenyekevu wa kiakili si kiamua cha moja kwa moja katika modeli kuu; lakini katika matokeo ya kiuchunguzi unaonekana kuhusiana na unyeti wa kutofautisha ujumbe ulioandikwa vizuri na ulioandikwa vibaya.
Kikomo muhimu zaidi cha tafsiri ya utafiti ni kwamba majibu halisi ya ChatGPT hayakulinganishwa na majibu halisi ya wataalamu binadamu. Watafiti waliandaa maandishi yote ya ushauri kwa ajili ya utafiti na wakaonyesha maandishi yale yale yakiwa na lebo tofauti tu za chanzo. Kwa hiyo matokeo hayaelezi ubora au uaminifu wa ushauri uliotolewa kweli na akili bandia, bali yanaeleza jinsi washiriki wanavyoitikia ujumbe unapopewa lebo “ChatGPT” au “mtaalamu binadamu”. Utafiti pia ni preprint ambayo haijapitiwa na wahakiki.
Kwa mtazamo wa Türkiye: Muundo wa utafiti unaweza kutekelezwa upya nchini Türkiye kwa wanafunzi wa vyuo vikuu, walimu wanaotarajiwa, wanafunzi wa ushauri nasaha wa kisaikolojia na makundi tofauti ya umri. Katika urekebishaji huo, ushauri unapaswa kuandaliwa kwa Kituruki; ufasaha wa lugha, ufaafu wa kitamaduni na maudhui ya usalama ya ujumbe yanapaswa kutathminiwa kando. Mbali na majaribio ya lebo ya chanzo, majibu halisi ya wataalamu, majibu yanayotolewa moja kwa moja na modeli kubwa za lugha, na majibu yanayotengenezwa kwa pamoja na binadamu–akili bandia yanapaswa kulinganishwa. Ili kutoa hitimisho kuhusu Türkiye, washiriki wanapaswa kuchukuliwa kutoka vyuo vikuu tofauti, viwango tofauti vya elimu na uzoefu tofauti wa akili bandia; si “nia ya kufuata ushauri” pekee bali pia tabia halisi ya baadaye inapaswa kupimwa. Kutokana na matokeo haya yaliyopatikana kwa washiriki wanaozungumza Kifaransa, wengi wao wakiwa vijana na wanawake, haiwezi kuhitimishwa moja kwa moja kwamba wanafunzi wote au jamii nchini Türkiye wataitikia akili bandia kwa namna ileile.
Swali kuu la utafiti ni lipi?
Utafiti unalenga maswali matatu makuu. Kwanza, je ushauri uleule unapotajwa kuwa unatoka ChatGPT unatathminiwa tofauti na unapotajwa kuwa unatoka kwa mtaalamu binadamu? Pili, je ujumbe uliopangwa wazi na unaotoa mapendekezo mahsusi unaonekana kuwa wa kuaminika na wa kutekelezeka zaidi kuliko ujumbe wenye kauli zisizo wazi, zinazojirudia na zenye kusita? Tatu, je mitazamo kuhusu akili bandia na unyenyekevu wa kiakili hubadilisha tathmini hizi?
Utafiti unatokana na njia mbili za uchakataji katika tafiti za ushawishi. Katika uchakataji wa kihisia au heuristic, mtu anaweza kutegemea dalili za chanzo kama “Hili limesemwa na mtaalamu” au “Hili limetolewa na akili bandia” badala ya kuchunguza ujumbe kwa kina. Katika uchakataji wa kimfumo, sababu, uthabiti, uwazi na umahususi wa ujumbe hutathminiwa kwa makini zaidi. Watafiti walitaka kupima ni ipi kati ya njia hizi mbili ndiyo yenye ushawishi mkubwa zaidi katika ushauri wa akili bandia.
Athari ya chanzo ilijaribiwaje?
Katika jaribio, chanzo kiliandaliwa kama kigezo cha kati ya washiriki. Washiriki waligawiwa kwa nasibu katika mojawapo ya makundi mawili:
- Kundi moja liliambiwa kwamba ushauri ulitolewa na ChatGPT.
- Kundi jingine liliambiwa kwamba ushauri uleule ulitolewa na mtaalamu binadamu au mwanasaikolojia.
Maudhui ya maandishi ya ushauri hayakubadilishwa kati ya hali za chanzo. Ni lebo ya chanzo iliyoonyeshwa juu ya jibu pekee iliyokuwa tofauti. Mbinu hii ilitumika kupima athari ya lebo ya “akili bandia” au “binadamu” pekee huku ubora halisi wa maandishi ukiwekwa sawa.
Maelezo haya ni muhimu sana kwa kutafsiri matokeo kwa usahihi. Utafiti haulinganishi jibu asili lililotolewa na ChatGPT na jibu asili lililoandikwa na mtaalamu binadamu. Washiriki walifanywa waamini kwamba chanzo ni halisi, lakini kipengele kilicholinganishwa kwa kweli kilikuwa taarifa ya chanzo pekee.
Ubora wa ujumbe ulibadilishwaje?
Kwa kila hali, matoleo mawili ya jibu yaliandaliwa: lililoandikwa vizuri na lililoandikwa vibaya. Ujumbe wa ubora wa juu ulikuwa na sifa kuu mbili:
- Kuwepo kwa mtiririko wa mawazo uliopangwa kati ya ufafanuzi wa tatizo, mapendekezo mahsusi na hatua zinazofuata,
- Kutoa mapendekezo mahsusi na yanayotekelezeka kama “Rudi nyuma hatua moja”, “Eleza hisia zako kwa uwazi” au “Tafuta msaada kutoka nje”.
Ujumbe wa ubora wa chini haukuwa na maendeleo ya wazi ya mawazo. Ulikuwa na kauli nyingi za uwezekano na kutokuwa na uhakika kama “Labda”, “Inategemea hali”, “Inaweza kufanya kazi”, “Lakini inaweza pia kuwa mbaya zaidi”. Majibu haya yalizunguka mada ileile lakini hayakupendekeza njia ya wazi ya uamuzi au hatua.
Kwa mfano, katika hali ya uhusiano yenye udanganyifu wa kihisia, jibu la ubora wa juu hufafanua dalili za uhusiano usio na afya, kupendekeza mtu aangalie hali kutoka nje, kutoa kauli mahsusi anayoweza kutumia katika mazungumzo, na kumshauri atafute msaada kutoka kwa rafiki, familia au mtaalamu wa tiba inapohitajika. Toleo la ubora wa chini huorodhesha chaguo zinazoshindana kama kuzungumza, kusubiri, kutokujibu au kuhoji uhusiano, huku likiacha bila uhakika kama kila chaguo litafanya kazi au la.
Ni hali gani zilitumika katika jaribio?
Watafiti waliunda hali kumi fupi za maisha kuhusu wanafunzi wanaokabili matatizo ya kitaaluma, kihisia na baina ya watu. Katika mfano mmoja, mwanafunzi aliyegombana na rafiki wa karibu na anayehisi upweke anauliza nini anaweza kufanya ili kurekebisha urafiki na kutoka katika upweke. Katika mfano mwingine, mtu anayefikiri anakabili udanganyifu wa kihisia katika uhusiano anajaribu kurejesha usawa katika uhusiano huo.
Kila mshiriki aliona hali zote kumi. Tano ziliunganishwa na majibu yaliyoandikwa vizuri na tano na majibu yaliyoandikwa vibaya. Ni hali gani ingeonyeshwa na toleo gani la ubora iliamuliwa kwa nasibu kupitia Qualtrics. Hivyo ilikusudiwa kuzuia hali fulani kuunganishwa kila wakati na jibu zuri au kila wakati na jibu baya.
Mchoro wa mtiririko wa jaribio unaonyesha nini?
Mchoro wa mchakato wa utafiti unaonyesha kwamba baada ya ridhaa na taarifa za kidemografia, washiriki waligawiwa kwa nasibu kwenye hali ya chanzo cha akili bandia au chanzo cha binadamu. Washiriki katika kila kundi la chanzo walitathmini hali kumi; tano zikiwa na ujumbe ulioandikwa vizuri na tano zikiwa na ujumbe ulioandikwa vibaya. Chanzo kilibadilika kati ya washiriki, huku ubora wa ujumbe ukibadilika ndani ya mshiriki huyo huyo.
Katika hatua ya pili ya jaribio, mtazamo kuhusu akili bandia, unyenyekevu wa kiakili na taarifa za kijamii-demografia zilipimwa. Kusudi la kutoa mizani hii baada ya hali lilikuwa kuepuka kuelekeza mapema mawazo ya washiriki kuhusu akili bandia na hivyo kuathiri tathmini zao za majibu.
Nadharia tete za utafiti ni zipi?
| Nadharia tete | Matarajio | Matokeo |
|---|---|---|
| H1: Athari ya chanzo | Ujumbe unaohusishwa na mtaalamu binadamu ulitarajiwa kuonekana wa kuaminika zaidi kuliko ujumbe wa ChatGPT na kufuatwa zaidi. | Haikuungwa mkono. Chanzo hakikuwa na athari kuu kubwa kwa matokeo yote mawili. |
| H2: Ubora wa ujumbe | Ujumbe ulioandikwa vizuri ulitarajiwa kuonekana wa kuaminika zaidi na kufuatwa zaidi. | Uliungwa mkono kwa sehemu. Uaminifu uliongezeka, lakini athari kuu katika kufuata ushauri haikuwa kubwa. |
| H3: Mwingiliano wa chanzo na ubora | Katika ujumbe wa ubora wa chini, washiriki walitarajiwa kutegemea zaidi chanzo na kumpendelea mtaalamu binadamu. | Haikuungwa mkono. Hakukuwa na mwingiliano mkubwa kati ya chanzo na ubora. |
| H4: Mtazamo kuhusu akili bandia kubadilisha athari ya chanzo | Kwa walio na mtazamo chanya kuhusu akili bandia, tofauti kati ya lebo ya binadamu na ChatGPT ilitarajiwa kupungua. | Haikuungwa mkono. Mtazamo kuhusu akili bandia haukubadilisha athari ya chanzo kwa kiasi kikubwa. |
| H5: Unyenyekevu wa kiakili | Unyenyekevu wa kiakili ulitarajiwa kuongeza tathmini za uaminifu na kufuata ushauri. | Haikuungwa mkono. Athari kuu hazikuwa kubwa; mwingiliano wa kiuchunguzi pekee ulipatikana. |
Kwa nini lebo ya chanzo huenda haikuonyesha athari iliyotarajiwa?
Washiriki walipewa jukumu la kutathmini moja kwa moja maudhui, uthabiti na utekelezekaji wa ujumbe. Watafiti wanafikiri maelekezo haya yanaweza kuwa yamewaondoa watu kwenye hukumu ya haraka inayotegemea tu lebo ya “akili bandia” au “binadamu” na kuwaelekeza kwenye uchambuzi zaidi wa ujumbe.
Matokeo yanaonyesha kuwa lebo ya ChatGPT haikusababisha kupotea kwa uaminifu kwa kiotomatiki wala ubora wa kiotomatiki. Maudhui yale yale yalipohusishwa na ChatGPT, kwa wastani hayakuonekana kuwa na uaminifu mdogo au mkubwa kwa kiasi kikubwa kuliko maudhui yale yale yenye lebo ya mtaalamu binadamu. Vivyo hivyo, nia ya kufuata ushauri haikubadilika kwa sababu ya lebo ya chanzo pekee.
Ubora wa ujumbe ulibadilisha nini?
Ushauri ulioandikwa vizuri ulionekana kuwa wa kuaminika zaidi bila kujali lebo ya chanzo. Matokeo haya yanaonyesha kwamba mtiririko wa mawazo ulio wazi, mapendekezo mahsusi na muundo wa ujumbe wenye hoja ni muhimu katika tathmini ya uaminifu.
Kwa upande mwingine, athari kuu ya jumla ya ubora wa ujumbe katika kufuata ushauri haikuwa kubwa. Ingawa wastani wa kimaelezo ulionyesha alama za juu za kufuata ujumbe ulioandikwa vizuri, modeli mchanganyiko ya mpangilio haikuthibitisha tofauti hii ya jumla kwa takwimu baada ya kuzingatia vigezo vingine na mwingiliano. Kwa hiyo haiwezi kuhitimishwa kwamba “kila ushauri ulioandikwa vizuri lazima ufuatwe”.
Jukumu la mtazamo kuhusu akili bandia ni lipi?
Washiriki waliokuwa na mtazamo chanya zaidi kuhusu akili bandia, bila kujali kama chanzo kilionyeshwa kuwa ChatGPT au binadamu, kwa ujumla waliiona ujumbe kuwa wa kuaminika zaidi na walionyesha utayari mkubwa wa kufuata ushauri. Matokeo haya yanaonyesha kwamba mtazamo kuhusu akili bandia haufanyi kazi tu kama upendeleo mwembamba unaolenga maudhui yenye lebo ya akili bandia.
Katika uchambuzi wa kiuchunguzi, muundo wa kina zaidi ulijitokeza. Mtazamo chanya kuhusu akili bandia uliongeza tathmini za uaminifu na kufuata ushauri katika ujumbe ulioandikwa vizuri. Katika ujumbe ulioandikwa vibaya, hakukuwa na uhusiano mkubwa kati ya mtazamo kuhusu akili bandia na tathmini. Kwa maneno mengine, kuwa na mtazamo chanya kuhusu akili bandia hakukumaanisha kukubali kiotomatiki ushauri ulioandaliwa vibaya.
Unyenyekevu wa kiakili unamaanisha nini?
Unyenyekevu wa kiakili ni kukubali kwamba maarifa ya mtu yanaweza kuwa na mipaka, kutambua kwamba anaweza kukosea, na kuwa tayari kubadili mtazamo anapokabili ushahidi mpya. Katika utafiti, sifa hii ilipimwa kupitia vipengele vya kuwa tayari kubadili mitazamo na uhuru wa mawazo na ego kutoka Comprehensive Intellectual Humility Scale.
Katika uchambuzi mkuu, unyenyekevu wa kiakili haukuonyesha athari ya jumla iliyo kubwa katika uaminifu au kufuata ushauri. Hata hivyo uchambuzi wa kiuchunguzi unaonyesha kwamba washiriki wenye unyenyekevu wa kiakili wa juu walitofautisha zaidi kati ya ujumbe ulioandikwa vizuri na ulioandikwa vibaya. Washiriki hawa walitathmini ushauri ulioandikwa vizuri kwa njia chanya zaidi na ushauri ulioandikwa vibaya kwa njia hasi zaidi.
Aidha, katika kiwango cha juu cha unyenyekevu wa kiakili, ujumbe unaohusishwa na mtaalamu binadamu ulionekana kuwa wa kuaminika zaidi kuliko ujumbe unaohusishwa na ChatGPT. Kwa upande wa kufuata ushauri, unyenyekevu wa kiakili ulionyesha uhusiano chanya katika ujumbe wenye lebo ya mtaalamu binadamu, lakini haukuonyesha uhusiano mkubwa katika lebo ya ChatGPT. Matokeo haya si sehemu ya modeli kuu ya uthibitishaji, bali ni ya uchambuzi wa kiuchunguzi uliofanywa baadaye na yanapaswa kujaribiwa upya katika tafiti mpya.
Grafu ya uaminifu inaonyesha nini?
Kielelezo 4 kwenye ukurasa wa 27 wa utafiti kinaonyesha uhusiano kati ya mtazamo kuhusu akili bandia na uaminifu uliotabiriwa kulingana na ubora wa ujumbe. Mstari unaowakilisha ujumbe ulioandikwa vizuri unapanda wazi kadiri mtazamo kuhusu akili bandia unavyokuwa chanya zaidi. Mstari wa ujumbe ulioandikwa vibaya uko karibu na usawa na una mwelekeo mdogo wa kushuka. Maeneo yenye kivuli yanaonyesha vipindi vya kujiamini vya asilimia 95.
Mhimili wima wa grafu si wastani wa moja kwa moja wa Likert 1-7 katika Jedwali 1; ni thamani ya kiwango iliyotabiriwa kutoka modeli mchanganyiko ya mpangilio. Kwa hiyo thamani kama 0, 1, 2 na 3 kwenye grafu hazipaswi kulinganishwa moja kwa moja na alama ghafi za uaminifu.
Grafu ya kufuata ushauri inaonyesha nini?
Kielelezo 5 kwenye ukurasa wa 30 wa utafiti kinaonyesha muundo unaofanana kwa kufuata ushauri. Katika ujumbe ulioandikwa vizuri, utayari uliotabiriwa wa kufuata ushauri uliongezeka kadiri mtazamo chanya kuhusu akili bandia ulivyoongezeka. Katika ujumbe ulioandikwa vibaya, mstari ulibaki karibu na usawa. Grafu hii pia inaonyesha utabiri wa modeli na vipindi vya kujiamini vya asilimia 95.
Ni matokeo gani yanayoungwa mkono na utafiti?
- Kutumia lebo ya ChatGPT au binadamu pekee kwenye maudhui yale yale hakukubadilisha kwa kiasi kikubwa tathmini za uaminifu na kufuata ushauri.
- Ujumbe ulio wazi, uliopangwa na wenye mapendekezo mahsusi ulionekana kuwa wa kuaminika zaidi.
- Athari kuu ya jumla ya ubora wa ujumbe katika kufuata ushauri haikuwa kubwa kwa takwimu.
- Mtazamo chanya kuhusu akili bandia kwa ujumla ulihusishwa na tathmini za juu zaidi za uaminifu na kufuata ushauri.
- Mtazamo chanya kuhusu akili bandia haukusababisha kukubali bila ukosoaji ujumbe ulioandikwa vibaya.
- Hakukuwa na athari kuu ya moja kwa moja ya unyenyekevu wa kiakili.
- Matokeo ya kiuchunguzi yanaashiria kwamba tofauti za mtu binafsi zinaweza kubadilisha unyeti kwa ubora wa ujumbe.
Utafiti hauthibitishi nini?
- Haudhibitishi kwamba ushauri uliotolewa kweli na ChatGPT ni mzuri kama ushauri halisi wa wataalamu binadamu.
- Hauonyeshi kwamba ChatGPT inaweza kutumiwa badala ya mwanasaikolojia, mshauri wa kisaikolojia au mtaalamu mwingine.
- Hauonyeshi kwamba washiriki walifuata ushauri katika maisha halisi; nia ya kufuata pekee ndiyo ilipimwa.
- Hautathmini usahihi wa kitabibu, usalama au manufaa ya kisaikolojia ya ujumbe.
- Hauonyeshi kwamba watu wenye mtazamo chanya kuhusu akili bandia huamini maudhui yote ya akili bandia bila masharti.
- Hauonyeshi kwamba matokeo yaliyopatikana kwa washiriki vijana nchini Ufaransa yanaweza kujumlishwa kwa nchi zote na makundi yote ya umri.
- Hauonyeshi kwamba mwingiliano wa kiuchunguzi wa unyenyekevu wa kiakili ni matokeo ya uhakika na yaliyorudiwa.
- Haudhibitishi kwamba lebo ya chanzo haitakuwa na athari katika maeneo mengine, hasa maamuzi ya kimatibabu, kisheria au yenye hatari kubwa.
Ni nguvu zipi za utafiti?
Nguvu kuu ya utafiti ni kutenganisha chanzo na maudhui ya ujumbe. Kuonyesha maandishi yale yale huku lebo ya chanzo pekee ikibadilishwa huruhusu kupima kwa usafi zaidi kama tofauti iliyoonekana inatokana na ubora wa maandishi au taarifa ya chanzo.
Kila mshiriki kutathmini ujumbe ulioandikwa vizuri na ulioandikwa vibaya husaidia kuzuia mielekeo binafsi ya tathmini kuamua kabisa ulinganisho wa ubora. Matumizi ya modeli mchanganyiko za cumulative link zinazozingatia vipimo vinavyorudiwa katika kiwango cha hali na mshiriki pia yanafaa kwa muundo wa majibu ya mpangilio wa 1-7.
Pia ni muhimu kwamba utafiti ulitathmini uaminifu na utayari wa kufuata ushauri kama matokeo tofauti. Mtu anaweza kuona ujumbe kuwa wenye uthabiti na wa kuaminika lakini bado asiwe tayari kuutekeleza. Utafiti haukuchukulia tathmini hizi mbili kuwa dhana moja.
Ni mapungufu gani makuu?
- Utafiti ni preprint ambayo haijapitiwa na wahakiki.
- Watu 286 walianza utafiti, lakini washiriki 175 tu waliokamilisha waliingizwa katika uchambuzi; sifa za waliokosa kukamilisha hazikuchunguzwa kwa kina.
- Sampuli ilikuwa hasa ya vijana watu wazima na wanawake.
- Lugha ya kwanza ya washiriki wote ilikuwa Kifaransa; uwezo wa kujumlisha kati ya tamaduni ni mdogo.
- Hali zilikuwa fupi na za kubuni; huenda zisiwakilishe kikamilifu ugumu wa maisha halisi.
- Kwa kuwa washiriki walitathmini hali kumi mfululizo, uchovu au kupungua kwa umakini kunaweza kutokea.
- Kufuata ushauri kulipimwa kwa kipengele kimoja cha kujiripoti na tabia halisi haikufuatiliwa.
- Udhibiti wa chanzo haukubadilisha chanzo halisi cha uzalishaji, bali lebo iliyoonyeshwa pekee.
- Hali za ubora wa juu na chini zilibadilisha pamoja si muundo wa ujumbe tu, bali pia kiwango cha uhakika na umahususi; athari huru za vipengele hivi hazikutenganishwa.
- Mwingiliano wa unyenyekevu wa kiakili ni matokeo ya uchambuzi wa kiuchunguzi, si modeli ya uthibitishaji.
- Kuna kauli tofauti kuhusu upatikanaji wa data kati ya maandishi makuu na ukurasa wa kichwa mwishoni mwa faili.
Mbinu na Matokeo ya Utafiti
Sifa za sampuli
| Sifa ya sampuli | Thamani iliyoripotiwa katika utafiti |
|---|---|
| Idadi ya watu walioanza utafiti | 286 |
| Idadi ya washiriki walioingizwa katika uchambuzi wa mwisho | 175 |
| Lugha | Washiriki ambao lugha yao ya kwanza ni Kifaransa |
| Umri wa wastani | miaka 25 |
| Mkengeuko wa kawaida wa umri | miaka 4,90 |
| Anuwai ya umri | miaka 18-45 |
| Wanawake | %68,9 |
| Wanaume | %29,9 |
| Utambulisho wa kijinsia usio wa binary | %1,1 |
| Njia za kupata washiriki | SurveyCircle, mitandao ya kijamii na marejeo binafsi |
Muundo wa jaribio
| Kigezo | Aina | Viwango | Namna ya utekelezaji |
|---|---|---|---|
| Chanzo cha ujumbe | Kipengele kati ya washiriki | ChatGPT au mtaalamu binadamu | Mshiriki aligawiwa kwa nasibu kwenye hali moja tu ya chanzo. |
| Ubora wa ujumbe | Kipengele ndani ya mshiriki | Ulioandikwa vizuri au ulioandikwa vibaya | Kila mshiriki alitathmini ujumbe tano mzuri na tano mibaya. |
| Mtazamo kuhusu akili bandia | Kigezo endelevu cha mtu binafsi | Kutoka chini hadi juu | Ulipimwa kwa kipimo cha vipengele sita. |
| Unyenyekevu wa kiakili | Kigezo endelevu cha mtu binafsi | Kutoka chini hadi juu | Ulipimwa kwa vipengele viwili vya chini vya kipimo kifupi cha vipengele kumi. |
Vyombo vya kipimo
| Dhana iliyopimwa | Namna ya kipimo | Kipimo |
|---|---|---|
| Uaminifu unaotambuliwa | Vipengele “Jibu linaaminika” na “Jibu lina uthabiti” | 1: Sikubaliani kabisa – 7: Nakubaliana kabisa |
| Kufuata ushauri | Kipengele “Ningekuwa tayari kufuata jibu hili” | Kipimo cha Likert 1-7 |
| Uzoefu wa hali | Idadi ya mara mtu mwenyewe au mtu wa karibu amekabili hali sawa | 0-10 |
| Athari ya kihisia | Kiasi ambacho hali ingemwathiri mtu | Kipimo cha Likert 1-7 |
| Unyenyekevu wa kiakili | Utayari wa kubadili mtazamo na uhuru wa mawazo-ego | Vipengele kumi; uaminifu wa subscale α = 0,90 na α = 0,83 |
| Mtazamo kuhusu akili bandia | Vipengele sita vinavyopima uaminifu, kukubali na mwitikio wa kihisia | Uaminifu wa kipimo α = 0,86 |
Kwa kuwa hakukuwa na tofauti kubwa kati ya hali katika uzoefu wa hali na athari ya kihisia, vigezo hivi havikuongezwa katika modeli kuu kama vigezo vya udhibiti.
Uchambuzi wa takwimu
Kwa kuwa vigezo tegemezi vilikuwa majibu ya Likert ya mpangilio kati ya 1-7 na washiriki wale wale walitathmini hali nyingi, modeli mchanganyiko za cumulative link zilitumika. Modeli ziliundwa kwa link function ya logit. Uchambuzi ulifanywa katika programu R 4.5.1 kwa kifurushi cha “ordinal”. Ulinganisho wa jozi wa baadaye ulifanywa kwa kifurushi cha “emmeans” na thamani za p zilirekebishwa kwa ulinganisho mwingi.
Mbinu ya modeli mchanganyiko inazingatia clustering ya majibu ndani ya washiriki na ndani ya hali. Hivyo ilijaribiwa kutenganisha mwelekeo wa mtu fulani kutoa alama kubwa kwa ujumla na ukweli kwamba hali fulani zinaweza kuwa rahisi au ngumu zaidi kutathmini kuliko nyingine, kutoka kwa athari za majaribio.
Wastani wa kimaelezo kulingana na hali
| Chanzo | Ubora wa ujumbe | Wastani wa uaminifu na SD | Wastani wa kufuata ushauri na SD |
|---|---|---|---|
| ChatGPT | Ulioandikwa vizuri | 6,14 (0,83) | 6,03 (0,93) |
| ChatGPT | Ulioandikwa vibaya | 5,85 (0,92) | 5,43 (1,03) |
| Mtaalamu binadamu | Ulioandikwa vizuri | 6,26 (0,78) | 6,22 (0,75) |
| Mtaalamu binadamu | Ulioandikwa vibaya | 5,47 (1,12) | 5,34 (1,10) |
Thamani hizi ni wastani wa kimaelezo katika kiwango cha mshiriki. Matokeo ya takwimu yanategemea utabiri wa modeli mchanganyiko ya mpangilio, si ulinganisho wa moja kwa moja wa wastani huu.
Matokeo ya uthibitishaji kuhusu uaminifu
| Athari iliyojaribiwa | Matokeo ya takwimu | Tafsiri |
|---|---|---|
| Chanzo cha ujumbe | χ2(1) = 1,82; p = 0,177 | Hakuna tofauti kuu kubwa kati ya lebo za ChatGPT na mtaalamu binadamu. |
| Ubora wa ujumbe | χ2(1) = 4,84; p = 0,028 | Ujumbe ulioandikwa vizuri ulionekana kuwa wa kuaminika zaidi. |
| Chanzo × ubora | χ2(1) = 1,42; p = 0,234 | Athari ya ubora haikubadilika kwa kiasi kikubwa kulingana na lebo ya chanzo. |
| Mtazamo kuhusu akili bandia | χ2(1) = 9,18; p = 0,002 | Mtazamo chanya zaidi ulihusishwa na tathmini ya juu zaidi ya uaminifu. |
| Chanzo × mtazamo kuhusu akili bandia | χ2(1) = 1,23; p = 0,268 | Mtazamo kuhusu akili bandia haukuonyesha athari mahususi kwa ujumbe wenye lebo ya ChatGPT pekee. |
| Unyenyekevu wa kiakili | χ2(1) = 2,80; p = 0,094 | Hakuna athari kuu kubwa iliyopatikana. |
Matokeo ya kiuchunguzi kuhusu uaminifu
| Uchambuzi wa kiuchunguzi | Matokeo | Maelezo |
|---|---|---|
| Mtazamo kuhusu akili bandia × ubora wa ujumbe | χ2(1) = 16,82; p < 0,001 | Katika ujumbe mzuri slope 0,77; %95 CI [0,29, 1,25]. Katika ujumbe mbaya slope −0,22; %95 CI [−0,69, 0,24]. |
| Chanzo × ubora × mtazamo kuhusu akili bandia | χ2(1) = 0,76; p = 0,384 | Haikuonyeshwa kwamba unyeti kwa ubora unatofautiana kati ya lebo ya ChatGPT na binadamu. |
| Unyenyekevu wa kiakili × ubora | χ2(1) = 46,77; p < 0,001 | Katika ujumbe mzuri slope 0,996; katika ujumbe mbaya −0,495. |
| Unyenyekevu wa kiakili × chanzo | χ2(1) = 4,40; p = 0,036 | Katika kiwango cha juu cha unyenyekevu wa kiakili, lebo ya binadamu ilitathminiwa kuwa ya kuaminika zaidi. |
Matokeo ya uthibitishaji kuhusu kufuata ushauri
| Athari iliyojaribiwa | Matokeo ya takwimu | Tafsiri |
|---|---|---|
| Chanzo cha ujumbe | χ2(1) = 0,36; p = 0,548 | Hakuna tofauti kuu kubwa kati ya lebo za ChatGPT na mtaalamu binadamu. |
| Ubora wa ujumbe | χ2(1) = 1,18; p = 0,277 | Athari kuu ya jumla ya ubora wa ujumbe si kubwa. |
| Chanzo × ubora | χ2(1) = 2,07; p = 0,151 | Haikuonyeshwa kwamba athari ya ubora inabadilika kulingana na chanzo. |
| Mtazamo kuhusu akili bandia | χ2(1) = 5,76; p = 0,016 | Mtazamo chanya zaidi ulihusishwa na utayari mkubwa zaidi wa kufuata ushauri. |
| Chanzo × mtazamo kuhusu akili bandia | χ2(1) = 0,03; p = 0,852 | Athari ya mtazamo si mahususi kwa lebo ya ChatGPT pekee. |
| Unyenyekevu wa kiakili | χ2(1) = 1,70; p = 0,192 | Hakuna athari kuu kubwa iliyopatikana. |
Matokeo ya kiuchunguzi kuhusu kufuata ushauri
| Uchambuzi wa kiuchunguzi | Matokeo | Maelezo |
|---|---|---|
| Mtazamo kuhusu akili bandia × ubora wa ujumbe | χ2(1) = 9,44; p = 0,002 | Katika ujumbe mzuri slope 0,63; %95 CI [0,24, 1,02]. Katika ujumbe mbaya slope ni takribani 0. |
| Chanzo × ubora × mtazamo kuhusu akili bandia | χ2(1) = 1,34; p = 0,247 | Haikuonyeshwa kwamba uhusiano wa ubora na mtazamo unatofautiana kulingana na lebo ya chanzo. |
| Unyenyekevu wa kiakili × ubora | χ2(1) = 51,63; p < 0,001 | Katika ujumbe mzuri slope 0,71; katika ujumbe mbaya −0,83. Tofauti ya slope iko katika kiwango cha p < 0,0001. |
| Unyenyekevu wa kiakili × chanzo | χ2(1) = 4,40; p = 0,036 | Unyenyekevu wa kiakili uliongeza utayari wa kufuata katika lebo ya binadamu, lakini haukuonyesha uhusiano mkubwa katika lebo ya ChatGPT. |
Maana ya matokeo kwa matumizi
Utafiti unaonyesha kwamba katika mifumo inayotoa ushauri, kutumia lebo pekee ya “imetolewa na akili bandia” au “imeandikwa na mtaalamu” huenda kusiwe na uwezo wa kuamua tathmini peke yake. Mpangilio wa ujumbe, hoja zilizo wazi na mapendekezo mahsusi vinaonekana kuwa muhimu zaidi kwa uaminifu.
Hata hivyo, mtindo mzuri wa uandishi pekee hauhakikishi kwamba ushauri ni sahihi kisayansi, salama au unafaa kwa mtu. Jaribio lilipima tu mtazamo wa washiriki; halikuwapa wataalamu huru jukumu la kutathmini usahihi wa maudhui ya ujumbe. Kwa hiyo katika matumizi halisi, lugha yenye ufasaha na ushawishi haipaswi kuchukua nafasi ya uthibitishaji wa maudhui na usimamizi wa mtaalamu.
Maelezo ya Chanzo na Mbinu
| Sehemu ya utambulisho wa chanzo | Taarifa iliyothibitishwa |
|---|---|
| Jina kamili asili la utafiti | Evaluating AI-Generated Advice: Source Cues, Argument Quality, and Individual Differences in Credibility and Adherence |
| Waandishi na mpangilio | 1. Elodie Andrieu; 2. Aurélie Pistono; 3. Franck Amadieu |
| Mwandishi mwenza wa kwanza | Hakuna taarifa ya mchango sawa au uandishi mwenza wa kwanza. |
| Mwandishi wa mawasiliano | Elodie Andrieu |
| Taasisi | CLLE Laboratory (Cognition, Languages, Language, Ergonomics), Toulouse Jean Jaurès University, Toulouse, Ufaransa |
| DOI | 10.2139/ssrn.7002154 |
| Jarida | Hakuna jina la jarida lililopitiwa na wahakiki. |
| Mchapishaji | Hakuna taarifa ya mchapishaji wa jarida lililopitiwa na wahakiki. |
| Jukwaa la uchapishaji | SSRN |
| Mwaka wa uchapishaji | 2026 |
| Tarehe ya kupakiwa SSRN | 26 Juni 2026 |
| Aina ya chanzo | Preprint ya utafiti wa majaribio mtandaoni wenye muundo mchanganyiko |
| Hali ya mapitio ya rika | Haijapitiwa na wahakiki. |
| Kiungo rasmi cha uchapishaji | Ukurasa rasmi wa utafiti wa SSRN |
| Data na nyenzo za uchambuzi | Ukurasa wa mradi wa Open Science Framework |
Utafiti huu ni preprint ambayo haijapitiwa na wahakiki; matokeo yanapaswa kusomwa kwa kuzingatia kikomo hiki. DOI hutambulisha rekodi ya utafiti ya SSRN na haipaswi kuwasilishwa kama DOI ya makala ya jarida lililopitiwa na wahakiki.
Itifaki ya utafiti iliidhinishwa na Bodi ya Maadili ya Toulouse Jean Jaurès University tarehe 24 Machi 2025, chini ya mradi namba 2025_1040. Ridhaa iliyoarifiwa ilipatikana kutoka kwa washiriki, na ushiriki uliendeshwa kwa hiari na bila kutambulisha majina.
Kulingana na taarifa ya michango ya waandishi, Elodie Andrieu alifanya conceptualization, mbinu, utafiti, usimamizi wa data, uchambuzi rasmi, visualization na uandishi wa rasimu ya kwanza. Aurélie Pistono alichangia ushauri, mapitio na uhariri; Franck Amadieu alichangia conceptualization, mbinu, ushauri na mapitio-uhariri. Imeelezwa kuwa hakuna ufadhili maalumu kutoka taasisi ya umma, kibiashara au isiyo ya faida uliopatikana kwa utafiti huu na waandishi hawakuripoti mgongano wa maslahi.
Waandishi wanaeleza kwamba walitumia ChatGPT wakati wa kuandaa maandishi ili kusaidia kuboresha lugha; walipitia na kuhariri maudhui yaliyotolewa na wanawajibika kwa utafiti.
Kuna kutolingana ndani ya utafiti kuhusu upatikanaji wa data. Maandishi makuu yanaeleza kwamba data na scripts za uchambuzi ziko wazi kwenye Open Science Framework. Ukurasa wa kichwa mwishoni mwa faili unasema data zinaweza kupatikana kutoka kwa mwandishi wa mawasiliano kwa ombi linalofaa. Ingawa kiungo cha mradi wa OSF kinapatikana, kauli hizi mbili za upatikanaji wa data hazina kiwango sawa cha uwazi.
Maudhui ya kisayansi ya makala haya ya Verianla yameandaliwa kwa kutegemea utafiti uliopakiwa pekee. Vyanzo vya nje vilitumika tu kuthibitisha taarifa za kibibliografia kama DOI, mpangilio wa waandishi, tarehe ya kupakiwa SSRN, jukwaa la uchapishaji na mradi rasmi wa data. Hakuna matokeo ya majaribio au matokeo ya kisayansi ya nje ambayo hayapo katika utafiti yaliyoongezwa.
Mapungufu makuu ya utafiti ni kwamba sampuli imeundwa na washiriki vijana na wengi wao wanawake, washiriki wanaozungumza Kifaransa pekee walichunguzwa, hali fupi za kubuni zilitumika, nia ya kufuata ushauri ilipimwa badala ya tabia halisi, na matokeo halisi ya ChatGPT hayakulinganishwa na majibu halisi ya wataalamu binadamu. Mwingiliano kuhusu unyenyekevu wa kiakili ni wa kiuchunguzi na unapaswa kuthibitishwa katika sampuli huru.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *