

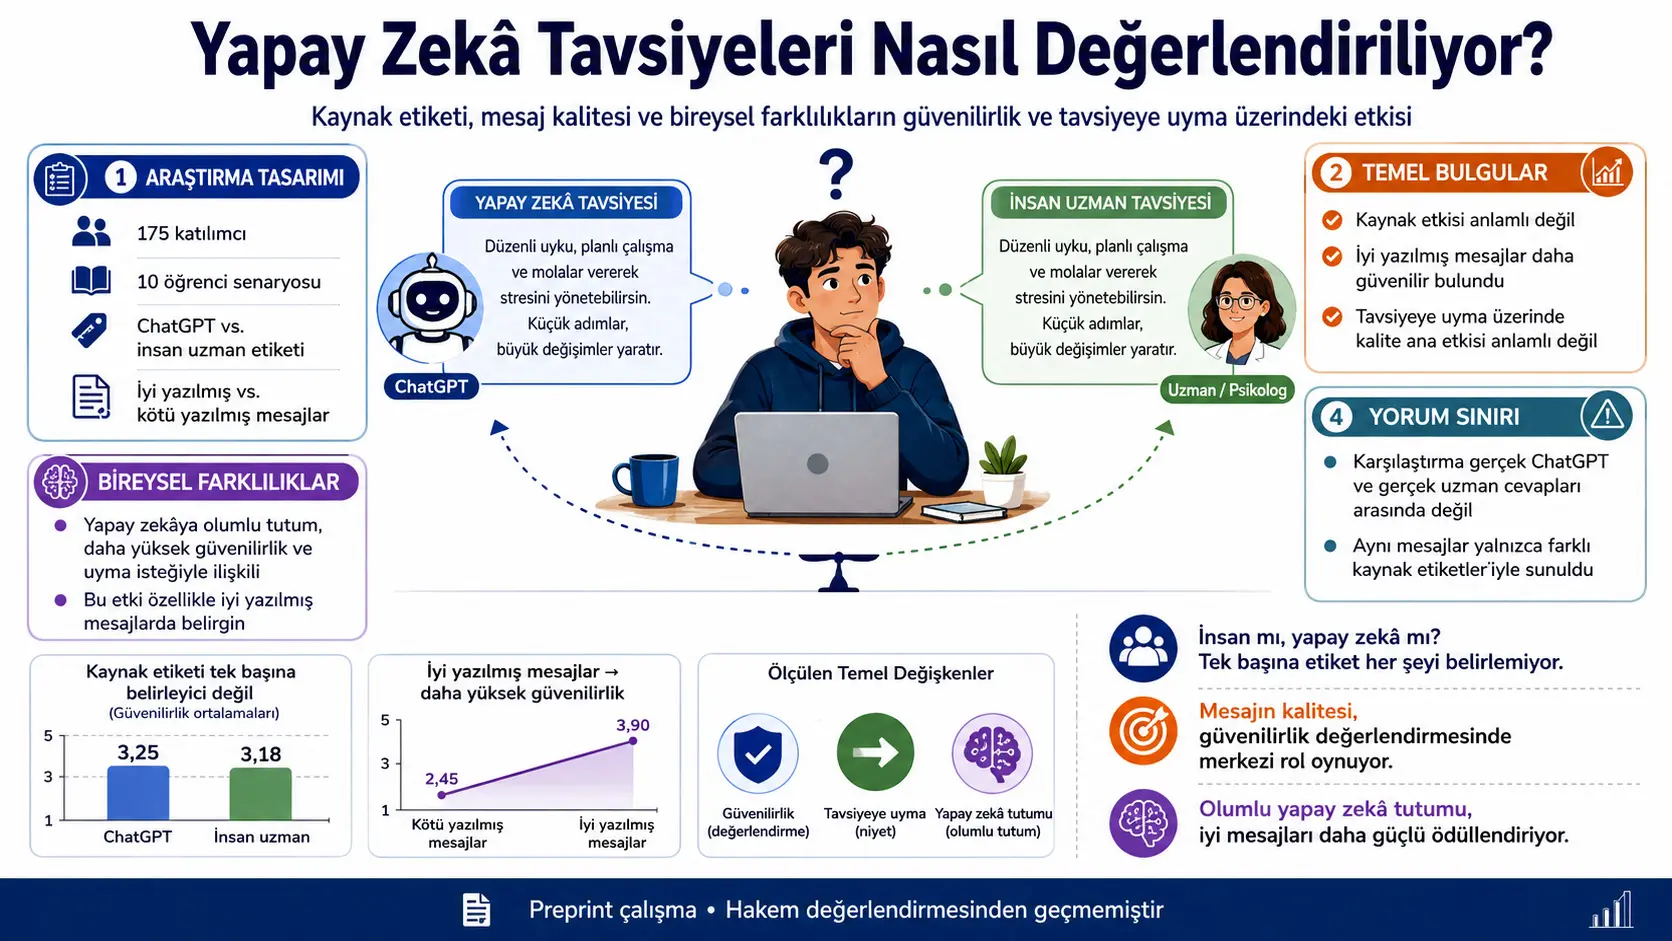
Bu tədqiqat, kişisel və tələbəlik həyatına ilişkin tövsiyələrin ChatGPT-yə və ya bir insan mütəxəssisə atfedilmesinin, mesajın yazı keyfiyyətinin və iştirakçıların süni intellektya yönelik tutumlarının qəbul edilən etibarlılıq ilə tövsiyəyə əməl etmə isteğini necə etkilediğini incelemiştir. Araşdırmaya ana dili fransızca olan 175 kişi katılmış; her iştirakçı beşi iyi, beşi kötü yapılandırılmış toplam on tövsiyə ssenarisunu değerlendirmiştir. Sıralı yanıtların və təkrarlı ölçmələrin yapısına uygun kümülatif əlaqəli qarışıq modellər kullanılmıştır. Sonuçlar, mesajın ChatGPT-yə və ya insan mütəxəssisə atfedilmesinin tek başına etibarlılıq ya da tövsiyəyə əməl etmə üzerinde anlamlı bir etkisi olmadığını; yaxşı yazılmış mesajların ise güvenilirliği anlamlı biçimde artırdığını göstermiştir. Mesaj kalitesinin tövsiyəyə əməl etmə üzerindeki genel ana etkisi anlamlı değildir.
Süni intellektya daha olumlu yaklaşan iştirakçılar genel olarak mesajları daha güvenilir bulmuş və tövsiyələre daha fazla əməl etmək istəyi göstermiştir. Ancaq bu eğilim yalnızca ChatGPT etiketi taşıyan mesajlarla sınırlı değildir; insan mütəxəssis etiketi taşıyan mesajlarda da görülmüştür. Keşifsel analizler, süni intellektya olumlu tutumun özellikle yaxşı yazılmış mesajların değerlendirilmesini güçlendirdiğini, pis yazılmış mesajlara ise otomatik bir güven sağlamadığını göstermektedir. Entelektüel alçakgönüllülük ana modellerde doğrudan bir belirleyici değildir; fakat keşifsel nəticələrda iyi və pis yazılmış mesajları ayırt etme duyarlılığıyla ilişkili görünmektedir.
Çalışmanın en önemli yorum sınırı, gerçek ChatGPT cevaplarının gerçek insan mütəxəssis cevaplarıyla karşılaştırılmamış olmasıdır. Tədqiqatçılar bütün tövsiyə metinlerini tədqiqat üçün hazırlamış və aynı metni yalnızca farklı kaynak etiketleriyle göstermiştir. Buna görə nəticələr, süni intellekt tarafından gerçekten üretilen tövsiyələrin kalitesini və ya güvenilirliğini değil, iştirakçıların bir mesaja “ChatGPT” ya da “insan mütəxəssis” etiketi verildiğinde necə tepki verdiğini açıklamaktadır. Çalışma ayrıca rəyçi qiymətləndirməsindən keçməmiş bir preprinttir.
Türkiyə baxımından qiymətləndirmə: Araşdırma deseni Türkiye’de üniversite öğrencileri, öğretmen adayları, psikolojik danışmanlık öğrencileri və farklı yaş gruplarıyla yeniden uygulanabilir. Böyle bir uyarlamada tövsiyələr Türkçe hazırlanmalı; mesajların dilsel akıcılığı, kültürel uygunluğu və güvenlik içeriği ayrı ayrı değerlendirilmelidir. Kaynak etiketi təcrübələrine ek olarak gerçek uzman cevapları, doğrudan büyük dil modelleri tarafından oluşturulan cevaplar və insan-süni intellekt ortak istehsali karşılaştırılmalıdır. Türkiye üçün nəticə çıkarabilmek amacıyla farklı üniversitelerden, eğitim düzeylerinden və süni intellekt təcrübəimlerinden iştirakçılar alınmalı; yalnızca “tövsiyəyə əməl etmə niyeti” değil, sonraki gerçek davranış da ölçülmelidir. fransızca konuşan, çoğunluğu genç və kadın iştirakçılardan elde edilen bu nəticələrdan Türkiye’deki bütün öğrencilerin və ya toplumun süni intellektya aynı biçimde yaklaşacağı doğrudan çıkarılamaz.
Araşdırmanın əsas sorusu nədir?
Araşdırma üç əsas soruya odaklanmaktadır. Birincisi, aynı tövsiyə ChatGPT-yə atfedildiğinde insan mütəxəssisə atfedildiği zamandan daha farklı mı değerlendirilmektedir? İkincisi, açık biçimde yapılandırılmış və somut öneriler sunan mesajlar; belirsiz, tekrarlı və kararsız ifadeler içeren mesajlardan daha güvenilir və uygulanabilir mi bulunmaktadır? Üçüncüsü, süni intellektya yönelik tutumlar ilə intellektual təvazökarlıq bu değerlendirmeleri değiştirmekte midir?
Çalışma, ikna araşdırmalarındaki iki işlem yolundan hareket etmektedir. Sezgisel işlemde kişi, mesajı ayrıntılı biçimde incelemek yerine “Bunu bir uzman söyledi” və ya “Bunu süni intellekt üretti” gibi kaynak ipuçlarına dayanabilir. Sistematik işlemde ise mesajın gerekçeleri, tutarlılığı, açıklığı və somutluğu daha dikkatli değerlendirilir. Tədqiqatçılar, süni intellekt tövsiyələrinde bu iki yolun hansısinin daha belirleyici olduğunu sınamak istemiştir.
Kaynak etkisi necə test edilmiştir?
Deneyde kaynak, iştirakçılar arası bir değişken olarak düzenlenmiştir. Katılımcılar rastgele iki gruptan birine atanmıştır:
- Bir gruba tövsiyələrin ChatGPT tarafından verildiği söylenmiştir.
- Diğer gruba aynı tövsiyələrin bir insan mütəxəssis və ya psikolog tarafından verildiği söylenmiştir.
Kaynak koşulları arasında tövsiyə metninin içeriği değiştirilmemiştir. Yalnızca cevabın üzerinde gösterilen mənbə etiketi farklıdır. Bu üsul, metnin gerçek kalitesini sabit tutarak yalnızca “süni intellekt” və ya “insan” etiketinin etkisini sınamak üçün kullanılmıştır.
Bu ayrıntı, nəticələrın doğru yorumlanması açısından kritiktir. Araşdırma, ChatGPT’nin ürettiği özgün bir cevabı insan mütəxəssisın yazdığı özgün bir cevapla karşılaştırmamaktadır. Katılımcılar kaynağın gerçek olduğuna inandırılmış, fakat karşılaştırılan unsur gerçekte yalnızca kaynak bilgisidir.
Mesaj kalitesi necə değiştirilmiştir?
Her ssenari üçün iyi və pis yazılmış olmak üzere iki cevap sürümü hazırlanmıştır. Yüksek kaliteli mesajların iki əsas özelliği bulunmaktadır:
- Problem tanımı, somut öneriler və sonraki adımlar arasında düzenli bir düşünce akışı bulunması,
- “Bir adım geri çekilin”, “duygularınızı açıkça ifade edin” və ya “dışarıdan destek alın” gibi belirli və uygulanabilir öneriler sunulması.
Düşük kaliteli mesajlar ise açık bir düşünce ilerlemesine sahip değildir. “Belki”, “duruma bağlı”, “işe yarayabilir”, “ama daha kötü de olabilir” gibi çok sayıda olasılık və belirsizlik ifadesi içermektedir. Bu cevaplar aynı konunun çevresinde dolaşmakta, fakat belirgin bir karar və ya eylem yolu önermemektedir.
Örneğin duygusal manipülasyon içeren bir ilişki ssenarisunda yüksek kaliteli cevap, sağlıksız ilişki belirtilerini tanımlamakta, kişinin durumuna dışarıdan bakmasını önermekte, konuşmada kullanabileceği somut bir ifade vermekte və gerektiğinde arkadaş, aile və ya terapist desteği aramasını söylemektedir. Düşük kaliteli sürüm ise konuşmak, beklemek, tepki vermemek və ya ilişkiyi sorgulamak gibi birbiriyle yarışan seçenekleri sıralamakta; her seçeneğin işe yarayıp yaramayacağını belirsiz bırakmaktadır.
Deneyde hansı ssenarilar kullanılmıştır?
Tədqiqatçılar akademik, duygusal və kişiler arası güçlükler yaşayan öğrencileri konu alan on kısa yaşam ssenarisu oluşturmuştur. Örneklerden birinde yakın arkadaşıyla tartışan və yalnızlık yaşayan bir öğrenci, arkadaşlığı düzeltmek və yalnızlıktan çıkmak üçün ne yapabileceğini sormaktadır. Başka bir örnekte, duygusal manipülasyon yaşadığını düşünen bir kişi ilişkideki dengesini yeniden kurmaya tədqiqatktadır.
Her iştirakçı on ssenarinun tamamını görmüştür. Bunların beşine yaxşı yazılmış, beşine pis yazılmış cevap eşleştirilmiştir. Hangi ssenarinun hansı kalite sürümüyle gösterileceği Qualtrics üzerinden rastgele belirlenmiştir. Böylece belirli bir ssenarinun sürekli iyi və ya sürekli kötü cevapla eşleşmesinin önüne geçilmek istenmiştir.
Deney akış şeması nə göstərir?
Çalışmanın işlem şeması, onam və demografik bilgilerden sonra iştirakçıların rastgele süni intellekt və ya insan kaynağı koşuluna dağıtıldığını göstermektedir. Her kaynak grubundaki iştirakçılar on ssenari değerlendirmiş; bunların beşinde iyi, beşinde pis yazılmış mesaj görmüştür. Kaynak iştirakçılar arasında, mesaj keyfiyyəti ise aynı iştirakçının içinde değişmiştir.
Deneyin ikinci aşamasında süni intellektya yönelik tutum, intellektual təvazökarlıq və sosyodemografik bilgiler ölçülmüştür. Bu ölçeklerin ssenarilardan sonra verilmesinin amacı, iştirakçıların süni intellekt hakkındaki düşüncelerine önceden dikkat çekerek cevap değerlendirmelerini yönlendirmemektir.
Araşdırmanın hipotezleri nelerdir?
| Hipotez | Beklenti | Sonuç |
|---|---|---|
| H1: Kaynak etkisi | İnsan uzmana atfedilen mesajların ChatGPT mesajlarından daha güvenilir bulunması və daha fazla takip edilmesi beklenmiştir. | Desteklenmemiştir. Kaynağın iki nəticə üzerinde de anlamlı ana etkisi bulunmamıştır. |
| H2: Mesaj kalitesi | İyi yazılmış mesajların daha güvenilir bulunması və daha fazla takip edilmesi beklenmiştir. | Kısmen desteklenmiştir. Güvenilirlik artmış, fakat tövsiyəyə əməl etmə üzerindeki ana etki anlamlı olmamıştır. |
| H3: Kaynak və kalite etkileşimi | Kalitesiz mesajlarda iştirakçıların kaynağa daha çok dayanması və insan mütəxəssisı tercih etmesi beklenmiştir. | Desteklenmemiştir. Kaynak ilə kalite arasında anlamlı etkileşim bulunmamıştır. |
| H4: Süni intellekt tutumunun kaynak etkisini değiştirmesi | Süni intellektya olumlu yaklaşanlarda insan və ChatGPT etiketleri arasındaki farkın azalması beklenmiştir. | Desteklenmemiştir. Süni intellekt tutumu kaynak etkisini anlamlı biçimde değiştirmemiştir. |
| H5: Entelektüel alçakgönüllülük | Entelektüel alçakgönüllülüğün etibarlılıq və tövsiyəyə əməl etmə değerlendirmelerini artırması beklenmiştir. | Desteklenmemiştir. Ana etkiler anlamlı değildir; yalnızca keşifsel etkileşimler bulunmuştur. |
Kaynak etiketi niyə beklenen etkiyi göstermemiş olabilir?
Katılımcılar, mesajların içeriğini, tutarlılığını və uygulanabilirliğini doğrudan değerlendirmekle görevlendirilmiştir. Tədqiqatçılar, bu talimatın kişileri yalnızca “süni intellekt” və ya “insan” etiketine dayanan hızlı bir yargıdan uzaklaştırarak mesaja daha analitik yaklaşmaya yöneltmiş olabileceğini düşünmektedir.
Bulgular, ChatGPT etiketinin otomatik bir güven kaybı və ya otomatik bir üstünlük oluşturmadığını göstermektedir. Aynı içerik ChatGPT-yə atfedildiğinde, ortalama olarak insan mütəxəssis etiketi taşıyan aynı içerikten anlamlı biçimde daha az və ya daha fazla güvenilir bulunmamıştır. Benzer biçimde, tövsiyəyə əməl etmə niyeti de yalnızca mənbə etiketi niyəiyle değişmemiştir.
Mesaj kalitesi neyi değiştirmiştir?
İyi yazılmış tövsiyələr, mənbə etiketi ne olursa olsun daha güvenilir bulunmuştur. Bu nəticə, açık bir düşünce akışının, belirli önerilerin və gerekçelendirilmiş bir mesaj yapısının etibarlılıq değerlendirmesinde önemli olduğunu göstermektedir.
Buna karşılık mesaj keyfiyyətinin tövsiyəyə əməl etmə üzerindeki genel ana etkisi anlamlı değildir. Betimsel ortalamalarda yaxşı yazılmış mesajlara uyma puanları daha yüksek görünse de sıralı karma model, diğer değişkenler və etkileşimler dikkate alındığında bu genel farkı istatistiksel olarak doğrulamamıştır. Bu səbəbdən “yaxşı yazılmış her tövsiyə mutlaka uygulanır” sonucu çıkarılamaz.
Süni intellektya yönelik tutumların rolü nədir?
Süni intellektya daha olumlu yaklaşan iştirakçılar, kaynağın ChatGPT və ya insan olarak gösterilmesinden bağımsız biçimde mesajları genel olarak daha güvenilir bulmuş və tövsiyələre daha fazla əməl etmək istəyi göstermiştir. Bu nəticə, süni intellektya yönelik tutumun yalnızca süni intellekt etiketli içeriklere yönelik dar bir önyargı gibi tədqiqatdığını göstermektedir.
Keşifsel analizlerde daha ayrıntılı bir örüntü ortaya çıkmıştır. Süni intellektya olumlu tutum, yaxşı yazılmış mesajlarda etibarlılıq və tövsiyəyə əməl etmə değerlendirmelerini artırmıştır. Kötü yazılmış mesajlarda ise süni intellekt tutumuyla değerlendirme arasında anlamlı ilişki bulunmamıştır. Başka bir ifadeyle, süni intellektya olumlu yaklaşmak kötü yapılandırılmış bir tövsiyəyi otomatik olarak kabul etmek anlamına gelmemiştir.
Entelektüel alçakgönüllülük ne anlama gelmektedir?
Entelektüel alçakgönüllülük, kişinin kendi bilgisinin sınırlı olabileceğini kabul etmesi, yanılabileceğini düşünmesi və yeni kanıtlar karşısında görüşünü değiştirmeye açık olmasıdır. Araşdırmada bu özellik, Kapsamlı Entelektüel Alçakgönüllülük Ölçeği’nin görüşleri değiştirmeye açıklık ilə düşünce və ego bağımsızlığı boyutları üzerinden ölçülmüştür.
Ana analizlerde intellektual təvazökarlıq etibarlılıq və ya tövsiyəyə əməl etmə üzerinde anlamlı bir genel etki göstermemiştir. Bununla belə kəşfiyyat xarakterli analizler, yüksek entelektüel alçakgönüllülüğe sahip iştirakçıların iyi və kötü mesajlar arasında daha güçlü ayrım yaptığını göstermektedir. Bu iştirakçılar yaxşı yazılmış tövsiyələri daha olumlu, pis yazılmış tövsiyələri ise daha olumsuz değerlendirmiştir.
Bundan əlavə yüksek intellektual təvazökarlıq düzeyinde insan mütəxəssisə atfedilen mesajlar ChatGPT-yə atfedilenlerden daha güvenilir bulunmuştur. Tavsiyeye uyma açısından intellektual təvazökarlıq insan mütəxəssis etiketi taşıyan mesajlarda pozitif bir ilişki gösterirken, ChatGPT etiketinde anlamlı ilişki göstermemiştir. Bu nəticələr doğrulayıcı ana modelin parçası değil, sonradan yapılan kəşfiyyat xarakterli analizlerdir və yeni araşdırmalarda yeniden sınanmalıdır.
Güvenilirlik grafiği nə göstərir?
Çalışmanın 27. sayfasındaki Şekil 4, süni intellektya yönelik tutum ilə tahmini etibarlılıq arasındaki ilişkiyi mesaj keyfiyyətine göre göstermektedir. İyi yazılmış mesajları temsil eden çizgi, süni intellektya yönelik tutum olumlu hâle geldikçe belirgin biçimde yükselmektedir. Kötü yazılmış mesajların çizgisi ise yataya yakın və hafif aşağı yönlüdür. Gölgeli alanlar yüzde 95 güven aralıklarını göstermektedir.
Grafiğin dikey ekseni, Tablo 1’deki doğrudan 1-7 Likert ortalaması değildir; sıralı karma modelden elde edilen tahmini ölçek değeridir. Bu səbəbdən grafikteki 0, 1, 2 və 3 gibi değerler ham etibarlılıq puanlarıyla doğrudan karşılaştırılmamalıdır.
Tavsiyeye uyma grafiği nə göstərir?
Çalışmanın 30. sayfasındaki Şekil 5’te benzer bir örüntü tövsiyəyə əməl etmə üçün görülmektedir. İyi yazılmış mesajlarda süni intellektya yönelik olumlu tutum arttıkça tahmini əməl etmək istəyi yükselmiştir. Kötü yazılmış mesajlarda çizgi yaklaşık yatay kalmıştır. Bu grafik de model tahminlerini və yüzde 95 güven aralıklarını göstermektedir.
Çalışmanın desteklediği nəticələr nelerdir?
- Aynı içerik üzerinde yalnızca ChatGPT və ya insan etiketi kullanılması, etibarlılıq və tövsiyəyə əməl etmə değerlendirmelerini tek başına anlamlı biçimde değiştirmemiştir.
- Açık, düzenli və somut öneriler içeren mesajlar daha güvenilir bulunmuştur.
- Mesaj kalitesinin tövsiyəyə əməl etmə üzerindeki genel ana etkisi istatistiksel olarak anlamlı değildir.
- Süni intellektya olumlu tutum, genel olarak daha yüksek etibarlılıq və tövsiyəyə əməl etmə değerlendirmeleriyle ilişkilidir.
- Olumlu süni intellekt tutumu, pis yazılmış mesajların eleştirilmeden kabul edilmesine yol açmamıştır.
- Entelektüel alçakgönüllülüğün doğrudan ana etkisi bulunmamıştır.
- Keşifsel nəticələr, bireysel özelliklerin mesaj keyfiyyətine duyarlılığı değiştirebileceğini düşündürmektedir.
Çalışma neyi kanıtlamamaktadır?
- ChatGPT tarafından gerçekten üretilen tövsiyələrin insan mütəxəssisların gerçek tövsiyələri kadar iyi olduğunu kanıtlamamaktadır.
- ChatGPT’nin psikolog, psikolojik danışman və ya başka bir uzman yerine kullanılabileceğini göstermemektedir.
- Katılımcıların gerçek yaşamda tövsiyələri uyguladığını göstermemektedir; yalnızca uygulama niyeti ölçülmüştür.
- Mesajların klinik doğruluğunu, güvenliğini və ya psikolojik yararını değerlendirmemektedir.
- Süni intellektya olumlu yaklaşan kişilerin bütün süni intellekt içeriklerine koşulsuz güvendiğini göstermemektedir.
- Fransa’daki genç iştirakçılardan elde edilen nəticələrın bütün ülkelere və yaş gruplarına genellenebileceğini göstermemektedir.
- Keşifsel intellektual təvazökarlıq etkileşimlerinin kesin və tekrarlanmış bulgular olduğunu göstermemektedir.
- Kaynak etiketinin başka alanlarda, özellikle tıbbi, hukuki və ya yüksek riskli kararlarda etkisiz olacağını kanıtlamamaktadır.
Güçlü yönler nelerdir?
Çalışmanın əsas güçlü yönü, kaynak ilə mesaj içeriğini birbirinden ayırmasıdır. Aynı metnin yalnızca mənbə etiketi değiştirilerek sunulması, gözlenen bir farkın metin kalitesinden değil kaynak bilgisinden kaynaklanıp kaynaklanmadığını daha temiz biçimde sınamaya olanak vermektedir.
Her iştirakçının hem iyi hem pis yazılmış mesajları değerlendirmesi, kişisel değerlendirme eğilimlerinin kalite karşılaştırmasını tamamen belirlemesini önlemektedir. Senaryo və iştirakçı düzeyindeki təkrarlı ölçmələri dikkate alan kümülatif əlaqəli qarışıq modellərin kullanılması da 1-7 arasındaki sıralı cavabların yapısına uygundur.
Çalışmada etibarlılıq ilə tövsiyəyə əməl etmə isteğinin ayrı nəticələr olarak incelenmesi de önemlidir. Bir kişi bir mesajı tutarlı və güvenilir bulduğu hâlde onu uygulamak istemeyebilir. Araşdırma bu iki değerlendirmeyi aynı kavram olarak kabul etmemiştir.
Başlıca sınırlılıklar nelerdir?
- Çalışma rəyçi qiymətləndirməsindən keçməmiş bir preprinttir.
- 286 kişi araşdırmaya başlamış, yalnızca tamamlayan 175 kişi analize alınmıştır; tamamlamayanların özellikleri ayrıntılı olarak incelenmemiştir.
- Örneklem çoğunlukla genç yetişkinlerden və kadınlardan oluşmaktadır.
- Bütün iştirakçıların ana dili fransızcadır; kültürler arası genellenebilirlik sınırlıdır.
- Senaryolar kısa və kurgusaldır; gerçek yaşamın karmaşıklığını tam olarak yansıtmayabilir.
- Katılımcılar on ssenariyu art arda değerlendirdiği üçün yorgunluk və ya dikkat azalması oluşmuş olabilir.
- Tavsiyeye uyma tek bir öz bildirim maddesiyle ölçülmüş, gerçek davranış izlenmemiştir.
- Kaynak manipülasyonu gerçek istehsal kaynağını değil, yalnızca sunulan etiketi değiştirmiştir.
- Yüksek və düşük kalite koşulları yalnızca mesajın yapısını değil, dəqiqlik tonunu və somutluk düzeyini de birlikte değiştirmiştir; bu unsurların bağımsız etkileri ayrıştırılmamıştır.
- Entelektüel alçakgönüllülük etkileşimleri doğrulayıcı modelin değil kəşfiyyat xarakterli analizlerin sonucudur.
- Veri erişimi konusunda ana metin ilə son başlık sayfasında farklı ifadeler bulunmaktadır.
Tədqiqatın metodu və nəticələri
Örneklem özellikleri
| Örneklem özelliği | Çalışmada bildirilen değer |
|---|---|
| Araşdırmaya başlayan kişi sayısı | 286 |
| Son analize alınan iştirakçı sayısı | 175 |
| Dil | Ana dili fransızca olan iştirakçılar |
| Ortalama yaş | 25 yıl |
| Yaş standart sapması | 4,90 yıl |
| Yaş aralığı | 18-45 yıl |
| Kadın | %68,9 |
| Erkek | %29,9 |
| İkili olmayan cinsiyet kimliği | %1,1 |
| Katılımcı bulma kanalları | SurveyCircle, sosyal medya və kişisel yönlendirme |
Deney deseni
| Değişken | Türü | Düzeyleri | Uygulama biçimi |
|---|---|---|---|
| Mesaj kaynağı | Katılımcılar arası faktör | ChatGPT və ya insan mütəxəssis | Katılımcı yalnızca bir kaynak koşuluna rastgele atanmıştır. |
| Mesaj kalitesi | Katılımcı içi faktör | İyi yazılmış və ya pis yazılmış | Her iştirakçı beş iyi və beş pis yazılmış mesaj değerlendirmiştir. |
| Süni intellektya yönelik tutum | Sürekli bireysel değişken | Düşükten yükseğe | Altı maddelik ölçekle ölçülmüştür. |
| Entelektüel alçakgönüllülük | Sürekli bireysel değişken | Düşükten yükseğe | On maddelik kısa ölçeğin iki alt boyutuyla ölçülmüştür. |
Ölçüm araçları
| Ölçülen yapı | Ölçüm biçimi | Ölçek |
|---|---|---|
| Algılanan etibarlılıq | “Cevap güvenilirdir” və “Cevap tutarlıdır” maddeleri | 1: Kesinlikle katılmıyorum – 7: Kesinlikle katılıyorum |
| Tavsiyeye uyma | “Bu cevabı takip etmeye istekli olurdum” maddesi | 1-7 Likert ölçeği |
| Senaryoya aşinalık | Kendisinin və ya yakın çevresinin benzer durumla karşılaşma sayısı | 0-10 |
| Duygusal etkilenme | Senaryonun kişiyi ne ölçüde etkileyeceği | 1-7 Likert ölçeği |
| Entelektüel alçakgönüllülük | Görüşü değiştirmeye açıklık və düşünce-ego bağımsızlığı | On madde; alt ölçek etibarlılıqleri α = 0,90 və α = 0,83 |
| Süni intellektya yönelik tutum | Güven, kabul və duygusal tepkiyi ölçen altı madde | Ölçek güvenilirliği α = 0,86 |
Senaryolar arasında aşinalık və duygusal etkilenme bakımından anlamlı fark bulunmadığı üçün bu değişkenler ana modellere kontrol değişkeni olarak eklenmemiştir.
İstatistiksel analiz
Bağımlı değişkenler 1-7 arasındaki sıralı Likert yanıtlarından oluştuğu və aynı iştirakçılar birden fazla ssenariyu değerlendirdiği üçün kümülatif əlaqəli qarışıq modellər kullanılmıştır. Modeller logit bağlantı fonksiyonuyla kurulmuştur. Analizler R 4.5.1 yazılımında “ordinal” paketiyle gerçekleştirilmiştir. Sonraki ikili karşılaştırmalar “emmeans” paketiyle yapılmış və çoklu karşılaştırmalar üçün p değerleri düzeltilmiştir.
Karma model yaklaşımı, yanıtların hem iştirakçılar hem de ssenarilar içinde kümelenmesini dikkate almaktadır. Böylece aynı kişinin genel olarak yüksek puan verme eğilimi ilə bazı ssenariların diğerlerinden daha kolay və ya zor değerlendirilmesi, təcrübəsel etkilerden ayrıştırılmaya çalışılmıştır.
Koşullara göre betimsel ortalamalar
| Kaynak | Mesaj kalitesi | Güvenilirlik ortalaması və SS | Tavsiyeye uyma ortalaması və SS |
|---|---|---|---|
| ChatGPT | İyi yazılmış | 6,14 (0,83) | 6,03 (0,93) |
| ChatGPT | Kötü yazılmış | 5,85 (0,92) | 5,43 (1,03) |
| İnsan uzman | İyi yazılmış | 6,26 (0,78) | 6,22 (0,75) |
| İnsan uzman | Kötü yazılmış | 5,47 (1,12) | 5,34 (1,10) |
Bu değerler iştirakçı düzeyindeki betimsel ortalamalardır. İstatistiksel nəticələr, bu ortalamaların doğrudan karşılaştırılmasına değil sıralı karma model tahminlerine dayanmaktadır.
Güvenilirliğe ilişkin doğrulayıcı nəticələr
| Test edilen etki | İstatistiksel nəticə | Yorum |
|---|---|---|
| Mesaj kaynağı | χ2(1) = 1,82; p = 0,177 | ChatGPT və insan mütəxəssis etiketleri arasında anlamlı ana fark yoktur. |
| Mesaj kalitesi | χ2(1) = 4,84; p = 0,028 | İyi yazılmış mesajlar daha güvenilir bulunmuştur. |
| Kaynak × kalite | χ2(1) = 1,42; p = 0,234 | Kalitenin etkisi mənbə etiketine göre anlamlı biçimde değişmemiştir. |
| Süni intellektya yönelik tutum | χ2(1) = 9,18; p = 0,002 | Daha olumlu tutum daha yüksek etibarlılıq değerlendirmesiyle ilişkilidir. |
| Kaynak × süni intellekt tutumu | χ2(1) = 1,23; p = 0,268 | Süni intellekt tutumu yalnızca ChatGPT etiketli mesajlara özgü bir etki göstermemiştir. |
| Entelektüel alçakgönüllülük | χ2(1) = 2,80; p = 0,094 | Anlamlı ana etki bulunmamıştır. |
Güvenilirliğe ilişkin keşifsel nəticələr
| Keşifsel analiz | Sonuç | Ayrıntı |
|---|---|---|
| Süni intellekt tutumu × mesaj keyfiyyəti | χ2(1) = 16,82; p < 0,001 | İyi mesajlarda eğim 0,77; %95 GA [0,29, 1,25]. Kötü mesajlarda eğim −0,22; %95 GA [−0,69, 0,24]. |
| Kaynak × kalite × süni intellekt tutumu | χ2(1) = 0,76; p = 0,384 | Kaliteye duyarlılığın ChatGPT və insan etiketlerine göre farklılaştığı gösterilmemiştir. |
| Entelektüel alçakgönüllülük × kalite | χ2(1) = 46,77; p < 0,001 | İyi mesajlarda eğim 0,996; kötü mesajlarda −0,495’tir. |
| Entelektüel alçakgönüllülük × kaynak | χ2(1) = 4,40; p = 0,036 | Yüksek intellektual təvazökarlıq düzeyinde insan etiketi daha güvenilir değerlendirilmiştir. |
Tavsiyeye uymaya ilişkin doğrulayıcı nəticələr
| Test edilen etki | İstatistiksel nəticə | Yorum |
|---|---|---|
| Mesaj kaynağı | χ2(1) = 0,36; p = 0,548 | ChatGPT və insan mütəxəssis etiketleri arasında anlamlı ana fark yoktur. |
| Mesaj kalitesi | χ2(1) = 1,18; p = 0,277 | Mesaj kalitesinin genel ana etkisi anlamlı değildir. |
| Kaynak × kalite | χ2(1) = 2,07; p = 0,151 | Kalite etkisinin kaynağa göre değiştiği gösterilmemiştir. |
| Süni intellektya yönelik tutum | χ2(1) = 5,76; p = 0,016 | Daha olumlu tutum daha yüksek tövsiyəyə əməl etmə isteğiyle ilişkilidir. |
| Kaynak × süni intellekt tutumu | χ2(1) = 0,03; p = 0,852 | Tutumun etkisi yalnızca ChatGPT etiketine özgü değildir. |
| Entelektüel alçakgönüllülük | χ2(1) = 1,70; p = 0,192 | Anlamlı ana etki bulunmamıştır. |
Tavsiyeye uymaya ilişkin keşifsel nəticələr
| Keşifsel analiz | Sonuç | Ayrıntı |
|---|---|---|
| Süni intellekt tutumu × mesaj keyfiyyəti | χ2(1) = 9,44; p = 0,002 | İyi mesajlarda eğim 0,63; %95 GA [0,24, 1,02]. Kötü mesajlarda eğim yaklaşık 0’dır. |
| Kaynak × kalite × süni intellekt tutumu | χ2(1) = 1,34; p = 0,247 | Kalite və tutum ilişkisinin mənbə etiketine göre farklılaştığı gösterilmemiştir. |
| Entelektüel alçakgönüllülük × kalite | χ2(1) = 51,63; p < 0,001 | İyi mesajlarda eğim 0,71; kötü mesajlarda −0,83’tür. Eğim farkı p < 0,0001 düzeyindedir. |
| Entelektüel alçakgönüllülük × kaynak | χ2(1) = 4,40; p = 0,036 | Entelektüel alçakgönüllülük insan etiketinde əməl etmək istəyini artırmış, ChatGPT etiketinde anlamlı ilişki göstermemiştir. |
Sonuçların uygulama açısından anlamı
Çalışma, tövsiyə sunan sistemlerde yalnızca “süni intellekt tarafından üretildi” və ya “uzman tarafından yazıldı” etiketi kullanmanın değerlendirmeleri tek başına belirlemeyebileceğini göstermektedir. Mesajın düzeni, açık gerekçeleri və somut önerileri etibarlılıq açısından daha belirgin görünmektedir.
Bununla belə iyi bir yazım biçimi, tövsiyənin bilimsel olarak doğru, güvenli və ya kişiye uygun olduğunu tek başına garanti etmez. Deney yalnızca iştirakçıların algısını ölçmüştür; mesajların içerik doğruluğunu bağımsız uzmanlara değerlendirmemiştir. Bu səbəbdən uygulamalarda akıcı və ikna edici dilin, içerik doğrulaması və uzman denetiminin yerine geçirilmemesi gerekir.
Mənbə və metod qeydi
| Kaynak kimliği alanı | Doğrulanan bilgi |
|---|---|
| Çalışmanın tam özgün adı | Evaluating AI-Generated Advice: Source Cues, Argument Quality, and Individual Differences in Credibility and Adherence |
| Yazarlar və sıraları | 1. Elodie Andrieu; 2. Aurélie Pistono; 3. Franck Amadieu |
| Eş birinci yazar | Eş katkı və ya eş birinci yazarlık bilgisi yer almamaktadır. |
| Sorumlu yazar | Elodie Andrieu |
| Kurum | CLLE Laboratory (Cognition, Languages, Language, Ergonomics), Toulouse Jean Jaurès University, Toulouse, Fransa |
| DOI | 10.2139/ssrn.7002154 |
| Dergi | Hakemli bir dergi adı bulunmamaktadır. |
| Yayınevi | Hakemli dergi yayınevi bilgisi bulunmamaktadır. |
| Yayın platformu | SSRN |
| Yayın yılı | 2026 |
| SSRN’ye yüklenme tarihi | 26 Haziran 2026 |
| Kaynak türü | Çevrim içi, karma desenli təcrübəsel araşdırma preprinti |
| Hakemlik durumu | Hakem değerlendirmesinden geçmemiştir. |
| Resmî yayın bağlantısı | SSRN resmî tədqiqat sayfası |
| Veri və analiz materyalleri | Open Science Framework proje sayfası |
Bu tədqiqat rəyçi qiymətləndirməsindən keçməmiş bir preprinttir; nəticələrı bu sınırlılık dikkate alınarak okunmalıdır. DOI, SSRN tədqiqat kaydını tanımlamaktadır və hakemli bir dergi yayınına ait DOI olarak sunulmamalıdır.
Araşdırma protokolü Toulouse Jean Jaurès Üniversitesi Etik Kurulu tarafından 24 Mart 2025 tarihinde, 2025_1040 numaralı proje kapsamında onaylanmıştır. Katılımcılardan bilgilendirilmiş onam alınmış, katılım gönüllü və anonim olarak yürütülmüştür.
Yazar katkıları beyanına göre Elodie Andrieu kavramsallaştırma, üsul, araşdırma, veri düzenleme, biçimsel analiz, görselleştirme və ilk taslak yazımını üstlenmiştir. Aurélie Pistono danışmanlık ilə inceleme və düzenlemeye; Franck Amadieu ise kavramsallaştırma, üsul, danışmanlık və inceleme-düzenlemeye katkı sağlamıştır. Çalışma üçün özel bir kamu, ticari və ya kâr amacı gütmeyen kuruluş finansmanı alınmadığı və yazarların çıkar çatışması bildirmediği belirtilmiştir.
Yazarlar, metnin hazırlanmasında dil iyileştirmesine yardımcı olmak amacıyla ChatGPT kullandıklarını; üretilen içeriği gözden geçirip düzenlediklerini və tədqiqatnın sorumluluğunu üstlendiklerini beyan etmektedir.
Veri erişimi konusunda tədqiqat içinde bir tutarsızlık bulunmaktadır. Ana metin, veri və analiz betiklerinin Open Science Framework üzerinde açık olduğunu belirtmektedir. Dosyanın sonundaki başlık sayfası ise verilerin sorumlu yazardan makul talep üzerine alınabileceğini söylemektedir. OSF proje bağlantısı mevcut olmakla birlikte iki veri erişim beyanı aynı açıklığı taşımamaktadır.
Bu Verianla makalesinin bilimsel içeriği yalnızca yüklenen tədqiqatya dayanarak hazırlanmıştır. Dış kaynaklar yalnızca DOI, yazar sırası, SSRN yüklenme tarihi, yayın platformu və resmî veri projesi gibi bibliyografik bilgileri doğrulamak amacıyla kullanılmıştır. Çalışmada bulunmayan təcrübəsel bulgu və ya dış bilimsel nəticə eklenmemiştir.
Çalışmanın əsas sınırlılıkları; örneklemin genç və ağırlıklı olarak kadın iştirakçılardan oluşması, yalnızca fransızca konuşan iştirakçıların incelenmesi, kısa kurgusal ssenarilar kullanılması, gerçek davranış yerine tövsiyəyə əməl etmə niyetinin ölçülmesi və gerçek ChatGPT çıktılarının gerçek insan mütəxəssis cevaplarıyla karşılaştırılmamış olmasıdır. Entelektüel alçakgönüllülüğe ilişkin etkileşimler keşifsel niteliktedir və bağımsız örneklemlerde doğrulanmalıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib