

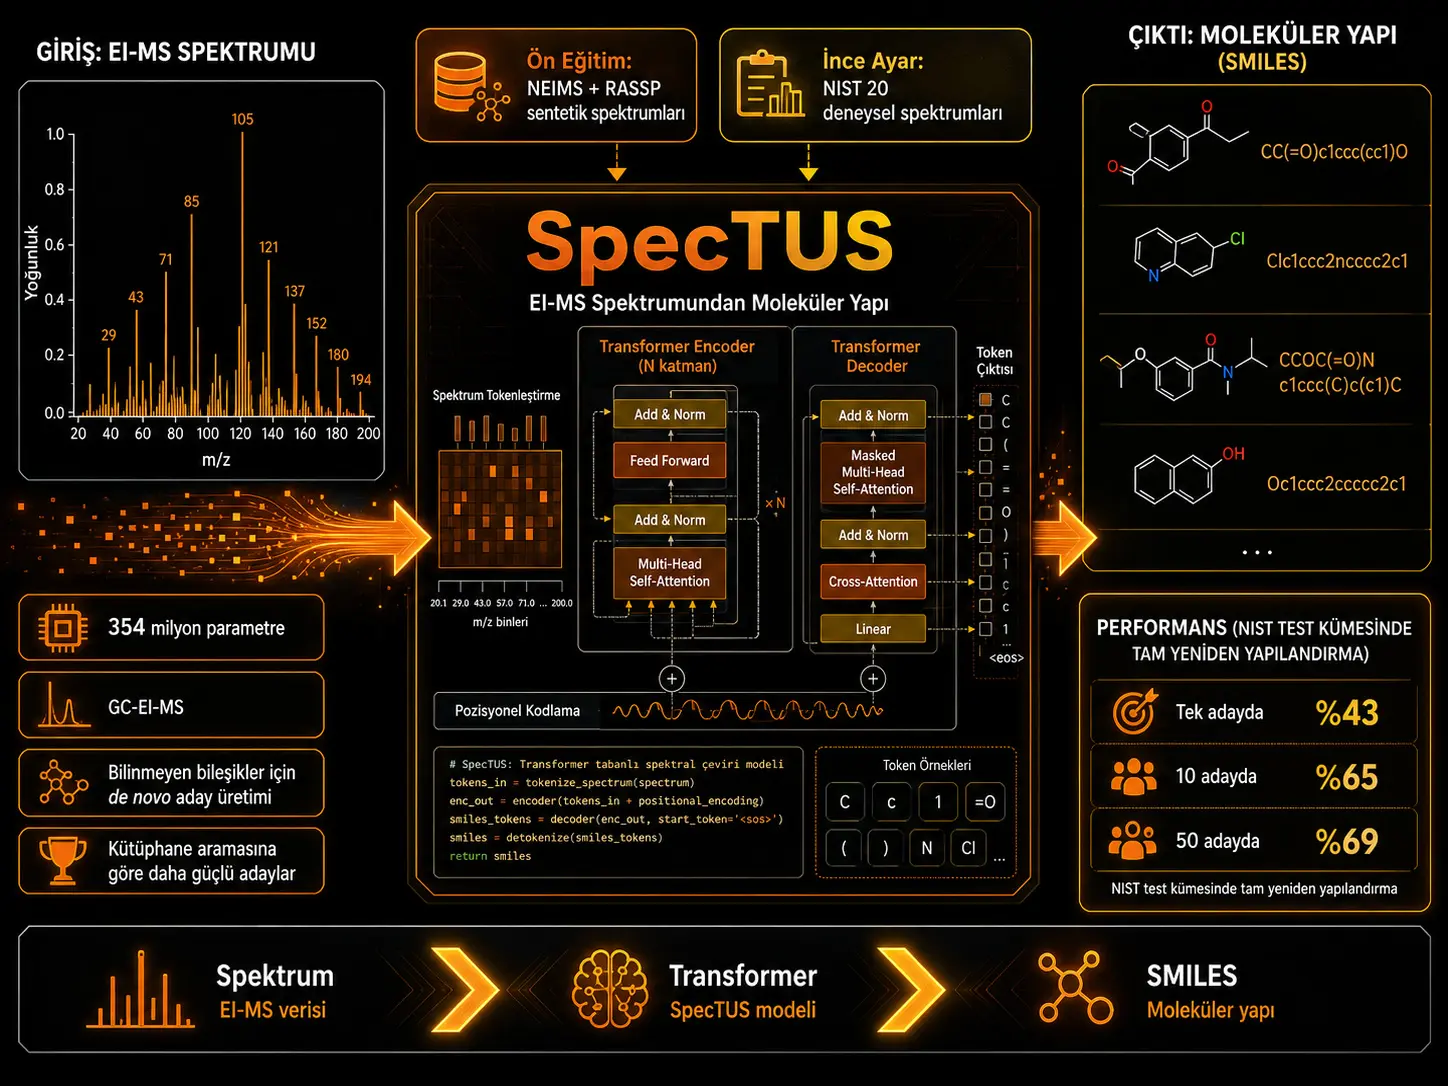
Utafiti huu unatambulisha modeli ya ujifunzaji wa kina iitwayo SpecTUS, iliyolenga kuzalisha moja kwa moja muundo wa molekuli kutoka kwenye spektra ya wingi yenye azimio la chini iliyopatikana kwa kromatografia ya gesi–spektrometria ya wingi yenye uionishaji wa elektroni (GC-EI-MS). Mbinu za jadi za utambuzi wa EI-MS kwa kawaida hutafuta spektra iliyopimwa katika maktaba ya spektra rejea. SpecTUS, kwa upande mwingine, hujaribu kuchakata taarifa za wingi/chaji na ukubwa wa kilele katika spektra na kuzalisha molekuli kama mfuatano wa SMILES bila kulazimisha kiwanja kinachoulizwa kiwepo katika maktaba ya spektra.
SpecTUS ni usanifu wa encoder–decoder Transformer wenye vigezo milioni 354 vinavyofundishika. Modeli kwanza ilifanyiwa mafunzo ya awali kwenye seti kubwa za data za sintetiki za EI-MS zilizotengenezwa na NEIMS na RASSP, kisha ikafanyiwa fine-tuning kwa spektra za majaribio za GC-EI-MS kutoka NIST 20. Ingizo la modeli linaundwa na jozi za m/z na ukubwa wa jamaa katika spektra; pato ni uwakilishi wa molekuli wa SMILES unaozalishwa herufi kwa herufi.
Katika seti ya majaribio ya spektra 28.267 iliyotengwa kutoka NIST 20, SpecTUS ilijenga upya kikamilifu %43 ya viwanja ilipopendekeza muundo mmoja tu. Wakati wagombea kumi walipozalishwa, kiwango cha ujenzi kamili kiliongezeka hadi %65, na katika hali ya wagombea 50 hadi %69. Katika hali ya mgombea mmoja, pendekezo la SpecTUS lilikuwa bora kuliko matokeo ya utafutaji wa hifadhidata mseto katika %76 ya sampuli za majaribio za NIST katika ulinganisho uliotegemea ufanano wa Tanimoto wa Morgan fingerprint na ukaguzi wa ulinganifu kamili; katika ulinganisho wa wagombea kumi, kiwango hiki ni %84.
Utendaji si sawa katika vyanzo vyote vya data. Matokeo ni ya juu katika spektra zilizoratibiwa kwa ukali zaidi za NIST na SWGDRUG, ilhali usahihi hupungua katika seti za data zenye utofauti mkubwa zaidi kama Cayman na MONA. Zaidi ya hayo, utendaji hupungua kwa kasi molekuli zinapochaguliwa zikiwa na ufanano unaozidi kupungua na miundo katika seti ya mafunzo. Kwa hiyo, utafiti unaonyesha kuwa SpecTUS inaweza kujumuisha kwa kiwango fulani viwanja ambavyo haikuviona wakati wa mafunzo, lakini hauonyeshi kuwa nafasi yote ya miundo mipya kabisa ya kemikali imetatuliwa.
Kwa mtazamo wa Türkiye, kazi hii inavutia kimetodolojia kwa maabara za utafiti zinazotumia GC-EI-MS katika kemia ya uchunguzi wa jinai, uchambuzi wa mazingira, uchambuzi wa dawa/madawa ya kulevya na ubainishaji wa molekuli ndogo. Hata hivyo, modeli haijathibitishwa kando kwenye vifaa vya maabara, michakato ya maandalizi ya sampuli au seti za analyte za ndani nchini Türkiye. Kwa kuwa ubora wa spektra na itifaki ya kipimo huathiri utendaji, matumizi ya ndani yanahitaji uthibitishaji huru na tathmini ya mwanakemia mtaalamu.
Kwa nini mbinu zaidi ya utafutaji wa maktaba ya spektra inahitajika?
Katika uchambuzi wa GC-MS, viwanja hutenganishwa kwanza kwa kromatografia ya gesi. Kisha molekuli zisizo na chaji huionishwa na spektrometa ya wingi hupima uwiano wa wingi/chaji (m/z) na wingi wa jamaa wa ioni zinazotokea. Matokeo ni mfululizo wa vilele vya spektra kwa kila kiwanja.
Kipaumbele cha utafiti ni uionishaji wa elektroni (EI). Nishati ya elektroni ya takribani 70 eV, ambayo imetumika sana kwa miongo kadhaa katika GC-EI-MS, inaweza kutoa mifumo ya mgawanyiko iliyo thabiti kwa kiasi kati ya maktaba tofauti za spektra. Hata hivyo, tofauti zinazotegemea kifaa na hali ya kipimo bado zinaweza kuwepo katika spektra ya kiwanja kilekile.
Katika mbinu ya jadi, spektra ya hoja hulinganishwa na spektra rejea zilizopimwa. Utafiti unatumia mbinu mbili kuu:
- Simple Similarity Search (SSS): hulinganisha vilele vya spektra vilivyo katika thamani zinazofanana za m/z.
- Hybrid Similarity Search (HSS): hutumia pia upotevu wa molekuli zisizo na chaji pamoja na ioni za vipande na huzingatia tofauti ya uzito wa molekuli kati ya molekuli ya hoja na ya rejea.
HSS inaweza kuwa na manufaa zaidi kuliko SSS, hasa ikiwa kiwanja kinachoulizwa hakipo kwenye maktaba. Hata hivyo, kikwazo muhimu cha mbinu hiyo ni kutegemea taarifa sahihi ya uzito wa molekuli ya kiwanja cha hoja; taarifa hii haiwezi kupatikana kwa kuaminika kila wakati kutoka kwa spektra za EI-MS zenye azimio la chini.
Kikwazo cha msingi zaidi ni wigo wa maktaba ya spektra. Ikiwa kiwanja hakipo kabisa katika maktaba rejea, utafutaji wa kawaida hauwezi kurudisha molekuli sahihi yenyewe; unaweza kupendekeza tu muundo ulio karibu zaidi kati ya wagombea waliopatikana. SpecTUS inalenga kuvuka kikwazo hiki kwa kujaribu kuzalisha muundo mpya wa molekuli moja kwa moja kutoka kwenye spektra.
Wazo kuu la SpecTUS ni nini?
SpecTUS huichukulia tatizo kama aina ya tatizo la “tafsiri”. Kama modeli ya lugha asilia inavyobadilisha mfuatano katika lugha moja kuwa mfuatano katika lugha nyingine, modeli hubadilisha spektra ya EI-MS kuwa uwakilishi wa muundo wa molekuli:
Spektra ya EI-MS → Transformer → mfuatano wa molekuli wa SMILES
Upande wa ingizo, kila kilele cha spektra hubeba taarifa mbili: thamani ya m/z iliyozungushwa hadi namba kamili iliyo karibu zaidi na ukubwa wa jamaa. Upande wa pato, modeli huzalisha muundo wa molekuli kwa kutengeneza herufi za SMILES kwa mtindo wa autoregressive, yaani kwa kutumia herufi ilizozalisha awali ili kuunda zinazofuata kwa mpangilio.
Usanifu wa modeli ni mkubwa kiasi gani?
SpecTUS ni encoder–decoder Transformer yenye vigezo milioni 354 vinavyofundishika, iliyojengwa juu ya mbinu ya BART. Vipimo vikuu vya usanifu vilivyotolewa katika chanzo ni hivi:
| Kipengele cha usanifu | Thamani ya SpecTUS |
|---|---|
| Idadi ya vitalu vya Encoder | 12 |
| Idadi ya vitalu vya Decoder | 12 |
| Idadi ya attention head | 16 |
| Ukubwa wa embedding | 1024 |
| Ukubwa wa safu fiche ya feed-forward | 4096 |
| Jumla ya vigezo vinavyofundishika | milioni 354 |
Vikomo vya ingizo vya modeli viliwekwa kuwa kiwango cha juu cha vilele 300 vya spektra, kiwango cha juu cha m/z = 500 na SMILES yenye urefu wa kiwango cha juu cha herufi 100. Vichujio hivi vilisababisha takribani %3 ya data ya NIST kuondolewa.
Spektra inasimbwaje kwa ajili ya modeli?
Katika utafiti, thamani za m/z huzungushwa hadi namba kamili iliyo karibu zaidi. Ukubwa wa jamaa hugawanywa katika vipindi vya logarithm badala ya kutumika moja kwa moja kama ingizo la nambari lenye azimio la juu sana. Katika modeli ya mwisho, thamani za ukubwa huwakilishwa ndani ya bin 30 kwa mabadiliko ya logarithm yenye msingi wa 1,28.
Modeli hutumia seti tatu za embedding zinazofundishika:
- embedding kwa thamani za m/z,
- embedding kwa bin za ukubwa,
- embedding kwa herufi za SMILES.
Uwakilishi wa kila kilele cha spektra kinachotumwa kwa Encoder ni jumla ya embedding ya m/z na embedding ya ukubwa. Upande wa Decoder, kila hatua huwakilisha herufi moja ya SMILES.
Kwa nini data za sintetiki zilitumika?
Idadi ya spektra halisi za majaribio za GC-EI-MS ni ndogo ikilinganishwa na nafasi inayowezekana ya miundo ya molekuli. Kwa hiyo, watafiti waliifundisha modeli kwanza katika nafasi pana zaidi ya kemia sintetiki na baadaye wakaibadilisha kwa spektra halisi za majaribio.
Hapo awali takribani bilioni 1,8 za mfuatano wa SMILES zilikusanywa kutoka ZINC20. Katika kila raundi ya ukusanyaji wa data, milioni 30 za SMILES zisizoharibika zenye urefu chini ya herufi 100 zilichaguliwa kwa nasibu, kisha miundo ikafanywa canonical, rekodi zinazojirudia zikaondolewa na taarifa za stereochemistry zikaondolewa. Viwanja vilivyopo katika NIST 20 viliondolewa kwenye viwanja vya mafunzo ya awali ya sintetiki ili kuzuia kuvuja kwa data.
Baada ya vikwazo vya elementi na sub-formula vinavyoweza kushughulikiwa na RASSP, takribani milioni 4,7 na milioni 4,8 za viwanja zilibaki katika raundi mbili za ukusanyaji. Kwa kuwa spektra ilitengenezwa kwa kila kiwanja kwa kutumia NEIMS na RASSP, makusanyo ya data sintetiki yalikuwa na jumla ya takribani milioni 9,4 na milioni 9,6 za spektra. Seti hizi ziligawanywa kwa mafunzo/uthibitishaji/majaribio kwa uwiano wa 0,90/0,05/0,05.
Mafunzo ya awali yalichukua muda gani?
Mafunzo ya mwisho ya awali ya SpecTUS yalifanywa kwenye mchanganyiko uliosawazishwa wa 1:1 wa vyanzo vya NEIMS na RASSP. Chanzo kinaripoti kuwa katika hatua ya mwisho ya mafunzo ya awali, spektra milioni 17,2 za mafunzo zilichakatwa takribani mara tatu.
| Kipengele cha mafunzo ya awali | Thamani |
|---|---|
| Ukubwa wa Batch | 128 |
| Hatua za kusasisha | 448.000 |
| Vifaa | 1 × NVIDIA H100 GPU |
| Muda wa jumla | saa 58 |
Mwishoni mwa mafunzo ya awali, kiwango cha ujenzi kamili wa muundo kilikuwa %38 kwa spektra zilizotengenezwa na RASSP, %29 kwa spektra za NEIMS na %3 pekee kwa spektra halisi za NIST. Hata hivyo, iliripotiwa kuwa %96 ya SMILES zilizozalishwa zilikuwa molekuli halali za canonical. Watafiti walitafsiri matokeo haya kuwa mafunzo ya awali yaliweka msingi wa kujifunza kanuni za muundo wa molekuli na uhusiano wa wingi wa atomu–m/z.
Fine-tuning kwa spektra halisi za NIST ilifanywaje?
Katika maktaba ya NIST 20 GC-EI-MS, spektra zilizoharibika au zisizo na annotation zilisafishwa, taarifa za stereochemistry zikaondolewa, uwakilishi wa SMILES ukafanywa canonical na viwanja vyenye deuterium vikaondolewa. Vikomo vya modeli vya m/z, idadi ya vilele na urefu wa SMILES pia vilitumika.
Katika sehemu ya kina ya mbinu, mgawanyo wa mwisho wa NIST umepewa kama ifuatavyo:
| Sehemu ndogo ya NIST 20 | Idadi ya spektra |
|---|---|
| Mafunzo | 224.737 |
| Uthibitishaji | 28.177 |
| Majaribio | 28.267 |
Viwanja vinavyojirudia havikuruhusiwa kusambazwa katika split tofauti. Kwa njia hii, ilijaribiwa kuzuia molekuli ileile kuwepo katika seti za mafunzo na majaribio.
Dokezo la namba ndani ya chanzo: Katika sehemu nyingine za makala, ukubwa wa mafunzo/fine-tuning wa NIST pia umeandikwa kama 232.025 na 232.035. Thamani ya spektra 224.737 za mafunzo katika sehemu ya kina ya seti ya data hailingani na kauli hizi mbili. Kwa hiyo, namba hizi tatu hazipaswi kubadilishwa kimya kimya kuwa thamani moja “iliyorekebishwa”.
Fine-tuning ilichukua muda gani?
Modeli ilifundishwa katika seti ya mafunzo ya NIST kwa hatua 296.000 za kusasisha na imeelezwa kuwa kila spektra ilichakatwa takribani mara 80. Fine-tuning, pamoja na tathmini za udhibiti, ilichukua takribani saa 28 kwenye NVIDIA H100 GPU moja.
Kwa kuvutia, wakati wa fine-tuning ya NIST uwezo wa modeli wa kujenga upya kikamilifu spektra sintetiki ulipungua haraka, huku utendaji wa uthibitishaji wa NIST wa majaribio ukiongezeka sana. Utafiti unaonyesha hili kama matokeo ya modeli kubadilika kutoka usambazaji wa data sintetiki kwenda usambazaji halisi wa majaribio.
Ni chaguo gani za muundo zilizolinganishwa kwa majaribio?
Badala ya kuripoti modeli ya mwisho pekee, watafiti walifanya majaribio matano tofauti ya maendeleo.
1. Kugawa ukubwa katika bin
Mbinu za uwakilishi wa ukubwa wa mstari na logarithm zililinganishwa. Uwakilishi mbovu sana ulisababisha upotevu wa taarifa, hasa katika vilele vya ukubwa mdogo. Mbinu ya logarithm yenye bin 30 iliongeza thamani ya uthibitishaji ya Acc1 kwa takribani pointi 0,9 za asilimia ikilinganishwa na usimbaji wa mstari wa nafasi nne za desimali, huku ikihitaji takribani vigezo milioni 10 vinavyofundishika vichache, na ilichaguliwa kwa modeli ya mwisho.
2. SMILES, SELFIES na tokenization
Modeli zinazotegemea SMILES zilitoa matokeo ya juu kwa pointi 1,7–5,8 za asilimia katika uthibitishaji wa Acc1 kuliko modeli inayotegemea SELFIES. Aidha, kamusi kubwa za Byte Pair Encoding, ambazo mara nyingi zina faida katika modeli za lugha asilia, hazikutoa manufaa hapa. Usimbaji rahisi zaidi wa SMILES wa kiwango cha herufi ulitoa matokeo bora kwa takribani pointi 3,5–4 za asilimia kuliko lahaja nyingine za BPE.
3. Mchanganyiko wa mafunzo ya awali ya sintetiki
Modeli isiyopata mafunzo ya awali ya sintetiki ililinganishwa na RASSP, NEIMS na mchanganyiko wao. Modeli zilizopata mafunzo ya awali ya sintetiki zilitoa faida ya takribani pointi 7–10 za asilimia katika uthibitishaji wa Acc1 ikilinganishwa na modeli iliyofanyiwa fine-tuning kwa data halisi pekee. Mchanganyiko wa 1:1 wa NEIMS na RASSP ulitoa matokeo bora zaidi.
4. Lebo ya chanzo cha spektra
Matumizi ya token maalum za chanzo kama <rassp>, <neims> na <nist> hayakuwa na mchango dhahiri katika utendaji wa mwisho. Lahaja iliyotumia token moja ya jumla ya chanzo ilitoa matokeo ya juu kwa takribani pointi 0,2 za asilimia katika Acc1. Hata hivyo, watafiti waliweka utaratibu wa token ya chanzo katika modeli ya mwisho kwa ajili ya fine-tuning ya baadaye kwenye seti maalum za data.
5. Kuongeza muda wa mafunzo na kiasi cha data
Utendaji uliimarika wakati muda wa mafunzo ya awali, muda wa fine-tuning na ukubwa wa data sintetiki viliongezwa kila kimoja kivyake. Usanidi wa mwisho wa kiwango kamili `8.6M_448k_296k` uliongeza Acc1 kwa pointi 5,4 za asilimia ikilinganishwa na modeli ya mwanzo `4.2M_112k_74k`.
Utafiti unatathminije pato?
Acck ni sehemu ya matukio ambapo molekuli halisi hupatikana kikamilifu ndani ya wagombea wa kwanza k waliotengenezwa na modeli. Metriki hii haitathmini tu muundo unaofanana, bali ulinganifu kamili wa molekuli.
Simk hupima ufanano wa Tanimoto kwenye Morgan molecular fingerprint wa muundo unaofanana zaidi na molekuli halisi ndani ya wagombea k.
Utafiti pia hutumia viwango vya win rate na at-least-as-good kulinganisha SpecTUS moja kwa moja na mbinu nyingine. Kwa kuwa Tanimoto fingerprints wakati mwingine zinaweza kutoa ufanano wa 1,0 kwa molekuli tofauti, ukaguzi wa ulinganifu kamili wa muundo pia umeongezwa kwenye kazi ya kupanga.
Kwa nini ulinganisho bandia unaoitwa BDC unatumika?
Best Database Candidate (BDC) ni kikomo cha juu cha kinadharia kisichopatikana katika matumizi halisi. BDC hudhani tayari tunajua muundo halisi wa molekuli ya hoja na huchagua kutoka miundo katika maktaba rejea ile iliyo karibu zaidi nayo kwa Morgan fingerprint.
Kwa hiyo BDC si mbinu ya utambuzi wa vitendo. Jukumu lake katika utafiti ni kuweka kikomo cha juu kwa swali, “ikiwa tayari hakuna muundo bora zaidi katika hifadhidata, ni ipi mipaka ya kuboresha algoriti ya utafutaji?”
Kielelezo 1 kinaeleza nini?
Mchoro wa mbinu wa utafiti unaonyesha pamoja mafunzo ya hatua mbili ya SpecTUS na inference ya mwisho. Upande wa mafunzo ya awali, miundo ya SMILES kutoka ZINC hubadilishwa kuwa spektra sintetiki kupitia NEIMS/RASSP na kufundishwa kwa SpecTUS. Katika hatua ya fine-tuning, spektra za majaribio za NIST na lebo halisi za SMILES hutumika. Wakati wa inference, mtiririko hufanya kazi kinyume: spektra ya EI-MS inayochambuliwa huingizwa moja kwa moja katika SpecTUS na modeli huzalisha mgombea mmoja au zaidi wa SMILES waliopangwa.
Matokeo yanayoungwa mkono na utafiti
- SpecTUS iliweza kuzalisha wagombea wapya wa muundo wa molekuli kutoka spektra za GC-EI-MS zenye azimio la chini hata wakati viwanja vya majaribio vilitenganishwa na seti za data za mafunzo.
- Katika seti ya majaribio ya NIST, usahihi wa muundo kamili kwa mgombea mmoja ni %43, kwa wagombea 10 ni %65 na kwa wagombea 50 ni %69.
- Katika NIST, mgombea mmoja wa SpecTUS alitoa mgombea bora wa kimuundo kuliko mgombea mmoja wa HSS katika %76 ya sampuli.
- Katika spektra zilizoratibiwa vizuri zaidi kama NIST na SWGDRUG, modeli ilifanya vizuri zaidi kuliko katika Cayman na MONA.
- Mafunzo ya awali kwenye data sintetiki yalitoa utendaji wa uthibitishaji wa juu kuliko mafunzo kwa data za majaribio za NIST pekee.
- Kutumia pamoja wazalishaji wengi wa spektra sintetiki kulitoa faida ikilinganishwa na chanzo kimoja.
Matokeo ambayo utafiti hauungi mkono au kuthibitisha
- SpecTUS si mfumo wa utambuzi wa kemikali wa ulimwengu wote unaoweza kutambua kwa kuaminika kila molekuli isiyojulikana.
- Pato la kwanza la modeli halipaswi kuchukuliwa kama ushahidi wa mwisho wa utambulisho bila uthibitishaji huru.
- Modeli haitoi dhamana ya usahihi wa juu kwa miundo mipya kabisa iliyo mbali sana na kemia ya mafunzo.
- Utafiti hauonyeshi kuwa modeli inaweza kuchukua nafasi ya mtaalamu wa maabara.
- Haijaonyeshwa kuwa pato la modeli linaweza kuelezwa kupitia mti wa mgawanyiko au utaratibu wa peak assignment.
- Kupungua kwa utendaji katika Cayman na MONA kunaonyesha kuwa usahihi uleule hauwezi kutarajiwa katika hali zote za maabara na vifaa.
Mbinu na Matokeo ya Utafiti
Seti za data za tathmini
Modeli ilitathminiwa si tu katika NIST test split, bali pia katika data za EI-MS kutoka vyanzo huru vya SWGDRUG, Cayman na MONA. Baada ya kuondoa viwanja vinavyogongana na data za mafunzo na sampuli zinazozidi mipaka ya modeli, idadi ya spektra zilizotumika ilikuwa kama ifuatavyo:
| Seti ya data ya majaribio | Idadi ya awali ya spektra | Idadi ya spektra zilizotumika baada ya kuchuja |
|---|---|---|
| NIST test | 29.218 | 28.267 |
| SWGDRUG | 3.589 | 1.640 |
| Cayman | 2.262 | 469 |
| MONA | 18.914 | 5.015 |
Kuchuja kulihusisha kuondoa miingiliano na seti ya mafunzo ya NIST, kuondoa miundo yenye deuterium, sampuli zenye m/z > 500, spektra zenye zaidi ya vilele 300 vya spektra na mfuatano wa SMILES unaozidi herufi 100.
Ujenzi sahihi wa molekuli katika NIST
Spektra 28.267 za majaribio katika NIST ndizo tathmini pana zaidi na iliyodhibitiwa vizuri zaidi katika utafiti. Idadi ya wagombea inapoongezeka, uwezekano wa molekuli halisi kuwepo kwenye orodha ya mapendekezo huongezeka.
Kutoka mgombea mmoja hadi wagombea 10 huongeza pointi 22 za asilimia za ulinganifu kamili. Kinyume chake, kutoka wagombea 10 hadi 50 huleta faida ya pointi 4 za asilimia pekee. Matokeo haya yanaonyesha kuwa kuongeza idadi ya wagombea bila kikomo lazima kuzingatiwe pamoja na mzigo wa tathmini ya mtaalamu.
Kwa nini mtaalamu bado anahitajika katika matokeo ya wagombea wengi?
SpecTUS huzalisha uwezekano wake wa kupanga kwa kila mgombea; hata hivyo, watafiti waligundua kuwa upangaji huu hauaminiki kiasi cha kuchukua nafasi ya tathmini ya mtaalamu. Hata mgombea wa kwanza katika hali ya wagombea 10 kwa wastani ana usahihi ulio chini kidogo kuliko mgombea katika hali ya kuzalisha mgombea mmoja tu.
Kwa hiyo utafiti unafafanua hali tatu za matumizi:
- mgombea 1: mzigo mdogo zaidi wa kazi ya mikono, unafaa kwa uchambuzi wa kiasi kikubwa; lakini usahihi ni mdogo.
- wagombea 10: hali yenye uwiano bora zaidi kati ya usahihi na mzigo wa mapitio ya mtaalamu.
- wagombea 50: huongeza uwezo wa modeli lakini huongeza sana mzigo wa mapitio ya mikono.
Ulinganisho na HSS kwa ufanano wa kimuundo
Katika majaribio ya NIST, wastani wa ufanano wa Morgan/Tanimoto wa SpecTUS kwa mgombea mmoja ni 0,67. Hata katika matokeo ya HSS yenye wagombea 50, thamani hii imeripotiwa kuwa 0,62. Katika SWGDRUG, wastani wa mgombea mmoja wa SpecTUS ni 0,69, ilhali HSS50 ni 0,61.
| Seti ya data | SpecTUS mgombea 1 Sim1 | HSS wagombea 50 Sim50 | Kikomo cha juu cha kinadharia cha BDC | SpecTUS wagombea 10 Sim10 |
|---|---|---|---|---|
| NIST test | 0,67 | 0,62 | 0,72 | 0,81 |
| SWGDRUG | 0,69 | 0,61 | 0,69 | 0,82 |
SpecTUS yenye wagombea kumi inaweza katika seti hizi mbili za data kutoa wastani wa ufanano ulio juu hata kuliko thamani ya BDC, ambayo huwakilisha molekuli iliyo karibu zaidi inayowezekana katika maktaba rejea. Sababu ni kwamba SpecTUS hailazimiki kuchagua tu kati ya miundo iliyopo kwenye maktaba na inaweza kuunda miundo mipya.
Kiwango cha ushindi wa moja kwa moja dhidi ya HSS
Katika majaribio ya NIST, SpecTUS yenye mgombea mmoja ilipendekeza muundo bora kwa uwazi kuliko mgombea wa HSS chini ya hali hiyo hiyo katika %76 ya sampuli za majaribio. Katika hali ya wagombea kumi, kiwango hiki hufikia %84. Wakati hali zote za wagombea katika chanzo zinatathminiwa pamoja, kiwango cha ushindi cha SpecTUS–HSS katika NIST kiko katika safu ya %76–86.
Kwa SWGDRUG safu imeripotiwa kuwa %72–85, Cayman %63–74 na MONA %62–65. Kupungua kwa ukubwa wa faida ya SpecTUS kadiri kuratibu spektra kunavyopungua kunaonyesha wazi unyeti wake kwa ubora wa data ya ingizo.
Je, hata mgombea bora zaidi wa kinadharia wa hifadhidata anaweza kushindwa?
BDC ni kikomo cha juu cha kinadharia cha hifadhidata kinachodhani kuwa tunajua muundo halisi wa hoja. Hata hivyo, katika NIST mgombea mmoja wa SpecTUS alikuwa bora kuliko BDC katika %47 ya matukio, na katika SWGDRUG katika %45.
Wakati wagombea kumi walipozalishwa, SpecTUS ilikuwa bora kuliko BDC katika %70 ya sampuli katika NIST na SWGDRUG na ilizalisha mgombea bora katika %56 ya Cayman. Matokeo haya yanaonyesha faida kuu ya uzalishaji wa de novo: hata ikiwa muundo sahihi au wa karibu zaidi wa molekuli haupo katika maktaba rejea, modeli inaweza kuunda mgombea mpya.
Ujumbe mkuu wa Kielelezo 3
Kielelezo 3 kinaonyesha kwa pamoja wastani wa ufanano wa kimuundo wa SSS, HSS na SpecTUS katika NIST, SWGDRUG, Cayman na MONA kwa hali za wagombea 1, 10 na 50. Thamani za usahihi wa SpecTUS pia zinaonyeshwa kwa alama nyeusi.
Katika safu za NIST na SWGDRUG, faida ya SpecTUS inaonekana wazi zaidi. Tukihamia Cayman na hasa MONA, ufanano wa kimuundo wa mbinu zote hupungua na tofauti kati ya SpecTUS na HSS hupungua. Watafiti wanahusisha hili na tofauti katika ubora wa uzalishaji na uratibu wa spektra.
Kielelezo 4 kinaonyesha nini?
Paneli A ya Kielelezo 4 inalinganisha SpecTUS moja kwa moja na HSS, huku paneli B ikiilinganisha na kikomo cha juu cha kinadharia cha BDC. Nguzo nyekundu zinaonyesha sampuli ambapo SpecTUS ni bora kwa wazi; sehemu nyepesi ya ziada inaonyesha kiwango cha “at-least-as-good” kinachojumuisha pia sare.
Katika NIST na SWGDRUG, faida ya SpecTUS dhidi ya HSS inaongezeka kadiri idadi ya wagombea inavyoongezeka, ilhali katika MONA manufaa ya wagombea wa ziada ni madogo zaidi. Mwonekano huu unaonyesha kuwa kuzalisha wagombea wengi pekee hakuwezi kufidia data duni ya spektra.
Je, modeli inajumuisha kweli kemia mpya kabisa?
Mojawapo ya majaribio muhimu zaidi ya mipaka ya utafiti ni kupunguza kwa utaratibu ufanano wa kimuundo wa molekuli za majaribio na miundo katika seti ya mafunzo. Watafiti walitumia umbali wa maximum common edge subgraph (MCES) kuzuia seti ya majaribio ya NIST kwa molekuli zinazozidi kuwa tofauti.
Wakati kizingiti cha umbali kilikuwa T = 10, ni %1,7 tu ya seti ya awali ya majaribio ya NIST, yaani miundo 469, iliyobaki. Katika hali hii ngumu zaidi, SpecTUS iliweza kujenga upya kikamilifu molekuli 19 pekee ndani ya wagombea 10 na wastani wa ufanano wa kimuundo ukashuka hadi 0,38.
Matokeo haya yanalingana na takribani %4 Acc10 na yanaonyesha wazi kikomo cha kiutendaji cha modeli. Ingawa SpecTUS inaweza kutabiri molekuli ambazo haijawahi kuona, haionyeshi ujanibishaji wa juu kwa miundo iliyo mbali kabisa na mifumo ya kemikali iliyojifunza wakati wa mafunzo.
Ni makosa gani ya kawaida ya utabiri wa muundo?
Katika Kielelezo 5, ufanano wa SpecTUS10 na HSS10 kwa hoja 200 za nasibu kutoka seti ya majaribio ya NIST ulilinganishwa na mifano mitano ikaonyeshwa kwa kina. Watafiti wanafafanua aina tatu za kawaida za makosa:
- kuzalisha minyororo ya kaboni inayojirudia ikiwa mirefu au mifupi kuliko inavyohitajika,
- kuunganisha kundi sahihi la kikemia kwenye atomu isiyo sahihi ya pete ya aromatiki,
- kutatua kwa usahihi miundo mikubwa ya sehemu ya molekuli lakini kuiunganisha vibaya.
Kielelezo 5 pia kinaonyesha kikwazo cha kipimo chenyewe cha Tanimoto/Morgan. Katika minyororo mirefu na inayojirudia, molekuli mbili tofauti wakati mwingine zinaweza kutoa Tanimoto = 1 kana kwamba zina fingerprint sawa. Kwa hiyo utafiti hukagua pia ulinganifu kamili wa muundo kando.
Kasi ya inference
Modeli ilijaribiwa kwenye madaraja matatu tofauti ya vifaa. Thamani zifuatazo ni muda wa kuzalisha mgombea 1, 10 au 50 wa muundo kwa spektra moja:
| Vifaa | mgombea 1 | wagombea 10 | wagombea 50 |
|---|---|---|---|
| NVIDIA H100 80 GB | 0,2 s | 0,4 s | 1,9 s |
| NVIDIA Quadro RTX 5000 16 GB | 0,5 s | 1,1 s | 7,6 s |
| Xeon Gold 6130 CPU + 8 GB RAM | 8 s | 36 s | 450 s |
Nyakati hizi zinaonyesha kuwa modeli inaweza kutumika katika mtiririko wa kazi wa maabara, lakini zinategemea vifaa. Hasa, kuzalisha wagombea 50 kwenye CPU hufikia dakika 7,5; kwa hiyo neno “haraka” halipaswi kutumiwa bila kuzingatia idadi ya wagombea na muktadha wa vifaa.
Kikomo cha kuelezeka
SpecTUS haielezi kwa hatua za mgawanyiko wa kemikali kwa nini ilizalisha molekuli fulani. Pato la kati la modeli halina annotation za vilele, miti ya mgawanyiko au spektra rejea za wagombea waliopendekezwa.
Hali hii hufanya iwe vigumu kwa mtaalamu kusahihisha mgombea asiye sahihi hatua kwa hatua. Ingawa modeli ni jenereta yenye nguvu ya wagombea, si chombo kinachoeleza chenyewe msingi wa kemikali wa utabiri.
Maana ya kisayansi ya matokeo
Ubunifu mkuu wa utafiti ni matumizi ya modeli kubwa ya Transformer inayotafsiri spektra moja kwa moja kuwa muundo wa molekuli badala ya kutafuta tu maktaba ya spektra katika GC-EI-MS yenye azimio la chini. Kutenganishwa kwa viwanja vya majaribio na viwanja vya mafunzo kunaunga mkono kuwa SpecTUS haikufanya kukariri pekee na imeendeleza uwezo fulani wa ujumlishaji.
Hata hivyo, kushuka kwa kasi kwa utendaji katika viwanja vya majaribio vilivyo mbali sana kimuundo kunaonyesha mipaka ya dhana ya “isiyojulikana” kwa modeli. Modeli inaweza kuunda miundo ambayo haikuiona moja kwa moja wakati wa mafunzo, lakini hufanya hivyo kwa kiasi kikubwa kwa kuunganisha upya mifumo midogo ya kemikali iliyojifunza hapo awali kwa njia mpya.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: SpecTUS: Spectral Translator for Unknown Structures Annotation from EI-MS Spectra
Waandishi na mpangilio wao: Adam Hájek; Michal Starý; Elliott Price; Filip Jozefov; Helge Hecht; Aleš Křenek.
Mchango sawa / uandishi wa kwanza wa pamoja: Hakuna tamko la mchango sawa katika utafiti uliokaguliwa.
Mwandishi anayewajibika: Aleš Křenek.
Taasisi: Adam Hájek na Aleš Křenek — Institute of Computer Science, Masaryk University, Brno, Czech Republic. Michal Starý — School of Computation, Information and Technology, Technical University Munich, Garching bei München, Germany. Elliott Price na Helge Hecht — RECETOX, Masaryk University, Brno, Czech Republic. Filip Jozefov — Faculty of Informatics, Masaryk University, Brno, Czech Republic.
Aina ya chanzo / hali ya peer review: Makala ya utafiti iliyopitiwa na wataalamu rika.
Jarida: Analytical Chemistry.
Mchapishaji: American Chemical Society.
Taarifa ya bibliografia: Anal. Chem. 2026, 98, 21670–21682.
DOI: 10.1021/acs.analchem.6c02423.
Kuwasilishwa / kurekebishwa / kukubaliwa / kuchapishwa: 14 Aprili 2026 / 29 Juni 2026 / 30 Juni 2026 / 13 Julai 2026.
Kiungo rasmi:https://doi.org/10.1021/acs.analchem.6c02423
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Upatikanaji wa data na msimbo: Msimbo chanzo wa utafiti, mtiririko wa maandalizi ya data na tathmini umeshirikiwa kupitia GitHub. Seti za data sintetiki na modeli iliyofundishwa awali zimechapishwa kwenye Hugging Face. Hata hivyo, kutokana na masharti ya leseni ya kibiashara ya NIST, modeli ya mwisho iliyofanyiwa fine-tuning kwenye NIST 20 haiwezi kusambazwa kwa uhuru. Imeelezwa kuwa watumiaji wenye leseni ya NIST wanaweza kurudia fine-tuning kwa split na scripts zilizochapishwa.
Mgongano wa maslahi: Waandishi wametangaza kutokuwa na maslahi ya kifedha yanayoshindana.
Ufadhili: Utafiti uliungwa mkono na miradi ya e-Infrastruktura CZ (LM2023054) na RECETOX Research Infrastructure (LM2023069) ya Wizara ya Elimu, Vijana na Michezo ya Czechia pamoja na mradi wa CETOCOEN Excellence (857560) wa mpango wa Horizon 2020 wa Umoja wa Ulaya. Rasilimali za kompyuta zilitolewa kupitia mradi wa e-INFRA CZ No. 90254.
Michango ya waandishi: Adam Hájek alitekeleza SpecTUS, alishiriki katika muundo wa majaribio, aliendesha majaribio na kuchangia uandishi wa makala. Michal Starý alichangia muundo wa modeli na majaribio. Elliott Price alitoa mwongozo katika maandalizi ya data, muundo wa majaribio na tathmini. Filip Jozefov alitekeleza maandalizi/split ya data na uzalishaji wa data sintetiki. Helge Hecht alichangia tathmini. Aleš Křenek aliongoza utafiti, alitekeleza mabadiliko na mafunzo ya RASSP, alichangia uzalishaji wa data sintetiki, muundo wa majaribio na uandishi wa makala, na alisimamia taratibu za kuwasilisha/kurekebisha.
Kutokulingana kwa seti ya data ndani ya chanzo: Katika sehemu ya kina ya mbinu, NIST 20 training split imetolewa kama spektra 224.737, ilhali sehemu ya utangulizi ina 232.025 na sehemu ya baseline ina 232.035. Namba hizi hazijaunganishwa kimya kimya kuwa thamani moja. Katika jedwali la mafunzo/uthibitishaji/majaribio la maandishi haya ya Verianla, mgawanyo wa 224.737 / 28.177 / 28.267 kutoka sehemu ya kina ya “Fine-Tuning Data Set” umetumika.
Vikwazo vya mbinu: SpecTUS ilitengenezwa kwa GC-EI-MS yenye azimio la chini na ni nyeti kwa ubora wa spektra ya ingizo. Modeli haitoi maelezo ya mgawanyiko wa kemikali kwa utabiri maalum. Katika hali za wagombea wengi, upangaji wa ndani wa modeli wa wagombea haukuonekana kuaminika peke yake na tathmini ya mtaalamu ilionekana kuwa muhimu. Utendaji wa ujenzi kamili hupungua sana katika miundo ya molekuli iliyo mbali sana na miundo ya mafunzo.
Mbinu ya maudhui: Matokeo ya kisayansi katika makala hii ya Verianla yanategemea tu maandishi, majedwali, vielelezo na matokeo yaliyotolewa na waandishi wa utafiti uliokaguliwa. Uthibitishaji wa nje ulitumiwa tu kwa nyanja za utambulisho wa bibliografia kama DOI, mchapishaji, jarida na hali ya peer review; hakuna matokeo mapya ya utendaji au ugunduzi wa kemikali ulioongezwa kutoka nje.
Lebo za Meta
GC-EI-MS, SpecTUS, annotation ya muundo wa molekuli, spektrometria ya wingi, modeli ya Transformer
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *