

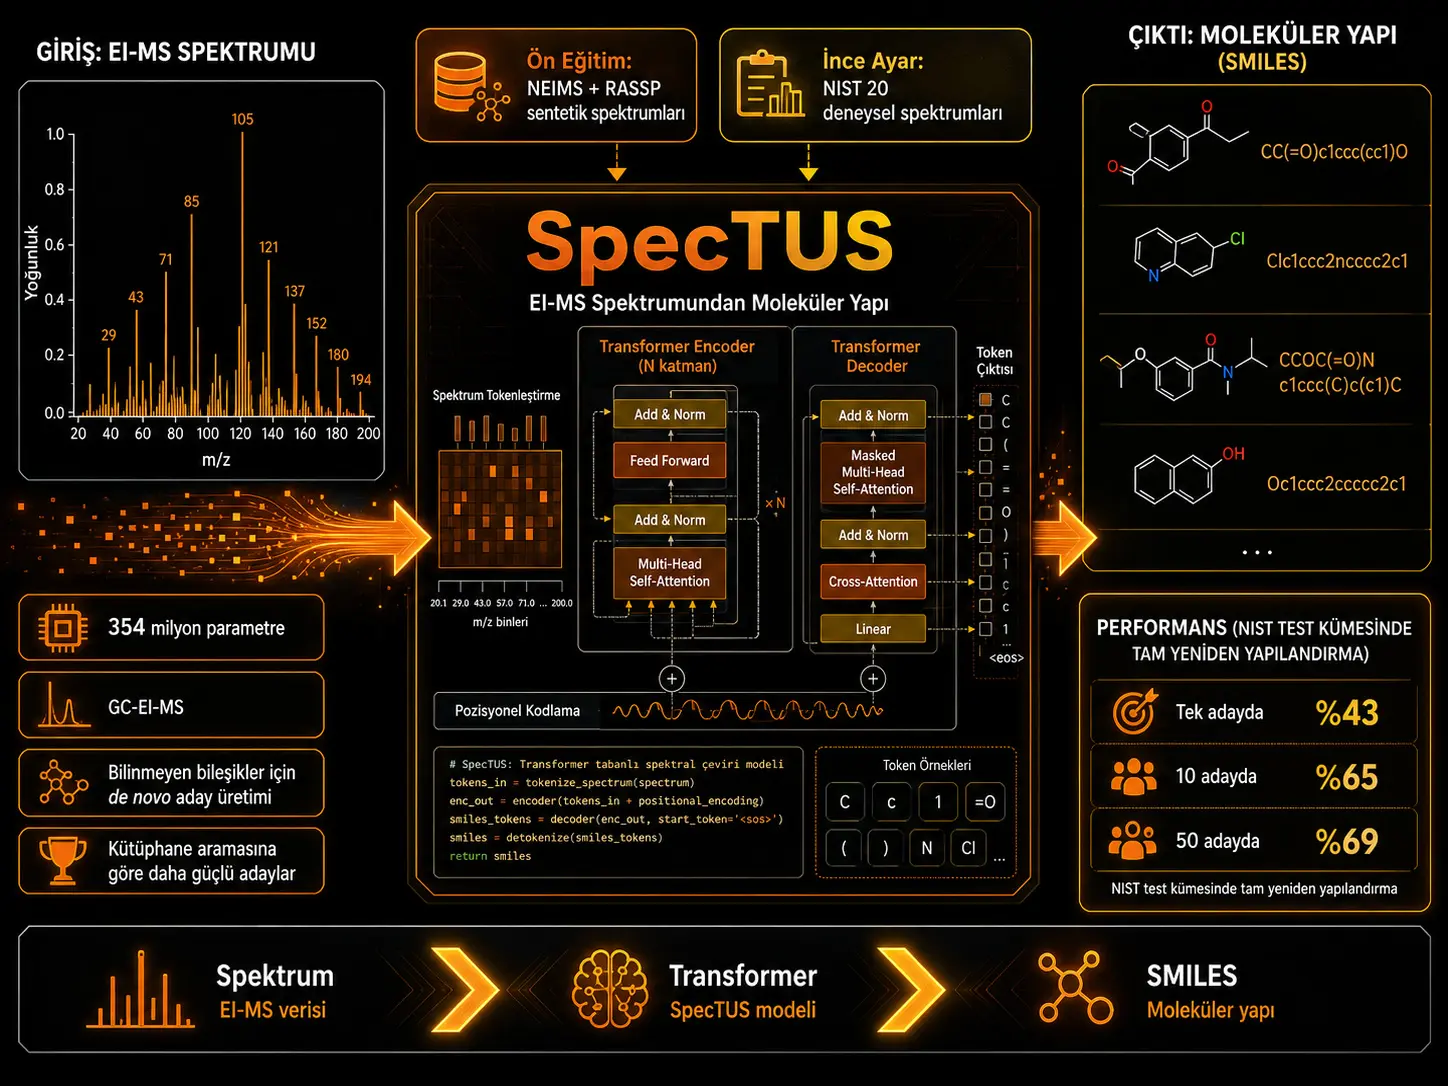
Ushbu tadqiqot gaz xromatografiyasi–elektron ionlanishli massa-spektrometriyasi (GC-EI-MS) orqali olingan past aniqlikdagi massa spektridan molekulyar tuzilmani bevosita yaratishga qaratilgan SpecTUS nomli chuqur o‘rganish modelini taqdim etadi. An’anaviy EI-MS identifikatsiya usullari odatda o‘lchangan spektrni mos yozuvlar spektrlari kutubxonasida qidiradi. SpecTUS esa so‘ralayotgan birikmaning spektral kutubxonada mavjud bo‘lishini talab qilmasdan, spektrdagi massa/zaryad va intensivlik ma’lumotlarini qayta ishlab, molekulani SMILES ketma-ketligi ko‘rinishida yaratishga harakat qiladi.
SpecTUS 354 million o‘rgatiladigan parametrga ega encoder–decoder Transformer arxitekturasidir. Model avval NEIMS va RASSP tomonidan yaratilgan katta sintetik EI-MS ma’lumot to‘plamlarida oldindan o‘qitilgan, so‘ng NIST 20 eksperimental GC-EI-MS spektrlari bilan nozik sozlangan. Model kirishini spektrdagi m/z va nisbiy intensivlik juftliklari; chiqishini esa belgi-beligiga yaratiladigan molekulyar SMILES ifodasi tashkil etadi.
NIST 20 dan ajratilgan 28.267 spektrli test to‘plamida SpecTUS faqat bitta tuzilma taklif qilganida birikmalarning %43'ini aynan qayta yaratgan. O‘n nomzod yaratilganda to‘liq qayta yaratish darajasi %65'ga, 50 nomzodli ssenariyda %69'ga ko‘tarilgan. Bitta nomzodli ssenariyda SpecTUS taklifi Morgan fingerprint Tanimoto o‘xshashligi va aniq moslik nazoratiga asoslangan taqqoslashda NIST test namunalarining %76'sida gibrid ma’lumotlar bazasi qidiruvi natijasidan yaxshiroq bo‘lgan; o‘n nomzodli taqqoslashda bu ulush %84'dir.
Natija barcha ma’lumot manbalarida bir xil emas. Qat’iyroq kuratsiya qilingan NIST va SWGDRUG spektrlarida natijalar yuqoriroq bo‘lsa, Cayman va MONA kabi heterogenroq ma’lumot to‘plamlarida aniqlik kamaygan. Bundan tashqari, o‘qitish to‘plamidagi tuzilmalarga tobora kamroq o‘xshaydigan molekulalar tanlanganda natija keskin pasayadi. Shu sababli tadqiqot SpecTUS o‘qitish davomida ko‘rmagan birikmalarga ma’lum darajada umumlashtira olishini ko‘rsatsa-da, mutlaqo yangi kimyoviy tuzilma fazosi yechilganini ko‘rsatmaydi.
Türkiye nuqtai nazaridan ushbu ish sud kimyosi, atrof-muhit tahlili, dori/giyohvand modda tahlili va kichik molekulalarni tavsiflashda GC-EI-MS ishlatadigan tadqiqot laboratoriyalari uchun metodologik jihatdan e’tiborlidir. Biroq model Türkiye'dagi laboratoriya asboblari, namuna tayyorlash jarayonlari yoki mahalliy analit to‘plamlarida alohida tasdiqlanmagan. Ayniqsa spektr sifati va o‘lchash protokoli natijaga ta’sir qilgani sababli mahalliy qo‘llash uchun mustaqil tasdiqlash va mutaxassis kimyogar bahosi talab etiladi.
Nega spektral kutubxona qidiruvidan tashqari usul kerak?
GC-MS tahlilida birikmalar avval gaz xromatografiyasi bilan ajratiladi. Keyin neytral molekulalar ionlanadi va massa-spektrometr hosil bo‘lgan ionlarning massa/zaryad nisbatlarini (m/z) hamda nisbiy ko‘pligini o‘lchaydi. Natija har bir birikmaga tegishli spektral cho‘qqilar ketma-ketligidir.
Tadqiqotning markazida elektron ionlanish (EI) turadi. GC-EI-MS'da o‘nlab yillar davomida keng qo‘llanayotgan taxminan 70 eV elektron energiyasi turli spektral kutubxonalar orasida nisbatan barqaror parchalanish naqshlarini hosil qilishi mumkin. Shunga qaramay, bir xil birikmaning spektrida asbob va o‘lchash sharoitlariga bog‘liq farqlar bo‘lishi mumkin.
An’anaviy yondashuvda so‘rov spektri o‘lchangan mos yozuvlar spektrlari bilan taqqoslanadi. Tadqiqot ikki asosiy usuldan foydalanadi:
- Simple Similarity Search (SSS): o‘xshash m/z qiymatlaridagi spektral cho‘qqilarni moslashtiradi.
- Hybrid Similarity Search (HSS): fragment ionlari bilan birga neytral yo‘qotishlardan ham foydalanadi va so‘rov hamda mos yozuv molekulasi orasidagi molekulyar massa farqini hisobga oladi.
HSS, ayniqsa so‘ralgan birikma kutubxonada bo‘lmasa, SSS'dan foydaliroq bo‘lishi mumkin. Biroq usulning muhim cheklovi so‘rov birikmasining to‘g‘ri molekulyar massa ma’lumotidan foydalanishidir; bu ma’lumot past aniqlikdagi EI-MS spektrlaridan har doim ham ishonchli olinmasligi mumkin.
Yana asosiyroq cheklov spektral kutubxonaning qamrovidir. Birikma mos yozuvlar kutubxonasida umuman bo‘lmasa, standart qidiruv to‘g‘ri molekulaning o‘zini qaytara olmaydi; faqat topilgan nomzodlar orasidagi eng yaqin tuzilmani taklif qilishi mumkin. SpecTUS bu cheklovni spektrdan bevosita yangi molekulyar tuzilma yaratishga urinish orqali yengishni maqsad qiladi.
SpecTUS'ning asosiy g‘oyasi nima?
SpecTUS muammoni bir turdagi “tarjima” muammosi sifatida ko‘radi. Tabiiy til modeli bir tildagi ketma-ketlikni boshqa tildagi ketma-ketlikka aylantirgani kabi, model EI-MS spektrini molekulyar tuzilma ifodasiga tarjima qiladi:
EI-MS spektri → Transformer → SMILES molekula ketma-ketligi
Kirish tomonida har bir spektral cho‘qqi ikki ma’lumotni tashiydi: eng yaqin butun songa yaxlitlangan m/z qiymati va nisbiy intensivlik. Chiqishda esa model molekulyar tuzilmani SMILES belgilarini avtoregressiv tarzda, ya’ni oldin yaratgan belgilaridan foydalanib ketma-ket hosil qiladi.
Model arxitekturasi qanchalik katta?
SpecTUS BART yondashuviga asoslangan 354 million o‘rgatiladigan parametrli encoder–decoder Transformer'dir. Manbada arxitekturaning asosiy o‘lchamlari quyidagicha berilgan:
| Arxitektura xususiyati | SpecTUS qiymati |
|---|---|
| Encoder bloklari soni | 12 |
| Decoder bloklari soni | 12 |
| Attention head soni | 16 |
| Embedding o‘lchami | 1024 |
| Feed-forward yashirin qatlam o‘lchami | 4096 |
| Jami o‘rgatiladigan parametr | 354 million |
Modelning kirish chegaralari ko‘pi bilan 300 spektral cho‘qqi, ko‘pi bilan m/z = 500 va ko‘pi bilan 100 belgili SMILES sifatida belgilangan. Bu filtrlar NIST ma’lumotlarining taxminan %3'ini chiqarib tashlashga olib kelgan.
Spektr model uchun qanday kodlanadi?
Tadqiqotda m/z qiymatlari eng yaqin butun songa yaxlitlanadi. Nisbiy intensivliklar esa juda yuqori aniqlikdagi sonli kirish sifatida bevosita ishlatilish o‘rniga logarifmik oraliqlarga ajratiladi. Yakuniy modelda intensivlik qiymatlari asosi 1,28 bo‘lgan logarifmik o‘zgartirish bilan 30 bin ichida ifodalanadi.
Model uchta o‘rgatiladigan embedding to‘plamidan foydalanadi:
- m/z qiymatlari uchun embedding,
- intensivlik binlari uchun embedding,
- SMILES belgilari uchun embedding.
Encoder'ga yuborilgan har bir spektral cho‘qqining ifodasi m/z embedding'i bilan intensivlik embedding'ining yig‘indisidan iborat. Decoder tomonida esa har bir qadam bitta SMILES belgisini ifodalaydi.
Nega sintetik ma’lumotlar ishlatildi?
Haqiqiy eksperimental GC-EI-MS spektrlari soni potensial molekulyar tuzilma fazosiga nisbatan cheklangan. Shu sababli tadqiqotchilar modelni avval ancha keng sintetik kimyoviy fazoda o‘qitib, keyin haqiqiy eksperimental spektrlarga moslashtirgan.
ZINC20'dan dastlab taxminan 1,8 milliard SMILES ketma-ketligi to‘plangan. Har bir ma’lumot yig‘ish bosqichida 100 belgidan qisqa 30 million buzilmagan SMILES tasodifiy tanlangan, so‘ng tuzilmalar kanoniklashtirilgan, takror yozuvlar olib tashlangan va stereokimyo ma’lumoti chiqarilgan. NIST 20'da mavjud birikmalar ma’lumot sizib chiqishini oldini olish uchun sintetik oldindan o‘qitish birikmalaridan chiqarib tashlangan.
RASSP qayta ishlay oladigan element va sub-formula cheklovlaridan so‘ng ikki yig‘ish bosqichida taxminan 4,7 million va 4,8 million birikma qolgan. Har bir birikma uchun ham NEIMS, ham RASSP modeli bilan spektr yaratilgani sababli sintetik ma’lumot to‘plamlari jami taxminan 9,4 million va 9,6 million spektrni o‘z ichiga oladi. Bu ma’lumotlar o‘qitish/validatsiya/test uchun 0,90/0,05/0,05 nisbatida ajratilgan.
Oldindan o‘qitish qancha davom etdi?
Yakuniy SpecTUS oldindan o‘qitilishi NEIMS va RASSP manbalarining 1:1 muvozanatli aralashmasida bajarilgan. Manba yakuniy oldindan o‘qitish bosqichida 17,2 million o‘qitish spektri taxminan uch marta qayta ishlanganini bildiradi.
| Oldindan o‘qitish xususiyati | Qiymat |
|---|---|
| Batch o‘lchami | 128 |
| Yangilash qadami | 448.000 |
| Uskuna | 1 × NVIDIA H100 GPU |
| Jami vaqt | 58 soat |
Oldindan o‘qitish oxirida to‘liq tuzilmani qayta yaratish darajasi RASSP hosil qilgan spektrlarda %38, NEIMS spektrlarida %29 va haqiqiy NIST spektrlarida atigi %3 bo‘lgan. Shunga qaramay, yaratilgan SMILES'larning %96'i yaroqli kanonik molekula ekani bildirilgan. Tadqiqotchilar buni oldindan o‘qitish molekulyar tuzilma qoidalari va atom massasi–m/z munosabatini o‘rganish uchun asos yaratgani sifatida talqin qiladi.
Haqiqiy NIST spektrlari bilan nozik sozlash qanday bajarildi?
NIST 20 GC-EI-MS kutubxonasida buzilgan yoki annotatsiyasiz spektrlar tozalangan, stereokimyo ma’lumotlari chiqarilgan, SMILES ifodalari kanoniklashtirilgan va deyteriy saqlovchi birikmalar olib tashlangan. Modelning m/z, cho‘qqilar soni va SMILES uzunligi bo‘yicha chegaralari ham qo‘llangan.
Batafsil metodika bo‘limida yakuniy NIST ajratilishi quyidagicha berilgan:
| NIST 20 quyi to‘plami | Spektrlar soni |
|---|---|
| O‘qitish | 224.737 |
| Validatsiya | 28.177 |
| Test | 28.267 |
Takrorlangan birikmalarning turli split'larda tarqalishiga yo‘l qo‘yilmagan. Shu tariqa bir xil molekulaning o‘qitish va test to‘plamlarida bo‘lishining oldini olishga harakat qilingan.
Manba ichidagi son bo‘yicha eslatma: Maqolaning boshqa bo‘limlarida NIST o‘qitish/nozik sozlash hajmi 232.025 va 232.035 deb ham yozilgan. Batafsil ma’lumot to‘plami bo‘limidagi 224.737 o‘qitish spektri qiymati bu ikki ifodaga mos kelmaydi. Shu sababli bu uch son bitta “tuzatilgan” qiymatga aylantirilmasligi kerak.
Nozik sozlash qancha davom etdi?
Model NIST o‘qitish to‘plamida 296.000 yangilash qadami davomida o‘qitilgan va har bir spektr taxminan 80 marta qayta ishlangani ko‘rsatilgan. Nozik sozlash nazorat baholashlarini ham qo‘shganda yana bitta NVIDIA H100 GPU'da taxminan 28 soat davom etgan.
Qiziq jihati shundaki, NIST nozik sozlashi vaqtida modelning sintetik spektrlarni aynan qayta yaratish qobiliyati tez pasaygan, eksperimental NIST validatsiya natijasi esa keskin oshgan. Tadqiqot buni modelning sintetik ma’lumot taqsimotidan haqiqiy eksperimental taqsimotga moslashishi natijasi sifatida ko‘rsatadi.
Qaysi dizayn tanlovlari eksperimental ravishda taqqoslandi?
Tadqiqotchilar faqat yakuniy modelni hisobot qilish o‘rniga beshta alohida rivojlantirish tajribasini o‘tkazgan.
1. Intensivlikni binlash
Chiziqli va logarifmik intensivlikni ifodalash usullari taqqoslangan. Juda qo‘pol ifoda, ayniqsa past intensivlikli cho‘qqilarda ma’lumot yo‘qotilishiga olib kelgan. 30 binli logarifmik yondashuv to‘rt o‘nlikli chiziqli kodlashga nisbatan validatsiya Acc1 qiymatini taxminan 0,9 foiz punktga oshirgan, shu bilan birga taxminan 10 million kamroq o‘rgatiladigan parametr talab qilgan va yakuniy model uchun tanlangan.
2. SMILES, SELFIES va tokenizatsiya
SMILES asosidagi modellar SELFIES asosidagi modeldan validatsiya Acc1 bo‘yicha 1,7–5,8 foiz punkt yuqori natija bergan. Bundan tashqari, tabiiy til modellarida ko‘pincha foydali bo‘ladigan kattaroq Byte Pair Encoding lug‘atlari bu yerda foyda bermagan. Eng sodda belgi darajasidagi SMILES kodlash boshqa BPE variantlaridan taxminan 3,5–4 foiz punkt yaxshi natija bergan.
3. Sintetik oldindan o‘qitish aralashmasi
Sintetik oldindan o‘qitilmagan model RASSP, NEIMS va ularning aralashmalari bilan taqqoslangan. Sintetik oldindan o‘qitilgan modellar faqat haqiqiy ma’lumotda nozik sozlangan modelga nisbatan validatsiya Acc1'da taxminan 7–10 foiz punkt ustunlik bergan. NEIMS va RASSP'ning 1:1 aralashmasi eng yaxshi natijani bergan.
4. Spektr manbasi yorlig‘i
<rassp>, <neims> va <nist> kabi maxsus manba tokenlaridan foydalanish yakuniy natijaga sezilarli hissa qo‘shmagan. Bitta umumiy manba tokenidan foydalangan variant Acc1'da taxminan 0,2 foiz punkt yuqori natija bergan. Shunga qaramay, tadqiqotchilar kelajakda maxsus ma’lumot to‘plamlarida nozik sozlash uchun manba tokeni mexanizmini yakuniy modelda saqlab qolgan.
5. O‘qitish vaqti va ma’lumot miqdorini masshtablash
Oldindan o‘qitish vaqti, nozik sozlash vaqti va sintetik ma’lumot hajmi alohida oshirilganda natija yaxshilangan. Yakuniy to‘liq masshtabli `8.6M_448k_296k` konfiguratsiyasi boshlang‘ich `4.2M_112k_74k` modeliga nisbatan Acc1 qiymatini 5,4 foiz punkt oshirgan.
Tadqiqot chiqishni qanday baholaydi?
Acck — model yaratgan dastlabki k nomzod ichida haqiqiy molekulaning aynan mavjud bo‘lish ulushi. Bu metrika shunchaki o‘xshash tuzilmani emas, aniq molekulyar moslikni baholaydi.
Simk — k nomzod ichida haqiqiy molekulaga eng o‘xshash tuzilmaning Morgan molekulyar fingerprint'i bo‘yicha Tanimoto o‘xshashligini o‘lchaydi.
Tadqiqot SpecTUS bilan boshqa usulni to‘g‘ridan-to‘g‘ri taqqoslash uchun win rate va at-least-as-good ko‘rsatkichlaridan ham foydalanadi. Tanimoto fingerprint'lari turli molekulalarda ba’zan 1,0 o‘xshashlik berishi mumkinligi sababli reyting funksiyasiga aniq tuzilma mosligi nazorati ham qo‘shilgan.
Nega BDC deb nomlangan sun’iy taqqoslash ishlatiladi?
Best Database Candidate (BDC) amaliyotda erishib bo‘lmaydigan nazariy yuqori chegaradir. BDC so‘rov molekulasining haqiqiy tuzilmasini allaqachon bilamiz deb faraz qilib, mos yozuvlar kutubxonasidagi tuzilmalar orasidan Morgan fingerprint'i bo‘yicha unga eng yaqinini tanlaydi.
Shu sababli BDC amaliy identifikatsiya usuli emas. Tadqiqotdagi vazifasi “ma’lumotlar bazasida bundan yaxshiroq tuzilma allaqachon bo‘lmasa, qidiruv algoritmini yaxshilashning chegarasi nima?” savoliga yuqori chegara berishdir.
1-shakl nimani tushuntiradi?
Tadqiqot metodik sxemasi SpecTUS'ning ikki bosqichli o‘qitilishi va yakuniy inferensiyasini birgalikda ko‘rsatadi. Oldindan o‘qitish tomonida ZINC'dan kelgan SMILES tuzilmalari NEIMS/RASSP orqali sintetik spektrlarga aylantirilib SpecTUS'ga o‘rgatiladi. Nozik sozlash bosqichida eksperimental NIST spektrlari va haqiqiy SMILES yorliqlari ishlatiladi. Inferensiyada esa oqim teskari ishlaydi: tahlil qilinayotgan EI-MS spektri to‘g‘ridan-to‘g‘ri SpecTUS'ga kiradi va model tartiblangan bir yoki bir nechta SMILES nomzodini yaratadi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- SpecTUS test birikmalari o‘qitish ma’lumot to‘plamlaridan ajratilganda ham past aniqlikdagi GC-EI-MS spektrlaridan yangi molekulyar tuzilma nomzodlarini yarata olgan.
- NIST test to‘plamida bitta nomzodning to‘liq tuzilma aniqligi %43, 10 nomzod aniqligi %65 va 50 nomzod aniqligi %69.
- NIST'da bitta SpecTUS nomzodi HSS'ning bitta nomzodidan namunalarning %76'sida yaxshiroq strukturaviy nomzod yaratgan.
- NIST va SWGDRUG kabi yaxshiroq kuratsiya qilingan spektrlarda model Cayman va MONA'ga qaraganda yuqoriroq natija ko‘rsatgan.
- Sintetik ma’lumotda oldindan o‘qitish faqat eksperimental NIST ma’lumotlari bilan o‘qitishdan yuqoriroq validatsiya natijasini bergan.
- Bir nechta sintetik spektr generatorini birgalikda ishlatish bitta manbaga nisbatan ustunlik bergan.
Tadqiqot qo‘llab-quvvatlamaydigan yoki isbotlamaydigan natijalar
- SpecTUS har bir noma’lum molekulani ishonchli aniqlay oladigan universal kimyoviy identifikatsiya tizimi emas.
- Modelning birinchi o‘rindagi chiqishi mustaqil tasdiqlashsiz aniq identifikatsiya dalili sifatida baholanmasligi kerak.
- Model mutlaqo yangi va o‘qitish kimyosidan juda uzoq tuzilmalarda yuqori aniqlikni kafolatlamaydi.
- Tadqiqot model laboratoriya mutaxassisi o‘rnini bosa olishini ko‘rsatmaydi.
- Model chiqishlari parchalanish daraxti yoki pik-annotatsiya mexanizmi bilan tushuntirilishi ko‘rsatilmagan.
- Cayman va MONA'dagi natija pasayishi barcha laboratoriya va asbob sharoitlarida bir xil aniqlikni kutib bo‘lmasligini ko‘rsatadi.
Tadqiqotning Usuli va Natijalari
Baholash ma’lumot to‘plamlari
Model faqat NIST test split'ida emas, mustaqil manbalardan olingan SWGDRUG, Cayman va MONA EI-MS ma’lumotlarida ham baholangan. O‘qitish ma’lumotlari bilan ustma-ust keladigan birikmalar va model chegaralaridan tashqari misollar chiqarilgach, ishlatilgan spektrlar soni quyidagicha:
| Test ma’lumot to‘plami | Asl spektrlar soni | Filtrdan keyin ishlatilgan spektrlar soni |
|---|---|---|
| NIST test | 29.218 | 28.267 |
| SWGDRUG | 3.589 | 1.640 |
| Cayman | 2.262 | 469 |
| MONA | 18.914 | 5.015 |
Filtrlash NIST o‘qitish to‘plami bilan ustma-ust kelishlarni olib tashlash, deyteriy saqlovchi tuzilmalarni chiqarish, m/z > 500 bo‘lgan misollarni, 300'dan ortiq spektral cho‘qqili spektrlarni va 100 belgidan uzun SMILES ketma-ketliklarini chiqarishni qamrab oladi.
NIST'da aniq molekulani qayta qurish
NIST'dagi 28.267 test spektri tadqiqotning eng keng va yaxshi nazorat qilingan baholashidir. Nomzodlar soni oshganda haqiqiy molekulaning takliflar ro‘yxatida topilish ehtimoli ortadi.
Bir nomzoddan 10 nomzodga o‘tish 22 foiz punkt qo‘shimcha aniq moslik beradi. Bunga qarshi, 10 nomzoddan 50 nomzodga chiqish faqat 4 foiz punkt qo‘shimcha foyda beradi. Bu natija nomzodlar sonini cheksiz oshirish mutaxassis baholash yuklamasi bilan birga ko‘rib chiqilishi kerakligini ko‘rsatadi.
Nega ko‘p nomzodli natijalarda mutaxassis hali ham zarur?
SpecTUS har bir nomzod uchun o‘z tartiblash ehtimolini hosil qiladi; biroq tadqiqotchilar bu tartiblash mutaxassis bahosini almashtiradigan darajada ishonchli emasligini aniqlagan. Hatto 10 nomzod yaratiladigan ssenariydagi modelning birinchi o‘rindagi nomzodi o‘rtacha hisobda faqat bitta nomzod yaratish ssenariysidagi nomzoddan biroz pastroq aniqlikka ega.
Shu sababli tadqiqot uch foydalanish ssenariysini belgilaydi:
- 1 nomzod: qo‘lda ko‘rib chiqish yuki eng past, katta hajmli tahlillar uchun mos; ammo aniqlik pastroq.
- 10 nomzod: aniqlik va mutaxassis ko‘rib chiqish yuki o‘rtasida muvozanatliroq ssenariy.
- 50 nomzod: model salohiyatini oshiradi, biroq qo‘lda ko‘rib chiqish yukini jiddiy oshiradi.
Strukturaviy o‘xshashlik bo‘yicha HSS bilan taqqoslash
NIST testida SpecTUS'ning bitta nomzod uchun o‘rtacha Morgan/Tanimoto o‘xshashligi 0,67. HSS'ning 50 nomzodli natijasida ham bu qiymat 0,62 deb hisobot qilingan. SWGDRUG'da SpecTUS bitta nomzod o‘rtachasi 0,69, HSS50 esa 0,61.
| Ma’lumot to‘plami | SpecTUS 1 nomzod Sim1 | HSS 50 nomzod Sim50 | BDC nazariy yuqori chegarasi | SpecTUS 10 nomzod Sim10 |
|---|---|---|---|---|
| NIST test | 0,67 | 0,62 | 0,72 | 0,81 |
| SWGDRUG | 0,69 | 0,61 | 0,69 | 0,82 |
O‘n nomzodli SpecTUS bu ikki ma’lumot to‘plamida mos yozuvlar kutubxonasidagi mumkin bo‘lgan eng yaqin molekulani ifodalovchi BDC qiymatidan ham yuqori o‘rtacha o‘xshashlik bera oladi. Buning sababi SpecTUS faqat mavjud kutubxona tuzilmalari orasidan tanlashga majbur emas, balki yangi tuzilmalar yaratishi mumkin.
HSS'ga nisbatan to‘g‘ridan-to‘g‘ri yutish darajasi
NIST testida bitta nomzodli SpecTUS shu sharoitdagi HSS nomzodidan test misollarining %76'sida aniq yaxshiroq tuzilma taklif qilgan. O‘n nomzodli holatda bu ulush %84'ga yetadi. Manbadagi barcha nomzod ssenariylari birgalikda baholanganda NIST'dagi SpecTUS–HSS yutish darajasi %76–86 oralig‘ida.
SWGDRUG uchun diapazon %72–85, Cayman uchun %63–74, MONA uchun %62–65 deb berilgan. Spektr kuratsiyasi kamaygani sari SpecTUS ustunligining ham torayishi kirish ma’lumotlari sifatiga sezgirlikni aniq ko‘rsatadi.
Ma’lumotlar bazasining nazariy eng yaxshi nomzodidan ham oshish mumkinmi?
BDC — so‘rovning haqiqiy tuzilmasini bilamiz deb faraz qiladigan nazariy ma’lumotlar bazasi yuqori chegarasi. Shunga qaramay, NIST'da bitta SpecTUS nomzodi BDC'dan holatlarning %47'sida, SWGDRUG'da %45'ida yaxshiroq natija bergan.
O‘n nomzod yaratilganda SpecTUS ham NIST, ham SWGDRUG'da misollarning %70'ida BDC'dan yaxshiroq; Cayman'da esa %56'ida yaxshiroq nomzod yaratgan. Bu natija de novo generatsiyaning asosiy ustunligini ko‘rsatadi: to‘g‘ri yoki yaqinroq molekulyar tuzilma mos yozuvlar kutubxonasida bo‘lmasa ham model yangi nomzod yaratishi mumkin.
3-shaklning asosiy xabari
3-shakl SSS, HSS va SpecTUS'ning NIST, SWGDRUG, Cayman va MONA'dagi o‘rtacha strukturaviy o‘xshashligini 1, 10 va 50 nomzod ssenariylarida birgalikda ko‘rsatadi. SpecTUS aniqlik qiymatlari qo‘shimcha ravishda qora belgilar bilan berilgan.
NIST va SWGDRUG ustunlarida SpecTUS ustunligi eng yaqqol. Cayman va ayniqsa MONA'ga o‘tilganda barcha usullarning strukturaviy o‘xshashligi pasayadi va SpecTUS bilan HSS orasidagi farq qisqaradi. Tadqiqotchilar buni spektrlarni ishlab chiqarish va kuratsiya qilish sifatidagi farqlar bilan bog‘laydi.
4-shakl nimani ko‘rsatadi?
4-shaklning A paneli SpecTUS'ni HSS bilan, B paneli esa nazariy BDC yuqori chegarasi bilan bevosita taqqoslaydi. Qizil ustunlar SpecTUS aniq ustun bo‘lgan misollarni; och rangli qo‘shimcha qism esa tengliklar ham kiritilgan “at-least-as-good” ulushini ko‘rsatadi.
NIST va SWGDRUG'da nomzodlar soni oshgani sari SpecTUS'ning HSS'ga nisbatan ustunligi aniqroq bo‘ladi, MONA'da esa qo‘shimcha nomzodlardan olinadigan foyda cheklanganroq. Bu ko‘rinish ko‘proq nomzod yaratishning o‘zi yomon spektral ma’lumotni qoplay olmasligini ko‘rsatadi.
Model haqiqatan ham mutlaqo yangi kimyoda umumlashadimi?
Tadqiqotning eng muhim chegara sinovlaridan biri test molekulalarining o‘qitish to‘plamidagi tuzilmalarga strukturaviy o‘xshashligini tizimli ravishda kamaytirishdir. Tadqiqotchilar maximum common edge subgraph (MCES) masofasidan foydalanib NIST test to‘plamini tobora boshqacha molekulalar bilan cheklagan.
Masofa chegarasi T = 10 bo‘lganda boshlang‘ich NIST test to‘plamining atigi %1,7'i, ya’ni 469 tuzilma qolgan. Eng qiyin sharoitda SpecTUS 10 nomzod ichida faqat 19 molekulani to‘liq qayta yarata olgan, o‘rtacha strukturaviy o‘xshashlik esa 0,38 darajasiga tushgan.
Bu natija taxminan %4'lik Acc10'ga teng va modelning funksional chegarasini aniq ko‘rsatadi. SpecTUS avval ko‘rmagan molekulalarni bashorat qila olsa ham, o‘qitish vaqtida o‘rgangan kimyoviy naqshlardan mutlaqo uzoq tuzilmalar uchun yuqori umumlashishni ko‘rsatmaydi.
Tipik tuzilma bashorat xatolari qanday?
5-shaklda NIST test to‘plamidan 200 tasodifiy so‘rovning SpecTUS10 va HSS10 o‘xshashliklari taqqoslangan va besh misol batafsil ko‘rsatilgan. Tadqiqotchilar uch tipik xato shaklini aniqlaydi:
- takrorlanuvchi uglerod zanjirlarini keragidan uzun yoki qisqa yaratish,
- to‘g‘ri funksional guruhni noto‘g‘ri aromatik halqa atomiga ulash,
- katta molekulyar sub-tuzilmalarni o‘zini to‘g‘ri yechgan holda ularni bir-biriga noto‘g‘ri bog‘lash.
5-shakl Tanimoto/Morgan mezonining o‘z cheklovini ham ko‘rsatadi. Uzun va takroriy zanjirlarda ikki xil molekula ba’zan xuddi bir xil fingerprint'ga ega bo‘lgandek Tanimoto = 1 natija berishi mumkin. Shu sababli tadqiqot aniq tuzilma mosligini alohida tekshiradi.
Inferensiya tezligi
Model uch xil uskuna sinfida sinovdan o‘tkazilgan. Quyidagi qiymatlar bitta spektr uchun 1, 10 yoki 50 tuzilma nomzodini yaratish vaqtlaridir:
| Uskuna | 1 nomzod | 10 nomzod | 50 nomzod |
|---|---|---|---|
| NVIDIA H100 80 GB | 0,2 s | 0,4 s | 1,9 s |
| NVIDIA Quadro RTX 5000 16 GB | 0,5 s | 1,1 s | 7,6 s |
| Xeon Gold 6130 CPU + 8 GB RAM | 8 s | 36 s | 450 s |
Bu vaqtlar model laboratoriya ish oqimlarida foydalanish mumkinligini ko‘rsatadi, biroq ular uskunaga xos. Ayniqsa CPU'da 50 nomzod yaratish 7,5 daqiqagacha yetadi; shuning uchun “tez” ifodasi nomzodlar soni va uskuna kontekstidan mustaqil ishlatilmasligi kerak.
Tushuntiriluvchanlik cheklovi
SpecTUS nima sababdan ma’lum bir molekulani yaratganini kimyoviy parchalanish bosqichlari orqali tushuntirmaydi. Modelning oraliq chiqishida pik annotatsiyalari, parchalanish daraxtlari yoki taklif qilingan nomzodlarga tegishli mos yozuv spektrlari mavjud emas.
Bu holat noto‘g‘ri nomzodni mutaxassis tomonidan bosqichma-bosqich tuzatishni qiyinlashtiradi. Model kuchli nomzod generatori bo‘lsa ham, bashoratning kimyoviy asosini o‘zi tushuntiradigan vosita emas.
Natijalarning ilmiy ma’nosi
Tadqiqotning asosiy yangiligi past aniqlikdagi GC-EI-MS'da faqat spektral kutubxonani qidirish o‘rniga spektrni bevosita molekulyar tuzilmaga tarjima qiluvchi katta Transformer modelini qo‘llashdir. Test birikmalarining o‘qitish birikmalaridan ajratilishi SpecTUS faqat yodlash qilmaganini va ma’lum umumlashtirish qobiliyatini rivojlantirganini qo‘llab-quvvatlaydi.
Biroq strukturaviy jihatdan juda uzoq test birikmalaridagi keskin natija pasayishi modelning “noma’lum” tushunchasi chegaralarini ko‘rsatadi. Model o‘qitishda aynan ko‘rmagan tuzilmalarni yaratishi mumkin; ammo buni katta darajada avval o‘rgangan kimyoviy sub-naqshlarni yangi usullarda birlashtirish orqali bajaradi.
Manba va Usul Haqida Izoh
To‘liq asl tadqiqot nomi: SpecTUS: Spectral Translator for Unknown Structures Annotation from EI-MS Spectra
Mualliflar va tartibi: Adam Hájek; Michal Starý; Elliott Price; Filip Jozefov; Helge Hecht; Aleš Křenek.
Teng hissa / teng birinchi mualliflik: Ko‘rib chiqilgan tadqiqotda teng hissa bayonoti yo‘q.
Mas’ul muallif: Aleš Křenek.
Muassasalar: Adam Hájek va Aleš Křenek — Institute of Computer Science, Masaryk University, Brno, Czech Republic. Michal Starý — School of Computation, Information and Technology, Technical University Munich, Garching bei München, Germany. Elliott Price va Helge Hecht — RECETOX, Masaryk University, Brno, Czech Republic. Filip Jozefov — Faculty of Informatics, Masaryk University, Brno, Czech Republic.
Manba turi / taqriz holati: Taqrizdan o‘tgan tadqiqot maqolasi.
Jurnal: Analytical Chemistry.
Nashriyot: American Chemical Society.
Bibliografik ma’lumot: Anal. Chem. 2026, 98, 21670–21682.
DOI: 10.1021/acs.analchem.6c02423.
Yuborish / qayta ko‘rib chiqish / qabul / nashr: 14 Aprel 2026 / 29 Iyun 2026 / 30 Iyun 2026 / 13 Iyul 2026.
Rasmiy havola:https://doi.org/10.1021/acs.analchem.6c02423
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Ma’lumot va kod mavjudligi: Tadqiqotning manba kodi, ma’lumot tayyorlash va baholash ish oqimlari GitHub orqali ulashilgan. Sintetik ma’lumot to‘plamlari va oldindan o‘qitilgan model Hugging Face'da nashr qilingan. Biroq NIST'ning tijoriy litsenziya shartlari sababli NIST 20'da nozik sozlangan yakuniy model erkin tarqatilmaydi. NIST litsenziyasiga ega foydalanuvchilar e’lon qilingan split va skriptlar bilan nozik sozlashni takrorlashi mumkinligi aytilgan.
Manfaatlar to‘qnashuvi: Mualliflar raqobatdosh moliyaviy manfaatlar yo‘qligini bildirgan.
Moliyalashtirish: Tadqiqot Chexiya Ta’lim, Yoshlar va Sport vazirligining e-Infrastruktura CZ (LM2023054) va RECETOX Research Infrastructure (LM2023069) loyihalari hamda Yevropa Ittifoqi Horizon 2020 dasturining CETOCOEN Excellence loyihasi (857560) tomonidan qo‘llab-quvvatlangan. Hisoblash resurslari e-INFRA CZ loyihasi No. 90254 orqali taqdim etilgan.
Muallif hissalari: Adam Hájek SpecTUS'ni amalga oshirgan, tajriba dizaynida qatnashgan, tajribalarni o‘tkazgan va maqola yozilishiga hissa qo‘shgan. Michal Starý model va tajriba dizayniga hissa qo‘shgan. Elliott Price ma’lumot tayyorlash, tajriba dizayni va baholash bo‘yicha yo‘nalish bergan. Filip Jozefov ma’lumot tayyorlash/split jarayonlari va sintetik ma’lumot yaratishni amalga oshirgan. Helge Hecht baholashga hissa qo‘shgan. Aleš Křenek tadqiqotni boshqargan, RASSP o‘zgarishlari va o‘qitilishini amalga oshirgan, sintetik ma’lumot yaratish, tajriba dizayni va maqola yozilishiga hissa qo‘shgan hamda yuborish/qayta ko‘rib chiqish jarayonlarini boshqargan.
Manba ichidagi ma’lumot to‘plami nomuvofiqligi: Batafsil metodika bo‘limida NIST 20 o‘qitish split'i 224.737 spektr sifatida berilgan bo‘lsa, kirish bo‘limida 232.025 va baseline bo‘limida 232.035 spektr degan ifodalar mavjud. Bu sonlar jim ravishda bitta qiymatga birlashtirilmagan. Ushbu Verianla matnidagi o‘qitish/validatsiya/test jadvalida batafsil “Fine-Tuning Data Set” bo‘limining 224.737 / 28.177 / 28.267 ajratilishi asos qilib olingan.
Metodik cheklovlar: SpecTUS past aniqlikdagi GC-EI-MS uchun ishlab chiqilgan va kirish spektri sifatiga sezgir. Model ayrim bashoratlar uchun kimyoviy parchalanish izohini bermaydi. Ko‘p nomzodli ssenariylarda nomzodlarning model ichidagi tartibi o‘zi yetarlicha ishonchli deb topilmagan va mutaxassis bahosi zarur deb ko‘rilgan. O‘qitish tuzilmalaridan juda uzoq molekulyar tuzilmalarda to‘liq qayta yaratish natijasi sezilarli pasayadi.
Kontent usuli: Ushbu Verianla maqolasining ilmiy topilmalari faqat ko‘rib chiqilgan tadqiqot matni, jadvallari, shakllari va mualliflar taqdim etgan natijalarga asoslanadi. Tashqi tasdiqlash faqat DOI, nashriyot, jurnal va taqriz kabi bibliografik identifikatsiya sohalari uchun ishlatilgan; tadqiqotga tashqaridan yangi natija yoki kimyoviy topilma qo‘shilmagan.
Meta Teglar
GC-EI-MS, SpecTUS, molekulyar tuzilma annotatsiyasi, massa-spektrometriya, Transformer modeli
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan