

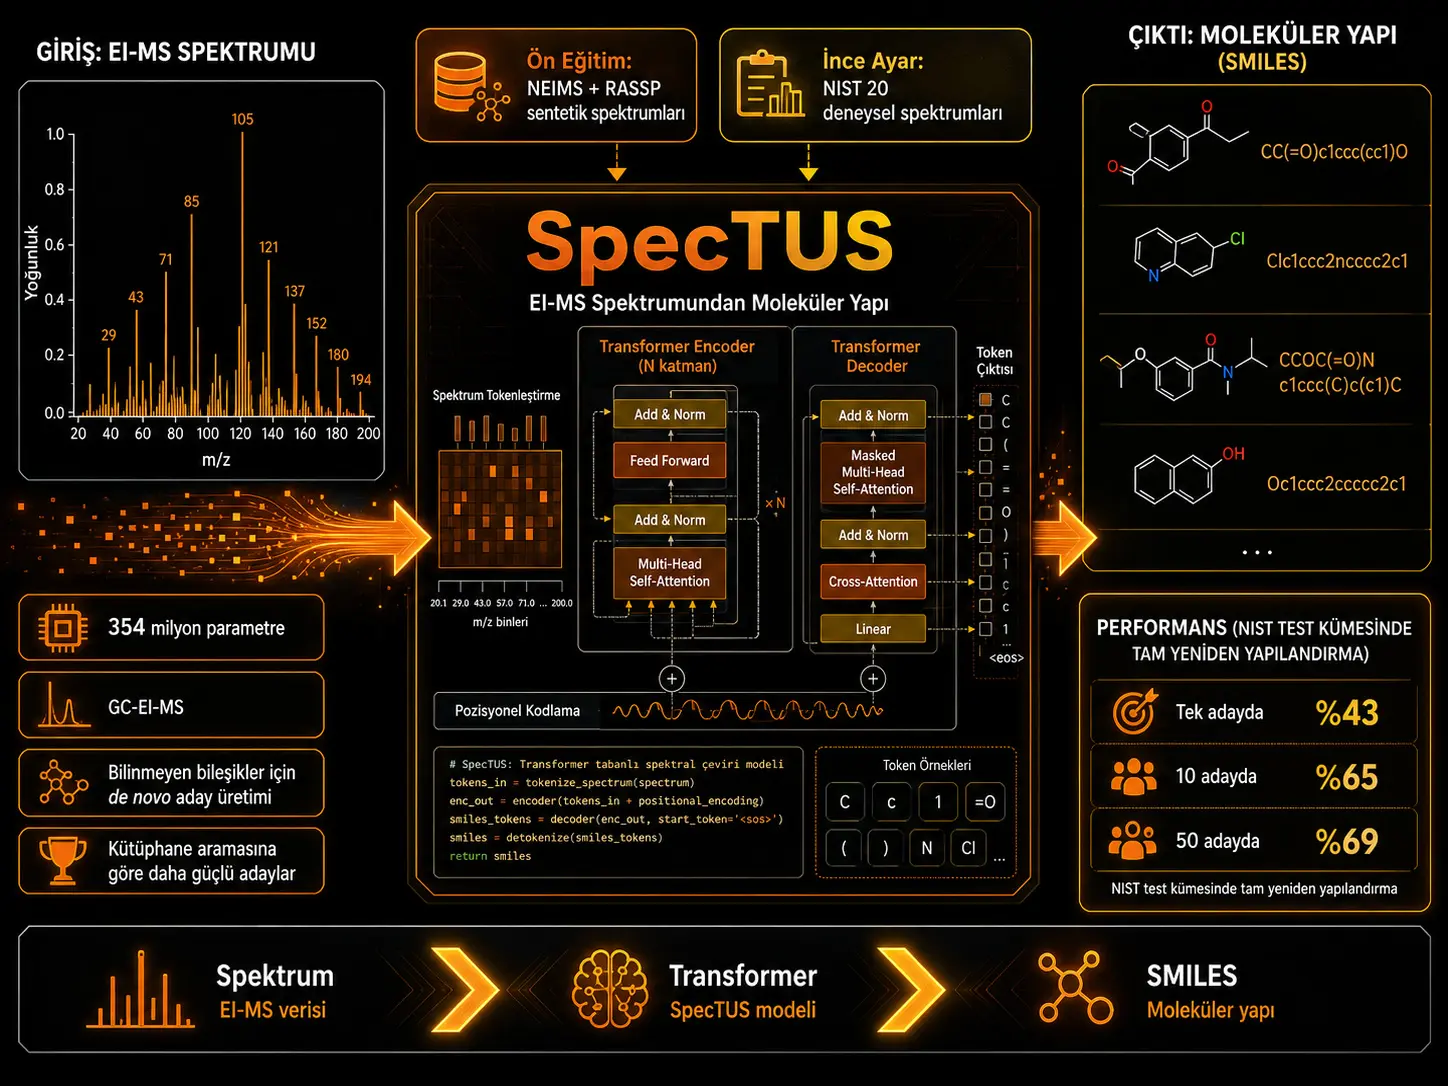
Bu araştırma, gaz kromatografisi–elektron iyonizasyonlu kütle spektrometrisi (GC-EI-MS) ile elde edilen düşük çözünürlüklü bir kütle spektrumundan moleküler yapıyı doğrudan üretmeyi amaçlayan SpecTUS adlı derin öğrenme modelini tanıtıyor. Geleneksel EI-MS tanımlama yöntemleri çoğunlukla ölçülen spektrumu bir referans spektrum kütüphanesinde arar. SpecTUS ise sorgulanan bileşiğin spektral kütüphanede bulunmasını zorunlu tutmadan, spektrumdaki kütle/yük ve yoğunluk bilgilerini işleyip molekülü bir SMILES dizisi olarak üretmeye çalışıyor.
SpecTUS, 354 milyon eğitilebilir parametreye sahip encoder–decoder Transformer mimarisidir. Model önce NEIMS ve RASSP tarafından üretilmiş geniş sentetik EI-MS veri kümeleri üzerinde ön eğitime tabi tutulmuş, ardından NIST 20 deneysel GC-EI-MS spektrumlarıyla ince ayarlanmıştır. Modelin girişini spektrumdaki m/z ve bağıl yoğunluk çiftleri; çıkışını ise karakter karakter oluşturulan moleküler SMILES gösterimi oluşturmaktadır.
NIST 20'den ayrılmış 28.267 spektrumluk test kümesinde SpecTUS yalnızca bir yapı önerdiğinde bileşiklerin %43'ünü tam olarak yeniden oluşturmuştur. On aday üretildiğinde tam yeniden oluşturma oranı %65'e, 50 aday senaryosunda %69'a çıkmıştır. Tek aday senaryosunda SpecTUS önerisi, Morgan parmak izi Tanimoto benzerliği ve kesin eşleşme kontrolüne dayalı karşılaştırmada NIST test örneklerinin %76'sında hibrit veritabanı aramasının sonucundan daha iyi bulunmuştur; on adaylı karşılaştırmada bu oran %84'tür.
Performans bütün veri kaynaklarında aynı değildir. Daha sıkı kürasyonlu NIST ve SWGDRUG spektrumlarında sonuçlar daha yüksekken Cayman ve MONA gibi daha heterojen veri kümelerinde doğruluk azalmıştır. Ayrıca eğitim kümesindeki yapılara giderek daha az benzeyen moleküller seçildiğinde performans keskin biçimde düşmektedir. Bu nedenle araştırma, SpecTUS'un eğitim sırasında görmediği bileşiklere belirli ölçüde genellenebildiğini gösterirken tamamen yeni kimyasal yapı uzayının çözüldüğünü göstermemektedir.
Türkiye açısından çalışma; adli kimya, çevresel analiz, ilaç/uyuşturucu analizi ve küçük molekül karakterizasyonunda GC-EI-MS kullanan araştırma laboratuvarları için yöntemsel açıdan dikkat çekicidir. Ancak model Türkiye'deki laboratuvar cihazları, numune hazırlama süreçleri veya yerel analit setleri üzerinde ayrıca doğrulanmamıştır. Özellikle spektrum kalitesi ve ölçüm protokolü performansı etkilediğinden yerel uygulama için bağımsız doğrulama ve uzman kimyager değerlendirmesi gerekir.
Neden spektral kütüphane aramasının dışında bir yönteme ihtiyaç duyuluyor?
GC-MS analizinde bileşikler önce gaz kromatografisiyle ayrılır. Ardından nötr moleküller iyonlaştırılır ve kütle spektrometresi oluşan iyonların kütle/yük oranlarını (m/z) ve bağıl bolluklarını ölçer. Sonuç, her bir bileşiğe ait bir dizi spektral tepedir.
Çalışmada odak noktası elektron iyonizasyonudur (EI). GC-EI-MS'de onlarca yıldır yaygın biçimde kullanılan yaklaşık 70 eV elektron enerjisi, farklı spektral kütüphaneler arasında görece tutarlı parçalanma örüntüleri oluşturabilmektedir. Bununla birlikte aynı bileşiğin spektrumunda cihaz ve ölçüm koşullarına bağlı farklılıklar yine bulunabilir.
Geleneksel yaklaşımda sorgu spektrumu ölçülmüş referans spektrumlarıyla karşılaştırılır. Çalışma iki temel yöntem kullanıyor:
- Simple Similarity Search (SSS): benzer m/z değerlerindeki spektral tepeleri eşleştirir.
- Hybrid Similarity Search (HSS): parçacık iyonlarının yanında nötr kayıpları da kullanır ve sorgu ile referans molekül arasındaki molekül ağırlığı farkını hesaba katar.
HSS özellikle sorgulanan bileşik kütüphanede bulunmuyorsa SSS'den daha kullanışlı olabilir. Ancak yöntemin önemli sınırlaması, sorgu bileşiğinin doğru molekül ağırlığı bilgisinden yararlanmasıdır; bu bilgi düşük çözünürlüklü EI-MS spektrumlarından her zaman güvenilir biçimde elde edilemeyebilir.
Daha temel sınırlama ise spektral kütüphanenin kapsamıdır. Bir bileşik referans kütüphanede hiç yoksa standart arama doğru molekülün kendisini geri döndüremez; yalnız bulunan adaylar arasındaki en yakın yapıyı önerebilir. SpecTUS bu kısıtı, spektrumdan doğrudan yeni moleküler yapı üretmeye çalışarak aşmayı hedeflemektedir.
SpecTUS'un temel fikri nedir?
SpecTUS problemi bir tür “çeviri” problemi olarak ele alır. Bir doğal dil modelinin bir dildeki diziyi başka bir dildeki diziye dönüştürmesi gibi, model EI-MS spektrumunu moleküler yapı gösterimine çevirmektedir:
EI-MS spektrumu → Transformer → SMILES molekül dizisi
Giriş tarafında her spektral tepe iki bilgi taşır: tam sayıya yuvarlanan m/z değeri ve bağıl yoğunluk. Çıkış tarafında ise model moleküler yapıyı SMILES karakterlerini otoregresif biçimde, yani önceki ürettiği karakterleri kullanarak sırayla oluşturarak üretir.
Model mimarisi ne kadar büyük?
SpecTUS, BART yaklaşımını temel alan 354 milyon eğitilebilir parametreli bir encoder–decoder Transformer'dır. Kaynakta mimarinin temel büyüklükleri şu şekilde verilmektedir:
| Mimari özelliği | SpecTUS değeri |
|---|---|
| Encoder blok sayısı | 12 |
| Decoder blok sayısı | 12 |
| Attention head sayısı | 16 |
| Embedding boyutu | 1024 |
| Feed-forward gizli katman boyutu | 4096 |
| Toplam eğitilebilir parametre | 354 milyon |
Modelin giriş sınırları en fazla 300 spektral tepe, en fazla m/z = 500 ve en fazla 100 karakter uzunluğunda SMILES olarak belirlenmiştir. Bu filtreler NIST verisinin yaklaşık %3'ünün dışlanmasına yol açmıştır.
Spektrum model için nasıl kodlanıyor?
Çalışmada m/z değerleri en yakın tam sayıya yuvarlanmaktadır. Bağıl yoğunluklar ise doğrudan çok yüksek çözünürlükte sayısal giriş olarak kullanılmak yerine logaritmik aralıklara ayrılmaktadır. Son modelde yoğunluk değerleri tabanı 1,28 olan logaritmik dönüşümle 30 bin içinde temsil edilmiştir.
Model üç eğitilebilir embedding kümesi kullanmaktadır:
- m/z değerleri için embedding,
- yoğunluk binleri için embedding,
- SMILES karakterleri için embedding.
Encoder'a gönderilen her spektral tepenin temsili, m/z embedding'i ile yoğunluk embedding'inin toplamından oluşmaktadır. Decoder tarafında ise her adım bir SMILES karakterini temsil eder.
Sentetik veriler neden kullanıldı?
Gerçek deneysel GC-EI-MS spektrumlarının sayısı potansiyel moleküler yapı uzayına kıyasla sınırlıdır. Araştırmacılar bu nedenle modeli önce çok daha geniş bir sentetik kimyasal uzayda eğitip daha sonra gerçek deneysel spektrumlara uyarlamıştır.
ZINC20'den başlangıçta yaklaşık 1,8 milyar SMILES dizisi toplanmıştır. Her veri toplama turunda 100 karakterden kısa 30 milyon bozulmamış SMILES rastgele örneklenmiş, ardından yapılar kanonikleştirilmiş, yinelenen kayıtlar kaldırılmış ve stereokimya bilgisi çıkarılmıştır. NIST 20'de bulunan bileşikler veri sızıntısını önlemek amacıyla sentetik ön eğitim bileşiklerinden uzaklaştırılmıştır.
RASSP'nin işleyebileceği element ve alt-formül kısıtlarından sonra iki toplama turunda yaklaşık 4,7 milyon ve 4,8 milyon bileşik kalmıştır. Her bileşik için hem NEIMS hem RASSP modeliyle bir spektrum üretildiğinden sentetik veri koleksiyonları toplamda yaklaşık 9,4 milyon ve 9,6 milyon spektrum içermektedir. Bu veri kümeleri eğitim/doğrulama/test için 0,90/0,05/0,05 oranında ayrılmıştır.
Ön eğitim ne kadar sürdü?
Son SpecTUS ön eğitimi, NEIMS ve RASSP kaynaklarının 1:1 dengeli karışımı üzerinde gerçekleştirilmiştir. Kaynak son ön eğitim aşamasında 17,2 milyon eğitim spektrumunun yaklaşık üç kez işlendiğini bildirmektedir.
| Ön eğitim özelliği | Değer |
|---|---|
| Batch büyüklüğü | 128 |
| Güncelleme adımı | 448.000 |
| Donanım | 1 × NVIDIA H100 GPU |
| Toplam süre | 58 saat |
Ön eğitimin sonunda tam yapı yeniden oluşturma oranı RASSP tarafından üretilen spektrumlarda %38, NEIMS spektrumlarında %29 ve gerçek NIST spektrumlarında yalnız %3 olmuştur. Buna karşın üretilen SMILES'lerin %96'sının geçerli kanonik molekül olduğu bildirilmiştir. Araştırmacılar bu sonucu, ön eğitimin moleküler yapı kurallarını ve atomik kütle–m/z ilişkisini öğrenmek için temel oluşturduğu biçiminde yorumlamaktadır.
Gerçek NIST spektrumlarıyla ince ayar nasıl yapıldı?
NIST 20 GC-EI-MS kütüphanesinde bozuk veya anotasyonsuz spektrumlar temizlenmiş, stereokimya bilgileri çıkarılmış, SMILES gösterimleri kanonikleştirilmiş ve döteryum içeren bileşikler kaldırılmıştır. Modelin m/z, tepe sayısı ve SMILES uzunluğu sınırları da uygulanmıştır.
Ayrıntılı yöntem bölümünde son NIST ayrımı şu şekilde verilmektedir:
| NIST 20 alt kümesi | Spektrum sayısı |
|---|---|
| Eğitim | 224.737 |
| Doğrulama | 28.177 |
| Test | 28.267 |
Yinelenen bileşiklerin farklı split'lere dağılmasına izin verilmemiştir. Böylece aynı molekülün eğitim ve test kümelerinde bulunmasının önüne geçilmeye çalışılmıştır.
Kaynak içi sayı notu: Makalenin başka bölümlerinde NIST eğitim/ince ayar büyüklüğü 232.025 ve 232.035 olarak da yazılmıştır. Ayrıntılı veri kümesi bölümünün 224.737 eğitim spektrumu değeri bu iki ifadeyle uyuşmamaktadır. Bu nedenle bu üç sayı tek bir “düzeltilmiş” değere dönüştürülmemelidir.
İnce ayar ne kadar sürdü?
Model NIST eğitim kümesinde 296.000 güncelleme adımı boyunca eğitilmiş ve her spektrumun yaklaşık 80 kez işlendiği belirtilmiştir. İnce ayar, yine tek NVIDIA H100 GPU üzerinde kontrol değerlendirmeleri dahil yaklaşık 28 saat sürmüştür.
İlginç biçimde NIST ince ayarı sırasında modelin sentetik spektrumları tam yeniden oluşturma yeteneği hızlı biçimde düşerken deneysel NIST doğrulama başarımı güçlü biçimde yükselmiştir. Çalışma bunu modelin sentetik veri dağılımından gerçek deneysel dağılıma uyarlanmasının bir sonucu olarak göstermektedir.
Hangi tasarım tercihleri deneysel olarak karşılaştırıldı?
Araştırmacılar yalnız son modeli raporlamak yerine beş ayrı geliştirme deneyi yürütmüştür.
1. Yoğunluk binleme
Lineer ve logaritmik yoğunluk temsil yöntemleri karşılaştırılmıştır. Çok kaba temsil, özellikle düşük yoğunluklu tepelerde bilgi kaybına yol açmıştır. 30 binli logaritmik yaklaşım, dört ondalıklı lineer kodlamaya göre doğrulama Acc1 değerini yaklaşık 0,9 yüzde puan artırırken yaklaşık 10 milyon daha az eğitilebilir parametre gerektirmiş ve son model için seçilmiştir.
2. SMILES, SELFIES ve tokenizasyon
SMILES tabanlı modeller SELFIES tabanlı modelden doğrulama Acc1 açısından 1,7–5,8 yüzde puan daha yüksek sonuç vermiştir. Ayrıca doğal dil modellerinde çoğu zaman avantajlı olan daha büyük Byte Pair Encoding sözlükleri burada fayda sağlamamıştır. En basit karakter düzeyindeki SMILES kodlaması diğer BPE varyantlarından yaklaşık 3,5–4 yüzde puan daha iyi sonuç vermiştir.
3. Sentetik ön eğitim karışımı
Sentetik ön eğitim almayan model ile RASSP, NEIMS ve bunların karışımları karşılaştırılmıştır. Sentetik ön eğitim alan modeller, yalnız gerçek veride ince ayar yapılan modele göre doğrulama Acc1'de yaklaşık 7–10 yüzde puan avantaj sağlamıştır. NEIMS ve RASSP'nin 1:1 karışımı en iyi sonucu vermiştir.
4. Spektrum kaynağı etiketi
<rassp>, <neims> ve <nist> gibi özel kaynak tokenlarının kullanılmasının final performansa belirgin katkısı bulunmamıştır. Tek genel kaynak tokenı kullanan varyant, Acc1'de yaklaşık 0,2 yüzde puan daha yüksek sonuç vermiştir. Buna rağmen araştırmacılar gelecekte özel veri kümelerine ince ayar için kaynak tokenı mekanizmasını final modelde korumuştur.
5. Eğitim süresi ve veri miktarının ölçeklenmesi
Ön eğitim süresi, ince ayar süresi ve sentetik veri büyüklüğü ayrı ayrı artırıldığında performans gelişmiştir. Son tam ölçekli `8.6M_448k_296k` yapılandırması, başlangıç olarak kullanılan `4.2M_112k_74k` modele kıyasla Acc1 değerini 5,4 yüzde puan artırmıştır.
Çalışma çıktıyı nasıl değerlendiriyor?
Acck, modelin ürettiği ilk k aday içinde gerçek molekülün birebir bulunma oranıdır. Bu metrik yalnız benzer yapıyı değil, kesin moleküler eşleşmeyi değerlendirir.
Simk, k aday içindeki gerçek moleküle en çok benzeyen yapının Morgan moleküler parmak izi üzerindeki Tanimoto benzerliğini ölçmektedir.
Çalışma ayrıca SpecTUS ile başka bir yöntemi doğrudan karşılaştırmak için win rate ve at-least-as-good oranlarını kullanmaktadır. Tanimoto parmak izleri farklı moleküllerde bazen 1,0 benzerlik verebildiği için sıralama fonksiyonuna kesin yapı eşleşmesi kontrolü de eklenmiştir.
Neden BDC adında yapay bir karşılaştırma kullanılıyor?
Best Database Candidate (BDC), gerçek uygulamada erişilemeyen teorik bir üst sınırdır. BDC, sorgu molekülünün gerçek yapısını zaten bildiğimizi varsayarak referans kütüphanedeki yapılar arasından Morgan parmak izi bakımından ona en yakın olanı seçmektedir.
Dolayısıyla BDC pratik bir tanımlama yöntemi değildir. Çalışmadaki görevi, “veritabanı içinde daha iyi bir yapı zaten yoksa arama algoritmasını geliştirmenin sınırı nedir?” sorusuna üst sınır oluşturmaktır.
Şekil 1 ne anlatıyor?
Çalışmanın yöntem şeması, SpecTUS'un iki aşamalı eğitimini ve final çıkarımını birlikte göstermektedir. Ön eğitim tarafında ZINC'den gelen SMILES yapıları NEIMS/RASSP aracılığıyla sentetik spektrumlara dönüştürülerek SpecTUS'a öğretilmektedir. İnce ayar aşamasında deneysel NIST spektrumları ile gerçek SMILES etiketleri kullanılmaktadır. Çıkarım sırasında ise bu akış ters yönde işler: analiz edilen EI-MS spektrumu doğrudan SpecTUS'a girer ve model sıralı bir veya daha fazla SMILES adayı üretir.
Çalışmanın desteklediği sonuçlar
- SpecTUS, test bileşikleri eğitim veri kümelerinden ayrıldığında dahi düşük çözünürlüklü GC-EI-MS spektrumlarından yeni moleküler yapı adayları üretebilmiştir.
- NIST test kümesinde tek aday tam yapı doğruluğu %43, 10 aday doğruluğu %65 ve 50 aday doğruluğu %69'dur.
- NIST'te tek SpecTUS adayı HSS'nin tek adayından örneklerin %76'sında daha iyi yapısal aday üretmiştir.
- NIST ve SWGDRUG gibi daha iyi kürasyonlu spektrumlarda model, Cayman ve MONA'ya kıyasla daha yüksek performans göstermiştir.
- Sentetik veri üzerinde ön eğitim, yalnız deneysel NIST verisiyle eğitimden daha yüksek doğrulama başarımı sağlamıştır.
- Birden fazla sentetik spektrum üreticisinin birlikte kullanılması tek kaynağa kıyasla avantaj sağlamıştır.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- SpecTUS her bilinmeyen molekülü güvenilir biçimde belirleyebilen evrensel bir kimyasal tanımlama sistemi değildir.
- Modelin ilk sıradaki çıktısı, bağımsız doğrulama olmadan kesin kimlik kanıtı olarak değerlendirilmemelidir.
- Model tamamen yeni ve eğitim kimyasından çok uzak yapılar üzerinde yüksek doğruluk garantisi vermemektedir.
- Çalışma modelin laboratuvar uzmanının yerine geçebildiğini göstermemektedir.
- Model çıktılarının parçalanma ağacı veya pik-atama mekanizmasıyla açıklanabilir olduğu gösterilmemiştir.
- Cayman ve MONA'daki performans düşüşü, bütün laboratuvar ve cihaz koşullarında aynı doğruluğun beklenemeyeceğini göstermektedir.
Çalışmanın Yöntemi ve Bulguları
Değerlendirme veri kümeleri
Model yalnız NIST test splitinde değil, bağımsız kaynaklardan alınan SWGDRUG, Cayman ve MONA EI-MS verilerinde de değerlendirilmiştir. Eğitim verileriyle çakışan bileşikler ve model sınırlarını aşan örnekler çıkarıldıktan sonra kullanılan spektrum sayıları şöyledir:
| Test veri kümesi | Orijinal spektrum sayısı | Filtre sonrası kullanılan spektrum sayısı |
|---|---|---|
| NIST test | 29.218 | 28.267 |
| SWGDRUG | 3.589 | 1.640 |
| Cayman | 2.262 | 469 |
| MONA | 18.914 | 5.015 |
Filtreleme; NIST eğitim kümesiyle çakışmaların kaldırılmasını, döteryum içeren yapıların çıkarılmasını, m/z > 500 olan örneklerin, 300'den fazla spektral tepe içeren spektrumların ve 100 karakteri aşan SMILES dizilerinin elenmesini kapsamaktadır.
NIST'te kesin molekül yeniden yapılandırması
NIST'teki 28.267 test spektrumu, çalışmanın en kapsamlı ve iyi kontrol edilen değerlendirmesidir. Aday sayısı arttırıldığında gerçek molekülün öneri listesinde bulunma olasılığı yükselmektedir.
Bir adaydan 10 adaya geçmek 22 yüzde puanlık ek tam eşleşme sağlamaktadır. Buna karşılık 10 adaydan 50 adaya çıkış yalnız 4 yüzde puanlık ek kazanım sağlar. Bu sonuç, aday sayısının sınırsız artırılmasının uzman değerlendirme yüküyle birlikte değerlendirilmesi gerektiğini göstermektedir.
Neden çok adaylı sonuçlarda uzman hâlâ gerekli?
SpecTUS her aday için kendi sıra olasılığını üretmektedir; ancak araştırmacılar bu sıralamanın uzman değerlendirmesinin yerini alacak kadar güvenilir olmadığını bulmuştur. Hatta 10 aday üretilen senaryodaki modelin ilk sıralı adayı, ortalamada yalnız tek aday üretme senaryosundaki adaydan biraz daha düşük doğruluğa sahiptir.
Bu nedenle çalışma üç kullanım senaryosu tanımlar:
- 1 aday: manuel yükü en düşük, yüksek hacimli analizler için uygun; fakat doğruluk daha düşük.
- 10 aday: doğruluk ve uzman inceleme yükü arasında daha dengeli senaryo.
- 50 aday: modelin potansiyelini yükseltir ancak manuel inceleme yükünü ciddi biçimde artırır.
Yapısal benzerlik açısından HSS ile karşılaştırma
NIST testinde SpecTUS'un tek aday için ortalama Morgan/Tanimoto benzerliği 0,67'dir. HSS'nin 50 adaylık sonucunda bile bu değer 0,62 olarak raporlanmaktadır. SWGDRUG'da SpecTUS tek aday ortalaması 0,69, HSS50 ise 0,61'dir.
| Veri kümesi | SpecTUS 1 aday Sim1 | HSS 50 aday Sim50 | BDC teorik üst sınırı | SpecTUS 10 aday Sim10 |
|---|---|---|---|---|
| NIST test | 0,67 | 0,62 | 0,72 | 0,81 |
| SWGDRUG | 0,69 | 0,61 | 0,69 | 0,82 |
On adaylı SpecTUS, bu iki veri kümesinde referans kütüphanedeki mümkün olan en yakın molekülü temsil eden BDC değerinin de üzerinde ortalama benzerlik sağlayabilmektedir. Bunun nedeni SpecTUS'un yalnız mevcut kütüphane yapıları arasından seçim yapmak zorunda olmaması, yeni yapılar oluşturabilmesidir.
HSS'ye karşı doğrudan kazanma oranı
NIST testinde tek adaylı SpecTUS, aynı koşuldaki HSS adayından test örneklerinin %76'sında kesin olarak daha iyi bir yapı önermiştir. On adaylı durumda bu oran %84'e ulaşmaktadır. Kaynağın bütün aday senaryoları birlikte değerlendirildiğinde NIST'teki SpecTUS–HSS kazanma oranı %76–86 aralığındadır.
SWGDRUG için aralık %72–85, Cayman için %63–74, MONA için %62–65 olarak raporlanmaktadır. Spektrum kürasyonu azaldıkça SpecTUS'un üstünlüğünün de daralması, giriş verisinin kalitesine duyarlılığı açık biçimde göstermektedir.
Veritabanının teorik en iyi adayı bile aşılabiliyor mu?
BDC, sorgunun gerçek yapısını bildiğimizi varsayan teorik bir veritabanı üst sınırıdır. Buna rağmen NIST'te tek SpecTUS adayı BDC'den vakaların %47'sinde, SWGDRUG'da %45'inde daha iyi sonuç vermiştir.
On aday üretildiğinde SpecTUS, hem NIST hem SWGDRUG'da örneklerin %70'inde BDC'den daha iyi; Cayman'da ise %56'sında daha iyi aday üretebilmiştir. Bu sonuç de novo üretimin temel avantajını gösterir: doğru veya daha yakın moleküler yapı referans kütüphanede bulunmasa bile model yeni aday oluşturabilir.
Şekil 3'ün temel mesajı
Şekil 3; SSS, HSS ve SpecTUS'un NIST, SWGDRUG, Cayman ve MONA üzerindeki ortalama yapısal benzerliklerini 1, 10 ve 50 aday senaryolarında birlikte göstermektedir. SpecTUS'un doğruluk değerleri ayrıca siyah işaretlerle verilmektedir.
NIST ve SWGDRUG sütunlarında SpecTUS'un avantajı en belirgin durumdadır. Cayman ve özellikle MONA'ya geçildiğinde bütün yöntemlerin yapısal benzerliği düşmekte ve SpecTUS ile HSS arasındaki fark küçülmektedir. Araştırmacılar bunu spektrumların üretim ve kürasyon kalitesindeki farklılıklarla ilişkilendirmektedir.
Şekil 4 neyi gösteriyor?
Şekil 4'ün A paneli SpecTUS'u HSS ile, B paneli ise teorik BDC üst sınırıyla doğrudan karşılaştırmaktadır. Kırmızı sütunlar SpecTUS'un kesin olarak üstün olduğu örnekleri; açık renkli ek bölüm ise eşitliklerin de dahil edildiği “en az onun kadar iyi” oranını göstermektedir.
NIST ve SWGDRUG'da aday sayısı arttıkça SpecTUS'un HSS karşısındaki üstünlüğü belirginleşirken MONA'da ek adaylardan sağlanan fayda daha sınırlıdır. Bu görünüm, daha fazla aday üretmenin tek başına kötü spektral veriyi telafi edemediğini düşündürmektedir.
Model gerçekten tamamen yeni kimyada genelleniyor mu?
Araştırmanın en önemli sınır testlerinden biri, test moleküllerinin eğitim kümesindeki yapılara olan yapısal benzerliğinin sistematik olarak azaltılmasıdır. Araştırmacılar maximum common edge subgraph (MCES) mesafesi kullanarak NIST test kümesini giderek daha farklı moleküllerle sınırlandırmıştır.
Mesafe eşiği T = 10 olduğunda başlangıç NIST test kümesinin yalnız %1,7'si, yani 469 yapı kalmıştır. Bu en zor koşulda SpecTUS 10 aday içinde yalnız 19 molekülü tam olarak yeniden oluşturabilmiş, ortalama yapısal benzerlik ise 0,38 düzeyine düşmüştür.
Bu sonuç yaklaşık %4'lük Acc10'a karşılık gelmekte ve modelin işlevsel sınırını açık biçimde göstermektedir. SpecTUS daha önce görmediği molekülleri tahmin edebilse de eğitim sırasında öğrendiği kimyasal örüntülerden tamamen uzak yapılar için yüksek genelleme göstermemektedir.
Tipik yapı tahmin hataları nelerdir?
Şekil 5'te NIST test kümesinden 200 rastgele sorgunun SpecTUS10 ve HSS10 benzerlikleri karşılaştırılmış ve beş örnek ayrıntılı olarak gösterilmiştir. Araştırmacılar üç tipik hata biçimi tanımlamaktadır:
- tekrarlayan karbon zincirlerini gereğinden uzun veya kısa üretmek,
- doğru fonksiyonel grubu yanlış aromatik halka atomuna bağlamak,
- büyük moleküler alt yapıların kendisini doğru çözerken bu alt yapıları birbirine yanlış bağlamak.
Şekil 5 ayrıca Tanimoto/Morgan ölçütünün kendi sınırlılığını da gösterir. Uzun ve tekrarlayan zincirlerde farklı iki molekül bazen aynı parmak izine sahipmiş gibi Tanimoto = 1 sonucu verebilir. Bu nedenle çalışma kesin yapı eşleşmesini ayrıca kontrol etmektedir.
Çıkarım hızı
Model üç farklı donanım sınıfında test edilmiştir. Aşağıdaki değerler tek bir spektrum için 1, 10 veya 50 yapı adayı üretme süreleridir:
| Donanım | 1 aday | 10 aday | 50 aday |
|---|---|---|---|
| NVIDIA H100 80 GB | 0,2 s | 0,4 s | 1,9 s |
| NVIDIA Quadro RTX 5000 16 GB | 0,5 s | 1,1 s | 7,6 s |
| Xeon Gold 6130 CPU + 8 GB RAM | 8 s | 36 s | 450 s |
Bu süreler modelin laboratuvar iş akışlarında kullanılabilir olabileceğini göstermektedir ancak donanıma özgüdür. Özellikle CPU üzerinde 50 aday üretimi 7,5 dakikaya ulaşmaktadır; dolayısıyla “hızlı” ifadesi aday sayısı ve donanım bağlamından bağımsız kullanılmamalıdır.
Açıklanabilirlik sınırı
SpecTUS, belirli bir molekülü neden ürettiğini kimyasal parçalanma adımları üzerinden açıklamamaktadır. Modelin ara çıktısında pik anotasyonları, parçalanma ağaçları veya önerilen adaylara ait referans spektrumlar bulunmaz.
Bu durum yanlış bir adayın uzman tarafından adım adım düzeltilmesini zorlaştırmaktadır. Model güçlü bir aday üretici olsa da tahminin kimyasal gerekçesini kendi başına açıklayan bir araç değildir.
Sonuçların bilimsel anlamı
Çalışmanın temel yeniliği, düşük çözünürlüklü GC-EI-MS'de yalnız spektral kütüphane aramak yerine spektrumu doğrudan moleküler yapıya çeviren büyük bir Transformer modelinin uygulanmasıdır. Test bileşiklerinin eğitim bileşiklerinden ayrılması, SpecTUS'un yalnız ezberleme yapmadığını ve belirli bir genelleme kapasitesi geliştirdiğini desteklemektedir.
Bununla birlikte yapısal olarak çok uzak test bileşiklerindeki keskin performans düşüşü, modelin “bilinmeyen” kavramının sınırlarını göstermektedir. Model eğitimde birebir görmediği yapıları oluşturabilir; fakat bunu büyük ölçüde daha önce öğrendiği kimyasal alt örüntüleri yeni biçimlerde birleştirerek yapmaktadır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: SpecTUS: Spectral Translator for Unknown Structures Annotation from EI-MS Spectra
Yazarlar ve sıraları: Adam Hájek; Michal Starý; Elliott Price; Filip Jozefov; Helge Hecht; Aleš Křenek.
Eş katkı / eş birinci yazarlık: İncelenen çalışmada eş katkı beyanı bulunmamaktadır.
Sorumlu yazar: Aleš Křenek.
Kurumlar: Adam Hájek ve Aleš Křenek — Institute of Computer Science, Masaryk University, Brno, Czech Republic. Michal Starý — School of Computation, Information and Technology, Technical University Munich, Garching bei München, Germany. Elliott Price ve Helge Hecht — RECETOX, Masaryk University, Brno, Czech Republic. Filip Jozefov — Faculty of Informatics, Masaryk University, Brno, Czech Republic.
Kaynak türü / hakemlik: Hakem değerlendirmesinden geçmiş araştırma makalesi.
Dergi: Analytical Chemistry.
Yayınevi: American Chemical Society.
Bibliyografik bilgi: Anal. Chem. 2026, 98, 21670–21682.
DOI: 10.1021/acs.analchem.6c02423.
Gönderim / revizyon / kabul / yayın: 14 Nisan 2026 / 29 Haziran 2026 / 30 Haziran 2026 / 13 Temmuz 2026.
Resmî bağlantı:https://doi.org/10.1021/acs.analchem.6c02423
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Veri ve kod erişilebilirliği: Çalışmanın kaynak kodu, veri hazırlama ve değerlendirme iş akışları GitHub üzerinden paylaşılmıştır. Sentetik veri kümeleri ve ön eğitilmiş model Hugging Face üzerinde yayımlanmıştır. Bununla birlikte NIST'in ticari lisans koşulları nedeniyle NIST 20 üzerinde ince ayarlanmış final model serbestçe dağıtılamamaktadır. NIST lisansına sahip kullanıcıların yayımlanan split ve betiklerle ince ayarı tekrar edebilecekleri belirtilmiştir.
Çıkar çatışması: Yazarlar rakip finansal çıkar bulunmadığını beyan etmektedir.
Finansman: Çalışma Çekya Eğitim, Gençlik ve Spor Bakanlığı'nın e-Infrastruktura CZ (LM2023054) ve RECETOX Research Infrastructure (LM2023069) projeleri ile Avrupa Birliği Horizon 2020 programının CETOCOEN Excellence projesi (857560) tarafından desteklenmiştir. Hesaplama kaynakları e-INFRA CZ projesi No. 90254 üzerinden sağlanmıştır.
Yazar katkıları: Adam Hájek SpecTUS'u uygulamış, deney tasarımına katılmış, deneyleri yürütmüş ve makale yazımına katkı sağlamıştır. Michal Starý model ve deney tasarımına katkı vermiştir. Elliott Price veri hazırlama, deney tasarımı ve değerlendirme için yönlendirme sağlamıştır. Filip Jozefov veri hazırlama/split işlemlerini ve sentetik veri üretimini uygulamıştır. Helge Hecht değerlendirmeye katkı vermiştir. Aleš Křenek çalışmayı yönetmiş, RASSP değişiklikleri ve eğitimini gerçekleştirmiş, sentetik veri üretimine, deney tasarımına ve makale yazımına katkı sağlamış ve gönderim/revizyon süreçlerini yönetmiştir.
Kaynak içi veri kümesi tutarsızlığı: Ayrıntılı yöntem bölümünde NIST 20 eğitim split'i 224.737 spektrum olarak verilirken giriş bölümünde 232.025, baseline bölümünde 232.035 spektrum ifadeleri bulunmaktadır. Bu sayılar sessizce tek bir değere dönüştürülmemiştir. Bu Verianla metnindeki eğitim/doğrulama/test tablosunda ayrıntılı “Fine-Tuning Data Set” bölümünün 224.737 / 28.177 / 28.267 ayrımı esas alınmıştır.
Yöntemsel sınırlar: SpecTUS düşük çözünürlüklü GC-EI-MS için geliştirilmiştir ve giriş spektrumunun kalitesine duyarlıdır. Model belirli tahminler için kimyasal parçalanma açıklaması üretmemektedir. Çok adaylı senaryolarda adayların model içi sıralaması tek başına güvenilir bulunmamış ve uzman değerlendirmesi gerekli görülmüştür. Eğitim yapılarından çok uzak moleküler yapılarda tam yeniden yapılandırma başarımı belirgin biçimde düşmektedir.
İçerik yöntemi: Bu Verianla makalesinin bilimsel bulguları yalnız incelenen çalışmanın metni, tabloları, şekilleri ve yazarların sunduğu sonuçlara dayanmaktadır. Dış doğrulama yalnız DOI, yayıncı, dergi ve hakemlik gibi bibliyografik kimlik alanları için kullanılmış; çalışmaya dışarıdan yeni performans sonucu veya kimyasal bulgu eklenmemiştir.
Meta Etiketler
GC-EI-MS, SpecTUS, moleküler yapı anotasyonu, kütle spektrometrisi, Transformer modeli
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir