

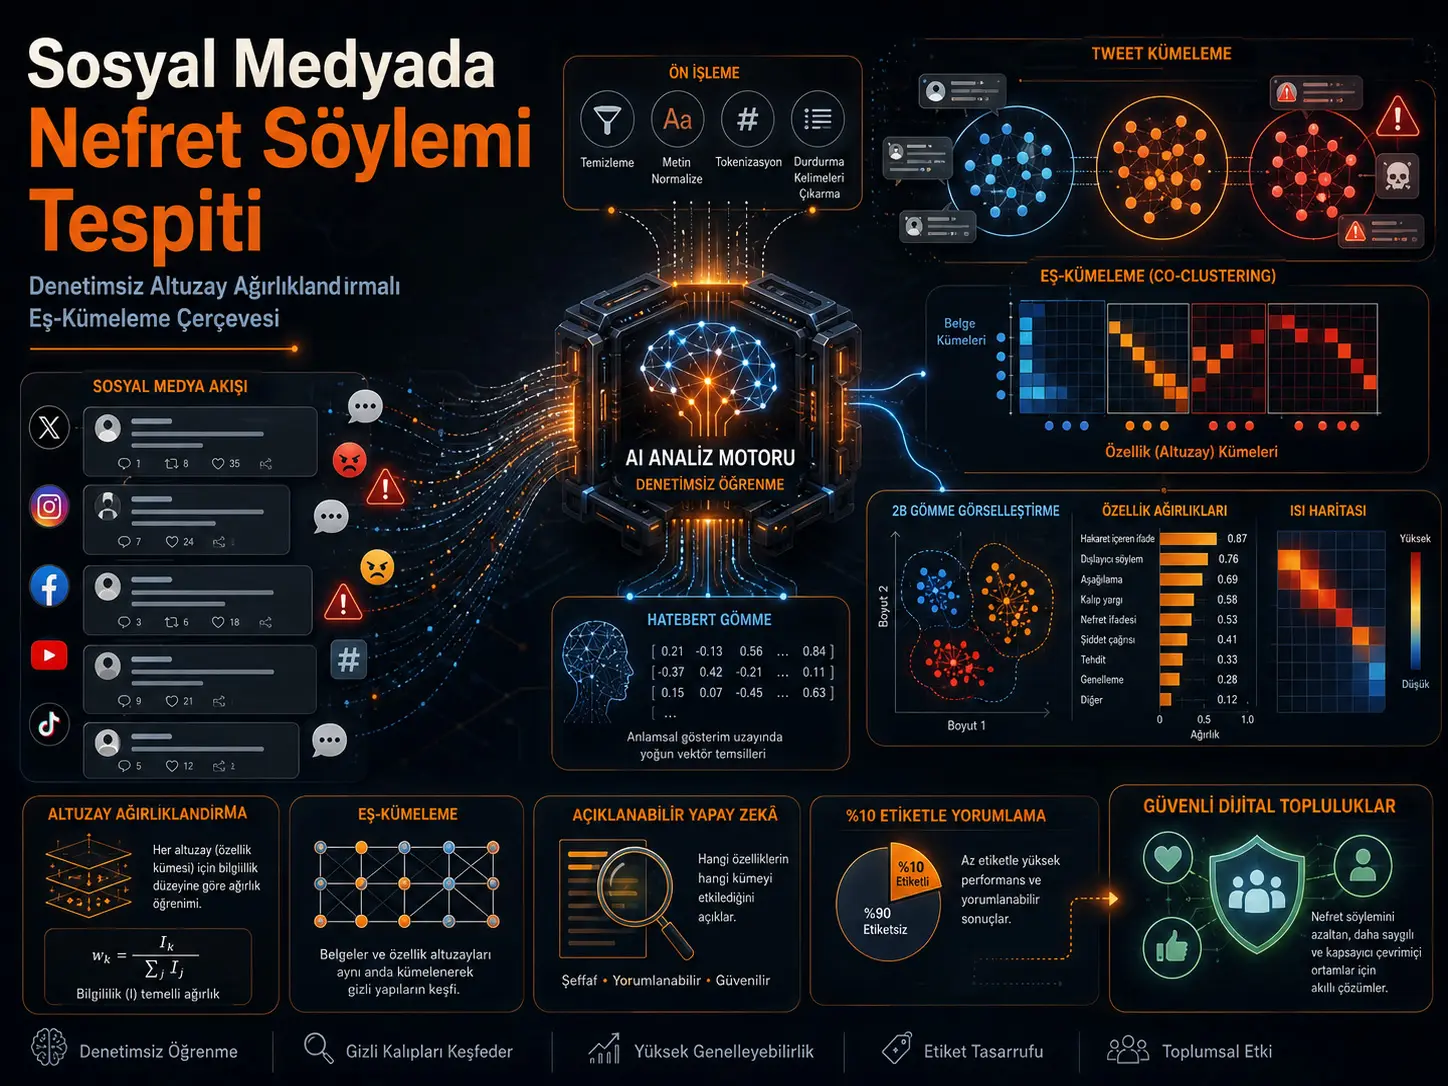
Utafiti huu unapendekeza mbinu iitwayo Subspace Weighting Co-Clustering (SWCC; Uunganishaji-Makundi wenye Upimaji wa Uzito wa Nafasi Ndogo) ili kugundua mifumo ya matamshi ya chuki ya Kiingereza katika mitandao ya kijamii bila kuhitaji kiasi kikubwa cha data ya mafunzo iliyowekewa lebo. Mfumo huanza na modeli ya lugha inayotegemea BERT ambayo hubadilisha maandishi kuwa embedding za kimuktadha zenye vipimo 768; kisha huunganisha kwa makundi kwa wakati mmoja tweet na vipimo vya sifa ndani ya nafasi hiyo ya embedding, na hujifunza uzito tofauti wa nafasi ndogo kwa kila kundi. Kwa mujibu wa ripoti ya waandishi, SWCC hufikia thamani za 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz na 0,43 Dunn katika tathmini ya ndani ya clustering. Katika tathmini ya nje kwenye mkusanyiko wa data wa Waseem, baada ya makundi kuundwa na %10 ya lebo kutumika kwa ulinganishaji wa kategoria, usahihi wa %93,1 na alama ya F1 ya %93,5 zimeripotiwa. Hata hivyo, utafiti huu si classifier ya kuanzia mwanzo hadi mwisho isiyotumia lebo kabisa; inahitaji subset ya uthibitishaji yenye lebo ili kuzipa kategoria majina. Aidha, katika matini chanzi kuna kutokuwiana kuhusu utambulisho wa modeli iliyotumika na mgawanyo wa madarasa katika mikusanyiko ya data, jambo ambalo linaweza kuathiri uwezo wa kuzalisha upya matokeo.
Wazo kuu la utafiti ni dhana kwamba aina zote za matamshi ya chuki hazitegemei vipengele vilevile vya lugha kwa kiwango sawa. Chuki inayolenga rangi, matamshi ya kibaguzi wa kijinsia na lugha ya kukera isiyo na chuki zinaweza kujilimbikiza katika vipimo tofauti vya kisemantiki. Kwa hiyo SWCC haigawanyi tweet tu katika makundi; pia hugawanya nafasi ya embedding yenye vipimo 768 katika nafasi ndogo na kupeana uzito wa umuhimu unaoweza kubadilika kwa nafasi hizo ndogo kwa kila kundi la tweet. Katika jaribio la ablation, uzito uliojifunzwa unapoondolewa, alama ya Silhouette hushuka kutoka 0,68 hadi 0,55; uzito unapochaguliwa bila mpangilio hushuka hadi 0,47, na unapowekwa sawa hushuka hadi 0,51. Matokeo haya yanaunga mkono kwamba katika data na mpangilio wa majaribio uliotathminiwa, upimaji wa uzito unaobadilika huchangia katika kutenganisha makundi.
Hata hivyo, madai mapana ya makala kuhusu matumizi kwa “matamshi ya chuki fiche” na “lugha zenye rasilimali chache” bado hayajathibitishwa kimajaribio. Majaribio yalifanywa kwenye data ya Twitter ya Kiingereza na, kwa maneno ya waandishi wenyewe, kwenye mikusanyiko ya data ya explicit hate. Kwa hiyo utafiti hautoi ushahidi wa mafanikio yaliyothibitishwa kwa majukwaa tofauti, lugha tofauti au moja kwa moja kwenye mikusanyiko ya data ya implicit hate.
Kwa nini inatafutwa mbinu tofauti na utambuzi wa kawaida wa matamshi ya chuki unaosimamiwa?
Njia ya kawaida katika kugundua matamshi ya chuki ni kufundisha classifier kwa kutumia maelfu au mamilioni ya matini ambazo tayari zimeainishwa na binadamu. Ingawa mbinu hii inaweza kutoa utendaji wa juu, huleta gharama endelevu ya uannishaji kwa lugha mpya, jamii mpya, misimu inayobadilika kwa kasi na aina mpya za matamshi ya chuki.
Pengo linalolengwa na utafiti linaonekana hasa hapa: je, inawezekana kujenga muundo ambao lebo hazitumiki katika hatua ya modeli kuunda makundi, lakini makundi ya tweet yenye maana ya kisemantiki bado yanaweza kugunduliwa?
Pendekezo la waandishi linaunganisha mbinu mbili:
- Uwakilishi wa lugha wa kimuktadha: kubadilisha maana ya tweet kuwa nafasi ya embedding yenye vipimo vingi badala ya kutegemea orodha thabiti za maneno.
- Uunganishaji-makundi wenye upimaji wa uzito wa nafasi ndogo: kupanga pamoja nyaraka na vipimo vya embedding na kujifunza ni nafasi ndogo zipi zinatofautisha zaidi katika kila kundi la nyaraka.
Neno “usiosimamiwa” hapa linamaanisha nini hasa?
Katika utafiti, madarasa ya matamshi ya chuki yaliyowekwa na binadamu hayatumiwi wakati wa kuunda document cluster. Kwa maana hiyo, hatua kuu ya clustering ya SWCC ni isiyosimamiwa.
Hata hivyo, angalau %10 ya lebo zilitumika kuamua ni kundi gani kati ya Cluster 1, Cluster 2 au Cluster 3 linalolingana na “ubaguzi wa rangi”, “ubaguzi wa kijinsia”, “lugha ya kukera isiyo na chuki” au darasa jingine rasmi la mkusanyiko wa data.
Kwa hiyo, maelezo ya tahadhari zaidi kuhusu mbinu ni haya:
SWCC ni mfumo usiosimamiwa katika hatua ya clustering, lakini hutumia kiasi kidogo cha lebo katika kutaja kategoria na katika tathmini ya nje ya utendaji.
Tofauti hii ni muhimu. Usahihi wa %93,1 au alama ya F1 ya %93,5 si utendaji wa mfumo usiotumia lebo kabisa ambao huzalisha kiotomatiki majina yenye maana ya kategoria bila kuangalia lebo yoyote.
Kwa nini HateBERT inatumika?
Hesabu rahisi za maneno zinaweza kushindwa kutofautisha maana ya neno lilelile katika miktadha tofauti. Modeli zinazotegemea BERT zinaweza kubadilisha uwakilishi wa neno kulingana na maneno yanayolizunguka.
Katika modeli ya kidhana ya utafiti, HateBERT hutumika kama kizalishaji cha uwakilishi wa kimuktadha kilichorekebishwa kwa mifumo ya lugha inayohusishwa na ukali wa mawasiliano katika mitandao ya kijamii na matamshi ya chuki.
Kila matini hubadilishwa kuwa nafasi fiche ya kisemantiki yenye jumla ya:
\[ M=768 \]
vipimo. Mkusanyiko wote wa data huwakilishwa kwa matriksi:
\[ X\in\mathbb{R}^{N\times768} \]
ambapo \(N\) ni idadi ya nyaraka/tweet.
Je, vipimo vya embedding ni maneno?
Hapana. Kila moja ya vipimo 768 vya embedding haimaanishi moja kwa moja “rangi”, “jinsia”, “tusi” au maana ya neno fulani. Hivi ni vipengele fiche vya nambari vilivyojifunzwa kwa namna iliyosambazwa ndani ya modeli.
Ili kutoa uwezekano wa kutafsiri matokeo, makala baadaye hutambua token ambazo vipimo vya embedding vyenye uzito mkubwa huziamsha zaidi katika mkusanyiko wa data na kuziunganisha na kategoria za kisemantiki.
Kwa hiyo, ufasiri wa sifa una hatua mbili:
- SWCC huamua ni kipimo fiche/nafasi ndogo ipi muhimu.
- Uchambuzi wa post hoc hujaribu kuhusisha vipimo hivyo fiche na token au dhana ambazo binadamu anaweza kuelewa.
Kwa hiyo maneno yanayoonekana kwenye jedwali si majina ya asili ya safu 768 za BERT; ni matokeo ya safu ya ufasiri wa baadaye iliyofanywa na utafiti.
Co-clustering inafanya nini tofauti?
K-means ya kawaida huweka makundi kwa safu mlalo tu, yaani tweet katika mfano huu. SWCC hupanga mihimili miwili kwa wakati mmoja:
- Safu mlalo: tweet / nyaraka.
- Safu wima: vipimo vya sifa za embedding.
Ugawaji wa tweet kwa kundi huwakilishwa na matriksi:
\[ U\in\{0,1\}^{N\times K} \]
na uanachama wa feature-subspace huwakilishwa na:
\[ V\in\{0,1\}^{M\times L} \]
huonyeshwa kwa matriksi hiyo.
Katika mipangilio ya mwisho ya majaribio ya utafiti, zimechaguliwa:
\[ K=3 \]
makundi ya tweet na:
\[ L=32 \]
nafasi ndogo za sifa.
Uzito wa nafasi ndogo hufanya kazi gani?
Haidhaniwi kwamba kila kategoria ya matamshi ya chuki inahitaji vipimo vilevile vya kisemantiki kwa kiwango sawa. Badala yake, hufafanuliwa matriksi ya uzito:
\[ C\in\mathbb{R}^{K\times L} \]
Thamani:
\[ c_{g,h} \]
inaonyesha kwa kundi la tweet la \(g\) umuhimu wa nafasi ndogo ya \(h\).
Kwa mfano, katika kundi moja vipengele fiche vinavyohisi ulengaji wa utambulisho/kundi vinaweza kuwa na nguvu, ilhali katika kundi jingine vipimo vinavyobeba ukali wa jumla au mifumo ya lugha ya kudhalilisha vinaweza kupata uzito mkubwa zaidi.
Faida ya kinadharia ya mbinu hii ni kwamba badala ya kutoa thamani moja ya kimataifa ya umuhimu kwa vipimo vyote 768, inaweza kujifunza umuhimu wa sifa unaotegemea kundi.
Funksheni ya lengo ya SWCC inafanyaje kazi?
Funksheni kuu ya lengo iliyotolewa katika makala ni:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
iko katika umbo hilo.
Sehemu ya kwanza hujaribu kupunguza umbali wa mraba uliowekewa uzito kati ya kila tweet na kituo cha nafasi ndogo kinachohusiana na kundi lake. Kadiri tweet na centroid zinavyokaribiana, ndivyo kosa la reconstruction/clustering linavyokuwa dogo.
Sehemu ya pili ni kipengele cha regularization kinachotegemea entropy:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Kigezo:
\[ \eta>0 \]
huathiri kiwango ambacho uzito unakuwa umekusanyika au umesawazishwa.
Kwa nini regularization ya entropy inahitajika?
Ikiwa uzito utaachwa huru kabisa, modeli inaweza kukusanya umuhimu wote katika feature chache na kuzalisha suluhisho kali kupita kiasi na lisilo thabiti. Sehemu ya entropy hujaribu kudhibiti tabia hii.
Katika jaribio la unyeti la utafiti:
| \(\eta\) | Silhouette | Tafsiri ya chanzo |
|---|---|---|
| 0,01 | 0,52 | Uzito umetawanyika sana |
| 0,1 | 0,61 | Regularization haitoshi |
| 0,5 | 0,68 | Usawa bora zaidi |
| 1,0 | 0,65 | Regularization kupita kiasi |
| 2,0 | 0,58 | Regularization kupita kiasi |
| 5,0 | 0,49 | Regularization kali kupita kiasi |
Katika jaribio hili:
\[ \eta=0{,}5 \]
ilitoa thamani ya juu zaidi ya Silhouette.
Mtiririko wa kurudia wa algoriti ukoje?
Algoriti ya SWCC katika makala hufuata mbinu ya alternating minimization:
- Makundi ya tweet na feature hupewa hali za awali.
- Tweet huwekwa tena katika makundi kulingana na umbali uliowekewa uzito.
- Cluster centroid husasishwa.
- Vipimo vya feature hupewa tena nafasi ndogo zinazohusika.
- Kwa kila jozi ya cluster–subspace, uzito unaotegemea usambazaji husasishwa.
- Mchakato husimama wakati ugawaji unakuwa thabiti au idadi ya juu ya iteration inafikiwa.
Kwa hivyo makundi ya nyaraka, nafasi ndogo za feature, centroid na uzito wa nafasi ndogo hazihesabiwi mara moja kwa kujitegemea; huathiriana kwa namna ya kurudia.
Gharama ya ukokotoaji ni ipi?
Makala inatoa takriban changamano ya iteration moja kuwa:
\[ O(NKML) \]
Wakati:
\[ K=3,\qquad L=32,\qquad M=768 \]
kuna takriban:
\[ 7{,}4\times10^4 \]
shughuli za msingi kwa kila waraka.
Kwa mujibu wa makadirio ya ukubwa ya waandishi, kwa \(N=10^6\) na kiwango cha iteration 50, jumla ya shughuli inaweza kuwa takriban:
\[ 3{,}7\times10^{12} \]
Kwa hiyo utafiti unaeleza kwamba utekelezaji uliosambazwa unaweza kuhitajika katika kiwango cha mamilioni ya nyaraka.
Jaribio halisi lilichukua muda gani?
Katika sehemu ya reproducibility, kwa mkusanyiko wa data wa Davidson, utoaji wa embedding uliripotiwa kuchukua:
\[ 2887\ \text{saniye} \]
yaani takriban dakika 48.
Kwa SWCC zilitumika iteration 30 na takriban sekunde 2–3 kwa kila iteration ziliripotiwa. Muda wa pipeline nzima ulitolewa kuwa takriban dakika 50–55.
Matriksi ya embedding iliripotiwa kuwa na ukubwa:
\[ 24.783\times768 \]
na kutumia takriban 72,61 MB ya kumbukumbu.
Ni mikusanyiko gani ya data iliyotumika?
Utafiti unatumia mikusanyiko miwili ya data ya Twitter ya Kiingereza:
| Mkusanyiko wa data | Ukubwa ulioripotiwa katika chanzo | Lengo la matumizi |
|---|---|---|
| Davidson na wenz. (2017) | 24.783 tweet | Majaribio kuhusu matamshi ya chuki / lugha ya kukera / maudhui yasiyoegemea upande |
| Waseem (2016) | 16.000 tweet zimeripotiwa | Tathmini kuhusu ubaguzi wa rangi / ubaguzi wa kijinsia / madarasa mengine |
Kwa sababu kuna kutokuwiana muhimu katika matini chanzi kuhusu mgawanyo wa madarasa kwa upande wa reproducibility, uwiano huu haupaswi kuchapishwa tena kama “mgawanyo sahihi wa mkusanyiko wa data” bila kuthibitishwa. Hoja hii inapaswa kuzingatiwa tofauti wakati wa kutathmini matokeo ya kimetodolojia ya makala.
Usindikaji wa awali wa data ulifanywaje?
Lengo lilikuwa kusafisha URL, majina ya watumiaji, alama za hashtag, alama za uakifishaji, stop-word na kelele mbalimbali za mitandao ya kijamii kwenye tweet. Imeripotiwa kuwa slang na vifupisho vilibadilishwa kwa maana zake zinazolingana, na emoticon pia zilibadilishwa kuwa maneno ya maelezo.
Katika uchambuzi wa preprocessing wa utafiti, iliripotiwa kwamba kwa wastani takriban:
\[ 19{,}1 \]
alama ziliondolewa kwa kila tweet.
Mchakato huu unalenga kuipa modeli ya embedding matini iliyosanifishwa zaidi. Hata hivyo, kwa kuzingatia kwamba hashtag au ishara za mitandao ya kijamii zinaweza kubeba muktadha wa matamshi ya chuki katika baadhi ya hali, utafiti haukupima kwa jaribio tofauti la ablation ikiwa maamuzi ya kusafisha yalisababisha upotevu wa taarifa.
Kwa nini \(K=3\) ilichaguliwa?
Kwa idadi ya tweet cluster:
\[ K=2,\ldots,10 \]
tathmini ya Within-Cluster Sum of Squares ilifanywa katika safu hiyo. Utafiti unaripoti kuwa WCSS ilipungua kwa %23,7 wakati wa kutoka \(K=2\) hadi \(K=3\), na hivyo kuchagua sehemu ya elbow kuwa \(K=3\).
Mchoro 7 pia unaonyesha vipimo vya Silhouette, Davies–Bouldin na Calinski–Harabasz. Hata hivyo, optimum za faharasa hizi saidizi kwenye grafu haziungani kikamilifu katika sehemu moja. Kwa hiyo, uchaguzi wa \(K=3\) unapaswa kufafanuliwa kwa usahihi zaidi kama suluhisho la makundi matatu linalopendelewa na uchambuzi wa elbow.
Kwa nini \(L=32\)?
Kwa kuwa idadi ya vipimo vya embedding ni:
\[ M=768 \]
utafiti huamua idadi ya feature-subspace kwa square-root heuristic kama:
\[ L\approx\sqrt{768}\approx32 \]
ndivyo idadi hiyo inavyoamuliwa.
Uchaguzi huu si optimum sahihi iliyojifunzwa kutoka kwenye data; ni uchaguzi wa hyperparameter unaotokana na heuristic iliyotumika.
Ubora wa ndani wa clustering ulionyesha nini?
Kwa SWCC, utafiti unaripoti metrika nne kuu za uthibitishaji wa ndani:
| Metrika | Matokeo ya SWCC | Mwelekeo wa tafsiri |
|---|---|---|
| Silhouette | 0,68 | Thamani kubwa ni utengano bora |
| Davies–Bouldin | 0,85 | Thamani ndogo ni bora |
| Calinski–Harabasz | 1580,5 | Thamani kubwa ni bora |
| Dunn | 0,43 | Thamani kubwa ni utengano bora |
Thamani za Silhouette zilizoripotiwa katika ulinganisho wa marudio kumi ni hizi:
| Mbinu | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Chanzo kinaripoti kuwa katika jedwali hilohilo SWCC pia ilitoa matokeo bora kuliko mbinu zilizolinganishwa kwa thamani za DB, CH na Dunn.
Ni nini kilipatikana katika tathmini ya nje?
Baada ya makundi kuundwa, %10 ya lebo zilitumika kwa cluster-to-category mapping na kwenye mkusanyiko wa data wa Waseem zikaripotiwa:
\[ \mathrm{Accuracy}=93{,}1\% \]
na:
\[ F1=93{,}5\% \]
zimeripotiwa.
Utafiti pia unaripoti kwa macro F1 ya kiwango cha darasa:
\[ 0{,}89 \]
na kwa racism, neither na sexism kwa mtiririko huo takriban:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
thamani za F1.
Hata hivyo, confusion matrix kamili haikuchapishwa katika chanzo; ilisemwa kuwa “inapatikana kwa ombi”. Aidha, kwa sababu ya tatizo la kuripoti uwiano wa madarasa katika mkusanyiko wa data, kuzalisha upya matokeo ya kiwango cha darasa ni muhimu hasa.
Je, inaweza kusemwa kuwa ilizidi modeli zinazosimamiwa?
Katika Jedwali 7 la makala, thamani ya F1 ya SWCC inaonekana kuwa juu kuliko baadhi ya matokeo ya fasihi ya mbinu zinazosimamiwa. Kwa mfano, chanzo kinatoa %93,1 F1 kwa GLTR+BERT, %90,9 kwa BERTweet-large na thamani za chini kwa baadhi ya mbinu nyingine.
Lakini utafiti huohuo pia unasema kwamba ulinganisho wa moja kwa moja na mbinu zinazosimamiwa kikamilifu si sahihi. Sababu ni:
- viwango vya matumizi ya lebo vinatofautiana,
- protokali za train/test si sawa,
- makala tofauti zina maamuzi tofauti ya usindikaji wa data,
- katika SWCC lebo hutumika baadaye kwa lengo la cluster mapping.
Kwa hiyo hitimisho salama zaidi ni:
“SWCC inaonekana kuwa na ushindani na baadhi ya matokeo ya fasihi kwa kuzingatia alama zilizoripotiwa.”
ndilo hitimisho salama zaidi.
“Imethibitishwa kuwa bora kuliko modeli zote zinazosimamiwa katika hali sawa za majaribio.”
haliwezi kutolewa kutokana na muundo huu wa majaribio.
Utafiti wa ablation unaonyesha nini kuhusu mekanizimu kuu?
Mojawapo ya ulinganisho safi zaidi uliodhibitiwa katika utafiti ni jaribio la ablation lililofanywa kwa kubadilisha mekanizimu ya feature-weighting ya mfumo uleule wa SWCC.
Modeli kamili ilifikia:
\[ S=0{,}68 \]
kwa Silhouette, huku zikishuhudiwa:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
zimeripotiwa.
Matokeo haya yanaunga mkono kwamba katika mazingira ya majaribio yaliyotathminiwa, si tu muundo wa co-clustering bali pia mekanizimu ya subspace weighting iliyojifunzwa na mahususi kwa cluster huchangia utendaji.
Je, uwezo wa kuelezeka unapatikana kweli?
Mojawapo ya faida za SWCC ni uwezo wa kuonyesha ni nafasi ndogo zipi zinapata uzito mkubwa kwa kila cluster. Kisha chanzo huunganisha vipimo hivyo vya embedding na token zinazoonyesha uamsho mkubwa na kutoa vikundi vya maneno vinavyohusishwa na chuki ya kikabila, matamshi ya kibaguzi wa kijinsia na lugha ya kukera isiyo ya chuki.
Hata hivyo, mipaka miwili ya kisayansi lazima ihifadhiwe.
Kwanza, hakuna usawa wa moja kwa moja wa kisemantiki wa moja-kwa-moja kati ya embedding dimension na dhana inayoeleweka na binadamu. Ulinganishaji huu ni post hoc.
Pili, waandishi wenyewe wanaacha kama swali la wazi la utafiti kwamba katika siku zijazo sifa zenye uzito mkubwa zinapaswa kuchunguzwa na watathmini huru wa kibinadamu.
Kwa hiyo, badala ya kuthibitisha kuwa umeunda “AI inayoelezeka kikamilifu”, utafiti hutoa njia ya ziada ya ufasiri katika kiwango cha uzito wa sifa ikilinganishwa na embedding za kawaida za black-box.
Je, implicit hate speech ilijaribiwa kweli?
Hapana. Katika utangulizi wa utafiti inaelezwa kwamba matamshi ya chuki fiche yanaweza kujitokeza kupitia sarcasm, lugha iliyosimbwa au kauli zisizo za moja kwa moja zisizo na tusi la wazi.
Hata hivyo, waandishi wanasema wazi:
tathmini ya kimajaribio ilifanywa kwenye mikusanyiko ya data ya Davidson na Waseem ya explicit-hate
na kwamba mikusanyiko ya dedicated implicit-hate itatumika siku zijazo.
Kwa hiyo, hitimisho kwamba utafiti:
“umegundua kwa mafanikio matamshi ya chuki fiche”
haliwezi kutolewa kutokana na jaribio la sasa.
Je, kuna matokeo kwa lugha zenye rasilimali chache?
Utafiti unapendekeza kuwa kupunguza hitaji la uannishaji kunaweza kuwa na manufaa kwa lugha zenye rasilimali chache. Hata hivyo, majaribio yote ni ya Kiingereza na modeli ya embedding iliyotumika pia inalenga Kiingereza.
Katika mpango wa kazi za baadaye, waandishi wanapendekeza kuchunguza muundo wa utambuzi wa lugha + subspace weighting mahususi kwa lugha kwa kutumia modeli za lugha nyingi kama XLM-RoBERTa na mBERT.
Kwa hiyo, matumizi kwa lugha zenye rasilimali chache kwa sasa ni mwelekeo unaowezekana wa matumizi, si matokeo yaliyothibitishwa.
Hii inamaanisha nini kwa Uturuki na Kituruki?
Kwa kuwa utafiti haukutumia data ya Kituruki, hakuna matokeo ya moja kwa moja ya utendaji kwa maudhui ya mitandao ya kijamii nchini Uturuki.
Katika toleo litakalohamishiwa Kituruki, haitoshi kutumia tu modeli ya Kiingereza kwa tweet za Kituruki. Muundo ambatani wa Kituruki, slang za eneo, ubaguzi fiche unaotegemea muktadha, kubadilisha msimbo, tofauti za uandishi na sifa mahususi za lugha ya mitandao ya kijamii nchini Uturuki zinahitaji utafiti mpya wa embedding na uthibitishaji wa kibinadamu.
Kwa hiyo, utafiti si modeli tayari ya moderesheni kwa Uturuki; unaonyesha usanifu wa clustering unaoweza kupimwa kando kwa Kituruki.
Matokeo yanayoungwa mkono na utafiti
- Katika mikusanyiko ya data ya Twitter ya Kiingereza iliyotathminiwa, SWCC ilitoa matokeo bora kuliko mbinu zisizosimamiwa zilizolinganishwa kwa metrika za ndani za clustering zilizoripotiwa.
- Utafiti wa ablation unaonyesha kuwa ubora wa clustering hupungua adaptive subspace weighting inapoondolewa au kuvurugwa.
- Uundaji wa makundi ulifanywa bila kutumia ground-truth label.
- Baada ya post hoc cluster mapping kwa kutumia %10 ya lebo, thamani kubwa za Accuracy na F1 ziliripotiwa katika tathmini ya Waseem.
- Cluster-specific subspace weights zinaonyesha kuwa maeneo tofauti ya feature yanaweza kuwa muhimu katika makundi tofauti.
- Sehemu muhimu ya vigezo vya ukokotoaji na reproducibility vya mfumo imeripotiwa wazi katika chanzo.
Matokeo ambayo utafiti hauungi mkono au haujathibitisha
- Mfumo si usiotumia lebo kabisa kuanzia mwanzo hadi mwisho; %10 label hutumika kwa category mapping.
- Mafanikio ya implicit hate speech hayajajaribiwa moja kwa moja.
- Hakuna mafanikio yaliyoonyeshwa kwa Kituruki au lugha nyingine zenye rasilimali chache.
- Cross-platform generalizability haijajaribiwa kwenye Facebook, YouTube, TikTok au majukwaa mengine.
- Jedwali 7 si head-to-head supervised benchmark iliyodhibitiwa chini ya protokali sawa ya train/test.
- Uzito wa feature si vipimo vya maana vilivyofafanuliwa moja kwa moja na binadamu.
- Haijathibitishwa kwa utafiti huru wa watumiaji kwamba cluster zinaendana kikamilifu na taksonomia ya kibinadamu ya matamshi ya chuki.
- Mfumo haujafanyiwa majaribio ya uga katika miundombinu halisi ya mitandao ya kijamii ya wakati halisi yenye mamilioni ya watumiaji.
- Kwa sababu ya Hard assignment, uwezekano kwamba tweet moja inaweza kuwa katika zaidi ya kategoria moja ya chuki kwa wakati mmoja haujaundwa katika toleo la sasa.
Mbinu na Matokeo ya Utafiti
Hatua nne kuu za mtiririko wa mbinu
Mchoro 1 na Mchoro 2 kwenye ukurasa wa 5 wa utafiti chanzi unaonyesha mfumo kama pipeline yenye hatua nne:
- Usindikaji wa awali wa data: kusafisha na kunormalisha matini ya mitandao ya kijamii.
- Feature embedding: kubadilisha matini kuwa uwakilishi wa kisemantiki wenye vipimo 768 kwa modeli inayotegemea BERT.
- SWCC: kuunganisha kwa makundi tweet na nafasi ndogo za feature kwa pamoja, na kujifunza uzito wa cluster-specific.
- Tathmini: tathmini ya nje kwa metrika za ndani za clustering na post hoc category mapping yenye %10 ya lebo.
Matokeo manne makuu ya modeli
| Kitu | Maana | Kipimo cha jaribio kilichoripotiwa katika chanzo |
|---|---|---|
| \(U\) | Matriksi ya uanachama wa Tweet → cluster | Imeripotiwa kama \((19.971,3)\) |
| \(V\) | Matriksi ya uanachama wa Feature dimension → subspace | \((768,32)\) |
| \(Z\) | Muundo wa Centroid | Katika sehemu ya majaribio imeripotiwa kama \((3,768)\) |
| \(C\) | Uzito wa Cluster → subspace | \((3,32)\) |
Kuna tofauti isiyoelezwa katika chanzo kati ya \(U=(19.971,3)\) hapa na matriksi ya embedding yenye tweet 24.783 iliyotolewa katika sehemu nyingine za utafiti.
Ulinganisho wa metrika za ndani
| Mbinu | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Chanzo kinaeleza kuwa thamani hizi ni wastani ± mkengeuko wa kawaida wa utekelezaji 10.
Verianla Live: Athari ya upimaji wa uzito unaobadilika kwenye matokeo ya ablation
Katika jedwali hilohilo la ablation, kwa full SWCC zimeripotiwa:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
Katika modeli isiyo na upimaji wa uzito, thamani hizi kwa mtiririko huo zilikuwa:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
ndivyo zilivyokuwa.
Jaribio hili lililodhibitiwa ni mojawapo ya ushahidi wenye nguvu zaidi wa mekanizimu ya utafiti; kwa sababu kinacholinganishwa si mifumo kutoka makala tofauti, bali variants za usanifu uleule zenye mabadiliko katika kipengele cha weighting.
Tathmini ya nje ya Waseem
| Modeli | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Haijatolewa katika chanzo | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Haijatolewa katika chanzo | %46,2 |
| BERTweet trained on GPT-4 | Haijatolewa katika chanzo | %90,1 |
Wakati wa kutathmini jedwali hili, inapaswa kukumbukwa kuwa matumizi ya lebo na protokali za majaribio za mbinu hizo si sawa. Maelezo ya chanzo yenyewe yanasisitiza kwamba SWCC hutumia %10 ya label kwa post hoc cluster mapping, ilhali ulinganisho wa supervised kwa kawaida hutumia sehemu kubwa zaidi za train zilizo na lebo.
Mazingira ya programu yaliyotolewa kwa reproducibility
| Kipengele | Thamani iliyotolewa katika chanzo |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| Urefu wa juu wa HateBERT | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| Idadi ya iteration za SWCC | 30 |
Mazingira ya maunzi
Utafiti unaripoti mazingira ya Google Colab yenye takriban 12–25 GB RAM, 2 vCPU Intel Xeon na, kulingana na mgao wa kikao, NVIDIA Tesla V100 au T4 GPU.
Taarifa hizi zina manufaa kwa reproducibility. Hata hivyo, kwa kuwa jina la modeli ya embedding iliyotumiwa limetolewa kwa namna tofauti katika sehemu mbalimbali, kutumia programu na thamani zilezile za seed pekee hakuhakikishi urudufishaji wa moja-kwa-moja.
Kutokuwiana kwa utambulisho wa modeli ndani ya chanzo
Katika sehemu ya mbinu, modeli iliyotumika imetajwa kuwa:
GroNLP/HateBERT
ilhali katika sehemu ya reproducibility imeandikwa:
Hate-speech-CNERG/bert-base-uncased-hatexplain
ndivyo ilivyoandikwa.
Kwa kuwa hizi ni vyanzo tofauti vya modeli, maswali yafuatayo hayawezi kujibiwa kwa uhakika kutoka katika matini chanzi:
- Embedding zenye vipimo 768 zilizoripotiwa zilitolewa kutoka checkpoint ipi?
- Model fallback iliingia katika hali gani?
- Majedwali ya mwisho ya utendaji yanahusiana na checkpoint ipi?
- Je, matokeo ya SWCC ya checkpoint tofauti yalijaribiwa kando?
Kwa hiyo matini ya Verianla haibadilishi kimya kimya matokeo yote kuwa “matokeo ya asili ya GroNLP HateBERT”.
Kutokuwiana kwa mikusanyiko ya data ndani ya chanzo
Kwa mkusanyiko wa data wa Waseem, asilimia za madarasa zilizotolewa katika chanzo kwa jumla zinazidi %100. Mgawanyo wa %22,8 / %51,8 / %25,4 ulioripotiwa kwa mkusanyiko wa data wa Davidson pia hauendani na mgawanyo wa darasa unaojulikana sana wa mkusanyiko wa kawaida wa Davidson unaorejelewa na utafiti.
Tatizo hili halibatilishi moja kwa moja ufafanuzi wa kihisabati wa mbinu ya clustering; lakini ni muhimu kwa uzalishaji upya wa kujitegemea wa ni mgawanyo gani kamili wa label na toleo gani la data lililotumika kuzalisha matokeo ya Accuracy/F1.
Kutokuwiana katika uwakilishi wa centroid na uzito wa awali
Jedwali la notation ya kihisabati linafafanua centroid kama:
\[ Z\in\mathbb R^{K\times L} \]
ilhali katika sehemu ya utekelezaji imetolewa:
\[ Z=(3,768) \]
ikiwa na kipimo cha \(K\times M\).
Vivyo hivyo, katika maelezo kabla ya algoriti uzito wa awali umetajwa kuwa \(1/K\), ilhali ndani ya Algorithm 1 imeandikwa:
\[ C^{(0)}\leftarrow[1/L] \]
ndivyo ilivyoandikwa.
Tofauti hizi ni mambo yanayohitaji kufafanuliwa hasa kwa watafiti wanaotaka kutekeleza upya mbinu kutoka kwenye msimbo.
Nguvu kuu za modeli
- Haihitaji madarasa ya ground-truth wakati wa kuunda makundi.
- Huunda modeli ya miundo ya tweet na feature subspace kwa wakati mmoja.
- Hujifunza uzito tofauti wa umuhimu wa feature/subspace kwa kila kundi.
- Mekanizimu ya upimaji wa uzito imejaribiwa kwa ablation.
- Huripoti metrika nyingi za ndani za clustering.
- Hutoa uchambuzi wa unyeti wa hyperparameter.
- Hushiriki sehemu muhimu ya taarifa za toleo la programu, seed, maunzi na runtime.
- Haipunguzi matokeo ya kundi kuwa thamani moja tu ya Accuracy, bali pia huyatathmini kwa metrika za muundo wa ndani.
Vikwazo vikuu
- Majaribio yalifanywa kwenye data ya Twitter ya Kiingereza pekee.
- Hakuna dedicated test set iliyotumiwa kwa implicit hate.
- %10 label inahitajika kwa kutaja kategoria.
- Hard cluster assignment inatumika; uanachama wa kategoria nyingi/zinazopishana hauundwi.
- Ubora wa embedding unategemea modeli ya lugha iliyochaguliwa.
- Ufasiri wa feature-to-word ni post hoc na haujathibitishwa na tathmini huru ya kibinadamu.
- Hakuna cross-platform test.
- Kuna kutokuwiana ndani ya chanzo katika uwiano wa madarasa ya mkusanyiko wa data.
- Utambulisho wa transformer checkpoint iliyotumika umeripotiwa kwa namna mbili tofauti.
- Tofauti kati ya embedding 24.783 na safu 19.971 za cluster-assignment haijaelezwa.
- Ulinganisho wa jedwali na modeli za supervised hautokani na protokali moja ya pamoja ya majaribio.
Utafiti wa baadaye
Waandishi wanapendekeza mielekeo minne mikuu:
- Lugha nyingi: kuchunguza nafasi ndogo mahususi kwa lugha na zinazoshirikiwa za matamshi ya chuki kwa modeli kama mBERT au XLM-RoBERTa.
- Uthibitishaji unaoweza kutafsiriwa na binadamu: annotator wachunguze feature zenye uzito mkubwa ili kuthibitisha maana ya cluster.
- Ulinganisho wa modeli za embedding: kupima modeli mbadala zinazoweka usawa kati ya domain specificity, gharama ya ukokotoaji na uelewa wa kimuktadha.
- Fuzzy clustering: upanuzi wa probabilistic/fuzzy unaoruhusu tweet kuwa na uanachama wa sehemu katika kategoria zaidi ya moja.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asilia: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Waandishi: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Mwandishi wa kwanza sawa/mchango sawa: Chanzo hakina taarifa ya mwandishi wa kwanza sawa au mchango sawa.
Mwandishi wa mawasiliano: Maya Sultan ALGhafri.
Taasisi: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na rika; utafiti wa uchakataji wa lugha asilia, ujifunzaji wa mashine na clustering.
Jarida: AI.
Mchapishaji: MDPI, Basel, Uswisi.
Rekodi ya bibliografia: AI, 2026, Juzuu 7, Toleo 6, Makala 204.
DOI: 10.3390/ai7060204.
Kupokelewa / marekebisho / kukubaliwa / kuchapishwa: 26 Aprili 2026 / 20 Mei 2026 / 27 Mei 2026 / 4 Juni 2026.
Hali ya mapitio: Ni chapisho la jarida lililopitiwa na rika.
Leseni: Creative Commons Attribution (CC BY).
Wahariri wa kitaaluma: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Mbinu kuu: Subspace Weighting Co-Clustering (SWCC) pamoja na embedding za kimuktadha zinazotegemea BERT.
Muundo wa SWCC: Makundi ya tweet \(U\), ugawaji wa feature-subspace \(V\), muundo wa centroid \(Z\) na matriksi ya cluster-specific subspace weighting \(C\) huboreshwa kwa pamoja kwa namna ya kurudia.
Kipimo cha embedding katika majaribio: 768.
Idadi ya tweet cluster: \(K=3\).
Idadi ya feature-subspace: \(L=32\).
Regularization: \(\eta=0,5\).
Mikusanyiko mikuu ya data: Mkusanyiko wa Davidson et al. (2017) Hate Speech and Offensive Language na mkusanyiko wa data wa Twitter hate-speech wa Kiingereza wa Waseem/Hovy.
Matumizi ya lebo: Imeripotiwa kwamba ground-truth label haitumiki wakati wa Cluster formation. Kwa category mapping na evaluation ya nje, angalau %10 ya label hutumika post hoc. Kwa hiyo, ingawa kiini cha clustering cha mfumo hakisimamiwi, uzalishaji wa kategoria kuanzia mwanzo hadi mwisho si usio na lebo kabisa.
Matokeo muhimu zaidi ya clustering ya ndani: Kwa SWCC, Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Matokeo ya nje yaliyoripotiwa kwenye Waseem: %93,1 Accuracy na %93,5 F1; baada ya post hoc cluster-to-category mapping kwa kutumia %10 label.
Matokeo ya ablation: Silhouette katika SWCC kamili 0,68; bila weighting 0,55; kwa random weighting 0,47; kwa equal weighting 0,51.
Changamano ya ukokotoaji: Chanzo kinatoa iteration moja ya SWCC kuwa \(O(NKML)\).
Runtime iliyotolewa katika chanzo: Uzalishaji wa embedding takriban sekunde 2887; SWCC iteration 30; takriban sekunde 2–3 kwa kila iteration; pipeline kamili takriban dakika 50–55.
Mazingira ya majaribio: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Ufadhili: Utafiti unaripoti kwamba haukupokea ufadhili wa nje.
Bodi ya maadili: Imeelezwa kuwa haitumiki.
Ridhaa yenye taarifa: Imeelezwa kuwa haitumiki.
Upatikanaji wa data: Chanzo kinaeleza kwamba mikusanyiko ya data ya Davidson na Waseem ilipatikana kutoka repository zilizo wazi.
Michango ya waandishi: Uundaji wa dhana M.S.A.; metodolojia M.S.A. na I.K.; programu, uthibitishaji, uchambuzi rasmi, uchunguzi, rasilimali, uratibu wa data, rasimu ya kwanza na uonyeshaji M.S.A.; mapitio na uhariri M.S.A.; usimamizi I.K. na A.A.; usimamizi wa mradi na upatikanaji wa ufadhili M.S.A., kama ilivyoripotiwa.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Maelezo muhimu ya reproducibility kwa uaminifu kwa chanzo
Katika sehemu ya mbinu ya utafiti, modeli ya embedding inaelezwa kama GroNLP/HateBERT, ilhali katika sehemu ya reproducibility jina Hate-speech-CNERG/bert-base-uncased-hatexplain limetolewa. Checkpoint hizi mbili si modeli ileile. Kwa hiyo haiwezekani kubainisha kwa uhakika kutoka katika matini chanzi ni checkpoint ipi iliyozalisha majedwali ya mwisho ya utendaji.
Aidha, kuna kutokuwiana katika mgawanyo wa madarasa ya mikusanyiko ya data iliyotumika, ndani ya chanzo na pia dhidi ya vyanzo asilia vya data. Kwa Waseem, uwiano katika Jedwali 4 unazidi %100 kwa jumla. Uwiano wa madarasa ulioripotiwa kwa Davidson pia hauendani na mgawanyo wa label katika faili ya kawaida ya data iliyo wazi. Kwa hiyo, hasa wakati wa kuiga kwa kujitegemea thamani za external Accuracy/F1, toleo la data ghafi na matokeo ya preprocessing yanapaswa kuthibitishwa.
Katika notation ya kihisabati pia kuna maelezo tofauti kuhusu kipimo cha matriksi ya centroid \(Z\) na uzito wa awali wa subspace. Aidha, kauli “Please remove it from the final published version.” iliyobaki katika matini iliyochapishwa baada ya Algorithm 1 ni mabaki ya mchakato wa uhariri.
Kutokuwiana huku hakujageuzwa kimya kimya kuwa toleo moja “sahihi” katika matini ya Verianla. Sababu ni kwamba utafiti chanzi hauelezi kwa uhakika ni mbadala upi unaowakilisha msimbo halisi wa majaribio wa waandishi.
Kikomo cha tafsiri ya kisayansi
Thamani za %93,1 Accuracy na %93,5 F1 katika utafiti huu si matokeo ya mfumo wa kuainisha matamshi ya chuki unaojiendesha kikamilifu na kutumia lebo sifuri za binadamu. %10 ya lebo hutumika kwa ulinganishaji wa kategoria wa post hoc.
Ingawa motisha ya utafiti kuhusu implicit hate speech ni muhimu, matokeo ya majaribio yanategemea mikusanyiko ya data ya Davidson na Waseem inayolenga explicit-hate. Kwa hiyo hakuna kiwango cha mafanikio ya implicit hate kilichoripotiwa.
Ulinganisho na modeli za supervised katika Jedwali 7 pia si jaribio moja la benchmark linalotumia train/test split, preprocessing na bajeti ya label sawa. Kwa hiyo, SWCC kuzidi baadhi ya alama zilizochapishwa hakupaswi kufasiriwa kama ushahidi wa ubora wa takwimu uliodhibitiwa dhidi ya modeli zote hizo.
Hatimaye, modeli imetathminiwa kwenye data ya Twitter ya Kiingereza pekee. Lugha nyingine, majukwaa mengine ya mitandao ya kijamii na mifumo halisi ya moderesheni ya wakati halisi zinahitaji uthibitishaji tofauti.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *