

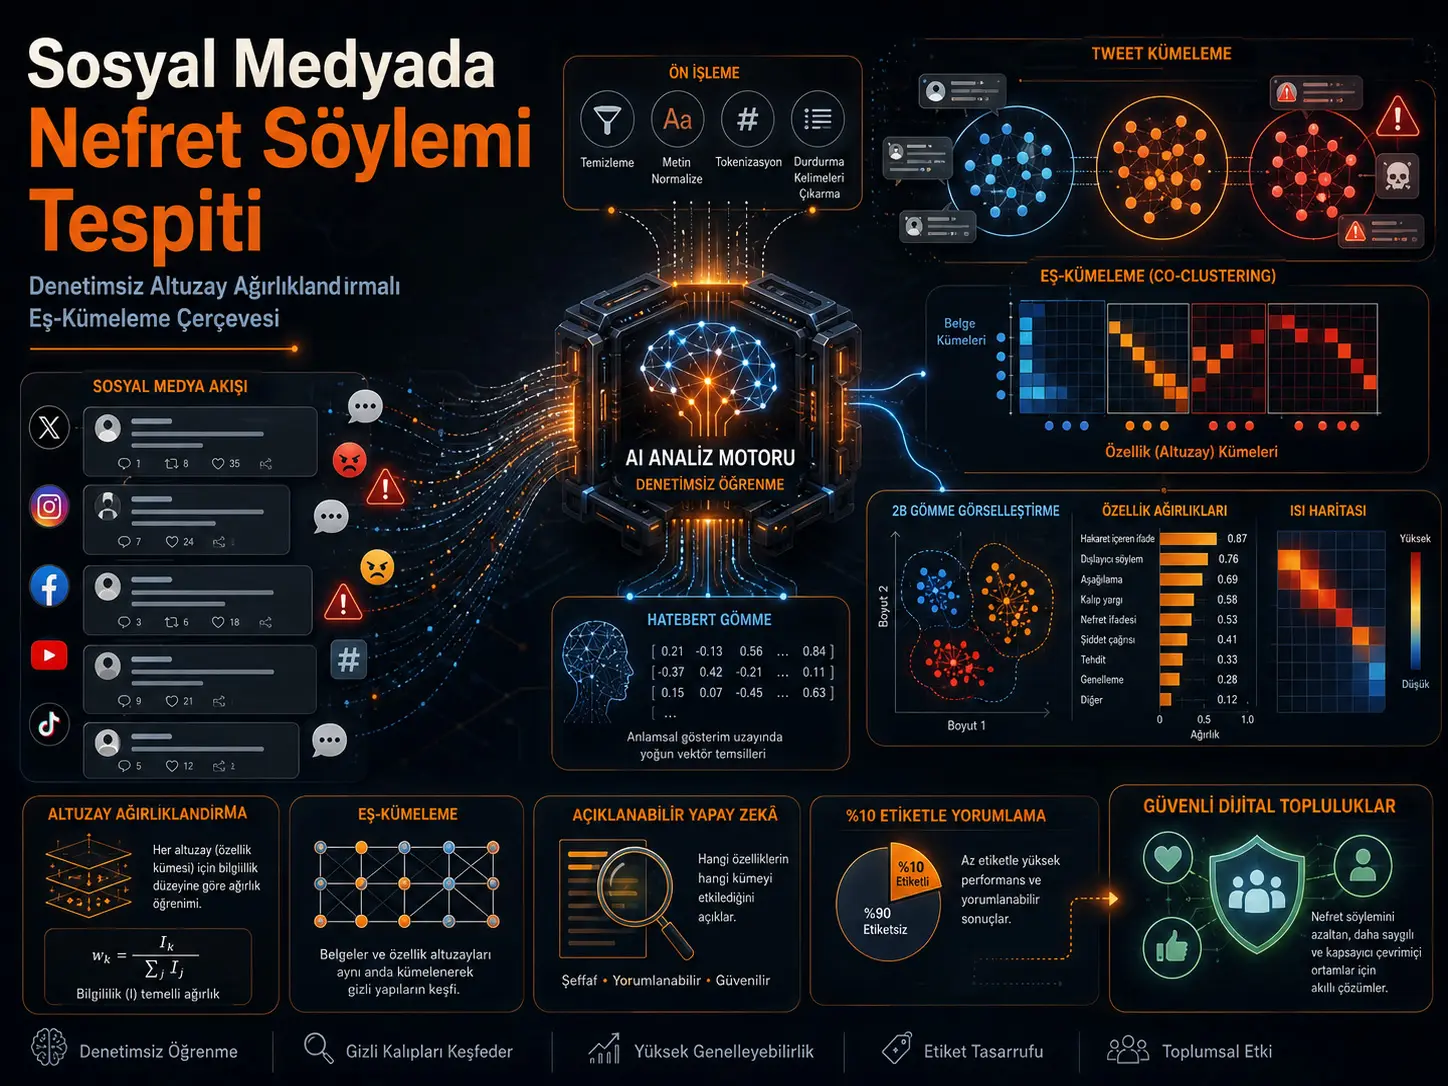
Ushbu tadqiqot ijtimoiy tarmoqlardagi ingliz tilidagi nafrat nutqi naqshlarini katta hajmdagi belgilangan oʻquv maʼlumotlariga ehtiyoj sezmasdan aniqlash maqsadida Subspace Weighting Co-Clustering (SWCC; subfazo vaznlashga asoslangan ko-klasterlash) deb nomlangan usulni taklif qiladi. Tizim matnlarni 768 oʻlchamli kontekstual embeddinglarga aylantiruvchi BERT-asosidagi til modelidan boshlanadi; soʻng tweetlarni va ushbu embedding fazosidagi xususiyat oʻlchamlarini bir vaqtning oʻzida klasterlaydi hamda har bir klaster uchun turli subfazo vaznlarini oʻrganadi. Mualliflar hisobotiga koʻra, SWCC ichki klasterlash baholashida 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz va 0,43 Dunn qiymatlariga erishadi. Waseem maʼlumotlar toʻplamidagi tashqi baholashda esa klasterlar hosil qilingandan keyin yorliqlarning %10'i kategoriyalarni moslashtirish uchun ishlatilganda %93,1 aniqlik va %93,5 F1 balli qayd etilgan. Biroq tadqiqot butunlay yorliqsiz uchidan-uchigacha tasniflagich emas; kategoriya nomlarini tayinlash uchun belgilangan validatsiya quyi toʻplami talab qilinadi. Bundan tashqari, foydalanilgan model identifikatori va maʼlumotlar toʻplamlarining sinf taqsimotlari borasida manba matnda qayta ishlab chiqilishiga taʼsir qilishi mumkin boʻlgan nomuvofiqliklar mavjud.
Tadqiqotning asosiy gʻoyasi shundan iboratki, nafrat nutqining barcha turlari bir xil lingvistik xususiyatlarga teng darajada tayanmaydi. Irqqa asoslangan nafrat, seksistik nutq va nafratni oʻz ichiga olmaydigan haqoratli til turli semantik oʻlchamlarda jamlanishi mumkin. Shu sababli SWCC faqat tweetlarni klasterlarga ajratibgina qolmaydi; 768 oʻlchamli embedding fazosini ham subfazolarga boʻladi va har bir tweet klasteri uchun ushbu subfazolarga moslashuvchan ahamiyat vaznlarini beradi. Ablation tajribasida oʻrganilgan vaznlash olib tashlanganda Silhouette balli 0,68 dan 0,55 gacha, vaznlar tasodifiy tanlanganda 0,47 gacha va teng saqlanganda 0,51 gacha pasayadi. Bu natija oʻrganilgan maʼlumotlar va tajriba tuzilmasida adaptiv vaznlash klasterlarning ajralishiga hissa qoʻshishini qoʻllab-quvvatlaydi.
Biroq maqolaning “yashirin nafrat nutqi” va “kam resursli tillar” uchun kengroq qoʻllash haqidagi daʼvolari hali tajribada tasdiqlanmagan. Tajribalar ingliz tilidagi Twitter maʼlumotlarida va mualliflarning oʻz ifodasiga koʻra explicit hate maʼlumotlar toʻplamlarida oʻtkazilgan. Shu sababli tadqiqot turli platformalar, turli tillar yoki bevosita implicit hate maʼlumotlar toʻplamlariga umumlashtirilgan muvaffaqiyat isbotini taqdim etmaydi.
Nega klassik nazoratli nafrat nutqini aniqlashdan farqli yondashuv izlanmoqda?
Nafrat nutqini aniqlashda keng tarqalgan usul oldindan insonlar tomonidan tasniflangan minglab yoki millionlab matnlardan foydalanib tasniflagichni oʻqitishdir. Ushbu yondashuv yuqori samaradorlik berishi mumkin boʻlsa-da, yangi tillar, yangi hamjamiyatlar, tez oʻzgaruvchi jargon va yangi nafrat nutqi shakllari uchun uzluksiz annotatsiya xarajatini keltirib chiqaradi.
Tadqiqot nishonga olayotgan boʻshliq aynan shu yerda paydo boʻladi: yorliqlar modelning klaster yaratish bosqichida ishlatilmaydigan, biroq semantik jihatdan mazmunli tweet guruhlarini baribir aniqlash mumkin boʻlgan tuzilmani qurish mumkinmi?
Mualliflar taklifi ikkita texnikani birlashtiradi:
- Kontekstual til vakilligi: tweet maʼnosini qatʼiy soʻz roʻyxatlaridan koʻra koʻp oʻlchamli embedding fazosiga aylantirish.
- Subfazo vaznlashga asoslangan ko-klasterlash: ham hujjatlarni, ham embedding oʻlchamlarini birgalikda tartibga solish va har bir hujjat klasterida qaysi subfazolar koʻproq farqlovchi ekanini oʻrganish.
Bu yerda “nazoratsiz” soʻzi aniq nimani anglatadi?
Tadqiqotda document cluster'lari yaratilayotgan paytda inson tomonidan berilgan nafrat nutqi sinflari ishlatilmaydi. Shu jihatdan SWCC ning asosiy klasterlash bosqichi nazoratsizdir.
Biroq hosil qilingan Cluster 1, Cluster 2 yoki Cluster 3 kabi klasterlarning qaysi biri “irqchilik”, “seksistik”, “nafratni oʻz ichiga olmaydigan haqoratli til” yoki maʼlumotlar toʻplamining boshqa rasmiy sinfiga mos kelishini aniqlash uchun yorliqlarning kamida %10'i ishlatilgan.
Shuning uchun usulning eng ehtiyotkor taʼrifi quyidagicha:
SWCC klasterlash bosqichida nazoratsiz, kategoriya nomlash va tashqi samaradorlikni baholashda minimal miqdordagi yorliqlardan foydalanadigan doiradir.
Bu farq muhim. %93,1 aniqlik yoki %93,5 F1 balli hech qanday yorliqni koʻrmasdan avtomatik ravishda mazmunli kategoriya nomlarini hosil qiladigan mutlaqo yorliqsiz tizim samaradorligi emas.
HateBERT nima uchun ishlatiladi?
Oddiy soʻz sanogʻi ayni bir soʻzning turli kontekstlardagi maʼnosini farqlashda qiynalishi mumkin. BERT-asosidagi modellar esa soʻz tasvirini uning atrofidagi soʻzlarga qarab oʻzgartira oladi.
Tadqiqotning konseptual modelida HateBERT ijtimoiy tarmoqdagi tajovuzkorlik va nafrat nutqi bilan bogʻliq til naqshlariga moslashtirilgan kontekstual tasvir hosil qiluvchi vosita sifatida ishlatiladi.
Har bir matn jami:
\[ M=768 \]
oʻlchamli latent semantik fazoga aylantiriladi. Butun maʼlumotlar toʻplami:
\[ X\in\mathbb{R}^{N\times768} \]
matritsasi bilan ifodalanadi. Bu yerda \(N\) hujjat/tweet sonidir.
Embedding oʻlchamlari soʻzmi?
Yoʻq. 768 ta embedding oʻlchamining har biri bevosita “irq”, “jins”, “haqorat” yoki muayyan bir soʻz maʼnosiga teng emas. Bular model ichida taqsimlangan tarzda oʻrganilgan latent sonli xususiyatlardir.
Maqola izohlanuvchanlikni taʼminlash uchun keyinchalik yuqori vaznli embedding oʻlchamlarining maʼlumotlar toʻplamida eng koʻp faollashadigan tokenlarini aniqlaydi va ularni semantik kategoriyalarga moslaydi.
Shu sababli xususiyatlarni talqin qilish ikki bosqichli:
- SWCC qaysi latent oʻlcham/subfazo muhimligini aniqlaydi.
- Post hoc tahlil ushbu latent oʻlchamlarni inson tushunishi mumkin boʻlgan token yoki tushunchalar bilan bogʻlashga urinadi.
Demak, jadvalda koʻrinadigan soʻzlar bevosita BERT ning 768 ustunining tabiiy nomlari emas; ular tadqiqot tomonidan keyinchalik bajarilgan talqin qatlamining natijasidir.
Ko-klasterlash nimani boshqacha qiladi?
Klassik K-means faqat qatorlarni, yaʼni ushbu misolda tweetlarni klasterlaydi. SWCC esa ikki oʻqni bir vaqtning oʻzida tartibga soladi:
- Qatorlar: tweetlar / hujjatlar.
- Ustunlar: embedding xususiyat oʻlchamlari.
Tweet klasteriga tayinlash:
\[ U\in\{0,1\}^{N\times K} \]
matritsasi bilan; feature-subspace aʼzoligi esa:
\[ V\in\{0,1\}^{M\times L} \]
matritsasi bilan ifodalanadi.
Tadqiqotning yakuniy tajriba sozlamalarida:
\[ K=3 \]
tweet klasteri va:
\[ L=32 \]
xususiyat subfazosi tanlangan.
Subfazo vazni nima vazifani bajaradi?
Har bir nafrat nutqi kategoriyasi bir xil semantik oʻlchamlarga bir xil darajada ehtiyoj sezadi, deb faraz qilinmaydi. Buning oʻrniga:
\[ C\in\mathbb{R}^{K\times L} \]
koʻrinishidagi vaznlar matritsasi aniqlanadi.
\[ c_{g,h} \]
qiymati \(g\)-tweet klasteri uchun \(h\)-subfazoning ahamiyatini koʻrsatadi.
Masalan, bir klasterda identifikatsiya/guruhni nishonga olishga sezgir latent xususiyatlar kuchli boʻlishi mumkin, boshqa bir klasterda esa umumiy tajovuzkorlik yoki kamsituvchi til naqshlarini tashuvchi oʻlchamlar yuqoriroq vazn olishi mumkin.
Ushbu yondashuvning nazariy afzalligi 768 ta oʻlchamning barchasiga bitta global ahamiyat qiymatini berish oʻrniga klasterga bogʻliq xususiyat ahamiyatini oʻrgana olishidir.
SWCC maqsad funksiyasi qanday ishlaydi?
Maqolada berilgan asosiy maqsad funksiyasi:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
koʻrinishidadir.
Birinchi had har bir tweetning oʻzi tegishli klasterning tegishli subfazo markazigacha boʻlgan vaznlangan kvadratik masofasini kamaytirishga intiladi. Tweet va centroid bir-biriga qanchalik yaqin boʻlsa, reconstruction/clustering xatosi shunchalik kichik boʻladi.
Ikkinchi had entropiyaga asoslangan regularization komponentidir:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Bu yerdagi:
\[ \eta>0 \]
parametri vaznlarning qanchalik jamlangan yoki muvozanatli boʻlishiga taʼsir qiladi.
Entropiya regulyarizatsiyasi nima uchun kerak?
Agar vaznlar butunlay erkin qoldirilsa, model barcha ahamiyatni bir nechta feature ga jamlab, haddan tashqari keskin va beqaror yechimlar hosil qilishi mumkin. Entropiya hadi ushbu xatti-harakatni nazorat qilishga urinadi.
Tadqiqotning sezgirlik tajribasida:
| \(\eta\) | Silhouette | Manba talqini |
|---|---|---|
| 0,01 | 0,52 | Vaznlar juda siyrak |
| 0,1 | 0,61 | Yetarli boʻlmagan regulyarizatsiya |
| 0,5 | 0,68 | Eng yaxshi muvozanat |
| 1,0 | 0,65 | Ortiqcha regulyarizatsiya |
| 2,0 | 0,58 | Ortiqcha regulyarizatsiya |
| 5,0 | 0,49 | Kuchli ortiqcha regulyarizatsiya |
Ushbu tajriba doirasida:
\[ \eta=0{,}5 \]
eng yuqori Silhouette qiymatini hosil qilgan.
Algoritmning iterativ oqimi qanday?
Maqoladagi SWCC algoritmi alternating minimization yondashuviga amal qiladi:
- Tweet va feature klasterlari dastlab tayinlanadi.
- Tweetlar vaznlangan masofaga koʻra qayta klasterlanadi.
- Cluster centroid'lari yangilanadi.
- Feature oʻlchamlari tegishli subfazolarga qayta tayinlanadi.
- Har bir cluster–subspace jufti uchun taqsimotga bogʻliq vaznlar yangilanadi.
- Tayinlashlar barqarorlashganda yoki maksimal iteratsiya soniga yetganda jarayon toʻxtaydi.
Shunday qilib, hujjat klasterlari, feature subfazolari, centroid'lar va subfazo vaznlari bir-biridan mustaqil tarzda bir marta hisoblanmaydi; ular iterativ ravishda bir-biriga taʼsir qiladi.
Hisoblash xarajati qancha?
Maqolada bir iteratsiya uchun taxminiy murakkablik:
\[ O(NKML) \]
deb berilgan.
\[ K=3,\qquad L=32,\qquad M=768 \]
boʻlganda har bir hujjat uchun taxminan:
\[ 7{,}4\times10^4 \]
asosiy operatsiya miqyosi hisoblanadi.
Mualliflarning masshtab bahosiga koʻra \(N=10^6\) va 50 iteratsiya darajasida umumiy operatsiyalar soni taxminan:
\[ 3{,}7\times10^{12} \]
boʻlishi mumkin. Shu sababli tadqiqot millionlab hujjatlar miqyosida taqsimlangan amalga oshirish talab qilinishi mumkinligini qayd etadi.
Haqiqiy tajriba qancha davom etgan?
Qayta ishlab chiqilish bo'limida Davidson maʼlumotlar toʻplami uchun embedding chiqarish:
\[ 2887\ \text{saniye} \]
yaʼni taxminan 48 daqiqa davom etgani qayd etilgan.
SWCC uchun 30 iteratsiya ishlatilgan va har bir iteratsiya uchun taxminan 2–3 soniya qayd etilgan. Toʻliq pipeline vaqti taxminan 50–55 daqiqa deb berilgan.
Embedding matritsasining:
\[ 24.783\times768 \]
oʻlchamda ekanligi va taxminan 72,61 MB xotira egallashi bildirilgan.
Qaysi maʼlumotlar toʻplamlari ishlatilgan?
Tadqiqot ikkita ingliz tilidagi Twitter maʼlumotlar toʻplamidan foydalanadi:
| Maʼlumotlar toʻplami | Manbada qayd etilgan hajm | Foydalanish maqsadi |
|---|---|---|
| Davidson va boshq. (2017) | 24.783 tweet | Nafrat nutqi / haqoratli til / neytral kontent boʻyicha tajribalar |
| Waseem (2016) | 16.000 tweet deb qayd etilgan | Irqchilik / seksizm / boshqa sinflar boʻyicha baholash |
Bu yerdagi sinf taqsimotlari bo'yicha manba matnda qayta ishlab chiqilish nuqtayi nazaridan muhim nomuvofiqliklar mavjudligi sababli, nisbatlar tekshirilmasdan “toʻgʻri maʼlumotlar toʻplami taqsimoti” sifatida qayta nashr etilmasligi kerak. Maqolaning metodologik natijalarini baholashda bu jihat alohida hisobga olinishi lozim.
Maʼlumotlarni oldindan qayta ishlash qanday bajarilgan?
Tweetlardagi URL'lar, foydalanuvchi nomlari, hashtag belgilari, tinish belgilari, stop-word'lar va turli ijtimoiy tarmoq shovqinlarini tozalash maqsad qilingan. Slang va qisqartmalar maʼno jihatdan mos ifodalar bilan almashtirilgani, emoticon'lar esa izohlovchi soʻzlarga aylantirilgani bildiriladi.
Tadqiqotning oldindan qayta ishlash tahlilida har bir tweetdan oʻrtacha taxminan:
\[ 19{,}1 \]
belgi olib tashlangani qayd etilgan.
Bu jarayon embedding modeliga yanada standartlashtirilgan matn berishni maqsad qiladi. Biroq hashtag yoki ijtimoiy tarmoq belgilarining ayrim hollarda nafrat nutqi kontekstini tashishi mumkinligi hisobga olinsa, tozalash qarorlari axborot yoʻqotilishiga olib kelgan-kelmagani tadqiqot doirasida alohida ablation tajribasi bilan sinovdan oʻtkazilmagan.
\(K=3\) nega tanlangan?
Tweet cluster soni uchun:
\[ K=2,\ldots,10 \]
oraligʻida Within-Cluster Sum of Squares baholashi oʻtkazilgan. Tadqiqot \(K=2\) dan \(K=3\) ga oʻtishda WCSS %23,7 ga kamayganini qayd etib, elbow nuqtasini \(K=3\) deb tanlaydi.
7-rasm shuningdek Silhouette, Davies–Bouldin va Calinski–Harabasz mezonlarini koʻrsatadi. Biroq ushbu yordamchi indekslarning grafikdagi optimumlari aynan bir nuqtada toʻliq birlashmaydi. Shu sababli \(K=3\) tanlovini eng toʻgʻri tarzda elbow tahlili afzal koʻrgan uch klasterli yechim deb taʼriflash kerak.
Nega \(L=32\)?
Embedding oʻlchamlari soni:
\[ M=768 \]
boʻlgani sababli tadqiqot feature-subspace sonini square-root heuristic orqali:
\[ L\approx\sqrt{768}\approx32 \]
deb belgilaydi.
Bu tanlov maʼlumotlardan oʻrganilgan aniq optimum emas; qoʻllangan heuristic dan kelib chiqadigan giperparametr tanlovidir.
Ichki klasterlash sifati nimani koʻrsatdi?
SWCC uchun tadqiqot toʻrtta asosiy ichki validatsiya metrikasini qayd etadi:
| Metrika | SWCC natijasi | Talqin yoʻnalishi |
|---|---|---|
| Silhouette | 0,68 | Yuqori qiymat yaxshiroq ajralish |
| Davies–Bouldin | 0,85 | Past qiymat yaxshiroq |
| Calinski–Harabasz | 1580,5 | Yuqori qiymat yaxshiroq |
| Dunn | 0,43 | Yuqori qiymat yaxshiroq ajralish |
Oʻn marta takrorlangan taqqoslashda qayd etilgan Silhouette qiymatlari quyidagicha:
| Usul | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Manbada ayni jadval uchun SWCC DB, CH va Dunn qiymatlarida ham taqqoslangan usullardan yaxshiroq natija bergani qayd etilgan.
Tashqi baholashda nima olindi?
Klasterlar hosil qilingandan soʻng yorliqlarning %10'i cluster-to-category mapping uchun ishlatilgan va Waseem maʼlumotlar toʻplamida:
\[ \mathrm{Accuracy}=93{,}1\% \]
hamda:
\[ F1=93{,}5\% \]
qayd etilgan.
Tadqiqot shuningdek sinflar bo'yicha macro F1 uchun:
\[ 0{,}89 \]
qiymatini va racism, neither hamda sexism uchun mos ravishda taxminan:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
F1 qiymatlarini qayd etadi.
Biroq manbada toʻliq confusion matrix eʼlon qilinmagan; u “soʻrov boʻyicha olinishi mumkin” deb aytilgan. Bundan tashqari, maʼlumotlar toʻplami sinf nisbatlarini qayd etishdagi muammo sababli sinf darajasidagi natijalarni qayta ishlab chiqish ayniqsa muhimdir.
Nazoratli modellardan ustun deb aytish mumkinmi?
Maqolaning 7-jadvalida SWCC ning F1 qiymati ayrim nazoratli adabiyot natijalaridan yuqoriroq koʻrinadi. Masalan, manbada GLTR+BERT uchun %93,1 F1, BERTweet-large uchun %90,9 va ayrim boshqa usullar uchun pastroq qiymatlar berilgan.
Biroq ayni tadqiqot toʻliq nazoratli usullar bilan bevosita taqqoslash mos emasligini ham qayd etadi. Buning sabablari:
- yorliqdan foydalanish ulushlarining turlicha boʻlishi,
- train/test protokollarining bir xil emasligi,
- turli maqolalarda maʼlumotlarni qayta ishlash qarorlarining farqlanishi,
- SWCC da yorliqlarning cluster mapping maqsadida keyinchalik ishlatilishidir.
Shu sababli eng ehtiyotkor xulosa:
“SWCC qayd etilgan ballar jihatidan ayrim adabiyot natijalari bilan raqobatbardosh koʻrinadi.”
shaklidadir.
“Bir xil tajriba sharoitida barcha nazoratli modellardan muvaffaqiyatliroq ekani isbotlangan.”
degan xulosa ushbu tajriba dizaynidan chiqarib boʻlmaydi.
Ablation tadqiqoti asosiy mexanizm haqida nimani koʻrsatadi?
Tadqiqotdagi eng toza nazoratli taqqoslashlardan biri ayni SWCC tizimining feature-weighting mexanizmini oʻzgartirib oʻtkazilgan ablation tajribasidir.
Toʻliq model:
\[ S=0{,}68 \]
Silhouette qiymatiga erishgan boʻlsa:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
qayd etilgan.
Ushbu natija oʻrganilgan tajriba muhitida nafaqat co-clustering tuzilmasi, balki oʻrganilgan va cluster ga xos subspace weighting mexanizmi ham samaradorlikka hissa qoʻshishini qoʻllab-quvvatlaydi.
Izohlanuvchanlik haqiqatan taʼminlanadimi?
SWCC ning afzalliklaridan biri har bir cluster uchun qaysi subfazolar yuqori vazn olishini koʻrsata olishidir. Soʻng manba ushbu embedding oʻlchamlarini yuqori faollashuv koʻrsatadigan tokenlar bilan bogʻlab, irqqa asoslangan nafrat, seksistik nutq va nafratga aloqador boʻlmagan haqoratli til uchun xos soʻz guruhlarini chiqaradi.
Biroq ikkita ilmiy chegara saqlanishi kerak.
Birinchidan, embedding dimension bilan inson tushunadigan tushuncha oʻrtasida toʻgʻridan-toʻgʻri bir-biriga teng semantik moslik yoʻq. Xaritalash post hoc hisoblanadi.
Ikkinchidan, mualliflar kelgusida yuqori vaznli xususiyatlarni mustaqil inson baholovchilari koʻrib chiqishi kerakligini ochiq tadqiqot savoli sifatida oʻzlari qoldiradilar.
Demak, tadqiqot “toʻliq tushuntiriladigan AI” ishlab chiqqanini isbotlashdan koʻra, klassik black-box embedding ga nisbatan xususiyat vazni darajasida qoʻshimcha talqin kanalini taqdim etadi.
Implicit nafrat nutqi haqiqatan sinovdan oʻtkazilganmi?
Yoʻq. Tadqiqot kirish qismida yashirin nafrat nutqi sarcasm, kodlangan til yoki bevosita haqoratni oʻz ichiga olmaydigan bilvosita ifodalar orqali namoyon boʻlishi mumkinligi tushuntiriladi.
Biroq mualliflar aniq ravishda:
tajribaviy baholash Davidson va Waseem explicit-hate maʼlumotlar toʻplamlarida oʻtkazilganini
va dedicated implicit-hate maʼlumotlar toʻplamlari kelajakda ishlatilishini qayd etadilar.
Shu sababli tadqiqot:
“yashirin nafrat nutqini muvaffaqiyatli aniqladi”
degan xulosani mavjud tajribadan chiqarishga imkon bermaydi.
Kam resursli tillar uchun natija bormi?
Tadqiqot annotatsiyaga ehtiyojni kamaytirish kam resursli tillar uchun foydali boʻlishi mumkinligini ilgari suradi. Biroq tajribalarning barchasi ingliz tilida va foydalanilgan embedding modeli ham ingliz tiliga yoʻnaltirilgan.
Mualliflarning kelgusidagi ish rejasida XLM-RoBERTa va mBERT kabi koʻp tilli modellar bilan tilni aniqlash + tilga xos subspace weighting tuzilmasini tadqiq qilish taklif etiladi.
Shuning uchun kam resursli tillarda foydalanish hozircha potensial qoʻllash yoʻnalishidir, tasdiqlangan topilma emas.
Turkiya va turk tili nuqtayi nazaridan bu nimani anglatadi?
Tadqiqotda turk tilidagi maʼlumotlar ishlatilmagani sababli Turkiyadagi ijtimoiy tarmoq kontenti uchun bevosita samaradorlik natijasi mavjud emas.
Turk tiliga moslashtiriladigan versiyada faqat inglizcha modelni turkcha tweetlarga qoʻllash yetarli boʻlmaydi. Turk tilining agglutinativ tuzilishi, mahalliy jargon, kontekstga bogʻliq yashirin diskriminatsiya, kod almashtirish, yozuv variantlari va Turkiyadagi ijtimoiy tarmoq tilining oʻziga xos xususiyatlari uchun yangi embedding va inson validatsiyasi tadqiqoti talab qilinadi.
Shu sababli tadqiqot Turkiya uchun tayyor moderatsiya modeli emas; turk tili uchun alohida sinovdan oʻtkazilishi mumkin boʻlgan clustering arxitekturasini taqdim etadi.
Tadqiqot qoʻllab-quvvatlaydigan natijalar
- Oʻrganilgan ingliz tilidagi Twitter maʼlumotlar toʻplamlarida SWCC qayd etilgan ichki klasterlash metrikalarida taqqoslangan nazoratsiz usullarga qaraganda yaxshiroq natija bergan.
- Ablation tadqiqoti adaptiv subspace weighting olib tashlanganda yoki buzilganda clustering sifati pasayishini koʻrsatadi.
- Klasterlarni yaratish jarayoni ground-truth label'lardan foydalanmasdan amalga oshirilgan.
- %10 yorliq bilan bajarilgan post hoc cluster mapping dan keyin Waseem baholashida yuqori Accuracy va F1 qiymatlari qayd etilgan.
- Cluster-specific subspace weights turli klasterlarda turli feature hududlari muhim boʻlishi mumkinligini koʻrsatadi.
- Doiraning hisoblash va qayta ishlab chiqilish parametrlarining muhim qismi manbada ochiq qayd etilgan.
Tadqiqot qoʻllab-quvvatlamaydigan yoki isbotlamaydigan natijalar
- Tizim uchidan-uchigacha mutlaqo yorliqsiz emas; category mapping uchun %10 label ishlatiladi.
- Implicit hate speech boʻyicha muvaffaqiyat bevosita sinovdan oʻtkazilmagan.
- Turk tili yoki boshqa kam resursli tillarda muvaffaqiyat koʻrsatilmagan.
- Facebook, YouTube, TikTok yoki boshqa platformalarda cross-platform umumlashtiriluvchanlik sinovdan oʻtkazilmagan.
- 7-jadval bir xil train/test protokolida oʻtkazilgan nazoratli head-to-head supervised benchmark emas.
- Feature vaznlari inson tomonidan bevosita belgilangan maʼno oʻlchamlari emas.
- Clusterlarning inson nafrat nutqi taksonomiyasi bilan toʻliq mosligi mustaqil foydalanuvchi tadqiqoti orqali tasdiqlanmagan.
- Tizim real vaqt rejimida, millionlab foydalanuvchili ijtimoiy tarmoq ishlab chiqarish infratuzilmasida dala sinovidan oʻtkazilmagan.
- Hard assignment sababli bitta tweetning bir vaqtning oʻzida bir nechta nafrat kategoriyasiga mansub boʻlish ehtimoli mavjud versiyada modellashtirilmaydi.
Tadqiqot Usuli va Natijalari
Usul oqimining toʻrtta asosiy bosqichi
Manba tadqiqotning 5-sahifasidagi 1-rasm va 2-rasm tizimni toʻrt bosqichli pipeline sifatida koʻrsatadi:
- Maʼlumotlarni oldindan qayta ishlash: ijtimoiy tarmoq matnini tozalash va normallashtirish.
- Feature embedding: matnni BERT-asosidagi model bilan 768 oʻlchamli semantik tasvirga aylantirish.
- SWCC: tweet va feature subfazolarini birgalikda klasterlash, cluster-specific vaznlarni oʻrganish.
- Baholash: ichki clustering metrikalari va %10 belgilangan post hoc category mapping orqali tashqi baholash.
Modelning toʻrtta asosiy chiqishi
| Obyekt | Maʼnosi | Manbada qayd etilgan tajriba oʻlchami |
|---|---|---|
| \(U\) | Tweet → cluster aʼzolik matritsasi | \((19.971,3)\) deb qayd etilgan |
| \(V\) | Feature dimension → subspace aʼzolik matritsasi | \((768,32)\) |
| \(Z\) | Centroid tuzilmasi | Tajriba bo'limida \((3,768)\) deb qayd etilgan |
| \(C\) | Cluster → subspace vaznlari | \((3,32)\) |
Bu yerdagi \(U=(19.971,3)\) bilan tadqiqotning boshqa bo'limlarida berilgan 24.783 tweetlik embedding matritsasi orasida manbada izohlanmagan namunalar soni farqi mavjud.
Ichki metrikalarni taqqoslash
| Usul | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Manbada bu qiymatlar 10 marta ishga tushirishning oʻrtacha ± standart ogʻishi ekanligi qayd etiladi.
Verianla Live: Adaptiv vaznlashning ablation natijasiga taʼsiri
Ayni ablation jadvalida full SWCC uchun:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
qayd etilgan. Vaznlashsiz modelda bu qiymatlar mos ravishda:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
boʻlgan.
Ushbu nazoratli tajriba tadqiqotning eng kuchli mexanizm dalillaridan biridir; chunki taqqoslanayotgan narsa turli maqolalardagi tizimlar emas, ayni arxitekturaning weighting komponenti oʻzgartirilgan variantlaridir.
Waseem tashqi baholashi
| Model | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Manbada berilmagan | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Manbada berilmagan | %46,2 |
| BERTweet trained on GPT-4 | Manbada berilmagan | %90,1 |
Ushbu jadvalni baholashda usullarning yorliqdan foydalanishi va tajriba protokollari bir xil emasligini unutmaslik kerak. Manbaning oʻz izohi SWCC label'larning %10'ini post hoc cluster mapping uchun ishlatishini, supervised taqqoslashlar esa odatda kattaroq belgilangan train qismlaridan foydalanishini taʼkidlaydi.
Qayta ishlab chiqish uchun berilgan dasturiy muhit
| Komponent | Manbada berilgan qiymat |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| HateBERT maksimal uzunlik | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| SWCC iteratsiyalar soni | 30 |
Apparat muhiti
Tadqiqot Google Colab muhitini taxminan 12–25 GB RAM, 2 vCPU Intel Xeon va sessiya ajratilishiga qarab NVIDIA Tesla V100 yoki T4 GPU bilan qayd etadi.
Bu maʼlumotlar qayta ishlab chiqilish nuqtayi nazaridan foydalidir. Biroq foydalanilgan embedding modelining nomi turli bo'limlarda turlicha berilgani sababli, ayni dasturiy taʼminot va seed qiymatlaridan foydalanishning oʻzi bir-biriga aynan mos replikatsiyani kafolatlamaydi.
Manba ichidagi model identifikatori nomuvofiqligi
Usul bo'limida foydalanilgan model:
GroNLP/HateBERT
deb koʻrsatilgan boʻlsa, qayta ishlab chiqilish bo'limida:
Hate-speech-CNERG/bert-base-uncased-hatexplain
deb yozilgan.
Bular turli model manbalari boʻlgani sababli quyidagi savollarga manba matnidan aniq javob berib boʻlmaydi:
- Qayd etilgan 768 oʻlchamli embeddinglar qaysi checkpoint dan hosil qilingan?
- Model fallback'i qaysi sharoitlarda ishga tushgan?
- Yakuniy samaradorlik jadvallari qaysi checkpoint ga tegishli?
- Turli checkpoint larning SWCC natijalari alohida sinovdan oʻtkazilganmi?
Shu sababli Verianla matni barcha natijalarni sukut bilan “asl GroNLP HateBERT natijasi” deb qayta belgilamaydi.
Manba ichidagi maʼlumotlar toʻplami nomuvofiqliklari
Waseem maʼlumotlar toʻplami uchun manbada berilgan sinf foizlari oʻz ichida jami %100 dan oshadi. Davidson maʼlumotlar toʻplami uchun qayd etilgan %22,8 / %51,8 / %25,4 taqsimoti ham tadqiqot havola qilgan standart Davidson maʼlumotlar toʻplamining keng tarqalgan sinf taqsimotiga mos kelmaydi.
Bu muammo clustering usulining matematik taʼrifini bevosita bekor qilmaydi; biroq Accuracy/F1 natijalari aynan qaysi label taqsimoti va qaysi maʼlumotlar versiyasida hosil qilinganini mustaqil qayta ishlab chiqish nuqtayi nazaridan muhimdir.
Centroid va boshlangʻich vazn ifodasidagi nomuvofiqlik
Matematik notation jadvali centroid ni:
\[ Z\in\mathbb R^{K\times L} \]
deb taʼriflagan boʻlsa, amalga oshirish bo'limida:
\[ Z=(3,768) \]
koʻrinishida \(K\times M\) oʻlchami beriladi.
Xuddi shuningdek, algoritmdan oldingi tushuntirishda boshlangʻich vazn \(1/K\) deb berilgan boʻlsa, Algorithm 1 ichida:
\[ C^{(0)}\leftarrow[1/L] \]
deb yozilgan.
Ushbu farqlar, ayniqsa usulni koddan qayta amalga oshirmoqchi boʻlgan tadqiqotchilar uchun aniqlashtirilishi kerak boʻlgan nuqtalardir.
Modelning asosiy kuchli tomonlari
- Klaster yaratishda ground-truth sinflariga ehtiyoj sezmasligi.
- Tweet va feature subspace tuzilmalarini bir vaqtning oʻzida modellashtirishi.
- Har bir klaster uchun alohida feature/subspace ahamiyat vaznlarini oʻrganishi.
- Vaznlash mexanizmining ablation orqali sinovdan oʻtkazilgani.
- Bir nechta ichki clustering metrikasini qayd etishi.
- Giperparametr sezgirlik tahlilini taqdim etishi.
- Dasturiy versiya, seed, apparat va runtime maʼlumotlarining muhim qismini ulashishi.
- Klaster natijasini faqat bitta Accuracy qiymatiga qisqartirmay, ichki tuzilma metrikalari bilan ham baholashi.
Asosiy cheklovlar
- Tajribalar faqat ingliz tilidagi Twitter maʼlumotlarida oʻtkazilgan.
- Implicit hate uchun dedicated test toʻplami ishlatilmagan.
- Kategoriya nomlash uchun %10 label talab qilinadi.
- Hard cluster assignment ishlatiladi; koʻp/ustma-ust kategoriya aʼzoliklari modellashtirilmaydi.
- Embedding sifati tanlangan til modeliga bogʻliq.
- Feature-to-word talqini post hoc boʻlib, mustaqil inson validatsiyasi oʻtkazilmagan.
- Cross-platform test mavjud emas.
- Maʼlumotlar toʻplami sinf nisbatlarida manba ichidagi nomuvofiqliklar mavjud.
- Foydalanilgan transformer checkpoint identifikatori ikki xil shaklda qayd etilgan.
- 24.783 embedding bilan 19.971 cluster-assignment qatori oʻrtasidagi farq izohlanmagan.
- Supervised modellar bilan jadvaldagi taqqoslashlar yagona umumiy tajriba protokolidan kelib chiqmagan.
Kelgusi tadqiqotlar
Mualliflar toʻrtta asosiy yoʻnalishni taklif etadilar:
- Koʻp tillilik: mBERT yoki XLM-RoBERTa kabi modellar bilan tilga xos va umumiy nafrat nutqi subfazolarini tadqiq qilish.
- Inson tomonidan talqin qilinadigan validatsiya: annotator'larning yuqori vaznli feature'larni koʻrib chiqib cluster maʼnosini tasdiqlashi.
- Embedding modelini taqqoslash: domain specificity, hisoblash xarajati va kontekstual tushunish oʻrtasida muvozanat saqlovchi muqobil modellarni sinash.
- Fuzzy clustering: bitta tweetning bir nechta kategoriyaga qisman aʼzolik koʻrsatishiga imkon beruvchi probabilistic/fuzzy kengaytmalar.
Manba va Usul Haqida Izoh
Toʻliq asl tadqiqot nomi: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Mualliflar: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Teng birinchi/teng hissa: Manbada teng birinchi yoki teng hissa bayonoti mavjud emas.
Masʼul muallif: Maya Sultan ALGhafri.
Muassasa: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Manba turi: Taqrizdan oʻtgan asl tadqiqot maqolasi; tabiiy tilni qayta ishlash, mashinaviy oʻrganish va klasterlash tadqiqoti.
Jurnal: AI.
Nashriyot: MDPI, Basel, Shveysariya.
Bibliografik qayd: AI, 2026, Jild 7, Son 6, Maqola 204.
DOI: 10.3390/ai7060204.
Qabul qilish / tahrir / qabul / nashr: 26-aprel 2026 / 20-may 2026 / 27-may 2026 / 4-iyun 2026.
Taqriz holati: Taqrizdan oʻtgan jurnal nashri.
Litsenziya: Creative Commons Attribution (CC BY).
Akademik muharrirlar: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Asosiy usul: BERT-asosidagi kontekstual embeddinglar bilan Subspace Weighting Co-Clustering (SWCC).
SWCC tuzilmasi: Tweet klasterlari \(U\), feature-subspace tayinlashlari \(V\), centroid tuzilmasi \(Z\) va cluster-specific subspace weighting matritsasi \(C\) birgalikda iterativ optimallashtiriladi.
Tajribaviy embedding oʻlchami: 768.
Tweet cluster soni: \(K=3\).
Feature-subspace soni: \(L=32\).
Regularization: \(\eta=0,5\).
Asosiy maʼlumotlar toʻplamlari: Davidson et al. (2017) Hate Speech and Offensive Language maʼlumotlar toʻplami va Waseem/Hovy ingliz tilidagi Twitter hate-speech maʼlumotlar toʻplami.
Yorliqlardan foydalanish: Cluster formation vaqtida ground-truth label ishlatilmagani qayd etiladi. Tashqi category mapping va evaluation uchun label'larning kamida %10'i post hoc ishlatiladi. Shu sababli tizimning clustering yadrosi nazoratsiz boʻlsa-da, uchidan-uchigacha kategoriya hosil qilish butunlay yorliqsiz emas.
Eng muhim ichki clustering natijasi: SWCC uchun Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Waseem da qayd etilgan tashqi natija: %93,1 Accuracy va %93,5 F1; %10 label bilan post hoc cluster-to-category mapping dan keyin.
Ablation natijasi: Silhouette toʻliq SWCC da 0,68; weighting siz 0,55; random weighting bilan 0,47; equal weighting bilan 0,51.
Hisoblash murakkabligi: Manbada bitta SWCC iteratsiyasi \(O(NKML)\) deb berilgan.
Manbada berilgan runtime: Embedding hosil qilish taxminan 2887 soniya; SWCC 30 iteratsiya; har bir iteratsiya taxminan 2–3 soniya; toʻliq pipeline taxminan 50–55 daqiqa.
Tajriba muhiti: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmaganini bildiradi.
Etika kengashi: Qoʻllanilmaydi deb koʻrsatilgan.
Xabardor qilingan rozilik: Qoʻllanilmaydi deb koʻrsatilgan.
Maʼlumotlar mavjudligi: Manba Davidson va Waseem maʼlumotlar toʻplamlari ochiq repositorylardan olinganini qayd etadi.
Muallif hissalari: Konseptualizatsiya M.S.A.; metodologiya M.S.A. va I.K.; dasturiy taʼminot, validatsiya, formal tahlil, tadqiqot, resurslar, maʼlumotlar kuratsiyasi, dastlabki qoralama va vizualizatsiya M.S.A.; koʻrib chiqish va tahrirlash M.S.A.; rahbarlik I.K. va A.A.; loyiha boshqaruvi va mablagʻ jalb qilish M.S.A. deb qayd etilgan.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvini bildirmagan.
Manbaga sodiqlik nuqtayi nazaridan muhim qayta ishlab chiqilish izohlari
Tadqiqotning usul bo'limida embedding modeli GroNLP/HateBERT deb taʼriflangan boʻlsa, qayta ishlab chiqilish bo'limida Hate-speech-CNERG/bert-base-uncased-hatexplain nomi berilgan. Ushbu ikki checkpoint bir xil model emas. Shuning uchun yakuniy samaradorlik jadvallarini qaysi checkpoint hosil qilgani manba matnidan aniq belgilanmaydi.
Bundan tashqari, foydalanilgan maʼlumotlar toʻplamlarining sinf taqsimotlari borasida manba ichida va asl maʼlumot manbalari bilan nomuvofiqliklar mavjud. Waseem uchun 4-jadvaldagi nisbatlar jami %100 dan oshadi. Davidson uchun qayd etilgan sinf nisbatlari ham standart ochiq maʼlumot faylidagi label taqsimotiga mos kelmaydi. Shu sababli, ayniqsa external Accuracy/F1 qiymatlarini mustaqil replikatsiya qilishda xom maʼlumotlar versiyasi va preprocessing chiqishi tekshirilishi lozim.
Matematik notation da \(Z\) centroid matritsasining oʻlchami va boshlangʻich subspace vazni uchun ham turlicha ifodalar mavjud. Bundan tashqari, Algorithm 1 dan keyin eʼlon qilingan matnda qolib ketgan “Please remove it from the final published version.” iborasi muharrirlik ishlab chiqarish qoldigʻidir.
Ushbu nomuvofiqliklar Verianla matnida sukut bilan yagona “toʻgʻri” versiyaga aylantirilmagan. Chunki muqobillardan qaysi biri mualliflarning haqiqiy tajriba kodini ifodalashi manba tadqiqotda aniq tushuntirilmagan.
Ilmiy talqin chegarasi
Ushbu tadqiqotdagi %93,1 Accuracy va %93,5 F1 qiymatlari nol inson yorligʻidan foydalanadigan mutlaqo avtonom nafrat nutqini kategoriyalash tizimi natijasi emas. Yorliqlarning %10'i post hoc kategoriya moslashtirish uchun ishlatiladi.
Tadqiqotning implicit hate speech haqidagi motivatsiyasi muhim boʻlsa-da, tajribaviy natijalar explicit-hate yoʻnaltirilgan Davidson va Waseem maʼlumotlar toʻplamlariga asoslanadi. Shu sababli implicit hate muvaffaqiyat koʻrsatkichi qayd etilmagan.
Supervised modellar bilan 7-jadvalda qilingan taqqoslashlar ham umumiy train/test split, umumiy preprocessing va umumiy label byudjeti bilan oʻtkazilgan bitta benchmark tajribasi emas. Shuning uchun SWCC ning ayrim eʼlon qilingan ballardan yuqori natija berishi barcha ushbu modellar ustidan nazoratli statistik ustunlik isboti sifatida talqin qilinmasligi kerak.
Nihoyat, model faqat ingliz tilidagi Twitter maʼlumotlarida baholangan. Boshqa tillar, boshqa ijtimoiy tarmoq platformalari va real vaqt ishlab chiqarish moderatsiya tizimlari uchun alohida validatsiya talab qilinadi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan