

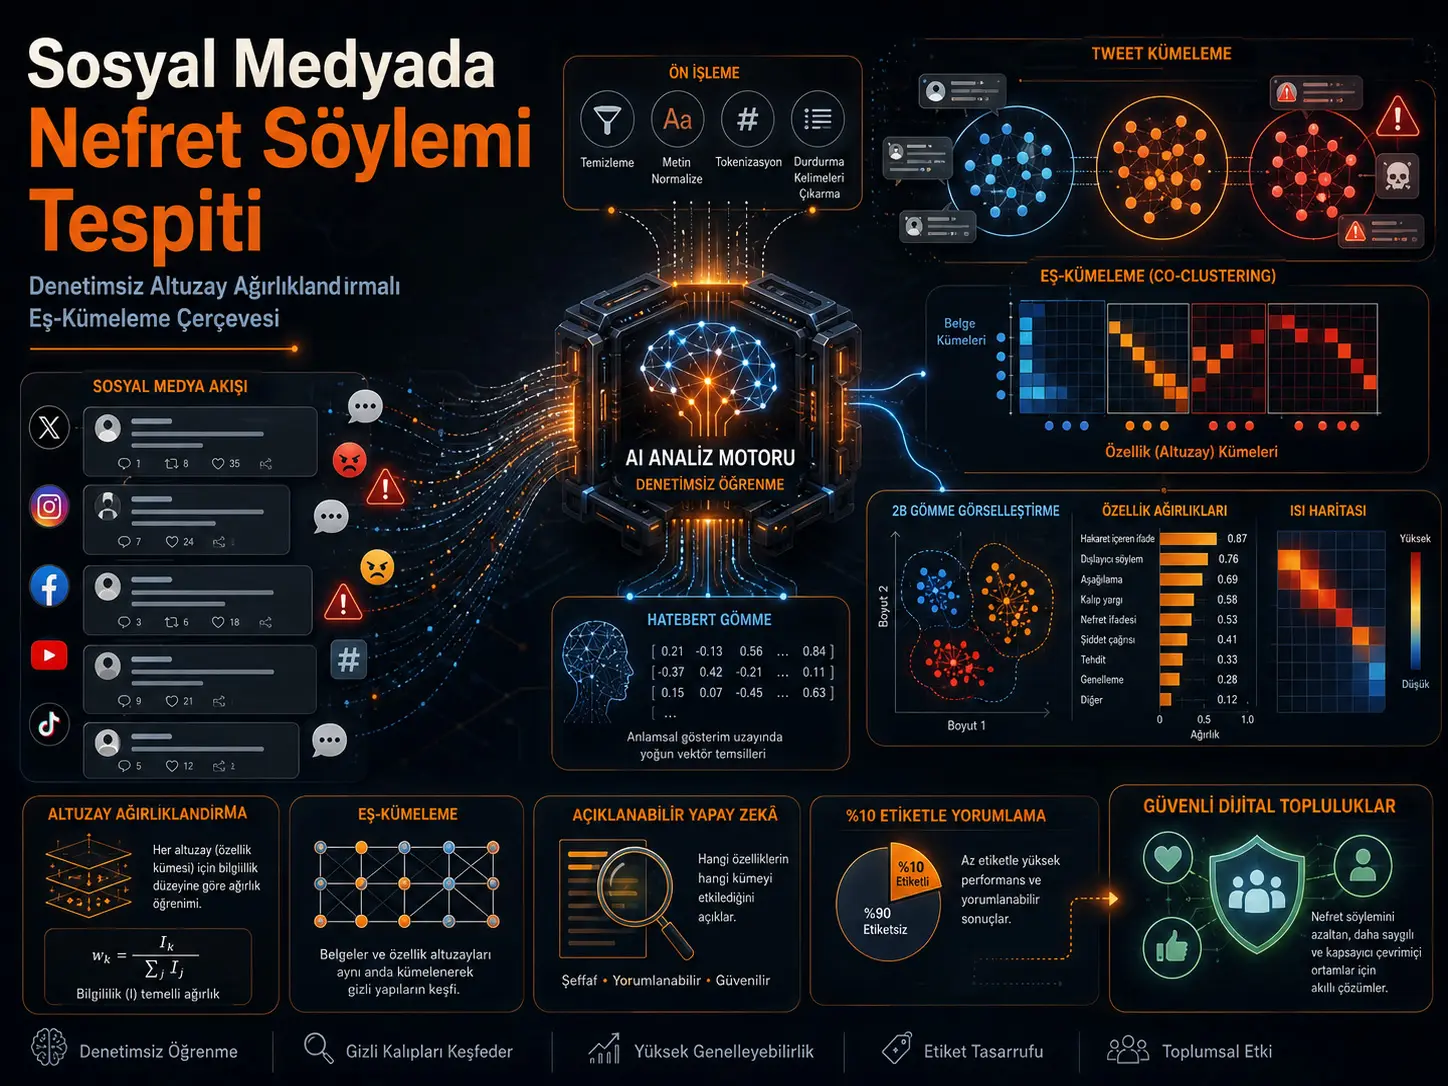
Ин таҳқиқот барои ошкор кардани намунаҳои гуфтори нафратомези англисӣ дар шабакаҳои иҷтимоӣ бидуни ниёз ба ҳаҷми зиёди додаҳои тамғагузоришудаи омӯзишӣ усули Subspace Weighting Co-Clustering (SWCC; ҳамкластербандӣ бо вазнгузории зерфазо)-ро пешниҳод мекунад. Система аз модели забонии бар BERT асосёфта оғоз мешавад, ки матнҳоро ба embedding-ҳои контекстии 768-ченака табдил медиҳад; сипас tweet-ҳо ва андозаҳои хусусиятро дар ин фазои embedding ҳамзамон кластербандӣ мекунад ва барои ҳар кластер вазнҳои гуногуни зерфазоро меомӯзад. Тибқи гузориши муаллифон, SWCC дар арзёбии дохилии кластербандӣ ба 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz ва 0,43 Dunn мерасад. Дар арзёбии берунии маҷмӯаи додаҳои Waseem бошад, пас аз ташкили кластерҳо, вақте %10-и тамғаҳо барои мутобиқсозии категория истифода мешаванд, %93,1 дақиқӣ ва %93,5 холҳои F1 гузориш шудаанд. Бо вуҷуди ин, таҳқиқот як классификатори комилан бенишонаи аз аввал то охир нест; барои таъйини номҳои категория зермаҷмӯаи тамғагузоришудаи санҷишӣ лозим аст. Илова бар ин, дар матни манбаъ оид ба шахсияти модели истифодашуда ва тақсимоти синфҳои маҷмӯаҳои додаҳо номувофиқатҳое мавҷуданд, ки метавонанд ба бозтавлидшавӣ таъсир расонанд.
Ғояи асосии таҳқиқот бар фарзияе асос ёфтааст, ки ҳамаи навъҳои гуфтори нафрат ба як маҷмӯи хусусиятҳои забонӣ бо дараҷаи баробар такя намекунанд. Нафрати бар пояи нажод, гуфтори ҷинсгароёна ва забони таҳқиромезе, ки нафратро дар бар намегирад, метавонанд дар андозаҳои гуногуни маъноӣ мутамарказ шаванд. Аз ин рӯ, SWCC танҳо tweet-ҳоро ба кластерҳо ҷудо намекунад; фазои embedding-и 768-ченака низ ба зерфазоҳо тақсим мешавад ва барои ҳар кластери tweet ба ин зерфазоҳо вазнҳои мутобиқшавандаи аҳамият дода мешаванд. Дар таҷрибаи ablation, вақте вазнгузории омӯхташуда хориҷ мешавад, холҳои Silhouette аз 0,68 ба 0,55, ҳангоми интихоби тасодуфии вазнҳо ба 0,47 ва ҳангоми баробар нигоҳ доштани онҳо ба 0,51 коҳиш меёбанд. Ин натиҷа дастгирӣ мекунад, ки дар додаҳо ва тарҳи таҷрибавии баррасишуда вазнгузории мутобиқшаванда ба ҷудошавии кластерҳо саҳм мегузорад.
Бо вуҷуди ин, иддаоҳои васеътари мақола дар бораи истифода барои “гуфтори нафрати пинҳонӣ” ва “забонҳои камманбаъ” ҳанӯз таҷрибавӣ тасдиқ нашудаанд. Таҷрибаҳо дар додаҳои англисии Twitter ва ба гуфтаи худи муаллифон дар маҷмӯаҳои додаҳои explicit hate анҷом дода шудаанд. Аз ин рӯ, таҳқиқот далели муваффақияти умумисозишуда ба платформаҳои гуногун, забонҳои гуногун ё бевосита маҷмӯаҳои додаҳои implicit hate пешниҳод намекунад.
Чаро равиши дигаре аз муайянсозии классикии назоратшавандаи гуфтори нафрат ҷустуҷӯ мешавад?
Дар муайянсозии гуфтори нафрат равиши маъмул омӯзонидани классификатор бо истифода аз ҳазорон ё миллионҳо матнест, ки пешакӣ аз ҷониби инсонҳо гурӯҳбандӣ шудаанд. Гарчанде ин равиш метавонад самаранокии баланд диҳад, барои забонҳои нав, ҷомеаҳои нав, лаҳҷа ва жаргони зудтағйирёбанда ва шаклҳои нави гуфтори нафрат хароҷоти доимии аннотатсия ба вуҷуд меорад.
Холигие, ки таҳқиқот ҳадаф мегирад, маҳз дар ҳамин ҷо пайдо мешавад: оё метавон сохторе сохт, ки дар марҳилаи ташкили кластерҳои модел тамғаҳо истифода нашаванд, вале гурӯҳҳои аз ҷиҳати маъноӣ пурмазмуни tweet-ҳо ҳамоно кашф шаванд?
Пешниҳоди муаллифон ду техникаро муттаҳид мекунад:
- Намояндагии контекстии забон: табдил додани маънои tweet ба фазои бисёрченакаи embedding ба ҷойи такя ба рӯйхатҳои собити калимаҳо.
- Ҳамкластербандӣ бо вазнгузории зерфазо: ҳам ҳуҷҷатҳо ва ҳам андозаҳои embedding-ро якҷо тартиб додан ва омӯхтани он ки дар ҳар кластери ҳуҷҷат кадом зерфазоҳо бештар фарқкунандаанд.
Калимаи “беназорат” дар ин ҷо дақиқ чӣ маъно дорад?
Дар таҳқиқот ҳангоми ташкили document cluster-ҳо синфҳои гуфтори нафрате, ки инсон додааст, истифода намешаванд. Аз ин ҷиҳат марҳилаи асосии кластербандии SWCC беназорат аст.
Аммо барои муайян кардани он ки кластерҳои бадастомада ба монанди Cluster 1, Cluster 2 ё Cluster 3 ба кадоме аз “нажодпарастона”, “ҷинсгароёна”, “забони таҳқиромези бе нафрат” ё дигар синфи расмии маҷмӯаи додаҳо мувофиқанд, ҳадди ақал %10-и тамғаҳо истифода шудаанд.
Аз ин рӯ, таърифи эҳтиёткоронаи усул чунин аст:
SWCC дар марҳилаи кластербандӣ беназорат аст, вале барои номгузории категорияҳо ва арзёбии берунии самаранокӣ миқдори ками тамғаро истифода мебарад.
Ин фарқият муҳим аст. %93,1 дақиқӣ ё %93,5 F1 нишондиҳандаи низоми комилан бенишонае нест, ки бидуни дидани ягон тамға ба таври худкор номҳои маънодори категорияҳоро тавлид мекунад.
Чаро HateBERT истифода мешавад?
Ҳисобкунии оддии калимаҳо метавонад дар ҷудо кардани маънои як калима дар контекстҳои гуногун душворӣ кашад. Моделҳои бар BERT асосёфта бошанд, метавонанд намояндагии калимаро вобаста ба калимаҳои атрофи он тағйир диҳанд.
Дар модели консептуалии таҳқиқот HateBERT ҳамчун тавлидкунандаи намояндагии контекстӣ истифода мешавад, ки ба намунаҳои забонии вобаста ба таҷовузкории шабакаҳои иҷтимоӣ ва гуфтори нафрат мутобиқ шудааст.
Ҳар матн дар маҷмӯъ ба фазои маъноии пинҳонии:
\[ M=768 \]
ченака табдил дода мешавад. Тамоми маҷмӯаи додаҳо бо матритсаи:
\[ X\in\mathbb{R}^{N\times768} \]
ифода мешавад. Дар ин ҷо \(N\) шумораи ҳуҷҷат/tweet аст.
Оё андозаҳои embedding калима ҳастанд?
Не. Ҳар яке аз 768 андозаи embedding мустақиман маънои “нажод”, “ҷинс”, “таҳқир” ё як калимаи муайянро надорад. Инҳо хусусиятҳои ададии пинҳонӣ мебошанд, ки дар дохили модел ба шакли тақсимшуда омӯхта шудаанд.
Барои эҷоди тафсирпазирӣ мақола баъдан token-ҳоеро муайян мекунад, ки андозаҳои embedding-и вазни баланд дар маҷмӯаи додаҳо бештар фаъол мекунанд, ва онҳоро ба категорияҳои семантикӣ мутобиқ месозад.
Аз ин рӯ, тафсири хусусиятҳо ду марҳила дорад:
- SWCC муайян мекунад, ки кадом андозаи пинҳонӣ/зерфазо муҳим аст.
- Таҳлили post hoc мекӯшад ин андозаҳои пинҳониро бо token ё мафҳумҳои барои инсон фаҳмо пайваст кунад.
Пас калимаҳои дар ҷадвал дидашуда номҳои табиии 768 сутуни BERT нестанд; онҳо натиҷаи қабати тафсири баъдӣ мебошанд, ки таҳқиқот анҷом додааст.
Ҳамкластербандӣ чӣ корро дигар мекунад?
K-means-и классикӣ танҳо сатрҳо, яъне дар ин мисол tweet-ҳоро кластербандӣ мекунад. SWCC бошад, ду меҳварро ҳамзамон танзим мекунад:
- Сатрҳо: tweet-ҳо / ҳуҷҷатҳо.
- Сутунҳо: андозаҳои хусусияти embedding.
Таъйини кластери tweet бо матритсаи:
\[ U\in\{0,1\}^{N\times K} \]
ва узвияти feature-subspace бо матритсаи:
\[ V\in\{0,1\}^{M\times L} \]
ифода мешавад.
Дар танзимоти ниҳоии таҷрибавии таҳқиқот:
\[ K=3 \]
кластери tweet ва:
\[ L=32 \]
зерфазои хусусият интихоб шудааст.
Вазни зерфазо чӣ кор мекунад?
Фарз карда намешавад, ки ҳар категорияи гуфтори нафрат ба ҳамон андозаҳои маъноӣ бо дараҷаи яксон ниёз дорад. Ба ҷойи ин:
\[ C\in\mathbb{R}^{K\times L} \]
матритсаи вазн муайян карда мешавад.
\[ c_{g,h} \]
барои кластери tweet-и \(g\)-ум аҳамияти зерфазои \(h\)-умро нишон медиҳад.
Масалан, дар як кластер хусусиятҳои пинҳонии ҳассос ба ҳадафгирии ҳувият/гурӯҳ метавонанд қавӣ бошанд, дар кластери дигар бошад андозаҳое, ки таҷовузкории умумӣ ё намунаҳои забони таҳқиромезро мебаранд, метавонанд вазни баландтар гиранд.
Бартарии назариявии ин равиш дар он аст, ки ба ҷойи додани як арзиши глобалии аҳамият ба ҳамаи 768 андоза, метавонад аҳамияти хусусияти вобаста ба кластер-ро омӯзад.
Функсияи ҳадафи SWCC чӣ гуна кор мекунад?
Функсияи асосии ҳадаф, ки мақола медиҳад:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
аст.
Қисми аввал мекӯшад масофаи квадратии вазндоштаи ҳар tweet-ро то маркази зерфазои мувофиқи кластере, ки ба он тааллуқ дорад, кам кунад. Ҳар қадар tweet ва centroid ба ҳам наздик бошанд, хатои reconstruction/clustering ҳамон қадар камтар аст.
Қисми дуюм компоненти regularization-и бар энтропия асосёфта мебошад:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Параметри:
\[ \eta>0 \]
ба он таъсир мерасонад, ки вазнҳо то чӣ андоза мутамарказ ё мутавозин бошанд.
Чаро регуляризатсияи энтропия лозим аст?
Агар вазнҳо комилан озод гузошта шаванд, модель метавонад тамоми аҳамиятро дар чанд feature ҷамъ кунад ва ҳалҳои аз ҳад тезу ноустувор тавлид намояд. Қисми энтропия кӯшиш мекунад ин рафторро назорат кунад.
Дар таҷрибаи ҳассосияти таҳқиқот:
| \(\eta\) | Silhouette | Тафсири манбаъ |
|---|---|---|
| 0,01 | 0,52 | Вазнҳо аз ҳад пароканда |
| 0,1 | 0,61 | Регуляризатсияи нокифоя |
| 0,5 | 0,68 | Мувозинати беҳтарин |
| 1,0 | 0,65 | Регуляризатсияи аз ҳад зиёд |
| 2,0 | 0,58 | Регуляризатсияи аз ҳад зиёд |
| 5,0 | 0,49 | Регуляризатсияи шадидан аз ҳад зиёд |
Дар доираи ин таҷриба:
\[ \eta=0{,}5 \]
баландтарин арзиши Silhouette-ро тавлид кардааст.
Ҷараёни итеративии алгоритм чӣ гуна аст?
Алгоритми SWCC дар мақола равиши alternating minimization-ро истифода мебарад:
- Кластерҳои tweet ва feature дар оғоз таъйин мешаванд.
- Tweet-ҳо аз рӯи масофаи вазндошта дубора кластербандӣ мешаванд.
- Cluster centroid-ҳо нав карда мешаванд.
- Андозаҳои feature ба зерфазоҳои дахлдор дубора таъйин мешаванд.
- Барои ҳар ҷуфти cluster–subspace вазнҳои вобаста ба тақсимот нав карда мешаванд.
- Вақте таъйинот устувор мешавад ё шумораи максималии итератсияҳо фаро мерасад, раванд қатъ мешавад.
Ҳамин тавр, кластерҳои ҳуҷҷат, зерфазоҳои feature, centroid-ҳо ва вазнҳои зерфазо як маротиба ва мустақил аз ҳам ҳисоб намешаванд; онҳо ба таври итеративӣ ба ҳамдигар таъсир мерасонанд.
Хароҷоти ҳисоббарорӣ чӣ қадар аст?
Мақола мураккабии тақрибии як итератсияро:
\[ O(NKML) \]
медиҳад.
\[ K=3,\qquad L=32,\qquad M=768 \]
аст, барои ҳар ҳуҷҷат тақрибан:
\[ 7{,}4\times10^4 \]
амалиёти асосӣ ҳисоб карда мешавад.
Тибқи баҳодиҳии миқёсии муаллифон, дар сатҳи \(N=10^6\) ва 50 итератсия шумораи умумии амалиёт метавонад тақрибан:
\[ 3{,}7\times10^{12} \]
бошад. Аз ин рӯ, таҳқиқот қайд мекунад, ки дар миқёси миллионҳо ҳуҷҷат татбиқи тақсимшуда метавонад лозим шавад.
Таҷрибаи воқеӣ чанд вақт давом кард?
Дар бахши бозтавлидшавӣ барои маҷмӯаи додаҳои Davidson истихроҷи embedding:
\[ 2887\ \text{saniye} \]
яъне тақрибан 48 дақиқа давом кардааст.
Барои SWCC 30 итератсия истифода шуда, барои ҳар итератсия тақрибан 2–3 сония гузориш шудааст. Вақти пурраи pipeline тақрибан 50–55 дақиқа дода шудааст.
Матритсаи embedding:
\[ 24.783\times768 \]
андоза дошта, тақрибан 72,61 MB хотира ишғол мекунад.
Кадом маҷмӯаҳои додаҳо истифода шуданд?
Таҳқиқот ду маҷмӯаи додаҳои англисии Twitter-ро истифода мебарад:
| Маҷмӯаи додаҳо | Ҳаҷми гузоришшуда дар манбаъ | Ҳадафи истифода |
|---|---|---|
| Davidson ва дигарон (2017) | 24.783 tweet | Таҷрибаҳо оид ба гуфтори нафрат / забони таҳқиромез / муҳтавои бетараф |
| Waseem (2016) | 16.000 tweet гузориш шудааст | Арзёбӣ барои нажодпарастӣ / ҷинсгароӣ / синфҳои дигар |
Азбаски дар матни манбаъ барои тақсимоти синфҳо номувофиқатҳои муҳими бозтавлидшавӣ мавҷуданд, ин таносубҳо набояд бе санҷиш ҳамчун “тақсимоти дурусти маҷмӯаи додаҳо” бознашр шаванд. Ҳангоми арзёбии натиҷаҳои методологии мақола ин нуқта бояд алоҳида ба назар гирифта шавад.
Коркарди пешакии додаҳо чӣ гуна анҷом шудааст?
Ҳадаф тоза кардани URL-ҳо, номҳои корбар, аломатҳои hashtag, аломатҳои китобатӣ, stop-word-ҳо ва садоҳои гуногуни шабакаҳои иҷтимоӣ дар tweet-ҳо будааст. Гуфта мешавад, ки slang ва ихтисораҳо бо маъноҳои мувофиқ иваз шудаанд ва emoticon-ҳо низ ба калимаҳои тавсифӣ табдил дода шудаанд.
Дар таҳлили коркарди пешакии таҳқиқот ба ҳисоби миёна барои ҳар tweet тақрибан:
\[ 19{,}1 \]
аломат хориҷ шудааст.
Ин раванд ҳадаф дорад ба модели embedding матни бештар стандартшуда диҳад. Бо вуҷуди ин, бо назардошти он ки hashtag ё нишонаҳои шабакаҳои иҷтимоӣ дар баъзе ҳолатҳо метавонанд контексти гуфтори нафратро дошта бошанд, дар дохили таҳқиқот бо таҷрибаи алоҳидаи ablation санҷида нашудааст, ки қарорҳои тозакунӣ боиси талафи иттилоот мешаванд ё не.
Чаро \(K=3\) интихоб шудааст?
Барои шумораи cluster-и tweet:
\[ K=2,\ldots,10 \]
дар фосилаи мазкур арзёбии Within-Cluster Sum of Squares анҷом шудааст. Таҳқиқот гузориш медиҳад, ки ҳангоми гузариш аз \(K=2\) ба \(K=3\), WCSS ба андозаи %23,7 кам шудааст ва нуқтаи elbow ҳамчун \(K=3\) интихоб мегардад.
Шакли 7 ҳамчунин меъёрҳои Silhouette, Davies–Bouldin ва Calinski–Harabasz-ро нишон медиҳад. Аммо optimum-ҳои ин индексҳои ёрирасон дар график пурра дар як нуқта ҷамъ намешаванд. Аз ин рӯ, интихоби \(K=3\)-ро дурусттар аст ҳамчун ҳалли се-кластерӣ, ки таҳлили elbow онро афзал донистааст тавсиф кунем.
Чаро \(L=32\)?
Азбаски шумораи андозаҳои embedding:
\[ M=768 \]
аст, таҳқиқот шумораи feature-subspace-ро бо square-root heuristic чунин муайян мекунад:
\[ L\approx\sqrt{768}\approx32 \]
муайян карда мешавад.
Ин интихоб optimum-и дақиқе нест, ки аз додаҳо омӯхта шудааст; он интихоби гиперпараметрест, ки аз heuristic-и истифодашуда бармеояд.
Сифати дохилии кластербандӣ чӣ нишон дод?
Барои SWCC таҳқиқот чаҳор метрикаи асосии валидасияи дохилиро гузориш медиҳад:
| Метрика | Натиҷаи SWCC | Самти тафсир |
|---|---|---|
| Silhouette | 0,68 | Арзиши баландтар ҷудошавии беҳтар |
| Davies–Bouldin | 0,85 | Арзиши пасттар беҳтар |
| Calinski–Harabasz | 1580,5 | Арзиши баландтар беҳтар |
| Dunn | 0,43 | Арзиши баландтар ҷудошавии беҳтар |
Арзишҳои Silhouette, ки дар муқоисаи даҳкарата гузориш шудаанд, чунинанд:
| Усул | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Дар манбаъ барои ҳамин ҷадвал гузориш шудааст, ки SWCC аз рӯи арзишҳои DB, CH ва Dunn низ аз усулҳои муқоисашуда натиҷаи беҳтар додааст.
Дар арзёбии берунӣ чӣ ба даст омад?
Пас аз ташкили кластерҳо %10-и тамғаҳо барои cluster-to-category mapping истифода шуда, дар маҷмӯаи додаҳои Waseem:
\[ \mathrm{Accuracy}=93{,}1\% \]
ва:
\[ F1=93{,}5\% \]
гузориш шудаанд.
Таҳқиқот ҳамчунин барои macro F1 аз рӯи синф:
\[ 0{,}89 \]
ва барои racism, neither ва sexism мутаносибан тақрибан:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
арзишҳои F1-ро гузориш мекунад.
Аммо дар манбаъ confusion matrix-и пурра нашр нашудааст; гуфта шудааст, ки он “бо дархост дастрас аст”. Илова бар ин, бинобар мушкили гузориши таносубҳои синфии маҷмӯаи додаҳо, бозтавлиди натиҷаҳои сатҳи синф махсусан муҳим аст.
Оё метавон гуфт, ки он аз моделҳои назоратшаванда гузашт?
Дар Ҷадвали 7-и мақола арзиши F1-и SWCC аз баъзе натиҷаҳои адабиёти назоратшаванда баландтар менамояд. Масалан, дар манбаъ барои GLTR+BERT %93,1 F1, барои BERTweet-large %90,9 ва барои баъзе усулҳои дигар арзишҳои пасттар дода шудаанд.
Аммо ҳамон таҳқиқот қайд мекунад, ки муқоисаи мустақим бо усулҳои комилан назоратшаванда мувофиқ нест. Сабабҳо чунинанд:
- таносуби истифодаи тамғаҳо фарқ мекунад,
- протоколҳои train/test яксон нестанд,
- дар мақолаҳои гуногун қарорҳои гуногуни коркарди додаҳо мавҷуданд,
- дар SWCC тамғаҳо баъдан барои cluster mapping истифода мешаванд.
Аз ин рӯ, натиҷаи бехавфтар чунин аст:
“SWCC аз рӯи холҳои гузоришшуда бо баъзе натиҷаҳои адабиёт рақобатпазир ба назар мерасад.”
аст.
“Исбот шудааст, ки дар шароити баробари таҷрибавӣ аз ҳамаи моделҳои назоратшаванда беҳтар аст.”
чунин натиҷаро аз ин тарҳи таҷрибавӣ баровардан мумкин нест.
Таҳқиқоти ablation дар бораи механизми асосӣ чӣ нишон медиҳад?
Яке аз муқоисаҳои назоратшавандаи тозатарини таҳқиқот таҷрибаи ablation мебошад, ки дар он механизми feature-weighting-и ҳамон системаи SWCC тағйир дода шудааст.
Модели пурра:
\[ S=0{,}68 \]
ба арзиши Silhouette мерасад, дар ҳоле ки:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
гузориш шудаанд.
Ин натиҷа дастгирӣ мекунад, ки дар муҳити таҷрибавии баррасишуда на танҳо сохтори co-clustering, балки механизми subspace weighting-и омӯхташуда ва махсуси cluster низ ба самаранокӣ саҳм мегузорад.
Оё тафсирпазирӣ воқеан таъмин мешавад?
Яке аз бартариҳои SWCC он аст, ки метавонад нишон диҳад барои ҳар cluster кадом зерфазоҳо вазни баланд гирифтаанд. Сипас манбаъ ин андозаҳои embedding-ро бо token-ҳое, ки фаъолшавии баланд нишон медиҳанд, пайваст карда, барои нафрати бар пояи нажод, гуфтори ҷинсгароёна ва забони таҳқиромези берун аз нафрат гурӯҳҳои хоси калимаҳоро ба даст меорад.
Аммо ду марзи илмӣ бояд нигоҳ дошта шавад.
Якум, байни embedding dimension ва мафҳуми барои инсон фаҳмо баробарии мустақими як-ба-яки семантикӣ вуҷуд надорад. Харитасозӣ post hoc аст.
Дуюм, худи муаллифон ҳамчун саволи кушодаи таҳқиқотӣ мегузоранд, ки дар оянда хусусиятҳои вазни баланд бояд аз ҷониби арзёбони мустақили инсонӣ баррасӣ шаванд.
Аз ин рӯ, таҳқиқот бештар аз он ки исбот кунад “AI-и пурра шарҳпазир” сохта шудааст, нисбат ба embedding-и классикии black-box канали иловагии тафсир дар сатҳи вазни хусусият пешниҳод мекунад.
Оё гуфтори нафрати implicit воқеан санҷида шудааст?
Не. Дар муқаддимаи таҳқиқот шарҳ дода мешавад, ки гуфтори нафрати пинҳонӣ метавонад бо sarcasm, забони рамзгузоришуда ё ибораҳои ғайримустақиме, ки таҳқири мустақим надоранд, зуҳур кунад.
Аммо муаллифон ошкоро мегӯянд:
арзёбии таҷрибавӣ дар маҷмӯаҳои додаҳои explicit-hate-и Davidson ва Waseem анҷом шудааст
ва маҷмӯаҳои dedicated implicit-hate дар оянда истифода хоҳанд шуд.
Аз ин рӯ, аз таҷрибаи ҳозира наметавон натиҷа гирифт, ки таҳқиқот:
“гуфтори нафрати пинҳониро бомуваффақият муайян кардааст.”
чунин натиҷаро аз таҷрибаи мавҷуда баровардан мумкин нест.
Оё барои забонҳои камманбаъ натиҷа вуҷуд дорад?
Таҳқиқот пешниҳод мекунад, ки кам кардани ниёз ба аннотатсия метавонад барои забонҳои камманбаъ муфид бошад. Аммо ҳамаи таҷрибаҳо бо забони англисӣ анҷом шудаанд ва модели embedding-и истифодашуда низ ба англисӣ нигаронида шудааст.
Дар нақшаи кори ояндаи муаллифон пешниҳод мешавад, ки бо моделҳои бисёрзабона ба монанди XLM-RoBERTa ва mBERT сохтори шинохти забон + subspace weighting-и махсуси забон таҳқиқ карда шавад.
Пас истифода барои забонҳои камманбаъ ҳоло самти эҳтимолии татбиқ аст, на натиҷаи тасдиқшуда.
Ин барои Туркия ва забони туркӣ чӣ маъно дорад?
Азбаски дар таҳқиқот додаҳои туркӣ истифода нашудаанд, барои муҳтавои шабакаҳои иҷтимоии Туркия натиҷаи мустақими самаранокӣ вуҷуд надорад.
Дар версияе, ки ба забони туркӣ мутобиқ карда мешавад, танҳо татбиқ кардани модели англисӣ ба tweet-ҳои туркӣ кофӣ нахоҳад буд. Барои сохтори агглютинативии туркӣ, сленги маҳаллӣ, табъизи пинҳонии вобаста ба контекст, ивазкунии код, вариантҳои имло ва хусусиятҳои хоси забони шабакаҳои иҷтимоӣ дар Туркия таҳқиқоти нави embedding ва санҷиши инсонӣ лозим аст.
Аз ин рӯ, таҳқиқот барои Туркия модели омодаи модератсия нест; балки меъмории clustering-ро пешниҳод мекунад, ки барои забони туркӣ алоҳида санҷидан мумкин аст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Дар маҷмӯаҳои додаҳои англисии Twitter, SWCC аз рӯи метрикаҳои гузоришшудаи дохилии кластербандӣ нисбат ба усулҳои беназорати муқоисашуда натиҷаи беҳтар додааст.
- Таҳқиқоти ablation нишон медиҳад, ки вақте adaptive subspace weighting хориҷ ё вайрон карда мешавад, сифати clustering коҳиш меёбад.
- Раванди ташкили кластерҳо бе истифодаи ground-truth label-ҳо иҷро шудааст.
- Пас аз post hoc cluster mapping бо %10 тамға, дар арзёбии Waseem арзишҳои баланди Accuracy ва F1 гузориш шудаанд.
- Cluster-specific subspace weights нишон медиҳанд, ки дар кластерҳои гуногун минтақаҳои гуногуни feature метавонанд аҳамият пайдо кунанд.
- Қисми муҳими параметрҳои ҳисоббарорӣ ва бозтавлидшавии чаҳорчӯба дар манбаъ ошкоро гузориш шудааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ ё исбот намекунад
- Система аз аввал то охир комилан бенишона нест; барои category mapping %10 label истифода мешавад.
- Муваффақияти implicit hate speech бевосита санҷида нашудааст.
- Дар забони туркӣ ё дигар забонҳои камманбаъ муваффақият нишон дода нашудааст.
- Cross-platform умумисозӣ дар Facebook, YouTube, TikTok ё дигар платформаҳо санҷида нашудааст.
- Ҷадвали 7 як head-to-head supervised benchmark-и назоратшаванда бо протоколи якхелаи train/test нест.
- Вазнҳои feature андозаҳои маъноии бевосита аз ҷониби инсон таъйиншуда нестанд.
- Мутобиқати пурраи cluster-ҳо бо таксономияи инсонии гуфтори нафрат тавассути таҳқиқоти мустақили корбарӣ тасдиқ нашудааст.
- Система дар инфрасохтори воқеии шабакаҳои иҷтимоӣ бо миллионҳо корбар дар вақти воқеӣ санҷиши саҳроӣ нагузаштааст.
- Аз сабаби Hard assignment, эҳтимоли он ки як tweet ҳамзамон ба зиёда аз як категорияи нафрат тааллуқ дошта бошад, дар версияи ҳозира моделсозӣ намешавад.
Усул ва Натиҷаҳои Таҳқиқот
Чаҳор марҳилаи асосии ҷараёни усул
Шакли 1 ва Шакли 2 дар саҳифаи 5-и таҳқиқоти манбаъ системаро ҳамчун pipeline-и чаҳормарҳила нишон медиҳанд:
- Коркарди пешакии додаҳо: тоза ва нормализатсия кардани матни шабакаҳои иҷтимоӣ.
- Feature embedding: табдил додани матн ба намояндагии маъноии 768-ченака бо модели бар BERT асосёфта.
- SWCC: кластербандии якҷояи tweet ва зерфазоҳои feature, омӯхтани вазнҳои cluster-specific.
- Арзёбӣ: арзёбии берунӣ бо метрикаҳои дохилии clustering ва post hoc category mapping бо %10 тамға.
Чаҳор баромади асосии модел
| Объект | Маъно | Андозаи таҷрибавии гузоришшуда дар манбаъ |
|---|---|---|
| \(U\) | Матритсаи узвияти Tweet → cluster | Ҳамчун \((19.971,3)\) гузориш шудааст |
| \(V\) | Матритсаи узвияти Feature dimension → subspace | \((768,32)\) |
| \(Z\) | Сохтори Centroid | Дар бахши таҷриба ҳамчун \((3,768)\) гузориш шудааст |
| \(C\) | Вазнҳои Cluster → subspace | \((3,32)\) |
Байни \(U=(19.971,3)\) дар ин ҷо ва матритсаи embedding-и 24.783 tweet, ки дар бахшҳои дигари таҳқиқот дода шудааст, фарқи шумораи намунаҳо мавҷуд аст, ки дар манбаъ шарҳ дода нашудааст.
Муқоисаи метрикаҳои дохилӣ
| Усул | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Манбаъ мегӯяд, ки ин арзишҳо миёна ± инҳирофи стандартии 10 иҷро мебошанд.
Verianla Live: Таъсири вазнгузории мутобиқшаванда ба натиҷаи ablation
Дар ҳамон ҷадвали ablation барои full SWCC:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
гузориш шудааст. Дар модели бе вазнгузорӣ ин арзишҳо мутаносибан:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
будаанд.
Ин таҷрибаи назоратшаванда яке аз далелҳои қавитарини механизми таҳқиқот аст; зеро муқоиса байни системаҳои мақолаҳои гуногун нест, балки байни вариантҳои ҳамон меъморӣ бо компоненти weighting-и тағйирёфта анҷом мешавад.
Арзёбии берунии Waseem
| Модел | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Дар манбаъ дода нашудааст | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Дар манбаъ дода нашудааст | %46,2 |
| BERTweet trained on GPT-4 | Дар манбаъ дода нашудааст | %90,1 |
Ҳангоми арзёбии ин ҷадвал набояд фаромӯш кард, ки истифодаи тамға ва протоколҳои таҷрибавии усулҳо яксон нестанд. Эзоҳи худи манбаъ таъкид мекунад, ки SWCC %10-и label-ҳоро барои post hoc cluster mapping истифода мебарад, дар ҳоле ки муқоисаҳои supervised маъмулан аз қисмҳои калонтари train-и тамғагузоришуда истифода мекунанд.
Муҳити нармафзор барои бозтавлидшавӣ
| Компонент | Арзиши додаи манбаъ |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| Дарозии максималии HateBERT | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| Шумораи итератсияҳои SWCC | 30 |
Муҳити сахтафзор
Таҳқиқот муҳити Google Colab-ро бо тақрибан 12–25 GB RAM, 2 vCPU Intel Xeon ва вобаста ба тақсимоти сессия NVIDIA Tesla V100 ё T4 GPU гузориш медиҳад.
Ин маълумотҳо барои бозтавлидшавӣ муфиданд. Аммо азбаски номи модели embedding-и истифодашуда дар бахшҳои гуногун ба таври гуногун оварда шудааст, танҳо истифодаи ҳамон нармафзор ва арзишҳои seed бозтавлиди як-ба-якро кафолат намедиҳад.
Номувофиқати шахсияти модел дар дохили манбаъ
Дар бахши усул модели истифодашуда:
GroNLP/HateBERT
номида мешавад, дар ҳоле ки дар бахши бозтавлидшавӣ:
Hate-speech-CNERG/bert-base-uncased-hatexplain
навишта шудааст.
Азбаски инҳо манбаъҳои гуногуни моделанд, ба саволҳои зерин аз матни манбаъ ҷавоби қатъӣ додан мумкин нест:
- Embedding-ҳои 768-ченакаи гузоришшуда аз кадом checkpoint тавлид шудаанд?
- Model fallback дар кадом шароит фаъол шудааст?
- Ҷадвалҳои ниҳоии самаранокӣ ба кадом checkpoint тааллуқ доранд?
- Оё натиҷаҳои SWCC-и checkpoint-ҳои гуногун алоҳида санҷида шудаанд?
Аз ин рӯ, матни Verianla ҳамаи натиҷаҳоро хомӯшона ҳамчун “натиҷаи аслии GroNLP HateBERT” дубора тамғагузорӣ намекунад.
Номувофиқатҳои маҷмӯаи додаҳо дар дохили манбаъ
Барои маҷмӯаи додаҳои Waseem фоизҳои синфҳои дар манбаъ додашуда дар маҷмӯъ аз %100 зиёд мешаванд. Тақсимоти %22,8 / %51,8 / %25,4, ки барои маҷмӯаи додаҳои Davidson гузориш шудааст, низ бо тақсимоти маъмули синфии маҷмӯаи стандартии Davidson, ки таҳқиқот ба он истинод мекунад, мувофиқат намекунад.
Ин мушкилӣ таърифи математикии усули clustering-ро бевосита беэътибор намекунад; аммо барои бозтавлиди мустақили он ки натиҷаҳои Accuracy/F1 дар кадом тақсимоти дақиқи label ва кадом версияи додаҳо ба даст омадаанд, муҳим аст.
Номувофиқӣ дар ифодаи centroid ва вазни ибтидоӣ
Ҷадвали notation-и математикӣ centroid-ро чунин таъриф мекунад:
\[ Z\in\mathbb R^{K\times L} \]
дар ҳоле ки дар бахши татбиқ:
\[ Z=(3,768) \]
андозаи \(K\times M\) дода мешавад.
Ҳамчунин, дар шарҳи пеш аз алгоритм гуфта мешавад, ки вазни ибтидоӣ \(1/K\) аст, вале дар Algorithm 1 чунин навишта шудааст:
\[ C^{(0)}\leftarrow[1/L] \]
навишта шудааст.
Ин фарқиятҳо махсусан барои муҳаққиқоне, ки мехоҳанд усулро аз рӯи код дубора татбиқ кунанд, нуқтаҳои ниёзманди равшанӣ мебошанд.
Ҷанбаҳои асосии қавии модел
- Ҳангоми ташкили кластер ба синфҳои ground-truth ниёз надорад.
- Сохторҳои tweet ва feature subspace-ро ҳамзамон моделсозӣ мекунад.
- Барои ҳар кластер вазнҳои алоҳидаи аҳамияти feature/subspace меомӯзад.
- Механизми вазнгузорӣ бо ablation санҷида шудааст.
- Якчанд метрикаи дохилии clustering гузориш мешавад.
- Таҳлили ҳассосияти гиперпараметрҳо пешниҳод мешавад.
- Қисми муҳими маълумоти версияи нармафзор, seed, сахтафзор ва runtime нашр шудааст.
- Натиҷаи кластерро танҳо ба як арзиши Accuracy кам намекунад ва онро бо метрикаҳои сохтори дохилӣ низ арзёбӣ мекунад.
Маҳдудиятҳои асосӣ
- Таҷрибаҳо танҳо дар додаҳои англисии Twitter гузаронида шудаанд.
- Барои implicit hate маҷмӯаи dedicated test истифода нашудааст.
- Барои номгузории категория %10 label лозим аст.
- Hard cluster assignment истифода мешавад; узвиятҳои чандгона/ҳампӯшии категория моделсозӣ намешаванд.
- Сифати embedding ба модели забонии интихобшуда вобаста аст.
- Тафсири Feature-to-word post hoc буда, санҷиши мустақили инсонӣ анҷом нашудааст.
- Cross-platform test мавҷуд нест.
- Дар таносубҳои синфии маҷмӯаи додаҳо номувофиқатҳои дохилиманбаъӣ ҳастанд.
- Шахсияти transformer checkpoint-и истифодашуда бо ду шакли гуногун гузориш шудааст.
- Фарқи байни 24.783 embedding ва 19.971 сатри cluster-assignment шарҳ дода нашудааст.
- Муқоисаҳои ҷадвалӣ бо моделҳои supervised аз як протоколи умумии таҷрибавӣ барнамеоянд.
Таҳқиқоти оянда
Муаллифон чаҳор самти асосиро пешниҳод мекунанд:
- Бисёрзабонӣ: таҳқиқи зерфазоҳои махсуси забон ва муштараки гуфтори нафрат бо моделҳое мисли mBERT ё XLM-RoBERTa.
- Санҷиши аз ҷониби инсон тафсиршаванда: annotator-ҳо feature-ҳои вазни баландро баррасӣ карда, маънои cluster-ро тасдиқ кунанд.
- Муқоисаи модели embedding: санҷиши моделҳои алтернативӣ, ки байни domain specificity, хароҷоти ҳисоббарорӣ ва фаҳмиши контекстӣ тавозун месозанд.
- Fuzzy clustering: тавсеаҳои probabilistic/fuzzy, ки имкон медиҳанд як tweet ба зиёда аз як категория узвияти қисман дошта бошад.
Ёддошт оид ба Манбаъ ва Усул
Номи пурраи аслии таҳқиқот: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Муаллифон: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Муаллифи якуми баробар/саҳми баробар: Дар манбаъ изҳороти муаллифи якуми баробар ё саҳми баробар вуҷуд надорад.
Муаллифи масъул: Maya Sultan ALGhafri.
Муассиса: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Навъи манбаъ: Мақолаи аслии таҳқиқотии рецензияшуда; таҳқиқоти коркарди забони табиӣ, омӯзиши мошинӣ ва кластербандӣ.
Маҷалла: AI.
Ношир: MDPI, Basel, Швейтсария.
Сабти библиографӣ: AI, 2026, Ҷилди 7, Шумораи 6, Мақолаи 204.
DOI: 10.3390/ai7060204.
Қабул / бозбинӣ / пазируфтан / нашр: 26 апрели 2026 / 20 майи 2026 / 27 майи 2026 / 4 июни 2026.
Ҳолати рецензия: Нашри маҷаллаи рецензияшуда.
Иҷозатнома: Creative Commons Attribution (CC BY).
Муҳаррирони академӣ: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Усули асосӣ: Subspace Weighting Co-Clustering (SWCC) бо embedding-ҳои контекстии бар BERT асосёфта.
Сохтори SWCC: Кластерҳои tweet \(U\), таъйиноти feature-subspace \(V\), сохтори centroid \(Z\) ва матритсаи cluster-specific subspace weighting \(C\) якҷо ба таври итеративӣ оптимизатсия мешаванд.
Андозаи таҷрибавии embedding: 768.
Шумораи tweet cluster: \(K=3\).
Шумораи feature-subspace: \(L=32\).
Regularization: \(\eta=0,5\).
Маҷмӯаҳои асосии додаҳо: Маҷмӯаи Davidson et al. (2017) Hate Speech and Offensive Language ва маҷмӯаи англисии Twitter hate-speech-и Waseem/Hovy.
Истифодаи тамға: Гуфта мешавад, ки ҳангоми Cluster formation ground-truth label истифода намешавад. Барои category mapping ва evaluation-и берунӣ ҳадди ақал %10-и label-ҳо post hoc истифода мешаванд. Аз ин рӯ, ҳарчанд ядрои clustering-и система беназорат аст, тавлиди категория аз аввал то охир комилан бенишона нест.
Муҳимтарин натиҷаи clustering-и дохилӣ: Барои SWCC Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Натиҷаи берунии гузоришшуда дар Waseem: %93,1 Accuracy ва %93,5 F1; пас аз post hoc cluster-to-category mapping бо %10 label.
Натиҷаи ablation: Silhouette дар SWCC-и пурра 0,68; бе weighting 0,55; бо random weighting 0,47; бо equal weighting 0,51.
Мураккабии ҳисоббарорӣ: Манбаъ як итератсияи SWCC-ро \(O(NKML)\) медиҳад.
Runtime-и додаи манбаъ: Тавлиди embedding тақрибан 2887 сония; SWCC 30 итератсия; барои ҳар итератсия тақрибан 2–3 сония; pipeline-и пурра тақрибан 50–55 дақиқа.
Муҳити таҷрибавӣ: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Маблағгузорӣ: Таҳқиқот хабар медиҳад, ки маблағгузории беруна нагирифтааст.
Кумитаи ахлоқ: Ҳамчун татбиқнашаванда нишон дода шудааст.
Розигии огоҳона: Ҳамчун татбиқнашаванда нишон дода шудааст.
Дастрасии додаҳо: Манбаъ қайд мекунад, ки маҷмӯаҳои додаҳои Davidson ва Waseem аз repository-ҳои кушода гирифта шудаанд.
Саҳми муаллифон: Консептуализатсия M.S.A.; методология M.S.A. ва I.K.; нармафзор, валидасия, таҳлили формалӣ, таҳқиқот, захираҳо, курасияи додаҳо, тарҳи аввал ва визуализатсия M.S.A.; бозбинӣ ва таҳрир M.S.A.; роҳбарӣ I.K. ва A.A.; идоракунии лоиҳа ва ҷалби маблағ M.S.A. гузориш шудааст.
Бархӯрди манфиатҳо: Муаллифон бархӯрди манфиатҳоро гузориш накардаанд.
Ёддоштҳои муҳими бозтавлидшавӣ аз нигоҳи садоқат ба манбаъ
Дар бахши усули таҳқиқот модели embedding ҳамчун GroNLP/HateBERT муайян шудааст, вале дар бахши бозтавлидшавӣ номи Hate-speech-CNERG/bert-base-uncased-hatexplain дода мешавад. Ин ду checkpoint як модел нестанд. Аз ин рӯ, аз матни манбаъ дақиқ муайян карда намешавад, ки кадом checkpoint ҷадвалҳои ниҳоии самаранокиро тавлид кардааст.
Илова бар ин, дар тақсимоти синфии маҷмӯаҳои додаҳои истифодашуда ҳам дар дохили манбаъ ва ҳам нисбат ба манбаъҳои аслии додаҳо номувофиқатҳо мавҷуданд. Барои Waseem таносубҳои Ҷадвали 4 дар маҷмӯъ аз %100 мегузаранд. Таносубҳои синфие, ки барои Davidson гузориш шудаанд, низ бо тақсимоти label дар файли стандартии кушодаи додаҳо мувофиқ нестанд. Аз ин рӯ, махсусан ҳангоми репликасияи мустақили арзишҳои external Accuracy/F1 версияи додаҳои хом ва натиҷаи preprocessing бояд санҷида шаванд.
Дар notation-и математикӣ барои андозаи матритсаи centroid-и \(Z\) ва вазни ибтидоии subspace низ ифодаҳои гуногун мавҷуданд. Илова бар ин, ибораи “Please remove it from the final published version.”, ки пас аз Algorithm 1 дар матни нашршуда боқӣ мондааст, боқимондаи раванди таҳрирӣ мебошад.
Ин номувофиқатҳо дар матни Verianla хомӯшона ба як версияи “дуруст” табдил дода нашудаанд. Зеро таҳқиқоти манбаъ ба таври қатъӣ шарҳ намедиҳад, ки кадом алтернатива коди воқеии таҷрибавии муаллифонро намояндагӣ мекунад.
Ҳудуди тафсири илмӣ
Арзишҳои %93,1 Accuracy ва %93,5 F1 дар ин таҳқиқот натиҷаи низоми комилан автономии категориябандии гуфтори нафрат бо сифр тамғаи инсонӣ нестанд. %10-и тамғаҳо барои мутобиқсозии post hoc-и категория истифода мешаванд.
Гарчанде ангезаи таҳқиқот дар бораи implicit hate speech муҳим аст, натиҷаҳои таҷрибавӣ ба маҷмӯаҳои додаҳои Davidson ва Waseem, ки ба explicit-hate нигаронда шудаанд, такя мекунанд. Аз ин рӯ, сатҳи муваффақияти implicit hate гузориш нашудааст.
Муқоисаҳои Ҷадвали 7 бо моделҳои supervised низ як озмоиши benchmark бо train/test split-и муштарак, preprocessing-и муштарак ва буҷаи умумии label нестанд. Аз ин рӯ, гузаштани SWCC аз баъзе холҳои нашршуда набояд ҳамчун далели бартарии омории назоратшаванда бар ҳамаи ин моделҳо тафсир шавад.
Ниҳоят, модель танҳо дар додаҳои англисии Twitter арзёбӣ шудааст. Барои забонҳои дигар, платформаҳои дигари шабакаҳои иҷтимоӣ ва системаҳои воқеии модератсияи вақти воқеӣ валидасияи алоҳида лозим аст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд