

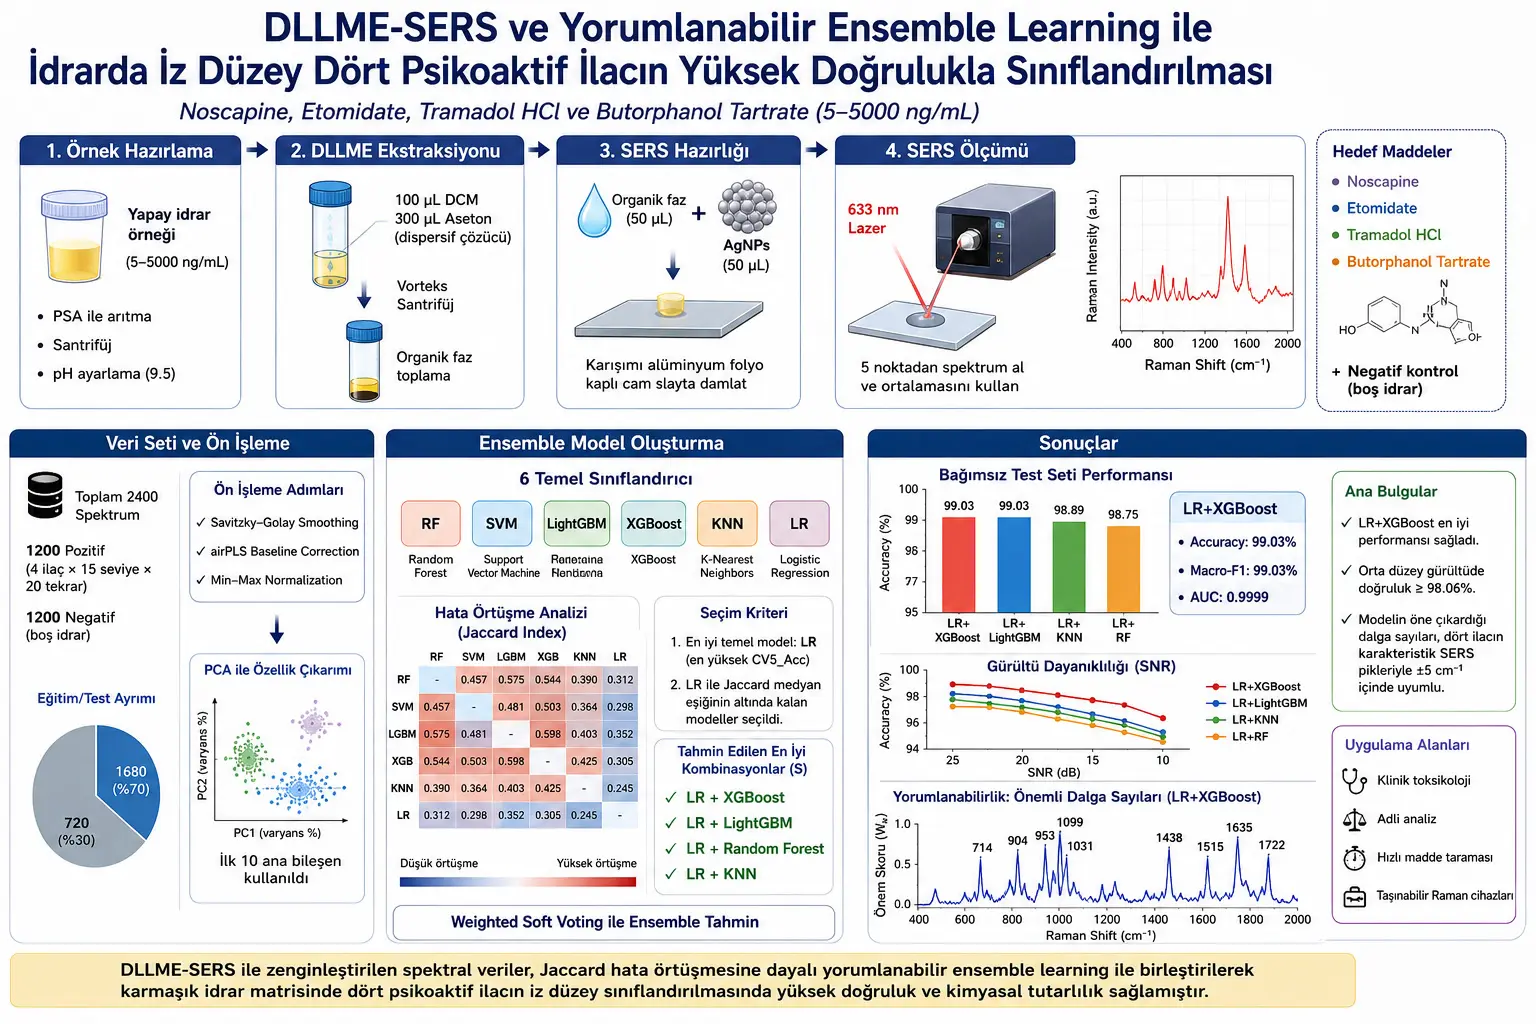
Matumizi mabaya ya dutu za kisaikolojia ni tatizo linalozidi kuwa muhimu kwa afya ya umma na sayansi za uchunguzi. Hasa katika hali ambapo dawa zaidi ya moja au dutu zenye miundo ya kemikali inayofanana zinaweza kuwepo katika mazingira yale yale ya kibaolojia, uchambuzi hauishii kwenye swali la “je, dutu ipo?”. Ni lazima pia ibainishwe kwa kuaminika ni dutu gani iliyopo, iko katika kiwango gani cha mkusanyiko na kama ishara hiyo kweli inatokana na molekuli husika.
Mkojo ni mojawapo ya sampuli za kibaolojia zinazotumiwa mara nyingi katika uchunguzi wa dutu. Sababu ni kwamba uchukuaji wa sampuli ni rahisi kiasi na si vamizi. Hata hivyo, uchambuzi wa mkojo si rahisi kikemia. Protini, urea, chumvi, metaboliti na viambajengo vingine vya ndani vinaweza kufunika ishara za dutu lengwa. Zaidi ya hayo, kama inavyosisitizwa katika utafiti, analiti lengwa zinaweza kuwa katika kiwango cha ng/mL. Hivyo kiasi cha dutu kinachochambuliwa ni kidogo sana na kinahitaji mkakati wenye nguvu wa kuongeza ishara au wa kuongeza mkusanyiko kabla ya kipimo.
Miongoni mwa mbinu za jadi, mbinu za kromatografia-spektrometria ya molekuli kama GC-MS na LC-MS/MS zinachukuliwa kuwa zenye nguvu na za kuaminika. Hata hivyo, mifumo hii inahitaji vifaa vya gharama kubwa, wafanyakazi waliopata mafunzo, taratibu tata za maandalizi na miundombinu ya maabara. Vipimo vya immunokromatografia vinaweza kuwa vya haraka; lakini vinaweza kuwa na matatizo kama mmenyuko mtambuka, matokeo chanya ya uongo na mipaka katika kutofautisha dutu nyingi. Kwa hiyo watafiti wanaelekea kwenye mbinu za spektroskopi zilizo za haraka zaidi, zenye gharama ndogo na zinazoweza kutoa alama ya kidole ya molekuli.
Spektroskopi ya Raman ni mbinu inayozalisha “alama ya kidole ya kemikali” kulingana na modi za mtetemo za molekuli. Kila molekuli hutoa ishara katika namba maalumu za mawimbi kulingana na muundo wa vifungo na sifa zake za mtetemo. Hata hivyo, ishara ya kawaida ya Raman mara nyingi huwa dhaifu. Hapa ndipo mbinu ya SERS inapoingia. Nanomiundo ya metali adhimu kama fedha au dhahabu inaweza kuimarisha uga wa sumakuumeme karibu na molekuli na kuongeza ishara ya Raman kwa viwango kadhaa vya ukubwa. Hivyo ishara za molekuli za kiwango cha athari ambazo kwa kawaida zingekuwa dhaifu sana zinaweza kupimika.
Katika utafiti huu, kabla ya SERS, DLLME ilitumika. Lengo la DLLME ni kuvuta dutu lengwa kutoka kwenye mkojo hadi katika awamu ndogo ya kikaboni na kuzikusanya kiasi cha kutosha kupata ishara. Kwa mfano wa kawaida, fikiria kiasi kidogo sana cha dutu kilichoyeyushwa katika glasi kubwa ya maji. Inaweza kuwa vigumu kuipima moja kwa moja. Lakini ukiweza kuikusanya katika tone dogo, kipimo huwa wazi zaidi. DLLME hufanya kazi kwa mantiki sawa: huongeza mkusanyiko wa molekuli lengwa zilizopo kwa kiwango kidogo katika sampuli tata ndani ya awamu ya kiyeyusho yenye ujazo mdogo.
Katika utafiti, mchakato wa maandalizi ya sampuli una hatua kadhaa. Kwanza, dawa lengwa ziliongezwa kwenye sampuli za mkojo bandia. Kwa usafishaji wa mkojo, 2.0 mL ya spiked artificial urine, yaani sampuli ya mkojo bandia iliyoongezewa dutu, ilichukuliwa; 100 mg PSA ikaongezwa, mchanganyiko ukavurugwa kwa vortex na kusentrifujwa. Kisha 1.0 mL kutoka awamu ya juu ilichukuliwa na hatua ya uchimbaji ikaanza.
Katika hatua ya DLLME, pH ya sampuli ilirekebishwa hadi 9.5. Kisha 100 μL ya dichloromethane kama kiyeyusho cha uchimbaji na 300 μL ya acetone kama kiyeyusho cha kutawanya viliongezwa haraka. Mchanganyiko ulivurugwa kwa vortex na kutengeneza emulsheni yenye ukungu; baada ya kusentrifujwa, awamu ya kikaboni ya chini ilikusanywa kwa microsyringe. Hatua hii hujilimbikiza molekuli lengwa katika awamu inayofaa zaidi kwa uchambuzi.
Nanochembe za fedha zilitumiwa kuimarisha ishara ya SERS. Chembe hizi, zilizofupishwa kama AgNPs, ziliandaliwa kwa mbinu ya upunguzaji wa sitrati ya Lee-Meisel. Katika utafiti, suluhisho la silver nitrate lilichemshwa, suluhisho la trisodium citrate likaongezwa na kutokea kwa nanochembe kukazingatiwa wakati suluhisho lilipobadilika kuwa rangi ya manjano-kijani. Kulingana na sifa za SEM, chembe zilionyesha mofolojia ya karibu nusu-duara yenye kipenyo wastani cha takribani 60 nm.
Katika kipimo cha spektra, mfumo wa kubebeka wa utambuzi wa Raman ulioundwa maabara ulitumika. Mfumo ulifanya kazi kwa leza ya 633 nm. 50 μL kutoka awamu ya kikaboni ilichukuliwa na kuchanganywa na ujazo sawa wa suluhisho lililokolezwa la nanochembe za fedha; kisha 10 μL ya mchanganyiko ilidondoshwa kwenye slaidi safi ya kioo iliyofunikwa kwa foil ya alumini. Kwa kila sampuli, spektra tano zilichukuliwa kutoka sehemu tofauti za uso wa tone na wastani wake ukatumika kama spektra wakilishi ya sampuli hiyo.
Seti ya data iliundwa kwa mpangilio mzuri. Kwa kila dawa lengwa, sampuli 20 zilizoandaliwa kwa kujitegemea zilipimwa katika viwango 15 vya mkusanyiko. Hii inamaanisha spektra chanya 1200 kwa hesabu ya dawa 4 × viwango 15 × sampuli 20. Aidha, spektra hasi 1200 zilichukuliwa kutoka mkojo bandia tupu uliopitia mchakato ule ule. Hivyo jumla ya spektra 2400 zilipatikana. Masafa ya spektra yalitajwa kuwa 159–1996 cm⁻¹.
Spektra ghafi za Raman/SERS hazikuingizwa moja kwa moja kwenye modeli. Kwanza kelele ilipunguzwa kwa Savitzky-Golay smoothing, mwinuko wa msingi ukasahihishwa kwa airPLS baseline correction na ishara zikapimwa katika masafa ya 0–1 kwa Min-Max normalization. Hatua hizi za uchakataji wa awali ni muhimu sana katika spektroskopi; kwa sababu haitakiwi modeli ijifunze kelele za kifaa, uhamaji wa baseline au tofauti za kipimo cha intensiti badala ya tofauti halisi za kemikali.
Kisha seti ya data iligawanywa kwa uwiano wa 7:3 kuwa seti ya mafunzo na seti huru ya majaribio. Spektra 1680 ziliwekwa kwenye seti ya mafunzo na spektra 720 kwenye seti huru ya majaribio. Jambo muhimu hasa ni kwamba vigezo vya PCA na StandardScaler vilijifunzwa kwenye seti ya mafunzo pekee na seti ya majaribio ikaprojewa kwa mabadiliko yale yale. Njia hii ni muhimu ili kuzuia uvujaji wa taarifa. Ikiwa taarifa kutoka seti ya majaribio itaingia kwenye modeli wakati wa uchakataji wa awali, utendaji wa majaribio unaweza kuonekana wa juu kuliko ulivyo.
Kwa uchimbaji wa vipengele, PCA, yaani principal component analysis ilitumika. PCA hupunguza data ya spektra yenye vipimo vingi hadi idadi ndogo ya vipengele. Spektra inaweza kuwa na mamia au maelfu ya pointi za namba za mawimbi; lakini si zote zinazobeba taarifa ya kiwango sawa kwa uainishaji. PCA hubadilisha vyanzo vikubwa zaidi vya utofauti katika data kuwa mhimili mipya na kuipa modeli nafasi ya vipengele inayoweza kudhibitiwa zaidi.
Katika utafiti, idadi ya vipengele vya PCA ilitathminiwa kwa kutumia LightGBM probe model. Kama inavyoonyeshwa katika Kielelezo 3a, usahihi ulifikia plateau karibu na n=8 na haukuonyesha uboreshaji mkubwa baada ya n=10. Kwa hiyo vipengele vikuu 10 vya kwanza vilihifadhiwa. Hii ina maana kwamba modeli ilifanya kazi katika nafasi ya vipengele vya PCA yenye vipimo 10 badala ya spektra ghafi.
Kielelezo 3b na 3c vinaonesha utengano kati ya madarasa kwa mchoro wa kutawanyika wa PCA wa vipimo vitatu na mbinu ya upachikaji ya t-SNE. Ukiangalia vipengele vikuu vitatu vya kwanza, kuna mielekeo fulani ya makundi kati ya madarasa; lakini mipaka si wazi kabisa. Hasa kunaweza kuwa na mwingiliano kati ya noscapine, etomidate na kidhibiti hasi. Uwasilishaji wa t-SNE unaonyesha makundi yaliyoshikamana zaidi kwa etomidate na tramadol hydrochloride, huku ukionyesha kwamba kidhibiti hasi kimesambaa karibu na baadhi ya mipaka ya madarasa. Hii inaonyesha kwamba utengano rahisi wa mstari pekee hautoshi na waainishaji wanahitaji kuchota taarifa nyeti zaidi za kutofautisha.
Katika sehemu ya machine learning ya utafiti, waainishaji sita wa msingi walitathminiwa: Random Forest, Support Vector Machine, LightGBM, XGBoost, K-Nearest Neighbors na Logistic Regression. Modeli hizi zinawakilisha familia tofauti za kialgorithimu. Logistic Regression hutoa njia ya mstari na ya kitakwimu zaidi, wakati XGBoost na LightGBM ni modeli za miti zenye gradient boosting. SVM inalenga kupata mpaka wa uamuzi, KNN inategemea uhusiano wa ujirani, na Random Forest hutumia wastani wa miti mingi ya uamuzi.
Kila moja ya modeli hizi sita iliboreshwa kwa uthibitishaji mtambuka wa fold 5 na grid search. Kulingana na matokeo, modeli zote za msingi zilifikia usahihi wa uthibitishaji mtambuka wa zaidi ya %97.3. Logistic Regression ilionyesha %99.29 ± 0.24 CV5_Acc kama modeli bora ya msingi. SVM na XGBoost zilifuata. Hata hivyo, kwa kuwa utendaji wa modeli moja moja tayari ulikuwa juu, mbinu ya ensemble ilionekana muhimu ili kupata uboreshaji zaidi.
Hapa ndipo upande wa kipekee wa utafiti unapoonekana. Ensemble learning inalenga kutoa uamuzi wenye nguvu zaidi kwa kuunganisha modeli zaidi ya moja. Lakini si kila mchanganyiko wa modeli una manufaa. Ikiwa modeli mbili zinafanya makosa kwenye sampuli zilezile, kuziunganisha hakuleti faida kubwa. Kinyume chake, ikiwa modeli mbili zinafanya makosa kwenye sampuli tofauti, moja inaweza kusahihisha kosa la nyingine. Utafiti unasawazisha wazo hili kwa Jaccard error overlap index.
Katika utafiti, faharasa ya mwingiliano wa makosa ya Jaccard imefafanuliwa kwa mantiki ifuatayo:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Katika fomula hii, Mi na Mj zinawakilisha waainishaji wawili tofauti wa msingi. Ei ni seti ya sampuli ambazo modeli i imeainisha vibaya. Ej ni seti ya sampuli ambazo modeli j imeainisha vibaya. Ei ∩ Ej inaonyesha sampuli ambazo modeli zote mbili zimekosea kwa pamoja; Ei ∪ Ej inaonyesha jumla ya sampuli ambazo angalau modeli moja imekosea. Thamani ya J hubadilika kati ya 0 na 1. Ikiwa thamani ni ndogo, mifumo ya makosa ya modeli hizo mbili ni tofauti zaidi; jambo hili linaweza kuonyesha uwezo mkubwa zaidi wa kukamilishana ndani ya ensemble.
Kwa mfano wa kila siku, fikiria maafisa wawili wa ukaguzi. Ikiwa wote wawili kila mara wanakosa makosa yale yale, kufanya kazi pamoja hakuongezi sana uaminifu. Lakini ikiwa mmoja anatambua vizuri makosa ya aina A na mwingine makosa ya aina B, kwa pamoja wanaweza kutoa matokeo ya kuaminika zaidi. Faharasa ya mwingiliano wa makosa ya Jaccard inatoa jibu la namba kwa swali la kama modeli “zinafanya makosa yale yale au makosa tofauti?”.
Kwa kutumia faharasa hii, watafiti walipendekeza kigezo cha uteuzi cha hatua mbili kinachoitwa select-the-best, pair-the-best. Katika hatua ya kwanza, modeli ya msingi yenye thamani ya juu zaidi ya CV5_Acc ilichaguliwa kama mwanachama wa lazima. Modeli hiyo ni Logistic Regression. Katika hatua ya pili, mwingiliano wa makosa wa Jaccard kati ya Logistic Regression na modeli nyingine ulihesabiwa, na mediana ya thamani zote za Jaccard za jozi ikatumika kama kizingiti. Modeli zilizoonyesha mwingiliano wa makosa na LR chini ya kizingiti hicho zilichukuliwa kuwa wagombea wazuri wa kuunganishwa.
Hatimaye, seti iliyotabiriwa ya mchanganyiko bora iliundwa kama ifuatavyo:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Hapa, S inawakilisha mchanganyiko wa ensemble wa jozi unaotarajiwa kuwa bora kinadharia. Jambo muhimu katika utafiti ni kwamba seti hii haikuachwa kama utabiri pekee. Watafiti walijaribu mchanganyiko wote 15 wa jozi unaowezekana kutoka modeli sita kwa exhaustive comparison, yaani ulinganisho kamili.
Kutokana na ulinganisho kamili, mchanganyiko minne ya kwanza katika orodha ya CV5_Acc kweli ilikuwa LR+XGBoost, LR+LightGBM, LR+RF na LR+KNN. Matokeo haya yanaunga mkono uwezo wa kutabiri wa kigezo cha “select-the-best, pair-the-best” kinachoongozwa na mwingiliano wa makosa wa Jaccard. Hasa, mchanganyiko wa LR+XGBoost ulikuwa wa kwanza kwa %99.40 ± 0.42 CV5_Acc. LR+LightGBM ilifikia %99.35 ± 0.39, huku LR+RF na LR+KNN zikifikia %99.29 ± 0.24.
Matokeo ya seti huru ya majaribio pia yanaunga mkono mfumo huu. Usahihi wa mchanganyiko minne katika seti S ulikuwa kati ya %98.75 na %99.03. LR+XGBoost na LR+LightGBM zilionyesha utendaji bora zaidi kwa ujumla, zote zikifikia %99.03 Accuracy na %99.03 Macro-F1. Miongoni mwa mchanganyiko wa udhibiti, LightGBM+XGBoost ilitoa usahihi wa %97.92 pekee. Hii inaonyesha kwamba kuunganisha modeli zilizo karibu katika familia ileile ya kialgorithimu na zenye mwingiliano mkubwa wa makosa si lazima kutoa matokeo mazuri kila wakati.
Tathmini kwa kila darasa katika utafiti pia inaonyesha ni katika dutu zipi modeli ilikumbana na ugumu zaidi. Kidhibiti hasi, noscapine na butorphanol tartrate zilionyesha thamani za recall za juu zaidi, huku etomidate na tramadol hydrochloride zikionyesha mwelekeo wa recall ya chini. Sababu ya kikemia ni kwamba mitetemo ya kupumua ya pete ya benzene ya dutu hizo mbili ina mwingiliano mkubwa karibu na 1000 cm⁻¹. Kwa hiyo eneo ambalo modeli inapata ugumu si kosa la nasibu, bali ni eneo ambako spektra za kemikali kweli zinakaribiana.
Ustahimilivu wa kelele pia ulijaribiwa katika utafiti. Kelele nyeupe ya Gaussian iliongezwa kwenye seti ya majaribio katika viwango vya SNR vya 25, 20, 15 na 10 dB. Katika kelele ya wastani, hasa katika hali ya 15 dB SNR, usahihi wa mchanganyiko minne katika seti S uliendelea kuwa zaidi ya %98.06. Hata katika hali kali ya kelele ya 10 dB, usahihi wa mchanganyiko huu uliendelea kuwa %96.53. Hili linaonyesha kwamba modeli zilizochaguliwa zilibaki thabiti kwa kiasi si tu kwenye spektra safi, bali pia wakati ishara iliharibika.
Hata hivyo, matokeo haya yanapaswa kusomwa kwa tahadhari. Ustahimilivu wa kelele hauwakilishi ugumu wote wa sampuli halisi za kliniki. Sampuli halisi za mkojo zinaweza kuwa na vigezo vingi kama tofauti za kimetaboliki kati ya watu, metaboliti za dawa, pH tofauti, dutu zinazoambatana, utendaji wa figo, lishe, ugonjwa, uchafuzi na hali za uhifadhi wa sampuli. Kwa kuwa utafiti ulifanywa kwenye mkojo bandia, uthibitishaji wa kliniki/uchunguzi katika sampuli halisi unahitajika kama hatua inayofuata.
Nguvu nyingine ya utafiti ni mnyororo wa ufasirikaji. Hata kama modeli za machine learning zinatoa usahihi wa juu, katika uchambuzi wa kemikali swali la “kwa nini modeli ilifanya uamuzi huu?” ni muhimu sana. Ikiwa uamuzi wa modeli unategemea artefact za uchakataji wa data au kelele za nasibu badala ya peaks halisi za molekuli, usahihi wa juu huenda usimaanishe ushahidi wa kemikali unaoaminika. Kwa sababu hiyo watafiti walirudisha permutation importance values kwenye nafasi ya awali ya namba za mawimbi kupitia PCA loadings.
Uhusiano uliotumika kwa ufasirikaji huu umetolewa katika utafiti kama ifuatavyo:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Katika fomula hii, Wk, inaonyesha jumla ya alama ya umuhimu ya pointi ya k ya namba ya mawimbi. PIi, ni thamani ya permutation importance ya principal component ya i. Lik, ni mgawo wa loading wa namba ya mawimbi ya k katika principal component ya i. n, ni idadi ya principal components zilizohifadhiwa. Katika utafiti n=10 ilichaguliwa. Lengo la fomula ni kurudisha mchango wa uamuzi wa modeli kutoka nafasi ya PCA hadi kwenye mhimili wa awali wa namba za mawimbi wa Raman.
Tunaweza kufikiria hivi: Modeli haikujifunza spektra ghafi moja kwa moja, bali ilitumia vipengele vya PCA. Hata hivyo, tafsiri ya kemikali hufanywa katika namba za mawimbi ghafi. Kwa hiyo swali la “ni kipengele kipi cha PCA kilikuwa muhimu kwa modeli?” lazima libadilishwe kuwa “umuhimu huo unaendana na namba zipi za mawimbi za Raman?”. Back-projection, yaani kurudisha projection, ndiyo hufanya hivyo.
Namba za mawimbi zinazojitokeza katika uchambuzi wa ufasirikaji zinaendana kwa kiasi kikubwa na peaks za SERS za tabia ya dawa nne. Kwa noscapine, maeneo ya 904 cm⁻¹ na 1635 cm⁻¹; kwa etomidate, 952/953 cm⁻¹, 1030/1031 cm⁻¹ na 1726/1722 cm⁻¹; kwa tramadol hydrochloride, 715/714 cm⁻¹ na 1000/999 cm⁻¹; na kwa butorphanol tartrate, 1437/1438 cm⁻¹ na 1515 cm⁻¹ yalionekana kuwa ya kuamua. Utafiti unasema kwamba mikengeuko hii ilibaki ndani ya 5 cm⁻¹.
Hali hii ni muhimu kisayansi. Modeli haikufanya kazi tu kama kiainishaji cha takwimu; katika maamuzi yake ilitumia maeneo yanayolingana na modi halisi za mtetemo wa kemikali. Kwa mfano, kunyooshwa kwa C-O-C kwenye pete ya lactone ya noscapine karibu na 904 cm⁻¹ kulibainishwa kama peak muhimu zaidi ya modeli. Kwa butorphanol tartrate, eneo la 1438 cm⁻¹ lilihusishwa na kunyooshwa kwa aromatiki C=C. Mwingiliano karibu na 1000 cm⁻¹ kwa tramadol na etomidate unaeleza msingi wa kikemia wa ugumu wa kutenganisha madarasa haya mawili.
Muhtasari wa kielelezo wa utafiti na Kielelezo 1 unaeleza kwa kuona mtiririko wa jumla wa mbinu. Sehemu ya kwanza inaonyesha sampuli ya mkojo, uchimbaji kwa DLLME, upatikanaji wa ishara ya SERS kwa AgNPs na kipimo cha spektra. Sehemu ya kati inaonyesha uteuzi wa modeli za RF, SVM, LightGBM, XGBoost, KNN na LR, matriksi ya mwingiliano wa makosa wa Jaccard na ujenzi wa mchanganyiko unaozunguka LR. Sehemu ya mwisho inaonyesha tathmini ya modeli ya ensemble, ustahimilivu wa kelele na grafu za umuhimu wa namba za mawimbi. Kielelezo hiki kinaonyesha wazi kwamba utafiti umeunda kemia ya maabara na uteuzi wa modeli ya AI kama mchakato mmoja.
Kielelezo 2 kinaonyesha spektra za DLLME-SERS za dawa nne katika viwango tofauti vya mkusanyiko. Inaelezwa kwamba kadiri mkusanyiko unavyoongezeka, intensiti ya peaks za tabia huongezeka, huku nafasi za peaks zikibaki thabiti. Hii inaonyesha kwamba mbinu huzalisha ishara inayohisi mabadiliko ya mkusanyiko lakini huhifadhi nafasi za alama za kidole za molekuli. Pia, kwa kuwa etomidate na tramadol hydrochloride zina mwingiliano wa peak karibu na 1000 cm⁻¹, inaonekana kwamba kutofautisha kwa macho pekee kunaweza kuwa vigumu.
Kielelezo 4 kinaonyesha kwa nini uteuzi wa modeli hauwezi kufanywa tu kwa mantiki ya “unganisha modeli mbili zenye usahihi mkubwa zaidi”. Utendaji wa kila modeli ya msingi ni mkubwa; lakini matriksi ya mwingiliano wa makosa inaonyesha kwamba baadhi ya modeli hufanya makosa yanayofanana. Hasa, mwingiliano mkubwa wa makosa kati ya modeli za msingi wa miti unaonyesha kwamba kuziunganisha kunaweza kutoa faida ndogo ya ensemble. Kinyume chake, thamani ndogo za Jaccard kati ya LR na KNN, RF, LightGBM na XGBoost zinaonyesha uwezo wa kukamilishana.
Kielelezo 5 kinawasilisha kwa pamoja utendaji wa seti huru ya majaribio, vipimo vya kila darasa, ustahimilivu wa kelele na usambazaji wa umuhimu wa namba za mawimbi unaoweza kufasiriwa. Ujumbe muhimu zaidi wa kielelezo hiki ni kwamba modeli haikutoa usahihi wa juu pekee; pia ilibaki thabiti chini ya kelele na ilitegemeza maamuzi yake kwenye maeneo ya namba za mawimbi yenye maana ya kikemia.
Umuhimu wa kihistoria wa utafiti ni kwamba unalenga mapengo mawili katika fasihi ya SERS-ML. Kwanza, wanachama wa modeli za ensemble mara nyingi huchaguliwa bila uhalali wa kiasi. Pili, haiwezi kufuatiliwa kikemia ni Raman shifts zipi zinazotumika katika maamuzi ya modeli. Utafiti huu unajaribu kuhalalisha uteuzi wa modeli kwa ukamilishanaji wa makosa na kuhusisha maamuzi ya modeli na peaks za kemikali.
Kwa mtazamo wa leo, utafiti unajibu hitaji la uchunguzi wa haraka. Katika toxicology ya kliniki, maabara za uchunguzi na ufuatiliaji wa matumizi mabaya ya dutu, kuna haja ya mifumo yenye usikivu wa juu, ya haraka na inayobebeka. Mbinu za spektroskopi kama DLLME-SERS, ingawa haziahidi nguvu ya uthibitishaji wa mwisho kama mass spectrometry, zinaweza kuwa na thamani kwa uchunguzi wa awali wa haraka au uchambuzi karibu na eneo la tukio.
Kwa mtazamo wa baadaye, utafiti unaonyesha umuhimu wa modeli za AI ya kemikali zinazoweza kufasiriwa. Katika kemia ya uchambuzi, haitoshi AI kuwa “black box inayotabiri kwa usahihi”. Hasa katika mazingira ya uchunguzi na kliniki, lazima ielezwe kwa nini modeli ilifanya uamuzi, ilitegemea peak gani ya kemikali na kama uamuzi huo unaendana na mitetemo halisi ya molekuli. Utafiti huu unatumia mchanganyiko wa back-projection kupitia PCA loadings na permutation importance kwa lengo hili.
Miongoni mwa nguvu za utafiti ni ujenzi wa seti ya data iliyo na mpangilio, matumizi ya seti huru ya majaribio, mgawanyo wa mafunzo/majaribio unaolenga kuzuia uvujaji wa taarifa, ulinganisho wa mchanganyiko wote 15 wa jozi, jaribio la ustahimilivu wa kelele na uchambuzi wa ufasirikaji wa kemikali. Aidha, kuonyesha kwamba namba za mawimbi za uamuzi wa modeli zinaendana na peaks za SERS za tabia kunafanya matokeo yaweze kufasiriwa kwa maana zaidi ya kemikali.
Kwa upande mwingine, vikwazo lazima vitajwe wazi. Utafiti ni preprint ambayo haijapitia tathmini ya wenzao. Sampuli ni mkojo bandia, si mkojo halisi wa kliniki. Utafiti umewekewa kikomo cha dawa nne. Kigezo cha uteuzi kinachotegemea Jaccard kimejaribiwa kwenye waainishaji sita tu; inahitaji kuchunguzwa kama kitafanya kazi kwa namna hiyo hiyo katika hazina kubwa zaidi za modeli. Aidha, katika sampuli halisi za uchunguzi, mchanganyiko, metaboliti, bidhaa za uharibifu, muundo tofauti wa mkojo kati ya watu na uwepo wa dutu nyingi vinaweza kuwa tata zaidi.
Utafiti unasema hivi: data za spektra za kiwango cha athari zilizopatikana kwa DLLME-SERS zinaweza kuainishwa kwa usahihi wa juu kwa uchakataji sahihi wa awali, uchimbaji wa vipengele wa PCA, modeli za ensemble zilizochaguliwa kwa ukamilishanaji wa makosa wa Jaccard na mnyororo wa ufasirikaji wa kemikali. Utafiti hausomi hivi: mbinu hii tayari iko tayari kutumiwa kama utambuzi wa uhakika au ushahidi wa kisheria katika sampuli halisi za mkojo wa kliniki/uchunguzi. Kwa hilo, tafiti zaidi kwa sampuli halisi, paneli pana za dawa, hali za mchanganyiko na uthibitishaji wa maabara huru zinahitajika.
Mbinu na Matokeo ya Utafiti
Utafiti una muundo wa majaribio na ukokotozi unaounganisha uchambuzi wa maabara na machine learning kwa uainishaji wa kiwango cha athari wa dawa nne za kisaikolojia katika matriksi ya mkojo bandia.
Dutu lengwa:
| Dutu | Jukumu lake katika Utafiti | Maeneo Makuu ya Peak za SERS |
| Noscapine | Mojawapo ya dawa nne lengwa za kisaikolojia. | 904 cm⁻¹ na 1635 cm⁻¹. |
| Etomidate | Dutu lengwa inayojaribiwa kutofautishwa kupitia mitetemo ya pete ya benzene. | 952, 1004, 1030 na 1726 cm⁻¹. |
| Tramadol hydrochloride | Dutu lengwa inayoonyesha mwingiliano wa peak na etomidate karibu na 1000 cm⁻¹. | 715 na 1000 cm⁻¹. |
| Butorphanol tartrate | Dutu lengwa inayotofautishwa kupitia maeneo ya kunyooshwa kwa aromatiki C=C. | 1437 na 1515 cm⁻¹. |
Maandalizi ya sampuli na kipimo cha SERS:
- Sampuli za mkojo bandia ziliongezewa dutu lengwa.
- Kwa usafishaji wa mkojo, 100 mg PSA iliongezwa kwenye 2.0 mL ya sampuli, kisha vortex na centrifugation zikafanywa.
- Kwa DLLME, pH ilirekebishwa hadi 9.5, na 100 μL dichloromethane pamoja na 300 μL acetone zilitumika.
- Nanochembe za fedha ziliandaliwa kwa mbinu ya upunguzaji wa sitrati ya Lee-Meisel.
- Inaelezwa kwamba AgNPs zilikuwa na muundo wa karibu nusu-duara wenye kipenyo wastani cha takribani 60 nm.
- Vipimo vya SERS vilifanywa kwa mfumo wa Raman unaobebeka wenye leza ya 633 nm.
- Kwa kila sampuli, spektra zilichukuliwa kutoka pointi tano tofauti na wastani wake ukatumika.
Seti ya data:
| Kipengele cha Data | Thamani | Maana yake |
| Idadi ya dawa lengwa | 4 | Noscapine, etomidate, tramadol hydrochloride, butorphanol tartrate. |
| Masafa ya mkusanyiko | 5–5000 ng/mL | Masafa ya uainishaji yanayoanzia kiwango cha athari hadi viwango vya juu zaidi. |
| Idadi ya viwango vya mkusanyiko | 15 | Pointi tofauti za mkusanyiko zilitumika kwa kila dawa. |
| Sampuli huru kwa kila mkusanyiko | 20 | Kwa kila dawa lengwa, sampuli 15 × 20 ziliandaliwa. |
| Spektra chanya | 1200 | Zilipatikana kwa hesabu ya 4 × 15 × 20. |
| Spektra hasi | 1200 | Zilichukuliwa kutoka sampuli tupu za mkojo bandia. |
| Jumla ya spektra | 2400 | Jumla ya data iliyotumika kwa modeli. |
| Mgawanyo wa mafunzo/majaribio | 1680 / 720 | Iligawanywa kwa uwiano wa 7:3. |
| Masafa ya spektra | 159–1996 cm⁻¹ | Masafa ya namba za mawimbi ya kipimo cha SERS. |
Hatua za uchakataji wa awali:
- Savitzky-Golay smoothing: ukubwa wa dirisha 11, daraja la polynomial 3.
- airPLS baseline correction: λ = 10⁵, kiwango cha juu cha marudio 100, convergence tolerance 10⁻⁶.
- Min-Max normalization: ishara zilipimwa katika masafa ya 0–1.
- Uchimbaji wa vipengele ulifanywa kwa PCA.
- Vipengele vikuu 10 vya kwanza vilihifadhiwa kwa modeli.
- Ili kuzuia uvujaji wa taarifa, PCA na StandardScaler zilifitishwa kwenye seti ya mafunzo pekee.
Waainishaji wa msingi waliotumika:
| Modeli | Kifupisho | Jukumu lake katika Utafiti |
| Random Forest | RF | Modeli ya msingi ya ensemble inayotegemea miti. |
| Support Vector Machine | SVM | Kiainishaji kinacholenga mpaka wa uamuzi. |
| LightGBM | LGBM | Modeli ya miti yenye gradient boosting. |
| XGBoost | XGB | Modeli yenye nguvu ya miti yenye gradient boosting. |
| K-Nearest Neighbors | KNN | Kiainishaji kinachotegemea uhusiano wa ujirani. |
| Logistic Regression | LR | Mwanachama wa lazima wa ensemble aliyetoa thamani ya juu zaidi ya msingi ya CV5_Acc. |
Fomula ya mwingiliano wa makosa wa Jaccard:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Katika fomula hii, Ei na Ej, ni seti za sampuli ambazo modeli mbili tofauti zimeainisha vibaya. Thamani ya J ikiwa ndogo, mifumo ya makosa ya modeli huwa tofauti zaidi na uwezekano wa kukamilishana ndani ya ensemble huwa mkubwa zaidi.
Kigezo cha uteuzi wa modeli:
- Select-the-best: Modeli ya msingi yenye CV5_Acc ya juu zaidi huchaguliwa. Katika utafiti huu LR ilichaguliwa.
- Pair-the-best: Mwingiliano wa makosa wa Jaccard kati ya LR na modeli nyingine huhesabiwa.
- Mediana ya thamani zote 15 za Jaccard za jozi ilitumika kama kizingiti.
- Modeli zilizoonyesha mwingiliano wa makosa na LR chini ya kizingiti zilikubaliwa kama wagombea wazuri wa kuunganishwa.
Seti iliyotabiriwa ya ensemble bora:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Matokeo ya modeli za msingi na ensemble:
| Matokeo | Matokeo ya Namba | Tafsiri |
| Thamani ya CV5_Acc ya modeli zote za msingi | Angalau %97.3 | Nafasi ya vipengele vya PCA yenye vipimo 10 hubeba taarifa yenye nguvu ya uainishaji. |
| Modeli bora ya msingi | LR, %99.29 ± 0.24 CV5_Acc | Ilifanywa mwanachama wa lazima wa ensemble kwa sababu ilionyesha utendaji wa juu zaidi wa mtu mmoja. |
| Masafa ya Jaccard | 0.245–0.575 | Mwingiliano wa makosa wa modeli ulitofautiana kwa kiwango kikubwa. |
| Kizingiti cha mediana cha Jaccard | 0.361 | Modeli zilizo chini ya kizingiti hiki kwa LR zilichaguliwa. |
| LR+XGBoost CV5_Acc | %99.40 ± 0.42 | Ilikuwa mchanganyiko wa juu zaidi katika ulinganisho kamili. |
| LR+LightGBM CV5_Acc | %99.35 ± 0.39 | Ni mojawapo ya mchanganyiko wa pili wenye nguvu zaidi. |
| LR+RF na LR+KNN CV5_Acc | %99.29 ± 0.24 | Inalingana na seti ya mchanganyiko mizuri iliyotabiriwa. |
Matokeo ya seti huru ya majaribio:
| Modeli / Mchanganyiko | Matokeo | Tafsiri |
| LR+XGBoost | %99.03 Accuracy, %99.03 Macro-F1, AUC 0.9999 | Mojawapo ya mchanganyiko wenye utendaji bora kwa ujumla. |
| LR+LightGBM | %99.03 Accuracy na Macro-F1 | Ilifikia usahihi wa majaribio sawa na LR+XGBoost. |
| LR+KNN | %98.89 Accuracy | Ipo ndani ya seti nzuri iliyotabiriwa. |
| LR+RF | %98.75 Accuracy | Ipo ndani ya seti nzuri iliyotabiriwa. |
| SVM+LR | %98.72 Accuracy | Ingawa utendaji wake ni wa karibu, mwingiliano wa makosa ni mkubwa. |
| LightGBM+XGBoost | %97.92 Accuracy | Mwingiliano mkubwa wa makosa wa modeli zilizo karibu katika familia moja ulizuia faida ya ensemble. |
Ustahimilivu wa kelele:
- Kelele nyeupe ya Gaussian iliongezwa kwenye seti ya majaribio katika viwango vya SNR vya 25, 20, 15 na 10 dB.
- Katika hali ya kelele ya wastani kama 15 dB, mchanganyiko minne katika seti S ulionyesha usahihi wa zaidi ya %98.06.
- Hata katika hali kali zaidi ya kelele ya 10 dB, usahihi uliendelea kuwa %96.53.
- LR+LightGBM ilionyesha usahihi wa %99.17 katika 25 dB SNR; inaelezwa kwamba tofauti hii ni mtikisiko mdogo unaolingana na sampuli moja tu kati ya 720.
- Mchanganyiko katika seti S ulionekana kuwa thabiti zaidi kuliko udhibiti wa LightGBM+XGBoost wenye muundo wa makosa unaofanana.
Fomula ya ufasirikaji wa kemikali:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Katika fomula hii, Wk, inaonyesha jumla ya alama ya umuhimu ya pointi ya k ya namba ya mawimbi; PIi, thamani ya permutation importance ya principal component ya i; Lik, loading ya namba ya mawimbi ya k katika principal component ya i; n inaonyesha idadi ya principal components zilizotumika. Back-projection hii ilitumika kueleza ni maeneo gani ya namba za mawimbi za Raman ambayo uamuzi wa modeli ulitegemea.
Namba za mawimbi za kemikali zilizoangaziwa na modeli:
| Namba ya Mawimbi | Chanzo Kinachohusishwa | Maana ya Kemikali |
| 904 cm⁻¹ | Noscapine | Kunyooshwa kwa C-O-C ya pete ya lactone. |
| 1438 cm⁻¹ | Butorphanol tartrate | Eneo la kunyooshwa kwa aromatiki C=C. |
| 1635 cm⁻¹ | Noscapine | Kunyooshwa kwa aromatiki C=C. |
| 953 cm⁻¹ | Etomidate | Deformation ya nje ya ndege ya pete ya benzene. |
| 999 cm⁻¹ | Tramadol / Etomidate | Modi inayopishana ya kupumua ya pete ya benzene. |
| 714 cm⁻¹ | Tramadol hydrochloride | Mtetemo unaohusiana na pete ya benzene. |
| 1031 cm⁻¹ | Etomidate | Mtetemo wa pete ya benzene/imidazole. |
| 1515 cm⁻¹ | Butorphanol tartrate | Kunyooshwa kwa aromatiki C=C. |
| 1722 cm⁻¹ | Etomidate | Kunyooshwa kwa carbonyl C=O. |
| 449 na 1397 cm⁻¹ | Substrate / matriksi | Mabadiliko ya background yanayohusiana na AgNP/sitrate au matriksi ya mkojo. |
Matokeo makuu ya utafiti:
- DLLME-SERS ilizalisha data ya spektra inayoweza kutumika kwa uainishaji wa kiwango cha athari wa dawa nne za kisaikolojia katika mkojo bandia katika masafa ya 5–5000 ng/mL.
- Kadiri mkusanyiko ulivyoongezeka, intensiti za peaks za tabia ziliongezeka huku nafasi za peaks zikibaki thabiti.
- Mwingiliano wa peak kati ya etomidate na tramadol hydrochloride karibu na 1000 cm⁻¹ ulifanya utengano wa kuona kuwa mgumu.
- Vipengele vikuu 10 vya kwanza vya PCA vilichaguliwa kama nafasi ya vipengele ya kutosha kwa uainishaji.
- Faharasa ya mwingiliano wa makosa wa Jaccard ilitathmini kwa kiasi ukamilishanaji wa makosa wa wanachama wa ensemble.
- Kigezo cha “Select-the-best, pair-the-best” kilitabiri kwa usahihi mchanganyiko minne bora kati ya mchanganyiko 15 wa jozi.
- LR+XGBoost na LR+LightGBM zilifikia %99.03 Accuracy na Macro-F1 kwenye seti huru ya majaribio.
- LR+XGBoost ilichaguliwa kama modeli wakilishi kwa uchambuzi wa ufasirikaji wa kemikali kwa sababu ya uwiano wake kati ya utendaji wa jumla na ustahimilivu.
- Namba za mawimbi zinazotofautisha modeli zilionyesha ulinganifu ndani ya 5 cm⁻¹ na peaks za SERS za tabia ya dawa nne.
Vikwazo vya utafiti:
- Utafiti ni preprint ambayo haijapitia tathmini ya wenzao.
- Sampuli ni mkojo bandia, si mkojo halisi wa kliniki/uchunguzi.
- Dutu lengwa nne pekee ndizo zilitathminiwa.
- Kigezo cha uteuzi kinachotegemea Jaccard kilijaribiwa kwa waainishaji sita; tafiti zaidi zinahitajika kwa hazina kubwa zaidi za modeli.
- Katika sampuli halisi, metaboliti, mchanganyiko, miundo tofauti ya mkojo na uwepo wa dutu nyingi vinaweza kubadilisha utendaji wa mbinu.
- Ingawa utafiti unatoa rejea ya kimetodolojia kwa uchunguzi wa haraka, haudai uthibitishaji wa moja kwa moja na wa mwisho wa kliniki/uchunguzi.
Dokezo la Chanzo na Mbinu
Makala hii imeandaliwa kwa kutegemea utafiti ulioandaliwa na Ruzhen Xiang, Shijie Zheng, Nan Yin, Haixia Zhao, Liwei Hou, Qinhong Wang na Li Chen wenye kichwa “Interpretable Ensemble Learning Combined with DLLME-SERS for High-Accuracy Classification and Identification of Four Trace Psychoactive Drugs in Urine”.
Kama inavyoelezwa wazi katika maandishi, utafiti huu ni makala ya utafiti ya preprint na haujapitia tathmini ya wenzao. Kwa hiyo matokeo hayapaswi kusomwa kama mbinu ya mwisho ya kliniki/uchunguzi iliyochapishwa katika jarida lililopitiwa na wenzao na kuthibitishwa kwa uhuru, bali kama pendekezo la utafiti na mchango wa majaribio-kimetodolojia unaohitaji uthibitishaji zaidi.
Utafiti ulifanywa katika mazingira ya maabara kwa sampuli za mkojo bandia. Mbinu iliyotumika inajumuisha kuongeza mkusanyiko wa sampuli kwa DLLME, kipimo cha SERS kinachosaidiwa na AgNP, uchakataji wa awali wa spektra, uchimbaji wa vipengele unaotegemea PCA, mafunzo ya waainishaji sita wa msingi, uteuzi wa wanachama wa ensemble kulingana na mwingiliano wa makosa wa Jaccard, weighted soft voting, tathmini ya seti huru ya majaribio, jaribio la ustahimilivu wa kelele na uchambuzi wa ufasirikaji wa kemikali kwa permutation importance-PCA loading back-projection.
Katika maudhui haya hakuna madai ya mafanikio ya kliniki, uhalali wa uchunguzi, matumizi ya uhakika kwenye uwanja, utendaji uliothibitishwa katika sampuli halisi za wagonjwa au idhini ya udhibiti ambayo hayapo kwenye PDF. Thamani kama %99.03 Accuracy, 0.9999 AUC, usahihi wa zaidi ya %98.06 katika kelele ya wastani na ulinganifu wa peak ndani ya 5 cm⁻¹ zimewasilishwa tu katika muktadha wa seti ya data ya mkojo bandia na hali za majaribio zilizotumika katika utafiti.
Mchango muhimu zaidi wa kisayansi wa utafiti ni kujaribu kuunganisha usahihi wa juu na ufasirikaji wa kemikali katika eneo la SERS-ML. Matumizi ya ukamilishanaji wa makosa katika uteuzi wa modeli na kurudisha maamuzi ya modeli kwenye nafasi ya awali ya namba za mawimbi za Raman yanalenga kuunga mkono matokeo si kwa utendaji wa takwimu pekee, bali pia kwa alama ya kidole ya kemikali.
Siku zijazo, mbinu inapaswa kujaribiwa kwa sampuli halisi za mkojo wa kliniki/uchunguzi, paneli pana zaidi za dutu, hali za mchanganyiko, vifaa tofauti na katika maabara huru. Kabla ya uthibitishaji huu, utafiti unapaswa kutathminiwa si kama chombo cha mwisho cha utambuzi au uamuzi wa kisheria, bali kama hatua yenye nguvu ya kimetodolojia kwa uchunguzi wa haraka na utafiti wa AI ya spektroskopi inayoweza kufasiriwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *