

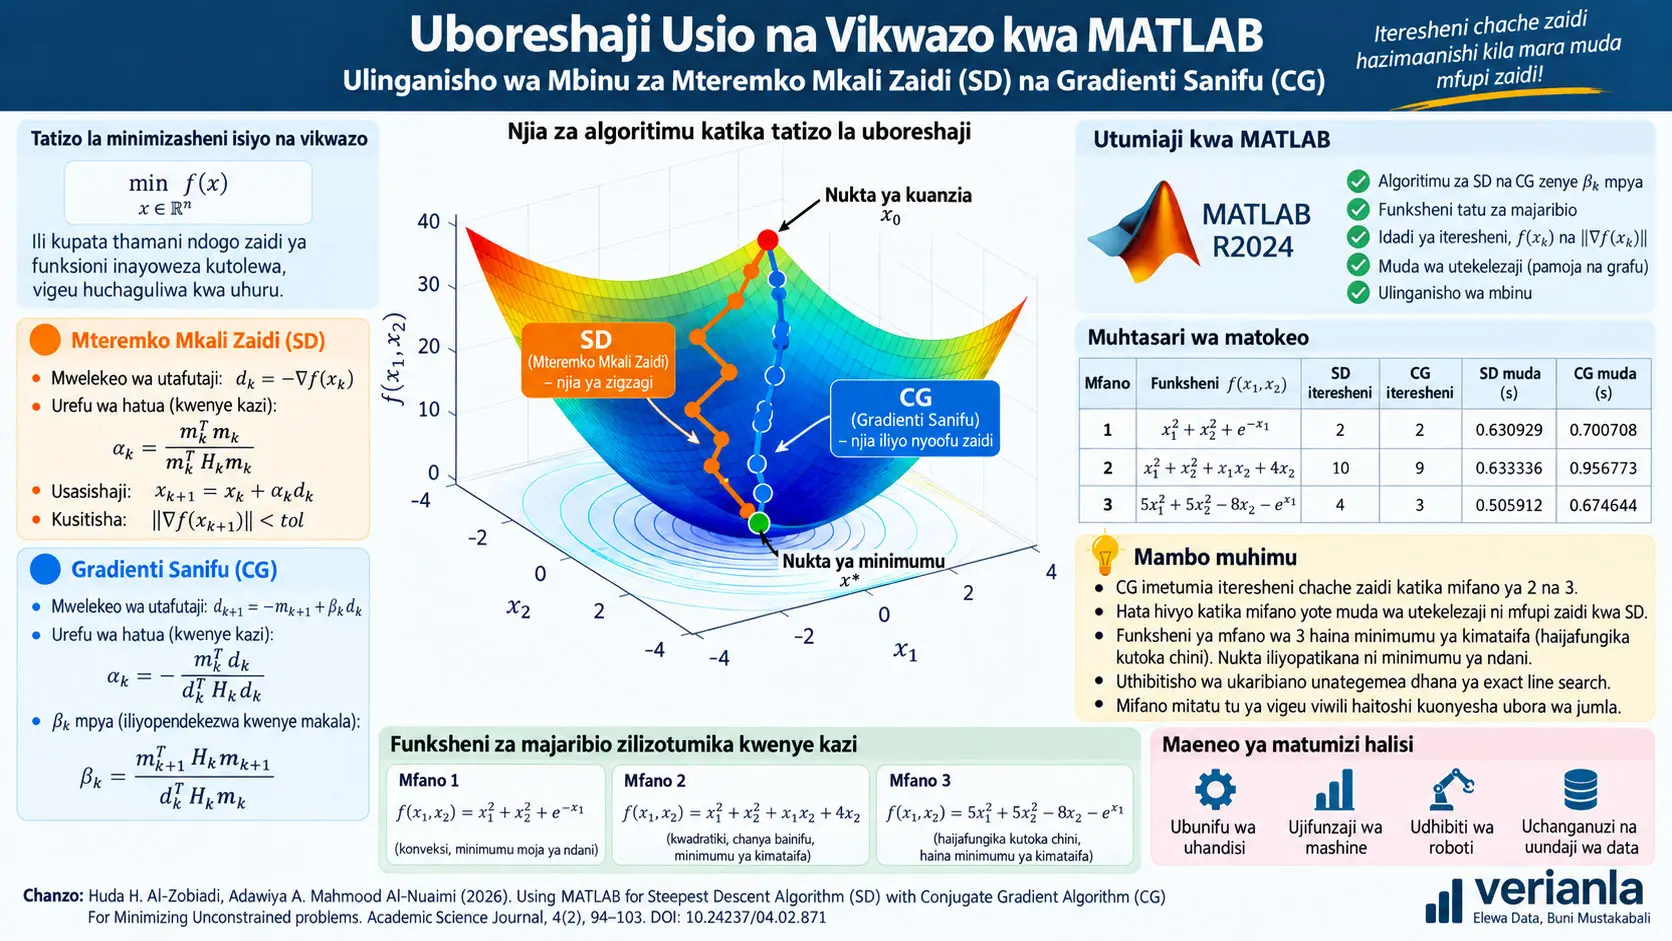
Kupata thamani ndogo zaidi inayowezekana ya funkseni ni msingi wa matatizo mengi ya ukokotoaji, kuanzia usanifu wa kihandisi na ujifunzaji wa mashine hadi robotiki na uchanganuzi wa data. Ikiwa hakuna vikwazo vya ziada vya usawa au ukosefu wa usawa juu ya vigeu, tatizo hilo kwa kawaida huitwa uboreshaji usio na vikwazo. Katika tatizo kama hilo, kazi ya algoriti ni kufuata mwelekeo wa mwinuko wa funkseni lengo ili kupata vekta ya vigeu inayofikia thamani ndogo zaidi za funkseni.
Kazi ya Huda H. Al-Zobiadi na Adawiya A. Mahmood Al-Nuaimi inalinganisha, katika mazingira ya MATLAB, mbinu mbili za kawaida zinazotumiwa kwa lengo hili: Steepest Descent (SD; Mshuko Mkali Zaidi) na Conjugate Gradient (CG; Gradiyenti Ambatani). Watafiti pia wanapendekeza usemi uliorekebishwa kwa mgawo \(\beta_k\), ambao huamua mwelekeo mpya wa utafutaji katika mbinu ya CG.
Katika uendeshaji wa MATLAB kwenye funkseni tatu za majaribio zenye vigeu viwili, katika mfano wa kwanza algoriti zote mbili zilisitisha kwa idadi ileile ya iteresheni; katika mfano wa pili SD ilitumia iteresheni 10 na CG yenye \(\beta_k\) mpya ilitumia 9; katika mfano wa tatu SD ilitumia 4 na CG ilitumia 3. Hata hivyo, katika nyakati zote za utekelezaji zilizoripotiwa katika makala, ikijumuisha utengenezaji wa grafu, SD ilichukua muda mfupi zaidi.
Matokeo haya yanaonyesha kuwa CG ilifikia uvumilivu uliotolewa kwa iteresheni chache zaidi katika mifano miwili iliyochunguzwa; lakini kwa kuwa yalitumika matatizo matatu madogo tu ya majaribio, ubora wa mbinu hiyo katika matatizo makubwa, yenye vipimo vingi au ya jumla ya uboreshaji usio wa kimstari bado haujaonyeshwa. Aidha, funkseni ya tatu ya majaribio iliyotumiwa katika chanzo haina mpaka wa chini wa kimataifa. Kwa hiyo nukta iliyopatikana katika mfano huo si ya kimataifa, bali ni minimum ya ndani katika eneo la mvuto wa nukta ya mwanzo.
Tatizo la minimization isiyo na vikwazo ni nini?
Umbo la msingi la tatizo la uboreshaji ni
\[ \min_x f(x) \]
Hapa \(x\) huonyesha vekta inayojumuisha vigeu vitakavyoboreshwa; \(f(x)\) nayo huonyesha funkseni lengo linalotakiwa kupunguzwa.
Chanzo huandika tatizo kama
\[ \operatorname{Minimize} f(x), \qquad x\in\Omega \]
Maandishi pia hutumia hali ya \(f\) kuwa endelevu na \(\Omega\) kuwa kompakt wakati yanajadili kuwepo kwa suluhisho. Kiufundi, usemi huu ni umbo linalohusisha tatizo la jumla “lisilo na vikwazo” na seti iliyo pana kidogo; katika tatizo la kawaida lililo huru kabisa mara nyingi huchukuliwa
\[ \Omega=\mathbb{R}^n \]
na \(\mathbb{R}^n\) si kompakt. Kwa hiyo matokeo ya kuwepo yaliyotolewa kupitia ukompakti hayawezi kutumika moja kwa moja kwa matatizo yote ya uboreshaji usio na vikwazo.
Tofauti Kati ya Minimum ya Ndani na Minimum ya Kimataifa ni Nini?
Minimum ya ndani huwakilisha thamani ndogo zaidi ya funkseni katika ujirani fulani pekee, ilhali minimum ya kimataifa ina thamani ndogo au sawa na wagombea wote katika eneo lote la ufafanuzi; kufika kwa algoriti ya gradiyenti katika nukta tulivu hakumaanishi moja kwa moja kuwa nukta hiyo ni minimum ya kimataifa.
Kwa nukta \(x^\ast\), ikiwa katika eneo la karibu
\[ f(x)\geq f(x^\ast) \]
basi \(x^\ast\) ni minimum ya ndani.
Ikiwa katika eneo lote la ufafanuzi
\[ f(x)\geq f(x^\ast) \qquad \forall x \]
basi huzungumziwa minimum ya kimataifa.
Tofauti hii ni muhimu hasa katika uboreshaji usio wa kimstari. Algoriti inaweza kupunguza norma ya gradiyenti na kufika katika nukta tulivu; lakini kulingana na jiometri ya funkseni lengo, nukta hiyo inaweza kuwa minimum ya ndani, maximum au nukta ya tandiko.
Kwa nini gradiyenti inaonyesha mwelekeo wa kushuka?
Chanzo huonyesha vekta ya gradiyenti kwa \(m\):
\[ m_k=\nabla f(x_k). \]
Gradiyenti hutoa mwelekeo ambao funkseni huongezeka kwa kasi zaidi katika nukta tuliyopo. Kwa hiyo
\[ -\nabla f(x_k) \]
ni mwelekeo wa ndani ambao, kwa hatua ndogo za kutosha, funkseni hupungua kwa kasi zaidi.
Taarifa za viambajengo vya pili hukusanywa ndani ya matriki ya Hessian:
\[ H(x)= \begin{bmatrix} \frac{\partial^2f}{\partial x_1^2} & \frac{\partial^2f}{\partial x_1\partial x_2}\\ \frac{\partial^2f}{\partial x_2\partial x_1} & \frac{\partial^2f}{\partial x_2^2} \end{bmatrix}. \]
Hessian hubeba si tu taarifa ya mwinuko ulivyo, bali pia jinsi uso unavyojikunja katika mwelekeo husika.
Algoriti ya Steepest Descent Inafanyaje Kazi?
Steepest Descent huchagua kinyume cha gradiyenti ya sasa kama mwelekeo wa utafutaji katika kila iteresheni; katika utafiti, urefu wa hatua huhesabiwa kwa kutumia gradiyenti na Hessian, kisha iteresheni husitishwa wakati norma ya gradiyenti katika nukta mpya inashuka chini ya uvumilivu.
Sasisho la SD lililotumiwa katika chanzo
Baada ya nukta ya mwanzo \(x_0\), gradiyenti
\[ m_0=\nabla f(x_0) \]
na uvumilivu wa ukaribu kuamuliwa, chanzo hufafanua urefu wa hatua kuwa
\[ \alpha_k= \frac{m_k^Tm_k} {m_k^TH_km_k} \]
kama ifuatavyo.
Nukta mpya
\[ x_{k+1}=x_k-\alpha_km_k \]
na gradiyenti mpya
\[ m_{k+1}=\nabla f(x_{k+1}) \]
huhesabiwa.
Sharti la kusitisha
\[ \|m_{k+1}\|<\text{tol} \]
limechaguliwa.
Sharti hili lina maana muhimu: nukta inayotolewa katika matokeo ya MATLAB kama “minimum point” si lazima iwe minimum kamili kwa maana ya kihisabati. Ni nukta tu ambayo norma ya gradiyenti imeshuka chini ya kiwango cha uvumilivu kilichowekwa na waandishi.
Kwa nini Mshuko Mkali Zaidi unaweza kufanya zigzag?
Katika bonde jembamba na refu la uboreshaji, gradiyenti hasi inaweza kuwa na mwelekeo wa kwenda kutoka upande mmoja wa bonde kwenda mwingine badala ya kuelekea moja kwa moja kwenye minimum. Hivyo algoriti hubadilisha mwelekeo mara kwa mara inapokaribia minimum.
Tabia hii ni mojawapo ya sababu kuu za SD kupungua kasi katika matatizo yenye masharti mabaya, hasa pale Hessian inapokuwa na mikunjo tofauti sana katika mielekeo tofauti.
Mbinu ya Conjugate Gradient Inatofautianaje na SD?
Conjugate Gradient haitumii tu gradiyenti hasi ya sasa; pia hubeba taarifa kutoka mwelekeo uliopita wa utafutaji. Kwa njia hiyo inalenga kupunguza hali ya mielekeo mfululizo kukata bonde lilelile la uboreshaji mara kwa mara na hasa kusonga kwa ufanisi zaidi kuelekea minimum katika matatizo ya kikwadrati.
Algoriti ya CG iliyotumiwa katika chanzo
Mwelekeo wa kwanza
\[ d_0=-m_0 \]
huchaguliwa kuwa.
Urefu wa hatua unaotumiwa na chanzo ni
\[ \alpha_k= - \frac{m_k^Td_k} {d_k^TH_kd_k} \]
katika umbo hili.
Vekta mpya ya kigeu
\[ x_{k+1}=x_k+\alpha_kd_k \]
na gradiyenti
\[ m_{k+1}=\nabla f(x_{k+1}) \]
huhesabiwa.
Sasisho la jumla la mwelekeo wa utafutaji ni
\[ d_{k+1} = -m_{k+1}+\beta_kd_k \]
katika umbo hili.
Kigezo kipya cha beta kilichopendekezwa katika makala
Mabadiliko makuu ya utafiti ni kwamba mgawo unaotumiwa katika sasisho la mwelekeo wa CG hufafanuliwa kuwa
\[ \beta_k= \frac{ m_{k+1}^{T}H_km_{k+1} }{ d_k^{T}H_km_k } \]
hivyo.
Sehemu hii hubadilisha mwelekeo mpya wa gradiyenti hasi, pamoja na mwelekeo wa awali wa utafutaji, kuwa mwelekeo unaofuata \(d_{k+1}\).
Chanzo kinadai kuwa \(\beta_k\) mpya huongeza ufanisi wa mbinu ya CG. Lakini dai hili limejaribiwa katika makala kwa funkseni tatu tu za majaribio zenye vigeu viwili.
Kwa nini dai la ukaribu wa kimataifa linapaswa kusomwa kwa uangalifu?
Katika utafiti, kwa CG mpya, sharti la kushuka la umbo
\[ m_k^Td_k \leq -c\|m_k\|^2, \qquad c>0 \]
linajadiliwa.
Katika hatua muhimu ya uthibitisho, hutumika kwamba kutokana na exact line search
\[ m_{k+1}^Td_k=0 \]
na kutokana na hilo
\[ m_{k+1}^Td_{k+1} = -\|m_{k+1}\|^2 \]
hupatikana.
Hata hivyo, katika funkseni za jumla zisizo za kimstari, usemi
\[ \alpha_k= - \frac{m_k^Td_k}{d_k^TH_kd_k} \]
unaohesabiwa kupitia Hessian hauwi sawa kila wakati na exact line search halisi. Katika funkseni za kikwadrati muundo huu hulingana kwa namna ya asili sana na utafutaji sahihi wa mstari; katika funkseni lengo za jumla zisizo za kimstari, mawazo ya ziada yanahitajika.
Kwa hiyo hoja ya ukaribu iliyotolewa katika chanzo haipaswi kufasiriwa kama dhamana ya jumla ya ukaribu wa kimataifa iliyo huru na sharti lililotajwa la exact-line-search.
Mbinu na Matokeo ya Utafiti
Mpangilio wa majaribio ya MATLAB
Waandishi waliendesha algoriti za SD na CG yenye kigezo kipya \(\beta_k\) katika mazingira ya MATLAB 2024 juu ya funkseni tatu zenye vigeu viwili.
Katika ulinganisho, kimsingi kiasi tatu viliripotiwa:
- idadi ya iteresheni zinazohitajika kwa ukaribu,
- thamani za \(x_k\) na \(f(x_k)\) zilizofikiwa,
- muda wa utekelezaji, ikijumuisha uzalishaji wa grafu.
| Mfano | Funkseni | Uvumilivu | Iteresheni za SD | Iteresheni za CG | Muda wa SD | Muda wa CG |
|---|---|---|---|---|---|---|
| 1 | \(x_1^2+x_2^2+e^{-x_1}\) | 0,1 | 2 | 2 | 0,630929 s | 0,700708 s |
| 2 | \(x_1^2+x_2^2+x_1x_2+4x_2\) | 0,01 | 10 | 9 | 0,633336 s | 0,956773 s |
| 3 | \(5x_1^2+5x_2^2-8x_2-e^{x_1}\) | 0,01 | 4 | 3 | 0,505912 s | 0,674644 s |
Mfano 1: Funkseni konveksi yenye sehemu ya eksponensheli
Funkseni ya kwanza
\[ f(x_1,x_2) = x_1^2+x_2^2+e^{-x_1} \]
na nukta ya mwanzo
\[ x_0=(0,0)^T \]
zimechaguliwa.
Kwa kuwa uvumilivu ni
\[ \text{tol}=0.1 \]
algoriti zote mbili zilisitisha baada ya sasisho la kwanza takriban
\[ x=(0.333333,0)^T \]
katika nukta hiyo.
Chanzo huripoti katika nukta hii
\[ f(x)\approx0.827642 \]
na
\[ \|\nabla f(x)\| \approx0.049865 \]
inaripotiwa.
Hata hivyo, hapa athari ya uvumilivu iko wazi sana. Sharti la minimum halisi ni
\[ 2x_1-e^{-x_1}=0, \qquad x_2=0 \]
kwa hiyo
\[ x_1e^{x_1}=\frac12 \]
na hivyo
\[ x_1=W(1/2) \approx0.351734 \]
hupatikana.
Thamani halisi ya minimum ni takriban
\[ f_{\min}\approx0.827184 \]
huwa hivyo.
Hulinganisho hili halionyeshi kuwa matokeo ya chanzo si sahihi, bali linaonyesha kuwa kwa sababu ya uvumilivu uliolegea kiasi kama \(0.1\), algoriti imechukuliwa kuwa imetimiza kigezo cha mafanikio kabla ya kufika katika nukta tulivu halisi.
Mfano 2: Uso wa kikwadrati ulio chanya bayana
Funkseni lengo la pili ni
\[ f(x_1,x_2) = x_1^2+x_2^2+x_1x_2+4x_2 \]
Katika umbo hili.
Kwa kuwa gradiyenti ni
\[ \nabla f= \begin{bmatrix} 2x_1+x_2\\ x_1+2x_2+4 \end{bmatrix} \]
nukta tulivu kamili hupatikana kutoka mfumo wa milinganyo
\[ 2x_1+x_2=0 \]
na
\[ x_1+2x_2+4=0 \]
ifuatayo:
\[ x^\ast= \left( \frac43, -\frac83 \right). \]
Hessian
\[ H= \begin{bmatrix} 2&1\\ 1&2 \end{bmatrix} \]
ni chanya bayana. Kwa hiyo nukta hii ni minimum ya kimataifa ya pekee na
\[ f(x^\ast) = -\frac{16}{3} \approx-5.333333 \]
hupatikana.
SD, chini ya uvumilivu \(0.01\), ilifikia katika iteresheni 10
\[ x_9 \approx (1.328125,-2.66406) \]
na
\[ f(x_9)\approx-5.333313 \]
matokeo yake.
CG yenye \(\beta_k\) mpya nayo ilitoa katika iteresheni 9
\[ x_8 \approx (1.3298,-2.6651) \]
na
\[ f(x_8)\approx-5.333324 \]
matokeo hayo.
Katika mfano huu CG kwa kweli imetumia iteresheni moja pungufu kuliko SD na, chini ya uvumilivu uleule, imetoa thamani ya funkseni iliyo karibu kidogo zaidi na minimum kamili.
Hata hivyo muda uliopimwa unaelekea upande wa kinyume:
\[ t_{\mathrm{SD}} = 0.633336\ \mathrm{s} \]
na
\[ t_{\mathrm{CG}} = 0.956773\ \mathrm{s}. \]
Kwa hiyo katika jaribio hili dogo la MATLAB, “iteresheni chache zaidi” haikumaanisha moja kwa moja “muda mfupi zaidi wa utekelezaji”.
Mfano 3: Mpaka muhimu wa kihisabati
Funkseni lengo la tatu
\[ f(x_1,x_2) = 5x_1^2+5x_2^2-8x_2-e^{x_1} \]
limefafanuliwa kuwa.
Chanzo kinaripoti kuwa kwa SD imefika takriban kwenye
\[ (0.111686,0.8) \]
katika iteresheni nne; kwa CG mpya imefika takriban kwenye
\[ (0.1118,0.7997) \]
katika iteresheni tatu.
Katika hali zote mbili
\[ f(x) \approx-4.255793 \]
imepatikana.
Hata hivyo, tunapotazama tabia ya kimataifa ya funkseni, sehemu
\[ 5x_1^2-e^{x_1} \]
wakati \(x_1\rightarrow+\infty\) huenda kwa
\[ -\infty \]
Kwa hiyo
\[ \inf f=-\infty \]
na funkseni hii haina minimum ya kimataifa juu ya \(\mathbb{R}^2\) yote.
Masharti ya gradiyenti
\[ 10x_1-e^{x_1}=0 \]
na
\[ 10x_2-8=0 \]
hutoa.
Suluhisho tulivu lililo karibu na nukta ya mwanzo \(x_0=(0,0)^T\) ni takriban
\[ x_1\approx0.111833, \qquad x_2=0.8 \]
na Hessian ni chanya bayana katika eneo hili. Kwa hiyo nukta iliyofikiwa na MATLAB ni minimum ya ndani ya kweli.
Tofauti hii ni muhimu: algoriti zinaweza kuwa zimekaribia minimum ya ndani kwa mafanikio katika maeneo yao ya mwanzo; lakini jaribio hili halipaswi kuwasilishwa kama mafanikio ya minimization ya kimataifa.
Matokeo ni nini kwa upande wa idadi ya iteresheni?
| Mfano | SD | CG Mpya | Ulinganisho |
|---|---|---|---|
| 1 | 2 iteresheni | 2 iteresheni | Sawa |
| 2 | 10 iteresheni | 9 iteresheni | CG iteresheni moja pungufu |
| 3 | 4 iteresheni | 3 iteresheni | CG iteresheni moja pungufu |
Kwa hiyo matokeo ya chanzo yanayosema “CG huhitaji iteresheni chache zaidi” ni sahihi katika mifano miwili kati ya iliyochunguzwa; katika mfano wa kwanza mbinu hizo mbili ni sawa.
Matokeo ni nini kwa upande wa muda wa kazi?
Katika chanzo, muda unapolinganishwa pamoja na grafu, SD inaonekana kuwa fupi zaidi katika mifano yote mitatu:
| Mfano | Muda wa SD | Muda wa CG | Fupi zaidi |
|---|---|---|---|
| 1 | 0.630929 s | 0.700708 s | SD |
| 2 | 0.633336 s | 0.956773 s | SD |
| 3 | 0.505912 s | 0.674644 s | SD |
Hata hivyo, makala haitoi idadi ya marudio ya vipimo hivyo vya muda, sifa za kichakataji, athari ya JIT warm-up, sehemu ya muda inayotokana na plotting au tofauti ya vipimo vya wakati. Vipimo hivi vya pekee katika kiwango cha milisekunde–sekunde havipaswi kutumiwa kama benchmark thabiti kuhusu utata wa jumla wa ukokotoaji wa mbinu hizo.
Je, beta mpya ni yenye ufanisi zaidi kweli?
Majaribio ya chanzo yanaonyesha kuwa sasisho la CG lililopendekezwa limefikia uvumilivu uliotolewa katika majaribio ya pili na ya tatu iteresheni moja kabla ya SD. Hili ni matokeo chanya ya awali kwa mbinu hiyo.
Lakini ili kudai ufanisi wa jumla kwa nguvu zaidi, angalau yanahitajika matatizo ya majaribio yenye vipimo vingi, condition number tofauti, funkseni za nonconvex benchmark, nukta tofauti za kuanzia, uvumilivu tofauti na ulinganisho wa moja kwa moja na masasisho yaliyokita mizizi ya nonlinear-CG kama Fletcher–Reeves, Polak–Ribière–Polyak au Hager–Zhang.
Ulinganisho huu haukufanywa katika kazi ya chanzo.
Matokeo yanayoungwa mkono na utafiti
- Algoriti za SD na CG yenye kigezo kipya \(\beta_k\) zimetekelezwa kwa MATLAB.
- Katika mifano yote mitatu ya chanzo, algoriti zilisonga kutoka nukta ya mwanzo iliyochaguliwa kuelekea eneo tulivu.
- Katika Mfano 1, SD na CG zilitumia idadi sawa ya iteresheni.
- Katika Mifano 2 na 3, CG mpya ilitumia iteresheni moja pungufu kuliko SD na kutimiza sharti la uvumilivu.
- Katika majaribio yote matatu ya chanzo, runtime iliyoripotiwa pamoja na grafu ni fupi zaidi kwa SD.
- Katika Mfano 2, algoriti zote mbili zilitoa matokeo yaliyo karibu sana na minimum ya kimataifa inayojulikana.
- Katika Mfano 3, algoriti zote mbili zilikaribia eneo la minimum ya ndani lililo karibu na nukta ya mwanzo.
Matokeo ambayo utafiti hauyathibitishi
- Haijaonyeshwa kuwa CG yenye \(\beta_k\) mpya ni bora kuliko SD katika matatizo yote ya nonlinear unconstrained optimization.
- Haijaonyeshwa kuwa iteresheni chache zaidi hutoa muda mfupi zaidi wa kazi; matokeo ya chanzo yanaonyesha kinyume chake.
- Mifano mitatu tu yenye vigeu viwili si ushahidi wa scalability ya vipimo vya juu.
- Data za runtime si benchmark ya takwimu iliyorudiwa.
- Katika Mfano 3 minimum ya kimataifa haijapatikana; funkseni haina mpaka wa chini.
- Hoja ya global convergence iliyotolewa bila dhana ya exact line search haiwezi kujumlishwa moja kwa moja kwa funkseni zote za lengo za nonlinear.
- Chanzo hakilinganishi \(\beta_k\) mpya na fomula kuu za kisasa za nonlinear-CG ndani ya benchmark ya kimfumo.
Dokezo la Chanzo na Mbinu
Kichwa kamili asili:Using MATLAB for Steepest Descent Algorithm (SD) with Conjugate Gradient Algorithm (CG) For Minimizing Unconstrained problems.
Waandishi: Huda H. Al-Zobiadi na Adawiya A. Mahmood Al-Nuaimi.
Taasisi: Department of Mathematics, College of Science, University of Diyala, Diyala, Iraq.
Jarida: Academic Science Journal (ASJ).
Juzuu / namba / kurasa: Vol. 4, No. 2, 94–103.
DOI: 10.24237/04.02.871.
Uwasilishaji / marekebisho / kukubaliwa / kuchapishwa: 29 Desemba 2025 / 7 Januari 2026 / 11 Machi 2026 / 30 Aprili 2026.
Uhakiki rika: Academic Science Journal linaripoti kutumia uhakiki rika wa upofu-mbili.
Leseni: CC BY 4.0.
Mbinu: Utekelezaji wa algoriti za Steepest Descent na Conjugate Gradient yenye kigezo kilichorekebishwa \(\beta_k\) kwenye funkseni tatu za lengo za nonlinear zenye vipimo viwili kwa MATLAB 2024, na kulinganisha idadi ya iteresheni, thamani ya minimum ya takriban na muda wa utekelezaji.
Ufadhili: Chanzo kinatoa tamko la “No funding”.
Mgongano wa maslahi: Waandishi wanasema hakuna mgongano wa maslahi.
Maadili: Kwa kuwa utafiti uko katika eneo la hisabati ya kinadharia, imeelezwa kuwa idhini ya kamati ya maadili haikuwa lazima.
Dokezo la uthibitishaji wa kihisabati: Nukta iliyotolewa katika chanzo kwa Mfano 1 ya \(x=(0.333333,0)\) ni nukta ya kusitisha mapema inayotokana na \(tol=0.1\); minimum tulivu kamili ya funkseni ni takriban \(x=(0.351734,0)\). Minimum kamili ya kimataifa ya Mfano 2 ni \((4/3,-8/3)\) na \(f=-16/3\). Mfano 3, kwa \(x_1\rightarrow+\infty\), una \(f\rightarrow-\infty\), hivyo hauna minimum ya kimataifa; nukta ya takriban \((0.1118,0.8)\) iliyopatikana katika chanzo ni minimum ya ndani.
Dokezo la ukaribu: Uthibitisho wa CG descent katika chanzo hutumia uorthogonali wa exact-line-search. Kwa kuwa haijathibitishwa kando kwamba fomula ya hatua inayotegemea Hessian katika utekelezaji huwa exact line search kila wakati katika funkseni za jumla za nonlinear, dai la global convergence linapaswa kusomwa kwa kuzingatia dhana hii.
Verianla Live: Inafaa sana. Kwa kuwa funkseni tatu za lengo zimetolewa moja kwa moja katika umbo la kihisabati, njia za SD na CG zinaweza kukokotolewa upya. Live Figure yenye nguvu zaidi ni kuonyesha, juu ya uso uleule wa vipimo vitatu, njia ya SD ya rangi ya chungwa na njia ya CG ya rangi ya buluu pamoja na thamani za \(x_k\), \(\|\nabla f(x_k)\|\), \(\alpha_k\), \(\beta_k\) na \(f(x_k)\) katika kila hatua. Katika Mfano 3, eneo la kamera likipanuliwa, inaweza pia kuonyeshwa kuwa uso huwa hauna mpaka wa chini katika mwelekeo wa \(x_1\), hivyo tofauti ya “minimum ya ndani ≠ minimum ya kimataifa” inaweza kuelezwa kwa namna ya kufundisha.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *