

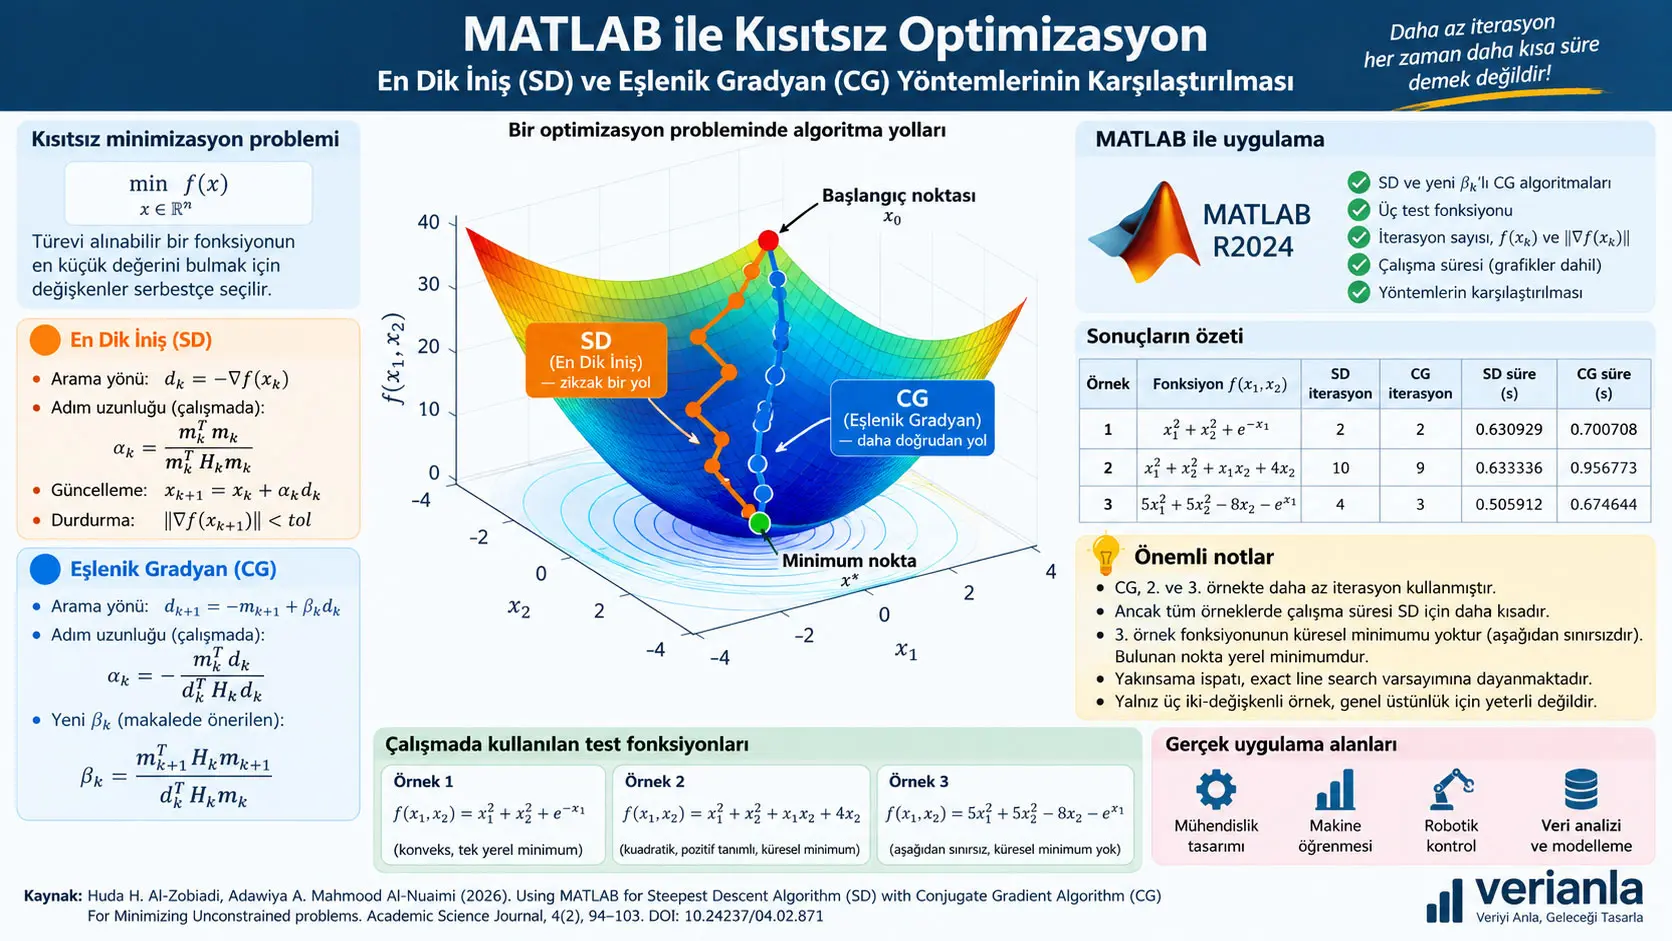
Bir fonksiyonun mümkün olan en küçük değerini bulmak; mühendislik tasarımından makine öğrenmesine, robotikten veri analizine kadar çok sayıda hesaplama probleminin temelidir. Eğer değişkenler üzerinde eşitlik veya eşitsizlik biçiminde ek kısıtlar bulunmuyorsa problem genellikle kısıtsız optimizasyon olarak adlandırılır. Böyle bir problemde algoritmanın görevi, amaç fonksiyonunun eğimini izleyerek daha düşük fonksiyon değerlerine ulaşan bir değişken vektörü bulmaktır.
Huda H. Al-Zobiadi ve Adawiya A. Mahmood Al-Nuaimi'nin çalışması, bu amaçla kullanılan iki klasik yaklaşımı MATLAB ortamında karşılaştırmaktadır: Steepest Descent (SD; En Dik İniş) ve Conjugate Gradient (CG; Eşlenik Gradyan). Araştırmacılar ayrıca CG yönteminin yeni arama yönünü belirleyen \(\beta_k\) katsayısı için değiştirilmiş bir ifade öneriyor.
Üç iki-değişkenli test fonksiyonunda yapılan MATLAB çalıştırmalarında, ilk örnekte iki algoritma da aynı iterasyon sayısında dururken ikinci örnekte SD 10, yeni \(\beta_k\)'lı CG 9 iterasyon; üçüncü örnekte ise SD 4, CG 3 iterasyon kullanmıştır. Buna karşılık makalede grafik oluşturma dahil raporlanan çalışma sürelerinin tamamında SD daha kısa sürmüştür.
Bu sonuçlar CG'nin incelenen iki örnekte daha az iterasyonla verilen toleransa ulaştığını gösterir; ancak yalnız üç küçük test problemi kullanıldığı için yöntemin büyük ölçekli, yüksek boyutlu veya genel doğrusal olmayan optimizasyon problemlerinde üstünlüğü henüz gösterilmiş değildir. Ayrıca kaynakta kullanılan üçüncü test fonksiyonu küresel olarak aşağıdan sınırsızdır. Dolayısıyla o örnekte bulunan nokta küresel değil, başlangıç noktasının çekim bölgesindeki bir yerel minimumdur.
Kısıtsız minimizasyon problemi nedir?
Bir optimizasyon probleminin temel biçimi
\[ \min_x f(x) \]
şeklindedir. Burada \(x\), optimize edilecek değişkenleri içeren vektörü; \(f(x)\) ise küçültülmek istenen amaç fonksiyonunu gösterir.
Kaynak problemi
\[ \operatorname{Minimize} f(x), \qquad x\in\Omega \]
şeklinde yazmaktadır. Metin ayrıca çözümün varlığını tartışırken \(f\)'nin sürekli ve \(\Omega\)'nın kompakt olması durumunu kullanır. Teknik olarak bu ifade genel “kısıtsız” problemin biraz daha geniş bir kümeye bağlı biçimidir; klasik tamamen kısıtsız problemde çoğu kez
\[ \Omega=\mathbb{R}^n \]
alınır ve \(\mathbb{R}^n\) kompakt değildir. Bu nedenle kompaktlık üzerinden verilen varlık sonucu, bütün kısıtsız optimizasyon problemlerine otomatik olarak uygulanamaz.
Yerel Minimum ile Küresel Minimum Arasındaki Fark Nedir?
Yerel minimum yalnız belirli bir komşulukta en küçük fonksiyon değerini temsil ederken küresel minimum bütün tanım kümesindeki tüm adaylardan daha küçük veya eşit değere sahiptir; bir gradyan algoritmasının bir durağan noktaya ulaşması, o noktanın otomatik olarak küresel minimum olduğu anlamına gelmez.
Bir \(x^\ast\) noktası için yakın çevrede
\[ f(x)\geq f(x^\ast) \]
oluyorsa \(x^\ast\) yerel minimumdur.
Bütün tanım bölgesinde
\[ f(x)\geq f(x^\ast) \qquad \forall x \]
oluyorsa küresel minimumdan söz edilir.
Bu ayrım özellikle doğrusal olmayan optimizasyonda önemlidir. Bir algoritma gradyan normunu küçültüp bir durağan noktaya ulaşabilir; fakat amaç fonksiyonunun geometrisine bağlı olarak bu nokta yerel minimum, maksimum veya eyer noktası olabilir.
Gradyan neden iniş yönünü gösteriyor?
Kaynak gradyan vektörünü \(m\) ile göstermektedir:
\[ m_k=\nabla f(x_k). \]
Gradyan, fonksiyonun bulunduğumuz noktada en hızlı arttığı yönü verir. Bu nedenle
\[ -\nabla f(x_k) \]
yönü, yeterince küçük adımlar için fonksiyonun en hızlı azaldığı yerel yöndür.
İkinci türev bilgileri ise Hessian matrisi içinde toplanır:
\[ H(x)= \begin{bmatrix} \frac{\partial^2f}{\partial x_1^2} & \frac{\partial^2f}{\partial x_1\partial x_2}\\ \frac{\partial^2f}{\partial x_2\partial x_1} & \frac{\partial^2f}{\partial x_2^2} \end{bmatrix}. \]
Hessian yalnız eğimin ne olduğunu değil, yüzeyin ilgili yönde ne kadar kıvrıldığını da taşır.
Steepest Descent Algoritması Nasıl Çalışıyor?
Steepest Descent her iterasyonda mevcut gradyanın tersini arama yönü olarak seçer; çalışmada adım uzunluğu gradyan ve Hessian kullanılarak hesaplanır, ardından yeni noktada gradyan normu toleransın altına düşünce iterasyon durdurulur.
Kaynakta kullanılan SD güncellemesi
Başlangıç noktası \(x_0\), gradyan
\[ m_0=\nabla f(x_0) \]
ve yakınsama toleransı belirlendikten sonra kaynak adım uzunluğunu
\[ \alpha_k= \frac{m_k^Tm_k} {m_k^TH_km_k} \]
olarak tanımlar.
Yeni nokta
\[ x_{k+1}=x_k-\alpha_km_k \]
ve yeni gradyan
\[ m_{k+1}=\nabla f(x_{k+1}) \]
şeklinde hesaplanır.
Durdurma koşulu
\[ \|m_{k+1}\|<\text{tol} \]
olarak seçilmiştir.
Bu koşulun önemli bir anlamı vardır: MATLAB çıktısında “minimum point” şeklinde verilen nokta, matematiksel olarak tam minimum olmak zorunda değildir. Yalnızca gradyan normunun yazarların belirlediği tolerans seviyesinin altına indiği noktadır.
En Dik İniş neden zikzak yapabilir?
Dar ve uzamış bir optimizasyon vadisinde negatif gradyan, minimuma doğrudan bakmak yerine vadinin bir yanından diğerine yönelme eğilimi gösterebilir. Böylece algoritma minimuma yaklaşırken sürekli yön değiştirir.
Bu davranış özellikle Hessian'ın farklı yönlerde çok farklı eğriliklere sahip olduğu kötü koşullu problemlerde SD'nin yavaşlamasının temel nedenlerinden biridir.
Conjugate Gradient Yöntemi SD'den Nasıl Farklıdır?
Conjugate Gradient yalnız mevcut negatif gradyanı kullanmak yerine önceki arama yönünden de bilgi taşır; böylece ardışık yönlerin aynı optimizasyon vadisini tekrar tekrar kesmesini azaltmayı ve özellikle kuadratik problemlerde minimuma daha verimli ilerlemeyi amaçlar.
Kaynakta kullanılan CG algoritması
İlk yön
\[ d_0=-m_0 \]
olarak seçilir.
Kaynağın kullandığı adım uzunluğu
\[ \alpha_k= - \frac{m_k^Td_k} {d_k^TH_kd_k} \]
şeklindedir.
Yeni değişken vektörü
\[ x_{k+1}=x_k+\alpha_kd_k \]
ve gradyan
\[ m_{k+1}=\nabla f(x_{k+1}) \]
ile hesaplanır.
Arama yönünün genel güncellemesi ise
\[ d_{k+1} = -m_{k+1}+\beta_kd_k \]
biçimindedir.
Makalede önerilen yeni beta parametresi
Çalışmanın temel değişikliği, CG yön güncellemesinde kullanılan katsayının
\[ \beta_k= \frac{ m_{k+1}^{T}H_km_{k+1} }{ d_k^{T}H_km_k } \]
olarak tanımlanmasıdır.
Bu terim yeni negatif gradyan yönünü, önceki arama yönüyle birlikte bir sonraki \(d_{k+1}\) yönüne dönüştürür.
Kaynak, yeni \(\beta_k\)'nın CG yönteminin verimliliğini artırdığını öne sürmektedir. Fakat bu iddia makalede yalnız üç iki-değişkenli test fonksiyonuyla sınanmıştır.
Global yakınsama iddiası neden dikkatli okunmalı?
Çalışmada yeni CG için
\[ m_k^Td_k \leq -c\|m_k\|^2, \qquad c>0 \]
biçimindeki descent koşulu tartışılır.
İspatın önemli adımında exact line search sonucunda
\[ m_{k+1}^Td_k=0 \]
olduğu kullanılır ve bunun sonucunda
\[ m_{k+1}^Td_{k+1} = -\|m_{k+1}\|^2 \]
elde edilir.
Ancak genel doğrusal olmayan fonksiyonlarda Hessian üzerinden hesaplanan
\[ \alpha_k= - \frac{m_k^Td_k}{d_k^TH_kd_k} \]
ifadesi her durumda gerçek bir exact line search ile aynı değildir. Kuadratik fonksiyonlarda bu yapı tam doğrusal aramayla çok doğal biçimde örtüşür; genel doğrusal olmayan amaç fonksiyonlarında ise ek varsayımlar gerekir.
Bu nedenle kaynakta verilen yakınsama argümanı, belirtilen exact-line-search koşulundan bağımsız genel bir küresel yakınsama garantisi olarak yorumlanmamalıdır.
Çalışmanın Yöntemi ve Bulguları
MATLAB deney düzeni
Yazarlar SD ve yeni \(\beta_k\) parametreli CG algoritmasını MATLAB 2024 ortamında üç iki-değişkenli fonksiyon üzerinde çalıştırmıştır.
Karşılaştırmada temel olarak üç nicelik raporlanmıştır:
- yakınsama için gereken iterasyon sayısı,
- ulaşılan \(x_k\) ve \(f(x_k)\) değerleri,
- grafik üretimi dahil yürütme süresi.
| Örnek | Fonksiyon | Tolerans | SD iterasyon | CG iterasyon | SD süre | CG süre |
|---|---|---|---|---|---|---|
| 1 | \(x_1^2+x_2^2+e^{-x_1}\) | 0,1 | 2 | 2 | 0,630929 s | 0,700708 s |
| 2 | \(x_1^2+x_2^2+x_1x_2+4x_2\) | 0,01 | 10 | 9 | 0,633336 s | 0,956773 s |
| 3 | \(5x_1^2+5x_2^2-8x_2-e^{x_1}\) | 0,01 | 4 | 3 | 0,505912 s | 0,674644 s |
Örnek 1: Üstel terimli konveks fonksiyon
İlk fonksiyon
\[ f(x_1,x_2) = x_1^2+x_2^2+e^{-x_1} \]
ve başlangıç noktası
\[ x_0=(0,0)^T \]
olarak seçilmiştir.
Tolerans
\[ \text{tol}=0.1 \]
olduğu için her iki algoritma da ilk güncellemeden sonra yaklaşık
\[ x=(0.333333,0)^T \]
noktasında durmuştur.
Kaynak bu noktada
\[ f(x)\approx0.827642 \]
ve
\[ \|\nabla f(x)\| \approx0.049865 \]
raporlamaktadır.
Ancak burada toleransın etkisi çok nettir. Gerçek minimum koşulu
\[ 2x_1-e^{-x_1}=0, \qquad x_2=0 \]
olduğundan
\[ x_1e^{x_1}=\frac12 \]
ve dolayısıyla
\[ x_1=W(1/2) \approx0.351734 \]
elde edilir.
Gerçek minimum değeri yaklaşık
\[ f_{\min}\approx0.827184 \]
olur.
Bu karşılaştırma kaynak sonuçlarının yanlış olduğunu değil, \(0.1\) gibi görece gevşek bir tolerans nedeniyle algoritmanın gerçek durağan noktaya ulaşmadan başarı kriterini sağlamış kabul edildiğini gösterir.
Örnek 2: Pozitif tanımlı kuadratik yüzey
İkinci amaç fonksiyonu
\[ f(x_1,x_2) = x_1^2+x_2^2+x_1x_2+4x_2 \]
şeklindedir.
Gradyan
\[ \nabla f= \begin{bmatrix} 2x_1+x_2\\ x_1+2x_2+4 \end{bmatrix} \]
olduğu için tam durağan nokta
\[ 2x_1+x_2=0 \]
ve
\[ x_1+2x_2+4=0 \]
denklem sisteminden bulunur:
\[ x^\ast= \left( \frac43, -\frac83 \right). \]
Hessian
\[ H= \begin{bmatrix} 2&1\\ 1&2 \end{bmatrix} \]
pozitif tanımlıdır. Dolayısıyla bu nokta benzersiz küresel minimumdur ve
\[ f(x^\ast) = -\frac{16}{3} \approx-5.333333 \]
elde edilir.
SD, tolerans \(0.01\) altında 10 iterasyonda
\[ x_9 \approx (1.328125,-2.66406) \]
ve
\[ f(x_9)\approx-5.333313 \]
sonucuna ulaşmıştır.
Yeni \(\beta_k\)'lı CG ise 9 iterasyonda
\[ x_8 \approx (1.3298,-2.6651) \]
ve
\[ f(x_8)\approx-5.333324 \]
sonucunu vermiştir.
Bu örnekte CG gerçekten SD'den bir iterasyon daha az kullanmış ve aynı tolerans altında tam minimuma biraz daha yakın bir fonksiyon değeri üretmiştir.
Bununla birlikte ölçülen süreler ters yöndedir:
\[ t_{\mathrm{SD}} = 0.633336\ \mathrm{s} \]
ve
\[ t_{\mathrm{CG}} = 0.956773\ \mathrm{s}. \]
Dolayısıyla bu küçük MATLAB deneyinde “daha az iterasyon” doğrudan “daha kısa çalışma süresi” anlamına gelmemiştir.
Örnek 3: Kritik matematiksel sınır
Üçüncü amaç fonksiyonu
\[ f(x_1,x_2) = 5x_1^2+5x_2^2-8x_2-e^{x_1} \]
olarak tanımlanmıştır.
Kaynak, SD ile yaklaşık
\[ (0.111686,0.8) \]
noktasına dört iterasyonda; yeni CG ile yaklaşık
\[ (0.1118,0.7997) \]
noktasına üç iterasyonda ulaşıldığını bildirmektedir.
Her iki durumda da
\[ f(x) \approx-4.255793 \]
elde edilmiştir.
Ancak fonksiyonun küresel davranışına bakıldığında
\[ 5x_1^2-e^{x_1} \]
teriminin \(x_1\rightarrow+\infty\) için
\[ -\infty \]
değerine gittiği görülür. Dolayısıyla
\[ \inf f=-\infty \]
ve bu fonksiyonun tüm \(\mathbb{R}^2\) üzerinde bir küresel minimumu yoktur.
Gradyan koşulları
\[ 10x_1-e^{x_1}=0 \]
ve
\[ 10x_2-8=0 \]
verir.
Başlangıç noktası \(x_0=(0,0)^T\)'ye yakın durağan çözüm yaklaşık
\[ x_1\approx0.111833, \qquad x_2=0.8 \]
olup Hessian bu bölgede pozitif tanımlıdır. Dolayısıyla MATLAB'ın ulaştığı nokta gerçek bir yerel minimumdur.
Bu ayrım önemlidir: algoritmalar kendi başlangıç bölgelerinde başarılı biçimde yerel minimuma yaklaşmış olabilir; fakat bu deney küresel minimizasyon başarısı olarak sunulmamalıdır.
İterasyon sayısı açısından sonuç ne?
| Örnek | SD | Yeni CG | Karşılaştırma |
|---|---|---|---|
| 1 | 2 iterasyon | 2 iterasyon | Eşit |
| 2 | 10 iterasyon | 9 iterasyon | CG bir iterasyon daha az |
| 3 | 4 iterasyon | 3 iterasyon | CG bir iterasyon daha az |
Dolayısıyla kaynakta söylenen “CG daha az iterasyon gerektirir” sonucu incelenen örneklerin ikisinde geçerlidir; birinci örnekte iki yöntem eşittir.
Çalışma süresi açısından sonuç ne?
Kaynakta grafikler dahil süreler karşılaştırıldığında üç örnekte de SD daha kısa görünmektedir:
| Örnek | SD zamanı | CG zamanı | Daha kısa |
|---|---|---|---|
| 1 | 0.630929 s | 0.700708 s | SD |
| 2 | 0.633336 s | 0.956773 s | SD |
| 3 | 0.505912 s | 0.674644 s | SD |
Bununla birlikte makale sürelerin kaç kez tekrarlandığını, işlemcinin özelliklerini, JIT warm-up etkisini, plotting süresinin payını veya zaman ölçümlerinin varyansını vermemektedir. Milisaniye–saniye ölçeğindeki bu tekil ölçümler yöntemlerin genel hesaplama karmaşıklığı konusunda güçlü benchmark olarak kullanılmamalıdır.
Yeni beta gerçekten daha verimli mi?
Kaynağın deneyleri, önerilen CG güncellemesinin ikinci ve üçüncü testte verilen toleransa SD'den bir iterasyon önce ulaştığını göstermektedir. Bu, yöntem için olumlu bir ön sonuçtur.
Fakat genel verimlilik iddiasının güçlü biçimde sınanması için en azından yüksek boyutlu test problemleri, farklı condition number'lar, nonconvex benchmark fonksiyonları, farklı başlangıç noktaları, değişik toleranslar ve Fletcher–Reeves, Polak–Ribière–Polyak veya Hager–Zhang gibi yerleşik nonlinear-CG güncellemeleriyle doğrudan karşılaştırmalar gerekir.
Bu karşılaştırmalar kaynak çalışmada yapılmamıştır.
Çalışmanın desteklediği sonuçlar
- SD ve yeni \(\beta_k\) parametreli CG algoritmaları MATLAB ile uygulanmıştır.
- Her üç kaynak örneğinde algoritmalar seçilen başlangıç noktasından bir durağan bölgeye ilerlemiştir.
- Örnek 1'de SD ile CG aynı sayıda iterasyon kullanmıştır.
- Örnek 2 ve 3'te yeni CG, SD'den bir iterasyon daha az kullanarak tolerans koşulunu sağlamıştır.
- Üç kaynak deneyinde de grafikler dahil raporlanan runtime SD için daha kısadır.
- Örnek 2'de her iki algoritma bilinen küresel minimuma oldukça yakın sonuç üretmiştir.
- Örnek 3'te her iki algoritma başlangıç noktasına yakın yerel minimum bölgesine yaklaşmıştır.
Çalışmanın kanıtlamadığı sonuçlar
- Yeni \(\beta_k\)'lı CG'nin bütün nonlinear unconstrained optimization problemlerinde SD'den üstün olduğu gösterilmemiştir.
- Daha az iterasyonun daha kısa çalışma süresi sağlayacağı gösterilmemiştir; kaynak sonuçları bunun tersini göstermektedir.
- Yalnız üç iki-değişkenli örnek yüksek boyutlu ölçeklenebilirlik kanıtı değildir.
- Runtime verileri tekrarlı istatistiksel benchmark değildir.
- Örnek 3'te küresel minimum bulunmuş değildir; fonksiyon aşağıdan sınırsızdır.
- Exact line search varsayımı olmadan verilen global convergence argümanı bütün nonlinear amaç fonksiyonlarına doğrudan genellenemez.
- Kaynak, yeni \(\beta_k\)'yı başlıca modern nonlinear-CG formülleriyle sistematik benchmark içinde karşılaştırmamaktadır.
Kaynak ve Yöntem Notu
Tam özgün başlık:Using MATLAB for Steepest Descent Algorithm (SD) with Conjugate Gradient Algorithm (CG) For Minimizing Unconstrained problems.
Yazarlar: Huda H. Al-Zobiadi ve Adawiya A. Mahmood Al-Nuaimi.
Kurum: Department of Mathematics, College of Science, University of Diyala, Diyala, Iraq.
Dergi: Academic Science Journal (ASJ).
Cilt / sayı / sayfalar: Vol. 4, No. 2, 94–103.
DOI: 10.24237/04.02.871.
Gönderim / revizyon / kabul / yayın: 29 Aralık 2025 / 7 Ocak 2026 / 11 Mart 2026 / 30 Nisan 2026.
Hakemlik: Academic Science Journal çift-kör hakemlik uyguladığını bildirmektedir.
Lisans: CC BY 4.0.
Yöntem: Steepest Descent ve değiştirilmiş \(\beta_k\) parametreli Conjugate Gradient algoritmalarının üç iki-boyutlu nonlinear amaç fonksiyonunda MATLAB 2024 ile uygulanması ve iterasyon sayısı, yaklaşık minimum değeri ve yürütme süresinin karşılaştırılması.
Finansman: Kaynak “No funding” beyanı vermektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını belirtmektedir.
Etik: Çalışma teorik matematik alanında olduğundan etik kurul onayının gerekli olmadığı belirtilmiştir.
Matematiksel doğrulama notu: Kaynakta Örnek 1 için verilen \(x=(0.333333,0)\) noktası, \(tol=0.1\) nedeniyle oluşan erken durma noktasıdır; fonksiyonun tam durağan minimumu yaklaşık \(x=(0.351734,0)\)'dır. Örnek 2'nin tam küresel minimumu \((4/3,-8/3)\) ve \(f=-16/3\)'tür. Örnek 3 ise \(x_1\rightarrow+\infty\) için \(f\rightarrow-\infty\) olduğundan küresel minimuma sahip değildir; kaynakta bulunan yaklaşık \((0.1118,0.8)\) noktası yerel minimumdur.
Yakınsama notu: Kaynaktaki CG descent ispatı exact-line-search ortogonalliğini kullanmaktadır. Uygulamadaki Hessian tabanlı adım formülünün genel nonlinear fonksiyonlarda her zaman exact line search olduğu ayrıca kanıtlanmadığı için global convergence iddiası bu varsayım dikkate alınarak okunmalıdır.
Verianla Live: Çok uygundur. Üç amaç fonksiyonu doğrudan matematiksel biçimde verildiği için SD ve CG rotaları yeniden hesaplanabilir. En güçlü Live Figure; aynı üç-boyutlu yüzey üzerinde turuncu SD ve mavi CG yollarını, her adımda \(x_k\), \(\|\nabla f(x_k)\|\), \(\alpha_k\), \(\beta_k\) ve \(f(x_k)\) değerleriyle birlikte göstermektir. Örnek 3'te ayrıca kamera alanı genişletildiğinde yüzeyin \(x_1\) yönünde aşağıdan sınırsız hale geldiği gösterilerek “yerel minimum ≠ küresel minimum” farkı öğretici biçimde anlatılabilir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir