

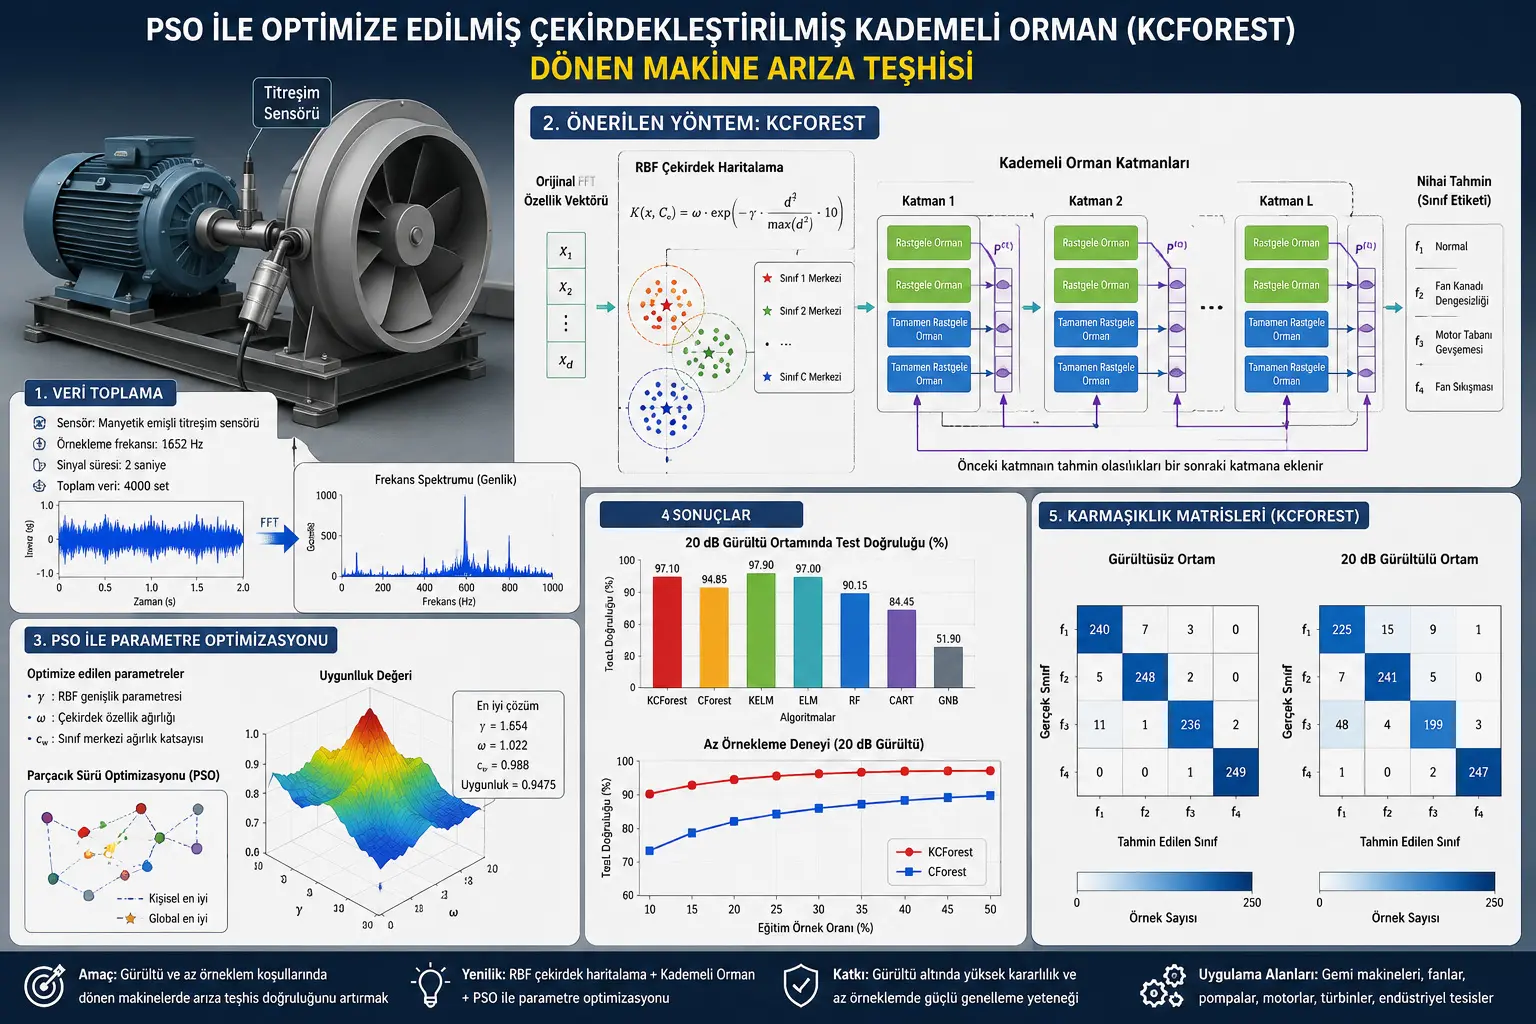
Utafiti huu unashughulikia kwa nini utambuzi wa hitilafu katika mashine zinazozunguka huwa mgumu zaidi hasa katika mazingira yenye kelele na wakati idadi ya mifano ya mafunzo ni ndogo. Mbinu inayopendekezwa katika utafiti ni modeli ya msitu wa kaskadi wenye kernel ya RBF, yaani Kernelized Cascade Forest (KCForest), iliyorekebishwa kwa uboreshaji wa kundi la chembe, yaani Particle Swarm Optimization (PSO). Lengo ni kutumia sifa za masafa zilizotolewa kutoka ishara za mtikisiko ili kutofautisha hali kama uendeshaji wa kawaida, kutokuwa na usawa kwa blade ya feni, kulegea kwa msingi wa mota na kukwama kwa feni katika mashine zinazozunguka kama feni ya meli.
Data zilizotumiwa katika utafiti zinatokana na ishara za mtikisiko zilizochukuliwa kutoka mpangilio wa majaribio wa feni ya meli inayoendeshwa na mota ya asinkroni ya awamu tatu. Kwanza ishara zilihamishwa kwenda eneo la masafa kwa Transformu ya Haraka ya Fourier, yaani Fast Fourier Transform (FFT), kisha utendaji wa vichambuzi tofauti ulilinganishwa kwenye vekta zilezile za sifa. Mbinu iliyopendekezwa ya KCForest ilipata usahihi wa %98,05 katika mazingira ya majaribio yasiyo na kelele; chini ya kelele nyeupe ya Gaussian yenye uwiano wa ishara kwa kelele wa 20 dB, usahihi wa majaribio uliripotiwa kuwa %97,10. Hii ina maana ya kushuka kwa pointi 0,95 tu ikilinganishwa na hali isiyo na kelele.
Jambo muhimu katika utafiti si kuripoti tu usahihi mkubwa. Utafiti unajaribu kuonyesha jinsi miundo ya jadi ya random forest na cascade forest inaweza kuharibika chini ya kelele, na jinsi ramani ya kernel pamoja na parameta zilizorekebishwa kwa PSO zinaweza kupunguza uharibifu huo. Hata hivyo, matokeo haya yanategemea utafiti wa preprint ambao haujapitia mapitio ya wenzao na mpangilio maalumu wa majaribio wa feni ya meli. Kwa hiyo, ingawa mbinu inaonekana yenye matumaini, haipaswi kusomwa kama dhamana ya mafanikio ya uhakika katika kila aina ya mashine inayozunguka.
Tatizo la msingi la utafiti ni nini?
Mashine zinazozunguka ziko katikati ya vifaa vingi vinavyotumika katika feni, pampu, mota, turbini, jenereta, mifumo saidizi ya meli na mistari ya uzalishaji wa viwanda. Hata hitilafu ndogo katika mashine hizi inaweza kukua kwa muda na kusababisha upotevu wa nishati, kusimama kwa uzalishaji, hatari ya usalama au michakato ya matengenezo yenye gharama kubwa. Kwa hiyo kutambua hitilafu mapema si suala la kiufundi pekee, bali pia ni jambo muhimu kwa usalama wa uendeshaji na gharama za matengenezo.
Tatizo ambalo utafiti huu unalenga ni hili: ishara za mtikisiko zinazochukuliwa kutoka mashine zinazozunguka hubeba taarifa muhimu sana kuhusu hitilafu; lakini ishara hizi si kila wakati safi, za kawaida na rahisi kutenganisha. Katika mazingira halisi ya kazi, data za mtikisiko huwa tata kwa sababu ya kelele, makosa ya sensa, athari za mazingira, mzigo unaobadilika, kulegea kwa kimekanika na alama zinazofanana za aina tofauti za hitilafu. Katika hali hii, ikiwa modeli ya kujifunza kwa mashine ni muundo unaokariri tu data, inaweza kujifunza alama ya kelele badala ya muundo halisi wa hitilafu.
Utafiti unasisitiza hasa changamoto mbili:
- Utenganishaji thabiti wa hitilafu chini ya kelele: Vipengele vya usumbufu vya nje vinapoongezwa kwenye ishara ya mtikisiko, mafanikio ya uainishaji wa modeli yanaweza kushuka haraka.
- Kujifunza kwa mifano michache: Katika viwanda, si kila wakati inawezekana kukusanya seti kubwa sana za data kwa kila aina ya hitilafu. Baadhi ya hitilafu hutokea mara chache, na baadhi ni ghali au hatari kuundwa kwa majaribio.
Matatizo haya mawili yakikutana, utambuzi wa hitilafu unakuwa mgumu. Kwa mfano, kutokuwa na usawa kwa blade ya feni na kulegea kwa msingi wa mota vinaweza kuunda vipengele fulani vya masafa vinavyofanana katika ishara ya mtikisiko. Kelele inapoongezwa juu yake, inakuwa vigumu zaidi kwa modeli kutofautisha hali hizi mbili. Mbinu ya KCForest iliyopendekezwa na utafiti inalenga hasa kutenganisha mipaka hii iliyochanganyika vizuri zaidi.
Kwa nini tatizo hili ni muhimu?
Katika mtazamo wa jadi wa matengenezo, mashine hukaguliwa kwa vipindi vilivyopangwa au huingiliwa baada ya hitilafu kuonekana wazi. Lakini katika viwanda vya kisasa, lengo ni kutoa onyo la mapema bila kusubiri hitilafu ikue. Mtazamo huu kwa ujumla hutathminiwa chini ya vichwa vya ufuatiliaji wa hali (condition monitoring) na matengenezo ya kutabiri (predictive maintenance).
Uchambuzi wa mtikisiko hutumiwa sana katika eneo hili, kwa sababu kutokuwa na usawa, kulegea, msuguano, kukwama au athari ya resonance katika sehemu inayozunguka mara nyingi huonekana kwenye ishara ya mtikisiko. Kama sikio la binadamu linavyoweza wakati mwingine kugundua “sauti isiyo ya kawaida” katika mota, vihisi vya mtikisiko pia vinaweza kunasa mabadiliko katika tabia ya kimekanika ya mashine kwa njia ya nambari. Lakini ili kile ambacho sikio la binadamu hukisikia kwa hisia kibadilike kuwa uamuzi wa kuaminika katika mifumo ya kihandisi, ishara hii lazima igawanywe katika sifa sahihi na kutafsiriwa kwa classifier imara.
Umuhimu wa utafiti huu unaonekana hapa: utafiti unapendekeza muundo wa classifier unaostahimili zaidi kelele na hali za data chache katika mpangilio wa mashine inayozunguka wa vitendo kama feni ya meli. Kwa matumizi ya baharini, feni, mota na vifaa saidizi vinavyozunguka ni muhimu kwa usalama wa meli na mwendelezo wa mfumo. Hata hivyo, matokeo ya utafiti hayapaswi kuchukuliwa kama ushahidi wa shambani unaotumika moja kwa moja kwa mashine zote za meli, bali kama uthibitishaji wa majaribio uliopatikana kwenye mpangilio maalumu wa majaribio.
Pengo ambalo utafiti unajibu katika fasihi au matumizi
Pengo la fasihi linaloelezwa katika utafiti ni kwamba classifiers za jadi na baadhi ya mbinu za ensemble learning hubaki na mipaka katika hali zenye kelele na sampuli ndogo. Random forest (Random Forest, RF) inaweza kutoa matokeo thabiti zaidi kuliko mti mmoja wa uamuzi kwa kuunganisha miti mingi ya uamuzi. Hata hivyo, RF huenda isiweze kila wakati kuwakilisha kwa kutosha muundo wa kina na wa matabaka uliomo katika ishara tata za mtikisiko.
Cascade forest (Cascade Forest, CForest) hujaribu kujifunza uwakilishi wa kina zaidi kwa kutumia tabaka nyingi za misitu moja baada ya nyingine. Uwezekano wa madarasa unaozalishwa na tabaka moja hupelekwa kama taarifa ya ziada kwa tabaka linalofuata. Kwa mtazamo wa kwanza, hili ni wazo lenye nguvu; kwa sababu modeli haitumii sifa ghafi tu, bali pia taarifa ya tabaka lililotangulia kwamba “mfano huu unaweza kuwa karibu na darasa gani?” Lakini tatizo linalosisitizwa na utafiti ni hili: ikiwa tabaka la kwanza linazalisha mgawanyo wa uwezekano usio sahihi kwa sababu ya kelele, kosa hili linaweza kuhamishwa na kukuzwa kwenye tabaka zinazofuata. Yaani muundo wa kaskadi wakati mwingine unaweza kuimarisha kosa la kelele badala ya kuimarisha taarifa sahihi.
Mbinu inayopendekezwa ya KCForest inajaribu kujaza pengo hili kwa zana mbili:
- Ramani ya kernel ya RBF: Inalenga kuonyesha upya sifa za mtikisiko katika nafasi isiyo ya mstari ya kufanana ili madarasa yanayochanganyika yaweze kutenganishwa vizuri zaidi.
- Uboreshaji wa parameta kwa PSO: Badala ya kuchagua kwa majaribio parameta nyeti za kazi ya kernel, huzitafuta kwa uboreshaji wa kundi la chembe.
Kwa upande huu, utafiti hauishii kusema “tulijaribu classifier mpya”; unapendekeza usanifu unaolenga kupunguza matatizo ya uhamishaji wa kosa na udhaifu wa sampuli ndogo katika muundo wa CForest.
Mantiki ya msingi ya random forest na fomula ya Gini
Utafiti kwanza unaeleza msingi wa algoriti ya random forest. Random forest huunganisha miti mingi ya uamuzi. Kila mti hufunzwa kwa sampuli tofauti ya data ya mafunzo na vikundi vidogo tofauti vya sifa. Hivyo hatari ya kujifunza kupita kiasi ya mti mmoja inapunguzwa. Wakati wa uainishaji, maamuzi ya miti hutathminiwa pamoja.
Mojawapo ya vigezo vya kugawanya nodi katika miti ya uamuzi ni indeksi ya Gini. Fomula iliyotolewa katika utafiti ni hii:
\[ Gini(M)=1-\sum_{k=1}^{K}p_k^2 \]
Hapa M ni seti ya mifano katika nodi husika; K ni idadi ya madarasa; p_k ni uwiano wa mifano ya darasa la k ndani ya seti M. Kadiri thamani ya Gini inavyopungua, nodi huchukuliwa kuwa “safi” zaidi. Yaani ikiwa mifano mingi katika nodi hiyo ni ya darasa moja, thamani ya Gini hushuka.
Kwa mfano wa kila siku, tunaweza kufikiria sanduku lenye mipira myekundu pekee kama sanduku lenye mpangilio na usafi mkubwa. Sanduku lenye mipira myekundu, ya buluu, ya kijani na ya njano iliyochanganyika lina ukungu zaidi. Indeksi ya Gini husaidia mti wa uamuzi kuchagua migawanyo itakayopunguza ukungu huu. Katika utambuzi wa hitilafu za mashine zinazozunguka, “mipira” hii ni madarasa kama hali ya kawaida, kutokuwa na usawa wa feni, kulegea kwa mota na kukwama kwa feni.
Kwa nini kaskadi forest peke yake inaweza isitose?
Katika muundo wa Cascade Forest, kila tabaka hutumia uwezekano wa madarasa unaotoka kwenye tabaka lililotangulia kama sifa mpya. Vekta ya sifa za mwanzo imefafanuliwa katika utafiti hivi:
\[ x^{(0)} \in \mathbb{R}^{d} \]
Hapa x^{(0)} ni vekta ya sifa za mwanzo iliyopatikana baada ya uchakataji wa awali na FFT; d ni kipimo cha sifa hizi za eneo la masafa. Kwa maneno mengine, ishara ghafi ya mtikisiko inayobadilika kwa muda huchukuliwa, hugawanywa katika vipengele vya masafa na kubadilishwa kuwa vekta ya nambari ambayo modeli inaweza kuelewa.
Ingizo katika tabaka za kaskadi hutolewa katika utafiti hivi:
\[ x^{(l)}=[x^{(0)},p^{(l-1)}] \]
Hapa x^{(l)} ni ingizo la tabaka la l; x^{(0)} ni sifa za kimwili za awali; p^{(l-1)} ni vekta za uwezekano wa madarasa zilizozalishwa na tabaka lililotangulia. Muundo huu huongeza tafsiri ya tabaka lililotangulia kwenye modeli bila kupoteza taarifa ya asili ya mtikisiko.
Mantiki hii ina nguvu, lakini ni hatari katika mazingira yenye kelele. Kwa sababu ikiwa tabaka lililotangulia linazalisha uwezekano usio sahihi, tabaka linalofuata hutumia kosa hilo pia kama “sifa”. Hili ndilo eneo ambalo utafiti unakosoa: ikiwa muundo wa kaskadi hauna utaratibu wa kutosha wa kuchuja kelele, unaweza kubeba makosa kati ya tabaka.
Wazo kuu la KCForest: kufanya madarasa yatenganishike zaidi kwa ramani ya kernel
Modeli inayopendekezwa ya KCForest inaongeza utaratibu wa ramani ya kernel kwenye muundo wa CForest. Wazo la jumla la ramani ya kernel linaonyeshwa katika utafiti kwa fomula hii:
\[ \phi:\mathbb{R}^{d}\rightarrow H \]
Hapa \(\phi\) ni kazi ya ubadilishaji fiche inayohamisha data kutoka nafasi ya awali ya sifa yenye kipimo d kwenda nafasi ya Hilbert yenye kipimo cha juu zaidi. H inawakilisha nafasi hii mpya ya uwakilishi wa juu. Lengo la ubadilishaji huu ni kufanya madarasa ya hitilafu yanayoonekana kuchanganyika katika nafasi ya asili yatenganishike zaidi katika nafasi mpya.
Tunaweza kulieleza kwa mfano wa kila siku hivi: fikiria aina mbili tofauti za hitilafu zinaonekana zimepishana kwenye grafu ya pande mbili. Ukiziangalia kutoka mbele tu, madarasa yanaonekana yamechanganyika. Lakini ukiangalia data ileile kutoka pembe tofauti, ndani ya uwakilishi wa kipimo cha juu zaidi, muundo unaoruhusu kutenganisha madarasa unaweza kujitokeza. Mbinu ya kernel hutoa uwezo huu wa “kuangalia kutoka pembe nyingine” kwa njia ya hisabati.
Kernel ya RBF inafanya nini?
Kazi ya kernel iliyotumiwa katika utafiti ni kernel ya RBF, yaani Radial Basis Function. Fomula ya jumla ni hii:
\[ K(x,z)=\exp(-\gamma \|x-z\|^2) \]
Hapa x na z ni vekta mbili za sifa zinazolinganishwa. \(\|x-z\|^2\) inaonyesha umbali wa Euclidean uliopigwa mraba kati ya vekta hizi mbili. \(\gamma\) ni parameta ya upana wa kernel na huamua jinsi kufanana kunavyopungua haraka kadiri umbali unavyoongezeka. \(\exp\) ni kazi ya eksponensheli.
Maana ya vitendo ya fomula hii ni hii: ikiwa mifano miwili ya mtikisiko inafanana sana, thamani ya RBF huwa kubwa; ikiwa iko mbali, thamani hupungua. Hivyo modeli inaweza kuangalia si thamani za masafa moja moja tu, bali pia jinsi mfano unavyofanana na vituo vya madarasa. Chini ya kelele, mtazamo huu ni muhimu kwa sababu kelele ya nasibu inaweza kuunda mabadiliko madogo; lakini muundo wa msingi wa hitilafu unaweza kuwakilishwa kwa uthabiti zaidi ikiwa skeli sahihi imechaguliwa.
Fomula maalumu ya sifa za RBF iliyotumiwa katika utafiti
Katika utafiti, sifa za kernel ya RBF huhesabiwa kupitia umbali wa mifano kutoka vituo vya madarasa. Fomula maalumu iliyotolewa katika utafiti ni hii:
\[ K_{i,c}=\omega \cdot \exp\left(-\gamma \cdot \frac{d^2_{i,c}}{\max(d^2)} \cdot 10\right) \]
Katika fomula hii \(K_{i,c}\) ni thamani ya kufanana ya kernel ya mfano nambari i dhidi ya kituo cha darasa nambari c. \(\omega\) ni uzito wa sifa za kernel; yaani hurekebisha kiwango ambacho sifa hizi mpya za kernel zinachangia kwenye modeli. \(\gamma\) ni parameta ya upana wa RBF. \(d^2_{i,c}\) ni umbali wa Euclidean uliopigwa mraba kati ya vekta ya sifa ya mfano i na vekta ya kituo cha darasa c. Katika utafiti, umbali huu umeelezwa hivi:
\[ d^2_{i,c}=\|X_i-C_c\|^2 \]
Hapa \(X_i\) ni vekta ya sifa ya mfano nambari i; \(C_c\) ni vekta ya kituo cha darasa c. Neno \(\max(d^2)\) hutumiwa kuskeli thamani za umbali. Kizidishi 10 katika fomula ni kipengele cha kuskeli kinachotumiwa ili kutoa uthabiti wa nambari katika hesabu ya kazi ya eksponensheli.
Maana ya fomula hii kwa utambuzi wa hitilafu za mashine ni hii: modeli huhesabu jinsi kila mfano wa mtikisiko unavyofanana na kituo cha kila darasa la hitilafu. Kwa mfano, ikiwa ishara iko karibu zaidi na kituo cha darasa la kutokuwa na usawa wa blade ya feni, thamani hii ya kufanana inaweza kuwa kubwa zaidi. Lakini hii peke yake si uamuzi wa mwisho; KCForest hutathmini sifa hizi za kernel pamoja na sifa za awali za FFT na vekta za uwezekano zinazotoka kwenye tabaka lililotangulia.
Uboreshaji wa sifa ndani ya tabaka na kati ya tabaka
Katika KCForest, katika kila tabaka sifa za awali hupanuliwa kwa sifa za kernel. Ingizo lililopanuliwa limeonyeshwa katika utafiti hivi:
\[ X^{(l)}_{aug}=[X^{(l)},K^{(l)}] \]
Hapa \(X^{(l)}_{aug}\) ni matriki ya sifa zilizopanuliwa katika tabaka la l. \(X^{(l)}\) inawakilisha sifa zilizopo zinazoingia katika tabaka hilo; \(K^{(l)}\) inawakilisha sifa za kernel zinazohesabiwa katika tabaka lilelile.
Katika utafiti imeelezwa kwamba katika kila tabaka hutumiwa random forest mbili na completely random tree forest mbili. Kila moja ya misitu hii tofauti huzalisha mgawanyo wa uwezekano wa madarasa. Tokeo la wastani la uwezekano wa misitu midogo M katika tabaka moja linaonyeshwa kwa fomula hii:
\[ P^{(l)}=\frac{1}{M}\sum_{m=1}^{M}P_m^{(l)} \]
Hapa \(P^{(l)}\) ni tokeo la wastani la uwezekano wa madarasa la tabaka la l; M ni idadi ya misitu midogo; \(P_m^{(l)}\) ni vekta ya uwezekano wa madarasa inayozalishwa na msitu nambari m katika tabaka la l. Operesheni hii ya kuchukua wastani husaidia kupunguza kosa la nasibu la modeli moja.
Zaidi ya hayo, matokeo ya uwezekano ya misitu yote katika tabaka huunganishwa na kuunda matriki ya uwezekano iliyopanuliwa hivi:
\[ P^{(l)}_{layer}=[P_1,P_2,\ldots,P_F] \]
Hapa F inaonyesha idadi ya misitu katika tabaka husika. Kwa muundo huu, modeli hutumia pamoja jinsi misitu tofauti inavyoitazama ishara ileile ya mtikisiko. Yaani uamuzi hauachiwi hukumu ya mti mmoja au msitu mmoja tu.
Kwa nini utaratibu wa kusimamisha mapema ni muhimu?
Katika modeli za kaskadi, kuongeza idadi ya tabaka kila wakati hakumaanishi matokeo bora. Ikiwa idadi ya tabaka itaongezwa bila sababu, modeli inaweza kujifunza si muundo halisi wa hitilafu katika data, bali maelezo ya nasibu yaliyo maalumu kwa data ya mafunzo. Hii huongeza hatari ya kujifunza kupita kiasi.
Kwa hiyo katika utafiti, utaratibu wa kusimamisha mapema unaotegemea mafanikio ya uthibitishaji hutumiwa. Sharti la kufikirika la kusimamisha limetolewa hivi:
\[ Acc^{(l)}\leq \max_{k
Hapa \(Acc^{(l)}\) ni usahihi wa uthibitishaji wa tabaka la l; \(\max_{k inawakilisha usahihi bora zaidi wa uthibitishaji uliopatikana kati ya tabaka za awali. Ikiwa tabaka jipya haliwezi kuboresha mafanikio bora ya awali, ukuaji wa kaskadi husimamishwa. Hii hutumiwa kuzuia modeli kuwa ya kina bila ulazima.
PSO inaboresha nini hapa?
Katika utafiti, PSO hutumiwa kuboresha parameta tatu muhimu katika utaratibu wa kernel ya RBF:
- \(\gamma\): Parameta ya upana wa kernel ya RBF. Huamua jinsi kufanana kunavyopungua haraka na umbali.
- \(\omega\): Uzito wa jumla wa sifa za kernel. Hurekebisha kiwango cha mchango wa sifa hizi kwa modeli.
- \(c_w\): Mgawo wa uzito wa kituo cha darasa. Huathiri umbo la mipaka ya uamuzi kwa kuskeli vituo vya madarasa.
Kwa mfano wa kila siku, PSO inaweza kufikiriwa kama kundi dogo la ndege wanaotafuta sehemu bora zaidi juu ya eneo. Kila chembe inawakilisha mchanganyiko unaowezekana wa parameta. Chembe husogea kwa kuzingatia nafasi nzuri waliyowahi kupata wao wenyewe na nafasi bora zaidi iliyopatikana na kundi lote. Hivyo mipangilio inayotoa usahihi bora zaidi hutafutwa ndani ya nafasi ya parameta.
Katika utafiti, utafutaji wa PSO ulifanywa katika mazingira yenye kelele nyeupe ya Gaussian katika kiwango cha 20 dB SNR. Idadi ya chembe imetolewa kama 10. Masafa ya parameta yamefafanuliwa kama [0,5, 8] kwa \(\gamma\), [0,5, 4] kwa \(\omega\), na [0,8, 1,5] kwa \(c_w\). Uzito wa inershia ulipunguzwa kutoka 0,8 hadi 0,4 kupitia iteresheni. Mgawo wa kiakili na mgawo wa kujifunza kijamii vilitumika kama 1,5.
Katika grafu ya uboreshaji wa PSO ya pande tatu, suluhisho bora linaonyeshwa takriban kama \(\gamma=1{,}654\), \(\omega=1{,}022\), \(c_w=0{,}988\) na thamani ya kufaa ya 0,9475. Thamani hizi zinalenga kuonyesha kwamba modeli ilipata skeli ya kernel inayoweza kudumisha utenganishaji wa madarasa katika mazingira yenye kelele.
Mpangilio wa majaribio na aina za hitilafu
Kitu cha majaribio kilichotumiwa katika utafiti ni feni ya meli inayoendeshwa na mota ya asinkroni ya awamu tatu. Thamani za kiufundi za mota ya feni ni hizi: voltage nominoli 380 V, mkondo nominoli 4,6 A, nguvu nominoli 1,1 kW, masafa nominoli 50 Hz na kasi ya kuzunguka nominoli 1400 dev/dak.
Hali nne za kazi zilichunguzwa:
- f1: Hali ya kawaida
- f2: Hitilafu ya kutokuwa na usawa wa blade ya feni
- f3: Hitilafu ya kulegea kwa msingi wa mota
- f4: Hitilafu ya kukwama kwa feni
Data za mtikisiko zilikusanywa kwa sensa yenye kunyonya kwa sumaku. Usikivu wa sensa umetolewa kama 10,20 mV/g, voltage ya bias 12,40 V na masafa ya sampuli 1652 Hz. Kila kundi la ishara lina muda wa sampuli wa 2 sekunde. Kwa kila jaribio zilikusanywa seti 20 za data, kwa kila hali ya feni yalifanywa majaribio 50, na kwa jumla data 4000 za majaribio zilipatikana. Kati ya majaribio, muda wa 5 dakika uliwekwa ili joto la kifaa liwe thabiti na athari za mazingira zidhibitiwe.
Kutoa sifa za masafa kutoka ishara ya mtikisiko kwa FFT
Katika utafiti, vekta ya sifa ya pamoja ilitumiwa kwa classifiers zote. Hatua hii ni muhimu kwa sababu ili algoriti tofauti zilinganishwe, taarifa inayotolewa kwa modeli lazima iwe ileile. Ishara za mtikisiko zilibadilishwa kutoka eneo la muda kwenda eneo la masafa kwa FFT. Vipengele vya masafa hasi viliondolewa, spektra ya amplitude ya FFT ilichaguliwa kama sifa, na normalizesheni ya min-maks ilitumika.
Maana ya FFT hapa ni hii: ishara ya mtikisiko katika eneo la muda inaonyesha jinsi mashine inavyotetemeka kwa muda. Eneo la masafa linaonyesha katika masafa gani mtikisiko huu umejikusanya zaidi. Hili ni la thamani sana katika utambuzi wa hitilafu, kwa sababu hitilafu tofauti zinaweza kuimarisha vipengele tofauti vya masafa au kuhamisha nishati kwenda maeneo tofauti ya masafa.
Tofauti za kimwili zinazoelezwa katika grafu na vielelezo
Katika utafiti, ishara za mtikisiko na grafu za spektra za hali tofauti za mota zinalinganishwa. Katika hali ya kawaida f1, amplitude ya mtikisiko inaonekana thabiti zaidi. Katika kutokuwa na usawa wa blade ya feni na kulegea kwa msingi wa mota, sifa za mapigo ya kipindi huonekana wazi zaidi. Katika hali ya kukwama kwa feni, muundo wa mtikisiko wa masafa ya juu unaoendelea zaidi unaonekana.
Matokeo ya spektra yanafanya tofauti za kimwili kati ya aina za hitilafu kuwa wazi zaidi. Katika hali ya kawaida, inatajwa kwamba kilele kikuu cha masafa kwa f1 kiko karibu 576,50 Hz, nishati ya jumla imejikita zaidi na entropy ya spektra ni ya chini. Hii inaonyesha kwamba mashine inafanya kazi kwa mpangilio na uthabiti zaidi. Katika f2 ya kutokuwa na usawa wa blade ya feni, masafa makuu hushuka hadi 518,00 Hz; nishati ya masafa ya chini na entropy ya spektra huongezeka. Hii inaendana na ongezeko la mitikisiko ya masafa ya chini kutokana na mgawanyo wa misa usio na usawa.
Katika f3 ya kulegea kwa msingi wa mota, masafa makuu yametolewa kama 518,50 Hz na inaelezwa kwamba nishati ya mtikisiko huhamia eneo la masafa ya juu. Hali hii inahusishwa na athari za resonance za masafa ya juu zinazosababishwa na viunganishi vya kimuundo vilivyolegea. Katika f4 ya kukwama kwa feni, masafa makuu ni 568,50 Hz; nishati ya jumla na entropy ya spektra ziko katika kiwango cha kati. Hii inaashiria muundo maalumu wa mtikisiko unaotokana na kizuizi cha mtiririko wa hewa au kukwama.
Hata kama grafu hizi hazijachapishwa moja kwa moja hapa, ni muhimu kwa kuelewa wazo kuu la utafiti: modeli haifanyi kazi na nambari za nasibu; inajaribu kujifunza alama za tabia halisi za kimekanika katika eneo la masafa. Yaani sifa za FFT zinazotolewa kwa classifier ni ishara zilizotokana na athari za kimwili za hitilafu.
Jaribio la kelele linaonyesha nini?
Katika utafiti, mazingira yenye kelele katika kiwango cha 20 dB SNR yaliundwa kwa kutumia kelele nyeupe ya Gaussian. Inaelezwa kwamba amplitude ya kelele ni takriban %10 ya amplitude ya ishara ya asili. Lengo la jaribio hili ni kuona kama modeli inaweza kufanya kazi si katika ishara safi za maabara tu, bali pia katika hali za ishara zilizoharibika.
Kuongeza kelele ni kama kuweka mitikisiko ya nasibu juu ya ishara. Ikiwa modeli inafanikiwa kwenye data safi pekee lakini inaporomoka kwenye kelele, inabaki na mipaka kwa matumizi ya viwanda. Dai kuu la KCForest ni kwamba kwa ramani ya kernel ya RBF na parameta zilizoboreshwa kwa PSO, athari hii ya kelele inaweza kukandamizwa vizuri zaidi.
Matokeo yanasema nini?
Katika mazingira yasiyo na kelele, usahihi wa uthibitishaji wa KCForest umetolewa kama %98,75 na usahihi wa majaribio kama %98,05. Katika hali ileile, usahihi wa majaribio wa CForest ni %98,25, ambao uko juu kidogo kuliko KCForest. RF ilitoa usahihi wa majaribio wa %98,05, sawa na KCForest. Kwa hiyo matokeo ya utafiti yanapaswa kusomwa kwa uaminifu hivi: katika hali ya data safi, KCForest haikutoa usahihi wa majaribio ulio wa juu kwa tofauti kubwa peke yake; mbinu za msingi wa misitu kama CForest na RF pia zilionyesha utendaji wenye nguvu sana.
Lakini katika mazingira yenye kelele, jedwali hubadilika. Chini ya kelele ya 20 dB SNR, usahihi wa majaribio wa KCForest hushuka hadi %97,10. Kushuka huku ni pointi 0,95 tu ikilinganishwa na hali isiyo na kelele. Usahihi wa majaribio wa CForest hushuka hadi %94,85 katika hali ileile ya kelele. Usahihi wa majaribio wa RF hushuka hadi %90,15. Hii inaonyesha kwamba KCForest ilibaki thabiti zaidi chini ya kelele hasa ikilinganishwa na modeli za familia ya misitu.
Hata hivyo, maelezo muhimu pia hayapaswi kupuuzwa: katika jedwali la mazingira yenye kelele, modeli ya KELM ilitoa usahihi wa majaribio wa %97,90, thamani iliyo juu kuliko KCForest. ELM pia iko karibu sana na KCForest kwa %97,00. Kwa hiyo utafiti haupaswi kusomwa kama “KCForest ndiyo matokeo bora kabisa kati ya algoriti zote katika kila hali.” Usemi sahihi zaidi ni huu: KCForest inaonyesha faida wazi katika ustahimilivu wa kelele na uthabiti wa sampuli ndogo hasa ikilinganishwa na modeli za kaskadi forest na random forest; modeli nyingine za msingi wa kernel kama KELM pia zilitoa matokeo yenye nguvu katika jaribio la kelele.
Majaribio ya sampuli ndogo yanaeleza nini?
Mojawapo ya sehemu muhimu zaidi za utafiti ni jaribio ambalo mifano ya mafunzo ilipunguzwa. Jaribio lilifanywa katika mazingira yenye kelele ya 20 dB. Kwa kutumia uwiano tofauti wa seti ya mafunzo, ilichunguzwa jinsi modeli zinavyotenda chini ya data chache. Uwiano wa mifano ya mafunzo uliongezwa kutoka %10 hadi %50 kwa vipindi vya pointi 5.
KCForest ilidumisha usahihi wa juu kiasi hata mifano ya mafunzo ilipopungua sana. Wakati %10 tu ya mifano ya mafunzo ilipotumika, yaani kwa mifano 80 ya mafunzo kama ilivyoelezwa katika utafiti, usahihi wa uthibitishaji wa KCForest uliripotiwa kuwa %92,00 na usahihi wa majaribio %90,25. Katika hali ileile, usahihi wa majaribio wa CForest ulikuwa %76,15. Tofauti hii inaonyesha kwamba muundo wa tabaka uliotiwa kernel unaweza kuunda mipaka ya uamuzi iliyo thabiti zaidi kuliko cascade forest ya jadi wakati data chache na kelele vinapokutana.
Uwiano wa mifano ya mafunzo ulipofika %20, usahihi wa uthibitishaji wa KCForest ulikuwa %94,17 na usahihi wa majaribio %94,05. Katika uwiano wa mafunzo wa %45, KCForest ilifikia thamani yake ya juu zaidi iliyoreripotiwa katika seti ya majaribio yenye kelele, %95,60. Kwa upande mwingine, CForest imeelezwa kutoa utendaji wenye kuyumba zaidi katika maeneo yale.
Maana ya vitendo ya matokeo haya ni hii: wakati haiwezekani kukusanya mifano mingi kwa kila hitilafu katika viwanda, modeli zinazoweza kufanya kazi kwa uthabiti kwa mifano michache huwa na thamani zaidi. Hesabu ya KCForest ya kufanana kwa kernel dhidi ya vituo vya madarasa inaweza kuwa imesaidia kufanya umbali kati ya madarasa uwe wazi zaidi katika data chache. Hata hivyo, tafsiri hii imefungwa na hali za majaribio za utafiti; mashine tofauti, sensa tofauti na aina tofauti za hitilafu zinahitaji kujaribiwa upya.
Matrix ya mkanganyiko inaonyesha nini?
Katika utafiti, matrix ya mkanganyiko imetolewa kwa KCForest katika hali za majaribio zisizo na kelele na zenye kelele. Matrix ya mkanganyiko huonyesha ni madarasa halisi gani modeli inayachanganya na madarasa gani ya utabiri. Grafu za aina hii hutoa taarifa zaidi kuliko kiwango cha usahihi; kwa sababu hata ikiwa usahihi wa jumla ni mkubwa, baadhi ya aina za hitilafu zinaweza kuchanganywa zaidi kuliko nyingine.
Katika mazingira yasiyo na kelele, inaonekana kwamba modeli kwa ujumla hufanya uainishaji sahihi. Kwa hali ya kawaida f1, baadhi ya mifano ilichanganywa na f2, f3 na f4. Darasa la f2 limetenganishwa kwa uwazi kabisa. Katika darasa la f3, baadhi ya mifano ilichanganywa na f1. Darasa la f4 lilitambuliwa kwa usahihi wazi katika mazingira yasiyo na kelele.
Katika mazingira yenye kelele, mkanganyiko unaojitokeza zaidi unaonekana katika darasa la f3. Sehemu muhimu ya mifano ya f3, ambayo ni kulegea kwa msingi wa mota, ilitabiriwa kama f1, yaani hali ya kawaida. Matokeo haya ni muhimu; kwa sababu hata ikiwa usahihi wa jumla ni mkubwa, kufanana kwa hitilafu ya kulegea na hali ya kawaida kunaweza kuwa hatari kwa usalama wa matengenezo. Utafiti unaonyesha kwamba KCForest ni thabiti dhidi ya kelele, lakini mkanganyiko katika darasa la f3 unaonyesha wazi kwamba modeli si kamilifu.
Nguvu za utafiti
- Ustahimilivu wa kelele: KCForest ilipoteza pointi 0,95 tu ya usahihi wa majaribio chini ya kelele ya 20 dB.
- Utendaji wa sampuli ndogo: Usahihi wa majaribio wa %90,25 uliripotiwa hata kwa kutumia %10 ya mifano ya mafunzo.
- Msingi wa sifa za kimwili: Modeli hutumia taarifa za eneo la masafa zilizotolewa kwa FFT badala ya sifa za nasibu kutoka data ghafi.
- Utenganishaji wa msingi wa kernel: Ufanano wa RBF unalenga kutoa sifa zinazotenganisha zaidi kulingana na vituo vya madarasa.
- Kina cha modeli kinachobadilika: Utaratibu wa kusimamisha mapema unalenga kupunguza ukuaji usiohitajika wa tabaka na hatari ya kujifunza kupita kiasi.
- Uboreshaji wa parameta: Parameta za RBF hutafutwa kimataifa kwa PSO; hii ni mtazamo wa mfumo zaidi kuliko kuchagua parameta kwa mkono.
Mapungufu
- Hali ya mapitio ya wenzao: Utafiti ni preprint ambao haujapitia mapitio ya wenzao. Kwa hiyo matokeo yanapaswa kusomwa kwa tahadhari.
- Mpangilio mmoja wa majaribio: Majaribio yalifanywa kwenye feni maalumu ya meli na hali nne maalumu za kazi. Matokeo hayawezi kuenezwa moja kwa moja kwa mashine zote zinazozunguka.
- Hali za hitilafu zilizosimuliwa: Utafiti huchunguza hitilafu za feni kupitia hali zilizoundwa kwenye mpangilio wa majaribio; hautoi ushahidi wa matumizi halisi ya shambani kwa muda mrefu.
- Modeli ya kelele ni yenye mipaka: Jaribio la kelele lilifanywa kwa kelele nyeupe ya Gaussian ya 20 dB. Kelele halisi za viwanda hazilingani kila wakati na modeli hii.
- Ulinganisho wa KELM: Katika jaribio lenye kelele, KELM ilitoa matokeo ya juu kuliko KCForest kwa usahihi wa %97,90. Hii inaonyesha kwamba KCForest si kiongozi kamili katika ulinganisho wote.
- Mchanganyiko wa f3: Katika matrix ya mkanganyiko yenye kelele, sehemu ya mifano ya kulegea kwa msingi wa mota ilichanganywa na hali ya kawaida.
Utafiti unasema nini, na haussemi nini?
Utafiti unasema hili: Ramani ya kernel ya RBF iliyoboreshwa kwa PSO, inapoongezwa kwenye muundo wa cascade forest, inaweza kutoa uainishaji thabiti zaidi wa hitilafu katika ishara za mtikisiko wa mashine zinazozunguka chini ya hali za kelele na mifano michache. Hasa ikilinganishwa na mbinu za msingi wa misitu kama CForest na RF, kushuka kwa utendaji chini ya kelele kumeonekana kuwa dogo zaidi.
Utafiti hausimi hili: Hausimi kwamba mbinu hii itatoa mafanikio yale yale kwa kila aina ya mashine inayozunguka, kila nafasi ya sensa, kila aina ya kelele na kila hali halisi ya shambani. Pia utafiti hauonyeshi kwamba mbinu inaweza kutumiwa moja kwa moja katika mifumo ya kibiashara ya matengenezo au kwamba itatoa dhamana ya usalama katika mashine za meli. Matokeo yamefungwa na mpangilio wa majaribio, seti ya data, madarasa manne ya hitilafu, sifa za FFT na algoriti za ulinganisho zilizochaguliwa.
Umuhimu wake kwa zamani, sasa na baadaye
Zamani, utambuzi wa hitilafu ulitegemea zaidi uzoefu wa wataalamu, thamani za kizingiti na sifa rahisi za kitakwimu. Mitazamo hii inaweza kufanya kazi katika baadhi ya hitilafu zilizo wazi, lakini inaweza kuwa haitoshi katika hali tata za uendeshaji. Mbinu za kujifunza kwa mashine ziliendelezwa ili kujaza pengo hili; lakini nazo hukutana na matatizo ya kelele na data chache.
Leo, data za sensa zinaongezeka katika viwanda, meli na mifumo ya nishati. Hata hivyo, kuwa na data nyingi hakumaanishi kila wakati kuwa na data nyingi za hitilafu zilizo na lebo bora. Hasa kwa hitilafu nadra, idadi ya mifano inaweza kuwa ndogo. Kwa hiyo mbinu zinazoweza kufanya kazi kwa data chache na kustahimili kelele zina thamani ya vitendo.
Baadaye, mbinu za aina hii zinaweza kuchangia katika mifumo mahiri zaidi ya onyo la mapema katika matengenezo ya kutabiri. Kwa mfano, ikiwa muundo wa mtikisiko katika feni ya meli unaanza kupotoka polepole kutoka hali ya kawaida, mfumo unaweza kuijulisha timu ya matengenezo mapema. Lakini kwa hili, modeli lazima ithibitishwe katika meli tofauti, mota tofauti, nafasi tofauti za sensa, mizigo tofauti na data za shambani za muda mrefu.
Mbinu na Matokeo ya Utafiti
Mtiririko wa mbinu ya kiufundi
- Ukusanyaji wa data: Data za mtikisiko zilikusanywa kutoka feni ya meli inayoendeshwa na mota ya asinkroni ya awamu tatu.
- Madarasa ya hitilafu: Madarasa manne yalifafanuliwa: hali ya kawaida, kutokuwa na usawa wa blade ya feni, kulegea kwa msingi wa mota na kukwama kwa feni.
- Uchakataji wa ishara: Ishara za mtikisiko za eneo la muda zilibadilishwa kwenda eneo la masafa kwa FFT.
- Uchaguzi wa sifa: Spektra ya amplitude ya FFT ilitumika kama sifa na vipengele vya masafa hasi viliondolewa.
- Normalizesheni: Normalizesheni ya min-maks ilitumika ili kufanya vipengele tofauti vya masafa viweze kulinganishwa.
- Ugawaji wa data: Data iligawanywa katika seti za mafunzo, uthibitishaji na majaribio. Seti ya mafunzo ilitumiwa kama %20, seti ya uthibitishaji %30 na seti ya majaribio %50.
- Uboreshaji wa PSO: Parameta za kernel ya RBF, \(\gamma\), \(\omega\) na \(c_w\), zilitafutwa kwa uboreshaji wa kundi la chembe.
- Mafunzo ya KCForest: Katika kila tabaka zilitumiwa random forest mbili na completely random forest mbili.
- Uhamishaji kati ya tabaka: Sifa za awali za FFT, sifa za kernel ya RBF na uwezekano wa madarasa wa tabaka lililotangulia ziliunganishwa.
- Kusimamisha mapema: Muundo wa kaskadi ulisimamishwa wakati mafanikio ya uthibitishaji hayakuongezeka.
- Ulinganisho: KCForest ililinganishwa na CForest, GNB, CART, RF, ELM, KELM na DELM.
Taarifa za data ya majaribio na vipimo
| Kipengele | Taarifa iliyotolewa katika utafiti |
|---|---|
| Kitu cha majaribio | Feni ya meli inayoendeshwa na mota ya asinkroni ya awamu tatu |
| Voltage ya mota | 380 V |
| Mkondo wa mota | 4,6 A |
| Nguvu ya mota | 1,1 kW |
| Masafa | 50 Hz |
| Kasi ya kuzunguka | 1400 dev/dak |
| Sensa | Sensa ya mtikisiko yenye kunyonya kwa sumaku |
| Usikivu wa sensa | 10,20 mV/g |
| Voltage ya bias | 12,40 V |
| Masafa ya sampuli | 1652 Hz |
| Muda wa ishara ya kila kundi | 2 sekunde |
| Jumla ya data | Data 4000 za majaribio |
Madarasa ya hitilafu na uchunguzi wa eneo la masafa
| Darasa | Hali | Tabia ya masafa/ishara iliyotajwa katika utafiti |
|---|---|---|
| f1 | Hali ya kawaida | Kilele kikuu cha masafa 576,50 Hz; nishati imejikita zaidi; entropy ya spektra ni ndogo; uendeshaji ni thabiti zaidi. |
| f2 | Kutokuwa na usawa wa blade ya feni | Masafa makuu 518,00 Hz; ongezeko la nishati ya masafa ya chini na entropy ya spektra; kuenea kwa mtikisiko kutokana na mgawanyo wa misa usio na usawa. |
| f3 | Kulegea kwa msingi wa mota | Masafa makuu 518,50 Hz; nishati huhamia eneo la masafa ya juu; huhusishwa na resonance ya masafa ya juu inayotokana na kiunganishi kilicholegea. |
| f4 | Kukwama kwa feni | Masafa makuu 568,50 Hz; nishati ya jumla na entropy ya spektra katika kiwango cha kati; muundo wa mtikisiko unaotokana na kizuizi cha hewa au kukwama. |
PSO na parameta za RBF
| Parameta | Masafa / Thamani | Maana |
|---|---|---|
| \(\gamma\) | [0,5, 8] | Huamua jinsi kufanana kunavyopungua haraka na umbali katika kernel ya RBF. |
| \(\omega\) | [0,5, 4] | Huamua uzito wa mchango wa sifa za kernel kwa modeli. |
| \(c_w\) | [0,8, 1,5] | Hurekebisha uskelishaji wa vituo vya madarasa. |
| Idadi ya chembe | 10 | Ni idadi ya suluhisho mgombea zilizotumiwa katika utafutaji wa PSO. |
| Uzito wa inershia | Hupunguzwa kutoka 0,8 hadi 0,4 | Huruhusu utafutaji mpana mwanzoni na utafutaji wa ndani zaidi mwishoni. |
| Vigawo vya kiakili na kijamii | 1,5 na 1,5 | Huunda usawazishaji kati ya uzoefu wa chembe na taarifa ya kundi. |
| Thamani bora kwenye grafu | \(\gamma\approx1{,}654\), \(\omega\approx1{,}022\), \(c_w\approx0{,}988\) | Ni mchanganyiko bora wa parameta ulioripotiwa katika uonyeshaji wa PSO. |
Usahihi wa classifiers katika mazingira yasiyo na kelele
| Algoriti | Usahihi wa uthibitishaji | Usahihi wa majaribio | Muda wa mafunzo | Muda wa majaribio |
|---|---|---|---|---|
| KCForest | %98,75 | %98,05 | 5,28 s | 2,203 s |
| CForest | %98,75 | %98,25 | 5,97 s | 2,102 s |
| GNB | %95,83 | %94,70 | 95,95 s | 95,95 s |
| CART | %96,17 | %95,70 | 0,007 s | 0,006 s |
| RF | %98,58 | %98,05 | 0,044 s | 0,044 s |
| ELM | %97,17 | %97,05 | 0,008 s | 0,002 s |
| KELM | %98,25 | %98,00 | 0,018 s | 0,016 s |
| DELM | %92,00 | %91,50 | 0,003 s | 0,002 s |
Jedwali hili linaonyesha kwamba KCForest ina nguvu katika mazingira safi; lakini usahihi wa majaribio wa CForest ni juu kidogo kwa %98,25, na RF pia imefikia usahihi sawa wa majaribio na KCForest. Kwa hiyo mchango mkuu wa KCForest haujitokezi kama ubora kamili katika mazingira safi, bali katika uthabiti chini ya kelele na hali za sampuli ndogo.
Usahihi wa classifiers katika mazingira yenye kelele ya 20 dB
| Algoriti | Usahihi wa uthibitishaji | Usahihi wa majaribio | Muda wa majaribio |
|---|---|---|---|
| KCForest | %97,92 | %97,10 | 3,813 s |
| CForest | %94,75 | %94,85 | 2,520 s |
| GNB | %52,83 | %51,90 | 26,930 s |
| CART | %84,00 | %84,45 | 0,001 s |
| RF | %89,83 | %90,15 | 0,019 s |
| ELM | %97,08 | %97,00 | 0,008 s |
| KELM | %98,25 | %97,90 | 0,064 s |
| DELM | %92,33 | %91,80 | 0,008 s |
Jedwali la mazingira yenye kelele linaonyesha kwamba KCForest huharibika kidogo zaidi hasa ikilinganishwa na CForest na RF. Usahihi wa majaribio wa KCForest katika hali isiyo na kelele ni %98,05, ilhali usahihi wa majaribio katika hali yenye kelele ni %97,10. Kushuka huku kwa pointi 0,95 kunaonyesha kwamba modeli ilibaki thabiti dhidi ya kelele. Kushuka kwa CForest ni pointi 3,40, na kushuka kwa RF ni pointi 7,90. CART na GNB zimedhoofika wazi chini ya kelele.
Hata hivyo, usahihi wa majaribio wa KELM katika hali yenye kelele ni %97,90, thamani iliyo juu kuliko matokeo ya %97,10 ya KCForest. Kwa hiyo KCForest inaonekana yenye nguvu hasa ndani ya mbinu za msingi wa misitu kwa upande wa ustahimilivu wa kelele; lakini haijatoa matokeo ya juu zaidi peke yake katika kila metriki kati ya algoriti zote zilizolinganishwa.
Matokeo ya sampuli ndogo
| Hali | Matokeo ya KCForest | Tafsiri |
|---|---|---|
| %10 ya mifano ya mafunzo | Uthibitishaji %92,00; majaribio %90,25 | Usahihi unaoweza kuchukuliwa kuwa wa juu ulidumishwa hata kwa data chache sana za mafunzo. |
| Ulinganisho wa CForest katika %10 ya mifano ya mafunzo | Usahihi wa majaribio wa CForest %76,15 | Tofauti ya pointi 14,10 ilitokea kati ya KCForest na CForest. |
| %20 ya mifano ya mafunzo | Uthibitishaji %94,17; majaribio %94,05 | Kadiri idadi ya mifano ilivyoongezeka, usahihi wa KCForest ulipanda kwa utaratibu. |
| %25 ya mifano ya mafunzo | Kushuka kwa ndani kwa pointi 1,35 katika usahihi wa majaribio | Modeli haikuonyesha ongezeko tambarare kabisa, lakini ilipata nafuu katika uwiano uliofuata. |
| %45 ya mifano ya mafunzo | Usahihi wa majaribio %95,60 | Huu ni usahihi wa juu zaidi wa majaribio ulioripotiwa kwa KCForest katika majaribio ya sampuli ndogo yenye kelele. |
Matokeo haya yanaonyesha kwamba KCForest ni thabiti zaidi kuliko muundo wa jadi wa cascade forest wakati sampuli chache na kelele vinakutana. Tafsiri ya utafiti ni kwamba tabaka za kati zilizotiwa kernel zinapanua pengo la mgawanyo kati ya madarasa na husaidia miti ya uamuzi kupata sehemu za kugawa zilizoaminika zaidi.
Athari za matokeo kwa maisha ya kila siku na viwanda
Athari ya utafiti huu kwa maisha ya kila siku ni ya moja kwa moja kupitia kugundua hitilafu mapema. Feni katika meli, mota katika kiwanda cha uzalishaji au kifaa kinachozunguka katika mfumo wa nishati kinapoharibika bila kutarajiwa, si mashine tu inayosimama; usalama, muda, gharama na mwendelezo wa operesheni pia huathiriwa. Modeli imara zaidi zinazoweza kufanya utambuzi wa hitilafu kutoka data za mtikisiko zinaweza kusaidia timu za matengenezo kuingilia kati kwa wakati sahihi.
Kwa upande wa viwanda, modeli ya aina hii inaweza kuwa ya thamani hasa mahali ambapo data za sensa zipo lakini mifano ya hitilafu yenye lebo ni michache. Kwa mfano, kila biashara inaweza kuwa na maelfu ya mifano ya kazi ya kawaida; lakini hitilafu kama kukwama kwa feni au kulegea kwa msingi wa mota zinaweza kuwa zimehifadhiwa mara chache tu. Utendaji wa KCForest katika hali za sampuli ndogo ni muhimu kwa upande huu.
Hata hivyo, utafiti hautoi ushahidi wa matumizi ya muda mrefu katika kiwanda halisi cha uzalishaji au katika chumba halisi cha mashine cha meli. Kwa hiyo mbinu inapaswa kutathminiwa kama mtazamo wa matengenezo mahiri wenye uwezo; kabla ya kutumiwa katika mifumo muhimu kwa usalama, inapaswa kuthibitishwa kwenye vifaa tofauti, mizigo tofauti na mazingira halisi ya kelele.
Noti ya Chanzo na Mbinu
Makala haya yametayarishwa kwa msingi wa utafiti wenye kichwa “Fault Diagnosis Method for Rotating Machinery Based on Particle Swarm Optimization-Driven Kernelized Cascade Forest” ulioandaliwa na Qinming Tan, Duankai Li, Jiawei Jiang na KunXiang Ge. Utafiti ni makala ya preprint iliyowasilishwa kwenye SSRN. Kwa kuwa maandishi yanaeleza wazi “This preprint research paper has not been peer reviewed”, haujapitia mapitio ya wenzao.
Mbinu inayoelezwa katika maudhui inategemea modeli ya KCForest, uboreshaji wa PSO, ramani ya kernel ya RBF, sifa za mtikisiko za msingi wa FFT, mpangilio wa majaribio wa feni ya meli, madarasa manne ya hitilafu na matokeo ya kulinganisha classifiers yaliyotolewa katika utafiti. Hakijaongezwa madai ambayo hayapo katika utafiti, kama mafanikio ya kibiashara, mafanikio ya uhakika ya shambani, dhamana ya usalama au uwezo wa kutumika kwa mashine zote zinazozunguka.
Utafiti ulifanywa kwenye mpangilio wa majaribio. Data zilizotumiwa ni ishara za mtikisiko zilizokusanywa kutoka feni ya meli inayoendeshwa na mota ya asinkroni ya awamu tatu. Katika utafiti, kelele nyeupe ya Gaussian katika kiwango cha 20 dB SNR ilitumiwa kupima ustahimilivu wa kelele. Hii haimaanishi kwamba inawakilisha aina zote za kelele halisi za viwanda. Aidha, utafiti haudai kutoa uthibitishaji wa muda mrefu wa shambani katika chumba halisi cha mashine cha meli.
Kwa sababu ni preprint, matokeo yanapaswa kusomwa kwa tahadhari. Modeli ya KCForest inatoa matokeo yenye matumaini hasa chini ya hali za kelele na mifano michache ya mafunzo; lakini uthibitishaji wa ziada unahitajika chini ya aina tofauti za vifaa, nafasi tofauti za sensa, madarasa tofauti ya hitilafu na hali halisi za shambani.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *