

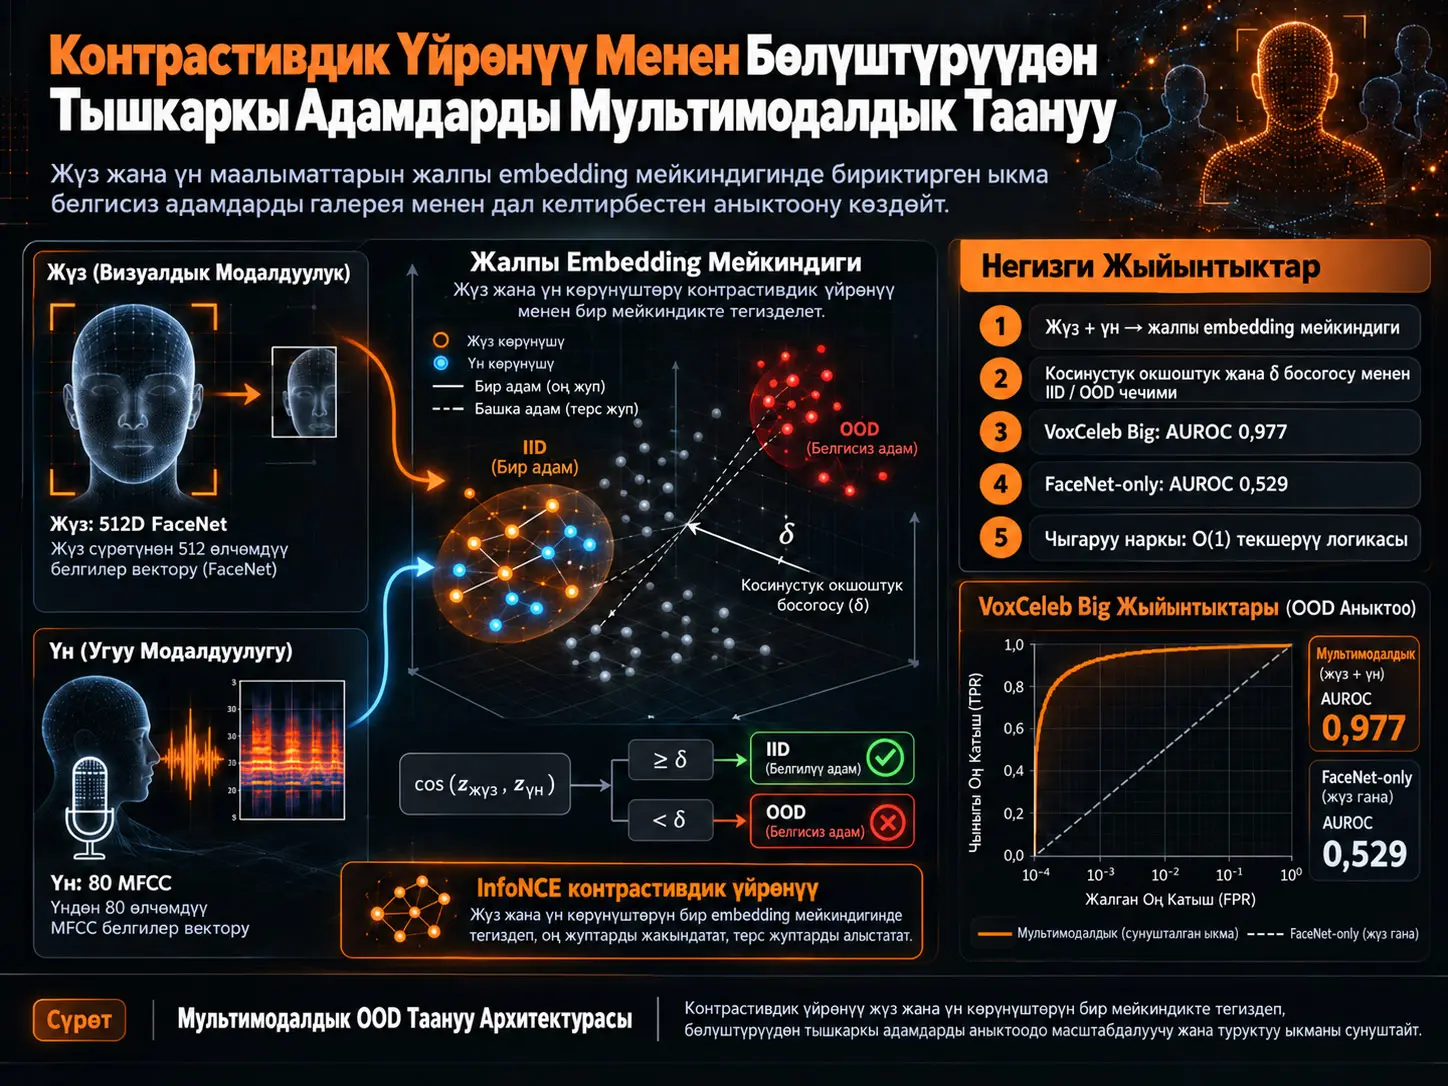
Бөлүштүрүүдөн тышкаркы адам (out-of-distribution, OOD) — адамды таануу системасы окутуу учурунда үйрөнгөн идентификациялык бөлүштүрүүгө кирбеген, мурда кездешпеген адам. Салттуу жабык-топтомдуу таануу системасына мындай үлгү берилгенде, модель белгисиз адамды бар класстардын бирине мажбурлап ыйгарышы мүмкүн. Sergio Garcia, Francisco Gomez-Donoso жана Miguel Cazorla иштеп чыккан ыкма бул көйгөйдү жүз же үн аркылуу гана чечпестен, эки биометрикалык модалдуулуктун бири-бирине канчалык шайкеш келерин өлчөйт.
Модель жүздүн сүрөтүнөн FaceNet аркылуу 512 өлчөмдүү белгилер векторун, ал эми үн жазмасынан 80 Mel-Frequency Cepstral Coefficient (MFCC) белгисин бөлүп алат. Эки өзүнчө нейрондук тармак бутагы бул көрүнүштөрдү 1200 өлчөмдүү жалпы embedding мейкиндигине проекциялайт. Окутуу учурунда InfoNCE негизиндеги контрастивдик жоготуу бир адамга тиешелүү жүз-үн жуптарын бири-бирине жакындатып, ар башка адамдарга тиешелүү жуптарды бири-биринен алыстатат.
Чыгаруу учурунда идентификациялар галереясынан эң жакын адам изделбейт. Анын ордуна жүз embedding-и менен үн embedding-и ортосундагы косинустук окшоштук өлчөнөт. Маани белгиленген \(\delta\) босогосунан төмөн болсо, жуп OOD, ал эми босогодон жогору болсо, бөлүштүрүүнүн ичиндеги үлгү катары классификацияланат.
Custom, LombardGrid жана VoxCeleb негизиндеги эксперименттерде бул ыкма, айрыкча идентификациялардын саны өскөндө, FaceNet-only салыштыруусуна караганда туруктуураак натыйжаларды берген. VoxCeleb Big экспериментинде мультимодалдык ыкманын AUROC мааниси 0,977, ал эми FaceNet-only салыштыруусунун мааниси 0,529 болгон. Ошол эле учурда натыйжалар адамды таануунун бардык мультимодалдык ыкмаларына карата кеңири state-of-the-art салыштыруу болуп саналбайт жана моделди реалдуу дүйнөдө кеңири масштабда этикалык жана операциялык валидациялоо келечектеги иш катары калтырылган.
Бөлүштүрүүдөн тышкаркы адам көйгөйү деген эмне?
Эгер нейрондук тармак окутуу учурунда көргөн класстардын арасынан гана тандоо жасай тургандай долбоорлонсо, ал мурда эч качан кездешпеген идентификацияны да белгилүү класстардын бирине ыйгарышы мүмкүн. Моделдин жогорку ишеним жаратышы бул адам чындап таанылды дегенди билдирбеши мүмкүн.
Бул көйгөй адамды таануу системаларында өзгөчө маанилүү. Системанын “бул адам окутууда көргөн адамдарымдын бири эмес” деп айта алышы — туура классификация жасай алуу жөндөмүнөн башкача жөндөм.
Макала бул көйгөйдү жүз жана үн деген эки өзүнчө биометрикалык модалдуулукту бирге колдонуу аркылуу карайт.
Жүз жана Үн Бирге OOD Аныктоону Кантип Камсыз Кылат?
Сунушталган системанын негизги божомолу — бир адамга тиешелүү жүз жана үн көрүнүштөрүн контрастивдик окутуудан кийин жалпы латенттик мейкиндикте бири-бирине шайкеш келтирүүгө болот. Модель “адамдын идентификациясын галереядан табууга” аракеттенбестен, жүз менен үн үйрөнүлгөн көрүнүш мейкиндигинде бир эле идентификацияга тиешелүү болгондой деңгээлде шайкешпи деген суроо коёт.
Жүз тарабы: FaceNet
Жүз сүрөттөрү сунушталган контрастивдик тармакка түздөн-түз чийки пикселдер түрүндө берилбейт. Адегенде FaceNet менен иштетилип, ар бир сүрөт үчүн 512 өлчөмдүү жүз embedding-и түзүлөт.
Бул көрүнүш жүздүн айырмалоочу белгилерин компакттуу метрикалык мейкиндикте коддоо үчүн колдонулат. Андан соң 512 өлчөмдүү вектор сунушталган мультимодалдык тармактын жүз бутагына өткөрүлөт.
Үн тарабы: MFCC
Үн маалыматтары үчүн Mel-Frequency Cepstral Coefficients колдонулган. Ар бир үн бөлүгүнөн 80 MFCC белгиси бөлүнүп алынган.
MFCC бөлүп алуудан мурда үндүн амплитудасы сызыктуу gain normalization аркылуу 0,03 максаттуу маанисине нормалдаштырылган. Авторлор мунун RMS же peak normalization эмес экенин өзгөчө белгилешет. Максат — жаздыруунун үн деңгээлиндеги айырмачылыктар спектрдик белгилерде керексиз өзгөрмөлүүлүктү жаратышын азайтуу.
Эки модалдуулук жалпы мейкиндикте биригет
Жүз жана үн бутактары окшош көп катмарлуу түзүмдөрдү колдонот. Эки бутактын тең аягында көрүнүш 1200 өлчөмдүү жалпы embedding мейкиндигине проекцияланат.
| Бутак | Киргизүү | Аралык катмарлар | Чыгыш |
|---|---|---|---|
| Жүз | 512D FaceNet embedding | 1024 → 512 → 256 | 1200D embedding |
| Үн | 80 MFCC белгиси | 1024 → 512 → 256 | 1200D embedding |
Ар бир аралык блокто Linear, BatchNorm1d, ReLU жана Dropout компоненттери бар. Булакта модель үчүн жалпысынан 2.544.480 окутулуучу параметр көрсөтүлгөн.
Контрастивдик Үйрөнүү Бул Жерде Эмнени Үйрөнөт?
Контрастивдик үйрөнүү бир адамга тиешелүү жүз-үн жуптарын embedding мейкиндигинде бири-бирине жакындатып, ар башка адамдардын жуптарын бири-биринен алыстатууну көздөйт. Ошентип, система класс энбелгисин жаттап алуунун ордуна эки башка модалдуулуктун ортосундагы идентификациялык шайкештикти үйрөнүүгө аракет кылат.
Оң жана терс жуптар
Бир адамга тиешелүү жүз \(f_i\) менен үн \(a_i\) оң жупту түзөт.
Ар башка адамдарга тиешелүү жүз \(f_i\) менен үн \(a_j\), \(i \neq j\) болгондо, терс жупту түзөт.
Булак 40 жүз жана 40 үн үлгүсү бар бир адам үчүн 1600 оң дал келүү комбинациясы түзүлүшү мүмкүн экенин көрсөтөт. Мисал катары 50 адамдан турган учурда жалпысынан 80.000 оң жуп жана 3.920.000 мүмкүн болгон терс жуп эсептелет. Бул бөлүм методологиялык комбинациянын мисалы; колдонулган бардык маалымат топтомдору чынында эле 50 адамдан турат дегенди билдирбейт.
InfoNCE жоготуусу
Окутууда колдонулган контрастивдик жоготуу:
\[ L_{\text{contrastive}} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{ \exp(sim(z_{f_i},z_{a_i})/\tau) }{ \sum_{j=1}^{N} \exp(sim(z_{f_i},z_{a_j})/\tau) } \]
түрүндө берилет.
Бул жерде \(z_f\) жүз embedding-ин, \(z_a\) үн embedding-ин, \(N\) batch өлчөмүн жана \(\tau\) температура параметрин билдирет.
Окшоштук өлчөмү — косинустук окшоштук:
\[ sim(z_f,z_a) = \frac{z_f \cdot z_a} {\|z_f\|\|z_a\|} \]
Окутуу параметрлерине 50 epoch, класстардын санына барабар batch size, 0,0005 learning rate жана \(\tau=0,05\) температура мааниси кирет.
Система Белгисиз Адам Жөнүндө Чечимди Кантип Чыгарат?
Чыгаруу учурунда жүз-үн жубунун эки embedding-и түзүлүп, алардын ортосундагы косинустук окшоштук эсептелет. Булакта OOD чечими төмөнкүдөй аныкталат:
\[ OOD(z_f,z_a)= \begin{cases} 1, & sim(z_f,z_a)<\delta \\ 0, & \text{aksi halde} \end{cases} \]
\(\delta\) — чечим босогосу.
Булакта баштапкы босого окутуудагы оң жуптардын орточо окшоштугунун жарымын колдонуу менен эмпирикалык түрдө түзүлгөн. Бирок авторлор бул маанини оптималдаштырылган туруктуу модель параметри катары көрсөтүшпөйт. Эксперименттерде кеңири threshold диапазону сканерленип, ыкманын ар башка иш чекиттериндеги сезгичтиги өзүнчө изилденген.
Маанилүү нюанс: “мурда көрүлбөгөн адам” дайыма эле төмөн окшоштук жаратпайт
Бул жагдай ыкманы түшүнүү үчүн өтө маанилүү. Модель мурда көрбөгөн адамдын жүзү менен үнүн да жалпы embedding мейкиндигинде жакшы дал келтириши мүмкүн.
Демек, системанын OOD механизми “бул идентификацияны мурда жаттадым беле?” деген суроого негизделбейт. Өлчөнүп жаткан нерсе — жүз менен үндүн ортосундагы cross-modal consistency.
Окутууга чейинки жана андан кийинки окшоштук бөлүштүрүүсү
Булактын 9-бетиндеги 2-сүрөт контрастивдик окутууга чейин жүз жана үн көрүнүштөрү бардык маалымат топтомдорунда болжол менен нөлдүн айланасында топтолгонун көрсөтөт. Башкача айтканда, FaceNet жүз белгилери менен MFCC үн белгилери табигый түрдө бир координаталык мейкиндикте тегизделген эмес.
Ошол эле беттеги 3-сүрөттө жана 4-сүрөттө окутуудан кийин LombardGrid оң жүз-үн жуптарынын косинустук окшоштуктары окутуу жана тест топтомдорунда тең 1 ге жакындаганы көрүнөт. Бул өзгөрүү контрастивдик модель эки башка модалдуулуктун ортосунда жалпы көрүнүштү үйрөнгөнүнүн түз визуалдык көрсөткүчү.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Колдонулган маалымат топтомдору
Изилдөө үч негизги маалымат булагын колдонот: изилдөөчүлөр түзгөн custom маалымат топтому, VoxCeleb1 жана Lombard Grid.
Custom маалымат топтому
Атайын маалымат топтому 15 ар башка адамдын жүз жана үн маалыматтарын камтыйт. Булактар YouTube сыяктуу жалпыга ачык платформалардагы видеолорду да, макулдук берген адамдардын реалдуу убакыттагы жазмаларын да камтыйт.
Ар бир адамда 3-10 үн клиби бар жана үндөрдүн орточо узактыгы 4-8 секунд. Окутуу маалыматтарына augmentation колдонулуп, ар бир адам үчүн 40 жүз кадрына жана 40 үн үлгүсүнө жеткирилген. Тест үчүн ар бир адамга үч жүз кадры жана үч үн үлгүсү бөлүнгөн; тест жазмалары окутууда колдонулган жазмалардан башка булактардан алынышына көңүл бурулган.
VoxCeleb1
VoxCeleb1 — жалпысынан 1251 адамга тиешелүү 100.000 ден ашык үн клибин камтыган кеңири масштабдуу сүйлөөчүлөр маалымат топтому. Жазмалар фондук ызы-чуу, акцент жана микрофон шарттары боюнча ар түрдүү.
Бул изилдөөдө тест видеолору окутуу видеолорунан өзүнчө сакталган. Окутуу үчүн ар бир адамга 20 жүз кадры жана 20 үн үлгүсү максат катары белгиленип, augmentation-дан кийин 40 жүз жана 40 үн үлгүсүнө жеткирилген.
Lombard Grid
Lombard Grid 54 сүйлөөчүнү жана ар бир адам үчүн 1000 ден ашык үн клибин камтыйт. Үндөр менен синхрондуу видео жазмалардын болушу аны жүз-үн дал келтирүүгө ылайыктуу кылат.
Бул изилдөөдө ар бир адам үчүн окутууга 20 жүз жана 20 үн, ал эми тестке башка жазмалардан 5 жүз жана 5 үн тандалган. Көзөмөлдөнгөн маалымат түзүмүнө байланыштуу augmentation колдонулган эмес.
Custom маалымат топтомунун жыйынтыктары
Custom маалымат топтомунда мультимодалдык ыкма да, FaceNet-only baseline да IID жана OOD үлгүлөрүн жогорку ийгилик менен ажыраткан. ROC талдоосунда:
| Ыкма | AUROC |
|---|---|
| Мультимодалдык | 0,9928 |
| FaceNet-only | 0,9828 |
Айырма өтө чоң эмес; бирок threshold графиктери мультимодалдык ыкма чечим босогосуна карата туруктуураак аймак түзгөнүн көрсөтөт.
LombardGrid жыйынтыктары
Көзөмөлдөнгөн LombardGrid маалымат топтомунда эки ыкма тең AUROC=1 маанисине жеткен. Ошондуктан ROC ийри сызыгынын негизинде гана мультимодалдык ыкма артык деп айтууга болбойт.
Булак баса белгилеген айырма — мультимодалдык ыкманын жогорку IID/OOD натыйжалуулугун кеңири threshold диапазонунда сакташы. Башкача айтканда, алар бирдей эң жогорку натыйжалуулукка жетсе да, босого тандоосуна сезгичтиги бирдей эмес.
VoxCeleb Mini
VoxCeleb Mini экспериментинде мультимодалдык система AUROC=0,974, ал эми FaceNet-only ыкмасы AUROC=0,971 алган. ROC жагынан ыкмалар бири-бирине жакын.
Бирок OOD аныктоо максаты жогорулаган сайын IID тактыгын сактоо жагынан мультимодалдык система туруктуураак калган.
| OOD аныктоо | Мультимодалдык IID | FaceNet IID |
|---|---|---|
| %90,0 | %95,0 | %93,0 |
| %91,8 | %95,0 | %88,5 |
| %93,5 | %92,5 | %85,0 |
| %95,2 | %90,0 | %85,0 |
| %97,0 | %87,5 | %66,7 |
VoxCeleb Big: масштаб өскөндө эмне болот?
Макаладагы эң айкын айырма VoxCeleb Big экспериментинде байкалат.
Мультимодалдык ыкманын AUROC мааниси 0,977, ал эми FaceNet-only салыштыруусунун мааниси 0,529. Экинчиси кокустук ажыратууга жакын ROC натыйжалуулугун билдирет.
| OOD аныктоо | Мультимодалдык IID | FaceNet IID |
|---|---|---|
| %90,0 | %94,6 | %18,7 |
| %91,8 | %94,3 | %17,8 |
| %93,5 | %93,8 | %16,8 |
| %95,2 | %92,7 | %14,7 |
| %97,0 | %86,2 | %11,7 |
Авторлордун түшүндүрмөсү FaceNet-only системасынын иштөө ыкмасына байланыштуу. Бул baseline сурам embedding-ин катталган идентификациялардын чоң галереясы менен салыштырат. Галерея чоңойгон сайын класстар аралык окшоштук бөлүштүрүүлөрү бири-бирин каптай баштайт жана белгилүү-белгисиз ажыратууда колдонулган босого туруксузураак болуп калат.
Ал эми мультимодалдык ыкма катталган бардык идентификациялар менен 1:N салыштыруу жүргүзүүнүн ордуна берилген жүз менен үндүн өз ара шайкештигин өлчөйт.
Эсептөө татаалдыгы
Булак сунушталган ыкма чыгаруу учурунда болгону:
- бир жүз embedding-ин,
- бир үн embedding-ин,
- бир косинустук окшоштук эсебин
талап кыларын билдирет.
Ошондуктан ар бир текшерүү үчүн эсептөө наркы галереянын көлөмүнө көз каранды эмес болуп, O(1) түрүндө берилген. Ал эми классикалык 1:N галереяга негизделген адамды таанууда сурам катталган бардык идентификациялар менен салыштырылгандыктан, эсептөөнүн көлөмү галереянын өлчөмү менен өсөт.
Бул татаалдык жөнүндөгү пикир изилдөөдө аныкталган текшерүү жол-жобосуна тиешелүү; реалдуу системадагы камеранын, үндү алдын ала иштетүүнүн, FaceNet feature extraction же жабдык кечигүүсүнүн баары O(1) жана туруктуу убакытта болот дегенди билдирбейт.
Изилдөөнүн маанилүү чектөөлөрү
- Негизги эксперименттик салыштыруу FaceNet-only unimodal baseline менен гана жүргүзүлгөн.
- Башка мультимодалдык state-of-the-art ыкмалар менен толук эксперименттик салыштыруу жүргүзүлгөн эмес.
- Жөнөкөй feature concatenation сыяктуу альтернативдүү multimodal fusion baseline-дары негизги салыштырууга киргизилген эмес.
- Ар бир модалдуулуктун өз алдынча салымын сандык түрдө ажыраткан кеңири абляциялык талдоо азырынча жүргүзүлгөн эмес.
- OOD чечим босогосу — эмпирикалык иш чекити; ал бирден-бир универсалдуу оптималдуу босого катары сунушталбайт.
- Custom маалымат топтому болгону 15 адамдан турат.
- Реалдуу дүйнө шарттарында алда канча кеңири масштабдуу валидация келечектеги иш катары калтырылган.
- Этика, купуялык жана реалдуу системаны колдонуу боюнча кеңири масштабдуу баалоо аяктай элек.
Келечектеги иштер
Авторлор системага басуу ыкмасы жана тереңдик маалыматтары сыяктуу кошумча модалдуулуктарды киргизүүнү, убакыттык моделдөөнү колдонууну, self-supervised жана few-shot үйрөнүү ыкмаларын изилдөөнү жана маалыматка болгон талапты азайтууну пландаштырууда.
Мындан тышкары, реалдуу дүйнөдөгү кеңири валидация, этикалык баалоолор жана ар бир модалдуулуктун натыйжага кошкон салымын өлчөгөн тереңирээк абляциялык эксперименттер келечектеги изилдөө темаларына кирет.
Изилдөө эмнени айтат?
Жүз жана үн көрүнүштөрүн контрастивдик жол менен бир embedding мейкиндигинде тегиздөө, айрыкча идентификациялар галереясы өскөндө, cross-modal consistency аркылуу IID/OOD ажыратуусун туруктуураак жүргүзүүгө мүмкүндүк бериши мүмкүн. Изилдөөдөгү эң күчтүү эксперименттик далил VoxCeleb Big жыйынтыктарынан алынган.
Изилдөө эмнени айтпайт?
Система мурда көрүлбөгөн адамдардын баарын катасыз аныктайт деген тыянак чыгарууга болбойт. Ыкманын бардык мультимодалдык биометрикалык системалардан артык экени көрсөтүлгөн эмес. Бул изилдөө өзү эле жүз-үн биометрикасы коопсуздук, көзөмөл же идентификацияны текшерүү колдонмолорунда жайылтууга даяр экенин да далилдебейт.
Булак жана Ыкма Жөнүндө Эскертүү
Түп нуска изилдөө: Multimodal Recognition of Out-of-Distribution Individuals Using Contrastive Learning
Авторлор: Sergio Garcia; Francisco Gomez-Donoso; Miguel Cazorla.
Жооптуу автор: Miguel Cazorla.
Мекеме: University Institute for Computer Research, University of Alicante, Alicante, Spain.
Журнал: AI.
Басмакана: MDPI.
Библиографиялык жазуу: AI 2026, 7, 162.
DOI: 10.3390/ai7050162
Макаланын түрү: Эксперименттик жасалма интеллект / мультимодалдык адамды таануу изилдөөсү.
Жарыялоо процесси: 31 Январь 2026-жылы кабыл алынган; 6 Апрель 2026-жылы оңдолгон; 24 Апрель 2026-жылы кабыл алынган; 6 Май 2026-жылы жарыяланган.
Лицензия: Creative Commons Attribution (CC BY).
Каржылоо: Изилдөө PID2022-138453OB-I00 грантынын алкагында MICIU/AEI/10.13039/501100011033 жана “ERDF A way of making Europe” тарабынан колдоого алынган.
Этика: Изилдөө Хельсинки декларациясына ылайык жүргүзүлүп, University of Alicante Ethics Committee тарабынан UA-2023-07-31 протокол коду менен Июль 2023-жылы жактырылган.
Маалымдалган макулдук: Изилдөөгө киргизилген адамдардан маалымдалган макулдук алынган.
Маалыматтардын жеткиликтүүлүгү: Жыйынтыктарды колдогон чийки маалыматтар авторлор тарабынан суроо-талап боюнча берилери айтылган.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет.
Методологиялык өзөк: FaceNet-тен бөлүнүп алынган 512 өлчөмдүү жүз embedding-дери жана 80 MFCC үн белгиси эки өзүнчө нейрондук тармак бутагы аркылуу 1200 өлчөмдүү жалпы embedding мейкиндигине проекцияланган. InfoNCE контрастивдик жоготуусу менен бир адамга тиешелүү жүз-үн жуптары жакындатылып, ар башка адамдардын жуптары алыстатылган. OOD чечими жүз жана үн embedding-деринин ортосундагы косинустук окшоштук менен эмпирикалык threshold аркылуу чыгарылган.
Негизги чечмелөө чеги: Изилдөө кеңири state-of-the-art мультимодалдык baseline салыштыруусун жүргүзбөйт. Натыйжалардын маанилүү бөлүгү FaceNet-only baseline менен көзөмөлдөнгөн салыштырууга негизделет, ал эми кеңири ablation, реалдуу дүйнөдө масштабдоо жана этикалык баалоо келечектеги иш катары калтырылган.
Verianla мазмун ыкмасы: Бул кыргызча текст булак PDFтин сүйлөммө-сүйлөм котормосу эмес. Изилдөөнүн маалымат топтомдору, жүз жана үн көрүнүштөрү, тармак архитектурасы, контрастивдик жоготуу, OOD босого механизми, окутуу протоколу, ROC/AUROC натыйжалары, масштаб талдоосу, эсептөө ыкмасы, этикалык билдирүүлөрү жана методологиялык чектөөлөрү сакталып, кыргыз тилинде өз алдынча илимий баяндоо түзүлгөн. Булакта жок натыйжалуулук, адам саны, клиникалык/коопсуздук натыйжасы же жайылтуу ийгилиги кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген