

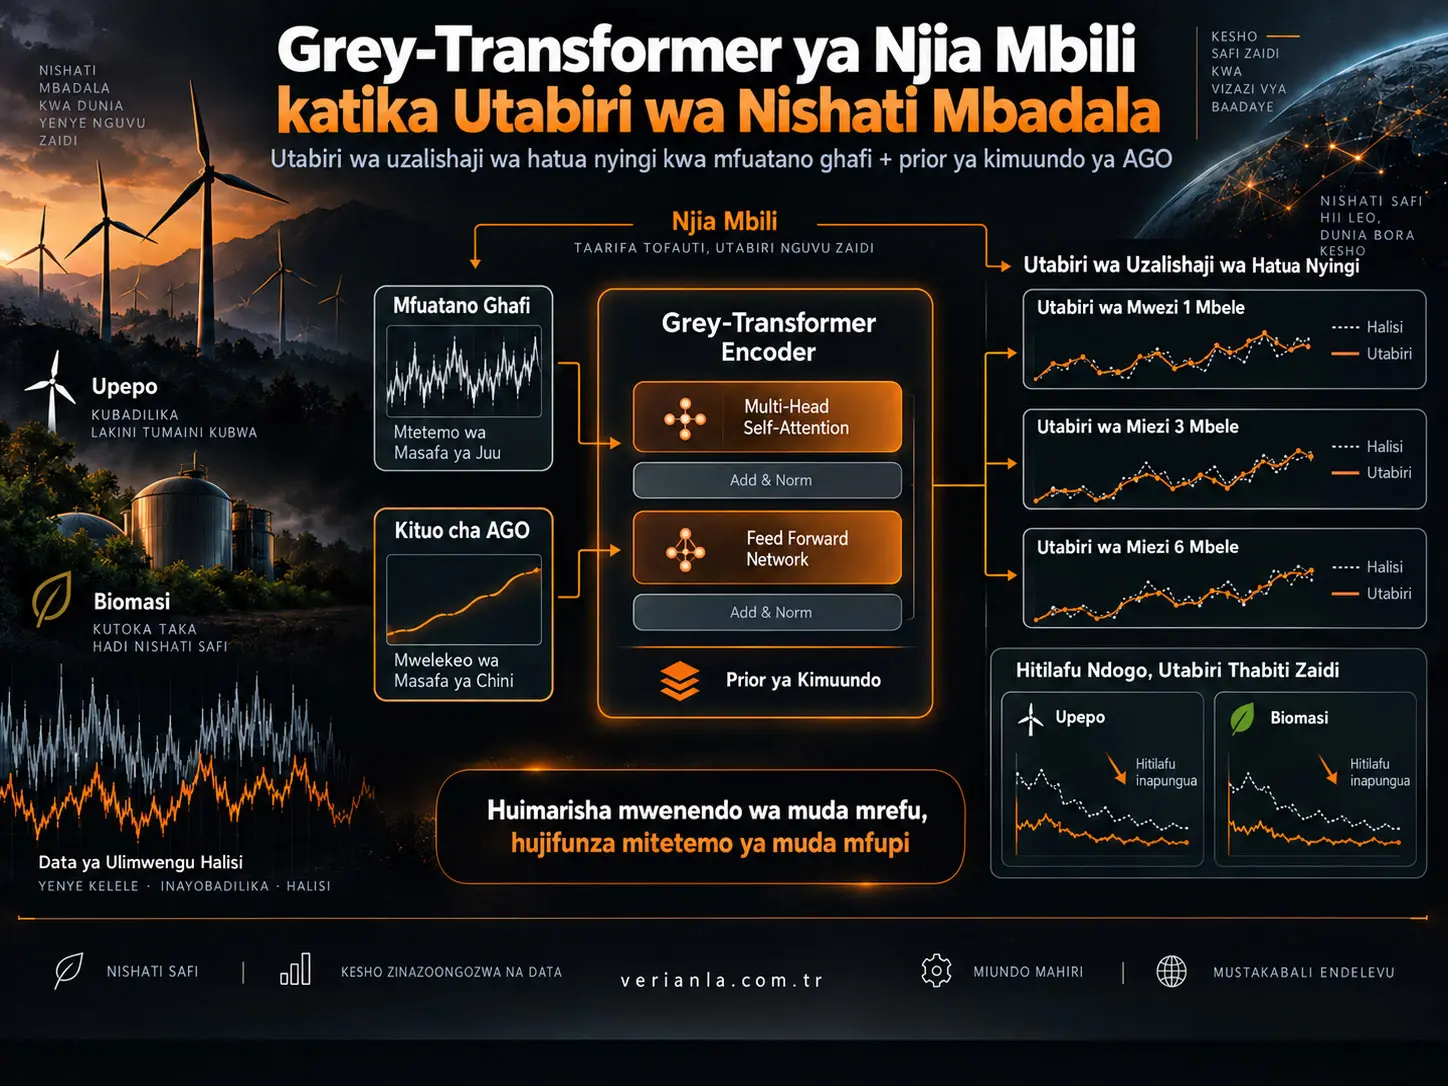
Uzalishaji wa nishati mbadala una mienendo ya muda mrefu pamoja na mabadiliko ya msimu na mabadiliko ya nasibu ya masafa ya juu. Ingawa modeli za kawaida za Transformer zinaweza kujifunza mahusiano katika vipindi virefu vya muda kupitia self-attention, zinapotegemea mfululizo ghafi wa muda pekee zinaweza kuzoea kupita kiasi thamani kali za eneo husika na kelele za muda mfupi. Hali hii, hasa katika utabiri wa miezi kadhaa mbele, inaweza kusababisha mkunjo wa utabiri kuondoka kwenye mwelekeo halisi wa muda mrefu.
Li Ye na wenzake wanapendekeza Grey-Transformer ya njia mbili inayounganisha Grey System Theory na usanifu wa Transformer ili kupunguza tatizo hili. Mfululizo uleule wa kihistoria wa uzalishaji wa nishati unaingia kwenye modeli kwa namna mbili. Njia ya Raw huhifadhi mitikisiko ya muda mfupi, huku njia ya Accumulated Generating Operation (AGO) ikikusanya kwa jumla thamani za zamani na kuunda rejeleo la mageuzi lililo laini zaidi na lenye masafa ya chini. Njia hizo mbili zinapotumiwa pamoja, Transformer inaweza kutathmini mabadiliko ya muda mfupi na pia mwelekeo wa muda mrefu ndani ya utaratibu uleule wa attention.
Katika majaribio yaliyofanywa kwenye data za kila mwezi za uzalishaji wa umeme wa biomasi na upepo nchini Marekani kwa 2001–2025, Grey-Transformer ilitoa thamani za chini za MAPE kuliko Transformer ya kawaida, Informer, Random Forest, SVR na modeli tatu za jadi za grey katika upeo wa utabiri wa mwezi 1, miezi 3 na miezi 6. Hata hivyo, utafiti unatumia mifululizo miwili tu ya muda yenye kigezo kimoja, hauna viingizo vya hali ya hewa na unatoa utabiri wa nukta wa kideterministiki. Matokeo yanaonyesha utendaji wa modeli kwenye mifululizo miwili iliyochunguzwa; hayathibitishi kuwa ubora huo huo utapatikana katika mifumo yote ya nishati mbadala.
Tatizo kuu katika utabiri wa nishati wa hatua nyingi ni nini?
Modeli ya mfululizo wa muda inapobashiri mwezi unaofuata pekee, kosa dogo la eneo linaweza kubaki na athari ndogo. Upeo wa utabiri unapopanuka hadi hatua kadhaa, modeli kujifunza vibaya mwelekeo wa jumla wa mfululizo kunaweza kuwa na matokeo makubwa zaidi.
Chanzo kinaeleza tatizo hili kwa dhana mbili:
- High-frequency noise overfitting: modeli kuweka uzito mkubwa kuliko inavyohitajika kwenye mabadiliko ya ghafla ya eneo husika.
- Trend drift: mkunjo wa utabiri wa mbele kuendelea kuondoka kwenye mwelekeo halisi wa mageuzi ya jumla ya mfululizo.
Self-attention ya kawaida hujifunza kutoka kwenye data ni nukta zipi za wakati wa nyuma zilizo muhimu. Lakini ikiwa hakuna rejeleo la kimuundo linalowakilisha wazi mwelekeo wa muda mrefu, vilele vikali vya eneo husika vinaweza kutawala uzito wa attention.
Accumulated Generating Operation (AGO) Hufanya Nini?
AGO ni ubadilishaji wa mfululizo unaotumiwa ndani ya Grey System Theory. AGO ya daraja la kwanza hujumlisha kwa mfuatano thamani za mfululizo asilia.
\[ x^{(1)}(k)=\sum_{j=1}^{k}x^{(0)}(j) \]
Hapa \(x^{(0)}\) inaonyesha mfululizo ghafi wa muda, na \(x^{(1)}\) inaonyesha mfululizo wa jumla wa daraja la kwanza.
Kwa kuwa mitikisiko chanya na hasi ya muda mfupi husawazishwa kwa kiasi ndani ya muundo wa jumla, mfululizo unaotokea huwa laini zaidi kuliko mfululizo ghafi. Chanzo kinafananisha tabia hii na athari ya kichujio cha low-pass.
Faida ya ubadilishaji huu ni kufanya mwelekeo wa muda mrefu uonekane. Hasara yake ni kwamba mchakato huo huo wa kulainisha hupunguza sehemu ya maelezo ya muda mfupi.
Kwa sababu hiyo, makala haitumii mfululizo wa AGO pekee kama kiingizo cha utabiri.
Kwa Nini Njia Mbili za Raw–AGO Zinatumika?
Muundo wa msingi wa Grey-Transformer ni kutumia kwa wakati mmoja mitazamo miwili ya mfululizo wa muda inayokamilishana pale ambapo mmoja una mapungufu.
| Njia | Maelezo yanayohifadhiwa | Jukumu kuu |
|---|---|---|
| Raw | Mabadiliko ya ghafla na mitikisiko ya muda mfupi | Kuwakilisha mabadiliko ya eneo yenye masafa ya juu |
| AGO | Muundo laini zaidi wa mageuzi ya muda mrefu | Kuunda rejeleo la kimuundo kwa Attention |
Dirisha ghafi la urefu \(L\) katika wakati fulani wa utabiri:
\[ \mathbf{x}^{(0)}_t= [x^{(0)}(t-L+1),\ldots,x^{(0)}(t)] \]
na dirisha la AGO la kipindi hicho hicho:
\[ \mathbf{x}^{(1)}_t= [x^{(1)}(t-L+1),\ldots,x^{(1)}(t)] \]
huchukuliwa.
Kisha mifululizo hiyo miwili huwekwa sambamba na kuunganishwa:
\[ Z_t=[\mathbf{x}^{(0)}_t,\mathbf{x}^{(1)}_t] \]
na hivyo kuunda matriki ya viingizo yenye vipengele viwili.
Nini Hutokea Ndani ya Grey-Transformer?
Baada ya njia mbili kuundwa, muundo hukaribia mantiki ya encoder ya kawaida ya Transformer.
Kwanza kiingizo huhamishwa kwa embedding ya mstari hadi nafasi ya uwakilishi yenye vipimo vya juu zaidi, na positional encoding huongezwa ili mpangilio wa muda usipotee:
\[ H^{(0)}=Z_tW_{emb}+P_{pos} \]
Kisha matriki za Query, Key na Value huundwa kwa kila attention head.
Scaled dot-product attention ya msingi:
\[ Attention(Q,K,V)= softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
hufanya kazi kwa namna hii.
Ubunifu unaopendekezwa na chanzo si kubadili kabisa mlinganyo wa attention. Ubunifu ni kwamba hesabu hii ya attention haioni tu mfululizo ghafi wenye kelele, bali pia huona kwa pamoja data ghafi na rejeleo la kimuundo la muda mrefu linalotengenezwa na AGO.
Usambazaji wa attention hubadilikaje?
Katika Kielelezo cha 3 cha chanzo, ramani ya attention ya Transformer ya kawaida inaonyesha mikanda iliyojikita kwenye vilele fulani vya eneo, ilhali katika Grey-Transformer uzito huonyeshwa kusambaa kwenye maeneo mapana zaidi ya kihistoria.
Tofauti hii pia hupimwa kwa attention entropy:
\[ H=-\sum_{i=1}^{W}\alpha_i\log \alpha_i \]
Hapa \(\alpha_i\) ni uzito wa attention wa hatua fulani ya muda wa nyuma.
Entropy ya juu zaidi inaonyesha kuwa attention imesambazwa kwa upana zaidi kwenye dirisha la kihistoria badala ya kujikita kupita kiasi kwenye nukta chache. Chanzo kinatafsiri attention entropy ya juu zaidi ya Grey-Transformer kama ushahidi unaounga mkono wazo kwamba mwenendo wa jumla unazingatiwa zaidi.
Je, Modeli Hutengeneza Utabiri kwa Mfuatano?
Kulingana na sehemu ya mbinu ya chanzo, hapana. Grey-Transformer hutumia direct multi-step forecasting.
Kutoka kwenye uwakilishi wa hatua ya mwisho ya muda ya encoder, malengo \(K\) ya baadaye hutolewa moja kwa moja kwa pamoja:
\[ \hat{\mathbf y}_t = [\hat y_{t+h_1}, \hat y_{t+h_2}, \ldots, \hat y_{t+h_K}] \]
Lengo la muundo huu ni kupunguza mnyororo wa makosa ya kimitambo katika recursive forecasting, ambapo utabiri wa kwanza huingizwa kwenye wa pili na wa pili huingizwa kwenye wa tatu.
Kauli “autoregressive extrapolation” iliyotumiwa katika sehemu ya matokeo ya chanzo hailingani na ufafanuzi huu wa mbinu; katika maelezo ya Verianla, ufafanuzi wazi wa kihisabati katika sehemu ya mbinu umechukuliwa kuwa msingi.
Mbinu na Matokeo ya Utafiti
Seti za data
| Sifa | Biomasi | Upepo |
|---|---|---|
| Nchi | Marekani | Marekani |
| Chanzo | U.S. Energy Information Administration | U.S. Energy Information Administration |
| Marudio | Kila mwezi | Kila mwezi |
| Kipindi | Januari 2001–Novemba 2025 | Januari 2001–Novemba 2025 |
| Uchunguzi | 299 | 299 |
| Kitengo | GWh | GWh |
Mgawanyo wa data
Uchunguzi 299 uligawanywa kwa mpangilio wa wakati:
- miezi 203 ya mafunzo,
- miezi 72 ya uthibitishaji,
- miezi 24 ya jaribio la mwisho.
Vigezo vya usawazishaji wa Z-score vilihesabiwa kutoka kwenye seti ya mafunzo pekee. Hivyo wastani na mkengeuko wa kawaida wa kipindi cha uthibitishaji au jaribio haukuvuja kwenye hatua ya mafunzo.
Dirisha linalosogea
Urefu wa dirisha la nyuma:
miezi 12, 18, 24, 36 au 48
ulichaguliwa kutoka kwa wagombea hao kwa kutumia seti ya uthibitishaji.
Upeo wa utabiri
Majukumu matatu tofauti yaliundwa:
- mwezi 1 mbele,
- miezi 3 mbele,
- miezi 6 mbele.
Rolling forecast evaluation ilitumika katika sehemu ya jaribio ya miezi 24.
Modeli zilizolinganishwa
| Paradigma | Modeli |
|---|---|
| Deep learning | Grey-Transformer, Transformer, Informer |
| Machine learning ya kawaida | SVR, Random Forest |
| Grey forecasting | GM(1,1), DGM(1,1), DGSM |
Matokeo ya uzalishaji wa biomasi
| Modeli | Mwezi 1 | Miezi 3 | Miezi 6 |
|---|---|---|---|
| Grey-Transformer | %6,34 | %7,75 | %7,51 |
| Transformer | %9,43 | %14,04 | %16,12 |
| Informer | %10,79 | %14,44 | %16,45 |
| Random Forest | %11,58 | %11,26 | %9,99 |
| GM(1,1) | %23,42 | %23,13 | %23,25 |
| SVR | %24,15 | %24,59 | %25,67 |
Katika Transformer ya kawaida, MAPE huongezeka kutoka %9,43 hadi %16,12 kadiri upeo wa utabiri unavyoongezeka, wakati Grey-Transformer hubaki katika safu ya %6,34–7,75.
Kielelezo cha 5 cha chanzo pia kinaonyesha kuwa utabiri wa Transformer ya kawaida na Informer huondoka juu kutoka kwenye mfululizo halisi katika upeo mrefu zaidi, huku mkunjo wa Grey-Transformer ukibaki ndani ya safu ya data halisi.
Matokeo ya uzalishaji wa upepo
| Modeli | Mwezi 1 | Miezi 3 | Miezi 6 |
|---|---|---|---|
| Grey-Transformer | %11,90 | %11,40 | %10,56 |
| Transformer | %13,84 | %15,14 | %16,14 |
| Informer | %14,42 | %14,49 | %16,46 |
| Random Forest | %12,77 | %14,36 | %13,04 |
| GM(1,1) | %60,74 | %69,54 | %81,37 |
| SVR | %30,56 | %28,86 | %25,26 |
Mfululizo wa upepo unaonekana kuwa mgumu hasa kwa modeli za jadi za grey. GM(1,1) na DGM(1,1) zilitoa MAPE ya %81,37 katika utabiri wa miezi sita. Matokeo haya yanaonyesha kuwa mwelekeo wa jumla wa masafa ya chini pekee hautoshi kuwakilisha uzalishaji wa upepo wenye kubadilika kwa kiwango kikubwa.
Utafiti wa ablation unaonyesha nini?
Chanzo huondoa vipengele viwili vikuu kimoja baada ya kingine.
AGO inapoondolewa: muundo hubadilika kuwa Transformer ya kawaida.
MAPE katika biomasi:
- %9,43 → %14,04 → %16,12
huongezeka pamoja na upeo wa utabiri.
Transformer inapoondolewa: muundo hupunguzwa kuwa modeli ya AGO pekee inayofanana na GM(1,1) ya jadi.
MAPE katika upepo:
- %60,74 → %69,54 → %81,37
hufikia viwango hivyo.
Grey-Transformer kamili katika majukumu hayo hayo ya upepo hutoa:
- %11,90 → %11,40 → %10,56
.
Waandishi wanatafsiri ulinganisho huu kama ushahidi wa majaribio wa ukamilishanaji wa vipengele viwili: AGO huimarisha mwelekeo wa muda mrefu, huku Transformer ikijenga upya mitikisiko ya eneo na isiyo ya mstari.
Umuhimu wa kitakwimu
Utafiti unatumia thamani za rolling-window APE za matokeo ya one-step-ahead kufanya jaribio la Nemenyi-based Multiple Comparisons with the Best katika kiwango cha umuhimu cha %5.
Grey-Transformer ilipata nafasi ya wastani ya chini zaidi katika mifululizo yote miwili ya nishati.
Hata hivyo, hasa katika jaribio la biomasi, kuingiliana kwa vipindi vya critical distance na Transformer ya kawaida na Informer kunamaanisha kwamba si tofauti zote kati ya modeli hizi za deep learning zina umuhimu wa kitakwimu katika kiwango cha one-step.
Kwa hiyo hitimisho sahihi ni:
Grey-Transformer ilipata nafasi bora zaidi ya wastani ya kosa na ilitofautiana kwa kiwango cha maana na benchmark nyingi.
Lakini:
Chanzo hakionyeshi hitimisho kwamba “ni bora kuliko modeli zote kwa umuhimu wa kitakwimu katika kila hali.”
Kutokulingana kwa RMSE ndani ya chanzo
Paragraphu ya maelezo kuhusu jaribio la hatua moja la upepo inatoa RMSE = 6095,5 kwa Grey-Transformer. Hata hivyo, Jedwali la 5 lina:
RMSE = 6905,5
.
Thamani ya nambari kwenye jedwali si sawa na maelezo ya maandishi. Verianla haichukui kimya kimya moja ya thamani hizi kuwa “sahihi.”
Kutokulingana kwa mbinu ya utabiri ndani ya chanzo
Sehemu ya metodolojia inaeleza wazi kwamba modeli huzalisha malengo ya baadaye moja kwa moja katika safu moja ya pato. Kwa hiyo mbinu ni direct multi-step forecasting.
Kauli “autoregressive extrapolation” iliyotumika katika sehemu ya matokeo hailingani kitaalamu na maelezo ya mbinu.
Hitimisho linaloungwa mkono na utafiti
Linaloungwa mkono na data ya chanzo: Grey-Transformer inayotumia kwa pamoja njia za Raw na AGO ilitoa thamani za chini za test MAPE kuliko benchmark zilizochaguliwa katika utabiri wa miezi 1, 3 na 6 kwenye mifululizo ya kila mwezi ya biomasi na upepo ya Marekani iliyochunguzwa. Matokeo ya ablation yanaonyesha kuwa kuondolewa kwa njia ya AGO kunahusishwa na kuongezeka kwa kosa, hasa katika upeo mrefu zaidi wa utabiri.
Hitimisho lisiloungwa mkono na utafiti
Kile ambacho chanzo hakijaonyesha: Haijaonyeshwa kuwa modeli itatoa utendaji uleule katika mashamba yote ya upepo, uzalishaji wa nishati ya jua, nchi tofauti au shughuli za soko la umeme la wakati halisi.
Utafiti haukufanya jaribio la udhibiti wa gridi ya wakati halisi, wala haukupima moja kwa moja uokoaji wa kiuchumi katika upangaji wa uzalishaji au kuboreka kwa uthabiti wa gridi.
Pia, kwa kuwa modeli haitumii kasi ya upepo, halijoto, mionzi ya jua, shinikizo au vigezo vingine vya hali ya hewa, haimodeli athari za hali ya hewa kwa kutenganisha.
Dokezo la Chanzo na Mbinu
Utafiti asilia: A dual-channel Grey-Transformer architecture with structural priors for renewable energy generation prediction.
Waandishi: Li Ye, Xinyu Song, Shuting Jin, Xiao Shen, Chunya Li, Tingting Yu.
Chanzo: SSRN preprint.
SSRN Abstract ID: 6904179.
DOI: 10.2139/ssrn.6904179.
Tarehe ya kuwasilishwa SSRN: 9 Juni 2026.
Idadi ya kurasa: 53.
Hali ya peer review: Preprint ambayo haijapitiwa na peer review. PDF ina kauli “Preprint not peer reviewed”.
Chanzo kikuu cha data: Mifululizo ya kila mwezi ya uzalishaji wa umeme wa biomasi na upepo kutoka U.S. Energy Information Administration.
Kipindi cha data: Januari 2001–Novemba 2025.
Idadi ya uchunguzi: 299 kwa kila mfululizo.
Mgawanyo wa data: uchunguzi 203 wa mafunzo, 72 wa uthibitishaji, 24 wa jaribio.
Upeo wa utabiri: mwezi 1, miezi 3 na miezi 6.
Mazingira ya programu: MATLAB R2024a, CPU-only platform.
Uboreshaji: Adam optimizer; kiwango cha juu 200 epoch; early stopping.
Vipimo vikuu vya tathmini: MAE, RMSE, APE, MAPE na sMAPE.
Modeli za kulinganisha: Transformer, Informer, SVR, Random Forest, GM(1,1), DGM(1,1), DGSM.
Jaribio la kitakwimu: Jaribio la Nemenyi-based Multiple Comparisons with the Best kwenye thamani za one-step rolling-window APE.
Kizuizi kikuu: Modeli ina kigezo kimoja na hutumia tu uzalishaji wa umeme wa zamani. Hakuna covariates za hali ya hewa.
Kizuizi cha pili kikuu: Modeli haitoi kipindi cha utabiri wa uwezekano bali utabiri wa nukta wa kideterministiki.
Kikomo cha uthibitishaji wa nje: Imejaribiwa kwenye mifululizo miwili tu ya kila mwezi ya nishati ya Marekani.
Dokezo la data ndani ya chanzo: Thamani ya RMSE ya Grey-Transformer ya hatua moja ya upepo imetolewa kama 6095,5 katika maelezo na 6905,5 katika Jedwali la 5.
Dokezo la mbinu ndani ya chanzo: Ingawa mbinu imefafanuliwa kama direct multi-step prediction, sehemu ya matokeo inatumia kauli autoregressive extrapolation.
Ufadhili: Utafiti uliungwa mkono na fedha mbalimbali, ikiwemo National Natural Science Foundation of China, Humanity and Social Science Youth Foundation of Ministry of Education, Hubei Provincial Natural Science Foundation, Hubei Education Department na Hubei Industrial Policy and Management Research Center.
Hakimiliki/leseni: Kwa kuwa hakuna leseni mahususi ya wazi ya Creative Commons kwa matumizi tena iliyothibitishwa katika chanzo kilichochunguzwa na rekodi ya SSRN inayopatikana, leseni ya wazi haijadhaniwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *