

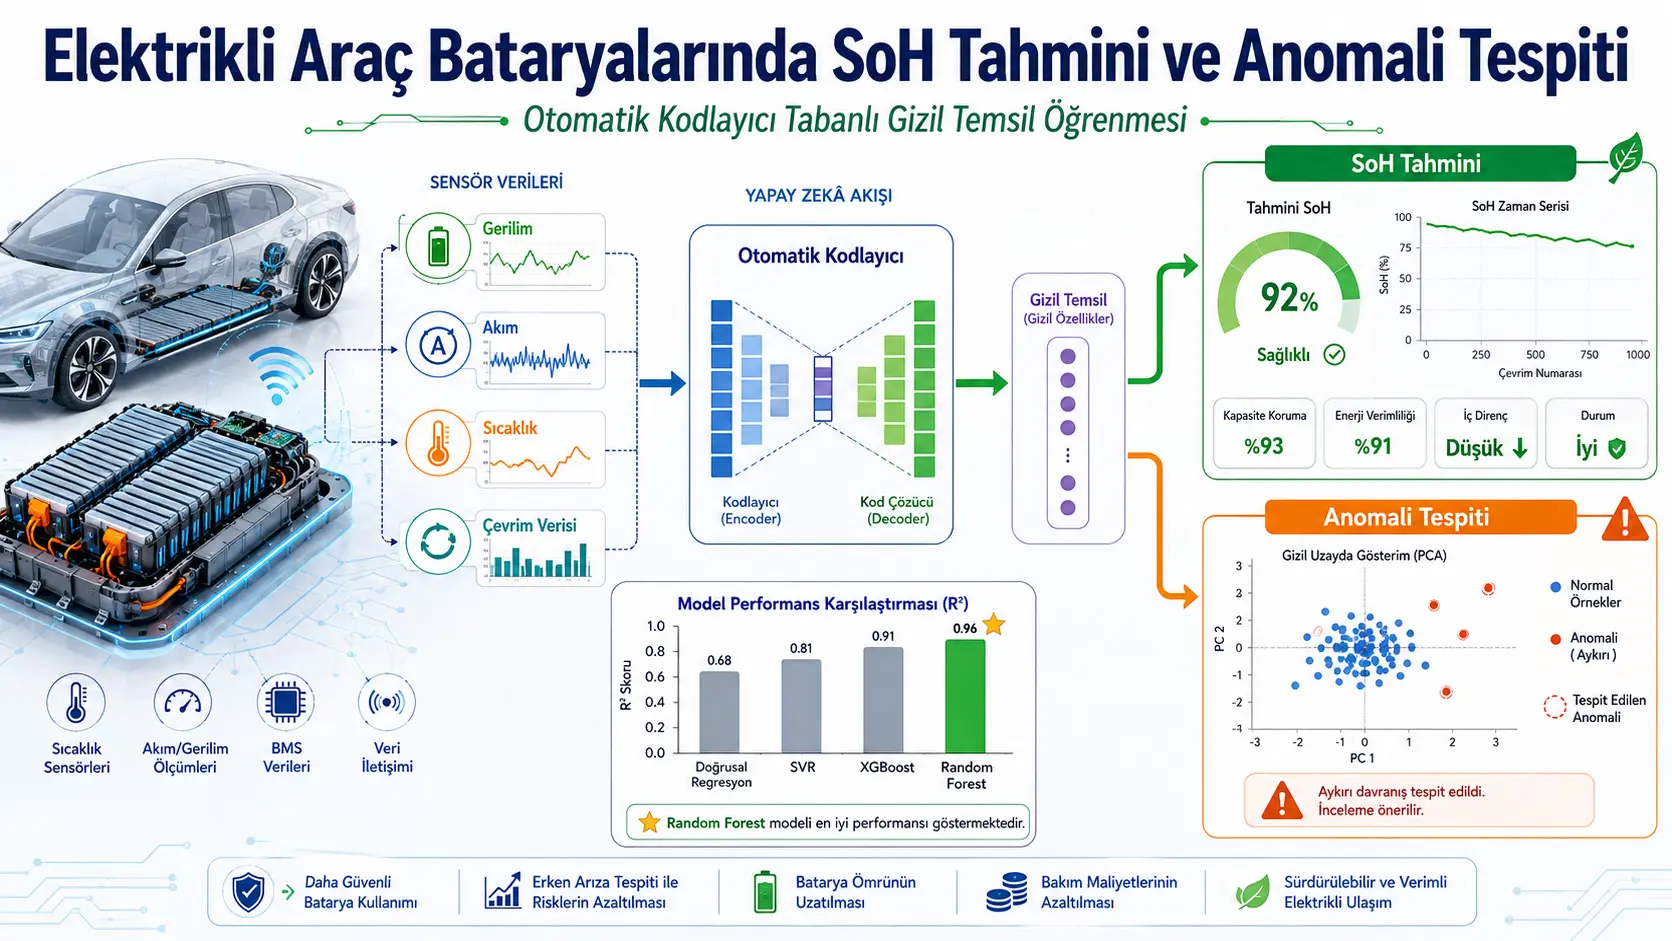
Utafiti huu unatengeneza mbinu mseto inayounganisha autoencoder na ujifunzaji wa mashine wa kawaida ili kukadiria hali ya afya ya betri za lithiamu-ioni (State of Health, SoH) na kubaini mifumo inayotofautiana na mwenendo wa kawaida wa kuzeeka. Ishara zenye vigezo vingi katika data za kuzeeka kwa betri za NASA B0005, B0006, B0007 na B0018 kwanza hubanwa na autoencoder kuwa uwakilishi fiche wa vipimo 64; vipengele hivi baadaye hutumiwa na modeli za Random Forest, linear regression, CNN-LSTM na GRU katika ukadiriaji wa SoH. Katika Jedwali 2 la chanzo, Random Forest inayotumia vipengele fiche inapata viwango vya chini zaidi vya hitilafu: MAE 0,0109, RMSE 0,0285 na R² 0,9693. Hata hivyo, matokeo haya yanahusu seti nne za data za betri za NASA; si jaribio la kundi halisi la magari ya umeme, mzunguko wa kuendesha wenye mienendo halisi au BMS ya uzalishaji iliyowekwa ndani ya gari.
Tawi la pili la mbinu linachunguza tabia zisizo za kawaida katika betri kwa mifumo miwili isiyosimamiwa badala ya kutumia klasifaya ya hitilafu yenye lebo. Reconstruction error, ambayo hupima jinsi autoencoder inavyoshindwa kujenga upya mzunguko, hutathminiwa kwa kizingiti cha three-sigma, huku Isolation Forest ikitenganisha pointi adimu au tofauti kimuundo katika nafasi ya vipengele fiche. Michoro ya PCA, t-SNE na UMAP pia inaonyesha jinsi uwakilishi fiche wenye vipimo vingi unavyokusanyika katika vipimo viwili na maeneo ambayo hitilafu kubwa za ujenzi upya hujitokeza. Hata hivyo, kwa kuwa utafiti haujatoa precision, recall, F1 au ROC-AUC dhidi ya ground-truth yenye lebo kwa ajili ya utambuzi wa anomali, haiwezi kuhitimishwa kwamba mfumo unatambua hitilafu halisi za betri kwa kiwango fulani cha usahihi.
Kwa mtazamo wa Türkiye: Utafiti haujumuishi data ya uwanjani kutoka kwa makundi ya magari ya umeme nchini Türkiye, hali za hewa za ndani, tabia za kuchaji kwa kasi au vifurushi halisi vya betri za magari. Kabla ya kuhamishwa kwenye matumizi ya BMS nchini Türkiye, uthibitishaji huru unahitajika kwa kemia tofauti za seli na wazalishaji, kutolingana kwa seli katika kiwango cha pakiti ya betri, halijoto za majira ya joto na baridi, kuchaji kwa kasi, mizunguko ya kazi ya mijini na safari ndefu pamoja na kelele za vihisio katika magari halisi. Hitilafu ndogo ya utabiri katika data za NASA haimaanishi kwamba usahihi uleule wa SoH umehakikishwa katika magari halisi nchini Türkiye.
Tatizo kuu la utafiti ni nini?
Kuzeeka kwa betri za lithiamu-ioni si mchakato wa mstari unaoendelea kwa kutegemea kigezo kimoja tu. Voltage, current, halijoto, capacity, historia ya matumizi na tabia ya mzunguko vinaweza kubadilika kwa pamoja. Kwa hiyo, kukadiria hali ya sasa ya afya ya betri kwa kutumia tu modeli rahisi ya curve fitting kunaweza kuwa vigumu.
Watafiti wanazingatia pengo kati ya mikabala miwili. Modeli za deep learning zinaweza kujifunza mifumo changamano na isiyo ya mstari, lakini gharama ya kompyuta na hitaji la urekebishaji vinaweza kuongezeka. Ujifunzaji wa mashine wa kawaida unaweza kuwa mwepesi zaidi, lakini mafanikio yake mara nyingi hutegemea vipengele vilivyobuniwa kwa mikono.
Suluhisho linalopendekezwa ni kuunganisha mikabala hii miwili badala ya kuitenganisha: autoencoder hujifunza vipengele vyake kutoka kwa ishara ghafi au zilizochakatwa awali za betri, huku Random Forest ikikadiria SoH kutoka kwenye uwakilishi huu uliobanwa.
Kwa nini autoencoder inatumika?
Autoencoder ina sehemu mbili kuu: encoder na decoder. Encoder hubadilisha ishara ya betri yenye vipimo vingi kuwa vekta fiche ndogo zaidi:
\[ z=f_{\theta}(x) \]
Decoder hujaribu kujenga upya ingizo la awali kutoka kwa vekta hii fiche:
\[ \hat{x}=g_{\phi}(z) \]
Mtandao unapofunzwa kwa kupunguza tofauti kati ya ingizo na pato lililojengwa upya, nafasi fiche inatarajiwa kubeba miundo muhimu iliyopo kwenye ingizo. Katika utafiti huu, ukubwa wa nafasi fiche umechaguliwa kuwa 64.
Waandishi wanafasiri uwakilishi huu fiche kama muhtasari unaotokana na data wa hali ya ndani ya afya ya betri ambayo haipimwi moja kwa moja. Michakato kama kupungua kwa capacity, kuongezeka kwa resistance na athari za joto inaweza kuacha alama katika mahusiano ya voltage, current na halijoto. Hata hivyo, haijathibitishwa kwa majaribio kwamba vigezo fiche vinafanana moja kwa moja na vigezo vya hali ya kimwili ya kielektrokemia.
Data ya ingizo inaandaliwaje?
Data ghafi huchakatwa kutoka kwenye rekodi za voltage, current, capacity, halijoto na wakati kwa msingi wa mzunguko. Ingizo zisizo sahihi au zinazokosekana husafishwa, vigezo hunormalishwa na mfululizo wa wakati hugawanywa katika madirisha yenye urefu thabiti yanayoingiliana.
Katika Sehemu ya 3.2, chanzo kinafafanua ingizo la dirisha kwa voltage \(V_c(t)\), current \(I_c(t)\) na capacity \(Q_c(t)\) kama ifuatavyo:
\[ x_{c,w}= [ v_c(t_{w,1}), i_c(t_{w,1}), Q_c(t_{w,1}), \ldots, v_c(t_{w,T}), i_c(t_{w,T}), Q_c(t_{w,T}) ]^T \in R^d \]
na:
\[ d=3T \]
inaelezwa.
Hata hivyo, maelezo ya seti ya data na sehemu ya autoencoder yanazungumzia voltage, current na halijoto. Kwa hiyo, hatua halisi ambayo vigezo vya capacity/halijoto vinatumika kwenye ingizo la encoder haijaelezwa kwa uthabiti kamili ndani ya chanzo.
Usanifishaji unafanywaje?
Wastani:
\[ \mu=\frac{1}{N}\sum_{i=1}^{N}x_i \]
na variance:
\[ \sigma^2= \frac{1}{N} \sum_{i=1}^{N} (x_i-\mu)^2 \]
baada ya kuhesabiwa, ingizo zinasanifishwa kwa:
\[ \hat{x}= \frac{x-\mu}{\sigma+\varepsilon} \]
ambapo \(\varepsilon\) ni konstanti ndogo inayotumika kuzuia kugawanya kwa sifuri.
Verianla Live: Kutoka ishara ya betri hadi tathmini ya SoH na anomali
Mchakato huu ni maelezo ya Kiswahili ya mbinu iliyotolewa katika Kielelezo 1 cha utafiti. Hakuna hatua mpya ya algoriti iliyoongezwa.
| Hatua | Kazi ya kisayansi | Chanzo |
|---|---|---|
| 1. Ishara za betri | Data za voltage, current, capacity/halijoto na wakati kwa msingi wa mzunguko hukusanywa. | Sehemu 2–3.2 |
| 2. Uchakataji wa awali | Rekodi zinazokosekana/zisizo sahihi husafishwa, vipengele hunormalishwa na mfululizo wa wakati hugawanywa katika madirisha yanayoingiliana. | Sehemu 3.1–3.2 |
| 3. Autoencoder | Encoder hubana ishara yenye vipimo vingi kuwa vekta fiche yenye vipimo 64; decoder hujaribu kujenga upya ingizo. | Sehemu 3.3 |
| 4. Uwakilishi wa mzunguko | Vekta fiche za kiwango cha dirisha hupelekwa kwenye kiwango cha mzunguko kwa muhtasari wa mean, median na percentiles. | Sehemu 3.4 |
| 5A. Ukadiriaji wa SoH | Vipengele fiche huingizwa katika modeli za LR, Random Forest, CNN-LSTM na GRU. | Sehemu 3.6 |
| 5B. Uchambuzi wa anomali | Reconstruction error na Isolation Forest hutumiwa kama viashiria viwili vinavyokamilishana vya anomali. | Sehemu 3.5 |
| 6. Ufafanuzi wa nafasi fiche | Uwakilishi uliojifunzwa huchunguzwa kwa PCA, t-SNE, UMAP na uchambuzi wa correlation. | Sehemu 4.3–4.4 |
Verianla Live: Jedwali hili ni uwakilishi wa maelezo wa mtiririko wa mbinu ya chanzo; JavaScript haitoi data mpya ya kisayansi.
Autoencoder inafunzwa kwa loss gani?
Katika utafiti, loss ya autoencoder inajumuisha regularization juu ya vigezo vya modeli na Jacobian ya encoder pamoja na hitilafu ya ujenzi upya:
\[ L(\theta,\phi)= \frac{1}{N} \sum_{i=1}^{N} \|x_i-\hat{x}_i\|^2 + \lambda_1\|\theta\|_2^2 + \lambda_2 \sum_{i=1}^{N} \|J_{f_\theta}(x_i)\|_F^2 \]
Hapa \(J_{f_\theta}(x)\) inawakilisha Jacobian ya encoder na \(\|\cdot\|_F\) inawakilisha Frobenius norm.
Chanzo pia kinaeleza kwamba denoising objective inaweza kutumika kwa kuongeza Gaussian noise. Lengo ni kufanya mtandao ujifunze uwakilishi ulio thabiti zaidi dhidi ya usumbufu mdogo wa vipimo badala ya kukariri tu ishara kamilifu.
Vipengele vya dirisha vinabadilishwaje kuwa kiwango cha mzunguko?
Kila mzunguko wa betri unaweza kuwa na madirisha mengi. Vekta fiche za \(Z_{c,w}\) zinazotolewa na encoder kwa kila dirisha huunganishwa katika kiwango cha mzunguko kwa:
\[ Z_c= [ \operatorname{mean}_w(Z_{c,w}), \operatorname{median}_w(Z_{c,w}), \operatorname{percentiles}_w(Z_{c,w}) ] \]
kwa kutumia takwimu za muhtasari. Hivyo vipimo kutoka nyakati tofauti za mzunguko mmoja hubadilishwa kuwa uwakilishi wa afya ulio kompakt zaidi.
Anomali inapatikanaje kwa reconstruction error?
Autoencoder iliyojifunza vizuri muundo wa kawaida inatarajiwa kujenga upya mzunguko wa kawaida wa betri kwa hitilafu ndogo. Chanzo kinafafanua hitilafu ya ujenzi upya katika kiwango cha sampuli kama:
\[ e(x)= \|x-g_{\phi}(f_{\theta}(x))\|_2^2 \]
na:
Hitilafu katika kiwango cha mzunguko:
\[ E(c)= \frac{1}{|W_c|} \sum_{w\in W_c} \|x_{c,w}-\hat{x}_{c,w}\|^2 \]
inahesabiwa.
Kisha:
\[ z_c= \frac{E(c)-\mu_e}{\sigma_e} \]
inasanifishwa na:
\[ |z_c|>k \]
hutumiwa kama hali ya kuashiria anomali. Katika utafiti \(k=3\) imechaguliwa; yaani, kwa kanuni ya three-sigma, mizunguko inayotoka kwa kiasi kikubwa kwenye usambazaji wa kawaida wa hitilafu ya ujenzi upya huwekewa alama.
Kwa nini Isolation Forest inatumika kama mbinu ya pili ya anomali?
Reconstruction error hutambua mizunguko ambayo autoencoder inapata ugumu kujenga upya ingizo. Isolation Forest huuliza swali tofauti: ni mizunguko ipi katika nafasi ya vipengele fiche iliyo tofauti kimuundo na mingine?
Algoriti hugawanya nafasi ya vipengele kwa nasibu na hutumia ukweli kwamba pointi zisizo za kawaida hutengwa kwa migawanyiko michache. Hivyo hata sampuli ambazo hazina reconstruction error kubwa lakini zina mchanganyiko usio wa kawaida wa vipengele fiche zinaweza kutambuliwa.
Utafiti unasema mbinu hizi mbili zinakamilishana; hata hivyo, hautoi kipimo cha usahihi dhidi ya data halisi yenye lebo za hitilafu. Kwa hiyo, “anomali” hapa si sawa moja kwa moja na hitilafu ya kimwili ya betri.
Ni modeli zipi za utabiri wa SoH zilizolinganishwa?
Modeli nne zilitumika:
- Linear Regression (LR): Modeli rahisi ya marejeo kwa uwezo wa utabiri wa mstari wa nafasi fiche.
- Random Forest (RF): Mbinu inayomodeli mahusiano yasiyo ya mstari kati ya vipengele fiche kwa mkusanyiko wa miti ya maamuzi.
- CNN-LSTM: Modeli ya kina iliyotumika kujifunza mahusiano ya kimuundo na mfuatano katika mizunguko/vipengele fiche.
- GRU: Mbinu inayomodeli utegemezi wa muda kwa muundo wa mtandao wa recurrent ulio kompakt zaidi.
Kwa Random Forest, majaribio manane yalifanywa kwa Optuna katika masafa ya miti 50–120 na kina cha juu 3–12. Muundo bora uliripotiwa kuwa miti 86 na kina cha juu 11, na cross-validation validation MAE ya takriban 0,00789 ilipatikana.
CNN-LSTM na GRU zilifunzwa kwa hidden units 64, batch size 64, Adam optimizer na learning rate ya \(10^{-3}\). Chanzo kinaeleza kuwa kila fold ilifunzwa kwa iterations tano tu. Kwa hiyo, tofauti ya utendaji kati ya modeli za kina na Random Forest iliyoboreshwa haipaswi kutafsiriwa kama mpangilio wa ubora wa jumla wa madarasa ya modeli.
Kwa nini Leave-One-Group-Out ni muhimu?
Katika Leave-One-Group-Out (LOGO) cross-validation, kundi fulani huondolewa kabisa kwenye mafunzo na modeli hutathminiwa kwenye kundi hilo ambalo halijawahi kuonekana. Utafiti unatumia mbinu hii kutathmini uimara wa generalization kati ya betri tofauti.
Mbinu hii ni muhimu kuliko mgawanyo wa kawaida wa sampuli kwa nasibu; inalenga kupunguza matumaini ya kupindukia yanayoweza kutokea endapo mizunguko inayofanana sana kutoka betri ileile ingekuwa katika pande zote mbili za training na test.
Ni modeli ipi ilitoa hitilafu ndogo zaidi ya utabiri?
Katika Jedwali 2 la chanzo, Random Forest ina MAE na RMSE ndogo zaidi kwa tofauti ya wazi. LR iko nafasi ya pili. Hitilafu za CNN na GRU ni kubwa zaidi na thamani za R² ni hasi.
R² hasi inamaanisha nini?
Katika Jedwali 2 la chanzo, R² ya CNN imeripotiwa kuwa −21,2515 na ya GRU −15,2340. R² hasi ni ishara kwamba, katika mpangilio huo wa test, utabiri wa modeli unaweza kuwa dhaifu hata kuliko kutumia wastani rahisi wa kigezo lengwa.
Hata hivyo, katika chanzo CNN na GRU zimetumika kwa usanifu wa kudumu na training yenye mipaka. Kwa hiyo, haiwezi kuhitimishwa kwa ujumla kutokana na matokeo hasi kwamba “CNN au GRU hazifai kwa ukadiriaji wa SoH wa betri”.
Je, nafasi fiche kweli hubeba taarifa yenye maana?
Utafiti unachunguza hili kwa njia kadhaa. PCA, t-SNE na UMAP hupunguza nafasi fiche ya vipimo 64 hadi vipimo viwili ili kuonyesha usambazaji wa kimuundo wa sampuli.
Katika mchoro wa PCA wa Kielelezo 6, pointi zimepakwa rangi kwa reconstruction error na maeneo yenye hitilafu kubwa yanaonekana kujikusanya katika makundi fulani ya ndani. Kielelezo 7 kinaonyesha muundo wa karibu kwa t-SNE, huku Kielelezo 8 kikionyesha muundo mpana zaidi wa nafasi fiche kwa UMAP.
Haya ni matokeo ya uwakilishi wa kuona; haijaonyeshwa kwa uthibitishaji wenye lebo kwamba makundi hayo yanawakilisha moja kwa moja aina fulani za hitilafu za kielektrokemia.
Je, kipengele fiche kinahusiana na vipimo vya kimwili?
Kielelezo 9 kinaonyesha matrix ya correlation kati ya dimension ya kwanza fiche na voltage, current na halijoto. Watafiti wanaripoti correlation chanya ya 0,766 kati ya kipengele cha kwanza fiche na voltage.
Katika mchoro, uhusiano wa Lat0–current unaonyeshwa takriban −0,18 na Lat0–halijoto takriban −0,38. Uchambuzi huu unaunga mkono kwamba nafasi fiche si msimbo wa nasibu kabisa na ina uhusiano wa kitakwimu na angalau baadhi ya ishara za kimwili zinazopimika. Correlation haimaanishi kwamba dimension fiche inapima moja kwa moja kigezo fulani cha kielektrokemia au kukiwakilisha kwa uhusiano wa sababu.
Ni nini kinachoonekana katika grafu za anomali?
Kielelezo 10 kinaonyesha kuwa reconstruction error kwa kila mzunguko iko katika viwango vya chini kwa sehemu kubwa, lakini kuna ongezeko kubwa katika baadhi ya indices. Histogram ya Kielelezo 11 pia inaonyesha kwamba usambazaji wa hitilafu umejikita sana katika thamani ndogo na sampuli chache zenye hitilafu kubwa huunda mkia mrefu.
Kielelezo 12 kinaonyesha matokeo ya Isolation Forest kama makundi mawili tofauti katika projection yenye vipimo vichache ya nafasi fiche. Taswira hii inaonyesha kuwa kuna utenganishaji wa kimuundo, lakini chanzo hakithibitishi ni pointi ipi inayolingana na utaratibu gani wa hitilafu ya kimwili.
Ulinganisho wa kitakwimu unasema nini?
Watafiti walilinganisha utendaji wa modeli kwa paired t-tests na wakaripoti \(p<0,001\) kwa ulinganisho wote wa RF–LR, RF–CNN na RF–GRU.
Matokeo haya yanaunga mkono kwamba, ndani ya fold na usanidi wa modeli za utafiti, tofauti za utendaji ni dhahiri kitakwimu. Hata hivyo, statistical significance haimaanishi kwamba familia zote za modeli zilizolinganishwa zilipewa kiwango sawa cha hyperparameter optimization.
Je, matumizi ya BMS ya wakati halisi yalijaribiwa kweli?
Kwa kiasi. Utafiti unatoa inference latency na idadi ya parameters kwa undani kwa CNN na GRU pekee:
| Modeli | Inference latency (s) | Idadi ya parameters (milioni) | Chanzo |
|---|---|---|---|
| CNN | 0,0042 | 0,033 | Kielelezo 14 / Sehemu 4.7 |
| GRU | 0,0008 | 0,025 | Kielelezo 14 / Sehemu 4.7 |
Ingawa Random Forest na linear regression zinaelezwa kuwa nyepesi na za haraka, hakuna latency ya namba au kipimo cha parameters/kumbukumbu kwa modeli hizi mbili katika jaribio hilo hilo. Zaidi ya hayo, mnyororo mzima wa autoencoder + Random Forest haujafanyiwa benchmark kwenye processor halisi ya BMS ya magari.
Ni nguvu zipi za utafiti?
- Kujifunza feature extraction kwa autoencoder badala ya kuitengeneza kwa mikono.
- Kuunganisha ukadiriaji wa SoH na uchambuzi wa anomali usiosimamiwa kwenye uwakilishi fiche uleule.
- Kutumia betri nne tofauti za NASA.
- Kutumia Leave-One-Group-Out cross-validation.
- Kuripoti MAE, RMSE, R² na %95 confidence intervals kwa pamoja.
- Kuonyesha uwakilishi fiche kwa PCA, t-SNE na UMAP.
- Kutoa uchambuzi wa correlation kati ya kipengele fiche na vigezo vya kimwili.
- Kutumia mbinu mbili tofauti za anomali: Reconstruction error na Isolation Forest.
Matokeo yanayoungwa mkono na utafiti
- Vipengele fiche vya autoencoder vya vipimo 64 vinabeba taarifa inayoweza kutumika kwa ukadiriaji wa SoH katika data za NASA zilizotumiwa kwenye chanzo.
- Katika protocol ya training ya chanzo, usanidi wa vipengele fiche + Random Forest ulitoa MAE na RMSE ndogo zaidi kati ya modeli zilizolinganishwa.
- R² ya juu ya Linear Regression pia inaunga mkono kuwepo kwa muundo wenye nguvu unaohusiana na SoH katika uwakilishi fiche.
- Reconstruction error inaweza kutenganisha baadhi ya mizunguko kwa kiasi kikubwa na muundo wa kawaida wa ujenzi upya.
- Isolation Forest inaweza kutumika kama mbinu ya pili isiyosimamiwa ya kubaini sampuli zisizo za kawaida katika nafasi ya vipengele fiche.
- Chanzo kinaripoti correlation ya 0,766 kati ya kipengele cha kwanza fiche na voltage iliyopimwa.
Matokeo ambayo utafiti hauungi mkono au haujajaribu
- Haionyeshi kwamba AE+RF itadumisha thamani zilezile za MAE/RMSE katika kundi halisi la magari ya umeme.
- Modeli haijathibitishwa kwenye kemia tofauti za betri na seli za wazalishaji tofauti.
- Halijoto chini ya sifuri, uendeshaji halisi wenye mienendo, kuchaji kwa kasi na kutolingana kwa seli katika kiwango cha pakiti halisi havijajaribiwa kwa kina.
- Haijathibitishwa kwamba kila pointi iliyoashiriwa na Reconstruction error au Isolation Forest ni hitilafu ya kimwili ya betri.
- Precision, recall, F1, specificity au ROC-AUC hazijatolewa kwa utambuzi wa anomali.
- Haijathibitishwa kwamba Random Forest ni bora kwa ujumla kuliko usanifu wote wa CNN, LSTM au GRU.
- End-to-end inference latency ya AE+RF haijapimwa kwenye hardware halisi ya BMS ya magari.
- Utafiti hauripoti kwa formula ya kimwili iliyo wazi na yenye maana moja jinsi thamani lengwa ya SoH ilivyotengenezwa.
- Haijathibitishwa kwamba vigezo fiche vinafanana moja kwa moja na vigezo mahususi vya hali ya kielektrokemia.
- Kwa kuwa hakuna matokeo ya namba ya Silhouette Score, ufanisi wa utenganishaji wa makundi hauwezi kutathminiwa quantitatively kwa kipimo hiki.
Mbinu na Matokeo ya Utafiti
Seti za data za betri za NASA zilizotumika
| Betri | Idadi ya mizunguko iliyoripotiwa kwenye chanzo | Jukumu |
|---|---|---|
| B0005 | 337 | Tathmini ya SoH na uwakilishi fiche |
| B0006 | 337 | Tathmini ya SoH na uwakilishi fiche |
| B0007 | 337 | Tathmini ya SoH na uwakilishi fiche |
| B0018 | 266 | Tathmini ya SoH na uwakilishi fiche |
Chanzo kinaona kuwa betri hizi nne zinaonyesha trajectories tofauti za degradation ndani ya mfumo mmoja wa majaribio na hilo ni muhimu kwa kupima uimara wa modeli kati ya betri.
Mipangilio ya autoencoder
| Kipengele | Muundo uliotolewa kwenye chanzo |
|---|---|
| Ukubwa wa nafasi fiche | 64 |
| Kazi kuu | Kubana na kujenga upya ingizo |
| Optimization | Adam |
| Udhibiti wa training | Early stopping kwa validation loss |
| Regularization | L2 parameter term + encoder Jacobian/Frobenius norm |
| Mbinu ya ziada ya uimara | Denoising objective kwa Gaussian noise inaweza kutumika |
Chanzo hakiripoti kikamilifu topology ya kina ya convolution layer-by-layer ya autoencoder. Muhtasari unatumia kauli “convolution neural network autoencoder”, huku sehemu ya mbinu ikitoa maelezo ya jumla zaidi ya kihisabati ya encoder–decoder.
Random Forest hyperparameter optimization
| Parameter | Search space / matokeo |
|---|---|
| Framework ya optimization | Optuna |
| Masafa ya idadi ya miti | 50–120 |
| Masafa ya kina cha juu | 3–12 |
| Idadi ya trials | 8 |
| Best n_estimators | 86 |
| Best max_depth | 11 |
| Validation MAE ya chini zaidi | Takriban 0,00789 |
Tahadhari ndani ya chanzo: Maelezo ya kinadharia ya Random Forest pia yanataja \(N=200\) miti. Katika mpangilio wa mwisho wa Optuna, miti 86 imeripotiwa; thamani hizi mbili zinatokea katika muktadha tofauti ndani ya chanzo.
Mipangilio ya training ya CNN-LSTM na GRU
| Parameter | Thamani |
|---|---|
| Hidden units | 64 |
| Batch size | 64 |
| Optimizer | Adam |
| Learning rate | 1 × 10⁻³ |
| Training kwa kila fold | 5 iterations |
| Pato | Ukadiriaji mmoja wa scalar wa SoH kwa kila mzunguko |
Jedwali kamili la utendaji wa modeli
| Modeli | MAE (%95 CI) | RMSE (%95 CI) | R² |
|---|---|---|---|
| RF | 0,0109 [0,0094–0,0124] | 0,0285 [0,0222–0,0336] | 0,9693 |
| LR | 0,0214 [0,0198–0,0230] | 0,0358 [0,0279–0,0423] | 0,9515 |
| CNN | 0,7410 [0,7299–0,7521] | 0,7669 [0,7577–0,7760] | −21,2515 |
| GRU | 0,6204 [0,6086–0,6323] | 0,6550 [0,6451–0,6649] | −15,2340 |
Ujumbe mkuu wa jedwali ni kwamba, katika masharti ya training na uthibitishaji wa LOGO yaliyotumiwa katika utafiti, RF na LR zilitoa hitilafu ndogo sana kuliko CNN/GRU. Hata hivyo, RF iliwekewa tuning maalum kwa Optuna, huku CNN na GRU zikitathminiwa kwa training yenye mipaka.
Umuhimu wa kitakwimu
Katika paired t-tests:
- RF – LR: \(p<0,001\)
- RF – CNN: \(p<0,001\)
- RF – GRU: \(p<0,001\)
zimeripotiwa. Thamani hizi zinaunga mkono kwamba, ndani ya matokeo ya fold yaliyotumiwa na utafiti, usambazaji wa hitilafu wa RF unatofautiana na wa modeli nyingine.
Vielelezo 2–5: Matokeo ya modeli yanaonyesha nini?
Kielelezo 2 kinalinganisha thamani halisi lengwa na utabiri wa RF, LR, CNN na GRU katika sample index ileile. Mstari wa RF uko karibu zaidi na thamani halisi, huku CNN na GRU zikionyesha tofauti kubwa.
Kielelezo 3 kinalinganisha modeli kwa pamoja kwa vipimo vya MAE, RMSE na R². Kwa sababu R² kubwa hasi za CNN na GRU zinaonyeshwa kwenye axis ileile, scale ya kuona hupunguza tofauti ndogo kati ya RF na LR.
Kielelezo 4 kinaonyesha katika boxplots za usambazaji wa hitilafu kwamba RF ina usambazaji mwembamba zaidi na ulio karibu na sifuri, huku CNN na GRU zikiwa na masafa mapana zaidi ya hitilafu.
Kielelezo 5 kinaonyesha wastani wa MAE na standard deviations za cross-validation; RF na LR zinaonekana kubaki katika eneo la hitilafu ndogo, huku CNN na GRU zikiwa katika eneo la hitilafu kubwa.
Vielelezo 6–9: Nafasi fiche inaeleza nini?
Kielelezo 6 kinaonyesha projection ya PCA ya uwakilishi wa vipimo 64 ikiwa imepakwa rangi kwa reconstruction error.
Kielelezo 7 kinaonyesha mgawanyiko wa normal/anomaly katika muundo wa ndani wa nafasi fiche kwa t-SNE.
Kielelezo 8 kinaonyesha muundo mpana zaidi na maeneo yenye reconstruction error kubwa katika projection ya UMAP.
Kielelezo 9 ni matrix ya correlation kati ya latent variable ya kwanza na ishara za kimwili. Maandishi yanasisitiza correlation ya voltage ya 0,766.
Vielelezo 10–12: Utambuzi wa anomali
Kielelezo 10 kinaonyesha mabadiliko ya reconstruction error kwa kila mzunguko kwa muda/index na baadhi ya spikes kubwa za hitilafu. Kielelezo 11 kinaonyesha kuwa histogram ya hitilafu imejikita sana katika eneo la MSE ndogo na ina thamani chache za hitilafu kubwa. Kielelezo 12 kinaonyesha pointi zilizotengwa na Isolation Forest katika uwakilishi fiche wenye vipimo vichache.
Vielelezo hivi vitatu vinaonyesha kwamba anomali zinaweza kubainishwa katika nafasi ya data; hata hivyo, kwa kuwa hakuna madarasa halisi ya hitilafu yenye lebo, usahihi wa utambuzi haujahesabiwa.
Kielelezo 14: Gharama ya kompyuta
Inference latency ya 4,2 ms imeripotiwa kwa CNN na 0,8 ms kwa GRU. GRU ina idadi ndogo ya parameters na latency ndogo zaidi. Kwa kuwa end-to-end latency ya AE+RF haipo kwenye jedwali hilo hilo, muda wa utekelezaji wa AE+RF katika kiwango cha millisecond hauwezi kuhesabiwa moja kwa moja kutoka matokeo haya.
Kielelezo 15: Ablation ya vipengele fiche
Axis ya x ya Kielelezo 15 inaonyesha index za vipimo 64 fiche, na axis ya y inaonyesha ongezeko la MAE wakati kipengele husika kinaondolewa au kubadilishwa. Baadhi ya dimensions fiche zinaonekana kuwa na athari kubwa zaidi kwa hitilafu ya utabiri kuliko nyingine.
Hata hivyo, maandishi ya sehemu yanasema kwamba “farklı latent sizes” zilijaribiwa, huku grafu ikionekana kuonyesha umuhimu wa dimensions binafsi fiche. Kwa hiyo, haipaswi kuhitimishwa kutoka utafiti kwamba encoder za 16, 32 au 64 dimensions zililinganishwa kwa utaratibu.
Vielelezo 16–17: Uchambuzi wa residual
Histogram za residual za Random Forest na Linear Regression zimejikita karibu na sifuri. Residual za CNN na GRU zinaonyesha usambazaji mpana wenye mwelekeo chanya.
Katika grafu za residual–prediction pia RF na LR zina usambazaji ulio finyu zaidi karibu na mstari wa sifuri, huku CNN na GRU zikionyesha miundo ya hitilafu iliyo wazi zaidi inayotegemea kiwango cha utabiri. Hii inaendana na thamani kubwa za hitilafu katika Jedwali 2 la chanzo.
Mapungufu makuu ya kimetodolojia ya utafiti
- Seti nne tu za data za betri za NASA zimetumika.
- Mizunguko ya kazi halisi ya magari imewakilishwa kwa kiwango kidogo.
- Hali za halijoto zinazobadilika, hasa kazi chini ya sifuri, hazijafunikwa kwa kina.
- CNN na GRU zimetathminiwa kwa muundo wa kudumu na training yenye mipaka.
- Ukubwa wa nafasi fiche 64 umechaguliwa kwa msingi wa majaribio.
- Kutofafanuliwa kwa label lengwa ya SoH kwa formula ya wazi ya kimwili katika chanzo ni pengo la kuripoti kwa reproducibility.
- Utambuzi wa anomali haujathibitishwa dhidi ya ground-truth yenye lebo za hitilafu kwa vipimo vya quantitative classification.
- End-to-end latency ya AE+RF kwenye processor ya BMS ya kiwango cha magari haijaripotiwa.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asilia: Autoencoder-Based Latent Representation Learning, SoH Estimation, and Anomaly Detection in Electric Vehicle Battery Energy Storage Systems
Waandishi na mpangilio wao: Nagendra Kumar; Anubhav Agrawal; Rajeev Kumar; Manoj Badoni.
Mchango sawa/mwandishi wa kwanza sawa: Haijaelezwa katika chanzo.
Mwandishi anayewasiliana: Rajeev Kumar.
Taasisi: Electrical and Electronics Engineering Department, GL Bajaj Institute of Technology & Management, Greater Noida, India; Department of Electronics and Communication Engineering, BML Munjal University, Gurgaon, India; Electrical and Electronics Engineering Department, Krishna Institute of Engineering & Technology (KIET), Delhi-NCR, Ghaziabad, India; Electrical and Instrumentation Engineering Department, Thapar Institute of Engineering & Technology, Patiala, India.
Jarida: Vehicles.
Mchapishaji: MDPI, Basel, Switzerland.
Taarifa ya uchapishaji: Vehicles 2026, 8, 81.
DOI: 10.3390/vehicles8040081.
Kiungo rasmi:https://doi.org/10.3390/vehicles8040081
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wataalamu; utafiti wa representation learning unaotegemea autoencoder, ulinganisho wa modeli za regression na uchambuzi wa anomali usiosimamiwa katika seti za data za kuzeeka kwa betri za lithiamu-ioni zinazopatikana kwa umma.
Hali ya peer review/uchapishaji: Chanzo kinaeleza kuwa makala ilipokelewa 28 Februari 2026, ikarekebishwa 30 Machi 2026, ikakubaliwa 2 Aprili 2026 na kuchapishwa 7 Aprili 2026.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti unaripoti kuwa haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeelezwa kuwa michango asilia ipo ndani ya utafiti na maswali ya ziada yanaweza kuelekezwa kwa mwandishi anayewasiliana.
Mgongano wa maslahi: Waandishi wameripoti kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Conceptualization, methodology na software N.K.; validation R.K. na M.B.; formal analysis A.A., R.K. na M.B.; investigation R.K.; resources A.A. na M.B.; data curation A.A.; rasimu ya kwanza N.K.; review na editing R.K.; visualization A.A., R.K. na M.B.; supervision na project management R.K.; funding acquisition R.K. kama ilivyoripotiwa.
Kikomo cha maudhui ya kisayansi: Seti ya data, fomula, mipangilio ya modeli, thamani za utendaji, mbinu ya anomali, takwimu, tafsiri za michoro na mapungufu katika maandishi haya ya Verianla yanategemea tu utafiti uliochunguzwa. Hakuna matokeo mapya ya utendaji wa betri au SoH yaliyoongezwa kutoka vyanzo vya nje.
Kikomo cha matumizi ya gari la umeme: Kichwa na lengo la utafiti vinalenga mifumo ya kuhifadhi nishati ya betri za magari ya umeme; hata hivyo, uthibitishaji wa modeli ulifanywa kwa data za kuzeeka za NASA B0005, B0006, B0007 na B0018 badala ya kundi halisi la uzalishaji la magari ya umeme au BMS ya ndani ya gari.
Maelezo kuhusu kuripoti kigezo cha ingizo: Maelezo ya seti ya data na maandishi ya autoencoder yanasisitiza ishara za voltage, current na halijoto, huku vekta ya kihisabati ya ingizo katika Sehemu 3.2 ikitumia voltage, current na capacity. Tofauti hii ya ndani ya chanzo haijawasilishwa kama data iliyosawazishwa.
Maelezo kuhusu label ya SoH: Ingawa lengo la utabiri linaitwa SoH katika sehemu ya mbinu iliyochunguzwa, hakuna formula wazi na yenye maana moja ya label lengwa inayoeleza ubadilishaji kutoka capacity hadi SoH. Kwa hiyo, thamani za MAE na RMSE hazijaitwa upya moja kwa moja kuwa “hitilafu ya pointi za asilimia za SoH”.
Maelezo kuhusu parameter za Random Forest: Sehemu 3.6.2 katika maelezo ya jumla ya RF inatumia kauli ya N=200 decision trees. Katika Optuna optimization, modeli bora imeripotiwa kuwa n_estimators=86 na max_depth=11. Kwa kuwa namba hizi mbili zinapatikana katika muktadha tofauti ndani ya chanzo, hazijaunganishwa kimyakimya.
Maelezo kuhusu R²: Muhtasari unatoa R² ya takriban 0,96, Jedwali 2 lina 0,9693, huku sehemu ya matokeo ikiandika thamani kwa typo kama “099”. Katika ulinganisho wa namba, 0,9693 kutoka Jedwali 2 imetumika.
Maelezo kuhusu PCA/PSA: Muhtasari unaandika moja ya uchambuzi wa nafasi fiche kama “PSA”; sehemu ya matokeo na mbinu ya Kielelezo 6 inaonyesha PCA. Katika maandishi haya ya Verianla, grafu halisi katika sehemu ya matokeo inaitwa PCA na uandishi wa muhtasari umehifadhiwa katika maelezo haya.
Maelezo kuhusu Silhouette Score: Muhtasari unasema utendaji wa clustering ulipimwa kwa Silhouette Score; hata hivyo, hakuna matokeo ya namba ya Silhouette Score katika sehemu za mbinu na matokeo zilizochunguzwa. Hakuna thamani isiyopatikana kwenye chanzo iliyobuniwa.
Kikomo cha uthibitishaji wa anomali: Anomali za Reconstruction error na Isolation Forest zimechunguzwa kwa kuona; hata hivyo, sensitivity, specificity, precision, recall, F1 au ROC-AUC hazijaripotiwa dhidi ya madarasa halisi ya anomali yenye lebo.
Kikomo cha ulinganisho wa modeli: Random Forest ilifanyiwa Optuna hyperparameter optimization, huku CNN na GRU zikitathminiwa kwa usanifu wa kudumu na iterations tano kwa kila fold. Kwa hiyo, matokeo ya utafiti yanaunga mkono ulinganisho ndani ya protocol hiyo ya majaribio; si uthibitisho wa ubora wa jumla dhidi ya usanifu wote wa deep learning.
Kikomo cha wakati halisi: Numerical inference latency imetolewa kwa CNN na GRU, lakini hakuna kipimo cha numerical latency kinacholinganishwa kwa RF/LR na mnyororo mzima wa AE+RF. Hakuna end-to-end field test kwenye BMS halisi ya kiwango cha magari.
Maelezo kuhusu Kielelezo 15: Maandishi ya sehemu yanasema kuwa thamani tofauti za latent dimensionality zilijaribiwa, huku axes za kielelezo zikionyesha ongezeko la MAE dhidi ya indices za dimensions binafsi fiche. Sehemu hii ya ablation protocol haijaelezwa kwa maana moja kabisa ndani ya chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *