

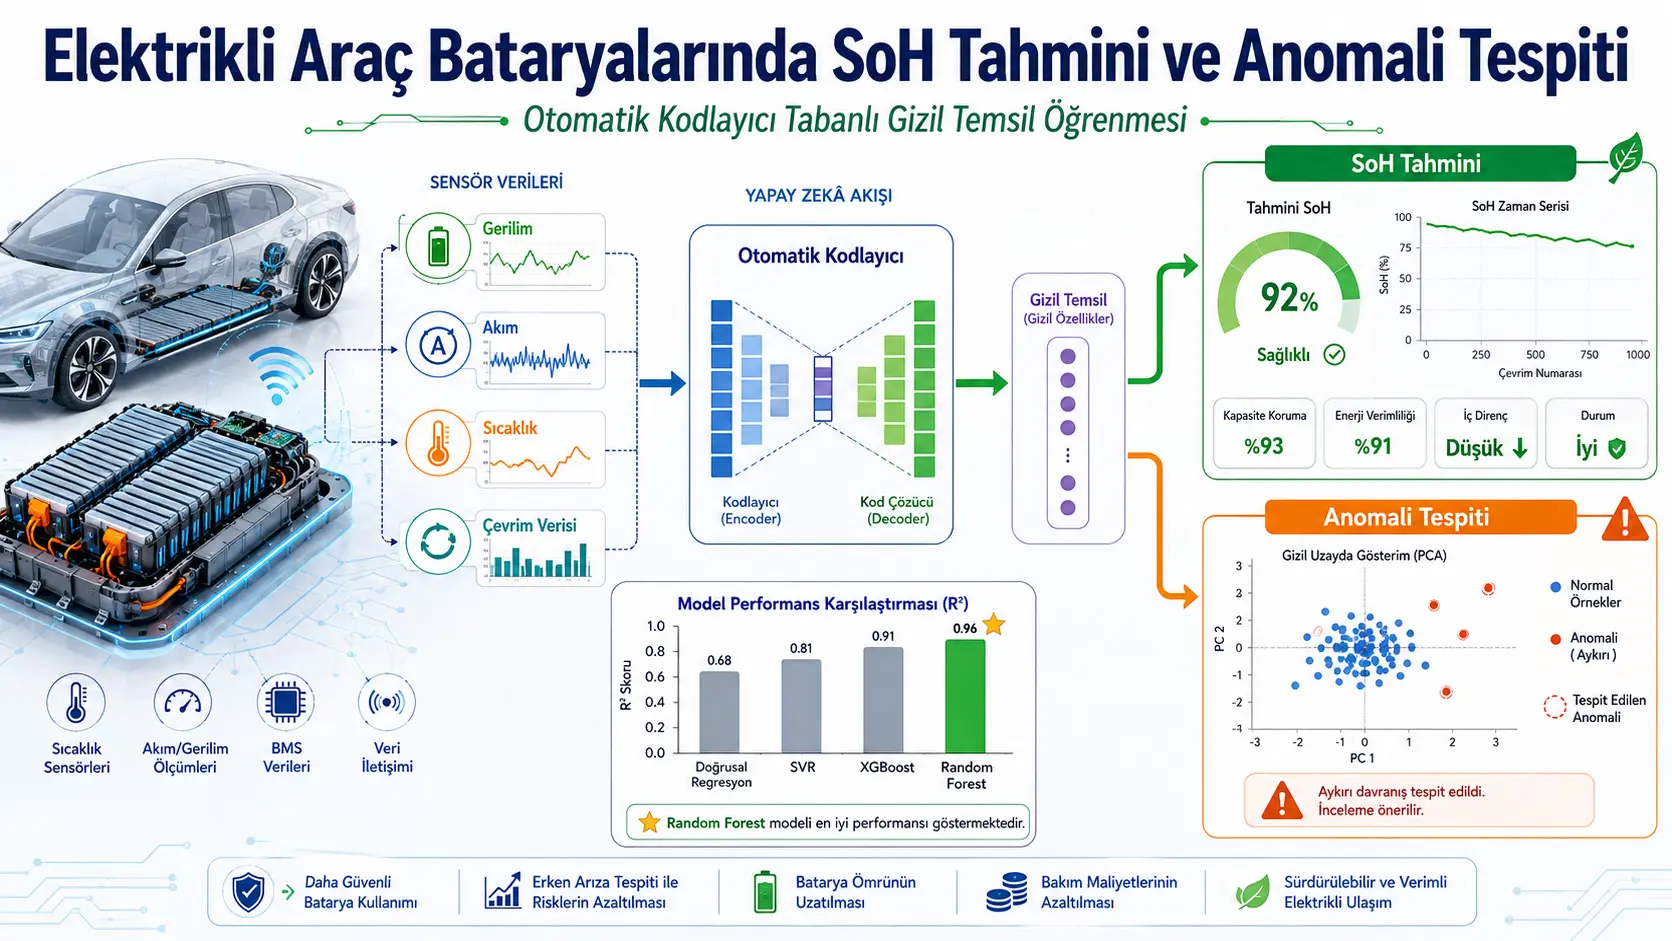
Bu araştırma, lityum-iyon bataryaların sağlık durumunu (State of Health, SoH) tahmin etmek ve normal yaşlanma davranışından ayrılan örüntüleri belirlemek için otomatik kodlayıcı ile klasik makine öğrenmesini birleştiren hibrit bir yaklaşım geliştiriyor. NASA'nın B0005, B0006, B0007 ve B0018 batarya yaşlanma verilerindeki çok değişkenli sinyaller önce bir otomatik kodlayıcı tarafından 64 boyutlu gizil temsile sıkıştırılıyor; bu özellikler daha sonra Random Forest, doğrusal regresyon, CNN-LSTM ve GRU modellerinin SoH tahmininde kullanılıyor. Kaynak Tablo 2'de gizil özelliklerle çalışan Random Forest en düşük hata değerlerini elde ediyor: MAE 0,0109, RMSE 0,0285 ve R² 0,9693. Bununla birlikte bu sonuçlar dört NASA batarya veri kümesine aittir; gerçek elektrikli araç filosu, dinamik sürüş çevrimi veya araç üstü üretim BMS testi değildir.
Yöntemin ikinci kolu bataryadaki alışılmadık davranışları etiketli bir arıza sınıflandırıcısı yerine iki gözetimsiz mekanizmayla araştırıyor. Otomatik kodlayıcının bir çevrimi ne kadar kötü yeniden oluşturduğunu ölçen reconstruction error üç-sigma eşiğiyle değerlendirilirken, Isolation Forest gizil özellik uzayındaki nadir veya yapısal olarak farklı noktaları ayırıyor. PCA, t-SNE ve UMAP görselleri de yüksek boyutlu gizil temsilin iki boyutta nasıl kümelendiğini ve yüksek yeniden oluşturma hatalarının hangi bölgelerde ortaya çıktığını göstermektedir. Ancak çalışmada anomali tespiti için etiketli ground-truth üzerinden precision, recall, F1 veya ROC-AUC verilmediğinden, sistemin gerçek batarya arızalarını belirli bir doğruluk oranıyla teşhis ettiği sonucuna varılamaz.
Türkiye açısından: Çalışma Türkiye'deki elektrikli araç filoları, yerel iklim koşulları, hızlı şarj alışkanlıkları veya gerçek araç batarya paketlerinden elde edilmiş saha verisi içermemektedir. Türkiye'de bir BMS uygulamasına taşınmadan önce farklı hücre kimyaları ve üreticileri, batarya paketi düzeyi hücre dengesizlikleri, yaz-kış sıcaklıkları, hızlı şarj, şehir içi ve uzun yol görev çevrimleri ile gerçek araç sensör gürültüsü üzerinde bağımsız doğrulama gerekir. NASA verilerindeki düşük tahmin hatası, Türkiye'deki gerçek araçlarda aynı SoH doğruluğunun garanti edildiği anlamına gelmez.
Araştırmanın temel problemi nedir?
Lityum-iyon bataryaların yaşlanması tek bir değişkenle ilerleyen doğrusal bir süreç değildir. Gerilim, akım, sıcaklık, kapasite, kullanım geçmişi ve çevrim davranışı birlikte değişebilir. Bu nedenle bir bataryanın mevcut sağlık durumunu yalnız basit bir eğri uydurma modeliyle tahmin etmek güçleşebilir.
Araştırmacılar iki yaklaşım arasındaki boşluğa odaklanmaktadır. Derin öğrenme modelleri karmaşık ve doğrusal olmayan örüntüleri öğrenebilir ancak hesaplama maliyeti ve ayarlama gereksinimi yükselebilir. Geleneksel makine öğrenmesi daha hafif olabilir ancak başarısı çoğu zaman elle tasarlanmış özelliklere bağlıdır.
Önerilen çözüm, bu iki yaklaşımı ayırmak yerine birleştirmektir: otomatik kodlayıcı ham veya ön işlenmiş batarya sinyallerinden kendi özelliklerini öğrenirken Random Forest bu sıkıştırılmış temsilden SoH tahmini yapar.
Otomatik kodlayıcı neden kullanılıyor?
Otomatik kodlayıcı iki temel bölümden oluşur: encoder ve decoder. Encoder yüksek boyutlu batarya sinyalini daha küçük bir gizil vektöre dönüştürür:
\[ z=f_{\theta}(x) \]
Decoder ise bu gizil vektörden özgün girdiyi yeniden oluşturmaya çalışır:
\[ \hat{x}=g_{\phi}(z) \]
Ağ, giriş ile yeniden oluşturulan çıkış arasındaki farkı küçülterek eğitildiğinde, gizil uzayın girdideki önemli düzenlilikleri taşıması beklenir. Çalışmada gizil boyut 64 olarak seçilmiştir.
Yazarlar bu gizil temsili bataryanın doğrudan ölçülmeyen iç sağlık durumunun veri tabanlı bir özeti olarak yorumlamaktadır. Kapasite azalması, direnç büyümesi ve termal etkiler gibi süreçlerin gerilim, akım ve sıcaklık ilişkilerinde iz bırakabileceği düşünülmektedir. Bununla birlikte gizil değişkenlerin elektrokimyasal fiziksel durum değişkenleriyle bire bir eşdeğer olduğu deneysel olarak kanıtlanmamıştır.
Girdi verisi nasıl hazırlanıyor?
Ham veriler çevrim bazındaki gerilim, akım, kapasite, sıcaklık ve zaman kayıtlarından işlenmektedir. Geçersiz veya eksik girdiler temizlenmekte, değişkenler normalize edilmekte ve zaman serileri sabit uzunluklu üst üste binen pencerelere ayrılmaktadır.
Kaynak Bölüm 3.2'de pencere girdisini gerilim \(V_c(t)\), akım \(I_c(t)\) ve kapasite \(Q_c(t)\) üzerinden şu biçimde tanımlar:
\[ x_{c,w}= [ v_c(t_{w,1}), i_c(t_{w,1}), Q_c(t_{w,1}), \ldots, v_c(t_{w,T}), i_c(t_{w,T}), Q_c(t_{w,T}) ]^T \in R^d \]
ve:
\[ d=3T \]
olarak verir.
Ancak veri kümesi açıklamasında ve otomatik kodlayıcı bölümünde gerilim, akım ve sıcaklık üçlüsü anlatılmaktadır. Dolayısıyla kapasite/sıcaklık değişkenlerinin encoder girdisinde tam olarak hangi aşamada kullanıldığı kaynak içinde tamamen tutarlı biçimde açıklanmamıştır.
Standardizasyon nasıl yapılıyor?
Ortalama:
\[ \mu=\frac{1}{N}\sum_{i=1}^{N}x_i \]
ve varyans:
\[ \sigma^2= \frac{1}{N} \sum_{i=1}^{N} (x_i-\mu)^2 \]
hesaplandıktan sonra girdiler:
\[ \hat{x}= \frac{x-\mu}{\sigma+\varepsilon} \]
ifadesiyle standartlaştırılmaktadır. \(\varepsilon\), sıfıra bölünmeyi önlemek için kullanılan küçük sabittir.
Verianla Live: Batarya sinyalinden SoH ve anomali değerlendirmesine
Bu süreç çalışmanın Şekil 1'de verdiği yöntemin Türkçeleştirilmiş açıklamasıdır. Yeni bir algoritma aşaması eklenmemiştir.
| Aşama | Bilimsel işlev | Kaynak |
|---|---|---|
| 1. Batarya sinyalleri | Çevrim bazındaki gerilim, akım, kapasite/sıcaklık ve zaman verileri alınır. | Bölüm 2–3.2 |
| 2. Ön işleme | Eksik/geçersiz kayıtlar temizlenir, özellikler normalize edilir ve zaman serileri üst üste binen pencerelere ayrılır. | Bölüm 3.1–3.2 |
| 3. Otomatik kodlayıcı | Encoder yüksek boyutlu sinyali 64 boyutlu gizil vektöre sıkıştırır; decoder girdiyi yeniden oluşturmaya çalışır. | Bölüm 3.3 |
| 4. Çevrim temsili | Pencere düzeyindeki gizil vektörler ortalama, medyan ve yüzdelik özetlerle çevrim düzeyine taşınır. | Bölüm 3.4 |
| 5A. SoH tahmini | Gizil özellikler LR, Random Forest, CNN-LSTM ve GRU modellerine verilir. | Bölüm 3.6 |
| 5B. Anomali analizi | Reconstruction error ve Isolation Forest birbirini tamamlayan iki anomali göstergesi olarak kullanılır. | Bölüm 3.5 |
| 6. Gizil uzay yorumlama | PCA, t-SNE, UMAP ve korelasyon analiziyle öğrenilen temsil incelenir. | Bölüm 4.3–4.4 |
Verianla Live: Bu tablo kaynak yöntem akışının açıklayıcı temsilidir; JavaScript bilimsel veri üretmez.
Otomatik kodlayıcı hangi kayıpla eğitiliyor?
Çalışmada otomatik kodlayıcı kaybı yeniden oluşturma hatasına ek olarak model parametreleri ve encoder Jacobian'ı üzerinde düzenlileştirme içermektedir:
\[ L(\theta,\phi)= \frac{1}{N} \sum_{i=1}^{N} \|x_i-\hat{x}_i\|^2 + \lambda_1\|\theta\|_2^2 + \lambda_2 \sum_{i=1}^{N} \|J_{f_\theta}(x_i)\|_F^2 \]
Burada \(J_{f_\theta}(x)\) encoder'ın Jacobian'ını, \(\|\cdot\|_F\) Frobenius normunu temsil eder.
Kaynak ayrıca Gaussian gürültüsü eklenerek denoising amacı uygulanabileceğini belirtmektedir. Bunun amacı ağın yalnız kusursuz sinyali ezberlemek yerine küçük ölçüm bozulmalarına karşı daha kararlı bir temsil öğrenmesidir.
Pencere özellikleri çevrim seviyesine nasıl dönüştürülüyor?
Her batarya çevriminde çok sayıda pencere bulunabilir. Encoder tarafından her pencereye üretilen \(Z_{c,w}\) gizil vektörleri çevrim seviyesinde:
\[ Z_c= [ \operatorname{mean}_w(Z_{c,w}), \operatorname{median}_w(Z_{c,w}), \operatorname{percentiles}_w(Z_{c,w}) ] \]
biçimindeki özet istatistiklerle birleştirilmektedir. Böylece tek bir çevrimin farklı anlarındaki ölçümler daha kompakt bir sağlık temsiline dönüştürülür.
Reconstruction error ile anomali nasıl bulunuyor?
Normal örüntüyü iyi öğrenen bir otomatik kodlayıcının alışılmış bir batarya çevrimini düşük hatayla yeniden oluşturması beklenir. Kaynak örnek düzeyindeki yeniden oluşturma hatasını:
\[ e(x)= \|x-g_{\phi}(f_{\theta}(x))\|_2^2 \]
şeklinde tanımlar.
Çevrim seviyesindeki hata:
\[ E(c)= \frac{1}{|W_c|} \sum_{w\in W_c} \|x_{c,w}-\hat{x}_{c,w}\|^2 \]
olarak hesaplanır.
Daha sonra:
\[ z_c= \frac{E(c)-\mu_e}{\sigma_e} \]
ile standartlaştırılır ve:
\[ |z_c|>k \]
koşulu anomali işareti olarak kullanılır. Araştırmada \(k=3\) seçilmiştir; yani üç-sigma kuralına göre normal yeniden oluşturma hata dağılımından güçlü biçimde uzaklaşan çevrimler işaretlenmektedir.
Isolation Forest neden ikinci bir anomali yöntemi olarak kullanılıyor?
Reconstruction error, otomatik kodlayıcının girdiyi yeniden üretmekte zorlandığı çevrimleri belirler. Isolation Forest ise farklı bir soru sorar: gizil özellik uzayında hangi çevrimler diğerlerinden yapısal olarak izoledir?
Algoritma özellik uzayını rastgele bölerek sıra dışı noktaların daha az bölmeyle izole edilmesinden yararlanır. Böylece yeniden oluşturma hatası yüksek olmayan ancak gizil özellik kombinasyonu bakımından sıra dışı olan örnekler de potansiyel olarak belirlenebilir.
Çalışma iki yöntemin tamamlayıcı olduğunu savunmaktadır; ancak etiketli gerçek arıza verisine karşı doğruluk ölçütü vermemektedir. Bu nedenle “anomali” burada doğrudan fiziksel batarya arızasıyla eş anlamlı değildir.
SoH için hangi tahmin modelleri karşılaştırıldı?
Dört model kullanılmıştır:
- Linear Regression (LR): Gizil uzayın doğrusal tahmin gücü için basit referans model.
- Random Forest (RF): Gizil özellikler arasındaki doğrusal olmayan ilişkileri karar ağaçları topluluğuyla modelleyen yöntem.
- CNN-LSTM: Çevrim/gizil özellikler üzerindeki yapısal ve sıralı ilişkileri öğrenmek amacıyla kullanılan derin model.
- GRU: Zaman bağımlılıklarını daha kompakt tekrarlayan ağ yapısıyla modelleyen yöntem.
Random Forest için Optuna ile 50–120 ağaç ve 3–12 maksimum derinlik aralığında sekiz deneme yapılmıştır. En iyi yapı 86 ağaç ve maksimum derinlik 11 olarak raporlanmış ve çapraz doğrulama doğrulama MAE'si yaklaşık 0,00789 bulunmuştur.
CNN-LSTM ve GRU ise 64 gizli birim, 64 batch boyutu, Adam optimizasyonu ve \(10^{-3}\) öğrenme oranıyla eğitilmiştir. Kaynak her fold'un yalnız beş iterasyon eğitildiğini belirtmektedir. Bu nedenle derin modeller ile optimize edilmiş Random Forest arasındaki performans farkı model sınıflarının mutlak üstünlük sıralaması olarak yorumlanmamalıdır.
Leave-One-Group-Out neden önemli?
Leave-One-Group-Out (LOGO) çapraz doğrulamada belirli bir grup eğitimden tamamen dışarıda bırakılır ve model bu görülmemiş grupta değerlendirilir. Çalışma bu yaklaşımı farklı bataryalar arasında genelleme sağlamlığı değerlendirmesi için kullanmaktadır.
Bu yaklaşım sıradan rastgele örnek bölünmesine kıyasla önemlidir; aynı bataryanın birbirine çok benzeyen çevrimlerinin hem eğitim hem test tarafında bulunmasından kaynaklanabilecek iyimserliği azaltmayı amaçlar.
Hangi model en düşük tahmin hatasını verdi?
Kaynak Tablo 2'de Random Forest belirgin biçimde en düşük MAE ve RMSE'ye sahiptir. LR ikinci sıradadır. CNN ve GRU'nun hata değerleri çok daha yüksektir ve R² değerleri negatiftir.
Negatif R² ne anlama geliyor?
Kaynak Tablo 2'de CNN için R² −21,2515 ve GRU için −15,2340 olarak raporlanmıştır. Negatif R², ilgili test düzeninde modelin tahminlerinin hedef değişkenin basit ortalamasını kullanmaya kıyasla dahi zayıf kalabildiğini gösteren bir işarettir.
Ancak kaynakta CNN ve GRU yalnız sabit mimari ve sınırlı eğitimle çalıştırılmıştır. Bu nedenle negatif sonuçlardan “CNN veya GRU batarya SoH tahminine uygun değildir” biçiminde genel bir sonuç çıkarılamaz.
Gizil uzay gerçekten anlamlı bilgi taşıyor mu?
Çalışma bunu birkaç farklı yolla incelemektedir. PCA, t-SNE ve UMAP, 64 boyutlu gizil uzayı iki boyuta indirerek örneklerin yapısal dağılımını görselleştirmektedir.
Şekil 6'daki PCA grafiğinde noktalar reconstruction error ile renklendirilmiştir ve yüksek hatalı bölgelerin belirli lokal kümelerde yoğunlaştığı görülmektedir. Şekil 7 t-SNE ile yerel yapıyı, Şekil 8 ise UMAP üzerinden daha küresel gizil uzay yapısını göstermektedir.
Bunlar görsel temsil bulgularıdır; kümelerin doğrudan belirli elektrokimyasal arıza türlerini temsil ettiği etiketli doğrulamayla gösterilmemiştir.
Gizil özellik fiziksel ölçümlerle ilişkili mi?
Şekil 9'da ilk gizil boyut ile gerilim, akım ve sıcaklık arasındaki korelasyon matrisi verilmiştir. Araştırmacılar ilk gizil özellik ile gerilim arasında 0,766 pozitif korelasyon raporlamaktadır.
Şekilde yaklaşık olarak Lat0–akım ilişkisi −0,18 ve Lat0–sıcaklık ilişkisi −0,38 düzeyinde gösterilmektedir. Bu analiz gizil uzayın tamamen rastgele bir kod olmadığını ve en azından bazı ölçülebilir fiziksel sinyallerle istatistiksel ilişki taşıdığını destekler. Korelasyon, gizil boyutun doğrudan belirli bir elektrokimyasal değişkeni ölçtüğü veya nedensel olarak onu temsil ettiği anlamına gelmez.
Anomali grafiklerinde ne görülüyor?
Şekil 10 çevrim başına reconstruction error değerlerinin büyük bölümünün düşük seviyelerde olduğunu ancak belirli indekslerde güçlü yükselmeler ortaya çıktığını göstermektedir. Şekil 11'in histogramı da hata dağılımının büyük ölçüde düşük değerlerde yoğunlaştığını ve az sayıdaki yüksek hata örneğinin uzun bir kuyruk oluşturduğunu göstermektedir.
Şekil 12, Isolation Forest sonuçlarını gizil uzayın düşük boyutlu projeksiyonunda iki farklı grup olarak gösterir. Bu görsel yapısal ayrışmanın bulunduğunu gösterse de hangi noktanın hangi fiziksel arıza mekanizmasına karşılık geldiği kaynakta doğrulanmamaktadır.
İstatistiksel karşılaştırma ne söylüyor?
Araştırmacılar model performanslarını eşleştirilmiş t-testleriyle karşılaştırmış ve RF–LR, RF–CNN ve RF–GRU karşılaştırmalarının tamamı için \(p<0,001\) raporlamıştır.
Bu sonuç çalışmanın kendi fold ve model yapılandırmaları içinde performans farklarının istatistiksel olarak belirgin olduğunu destekler. Ancak istatistiksel anlamlılık, karşılaştırılan bütün model ailelerinin aynı düzeyde hiperparametre optimizasyonuna tabi tutulduğu anlamına gelmez.
Gerçek zamanlı BMS kullanımı gerçekten test edildi mi?
Kısmen. Çalışmada yalnız CNN ve GRU için ayrıntılı inference gecikmesi ve parametre sayısı verilmiştir:
| Model | Çıkarım gecikmesi (s) | Parametre sayısı (milyon) | Kaynak |
|---|---|---|---|
| CNN | 0,0042 | 0,033 | Şekil 14 / Bölüm 4.7 |
| GRU | 0,0008 | 0,025 | Şekil 14 / Bölüm 4.7 |
Random Forest ve doğrusal regresyonun hafif ve hızlı olduğu ifade edilse de bu iki model için aynı deneyde sayısal latency veya parametre/bellek ölçümü verilmemektedir. Ayrıca otomatik kodlayıcı + Random Forest zincirinin tamamı gerçek bir otomotiv BMS işlemcisinde benchmark edilmemiştir.
Çalışmanın güçlü yönleri nelerdir?
- Özellik çıkarımını elle tasarlamak yerine otomatik kodlayıcıyla öğrenmesi.
- SoH tahmini ile gözetimsiz anomali analizini aynı gizil temsil üzerinde birleştirmesi.
- Dört ayrı NASA bataryası kullanması.
- Leave-One-Group-Out çapraz doğrulama uygulaması.
- MAE, RMSE, R² ve %95 güven aralıklarını birlikte raporlaması.
- PCA, t-SNE ve UMAP ile gizil temsili görselleştirmesi.
- Gizil özellik ile fiziksel değişkenler arasında korelasyon analizi sunması.
- Reconstruction error ve Isolation Forest olmak üzere iki farklı anomali yaklaşımı kullanması.
Çalışmanın desteklediği sonuçlar
- 64 boyutlu otomatik kodlayıcı gizil özellikleri, kaynakta kullanılan NASA verilerinde SoH tahmini için kullanılabilir bilgi taşımaktadır.
- Kaynakta kullanılan eğitim protokolünde gizil özellik + Random Forest yapılandırması karşılaştırılan modeller arasında en düşük MAE ve RMSE'yi sağlamıştır.
- Linear Regression'ın da yüksek R² elde etmesi, gizil temsilde SoH ile ilişkili güçlü bir yapı bulunduğunu desteklemektedir.
- Reconstruction error, bazı çevrimleri normal yeniden oluşturma örüntüsünden güçlü biçimde ayırabilmektedir.
- Isolation Forest gizil özellik uzayındaki sıra dışı örneklerin belirlenmesinde ikinci bir gözetimsiz yöntem olarak kullanılabilmektedir.
- İlk gizil özellik ile ölçülen gerilim arasında kaynakta 0,766 korelasyon raporlanmıştır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- AE+RF'nin gerçek elektrikli araç filosunda aynı MAE/RMSE değerlerini koruyacağını göstermemektedir.
- Model farklı batarya kimyaları ve farklı üreticilerin hücrelerinde doğrulanmamıştır.
- Sıfır altı sıcaklık, dinamik gerçek sürüş, hızlı şarj ve gerçek paket düzeyi hücre dengesizlikleri kapsamlı biçimde test edilmemiştir.
- Reconstruction error veya Isolation Forest tarafından işaretlenen her noktanın gerçek fiziksel batarya arızası olduğu kanıtlanmamıştır.
- Anomali tespiti için precision, recall, F1, specificity veya ROC-AUC sunulmamıştır.
- Random Forest'ın bütün CNN, LSTM veya GRU mimarilerinden genel olarak üstün olduğu kanıtlanmamıştır.
- AE+RF'nin uçtan uca çıkarım gecikmesi gerçek otomotiv BMS donanımında ölçülmemiştir.
- Çalışma SoH hedef değerinin nasıl üretildiğini ayrıntılı ve tek anlamlı bir fiziksel denklemle raporlamamaktadır.
- Gizil değişkenlerin belirli elektrokimyasal durum değişkenleriyle bire bir eşleştiği kanıtlanmamıştır.
- Silhouette Score için sayısal bir sonuç sunulmadığından küme ayırma başarımı bu ölçüt üzerinden nicel olarak değerlendirilemez.
Çalışmanın Yöntemi ve Bulguları
Kullanılan NASA batarya veri kümeleri
| Batarya | Kaynakta raporlanan çevrim sayısı | Rol |
|---|---|---|
| B0005 | 337 | SoH ve gizil temsil değerlendirmesi |
| B0006 | 337 | SoH ve gizil temsil değerlendirmesi |
| B0007 | 337 | SoH ve gizil temsil değerlendirmesi |
| B0018 | 266 | SoH ve gizil temsil değerlendirmesi |
Kaynak, bu dört bataryanın aynı deneysel çerçeve altında farklı bozulma yörüngeleri göstermesini modelin bataryalar arası sağlamlığını sınamak için yararlı görmektedir.
Otomatik kodlayıcı ayarları
| Öğe | Kaynakta verilen yapı |
|---|---|
| Gizil boyut | 64 |
| Temel görev | Girdiyi sıkıştırma ve yeniden oluşturma |
| Optimizasyon | Adam |
| Eğitim kontrolü | Validation loss üzerinde early stopping |
| Düzenlileştirme | L2 parametre terimi + encoder Jacobian/Frobenius normu |
| Ek sağlamlık yaklaşımı | Gaussian gürültüsüyle denoising objective uygulanabilir |
Kaynak, otomatik kodlayıcının ayrıntılı katman-katman convolution topolojisini tam olarak raporlamamaktadır. Özet “convolution neural network autoencoder” ifadesini kullanırken yöntem bölümü daha genel encoder–decoder matematiksel tanımı vermektedir.
Random Forest hiperparametre optimizasyonu
| Parametre | Arama alanı / sonuç |
|---|---|
| Optimizasyon çerçevesi | Optuna |
| Ağaç sayısı aralığı | 50–120 |
| Maksimum derinlik aralığı | 3–12 |
| Deneme sayısı | 8 |
| En iyi n_estimators | 86 |
| En iyi max_depth | 11 |
| En düşük doğrulama MAE | Yaklaşık 0,00789 |
Kaynak içi dikkat: Random Forest'ın teorik açıklamasında \(N=200\) ağaç ifadesi de bulunmaktadır. Nihai Optuna ayarında ise 86 ağaç raporlanmıştır; iki değer kaynakta ayrı bağlamlarda geçmektedir.
CNN-LSTM ve GRU eğitim ayarları
| Parametre | Değer |
|---|---|
| Gizli birim | 64 |
| Batch boyutu | 64 |
| Optimizer | Adam |
| Öğrenme oranı | 1 × 10⁻³ |
| Fold başına eğitim | 5 iterasyon |
| Çıkış | Çevrim başına tek skaler SoH tahmini |
Tam model performans tablosu
| Model | MAE (%95 GA) | RMSE (%95 GA) | R² |
|---|---|---|---|
| RF | 0,0109 [0,0094–0,0124] | 0,0285 [0,0222–0,0336] | 0,9693 |
| LR | 0,0214 [0,0198–0,0230] | 0,0358 [0,0279–0,0423] | 0,9515 |
| CNN | 0,7410 [0,7299–0,7521] | 0,7669 [0,7577–0,7760] | −21,2515 |
| GRU | 0,6204 [0,6086–0,6323] | 0,6550 [0,6451–0,6649] | −15,2340 |
Tablonun ana mesajı, araştırmanın kendi eğitim ve LOGO doğrulama koşullarında RF ve LR'nin CNN/GRU'dan çok daha düşük hata üretmesidir. Bununla birlikte RF özel olarak Optuna ile ayarlanmış, CNN ve GRU ise sınırlı eğitim altında değerlendirilmiştir.
İstatistiksel anlamlılık
Eşleştirilmiş t-testlerinde:
- RF – LR: \(p<0,001\)
- RF – CNN: \(p<0,001\)
- RF – GRU: \(p<0,001\)
raporlanmıştır. Bu değerler çalışmanın kullandığı fold sonuçları içinde RF hata dağılımının diğer modellerden farklı olduğunu desteklemektedir.
Şekil 2–5: Model sonuçları ne gösteriyor?
Şekil 2 gerçek hedef değerler ile RF, LR, CNN ve GRU tahminlerini aynı örnek indeksinde karşılaştırmaktadır. RF eğrisi gerçek değerlere en yakın yapıdayken CNN ve GRU geniş sapmalar göstermektedir.
Şekil 3 modellerin MAE, RMSE ve R² ölçütlerini toplu olarak karşılaştırır. CNN ve GRU'nun büyük negatif R² değerleri aynı eksende gösterildiği için görsel ölçek RF ve LR arasındaki küçük farkları bastırmaktadır.
Şekil 4 hata dağılımı boxplotlarında RF'nin en dar ve sıfıra yakın hata dağılımını gösterdiğini; CNN ve GRU'nun daha geniş hata aralıklarına sahip olduğunu göstermektedir.
Şekil 5 çapraz doğrulama ortalama MAE ve standart sapmalarını sunar; RF ve LR'nin düşük, CNN ve GRU'nun yüksek hata bölgesinde kaldığı görülmektedir.
Şekil 6–9: Gizil uzay ne anlatıyor?
Şekil 6 64 boyutlu temsilin PCA izdüşümünü reconstruction error ile renklendirerek sunmaktadır.
Şekil 7 t-SNE'nin yerel gizil yapıdaki normal/anomali ayrımını görselleştirmektedir.
Şekil 8 UMAP izdüşümünde küresel yapıyı ve yüksek reconstruction error bölgelerini göstermektedir.
Şekil 9 ilk gizil değişken ile fiziksel sinyaller arasındaki korelasyon matrisidir. Metinde gerilim korelasyonu 0,766 olarak vurgulanmaktadır.
Şekil 10–12: Anomali tespiti
Şekil 10 çevrim bazında yeniden oluşturma hatasının zaman/indeks boyunca değişimini ve bazı yüksek hata sıçramalarını gösterir. Şekil 11 hata histogramının düşük MSE bölgesinde güçlü yoğunlaşma ve az sayıda yüksek hata değeri içerdiğini gösterir. Şekil 12 Isolation Forest tarafından ayrılan noktaları düşük boyutlu gizil temsil üzerinde sunmaktadır.
Bu üç görsel anomalilerin veri uzayında belirlenebildiğini gösterir; ancak etiketli gerçek arıza sınıfları bulunmadığından algılama doğruluğu hesaplanmamıştır.
Şekil 14: Hesaplama maliyeti
CNN için 4,2 ms, GRU için 0,8 ms çıkarım gecikmesi raporlanmıştır. GRU hem daha küçük parametre sayısına hem de daha düşük gecikmeye sahiptir. AE+RF'nin tam uçtan uca gecikmesi aynı tabloda bulunmadığı için bu sonuçtan doğrudan AE+RF'nin milisaniye düzeyindeki çalışma süresi hesaplanamaz.
Şekil 15: Gizil özellik ablasyonu
Şekil 15'in x ekseni 64 gizil boyut indeksini, y ekseni ise ilgili özellik kaldırıldığında veya değiştirildiğinde MAE artışını göstermektedir. Bazı gizil boyutların tahmin hatası üzerinde diğerlerinden daha büyük etkiye sahip olduğu görülmektedir.
Bununla birlikte bölüm metni “farklı latent sizes” test edildiğini söylerken grafik bireysel latent boyutların önemini gösteriyor görünümündedir. Bu nedenle çalışmadan 16, 32 veya 64 boyutlu encoderların sistematik biçimde karşılaştırıldığı sonucu çıkarılmamalıdır.
Şekil 16–17: Artık analizi
Random Forest ve Linear Regression artık histogramları sıfıra yakın yoğunlaşmaktadır. CNN ve GRU artıklarında ise geniş, pozitif ağırlıklı dağılım görünmektedir.
Residual–prediction grafiklerinde de RF ve LR sıfır çizgisinin çevresinde daha sınırlı dağılım gösterirken CNN ve GRU'da tahmin seviyesine bağlı daha belirgin hata yapıları bulunmaktadır. Bu, kaynak Tablo 2'deki yüksek hata değerleriyle tutarlıdır.
Araştırmanın temel metodolojik sınırlılıkları
- Yalnız dört NASA batarya veri kümesi kullanılmıştır.
- Gerçek araç görev çevrimleri sınırlı temsil edilmektedir.
- Değişken sıcaklık koşulları ve özellikle sıfır altı çalışma kapsamlı değildir.
- CNN ve GRU sabit yapı ve sınırlı eğitimle değerlendirilmiştir.
- Gizil boyut 64 ampirik olarak seçilmiştir.
- SoH hedef etiketinin kaynakta açık bir fiziksel formülle tanımlanmaması yeniden üretilebilirlik açısından bir raporlama boşluğudur.
- Anomali tespiti etiketli arıza ground-truth'u üzerinde nicel sınıflandırma ölçütleriyle doğrulanmamıştır.
- AE+RF'nin otomotiv sınıfı BMS işlemcisi üzerinde uçtan uca gecikmesi raporlanmamıştır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Autoencoder-Based Latent Representation Learning, SoH Estimation, and Anomaly Detection in Electric Vehicle Battery Energy Storage Systems
Yazarlar ve sıraları: Nagendra Kumar; Anubhav Agrawal; Rajeev Kumar; Manoj Badoni.
Eş katkı/eş birinci yazar: Kaynakta belirtilmemiştir.
Sorumlu yazar: Rajeev Kumar.
Kurumlar: Electrical and Electronics Engineering Department, GL Bajaj Institute of Technology & Management, Greater Noida, India; Department of Electronics and Communication Engineering, BML Munjal University, Gurgaon, India; Electrical and Electronics Engineering Department, Krishna Institute of Engineering & Technology (KIET), Delhi-NCR, Ghaziabad, India; Electrical and Instrumentation Engineering Department, Thapar Institute of Engineering & Technology, Patiala, India.
Dergi: Vehicles.
Yayınevi: MDPI, Basel, Switzerland.
Yayın bilgisi: Vehicles 2026, 8, 81.
DOI: 10.3390/vehicles8040081.
Resmî bağlantı:https://doi.org/10.3390/vehicles8040081
Kaynak türü: Hakemli araştırma makalesi; kamuya açık lityum-iyon batarya yaşlanma veri kümeleri üzerinde otomatik kodlayıcı tabanlı temsil öğrenme, regresyon modeli karşılaştırması ve gözetimsiz anomali analizi çalışmasıdır.
Hakemlik/yayın durumu: Kaynakta makalenin 28 Şubat 2026'da alındığı, 30 Mart 2026'da revize edildiği, 2 Nisan 2026'da kabul edildiği ve 7 Nisan 2026'da yayımlandığı belirtilmektedir.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Çalışma dış finansman almadığını bildirmektedir.
Veri erişilebilirliği: Özgün katkıların çalışma içinde bulunduğu ve ilave soruların sorumlu yazara yöneltilebileceği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir.
Yazar katkıları: Kavramsallaştırma, metodoloji ve yazılım N.K.; doğrulama R.K. ve M.B.; biçimsel analiz A.A., R.K. ve M.B.; araştırma R.K.; kaynaklar A.A. ve M.B.; veri kürasyonu A.A.; ilk taslak N.K.; inceleme ve düzenleme R.K.; görselleştirme A.A., R.K. ve M.B.; gözetim ve proje yönetimi R.K.; finansman edinimi R.K. olarak belirtilmiştir.
Bilimsel içerik sınırı: Bu Verianla yazısındaki veri kümesi, formüller, model ayarları, performans değerleri, anomali yaklaşımı, istatistikler, grafik yorumları ve sınırlılıklar yalnızca incelenen çalışmaya dayanmaktadır. Dış kaynaklardan yeni batarya performansı veya SoH sonucu eklenmemiştir.
Elektrikli araç uygulaması sınırı: Çalışmanın başlığı ve amacı elektrikli araç batarya enerji depolama sistemlerini hedeflemektedir; ancak model doğrulaması gerçek bir üretim elektrikli araç filosu veya araç üstü BMS yerine NASA B0005, B0006, B0007 ve B0018 yaşlanma verileriyle yapılmıştır.
Girdi değişkeni raporlama notu: Veri kümesi açıklaması ve otomatik kodlayıcı metni gerilim, akım ve sıcaklık sinyallerini vurgularken Bölüm 3.2'nin matematiksel giriş vektörü gerilim, akım ve kapasiteyi kullanmaktadır. Bu kaynak içi farklılık giderilmiş veri olarak sunulmamıştır.
SoH etiketi notu: İncelenen yöntem bölümünde tahmin hedefi SoH olarak adlandırılmasına rağmen kapasiteden SoH'ye dönüşümü tanımlayan açık ve tek anlamlı hedef etiketi formülü verilmemektedir. Bu nedenle MAE ve RMSE değerleri doğrudan “yüzde puan SoH hatası” biçiminde yeniden adlandırılmamıştır.
Random Forest parametre notu: Bölüm 3.6.2 genel RF açıklamasında N=200 karar ağacı ifadesi kullanılmıştır. Optuna optimizasyonunda ise en iyi model n_estimators=86 ve max_depth=11 olarak raporlanmıştır. İki sayı kaynak içinde farklı bağlamlarda bulunduğundan sessizce birleştirilmemiştir.
R² notu: Özet R² değerini yaklaşık 0,96, Tablo 2 0,9693 olarak verirken sonuç bölümünde değer tipografik olarak “099” biçiminde yer almaktadır. Sayısal karşılaştırmada Tablo 2'deki 0,9693 kullanılmıştır.
PCA/PSA notu: Özet gizil uzay analizlerinden birini “PSA” olarak yazmaktadır; sonuç bölümü ve Şekil 6 yöntemi PCA olarak göstermektedir. Bu Verianla yazısında sonuç bölümündeki gerçek grafik PCA olarak adlandırılmıştır ve özet içindeki yazım ayrıca bu notta korunmuştur.
Silhouette Score notu: Özet kümeleme performansının Silhouette Score ile ölçüldüğünü belirtmektedir; ancak incelenen yöntem ve sonuç bölümlerinde sayısal bir Silhouette Score sonucu verilmemiştir. Kaynakta bulunmayan değer üretilmemiştir.
Anomali doğrulama sınırı: Reconstruction error ve Isolation Forest anomalileri görsel olarak incelenmiştir; ancak etiketli gerçek anomali sınıfları üzerinden sensitivity, specificity, precision, recall, F1 veya ROC-AUC raporlanmamıştır.
Model karşılaştırma sınırı: Random Forest Optuna hiperparametre optimizasyonuna tabi tutulurken CNN ve GRU sabit yapı ve fold başına beş iterasyonla değerlendirilmiştir. Bu nedenle çalışmanın sonuçları ilgili deney protokolü içindeki karşılaştırmayı destekler; bütün derin öğrenme mimarilerine karşı genel üstünlük kanıtı değildir.
Gerçek zamanlılık sınırı: CNN ve GRU için sayısal inference gecikmesi verilmiş, RF/LR ve tam AE+RF zinciri için karşılaştırılabilir sayısal latency ölçümü raporlanmamıştır. Gerçek otomotiv sınıfı BMS üzerinde uçtan uca saha testi sunulmamıştır.
Şekil 15 notu: Bölüm metni farklı latent dimensionality değerlerinin test edildiğini ifade ederken şeklin eksenleri bireysel latent boyut indekslerine karşı MAE artışını göstermektedir. Ablasyon protokolünün bu kısmı kaynakta tamamen tek anlamlı değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir