

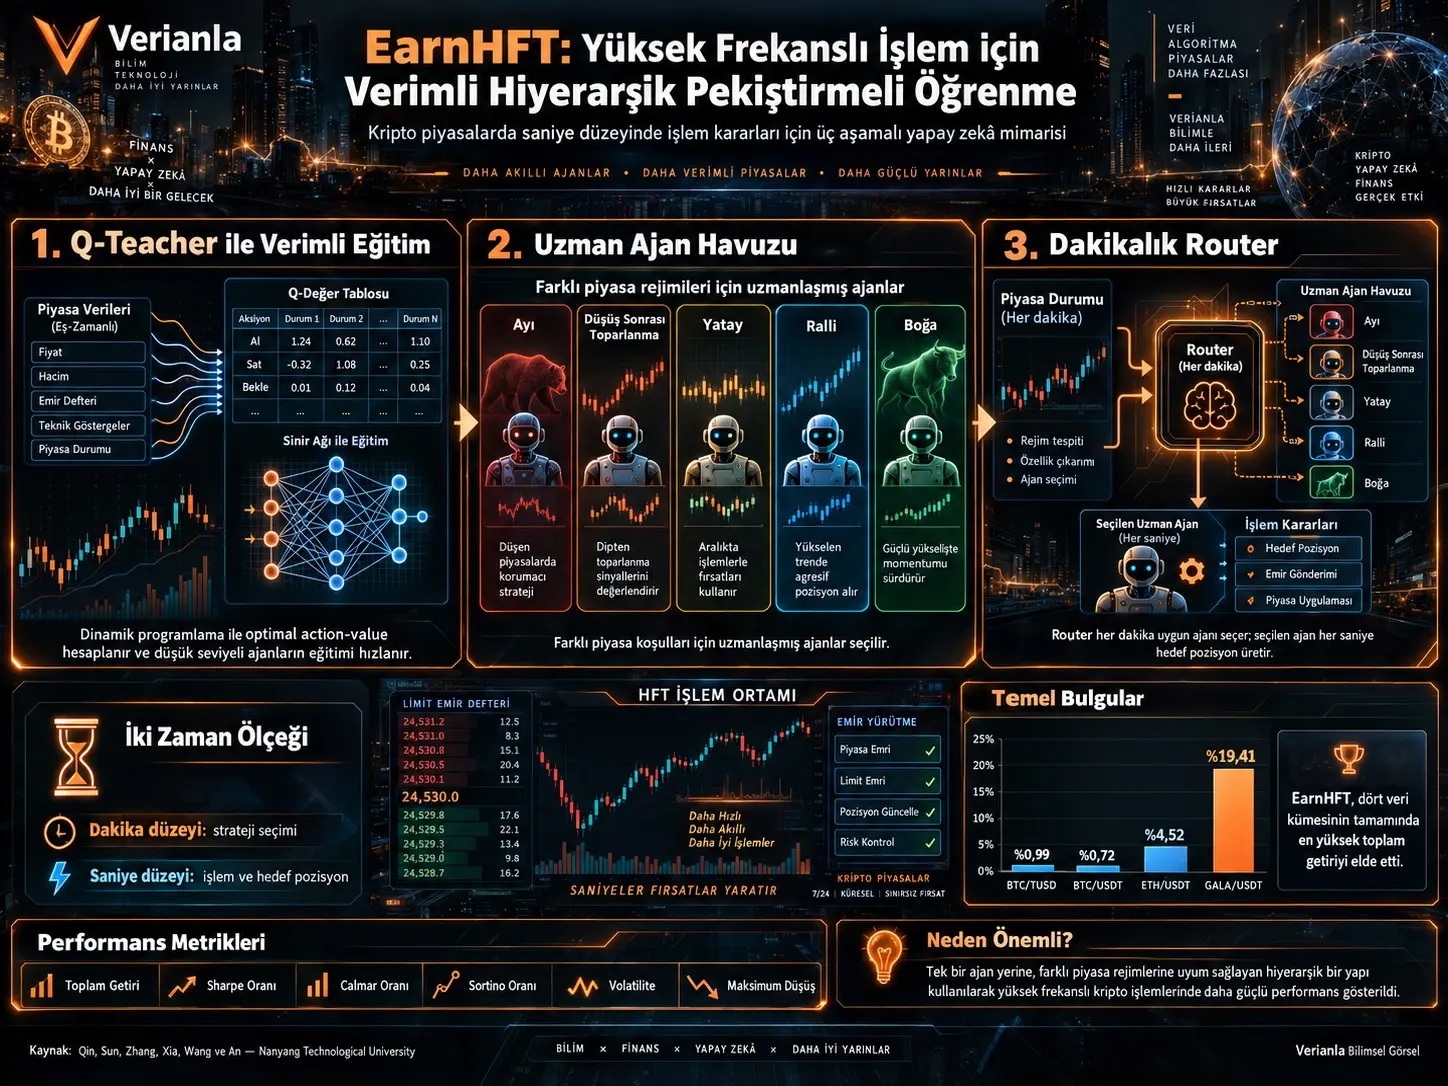
EarnHFT, ni mfumo wa ujifunzaji wa uimarishaji wa kihierarkia wenye hatua tatu uliotengenezwa ili kutatua matatizo mawili ya msingi ya mawakala wa ujifunzaji wa uimarishaji wanaofanya biashara katika masoko ya sarafu za kidijitali kwa kiwango cha sekunde. Tatizo la kwanza ni kwamba katika biashara ya masafa ya juu, njia za mafunzo huwa ndefu sana. Katika mfano wa utafiti, data ya sekunde ya siku 12 pekee huzalisha takriban hatua 1.036.800 za maamuzi; kwa kiwango cha mwezi idadi hiyo inaweza kufikia mamilioni ya hatua. Tatizo la pili ni kwamba kwa sababu hali za soko la kripto hubadilika kwa haraka, mkakati uliojifunzwa na wakala mmoja unaweza kushindwa katika hali tofauti ya soko.
EarnHFT hushughulikia matatizo haya kwa kugawanya kazi katika viwango tofauti vya muda badala ya kufundisha wakala mmoja wa trading wa jumla. Mawakala wa kiwango cha chini katika muda wa sekunde hufanya maamuzi halisi ya kununua na kuuza na kuweka nafasi lengwa, huku router wa kiwango cha juu katika muda wa dakika akichagua wakala wa kiwango cha chini anayefaa tabia ya sasa ya soko kwa kiwango cha makro. Kwa njia hii mfumo unaweza kushughulikia mienendo midogo ya soko katika kiwango cha sekunde na kutathmini mabadiliko ya trend katika kiwango cha dakika.
Katika hatua ya kwanza, Q-teacher, anayehesabiwa kwa dynamic programming kwa kutumia taarifa za bei za baadaye, humpa wakala wa kiwango cha chini wa DDQN si tu uzoefu wake wa trial-and-error bali pia taarifa iliyohesabiwa ya optimal action-value ya vitendo mbadala katika hali hiyo hiyo. Katika hatua ya pili, mamia ya mawakala hufundishwa ili wabobe katika tabia tofauti za bull, bear, pullback, sideways na rally; ni sehemu ndogo tu yenye faida kubwa katika hali mbalimbali za soko huingizwa kwenye mkusanyiko wa mikakati. Katika hatua ya tatu, router wa DDQN wa kiwango cha dakika huchagua mmoja wa mawakala hao, na wakala aliyechaguliwa hutengeneza nafasi lengwa kila sekunde kwa dakika inayofuata.
Katika majaribio ya uigaji yaliyofanywa kwa seti za data za BTC/TUSD, BTC/USDT, ETH/USDT na GALA/USDT, EarnHFT ilitoa total return ya juu zaidi katika kipindi cha test katika masoko yote manne. Total return ziliripotiwa kuwa takriban %0,99, %0,72, %4,52 na %19,41 kwa mtiririko huo. Hata hivyo, mbinu hii si bora katika kila kipimo cha risk; waandishi wanaeleza wazi kwamba EarnHFT ni trader mwenye ukali wa kiasi kutokana na muundo wake wa Q-teacher wenye mwelekeo wa profit na kwamba katika baadhi ya seti za data utendaji wa risk unabaki katika kiwango cha kati.
Kwa nini ujifunzaji wa kawaida wa uimarishaji unapata ugumu katika HFT?
Katika ujifunzaji wa uimarishaji, wakala huangalia hali ya sasa, huchagua kitendo, na huboresha sera yake kutokana na reward inayopokea kama matokeo ya kitendo hicho. Katika matatizo ya trading ya kila siku au ya kila saa, trajectory ya mafunzo inaweza kuwa fupi kwa kiasi. Lakini katika biashara ya masafa ya juu, ikiwa modeli inafanya uamuzi kila sekunde, tatizo huwa na mamilioni ya hatua zinazofuatana.
Mfano uliotolewa na utafiti:
Horizon ndefu kiasi hiki hufanya iwe vigumu kwa wakala wa RL kujifunza athari za muda mrefu za tabia nzuri na mbaya, na huhitaji uzoefu mwingi zaidi wa mafunzo.
Tatizo la pili ni hali ya non-stationary market dynamics . Katika soko la kripto, mwendo uleule mdogo wa bei unaweza kuwa na maana tofauti katika hali tofauti za soko kwa kiwango cha makro. Kwa mfano, kushuka kwa bei kwa muda mfupi katika soko linalopanda kunaweza kuwa pullback ya muda, ilhali mwendo unaofanana katika soko linaloshuka unaweza kuwa mwendelezo wa kushuka zaidi. Kwa hiyo, sera moja inaweza kushindwa kutoa mafanikio sawa katika kila hali ya soko.
Kwa nini EarnHFT hutumia muundo wa kihierarkia?
EarnHFT hugawanya taarifa za soko katika viwango viwili tofauti vya muda. MDP ya kiwango cha chini huiga mienendo midogo ya soko ya kiwango cha sekunde na execution ya biashara. MDP ya kiwango cha juu huiga trend za soko zinazobadilika polepole zaidi katika kiwango cha dakika na kuamua ni mkakati gani wa trading utumike.
Wakala wa kiwango cha chini hutengeneza nafasi lengwa kila sekunde, huku router wa kiwango cha juu akichagua wakala mmoja wa kiwango cha chini kila dakika. Hivyo maamuzi ya “ni coin ngapi zishikiliwe sasa?” na “ni trader gani atumike katika hali hii ya soko?” hutenganishwa.
Hali ya kiwango cha chini ina taarifa gani?
State ya kiwango cha chini ina vipengele viwili vikuu. Cha kwanza ni vipengele 54 vya kiufundivinavyotolewa kutoka kwenye taarifa za soko za kila sekunde; cha pili ni nafasi ya sasa inayoshikiliwa na wakala. Vipengele vya kiufundi hupatikana kutoka kwa taarifa za OHLC ndani ya rolling window ya sekunde 60 na snapshot za Limit Order Book.
Action si lebo ya moja kwa moja ya “buy” au “sell”. Wakala huchagua nafasi lengwa kutoka kwenye action pool yenye idadi maalumu iliyowekwa mapema. Ikiwa nafasi ya sasa ni tofauti na nafasi lengwa, tofauti hiyo hununuliwa au kuuzwa mara moja kwa market order.
Hali ya kiwango cha juu na action ni nini?
State ya kiwango cha juu hutolewa kutoka kwenye rolling OHLC window ya dakika 60 na ina vipengele 19 vya makro pamoja na nafasi ya sasa. Action hapa si nafasi moja kwa moja, bali ni kuchagua mmoja wa mawakala wa RL wa kiwango cha chini kutoka kwenye mkusanyiko wa mikakati.
Wakala aliyechaguliwa na router hufanya kazi kwa dakika moja na hutengeneza nafasi lengwa katika kiwango cha sekunde. Reward ya router ni mabadiliko ya net-value yaliyotokana na wakala huyo wa kiwango cha chini katika dakika hiyo.
Kwa nini Limit Order Book ni muhimu?
Uigaji wa EarnHFT hauchukulii kwamba biashara hufanyika tu kwa bei ya kufunga. Hutumia bid na ask prices katika Limit Order Book pamoja na kiasi kinachopatikana katika viwango hivyo. Ikiwa market order kubwa inazidi liquidity ya kiwango cha kwanza cha bei, agizo husogea kwenda viwango vinavyofuata vya bei.
Muundo unaotumiwa na chanzo kueleza gharama ya market-order:
Hapa \(p_t^i\) ni bei ya kiwango husika cha order-book, \(q_t^i\) ni kiasi kilichopo katika kiwango hicho, \(R_{i-1}\) ni kiasi cha agizo kilichobaki baada ya viwango vilivyotangulia, na \(\sigma\) ni kiwango cha commission-fee.
Matokeo muhimu ni kwamba hata kama commission ni sifuri, trading si bure. Kwa sababu market order hutumia upande wa ask wakati wa kununua na upande wa bid wakati wa kuuza, bid–ask spread yenyewe huwa gharama ya biashara.
Hatua I: Q-teacher hufanyaje kazi?
Wakala wa kawaida wa RL hujifunza ni kitendo gani kizuri kwa kujaribu. EarnHFT hutumia dhana kwamba katika mazingira ya uigaji yaliyotumika, mfululizo wa bei hauathiriwi na vitendo vya wakala. Kwa kuwa bei za baadaye zinajulikana wakati wa mafunzo, optimal action-value ya kila mchanganyiko wa muda–nafasi–action inaweza kuhesabiwa kwa kurudi nyuma kwa dynamic programming.
Q-table hii haitumiki wakati wa trading; wakati wa mafunzo hufanya kazi kama ishara ya mwalimu .
Kwenye kosa la kawaida la temporal-difference la DDQN huongezwa Kullback–Leibler divergence kati ya usambazaji wa action-value wa mtandao na usambazaji wa optimal action-value:
Sehemu ya TD:
Lengo hapa ni kuruhusu wakala kujifunza si tu matokeo ya action aliyochagua, bali pia thamani za jamaa za action nyingine katika hali hiyo hiyo. Katika chanzo, \(\alpha\) hutumiwa kama coefficient inayopungua kadiri mafunzo yanavyoendelea.
Optimal Actor huongeza nini?
Kutumia Q-teacher peke yake hakukuonekana kuwa kunatosha. Wakala anapoondoka kwenye sera optimal, nafasi anayoshikilia hubadilika na ishara ya mwalimu inaweza pia kubadilika. Ili kupunguza hili, EarnHFT huunda chanzo cha pili cha uzoefu.
Kundi moja la uzoefu hutengenezwa na wakala kwa sera ya kawaida ya \(\epsilon\)-greedy, huku kundi jingine likitengenezwa na optimal actor anayechagua moja kwa moja action yenye kiwango cha juu katika \(Q^*\). Hivyo replay buffer ina transitions zilizopatikana wakati wa exploration pamoja na transitions zilizotengenezwa na sera optimal iliyohesabiwa.
Hatua II: Kwa nini mamia ya mawakala hufundishwa badala ya wakala mmoja?
Moja ya hypotheses kuu za utafiti ni kwamba sera nzuri kwa bull market inaweza isiwe nzuri kwa kiwango sawa katika bear market. Kwa hiyo, data ya mafunzo hugawanywa katika vipande vinavyowakilisha trend tofauti za soko, na mawakala hupewa uwezekano tofauti wa kuona vipande hivyo.
Seti ya data ina sehemu za multivariate time series zenye zaidi ya hatua milioni tatu za muda. Kwa kila wakala, parameter ya upendeleo \(\beta\) hubadilishwa. Sampling weight ya market segments zenye buy-and-hold return ya juu au ya chini hubadilishwa kwa parameter hii ili kujaribu kuunda mawakala wanaobobea katika hali tofauti za soko.
Segment za soko huwekewa lebo vipi?
Chanzo kwanza hupunguza kelele za masafa ya juu kwa low-pass filtering. Kisha huunda segments kutokana na mabadiliko ya mwelekeo wa ndani katika curve ya price/net-value. Segment jirani huunganishwa ikiwa tofauti ya slope na ufanano wa Dynamic Time Warping ni mdogo vya kutosha.
Baadaye, kwa kutumia quantile za mteremko wa buy-and-hold return, segments hugawanywa katika madaraja tofauti ya trend. Makundi matano yaliyotumika katika vielelezo vya utafiti ni:
- Bear,
- Pullback,
- Sideways,
- Rally,
- Bull.
Kwa kila trend na nafasi ya kuanzia, mawakala wanaozalisha profitability ya wastani ya juu zaidi katika data ya validation huchaguliwa. Hivyo si wagombea wote mamia wanaowekwa kwenye router action space; huhifadhiwa tu mkusanyiko mdogo na tofauti wa mikakati.
Mawakala wangapi walifundishwa?
Katika utafiti, kwa parameter ya sampling-preference \(\beta\) zilitumika thamani \(-90\), \(-10\), \(30\) na \(100\). Kila thamani iliendeshwa kwa 50 epoch na jumla ya mawakala 200 wa kiwango cha chini walitengenezwa.
Hatua III: Router hufanya nini?
Router ni wakala wa kiwango cha juu unaotumia DDQN. Kila dakika hutathmini hali ya sasa ya soko kwa kiwango cha makro na huchagua trader mmoja kutoka agent pool.
Kwa sababu router hufanya uamuzi kwa kiwango cha dakika badala ya sekunde, urefu wa high-level trajectory hupunguzwa kwa:
uwiano huo, yaani kwa kauli ya chanzo takriban %98,33 .
Router pia hupunguza action space zaidi kwa kuzingatia tu mawakala wenye nafasi ya kuanzia inayolingana na nafasi ya sasa. Waandishi hawakutumia Q-teacher katika hatua ya high-level; kwa kuwa trajectory ilikuwa tayari imefupishwa sana na kuhesabu optimal action-value ya kuchagua wakala ni jambo gumu zaidi, waliona DDQN ya kawaida kuwa na ufanisi zaidi.
Je, router kweli hubadilika kulingana na hali ya soko?
Chanzo kilichunguza usambazaji wa uchaguzi wa router katika seti nne za test. Katika BTC/TUSD na BTC/USDT zenye volatility ya chini, uchaguzi wa router ulikusanyika katika market-state agents wachache; katika masoko yenye mabadiliko zaidi kama ETH na GALA, uchaguzi ulisambaa kwa usawa zaidi katika hali tano za soko.
Kwa mfano, katika test ya GALA takriban %67,6 ya uchaguzi ulikwenda kwa wakala Bull. Katika test ya BTC/USDT takriban %64,8 ilikuwa Sideways na %32,6 Rally. Katika ETH, sehemu ya wakala Pullback ilikuwa takriban %43,9. Thamani hizi zinaonyesha kwamba router haitumii wakala yuleyule wa chini katika kila soko.
Mbinu na Matokeo
Seti za data
| Trading Pair | Mienendo ya soko iliyotolewa kwenye chanzo | Idadi ya sekunde | Kipindi |
|---|---|---|---|
| BTC/TUSD | Sideways | 4.057.140 | 30 Machi 2023 – 15 Mei 2023 |
| BTC/USDT | Sideways | 3.884.400 | 1 Septemba 2022 – 15 Oktoba 2022 |
| ETH/USDT | Bear | 3.970.800 | 1 Mei 2022 – 15 Juni 2022 |
| GALA/USDT | Bull | 3.970.740 | 1 Julai 2022 – 15 Agosti 2022 |
Katika kila seti ya data, siku 9 za mwisho zilitumika kwa test, siku 9 zilizotangulia kwa validation, na data za zamani zaidi kwa training. Mgawanyo huu wa muda unalenga kuzuia matumizi ya moja kwa moja ya data ya baadaye ya test katika hatua ya mafunzo.
Vipindi vya validation na test havikuwa sawa
Utafiti uliunda tofauti kubwa kwa makusudi kati ya trend za validation na test. Katika BTC/TUSD test set kulitokea bear trend ya wazi ambayo haikuwepo katika validation. Katika ETH/USDT tofauti ilikuwa kubwa zaidi: trend katika validation ilikuwa inapanda, huku katika kipindi cha test chanzo kikiripoti kushuka kwa takriban %30.
Hali hii ilitumika kuonyesha kwamba EarnHFT ilijaribiwa si tu katika masoko yanayofanana na kipindi cha mafunzo, bali pia wakati market regime ilibadilika.
Mbinu zilizolinganishwa
EarnHFT ililinganishwa na RL nne na rule-based baseline mbili: PPO, DRA, DQN, CDQNRP, MACD na Imbalance Volume (IV). Hivyo policy-based RL, value-based RL na mbinu za kawaida zinazotegemea viashiria vya soko zilitathminiwa katika jaribio moja.
Vipimo vya tathmini
Vipimo sita vya kifedha vilitumika: Total Return (TR), Annual Sharpe Ratio (ASR), Annual Calmar Ratio (ACR), Annual Sortino Ratio (ASoR), Annual Volatility (AVOL) na Maximum Drawdown (MDD).
Total Return:
Annual Sharpe Ratio:
Calmar Ratio:
Sortino Ratio hutumia downside deviation ya return hasi pekee kama kipimo cha risk badala ya volatility ya jumla.
Matokeo makuu ya utendaji
| Soko | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) |
|---|---|---|---|---|---|---|
| BTC/USDT | 0,72 | 1,22 | 10,77 | 0,93 | 27,08 | 3,07 |
| BTC/TUSD | 0,99 | 1,34 | 7,76 | 1,01 | 32,40 | 5,61 |
| ETH/USDT | 4,52 | 2,92 | 14,30 | 1,78 | 67,92 | 13,89 |
| GALA/USDT | 19,41 | 9,77 | 79,08 | 7,79 | 74,94 | 9,26 |
EarnHFT ilipata matokeo ya juu zaidi kwa Total Return katika seti zote nne za data. Chanzo pia kinasema kwamba EarnHFT ilikuwa na utendaji bora zaidi katika vipimo vya risk-adjusted profit katika seti tatu kati ya nne.
BTC/TUSD ni tofauti. Katika seti hii baadhi ya risk-adjusted metrics za DQN ni za juu kuliko EarnHFT; kwa mfano DQN ina ASR 4,21 na ACR 27,94, huku EarnHFT ikiwa na 1,34 na 7,76. Kwa hiyo ubora wa mfumo katika profit haumaanishi ubora wa moja kwa moja katika kila kipimo.
Mfano wa biashara ya ETH
Katika Kielelezo 2 cha chanzo, kuna mfano wa nafasi iliyofunguliwa na EarnHFT kwenye ETH na kufungwa tena ndani ya takriban sekunde 30. Mwendo wa bei ambao unaweza kuonekana kama pullback ndogo katika kiwango cha dakika unatumiwa na wakala wa kiwango cha sekunde kama fursa ya muda mfupi ya trading.
Mfano huu unaonyesha kwa picha kwa nini mfumo hutenganisha viwango viwili vya muda: router huchagua muktadha mpana wa soko, huku wakala wa kiwango cha chini akijibu mienendo midogo zaidi ya bei ndani ya dakika hiyo.
Je, Q-teacher kweli iliharakisha mafunzo?
Katika jaribio la ablation, athari za Optimal Value Supervisor (OS) na Optimal Actor (OA) zilichunguzwa kando.
Katika seti ya GALA, DDQN ya kawaida iliconverge baada ya takriban hatua 30.720, huku muundo uliotumia OS pekee ukiconverge baada ya hatua 4.608. Kwa kauli ya chanzo, hii ni takriban %15 ya hatua za mafunzo . Converged reward sum katika ulinganisho huo ilipanda kutoka -0,01 hadi 2,89.
OS na OA zilipotumika pamoja, GALA reward sum ilifikia 4,43, lakini convergence step ilikuwa 78.848. Hii inaonyesha kwamba optimal actor inaweza kuongeza profit lakini wakati huo huo ikahitaji hatua zaidi za mafunzo.
Katika ETH, OS pekee haikupunguza convergence step dhidi ya baseline; zote zilikuwa katika kiwango cha hatua 30.720. Hata hivyo reward sum iliongezeka kutoka takriban -29,6 hadi 4,87. Chanzo kinaripoti reward sum 12,32 wakati vipengele vyote viwili vinapotumika pamoja.
Kwa nini EarnHFT ni dhaifu zaidi katika baadhi ya vipimo vya risk?
Kwa maelezo ya waandishi, Q-teacher na optimal actor hufundisha hasa uzoefu wenye profit. Kwa kuwa adhabu ya risk haijajumuishwa kwa uzito sawa katika optimal supervision, EarnHFT inaweza kuonyesha tabia ya trading yenye ukali zaidi.
Kwa hiyo matokeo hayapaswi kutafsiriwa kuwa “profit kubwa = risk ndogo”. Kwa mfano, katika GALA EarnHFT inatoa total return ya juu zaidi ya %19,41 lakini annual volatility ni %74,94, na kuna modeli mbadala zenye volatility ya chini.
Miundombinu ya mafunzo
Majaribio yalifanywa kwenye NVIDIA RTX 4090 GPU. Chanzo kinasema majaribio yote katika seti nne za data yalichukua takriban saa 10. Ukubwa wa replay buffer wa EarnHFT ulikuwa \(10^6\), mini-batch size 512, learning rate \(5\times10^{-4}\), coefficient ya Q-teacher \(\alpha=128\), na soft-update coefficient \(\tau=0.005\).
Tofauti ya ndani ya chanzo kuhusu commission
Katika sehemu kuu ya majaribio, commission kwa BTC/TUSD imeandikwa 0 na kwa seti nyingine %0,02. Lakini parameter table katika Kiambatisho D.3 inaonyesha 0 kwa BTC/TUSD na %0,015 kwa BTC/USDT, ETH/USDT na GALA/USDT.
Chanzo hakielezi kama thamani hizi mbili zinahusu majaribio tofauti, vipindi tofauti au kosa la uandishi. Kwa hiyo maandishi ya Verianla hayachagui moja kama “thamani sahihi”.
Ukaribiaji wa kinadharia
Katika Kiambatisho C.2, waandishi wanawasilisha derivation ya kihisabati inayolenga kuonyesha kwamba operator ya Q-learning iliyorekebishwa kwa Q-teacher supervisor itaconverge kwenda kwenye optimal action-value function \(Q^*\) katika MDP yenye ukomo.
Mbinu kwanza hujaribu kuonyesha kuwa \(Q^*\) ni fixed point ya operator iliyofafanuliwa, kisha kwamba operator hiyo ni contraction chini ya sup-norm. Hili ni hoja ya kinadharia ya utafiti na linapaswa kutathminiwa tofauti na matokeo ya majaribio.
Hitimisho zinazoungwa mkono na utafiti
Chanzo kinaonyesha kuwa router wa kiwango cha dakika akichagua kutoka kwenye mkusanyiko wa mawakala wa kiwango cha chini waliobobea katika hali tofauti za soko anaweza kutoa total return ya juu zaidi kwenye seti za kripto zilizojaribiwa kuliko baseline za wakala mmoja au rule-based. Majaribio ya ablation yanaunga mkono kwamba Q-teacher, hasa katika baadhi ya seti, huboresha ufanisi wa mafunzo na converged reward.
Hitimisho ambazo utafiti hauungi mkono
Matokeo hayaonyeshi kwamba EarnHFT itatoa return hiyo hiyo kwa fedha halisi kwenye exchange ya kweli. Utafiti uko katika mazingira ya uigaji. Market impact, order latency halisi, exchange queue priority, packet loss, API throttling, co-location, mwitikio wa mifumo shindani ya HFT na uncertainties zote za execution katika soko la moja kwa moja hazijawakilishwa kikamilifu.
Aidha, mafanikio katika trading pair nne za kripto zilizochaguliwa hayawezi kuenezwa moja kwa moja kwa mali zote za kripto, hisa, futures au miundo tofauti ya market-microstructure.
Dokezo la Chanzo na Mbinu
Kazi asili: EarnHFT: Efficient Hierarchical Reinforcement Learning for High Frequency Trading.
Waandishi: Molei Qin, Shuo Sun, Wentao Zhang, Haochong Xia, Xinrun Wang na Bo An.
Taasisi: Nanyang Technological University, Singapore.
Mchango sawa: PDF ya chanzo inawaweka Molei Qin na Shuo Sun kama waandishi wenye mchango sawa.
arXiv: 2309.12891v1 [q-fin.TR].
Tarehe ya arXiv: 22 Septemba 2023.
Taarifa ya uchapishaji kwenye chanzo: Copyright © 2024, Association for the Advancement of Artificial Intelligence (AAAI). Kwa kuwa hakuna uthibitishaji wa kibiblia uliofanywa nje ya PDF ya chanzo, hali ya peer review/uchapishaji haijatafsiriwa zaidi.
Aina ya mbinu: hierarchical reinforcement learning ya hatua tatu kwa high frequency crypto trading; Q-teacher inayotegemea dynamic programming; DDQN; agent pool iliyobobea katika trend tofauti za soko; dynamic strategy router ya kiwango cha dakika.
Kiwango cha muda cha kiwango cha chini: Sekunde 1.
Kiwango cha muda cha kiwango cha juu: Dakika 1.
Market representation ya kiwango cha chini: Kutoka rolling OHLC + LOB window ya sekunde 60 hupatikana vipengele 54 na nafasi ya sasa.
Market representation ya kiwango cha juu: Kutoka rolling OHLC window ya dakika 60 hupatikana vipengele 19 na nafasi ya sasa.
Idadi ya mawakala wa kiwango cha chini waliofunzwa: 200.
Parameter za trend preference: \(\beta\in\{-90,-10,30,100\}\), kila moja 50 epoch.
GPU: NVIDIA RTX 4090.
Jumla ya muda wa majaribio: Chanzo kinaripoti takriban saa 10.
Seti za data: Data za soko za kila sekunde za BTC/TUSD, BTC/USDT, ETH/USDT na GALA/USDT.
Mgawanyo wa validation/test: Siku 9 za mwisho test, siku 9 zilizotangulia validation, kipindi cha zamani kilichobaki training.
Ulinganisho: PPO, DRA, DQN, CDQNRP, MACD na Imbalance Volume.
Vipimo vya kifedha: Total Return, Annual Sharpe Ratio, Annual Calmar Ratio, Annual Sortino Ratio, Annual Volatility na Maximum Drawdown.
Matokeo makuu ya majaribio: EarnHFT inaripoti Total Return ya juu zaidi katika seti zote nne za test na matokeo yenye nguvu zaidi ya risk-adjusted profit katika seti tatu.
Kizuizi cha risk: Waandishi wanaeleza kuwa mbinu ni profit-oriented na yenye ukali wa kiasi kutokana na Q-teacher na optimal actor, na katika baadhi ya vipimo vya risk hutoa utendaji wa kiwango cha kati pekee.
Kutokulingana ndani ya chanzo 1: Commission ya %0,02 katika maandishi makuu hailingani na kiwango cha Kiambatisho D.3 cha %0,015.
Kutokulingana ndani ya chanzo 2: Jedwali la seti ya data linaainisha ETH/USDT kama Bear, lakini katika sehemu moja ya maelezo ya ablation limetumika neno “market is bull” kwa ETH. Sehemu nyingine za utafiti huieleza kipindi cha test cha ETH kama soko linaloshuka.
Kizuizi kikuu: Majaribio yalifanywa katika trading environment ya uigaji wa usahihi wa juu; utendaji wa end-to-end real-money trading kwenye mfumo wa HFT wa uzalishaji wa moja kwa moja haukujaribiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *