

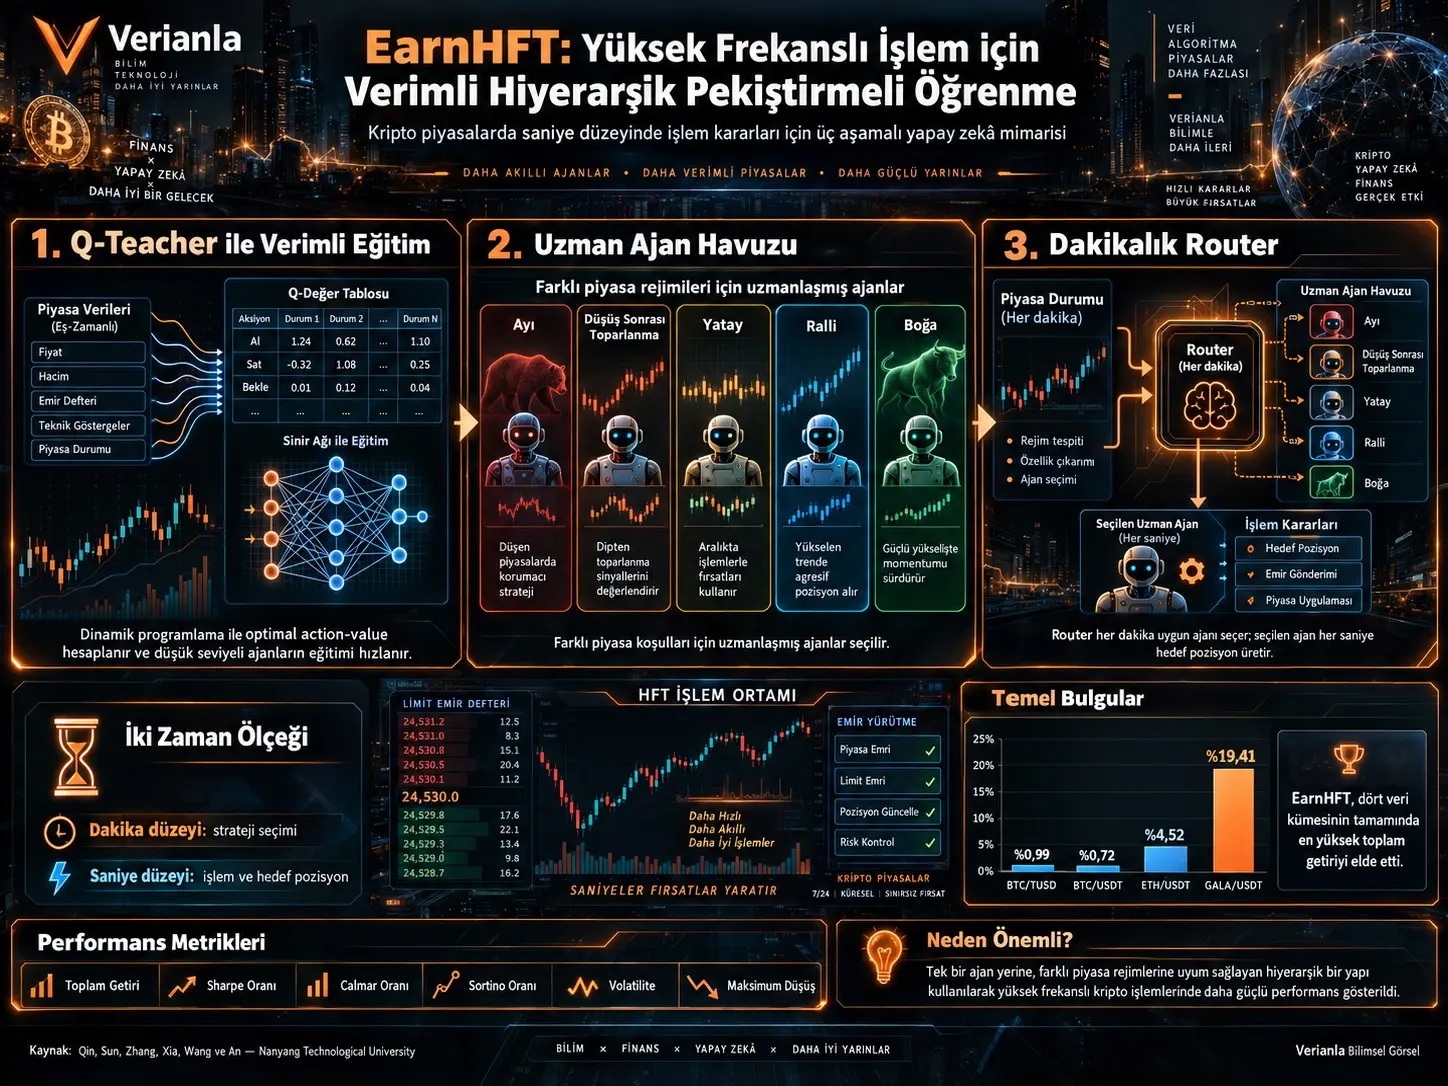
EarnHFT, kripto para piyasalarında saniye düzeyinde işlem yapan pekiştirmeli öğrenme ajanlarının iki temel sorununu çözmek amacıyla geliştirilen üç aşamalı bir hiyerarşik pekiştirmeli öğrenme sistemidir. İlk sorun, yüksek frekanslı işlemde eğitim yörüngelerinin olağanüstü uzun olmasıdır. Çalışmanın örneğinde yalnız 12 günlük saniyelik veri yaklaşık 1.036.800 karar adımı üretmektedir; aylık ölçek milyonlarca adıma ulaşabilmektedir. İkinci sorun ise kripto piyasalarının piyasa rejimlerinin hızla değişmesi nedeniyle tek bir ajan tarafından öğrenilen stratejinin farklı bir piyasa koşulunda başarısız olabilmesidir.
EarnHFT bu sorunları tek ve genel bir trading ajanı eğitmek yerine görevleri farklı zaman ölçeklerine ayırarak ele alır. Saniye düzeyindeki düşük seviyeli ajanlar gerçek alım-satım kararlarını ve hedef pozisyonu belirlerken, dakika düzeyindeki yüksek seviyeli bir router piyasanın mevcut makro davranışına uygun düşük seviyeli ajanı seçer. Sistem böylece mikro piyasa hareketlerini saniye düzeyinde işlerken trend değişimini dakika düzeyinde değerlendirebilir.
Birinci aşamada gelecekteki fiyat bilgisi kullanılarak dinamik programlamayla hesaplanan Q-teacher, düşük seviyeli DDQN ajanına yalnız kendi deneme-yanılma deneyimini değil, aynı durumdaki alternatif hareketlerin hesaplanmış optimal action-value bilgisini de verir. İkinci aşamada farklı bull, bear, pullback, sideways ve rally davranışlarında uzmanlaşması amaçlanan yüzlerce ajan eğitilir; bunların yalnız çeşitli piyasa rejimlerinde en kârlı olan küçük bir bölümü strateji havuzuna alınır. Üçüncü aşamada dakika düzeyindeki DDQN router bu ajanlardan birini seçer ve seçilen ajan bir sonraki dakika boyunca saniye saniye hedef pozisyon üretir.
BTC/TUSD, BTC/USDT, ETH/USDT ve GALA/USDT veri kümelerinde yapılan simülasyon deneylerinde EarnHFT dört piyasanın tamamında test dönemindeki en yüksek toplam getiriyi üretmiştir. Toplam getiriler sırasıyla yaklaşık %0,99, %0,72, %4,52 ve %19,41 olarak raporlanmıştır. Bununla birlikte yöntem her risk metriğinde en iyi değildir; yazarlar EarnHFT'nin profit-oriented Q-teacher yapısı nedeniyle görece agresif bir trader olduğunu ve bazı veri kümelerinde risk performansının orta düzeyde kaldığını açıkça belirtmektedir.
Neden normal pekiştirmeli öğrenme HFT için zorlanıyor?
Pekiştirmeli öğrenmede bir ajan, mevcut durumu gözlemleyip bir eylem seçer ve bu eylemin sonucunda aldığı ödülden hareketle politikasını geliştirir. Günlük veya saatlik trading problemlerinde bir eğitim yörüngesi görece kısa olabilir. Yüksek frekanslı işlemde ise aynı model saniyede bir karar verirse problem milyonlarca ardışık adımdan oluşur.
Çalışmanın verdiği örnek:
Bu kadar uzun horizon, RL ajanının olumlu ve olumsuz davranışların uzun dönemli etkisini öğrenmesini zorlaştırır ve eğitim için çok daha fazla deneyim gerektirir.
İkinci problem non-stationary market dynamics durumudur. Kripto piyasasında aynı mikro fiyat hareketi farklı makro piyasa rejimlerinde farklı anlam taşıyabilir. Örneğin yükselen bir piyasadaki kısa süreli fiyat düşüşü geçici bir pullback olabilirken düşüş piyasasındaki benzer hareket daha büyük bir aşağı hareketin devamına dönüşebilir. Bu nedenle tek bir politikanın bütün piyasa rejimlerinde aynı başarıyı göstermesi zorlaşır.
EarnHFT neden hiyerarşik bir yapı kullanıyor?
EarnHFT piyasa bilgisini iki farklı zaman ölçeğine ayırır. Düşük seviyeli MDP saniye düzeyindeki mikro piyasa hareketlerini ve işlem execution'ını modeller. Yüksek seviyeli MDP ise dakika ölçeğinde daha yavaş değişen piyasa trendlerini ve hangi trading stratejisinin kullanılacağını modeller.
Düşük seviyeli ajan her saniye hedef pozisyon üretirken yüksek seviyeli router her dakika bir düşük seviyeli ajan seçer. Böylece “şu anda kaç coin tutulmalı?” ve “şu piyasa rejiminde hangi trader kullanılmalı?” kararları birbirinden ayrılır.
Düşük seviyeli durum hangi bilgileri içeriyor?
Düşük seviyeli state iki ana bileşenden oluşur. Birincisi saniyelik piyasa bilgisinden çıkarılan 54 teknik özellik, ikincisi ise ajan tarafından tutulan mevcut pozisyondur. Teknik özellikler 60 saniyelik rolling window içindeki OHLC bilgisi ile Limit Order Book snapshot'larından elde edilir.
Action, doğrudan “buy” veya “sell” etiketi değildir. Ajan önceden belirlenmiş sonlu bir action pool içinden bir hedef pozisyon seçer. Mevcut pozisyon hedef pozisyondan farklıysa aradaki miktar market order ile anında alınır veya satılır.
Yüksek seviyeli durum ve action nedir?
Yüksek seviyeli state, 60 dakikalık rolling OHLC window'undan çıkarılan 19 makro özellik ile mevcut pozisyonu içerir. Action ise doğrudan pozisyon değil, strateji havuzundaki düşük seviyeli RL ajanlarından birinin seçilmesidir.
Router tarafından seçilen ajan bir dakika boyunca çalışır ve saniye düzeyinde hedef pozisyon üretir. Router'ın aldığı reward, bu bir dakikalık sürede seçilen düşük seviyeli ajanın oluşturduğu net-value değişimidir.
Limit Order Book neden önemli?
EarnHFT'nin simülasyonu yalnız kapanış fiyatından işlem yapıldığını varsaymaz. Limit Order Book içindeki bid ve ask fiyatları ile bu seviyelerde mevcut miktarları kullanır. Büyük bir market order'ın ilk fiyat seviyesindeki likiditeden fazla olması durumunda emir bir sonraki fiyat seviyelerine taşınır.
Kaynağın market-order maliyetini açıklamak için kullandığı yapı:
Burada \(p_t^i\) ilgili order-book seviyesinin fiyatını, \(q_t^i\) o seviyedeki miktarı, \(R_{i-1}\) önceki seviyelerden sonra kalan emir miktarını ve \(\sigma\) commission-fee oranını temsil eder.
Bunun önemli sonucu, komisyon sıfır olsa bile trading'in ücretsiz olmamasıdır. Market order alışta ask tarafını, satışta bid tarafını tükettiği için bid–ask spread kendi başına işlem maliyeti oluşturur.
Aşama I: Q-teacher nasıl çalışıyor?
Normal RL ajanı hangi hareketin iyi olduğunu deneyerek öğrenir. EarnHFT ise kullanılan simülasyon ortamında fiyat serisinin ajanın eylemlerinden etkilenmediği varsayımından yararlanır. Gelecekteki fiyatlar eğitim sırasında bilindiği için her zaman–pozisyon–action kombinasyonunun optimal action-value değeri dinamik programlamayla geriye doğru hesaplanabilir.
Bu Q-tablosu trading sırasında kullanılmaz; eğitim sırasında bir öğretmen sinyali görevi görür.
DDQN'nin normal temporal-difference hatasına, ağın action-value dağılımı ile optimal action-value dağılımı arasındaki Kullback–Leibler divergence eklenir:
TD bileşeni:
Buradaki amaç, ajanın yalnız seçtiği action'ın sonucunu değil aynı durumdaki diğer action'ların göreli değerlerini de öğrenebilmesini sağlamaktır. Kaynakta \(\alpha\) eğitim ilerledikçe azalan bir katsayı olarak kullanılır.
Optimal Actor ne ekliyor?
Yalnız Q-teacher kullanmak yeterli görülmemiştir. Ajan optimal politikadan uzaklaştığında bulunduğu pozisyon değiştiği için öğretmen sinyali de farklılaşabilir. Bunu azaltmak amacıyla EarnHFT ikinci bir deneyim kaynağı oluşturur.
Bir deneyim grubu normal \(\epsilon\)-greedy politika ile ajan tarafından oluşturulurken diğer grup doğrudan \(Q^*\) değerinde maksimum action'ı seçen optimal actor tarafından üretilir. Böylece replay buffer hem keşif sırasında elde edilen geçişleri hem de hesaplanmış optimal politikanın ürettiği geçişleri içerir.
Aşama II: Neden tek ajan yerine yüzlerce ajan eğitiliyor?
Çalışmanın temel hipotezlerinden biri, bull market için iyi olan politikanın bear market için aynı derecede iyi olmayabileceğidir. Bu nedenle eğitim verisi farklı piyasa trendlerini temsil eden parçalara bölünür ve ajanların bu parçaları farklı olasılıklarla görmesi sağlanır.
Veri kümesi üç milyondan fazla zaman adımına sahip multivariate time series bölümlerinden oluşmaktadır. Her ajan için tercih parametresi \(\beta\) değiştirilir. Buy-and-hold return yüksek veya düşük olan market segmentlerinin sampling ağırlığı bu parametreyle değiştirilerek farklı piyasa rejimlerinde uzmanlaşan ajanlar oluşturulmaya çalışılır.
Piyasa segmentleri nasıl etiketleniyor?
Kaynak önce yüksek frekanslı gürültüyü low-pass filtering ile azaltır. Ardından fiyat/net-value eğrisindeki yerel yön değişimlerinden segmentler oluşturur. Komşu segmentler slope farkı ve Dynamic Time Warping benzerliği yeterince küçükse birleştirilir.
Daha sonra buy-and-hold return eğimlerinin quantile değerleri kullanılarak segmentler farklı trend sınıflarına ayrılır. Çalışmanın görsellerinde kullanılan beş kategori:
- Bear,
- Pullback,
- Sideways,
- Rally,
- Bull.
Her trend ve başlangıç pozisyonu için doğrulama verisinde en yüksek ortalama profitability değerini üreten ajanlar seçilir. Böylece yüzlerce adayın tamamı router action space'e verilmez; yalnız küçük ve çeşitli bir strateji havuzu tutulur.
Kaç ajan eğitildi?
Çalışmada sampling-preference parametresi \(\beta\) için \(-90\), \(-10\), \(30\) ve \(100\) değerleri kullanılmıştır. Her değer 50 epoch çalıştırılmış ve toplam 200 düşük seviyeli ajan üretilmiştir.
Aşama III: Router ne yapıyor?
Router DDQN tabanlı yüksek seviyeli ajandır. Her dakika mevcut makro piyasa durumunu inceler ve agent pool içinden bir trader seçer.
Router'ın saniye yerine dakika düzeyinde karar vermesi high-level trajectory uzunluğunu:
oranında, yani kaynak ifadesiyle yaklaşık %98,33 azaltır.
Router ayrıca yalnız mevcut pozisyonla uyumlu başlangıç pozisyonuna sahip ajanları değerlendirdiğinden action space daha da küçülür. Yazarlar high-level aşamada Q-teacher kullanmamıştır; trajectory zaten büyük ölçüde kısaldığı ve bir agent seçiminin optimal action-value hesabı daha karmaşık hale geldiği için normal DDQN'yi daha verimli görmüşlerdir.
Router gerçekten piyasa rejimine göre farklı davranıyor mu?
Kaynakta router seçim dağılımı dört test veri kümesinde incelenmiştir. Daha düşük volatiliteye sahip BTC/TUSD ve BTC/USDT verilerinde router seçimleri birkaç market-state ajanında yoğunlaşırken ETH ve GALA gibi daha değişken piyasalarda seçim dağılımının beş piyasa rejimine daha dengeli yayıldığı görülmektedir.
Örneğin GALA testinde seçimlerin yaklaşık %67,6'sı Bull ajanına yönelmiştir. BTC/USDT testinde ise yaklaşık %64,8 Sideways ve %32,6 Rally ajanı seçilmiştir. ETH'te Pullback ajanının payı yaklaşık %43,9'dur. Bu değerler router'ın bütün piyasalarda aynı alt ajanı kullanmadığını göstermektedir.
Yöntem ve Bulgular
Veri kümeleri
| Trading Pair | Kaynakta verilen piyasa dinamiği | Saniye sayısı | Dönem |
|---|---|---|---|
| BTC/TUSD | Sideways | 4.057.140 | 30 Mart 2023 – 15 Mayıs 2023 |
| BTC/USDT | Sideways | 3.884.400 | 1 Eylül 2022 – 15 Ekim 2022 |
| ETH/USDT | Bear | 3.970.800 | 1 Mayıs 2022 – 15 Haziran 2022 |
| GALA/USDT | Bull | 3.970.740 | 1 Temmuz 2022 – 15 Ağustos 2022 |
Her veri kümesinde son 9 gün test, ondan önceki 9 gün validation ve daha eski veriler training için kullanılmıştır. Bu kronolojik ayrım gelecekteki test verisinin eğitim aşamasında doğrudan kullanılmasını önlemek amacı taşır.
Validation ile test dönemleri aynı değildi
Çalışma özellikle validation ve test market trendleri arasında önemli farklar oluşturmuştur. BTC/TUSD test setinde validation'da bulunmayan belirgin bir bear trend ortaya çıkmıştır. ETH/USDT'te fark daha da büyüktür: validation dönemindeki trend yükselirken test döneminde kaynak yaklaşık %30'luk bir düşüş bildirmektedir.
Bu durum EarnHFT'nin yalnız eğitim dönemine benzeyen piyasalarda değil market regime değişiminde de sınandığını göstermek için kullanılmıştır.
Karşılaştırılan yöntemler
EarnHFT dört RL ve iki rule-based baseline ile karşılaştırılmıştır: PPO, DRA, DQN, CDQNRP, MACD ve Imbalance Volume (IV). Böylece policy-based RL, value-based RL ve klasik piyasa göstergelerine dayanan yöntemler aynı deney içinde değerlendirilmiştir.
Değerlendirme ölçütleri
Altı finansal ölçüt kullanılmıştır: Total Return (TR), Annual Sharpe Ratio (ASR), Annual Calmar Ratio (ACR), Annual Sortino Ratio (ASoR), Annual Volatility (AVOL) ve Maximum Drawdown (MDD).
Total Return:
Annual Sharpe Ratio:
Calmar Ratio:
Sortino Ratio ise toplam volatilite yerine yalnız negatif return'ların downside deviation değerini risk ölçüsü olarak kullanır.
Ana performans sonuçları
| Piyasa | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) |
|---|---|---|---|---|---|---|
| BTC/USDT | 0,72 | 1,22 | 10,77 | 0,93 | 27,08 | 3,07 |
| BTC/TUSD | 0,99 | 1,34 | 7,76 | 1,01 | 32,40 | 5,61 |
| ETH/USDT | 4,52 | 2,92 | 14,30 | 1,78 | 67,92 | 13,89 |
| GALA/USDT | 19,41 | 9,77 | 79,08 | 7,79 | 74,94 | 9,26 |
EarnHFT dört veri kümesinin tamamında Total Return bakımından en yüksek sonucu elde etmiştir. Kaynak aynı zamanda dört veri kümesinin üçünde risk-adjusted profit ölçütlerinde en iyi performansın EarnHFT'ye ait olduğunu belirtmektedir.
BTC/TUSD bir istisnadır. Bu veri kümesinde DQN'nin bazı risk-adjusted metrikleri EarnHFT'den daha yüksektir; örneğin DQN için ASR 4,21 ve ACR 27,94 iken EarnHFT için aynı değerler 1,34 ve 7,76'dır. Dolayısıyla sistemin kâr üstünlüğü bütün metriklerde mutlak üstünlük anlamına gelmez.
ETH işlemi örneği
Kaynağın Şekil 2'sinde ETH üzerinde EarnHFT'nin açtığı bir pozisyonun yaklaşık 30 saniye içinde tekrar kapatıldığı bir örnek gösterilmektedir. Dakika ölçeğinde küçük bir pullback olarak görülebilecek fiyat hareketi, saniye düzeyindeki ajan tarafından kısa süreli trading fırsatı olarak kullanılmaktadır.
Bu örnek sistemin iki zaman ölçeğini neden ayırdığını görsel olarak gösterir: router daha geniş piyasa bağlamını seçerken düşük seviyeli ajan aynı dakika içindeki daha küçük fiyat hareketlerine yanıt verir.
Q-teacher gerçekten eğitimi hızlandırdı mı?
Ablation deneyinde Optimal Value Supervisor (OS) ve Optimal Actor'ın (OA) etkisi ayrı ayrı incelenmiştir.
GALA veri kümesinde normal DDQN yaklaşık 30.720 adımda yakınsarken yalnız OS kullanılan yapı 4.608 adımda yakınsamıştır. Bu, kaynağın ifadesiyle yaklaşık %15'i kadar eğitim adımı anlamına gelir. Converged reward sum aynı karşılaştırmada -0,01'den 2,89'a yükselmiştir.
OS ile OA birlikte kullanıldığında GALA reward sum 4,43'e ulaşmış, ancak convergence step 78.848 olmuştur. Bu sonuç optimal actor'ın getiriyi artırabilmesine rağmen daha fazla eğitim adımı gerektirebildiğini göstermektedir.
ETH'te yalnız OS convergence step'i baseline'a göre düşürmemiştir; her ikisi de 30.720 adım seviyesindedir. Buna karşın reward sum yaklaşık -29,6'dan 4,87'ye çıkmıştır. Her iki bileşen birlikte kullanıldığında kaynak 12,32 reward sum raporlamıştır.
Neden EarnHFT bazı risk ölçütlerinde daha zayıf?
Yazarların kendi açıklamasına göre Q-teacher ve optimal actor özellikle kârlı deneyimleri öğretmektedir. Risk cezası optimal supervision'a aynı ağırlıkla dahil edilmediğinden EarnHFT daha agresif trading davranışı gösterebilir.
Bu nedenle çalışmanın sonuçları “daha yüksek profit = daha düşük risk” şeklinde yorumlanmamalıdır. Örneğin GALA'da EarnHFT %19,41 total return ile en yüksek sonucu üretirken annual volatility değeri %74,94'tür ve daha düşük volatiliteye sahip alternatif modeller bulunmaktadır.
Eğitim altyapısı
Deneyler NVIDIA RTX 4090 GPU üzerinde yürütülmüştür. Kaynak dört veri kümesindeki bütün deneylerin yaklaşık 10 saat sürdüğünü belirtmektedir. EarnHFT'nin replay buffer boyutu \(10^6\), mini-batch size 512, learning rate \(5\times10^{-4}\), Q-teacher katsayısı \(\alpha=128\) ve soft-update katsayısı \(\tau=0.005\) olarak verilmiştir.
Komisyon oranındaki kaynak içi fark
Ana deney bölümünde BTC/TUSD için komisyon oranı 0, diğer veri kümeleri için %0,02 olarak yazılmıştır. Ek D.3'teki parameter table ise BTC/TUSD için 0, BTC/USDT, ETH/USDT ve GALA/USDT için %0,015 vermektedir.
Kaynak bu iki değerin farklı deneyler, farklı dönemler veya yazım hatası olup olmadığını açıklamamaktadır. Bu nedenle Verianla metni iki değerden birini “doğru değer” olarak seçmemektedir.
Teorik yakınsama
Ek C.2'de yazarlar Q-teacher supervisor ile değiştirilmiş Q-learning operatörünün sonlu bir MDP altında optimal action-value fonksiyonu \(Q^*\)'ya yakınsayacağını göstermek amacıyla matematiksel bir türetim sunmaktadır.
Yaklaşım önce \(Q^*\)'ın tanımlanan operatörün fixed point'i olduğunu, ardından operatörün sup-norm altında contraction olduğunu göstermeye çalışır. Bu sonuç çalışmanın teorik argümanıdır; deneysel sonuçlardan ayrı değerlendirilmelidir.
Çalışmanın desteklediği sonuçlar
Kaynak, farklı piyasa rejimlerinde uzmanlaşmış düşük seviyeli ajanlardan oluşan bir havuzun dakika düzeyinde bir router tarafından seçilmesinin, test edilen kripto veri kümelerinde tek ajanlı veya rule-based baseline'lara kıyasla daha yüksek toplam getiri üretebildiğini göstermektedir. Q-teacher'ın özellikle bazı veri kümelerinde eğitim verimliliğini ve converged reward'u artırdığı ablation deneyleriyle desteklenmektedir.
Çalışmanın desteklemediği sonuçlar
Sonuçlar EarnHFT'nin gerçek bir exchange üzerinde canlı para ile aynı getiriyi sağlayacağını göstermez. Çalışma simülasyon ortamındadır. Market impact, gerçek order latency, exchange queue priority, packet loss, API throttling, co-location, rakip HFT sistemlerinin reaksiyonu ve canlı piyasanın tüm execution belirsizlikleri deney ortamında eksiksiz biçimde temsil edilmemektedir.
Ayrıca dört seçilmiş kripto trading pair üzerindeki başarı bütün kripto varlıklara, hisse senetlerine, vadeli işlemlere veya farklı market-microstructure yapılarına otomatik olarak genellenemez.
Kaynak ve Yöntem Notu
Özgün çalışma: EarnHFT: Efficient Hierarchical Reinforcement Learning for High Frequency Trading.
Yazarlar: Molei Qin, Shuo Sun, Wentao Zhang, Haochong Xia, Xinrun Wang ve Bo An.
Kurum: Nanyang Technological University, Singapore.
Eşit katkı: Kaynak PDF, Molei Qin ve Shuo Sun'ı eşit katkı sağlayan yazarlar olarak işaretlemektedir.
arXiv: 2309.12891v1 [q-fin.TR].
arXiv tarihi: 22 Eylül 2023.
Kaynak üzerindeki yayın ibaresi: Copyright © 2024, Association for the Advancement of Artificial Intelligence (AAAI). Kaynak PDF dışında bibliyografik doğrulama yapılmadığından hakemlik/yayın durumu bundan ileri yorumlanmamıştır.
Yöntem türü: Yüksek frekanslı kripto trading için üç aşamalı hierarchical reinforcement learning; dinamik programlama tabanlı Q-teacher; DDQN; farklı piyasa trendlerinde uzmanlaştırılmış agent pool; dakika seviyesinde dynamic strategy router.
Düşük seviyeli zaman ölçeği: 1 saniye.
Yüksek seviyeli zaman ölçeği: 1 dakika.
Düşük seviyeli market representation: 60 saniyelik rolling OHLC + LOB penceresinden 54 özellik ve mevcut pozisyon.
Yüksek seviyeli market representation: 60 dakikalık rolling OHLC penceresinden 19 özellik ve mevcut pozisyon.
Eğitilen düşük seviyeli ajan sayısı: 200.
Trend preference parametreleri: \(\beta\in\{-90,-10,30,100\}\), her biri 50 epoch.
GPU: NVIDIA RTX 4090.
Toplam deney süresi: Kaynak yaklaşık 10 saat bildirmektedir.
Veri kümeleri: BTC/TUSD, BTC/USDT, ETH/USDT ve GALA/USDT saniyelik piyasa verileri.
Validation/test ayrımı: Son 9 gün test, önceki 9 gün validation, geri kalan geçmiş dönem training.
Karşılaştırmalar: PPO, DRA, DQN, CDQNRP, MACD ve Imbalance Volume.
Finansal ölçütler: Total Return, Annual Sharpe Ratio, Annual Calmar Ratio, Annual Sortino Ratio, Annual Volatility ve Maximum Drawdown.
Ana deneysel bulgu: EarnHFT dört test veri kümesinin tamamında en yüksek Total Return değerini ve üç veri kümesinde en güçlü risk-adjusted profit sonuçlarını raporlamaktadır.
Risk sınırlılığı: Yazarlar yöntemin Q-teacher ve optimal actor nedeniyle profit-oriented ve görece agresif olduğunu, bazı risk ölçütlerinde yalnız orta düzey performans verdiğini belirtmektedir.
Kaynak-içi tutarsızlık 1: Ana metindeki %0,02 komisyon oranı ile Ek D.3'teki %0,015 oranı uyuşmamaktadır.
Kaynak-içi tutarsızlık 2: Veri kümesi tablosu ETH/USDT'yi Bear olarak sınıflandırırken ablation açıklamasında bir yerde ETH için “market is bull” ifadesi kullanılmıştır. Aynı çalışmanın diğer bölümleri ETH test dönemini düşüş piyasası olarak tanımlamaktadır.
Temel sınırlılık: Deneyler yüksek doğruluklu bir simülasyon trading environment içinde gerçekleştirilmiştir; canlı üretim HFT sistemi üzerinde uçtan uca gerçek para trading performansı test edilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir