

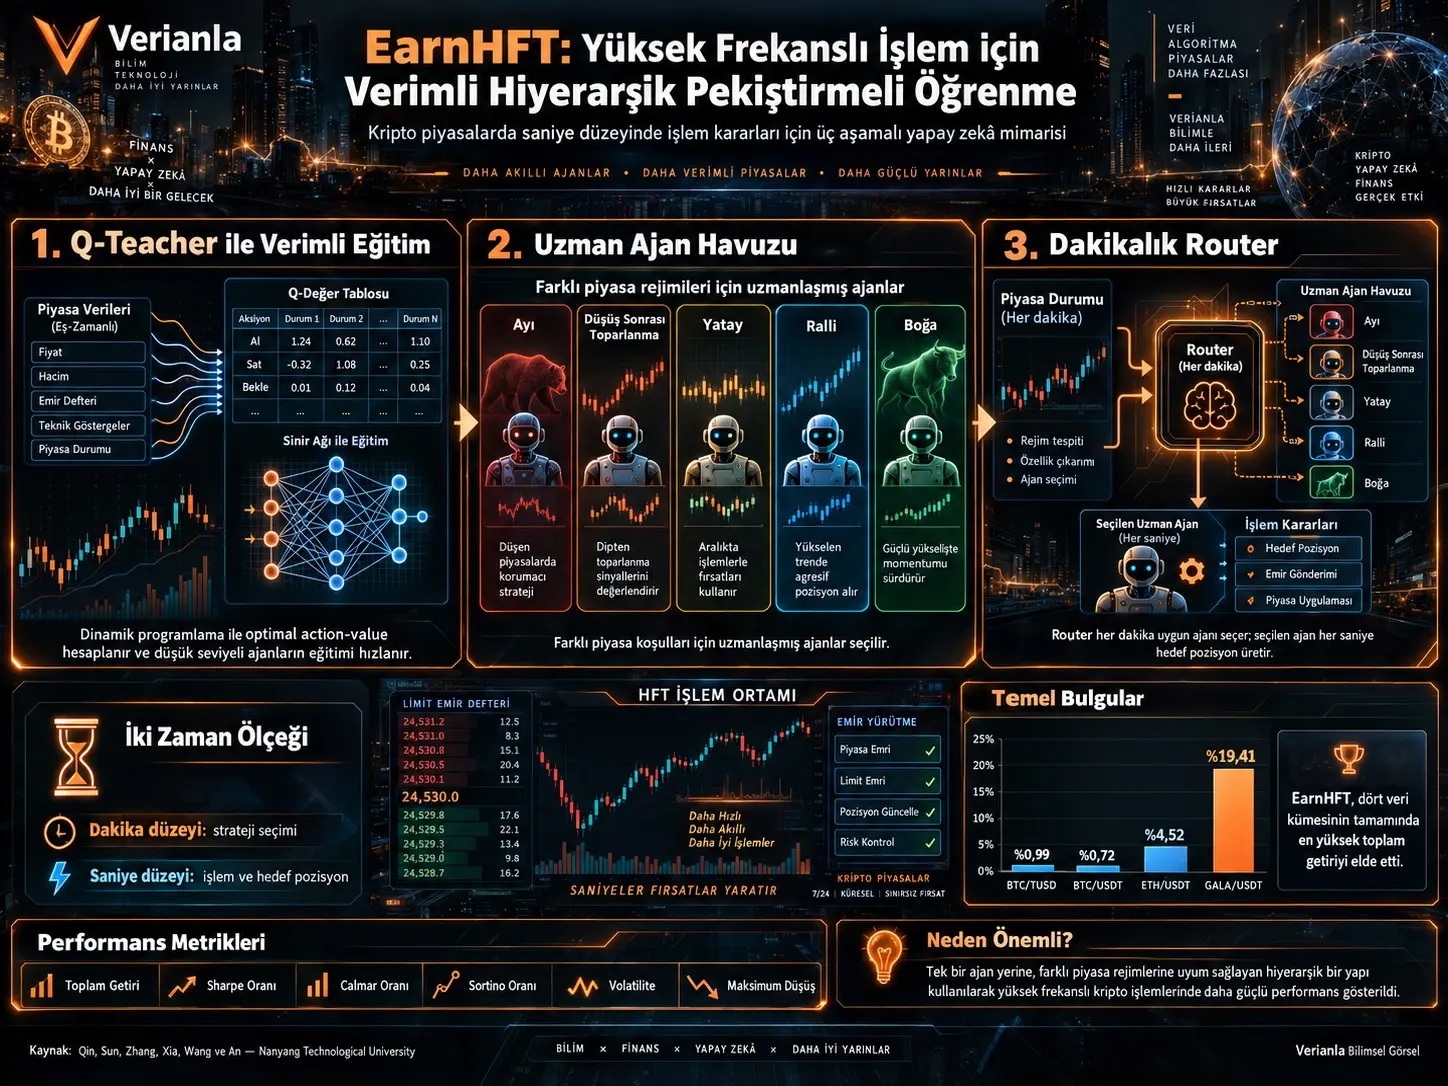
EarnHFT, kriptovalyuta bozorlarida soniya darajasida savdo qiladigan mustahkamlovchi o‘rganish agentlarining ikki asosiy muammosini hal qilish maqsadida ishlab chiqilgan uch bosqichli ierarxik mustahkamlovchi o‘rganish tizimidir. Birinchi muammo — yuqori chastotali savdoda o‘qitish trayektoriyalarining nihoyatda uzun bo‘lishidir. Tadqiqotdagi misolda atigi 12 kunlik soniyalik ma’lumot taxminan 1.036.800 ta qaror qadamini hosil qiladi; oylik miqyosda esa bu ko‘rsatkich millionlab qadamlarga yetishi mumkin. Ikkinchi muammo — kriptovalyuta bozorlarida bozor rejimlari tez o‘zgarishi sababli bitta agent o‘rgangan strategiya boshqa bozor sharoitida muvaffaqiyatsiz bo‘lishi mumkin.
EarnHFT bu muammolarni bitta umumiy trading agentini o‘qitish o‘rniga vazifalarni turli vaqt miqyoslariga ajratish orqali hal qiladi. Soniyalik darajadagi quyi darajali agentlar haqiqiy sotib olish-sotish qarorlarini va maqsadli pozitsiyani belgilaydi, daqiqalik darajadagi yuqori darajali router esa bozorning joriy makro xatti-harakatiga mos quyi darajali agentni tanlaydi. Shu tariqa tizim mikro bozor harakatlarini soniya darajasida qayta ishlarkan, trend o‘zgarishini daqiqa darajasida baholay oladi.
Birinchi bosqichda kelajakdagi narx ma’lumotidan foydalanib dinamik dasturlash orqali hisoblangan Q-teacher, quyi darajali DDQN agentiga faqat o‘zining sinov-xato tajribasini emas, balki ayni holatdagi muqobil harakatlarning hisoblangan optimal action-value ma’lumotini ham beradi. Ikkinchi bosqichda turli bull, bear, pullback, sideways va rally xatti-harakatlariga ixtisoslashishi ko‘zlangan yuzlab agentlar o‘qitiladi; ulardan turli bozor rejimlarida eng foydali bo‘lgan kichik qismigina strategiyalar havzasiga olinadi. Uchinchi bosqichda daqiqalik darajadagi DDQN router shu agentlardan birini tanlaydi va tanlangan agent keyingi bir daqiqa davomida soniyama-soniya maqsadli pozitsiya hosil qiladi.
BTC/TUSD, BTC/USDT, ETH/USDT va GALA/USDT ma’lumot to‘plamlarida o‘tkazilgan simulyatsiya tajribalarida EarnHFT to‘rtta bozorni ham test davrida eng yuqori umumiy daromad bilan yakunlagan. Umumiy daromadlar mos ravishda taxminan %0,99, %0,72, %4,52 va %19,41 deb xabar qilingan. Biroq usul har bir risk ko‘rsatkichida eng yaxshi emas; mualliflar EarnHFT profit-oriented Q-teacher tuzilishi sababli nisbatan agressiv trader ekanini va ayrim ma’lumot to‘plamlarida risk ko‘rsatkichlari o‘rta darajada qolganini aniq qayd etadi.
Nega odatiy mustahkamlovchi o‘rganish HFT uchun qiynaladi?
Mustahkamlovchi o‘rganishda agent joriy holatni kuzatadi, bir harakatni tanlaydi va shu harakat natijasida olgan mukofotga asoslanib siyosatini yaxshilaydi. Kunlik yoki soatlik trading muammolarida bitta o‘qitish trayektoriyasi nisbatan qisqa bo‘lishi mumkin. Yuqori chastotali savdoda esa model har soniyada bir qaror qilsa, muammo millionlab ketma-ket qadamlardan iborat bo‘ladi.
Tadqiqotda keltirilgan misol:
Bunday uzun horizon RL agentining ijobiy va salbiy xatti-harakatlarning uzoq muddatli ta’sirini o‘rganishini qiyinlashtiradi va o‘qitish uchun ancha ko‘proq tajriba talab qiladi.
Ikkinchi muammo non-stationary market dynamics holatidir. Kriptovalyuta bozorida bir xil mikro narx harakati turli makro bozor rejimlarida turli ma’noga ega bo‘lishi mumkin. Masalan, o‘sayotgan bozordagi qisqa muddatli narx pasayishi vaqtinchalik pullback bo‘lishi mumkin, pasayuvchi bozordagi o‘xshash harakat esa yanada katta tushishning davomi bo‘lishi mumkin. Shu sababli bitta siyosatning barcha bozor rejimlarida bir xil muvaffaqiyat ko‘rsatishi qiyinlashadi.
EarnHFT nega ierarxik tuzilishdan foydalanadi?
EarnHFT bozor ma’lumotini ikki xil vaqt miqyosiga ajratadi. Quyi darajali MDP soniya darajasidagi mikro bozor harakatlarini va savdo execution jarayonini modellashtiradi. Yuqori darajali MDP esa daqiqa miqyosida sekinroq o‘zgaradigan bozor trendlari va qaysi trading strategiyasidan foydalanilishini modellashtiradi.
Quyi darajali agent har soniyada maqsadli pozitsiya hosil qiladi, yuqori darajali router esa har daqiqada bitta quyi darajali agentni tanlaydi. Shu tariqa “hozir nechta coin ushlab turish kerak?” va “bu bozor rejimida qaysi trader ishlatilishi kerak?” qarorlari bir-biridan ajratiladi.
Quyi darajali holat qanday ma’lumotlarni o‘z ichiga oladi?
Quyi darajali state ikki asosiy tarkibiy qismdan iborat. Birinchisi soniyalik bozor ma’lumotidan olingan 54 ta texnik xususiyat, ikkinchisi esa agent tutib turgan joriy pozitsiyadir. Texnik xususiyatlar 60 soniyalik rolling window ichidagi OHLC ma’lumoti va Limit Order Book snapshot-laridan olinadi.
Action to‘g‘ridan-to‘g‘ri “buy” yoki “sell” yorlig‘i emas. Agent oldindan belgilangan chekli action pool ichidan bir maqsadli pozitsiya tanlaydi. Joriy pozitsiya maqsadli pozitsiyadan farq qilsa, farq miqdori market order orqali darhol sotib olinadi yoki sotiladi.
Yuqori darajali holat va action nima?
Yuqori darajali state 60 daqiqalik rolling OHLC window-dan olingan 19 ta makro xususiyat hamda joriy pozitsiyani o‘z ichiga oladi. Action esa to‘g‘ridan-to‘g‘ri pozitsiya emas, strategiyalar havzasidagi quyi darajali RL agentlaridan birini tanlashdir.
Router tanlagan agent bir daqiqa davomida ishlaydi va soniya darajasida maqsadli pozitsiya hosil qiladi. Router oladigan reward — shu bir daqiqa ichida tanlangan quyi darajali agent hosil qilgan net-value o‘zgarishidir.
Limit Order Book nega muhim?
EarnHFT simulyatsiyasi savdo faqat yopilish narxida amalga oshiriladi deb faraz qilmaydi. U Limit Order Book ichidagi bid va ask narxlaridan hamda shu darajalardagi mavjud miqdorlardan foydalanadi. Katta market order birinchi narx darajasidagi likvidlikdan oshsa, buyurtma keyingi narx darajalariga o‘tadi.
Manba market-order xarajatini tushuntirish uchun quyidagi tuzilishdan foydalanadi:
Bu yerda \(p_t^i\) tegishli order-book darajasining narxini, \(q_t^i\) o‘sha darajadagi miqdorni, \(R_{i-1}\) avvalgi darajalardan keyin qolgan buyurtma miqdorini va \(\sigma\) commission-fee nisbatini bildiradi.
Buning muhim natijasi shuki, komissiya nol bo‘lsa ham trading bepul bo‘lmaydi. Market order xaridda ask tomonini, sotuvda esa bid tomonini iste’mol qilgani sababli bid–ask spread o‘zi alohida savdo xarajati hosil qiladi.
I bosqich: Q-teacher qanday ishlaydi?
Oddiy RL agenti qaysi harakat yaxshi ekanini sinab ko‘rish orqali o‘rganadi. EarnHFT esa ishlatilgan simulyatsiya muhitida narx qatori agent harakatlaridan ta’sirlanmaydi degan farazdan foydalanadi. Kelajakdagi narxlar o‘qitish paytida ma’lum bo‘lgani uchun har bir vaqt–pozitsiya–action kombinatsiyasining optimal action-value qiymati dinamik dasturlash orqali orqaga qarab hisoblanishi mumkin.
Bu Q-jadval trading vaqtida ishlatilmaydi; o‘qitish vaqtida o‘qituvchi signali vazifasini bajaradi.
DDQNning odatiy temporal-difference xatosiga tarmoqning action-value taqsimoti bilan optimal action-value taqsimoti o‘rtasidagi Kullback–Leibler divergence qo‘shiladi:
TD komponenti:
Bu yerda maqsad agent faqat tanlagan action natijasini emas, ayni holatdagi boshqa action-larning nisbiy qiymatlarini ham o‘rganishini ta’minlashdir. Manbada \(\alpha\) o‘qitish davom etgani sari kamayuvchi koeffitsiyent sifatida qo‘llanadi.
Optimal Actor nima qo‘shadi?
Faqat Q-teacher dan foydalanish yetarli deb topilmagan. Agent optimal siyosatdan uzoqlashganda, u egallagan pozitsiya o‘zgargani sababli o‘qituvchi signali ham o‘zgarishi mumkin. Buni kamaytirish uchun EarnHFT ikkinchi tajriba manbasini yaratadi.
Bir tajriba guruhi odatiy \(\epsilon\)-greedy siyosat orqali agent tomonidan yaratiladi, boshqa guruh esa bevosita \(Q^*\) qiymatida maksimal action-ni tanlaydigan optimal actor tomonidan yaratiladi. Shu tariqa replay buffer ham izlanish vaqtida olingan o‘tishlarni, ham hisoblangan optimal siyosat hosil qilgan o‘tishlarni o‘z ichiga oladi.
II bosqich: Nega bitta agent o‘rniga yuzlab agentlar o‘qitiladi?
Tadqiqotning asosiy gipotezalaridan biri — bull market uchun yaxshi bo‘lgan siyosat bear market uchun ham shunchalik yaxshi bo‘lmasligi mumkin. Shu sababli o‘qitish ma’lumoti turli bozor trendlari vakili bo‘lgan bo‘laklarga ajratiladi va agentlar bu bo‘laklarni turli ehtimollar bilan ko‘rishi ta’minlanadi.
Ma’lumot to‘plami uch milliondan ortiq vaqt qadamiga ega multivariate time series bo‘limlaridan iborat. Har bir agent uchun afzallik parametri \(\beta\) o‘zgartiriladi. Buy-and-hold return yuqori yoki past bo‘lgan market segmentlarining sampling og‘irligi shu parametr bilan o‘zgartirilib, turli bozor rejimlariga ixtisoslashgan agentlar yaratishga urinish qilinadi.
Bozor segmentlari qanday belgilanadi?
Manba avval yuqori chastotali shovqinni low-pass filtering bilan kamaytiradi. So‘ng narx/net-value egri chizig‘idagi mahalliy yo‘nalish o‘zgarishlaridan segmentlar hosil qiladi. Qo‘shni segmentlar slope farqi va Dynamic Time Warping o‘xshashligi yetarlicha kichik bo‘lsa birlashtiriladi.
Keyin buy-and-hold return qiyaliklarining quantile qiymatlari yordamida segmentlar turli trend sinflariga ajratiladi. Tadqiqot tasvirlarida ishlatilgan besh toifa:
- Bear,
- Pullback,
- Sideways,
- Rally,
- Bull.
Har bir trend va boshlang‘ich pozitsiya uchun validation ma’lumotida eng yuqori o‘rtacha profitability qiymatini hosil qilgan agentlar tanlanadi. Shu tariqa yuzlab nomzodlarning hammasi router action space-ga berilmaydi; faqat kichik va xilma-xil strategiyalar havzasi saqlanadi.
Nechta agent o‘qitilgan?
Tadqiqotda sampling-preference parametri \(\beta\) uchun \(-90\), \(-10\), \(30\) va \(100\) qiymatlari ishlatilgan. Har bir qiymat 50 epoch ishlatilib, jami 200 ta quyi darajali agent hosil qilingan.
III bosqich: Router nima qiladi?
Router — DDQN asosidagi yuqori darajali agent. U har daqiqada joriy makro bozor holatini tekshiradi va agent pool ichidan bitta trader-ni tanlaydi.
Router soniya o‘rniga daqiqa darajasida qaror qilgani sababli high-level trajectory uzunligini:
nisbatda, ya’ni manba ifodasiga ko‘ra taxminan %98,33 kamaytiradi.
Router faqat joriy pozitsiyaga mos boshlang‘ich pozitsiyaga ega agentlarni baholagani uchun action space yanada kichrayadi. Mualliflar high-level bosqichda Q-teacher ishlatmagan; trayektoriya allaqachon sezilarli qisqargani va agent tanlash uchun optimal action-value hisoblash murakkabroq bo‘lgani sababli odatiy DDQNni samaraliroq deb hisoblaganlar.
Router haqiqatan ham bozor rejimiga qarab boshqacha ishlaydimi?
Manbada router tanlovlari taqsimoti to‘rtta test ma’lumot to‘plamida ko‘rib chiqilgan. Volatilligi pastroq BTC/TUSD va BTC/USDT ma’lumotlarida router tanlovi bir necha market-state agentlarida jamlangan bo‘lsa, ETH va GALA kabi o‘zgaruvchanroq bozorlarda tanlovlar besh bozor rejimi bo‘yicha muvozanatliroq taqsimlangan.
Masalan, GALA testida tanlovlarning taxminan %67,6 qismi Bull agentiga to‘g‘ri kelgan. BTC/USDT testida esa taxminan %64,8 Sideways va %32,6 Rally agenti tanlangan. ETHda Pullback agentining ulushi taxminan %43,9. Bu qiymatlar router barcha bozorlarda bir xil quyi agentdan foydalanmasligini ko‘rsatadi.
Usul va Natijalar
Ma’lumot to‘plamlari
| Trading Pair | Manbada berilgan bozor dinamikasi | Soniya soni | Davr |
|---|---|---|---|
| BTC/TUSD | Sideways | 4.057.140 | 30 Mart 2023 – 15 May 2023 |
| BTC/USDT | Sideways | 3.884.400 | 1 Sentyabr 2022 – 15 Oktyabr 2022 |
| ETH/USDT | Bear | 3.970.800 | 1 May 2022 – 15 Iyun 2022 |
| GALA/USDT | Bull | 3.970.740 | 1 Iyul 2022 – 15 Avgust 2022 |
Har bir ma’lumot to‘plamida oxirgi 9 kun test, undan oldingi 9 kun validation va undan avvalgi ma’lumotlar training uchun ishlatilgan. Bu xronologik ajratish kelajakdagi test ma’lumotidan o‘qitish bosqichida bevosita foydalanilmasligini ta’minlashga qaratilgan.
Validation va test davrlari bir xil emas edi
Tadqiqot validation va test bozor trendlari o‘rtasida sezilarli farqlar yaratgan. BTC/TUSD test setida validation davrida bo‘lmagan aniq bear trend paydo bo‘lgan. ETH/USDTda farq yanada katta: validation davrida trend ko‘tarilgan bo‘lsa, test davrida manba taxminan %30 pasayishni qayd etadi.
Bu holat EarnHFT faqat o‘qitish davriga o‘xshash bozorlarda emas, market regime o‘zgarishida ham sinovdan o‘tkazilganini ko‘rsatish uchun ishlatilgan.
Taqqoslangan usullar
EarnHFT to‘rtta RL va ikkita rule-based baseline bilan taqqoslangan: PPO, DRA, DQN, CDQNRP, MACD va Imbalance Volume (IV). Shu tariqa policy-based RL, value-based RL va klassik bozor ko‘rsatkichlariga asoslangan usullar bitta tajribada baholangan.
Baholash mezonlari
Oltita moliyaviy ko‘rsatkich ishlatilgan: Total Return (TR), Annual Sharpe Ratio (ASR), Annual Calmar Ratio (ACR), Annual Sortino Ratio (ASoR), Annual Volatility (AVOL) va Maximum Drawdown (MDD).
Total Return:
Annual Sharpe Ratio:
Calmar Ratio:
Sortino Ratio esa umumiy volatillik o‘rniga faqat manfiy return-larning downside deviation qiymatini risk o‘lchovi sifatida ishlatadi.
Asosiy natijalar
| Bozor | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) |
|---|---|---|---|---|---|---|
| BTC/USDT | 0,72 | 1,22 | 10,77 | 0,93 | 27,08 | 3,07 |
| BTC/TUSD | 0,99 | 1,34 | 7,76 | 1,01 | 32,40 | 5,61 |
| ETH/USDT | 4,52 | 2,92 | 14,30 | 1,78 | 67,92 | 13,89 |
| GALA/USDT | 19,41 | 9,77 | 79,08 | 7,79 | 74,94 | 9,26 |
EarnHFT to‘rtta ma’lumot to‘plamining hammasida Total Return bo‘yicha eng yuqori natijani olgan. Manba shuningdek to‘rtta ma’lumot to‘plamining uchtasida risk-adjusted profit mezonlarida eng yaxshi natija EarnHFTga tegishli ekanini bildiradi.
BTC/TUSD istisno. Bu ma’lumot to‘plamida DQNning ayrim risk-adjusted ko‘rsatkichlari EarnHFTdan yuqori; masalan, DQN uchun ASR 4,21 va ACR 27,94 bo‘lsa, EarnHFT uchun shu qiymatlar 1,34 va 7,76. Demak, tizimning daromad ustunligi barcha mezonlarda mutlaq ustunlik degani emas.
ETH savdosi misoli
Manbaning 2-rasmida ETH bo‘yicha EarnHFT ochgan pozitsiya taxminan 30 soniya ichida yana yopilgan misol ko‘rsatiladi. Daqiqa miqyosida kichik pullback bo‘lib ko‘rinadigan narx harakati soniya darajasidagi agent tomonidan qisqa muddatli trading imkoniyati sifatida ishlatilgan.
Bu misol tizim nima uchun ikki vaqt miqyosini ajratishini vizual ko‘rsatadi: router kengroq bozor kontekstini tanlar ekan, quyi darajali agent ayni daqiqa ichidagi kichikroq narx harakatlariga javob beradi.
Q-teacher haqiqatan o‘qitishni tezlashtirdimi?
Ablation tajribasida Optimal Value Supervisor (OS) va Optimal Actor (OA) ta’siri alohida o‘rganilgan.
GALA ma’lumot to‘plamida oddiy DDQN taxminan 30.720 qadamda yaqinlashgan bo‘lsa, faqat OS ishlatilgan tuzilma 4.608 qadamda yaqinlashgan. Bu manba ifodasiga ko‘ra taxminan %15 miqdoridagi o‘qitish qadamlari deganidir. Converged reward sum shu taqqoslashda -0,01 dan 2,89 gacha oshgan.
OS va OA birga ishlatilganda GALA reward sum 4,43 ga yetgan, ammo convergence step 78.848 bo‘lgan. Bu natija optimal actor daromadni oshira olsa ham ko‘proq o‘qitish qadamlarini talab qilishi mumkinligini ko‘rsatadi.
ETHda faqat OS convergence step-ni baselinega nisbatan kamaytirmagan; har ikkisi 30.720 qadam darajasida. Biroq reward sum taxminan -29,6 dan 4,87 gacha ko‘tarilgan. Ikkala komponent birga ishlatilganda manba 12,32 reward sum qayd etadi.
Nega EarnHFT ayrim risk ko‘rsatkichlarida kuchsizroq?
Mualliflarning izohiga ko‘ra Q-teacher va optimal actor ayniqsa foydali tajribalarni o‘rgatadi. Risk jazosi optimal supervision tarkibiga xuddi shu og‘irlikda kiritilmagani sababli EarnHFT ko‘proq agressiv trading xatti-harakatini ko‘rsatishi mumkin.
Shu sababli natijalar “yuqori profit = past risk” deb talqin qilinmasligi kerak. Masalan, GALAda EarnHFT %19,41 total return bilan eng yuqori natijani bergan bo‘lsa-da, annual volatility %74,94 va undan past volatillikka ega muqobil modellar mavjud.
O‘qitish infratuzilmasi
Tajribalar NVIDIA RTX 4090 GPUda o‘tkazilgan. Manba to‘rtta ma’lumot to‘plamidagi barcha tajribalar taxminan 10 soat davom etganini bildiradi. EarnHFT replay buffer hajmi \(10^6\), mini-batch size 512, learning rate \(5\times10^{-4}\), Q-teacher koeffitsiyenti \(\alpha=128\) va soft-update koeffitsiyenti \(\tau=0.005\) deb berilgan.
Komissiya nisbatidagi manba ichki tafovut
Asosiy tajriba bo‘limida BTC/TUSD uchun komissiya nisbati 0, boshqa ma’lumot to‘plamlari uchun %0,02 deb yozilgan. D.3 ilovasidagi parameter table esa BTC/TUSD uchun 0, BTC/USDT, ETH/USDT va GALA/USDT uchun %0,015 ni beradi.
Manba bu ikki qiymat turli tajribalar, turli davrlar yoki yozuv xatosi ekanini tushuntirmaydi. Shu sababli Verianla matni ulardan birini “to‘g‘ri qiymat” sifatida tanlamaydi.
Nazariy yaqinlashuv
C.2 ilovasida mualliflar Q-teacher supervisor bilan o‘zgartirilgan Q-learning operatori chekli MDP sharoitida optimal action-value funksiyasi \(Q^*\) ga yaqinlashishini ko‘rsatishga qaratilgan matematik hosila beradi.
Yondashuv avval \(Q^*\) belgilangan operatorning fixed point-i ekanini, so‘ng operator sup-norm ostida contraction ekanini ko‘rsatishga urinadi. Bu natija tadqiqotning nazariy argumentidir; eksperimental natijalardan alohida baholanishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
Manba turli bozor rejimlariga ixtisoslashgan quyi darajali agentlar havzasini daqiqa darajasidagi router tanlashi sinovdan o‘tkazilgan kripto ma’lumot to‘plamlarida bitta agentli yoki rule-based baseline-larga nisbatan yuqoriroq umumiy daromad berishi mumkinligini ko‘rsatadi. Q-teacher ayniqsa ayrim ma’lumot to‘plamlarida o‘qitish samaradorligi va converged reward-ni oshirgani ablation tajribalari bilan qo‘llab-quvvatlanadi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
Natijalar EarnHFT haqiqiy exchange-da real pul bilan ayni daromadni ta’minlashini ko‘rsatmaydi. Tadqiqot simulyatsiya muhitida. Market impact, haqiqiy order latency, exchange queue priority, packet loss, API throttling, co-location, raqobatchi HFT tizimlarining reaksiyasi va jonli bozorning barcha execution noaniqliklari tajriba muhitida to‘liq aks ettirilmagan.
Bundan tashqari, tanlangan to‘rtta kripto trading pairdagi muvaffaqiyat barcha kripto aktivlar, aksiyalar, fyucherslar yoki boshqa market-microstructure tuzilmalariga avtomatik tatbiq etilmaydi.
Manba va Usul Izohi
Asl ish: EarnHFT: Efficient Hierarchical Reinforcement Learning for High Frequency Trading.
Mualliflar: Molei Qin, Shuo Sun, Wentao Zhang, Haochong Xia, Xinrun Wang va Bo An.
Tashkilot: Nanyang Technological University, Singapore.
Teng hissa: Manba PDF Molei Qin va Shuo Sunni teng hissa qo‘shgan mualliflar sifatida belgilaydi.
arXiv: 2309.12891v1 [q-fin.TR].
arXiv sanasi: 22 Sentyabr 2023.
Manbadagi nashr qaydi: Copyright © 2024, Association for the Advancement of Artificial Intelligence (AAAI). Manba PDFdan tashqari bibliografik tekshiruv qilinmagani sababli hakamlik/nashr holati bundan ortiq talqin qilinmagan.
Usul turi: Yuqori chastotali kripto trading uchun uch bosqichli hierarchical reinforcement learning; dinamik dasturlash asosidagi Q-teacher; DDQN; turli bozor trendlariga ixtisoslashgan agent pool; daqiqa darajasidagi dynamic strategy router.
Quyi darajali vaqt miqyosi: 1 soniya.
Yuqori darajali vaqt miqyosi: 1 daqiqa.
Quyi darajali market representation: 60 soniyalik rolling OHLC + LOB oynasidan 54 xususiyat va joriy pozitsiya.
Yuqori darajali market representation: 60 daqiqalik rolling OHLC oynasidan 19 xususiyat va joriy pozitsiya.
O‘qitilgan quyi darajali agentlar soni: 200.
Trend preference parametrlari: \(\beta\in\{-90,-10,30,100\}\), har biri 50 epoch.
GPU: NVIDIA RTX 4090.
Umumiy tajriba davomiyligi: Manba taxminan 10 soat deb bildiradi.
Ma’lumot to‘plamlari: BTC/TUSD, BTC/USDT, ETH/USDT va GALA/USDT soniyalik bozor ma’lumotlari.
Validation/test ajratilishi: Oxirgi 9 kun test, oldingi 9 kun validation, qolgan oldingi davr training.
Taqqoslashlar: PPO, DRA, DQN, CDQNRP, MACD va Imbalance Volume.
Moliyaviy ko‘rsatkichlar: Total Return, Annual Sharpe Ratio, Annual Calmar Ratio, Annual Sortino Ratio, Annual Volatility va Maximum Drawdown.
Asosiy eksperimental natija: EarnHFT to‘rtta test ma’lumot to‘plamining barchasida eng yuqori Total Return va uchta ma’lumot to‘plamida eng kuchli risk-adjusted profit natijalarini qayd etadi.
Risk cheklovi: Mualliflar usul Q-teacher va optimal actor sababli profit-oriented va nisbatan agressiv ekanini, ayrim risk ko‘rsatkichlarida faqat o‘rta darajadagi natija berganini ta’kidlaydi.
Manba ichki nomuvofiqlik 1: Asosiy matndagi %0,02 komissiya nisbati D.3 ilovasidagi %0,015 nisbati bilan mos kelmaydi.
Manba ichki nomuvofiqlik 2: Ma’lumot to‘plami jadvali ETH/USDTni Bear deb tasniflasa, ablation izohining bir joyida ETH uchun “market is bull” iborasi ishlatilgan. Shu tadqiqotning boshqa bo‘limlari ETH test davrini pasayuvchi bozor sifatida tasvirlaydi.
Asosiy cheklov: Tajribalar yuqori aniqlikdagi simulyatsiya trading environment ichida o‘tkazilgan; jonli ishlab chiqarish HFT tizimida uchdan-uchgacha real pul trading ko‘rsatkichi sinovdan o‘tkazilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan