

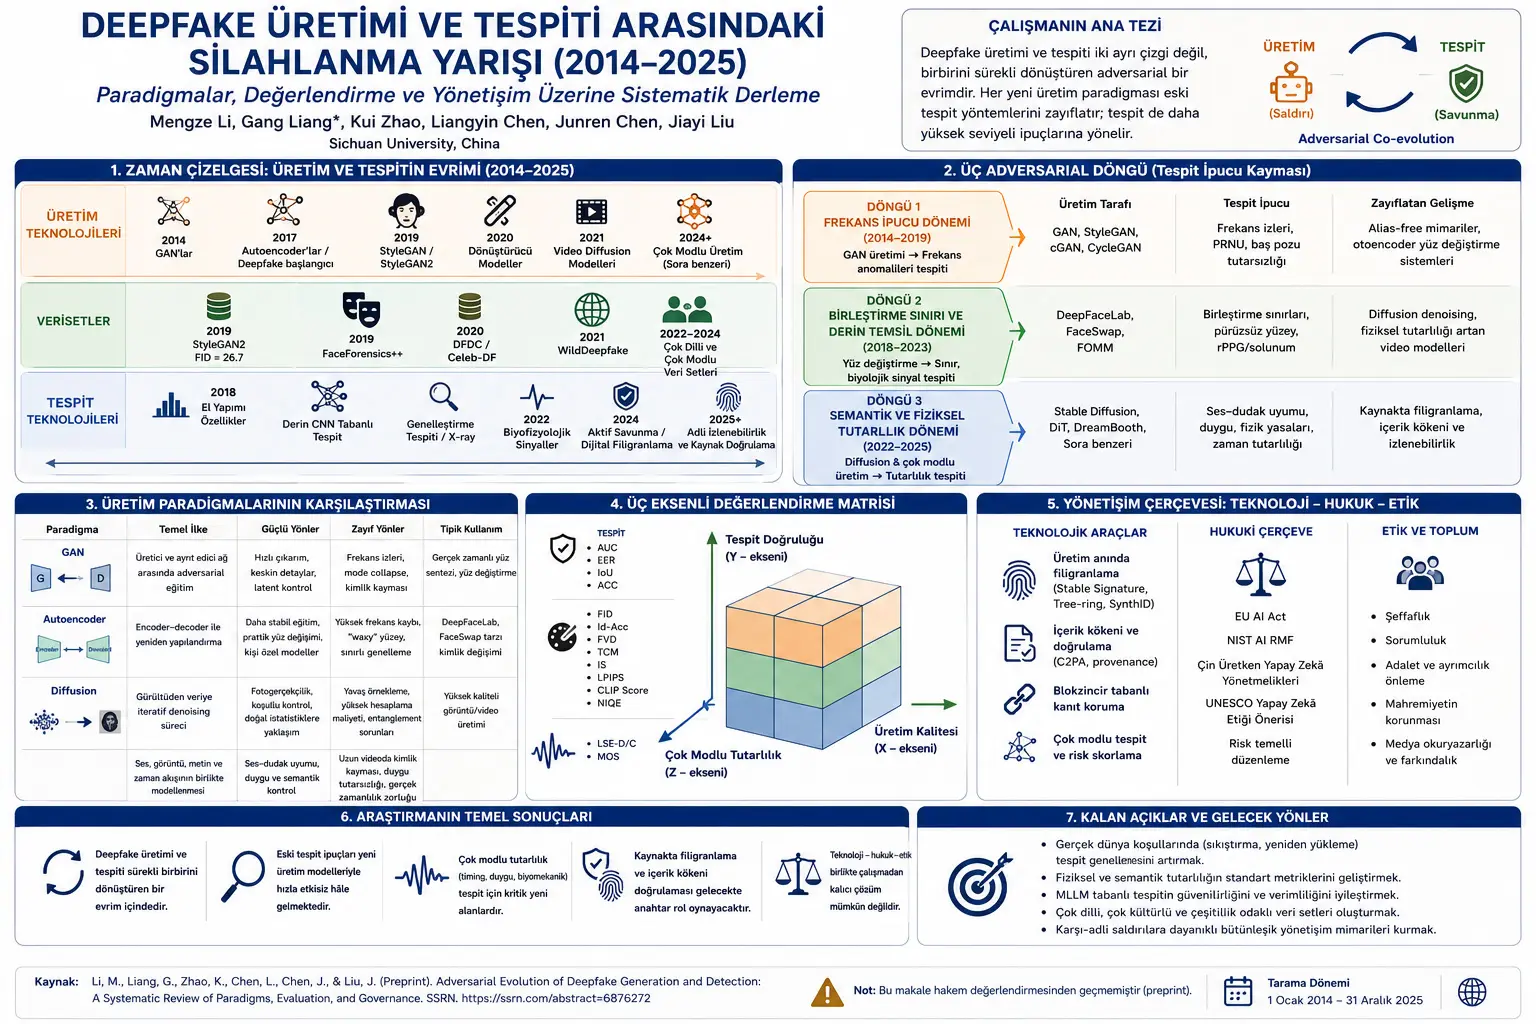
Teknolojia ya deepfake ni mchakato wa kutengeneza au kubadilisha picha, video, sauti au mchanganyiko wa hivi kwa kutumia mitandao ya kina ya neva ili vionekane kuwa halisi. Kwa mtazamo wa kwanza, mada hii inaweza kuonekana kuwa ni video za sura bandia tu au maudhui yaliyobadilishwa yanayosambaa kwenye mitandao ya kijamii. Hata hivyo, utafiti unasisitiza kwamba teknolojia ya deepfake sasa imepanuka kutoka ukiukaji wa faragha ya mtu binafsi hadi eneo kubwa zaidi la hatari. Hotuba bandia za kisiasa, ulaghai wa kifedha kupitia uigaji wa sauti, kudhoofika kwa imani ya umma, hatari kwa usalama wa taifa, matatizo ya uthibitishaji wa vyombo vya habari na uaminifu wa ushahidi wa kidijitali ni miongoni mwa athari za moja kwa moja za eneo hili.
Hoja ya kuanzia ya makala ni kutokulingana kwa kimuundo kati ya ubora wa uzalishaji wa deepfake na uwezo wa mifumo ya kutambua deepfake kufanya generalization. Kadiri modeli za uzalishaji zinavyozidi kuwa halisi, zinazodhibitika na za multimodal, mifumo ya utambuzi mara nyingi hubaki ikitegemea ishara zilizojifunza kwenye seti za data za awali. Matokeo ya Deepfake-Eval-2024 yaliyonukuliwa katika utafiti yanaweka pengo hili wazi: Mifumo ya kisasa ya utambuzi iliyofunzwa kwenye seti za data za awali ilipojaribiwa kwenye maudhui halisi ya deepfake yaliyokusanywa kutoka mitandao ya kijamii mwaka 2024, ilionyesha takribani kupungua kwa 50% katika thamani za AUC. Kushuka kukubwa zaidi kuonekana katika mifano inayotegemea diffusion kunaonyesha kwa uwazi kwa nini vidokezo vya zamani vya utambuzi vimedhoofika dhidi ya modeli mpya za uzalishaji.
Dhana muhimu hapa ni AUC, yaani Area Under the ROC Curve. AUC hupima uwezo wa modeli ya utambuzi kutenganisha mifano halisi na bandia katika viwango tofauti vya uamuzi. Kwa lugha rahisi, huangalia jinsi modeli inavyopanga kwa uaminifu swali la “halisi au bandia?”. Kupungua kwa AUC kunamaanisha kwamba vidokezo ambavyo modeli ilijifunza katika mazingira ya awali havifanyi kazi kwa ufanisi uleule katika mazingira mapya. Tatizo linalosisitizwa na utafiti ndilo hili hasa: Mafanikio ya juu yanayoonekana katika seti za data za maabara hayahifadhiwi kwa kiwango kilekile kwenye maudhui ya mitandao ya kijamii yaliyobanwa, kukatwa, kupakiwa upya na kutengenezwa kwa modeli tofauti za uzalishaji.
Makala inaeleza kwamba mapitio mengi yaliyopo huelezea uzalishaji na utambuzi kama mistari miwili sambamba lakini tofauti. Hata hivyo, kwa mujibu wa waandishi, mienendo halisi ya eneo hili ni ya mzunguko. Mfumo wa utambuzi hupata alama; modeli ya uzalishaji hupunguza alama hiyo; mfumo wa utambuzi huhamia kwenye alama ya kiwango cha juu zaidi. Kwa sababu hii, mfumo mkuu unaopendekezwa na utafiti ni adversarial evolution, yaani mageuzi ambapo upande wa mashambulizi na upande wa ulinzi hubadilishana na kuunda upya kila mmoja kila wakati.
Moja ya dhana muhimu zaidi katika utafiti ni cue drift, yaani kuhama kwa kidokezo cha utambuzi. Katika utambuzi wa deepfake, “cue” ni alama au ishara inayosaidia kugundua maudhui bandia. Ishara hii wakati mwingine inaweza kuwa muundo bandia katika eneo la frequency, mpaka wa kuchanganya kwenye ukingo wa uso, kuvurugika kwa ishara ya mtiririko wa damu, kutolingana kati ya sauti na mwendo wa midomo, au mwendo wa kimwili katika video usioendana na ulimwengu halisi. “Cue drift” ni kuhama kwa ishara hizi kadiri modeli za uzalishaji zinavyoendelea. Ikiwa mfumo wa utambuzi unategemea sana kidokezo cha kizazi fulani, ulinzi hudhoofika pale modeli mpya ya uzalishaji inapokiondoa.
Utafiti unagawa kipindi cha 2014–2025 katika mizunguko mitatu mikuu ya vidokezo vya utambuzi. Mzunguko wa kwanza ni frequency-cue era, yaani kipindi cha kidokezo cha frequency. Kipindi hiki kinahusisha takribani 2014–2019 na kinahusishwa hasa na uzalishaji unaotegemea GAN. Modeli za GAN hutumia michakato fulani ya upsampling wakati wa kuzalisha picha. Michakato hii inaweza kuunda alama za frequency ambazo hazipo katika picha zilizopigwa na kamera ya kawaida. Mifumo ya utambuzi katika kipindi hiki ilijaribu kugundua maudhui bandia kwa kuangalia eneo la frequency la picha.
Moja ya alama muhimu za kiufundi katika kipindi hiki ni mifumo ya mara kwa mara inayotengenezwa na transposed convolution. Utafiti unataja alama kama mkusanyiko wa nishati katika maeneo ya frequency ya takribani (±0.25, ±0.25) katika picha za GAN. Alama hizi ni tofauti na mifumo ya asili inayotokana na kamera na sensa katika picha za kawaida. Kwa mfano wa kila siku, inaweza kufikiriwa kama kitambaa halisi chenye kutokamilika kwa asili katika ufumaji, ilhali muundo bandia uliotoka mashineni unaacha mistari midogo inayojirudia. Mifumo ya utambuzi inayotegemea frequency huangalia mifumo hii isiyoonekana badala ya uso wa picha.
Operesheni ya msingi inayohusiana na uchambuzi wa frequency inaelezwa katika utafiti kwa uhusiano huu:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Katika fomula hii F(u,v) ni uwakilishi wa picha katika eneo la frequency. r inaonyesha radius katika eneo la frequency; θ inaonyesha mwelekeo wa pembe. P(r) hutengeneza profaili ya nishati ya radial yenye dimension moja kwa kuchukua wastani wa nishati ya frequency katika mwelekeo tofauti. Maana ya fomula ni hii: hupimwa ni maeneo gani ya frequency ya picha yanabeba mkusanyiko wa nishati usio wa asili. Ikiwa katika picha za bandia zinazotegemea GAN kuna vilele bandia katika maeneo fulani ya frequency, hili linaweza kutumika kwa utambuzi.
Hata hivyo, mzunguko huu wa kwanza pia una kikomo. Kadiri usanifu wa GAN unavyoendelea, hasa mikabala ya alias-free kama StyleGAN3, alama hizi za frequency huanza kupungua. Aidha, mifumo ya kubadilisha uso inahamia kutoka kutengeneza uso kutoka sifuri pekee hadi kuweka uso mmoja juu ya video ya mwingine. Kwa hivyo, alama ya kughushi huhama kutoka eneo la frequency kwenda kwenye mipaka ambako uso umeunganishwa na kwenye uthabiti wa kibayolojia katika muda.
Mzunguko wa pili ni blending-boundary and deep-representation era, yaani kipindi cha mpaka wa kuchanganya na uwakilishi wa kina. Kipindi hiki kinajitokeza hasa katika takribani 2018–2023. Mifumo ya autoencoder au face reenactment kama DeepFaceLab, FaceSwap na First Order Motion Model ni muhimu katika muktadha huu. Mifumo hii mara nyingi huweka utambulisho wa mtu mmoja juu ya mwendo wa uso mwingine au video lengwa. Kwa sababu eneo la uso linaunganishwa kwenye fremu lengwa, alama kama mpaka, masking, kutolingana kwa rangi, ulaini kupita kiasi na kuvurugika kwa kibiolojia zinaweza kubaki kuzunguka uso au katika texture yake.
Mifumo ya kubadilisha uso inayotegemea autoencoder kwa kawaida hufanya kazi kwa mantiki ya shared encoder–independent decoder. Encoder ya pamoja hutoa vipengele vya kimuundo visivyo vya utambulisho kama pose, expression na mwangaza; decoder tofauti hutengeneza upya texture ya uso ya utambulisho chanzo na lengwa. Kielelezo 7 katika utafiti inaonyesha mekanizimu hii kwa mchoro. Mkabala huu hupunguza baadhi ya kutokuwa thabiti kwa mafunzo ya GAN na hurahisisha kubadilisha uso. Hata hivyo, hasara ya reconstruction katika kiwango cha pikseli inaweza kulainisha maelezo ya frequency ya juu ya texture ya uso. Hili linashughulikiwa katika utafiti kama mwonekano “waxy”, yaani laini kama nta.
Mbinu za utambuzi katika kipindi hiki hujaribu kupata mipaka ambako uso bandia umebandikwa kwenye fremu lengwa. Mbinu kama Face X-ray na Self-Blended Images hujaribu ku-model moja kwa moja mpaka wa kuchanganya unaobaki katika mchakato wa face swap. Aidha, mikabala kama FakeCatcher hujaribu kutoa ishara za remote photoplethysmography, yaani fotopletismografia ya mbali/rPPG, zinazohusiana na mapigo ya moyo kutoka mabadiliko madogo sana ya rangi katika ngozi ya uso. Katika uso halisi wa binadamu, mtiririko wa damu na rangi ya ngozi hubeba ritimu ya kibayolojia kwa muda; katika video bandia ritimu hii mara nyingi haihifadhiwi vizuri.
Mzunguko wa tatu ni semantic and physical-consistency era, yaani kipindi cha uthabiti wa semantiki na kimwili. Kipindi hiki kinahusishwa na modeli za diffusion, mifumo mikubwa ya uzalishaji wa video na mikabala ya multimodal katika 2022–2025. Mifumo kama Stable Diffusion, DiT, DreamBooth na Sora hutoa kiwango cha juu zaidi cha uhalisia, udhibiti wa masharti na uthabiti wa mwonekano wa kimwili katika uzalishaji wa picha na video. Katika hatua hii, alama za frequency, mipaka rahisi ya blending au anomalies za pikseli moja moja zinaweza kutotosha kwa utambuzi.
Modeli za diffusion kimsingi hutumia mchakato wa denoising unaosonga kutoka kelele kwenda kwenye data. Modeli hujifunza kwanza mchakato wa kuongeza kelele hatua kwa hatua kwenye data, kisha hugeuza mchakato huu na kuzalisha picha au video yenye maana kutoka kelele. Msingi wa probabilistic wa modeli za diffusion katika utafiti unatolewa kwa uhusiano huu wa ELBO:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Katika fomula hii x0 inawakilisha mfano halisi/wa data, xT hali ya mwisho yenye kelele, q(xt|xt-1) mchakato wa kuongeza kelele mbele, na pθ(xt-1|xt) mchakato wa modeli wa kurudi nyuma kwa kuondoa kelele na kukaribia data. θ inaonyesha parameta za modeli. Kiufundi, usemi huu unaeleza kwamba badala ya kukokotoa moja kwa moja usambazaji wa data halisi, modeli hujaribu kuujifunza kupitia lower bound.
Katika mafunzo ya vitendo, lengo hili tata linaweza kupunguzwa kuwa hasara ya kutabiri kelele kama ilivyoonyeshwa na Ho na wenzake. Fomula rahisi ya loss iliyotolewa katika utafiti ni:
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Katika fomula hii ε ni kelele halisi iliyoongezwa kwenye data; εθ ni kelele inayotabiriwa na modeli; t ni hatua ya muda/kelele; \bar{α}t ni mgawo unaobainisha ratiba ya kelele; x0 ni mfano safi wa data mwanzoni. Kwa lugha rahisi, modeli hujifunza swali “ni kelele gani ilikuwa imeongezwa kwenye picha hii?”. Ikijifunza kulijibu vizuri, inaweza kwenda kinyume na kuzalisha picha halisi kutoka kelele.
Sehemu ngumu zaidi ya modeli za diffusion kwa upande wa utambuzi ni kwamba mchakato wa uzalishaji unaweza kukaribia sana takwimu za picha halisi. Vilele bandia vilivyoonekana kwenye eneo la frequency wakati wa GAN vinaweza kuwa dhaifu zaidi katika matokeo ya diffusion. Katika uzalishaji wa video pia, modeli kama Sora zinaweza ku-model vizuri zaidi mwendo, mwanga, mwingiliano wa kimwili na utegemezi wa mbali kupitia spatial-temporal patching na usanifu wa DiT. Hii husogeza utambuzi kutoka kiwango cha pikseli kwenda kiwango cha juu zaidi: Je, video inafuata sheria za fizikia? Je, sauti na mwendo wa midomo vinalingana kweli? Je, toni ya kihisia ya sauti inaendana na uso? Je, kivuli, chanzo cha mwanga na mwelekeo wa mwendo ni sehemu ya ulimwengu uleule wa kimwili?
Makala inachukulia eneo la deepfake ya multimodal kama kizingiti muhimu tofauti. Katika vipindi vya mwanzo, kughushi kulikuwa zaidi kwenye picha za uso. Kisha mifumo ya kuoanisha mwendo wa midomo na sauti ikaendelea. Mifumo kama Wav2Lip imekuwa yenye nguvu sana katika kutengeneza mwendo wa midomo unaolingana na sauti ya hotuba. Baadaye, talking-head models zinazotegemea NeRF na diffusion zikaanza kuzalisha pamoja expression ya uso, mwendo wa mdomo, toni ya sauti na uthabiti wa utambulisho. Leo na katika siku za karibu, hatari si video bandia pekee; ni kutengeneza kwa pamoja sauti bandia, uso bandia, lugha ya mwili bandia, hisia bandia na hali bandia ya hotuba inayolingana na muktadha.
Kwa sababu hii, utafiti unajadili kughushi kwa multimodal katika viwango vitatu: temporal synchronisation, yaani ulinganifu wa wakati; emotional consistency, yaani uthabiti wa hisia; na biomechanical consistency, yaani uthabiti wa biomekanika. Katika hotuba halisi, mwendo wa midomo, mwanzo wa sauti, ritimu ya kupumua, misuli ya uso, mwendo wa macho, intonation na nguvu ya hisia si huru kutoka kwa kila mmoja. Hata maudhui bandia yanapoonekana halisi sana, yanaweza kuacha kutolingana kidogo katika moja ya tabaka hizi.
Kwa mfano, mkengeuko wa zaidi ya milisekunde 40–60 kati ya sauti na mwendo wa midomo unaweza kuleta hisia isiyo ya asili kwa mtazamaji. Vilevile, ikiwa uso wa mtu unaonekana unatabasamu lakini toni ya sauti ina kilio au hofu, kutolingana kwa hisia hutokea. Kufungwa kwa midomo na namna ya kutamka katika lugha tofauti pia ni muhimu. Utafiti unaeleza kwamba uhusiano wa fonimu–viseme katika lugha kama Kichina na Kiingereza unaweza kuwa kidokezo cha utambuzi wa deepfake. Hii ina maana kwamba mifumo ya utambuzi inapaswa kutumia si uchakataji wa picha pekee, bali pia maarifa ya lugha, fonetiki, mwendo wa mwili na biolojia ya binadamu.
Sehemu ya mbinu ya utafiti inaonyesha kwamba mapitio haya hayakuundwa kwa vyanzo vilivyochaguliwa kiholela. Watafiti walitumia protokali iliyorekebishwa kwa PRISMA. IEEE Xplore, ACM Digital Library, Web of Science na arXiv zilitafutwa. Maneno ya utafutaji yaliundwa katika makundi matatu: maneno ya uzalishaji, maneno ya utambuzi na maneno ya modality. Upande wa uzalishaji ulijumuisha deepfake, face forgery, face swap, talking head, diffusion model, GAN na autoencoder; upande wa utambuzi ulijumuisha detection, forensics, authentication na anti-spoofing; upande wa modality ulijumuisha image, video, audio na multimodal.
Mtiririko wa PRISMA unaonyeshwa katika Kielelezo 2. Katika utafutaji wa kwanza, rekodi 1.486 zilipatikana. Baada ya kuondoa rekodi 312 zilizojirudia, rekodi 1.174 zilipitiwa kwa vichwa na muhtasari. Rekodi 627 ziliondolewa kwa kuwa nje ya mada. Maandishi kamili 547 yaliyobaki yalitathminiwa kwa ustahiki na tafiti 211 zikaingizwa katika usanisi wa ubora. Kati ya tafiti hizi 211, 83 ziliainishwa kuwa za mbinu za uzalishaji, 75 za mbinu za utambuzi, 31 za seti za data na tathmini, na 22 za utawala, maadili na sera. Nambari hizi zinaonyesha kwamba utafiti haujumuishi modeli za kiufundi pekee, bali pia vipengele vya seti za data na utawala.
Utafiti unaeleza hasa kwamba haukufanya meta-analysis. Sababu ni kwamba tafiti zilizojumuishwa ni heterogeneous kwa upande wa seti za data, itifaki za tathmini, kiwango cha compression, mbinu za kukata uso, sampling rates na aina za kuripoti. Kwa hiyo, watafiti hawakujaribu kuhesabu effect size moja ya pamoja. Badala yake walifanya thematic synthesis na katika kila mzunguko waliangalia mambo matatu: ni mbinu zipi za uzalishaji zinazotawala, mbinu hizi zinaacha alama zipi au zinaficha alama zipi za zamani, na mbinu za utambuzi zinafanyaje alama hizi kuwa operesheni za kupima.
Ulinganisho wa teknolojia za uzalishaji katika utafiti pia ni muhimu. GAN, autoencoder na diffusion si vizazi vinavyobadilishana kwa mlolongo kamili; katika vipindi vingi vimefanya kazi sambamba. GAN zinaweza kuwa na faida katika inference ya haraka na maelezo makali ya picha, lakini zina matatizo kama alama za frequency na kutokuwa thabiti kwa mafunzo. Mifumo ya autoencoder hutoa face swap yenye uthabiti zaidi na inayofanya kazi kwa vitendo, lakini inaweza kusababisha kulainika kwa texture ya uso na kupotea kwa maelezo ya frequency ya juu. Modeli za diffusion hutoa uhalisia mkubwa na conditional control, lakini zinaweza kuwa polepole na gharama kubwa ya kompyuta kwa sababu ya iterative sampling. Mifumo ya multimodal inalenga uthabiti wa pamoja wa sauti, picha, maandishi na muda; hata hivyo, identity drift katika video ndefu, kutolingana kwa hisia na changamoto za uzalishaji wa real-time bado ni muhimu.
Sehemu ya evaluation metrics inaonyesha kwamba namba moja ya mafanikio haitoshi katika utafiti wa deepfake. Upande wa utambuzi hutumia vipimo kama AUC, EER, IoU na ACC. Upande wa ubora wa uzalishaji hutumia FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score na NIQE. Upande wa uthabiti wa multimodal una LSE-D/C na MOS. Matrix ya mhimili mitatu inayopendekezwa na utafiti inakusanya vipimo hivi katika mfumo mmoja.
EER, yaani Equal Error Rate, inaonyesha threshold ambako false acceptance na false rejection rates zinakuwa sawa. Ni muhimu katika muktadha wa forensic na biometrics kwa sababu kukubali maudhui bandia kama halisi na kufikiri maudhui halisi ni bandia ni hatari tofauti lakini kubwa. IoU, yaani Intersection over Union, hupima kiasi ambacho eneo linalodhaniwa kuwa bandia linapishana na eneo bandia lenye ground truth. Hili linahitajika kujibu si tu “video ni bandia” bali “kughushi kuko eneo gani la picha?”.
Katika vipimo vya ubora wa uzalishaji, FID hupima jinsi picha zilizozalishwa zinavyofanana na usambazaji wa picha halisi. Id-Acc huangalia kama utambulisho lengwa unalindwa katika matumizi kama face swap. FVD inaweza kufikiriwa kama toleo la video la FID na huzingatia uthabiti wa muda. TCM hupima matatizo kama flicker au kutetemeka kwa kugundua kutolingana kwa optical flow kati ya fremu. Upande wa multimodal, LSE-D/C huonyesha ulinganifu kati ya mwendo wa midomo na sauti ya hotuba; MOS huonyesha alama ya uhalisia inayoonekana kwa tathmini ya binadamu.
Sehemu ya seti za data pia inaonyesha jinsi eneo la deepfake lilivyopanuka. Katika vipindi vya mwanzo, seti ndogo za video kama UADFV na DF-TIMIT zilitumika. Baadaye, seti kubwa na ngumu zaidi kama FaceForensics++, Celeb-DF, DFDC na WildDeepfake zikatokea. Upande wa picha, CelebA-HQ, FFHQ, seti za PGGAN/StyleGAN na seti za kipindi cha diffusion kama Fake2M zinajitokeza. Upande wa multimodal, seti kama FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake na DDL hujaribu kujibu mahitaji kama audio–video deepfake, hotuba ya lugha nyingi, manipulation ya eneo dogo na label za kina.
Kila moja ya seti hizi za data hufanya tatizo tofauti lionekane. FaceForensics++ ni yenye nguvu kwa benchmarking ya kawaida, lakini inaweza kuwa na kikomo kwa forgeries za kizazi kipya zenye uhalisia mkubwa. Celeb-DF hujaribu kughushi iliyosafishwa zaidi. DFDC hutoa usambazaji tata na wa kweli kwa kiwango cha viwanda. WildDeepfake inaakisi ugumu wa maudhui heterogeneous yanayosambaa mtandaoni. LAV-DF hutathmini hali ambapo sehemu fupi tu ya video imebadilishwa. MADD na KoDF huenda nje ya seti zinazolenga Kiingereza na kuleta masuala ya lugha nyingi na tamaduni tofauti.
Sehemu ya utawala ni moja ya sehemu muhimu zaidi zinazovuka mapitio ya kiufundi. Kwa mujibu wa waandishi, mapambano dhidi ya deepfake hayawezi kutatuliwa kwa kutengeneza detector bora pekee. Kwa sababu kugundua maudhui bandia baada ya kusambaa mara nyingi ni ulinzi uliochelewa. Kwa hiyo, utafiti unapendekeza kufikiria kwa pamoja zana kama generation-time watermarking, yaani kuweka watermark wakati wa uzalishaji; content provenance, yaani kuthibitisha chanzo na historia ya uchakataji wa maudhui; blockchain-based evidence preservation, yaani kuhifadhi ushahidi kwa blockchain; na risk-tiered regulation, yaani udhibiti unaotegemea kiwango cha hatari.
Katika hatua hii, mbinu kama Stable Signature, Tree-ring Watermarks na SynthID zinatolewa kama mifano. Stable Signature huweka tabaka la watermark linalojifunza ndani ya decoder ya latent diffusion. Tree-ring Watermarks hukodi alama isiyoonekana lakini inayoweza kutolewa katika Fourier space ya kelele ya mwanzo. SynthID hujaribu kuweka fingerprint ya takwimu katika mchakato wa uzalishaji ili kutengeneza ishara ambazo jicho la binadamu halioni lakini mfumo wa uthibitishaji unaweza kusoma. Mikabala hii inalenga kuacha alama kwenye chanzo cha uzalishaji badala ya kujaribu kukamata maudhui bandia baada ya kusambaa.
Viwango vya content provenance kama C2PA pia ni muhimu katika mfumo huu. Ikiwa inaweza kuthibitishwa kwa cryptography ni kifaa gani kilichopiga picha au video, ni programu gani iliyotumika kuichakata, ni mabadiliko gani yaliyofanywa na ni wapi mlolongo ulivunjika, utambuzi hauishii kwenye kiwango cha “algorithm inadhani hii ni bandia”. Chain of custody inaweza kujengwa katika mzunguko mzima wa maisha ya maudhui. Hili ni muhimu hasa kwa uandishi wa habari, sheria, bima, usalama, michakato ya forensic na mawasiliano ya umma.
Utafiti unaunganisha mfumo wa teknolojia–sheria–maadili na EU AI Act, NIST AI Risk Management Framework, hatua za China kuhusu generative AI na mapendekezo ya UNESCO kuhusu maadili ya AI. Zana za kiufundi hufanya wajibu wa udhibiti uweze kutekelezwa; mifumo ya udhibiti huongoza viwango vya kiufundi; media literacy ya jamii husaidia watu kutafsiri ishara hizi kwa usahihi. Yaani, kuweka watermark pekee haitoshi; watu na taasisi lazima wajue watermark hiyo ina maana gani, ni lini inaweza kuaminika na ni wapi inaweza kuwa na mapungufu.
Kwa mtazamo wa historia, umuhimu wa utafiti ni kwamba unatoa historia ya deepfake kutoka mfuatano rahisi wa “GAN ilikuja, autoencoder ikaja, diffusion ikaja” na kuitafsiri upya kupitia kuhama kwa vidokezo vya utambuzi. Hii husaidia kuelewa fasihi kwa namna yenye mienendo zaidi. Kwa sababu kinachobadilisha eneo kwa kweli si usanifu mpya wa modeli pekee, bali kuvunjika kwa vidokezo vya ulinzi wa zamani na kuhama kwenda viwango vipya vya ulinzi.
Kwa upande wa leo, umuhimu wake unatokana na kuongezeka kwa kasi kwa hatari ya deepfake kwenye mitandao ya kijamii, sekta ya fedha, mawasiliano ya kisiasa na uthibitishaji wa utambulisho wa kidijitali. Sauti ya meneja wa kampuni inaweza kuigwa, video bandia ya mwanasiasa inaweza kusambaa wakati wa mgogoro, picha ya faragha ya mtu inaweza kutengenezwa, uaminifu wa chanzo cha habari unaweza kuharibiwa. Mifumo ya utambuzi haipaswi kujaribiwa kwa mafanikio ya maabara pekee, bali katika usambazaji wa ulimwengu halisi, maudhui yaliyobanwa na kupakiwa upya, lugha tofauti, makundi tofauti ya nyuso na modeli mpya za uzalishaji.
Kwa upande wa siku zijazo, utafiti unatabiri kwamba utambuzi utazidi kuhama kutoka post-hoc classification kwenda uthibitishaji katika chanzo. Yaani, ulinzi mkuu wa siku zijazo unaweza usiwe detector zinazouliza tu “video hii ni bandia?”. Badala yake, maudhui yatawekewa watermark wakati wa kuzalishwa, taarifa ya provenance itaunganishwa kwa cryptography, majukwaa yataithibitisha, maudhui yenye shaka yatachunguzwa kwa mifumo ya utambuzi ya multimodal na, inapohitajika, chain of custody ya forensic itajengwa. Huu ni mmoja wa ujumbe wa kimkakati muhimu zaidi wa utafiti.
Nguvu ya utafiti ni kwamba unaunganisha uzalishaji, utambuzi, seti za data, vipimo na utawala katika mfumo mmoja. Hautoa tu orodha ya modeli za kiufundi; unaeleza kila paradigma ya uzalishaji inadhoofisha kidokezo gani cha utambuzi na jinsi ulinzi unavyohama kwenda vidokezo vipya. Aidha, vielelezo na majedwali vinaunga mkono hoja hii: Kielelezo 1 inaonyesha mageuzi ya uzalishaji na utambuzi kwenye timeline; Kielelezo 2 inaeleza mchakato wa uteuzi wa PRISMA; Jedwali 2 inatoa muhtasari wa ni njia gani ya uzalishaji inaacha alama gani katika mizunguko mitatu na ni mbinu zipi za utambuzi zinajibu; Jedwali 8 inaonyesha matrix ya tathmini; Jedwali 9 inaunganisha majibu ya kiufundi na ya utawala.
Mapungufu pia yanapaswa kusemwa kwa uangalifu. Utafiti ni preprint ambao haujapitia peer review. Hautoi matokeo mapya ya majaribio; unasanisi fasihi iliyopo. Haukokotoi effect size ya meta-analysis kwa sababu seti za data na itifaki ni heterogeneous sana. Baadhi ya thamani za utendaji zimechukuliwa kutoka itifaki za machapisho asilia na si salama kila wakati kufanya ulinganisho wa moja kwa moja kati ya tafiti tofauti. Aidha, ushahidi katika maeneo kama utambuzi unaotegemea MLLM bado ni wa awali; utafiti pia ni makini na unasema mifumo hii bado haijakomaa vya kutosha kuchukua nafasi ya detector maalum kwa real-time moderation.
Kile utafiti unachosema ni hiki: Uzalishaji na utambuzi wa deepfake hubadilika pamoja; kila paradigma mpya ya uzalishaji hudhoofisha vidokezo vya utambuzi vya zamani, na mbinu za utambuzi huhamia kwenye njia za kiwango cha juu zaidi za semantiki, fizikia, multimodal na uthibitishaji wa chanzo. Kile utafiti hausisemi ni hiki: Kila deepfake inaweza kugunduliwa kwa uhakika, watermark itatatua tatizo lote, mifumo ya MLLM inaweza kutumiwa tayari kama detector ya kuaminika au metric moja inatosha kupima usalama wa deepfake. Kinyume chake, utafiti unasisitiza kwamba eneo linahitaji usanifu wa ulinzi wa tabaka nyingi, wenye mienendo na unaosasishwa kila wakati.
Mbinu na Matokeo ya Utafiti
Utafiti huu si kazi ya kutengeneza modeli ya majaribio, bali ni usanisi wa fasihi wa aina ya systematic review. Watafiti walitafuta fasihi kuhusu uzalishaji wa deepfake, utambuzi, seti za data, evaluation metrics na utawala katika kipindi cha 2014–2025 na kupanga upya matokeo ndani ya mfumo wa “adversarial evolution”.
Mbinu ya utafutaji wa vyanzo:
| Kipengele cha Mbinu | Mkabala Uliotumika katika Utafiti | Maana |
| Kipindi cha utafutaji | 1 Januari 2014 – 31 Desemba 2025. | Eneo limefuatiliwa kutoka kuibuka kwa GAN hadi diffusion na modeli kubwa za uzalishaji wa video. |
| Hifadhidata | IEEE Xplore, ACM Digital Library, Web of Science, arXiv. | Machapisho yaliyopitia peer review na preprint zenye ushawishi mkubwa na citations nyingi zilijumuishwa. |
| Makundi ya utafutaji | Maneno ya uzalishaji, utambuzi na modality. | Uzalishaji wa deepfake, forensic detection, picha, video, sauti na maudhui ya multimodal vilijumuishwa pamoja. |
| Mkabala wa uteuzi | Protokali ya systematic selection iliyorekebishwa kwa PRISMA. | Lengo lilikuwa kufanya uteuzi wa fasihi uwe unaofuatilika na unaoweza kurudiwa. |
| Mbinu ya usanisi | Thematic analysis. | Tafiti ziliainishwa kwa paradigma ya uzalishaji, paradigma ya utambuzi na mwaka wa uchapishaji. |
Mchakato wa uteuzi wa PRISMA:
| Hatua | Idadi | Maelezo |
| Rekodi zilizopatikana mwanzoni | 1.486 | Zilipatikana kupitia IEEE Xplore, ACM Digital Library, Web of Science na arXiv. |
| Rekodi zilizojirudia zilizoondolewa | 312 | Muunganiko kati ya hifadhidata ulisafishwa. |
| Uchunguzi wa kichwa/muhtasari | 1.174 | Rekodi zilizobaki zilitathminiwa kwa ufaafu wa mada. |
| Rekodi zilizoondolewa kwa kuwa nje ya mada | 627 | Tafiti za generative modeling kwa ujumla au forensic analysis zisizo za deepfake ziliondolewa. |
| Tathmini ya maandishi kamili | 547 | Maandishi kamili yalichunguzwa kwa vigezo vya ustahiki. |
| Tafiti zilizoingizwa katika usanisi wa ubora | 211 | 83 ni uzalishaji, 75 utambuzi, 31 seti za data/metrics, 22 utawala/maadili/sera. |
Mihimili mikuu ya uainishaji wa tafiti:
- Paradigma ya uzalishaji: mbinu zinazotegemea GAN, autoencoder, diffusion na multimodal/hybrid.
- Paradigma ya utambuzi: artefakti za kimwili, deep representations, mekanizimu za kuongeza robustness, ukaguzi wa uthabiti wa multimodal na mbinu za active defense.
- Mhimili wa muda: tafiti zimeunganishwa na mizunguko mitatu inayopishana ya adversarial.
Mizunguko mitatu ya adversarial detection:
| Mzunguko | Kipindi | Upande wa Uzalishaji | Kidokezo cha Utambuzi | Maendeleo Yanayodhoofisha Mzunguko |
| Kipindi cha kidokezo cha frequency | 2014–2019 | GAN, StyleGAN, cGAN, CycleGAN na modeli zinazofanana. | Anomalies za frequency, checkerboard traces, kutolingana kwa PRNU, kutolingana kwa head pose. | Usanifu wa alias-free na mifumo ya autoencoder ya kubadilisha uso ilidhoofisha alama hizi. |
| Kipindi cha mpaka wa blending na deep representation | 2018–2023 | Mifumo ya face swap/reenactment kama DeepFaceLab, FaceSwap, FOMM. | Mipaka ya kuchanganya uso, texture laini, kuvurugika kwa biophysiological signals kama rPPG na kupumua. | Diffusion denoising na modeli za video zenye uthabiti mkubwa wa kimwili zilipunguza alama hizi. |
| Kipindi cha uthabiti wa semantiki na kimwili | 2022–2025 | Mifumo kama Stable Diffusion, DiT, DreamBooth, Sora. | Diffusion reconstruction error, kutolingana kwa biomekanika ya audio–visual, ukiukaji wa sheria za fizikia, uthibitishaji wa chanzo. | Inaelezwa kwamba lengo linalofuata la ulinzi litakuwa watermark na provenance verification kwenye chanzo. |
Ulinganisho wa paradigma za uzalishaji wa deepfake:
| Paradigma | Kanuni ya Msingi | Nguvu | Udhaifu | Matumizi ya Kawaida |
| GAN | Adversarial distribution matching kati ya generator na discriminator. | Inference ya haraka, maelezo makali, manipulation ya latent space. | Alama za frequency, mode collapse, identity drift kati ya fremu za video. | Uzalishaji wa uso wa real-time na face swap. |
| Autoencoder | Encoder–decoder reconstruction. | Mafunzo thabiti zaidi, urahisi wa face swap, pipeline ya mtu binafsi. | Kupotea kwa maelezo ya frequency ya juu, uso laini kama nta, generalization yenye kikomo. | Kubadilisha utambulisho kwa mtindo wa DeepFaceLab na FaceSwap. |
| Diffusion | Iterative denoising kutoka kelele hadi data. | Photorealism, udhibiti wa text/image conditioning, kukaribia takwimu za picha halisi. | Sampling polepole, gharama kubwa ya kompyuta, tatizo la identity–attribute entanglement. | Uzalishaji wa picha/video wa ubora wa juu na synthesis iliyobinafsishwa. |
| Mifumo ya multimodal | Kuoanisha sauti, picha, maandishi na mtiririko wa muda kwa pamoja. | Talking digital human, audio–lip synchronization, udhibiti wa hisia na semantiki. | Identity drift katika video ndefu, kutolingana kwa hisia, changamoto za real-time na usalama. | Digital human, dubbing correction, talking avatar, hatari ya social engineering. |
Mahusiano ya msingi ya mafunzo ya diffusion yaliyopewa katika utafiti:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Fomula hii inaonyesha mfumo wa mafunzo wa probabilistic wa diffusion model. Badala ya kukokotoa moja kwa moja probability ya usambazaji wa data, modeli hujifunza reverse denoising process na kukaribia data. Hapa x0 ni mfano safi wa data, xT ni mfano wenye kelele kabisa, q ni forward noising process, pθ ni reverse process iliyojifunza na θ ni parameta za modeli.
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Fomula hii inaonyesha kwamba diffusion model inaweza kufunzwa kwa noise prediction katika vitendo. ε ni kelele halisi, εθ ni kelele inayotabiriwa na modeli, \bar{α}t ni mgawo wa ratiba ya kelele na t ni hatua ya denoising. Jukumu la modeli ni kutabiri kelele katika data yenye kelele na kwa hivyo kuzalisha mfano halisi kwa kurudi nyuma.
Uhusiano wa msingi unaotumika katika utambuzi unaotegemea frequency:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Fomula hii hutoa radial energy profile katika eneo la frequency la picha. F ni uwakilishi wa frequency wa picha, r radius/kiwango cha frequency, θ mwelekeo wa pembe, na P(r) ni wastani wa nishati ya frequency usiotegemea mwelekeo. Kwa kuwa baadhi ya frequency peaks katika picha za GAN zinaweza kuwa tofauti na picha halisi, profaili hii inaweza kutumika kwa utambuzi wa kughushi.
Matrix ya tathmini ya mihimili mitatu inayopendekezwa na utafiti:
| Mhimili | Metrics | Inapima Nini? |
| Utendaji wa utambuzi | AUC, EER, IoU, ACC. | Hupima mafanikio ya mfumo katika kutenganisha maudhui halisi na bandia na kulocalize eneo bandia. |
| Ubora wa uzalishaji | FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score, NIQE. | Hupima uhalisia wa maudhui yaliyozalishwa, ulinzi wa utambulisho, uthabiti wa video na ulinganifu na maandishi. |
| Uthabiti wa multimodal | LSE-D/C, MOS. | Hupima audio–lip synchronization, uhalisia unaotambuliwa na binadamu na ulinganifu wa multimodal. |
Familia kuu za seti za data:
| Kundi la Seti za Data | Mifano | Jukumu katika Utafiti |
| Seti za picha | CelebA-HQ, FFHQ, PGGAN/StyleGAN sets, iFakeFaceDB, Fake2M. | Hutumika kwa static face generation, GAN fingerprint, utambuzi wa diffusion image na ubora wa picha bandia. |
| Seti za video | UADFV, DF-TIMIT, FaceForensics++, Celeb-DF, DFDC, WildDeepfake, FFIW-10K, DFDC-Medical. | Hutumika kwa face swap, hali za social media, compression, usambazaji wa ulimwengu halisi na kughushi maalum kwa domain. |
| Seti za multimodal | FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake, DDL. | Hutumika kwa audio–video deepfake, kughushi sauti kwa lugha nyingi, local manipulation na fine-grained labeling. |
Matokeo makuu ya kiufundi yaliyobainishwa na mapitio:
- Uzalishaji na utambuzi wa deepfake si mistari miwili huru; ni mfumo wa mashambulizi–ulinzi unaobadilika kwa pamoja.
- Alama za frequency za kipindi cha GAN zimekuwa si za kuaminika sana kutokana na alias-free architectures na mbinu mpya za uzalishaji.
- Autoencoder na mifumo ya face swap iliunda vidokezo vipya vya utambuzi kama blending boundaries na kuvurugika kwa ishara za biophysiological.
- Modeli za diffusion, kwa kukaribia zaidi takwimu za picha halisi, zimepunguza nguvu ya detector zinazotegemea frequency na pikseli.
- Kwa utambuzi wa multimodal deepfake, si picha pekee; sauti, mwendo wa midomo, hisia, prosody, kupumua, mwendo wa biomekanika na muktadha wa semantiki vinapaswa kutathminiwa pamoja.
- Mifumo ya utambuzi inayotegemea MLLM inaweza kutoa maelezo; lakini bado haijakomaa vya kutosha kwa real-time moderation na uaminifu wa juu.
- Watermark na provenance verification kwenye chanzo zinaweza kuwa mstari mkuu wa ulinzi utakaojaza mapengo ya post-hoc detection siku zijazo.
Mapendekezo ya utawala ya utafiti:
| Tatizo | Jibu la Kiufundi | Jibu la Utawala |
| Kushindwa kwa detector katika domains mpya za data | Causal reasoning, domain adaptation, self-blended training, benchmarks zinazosasishwa kila mara. | Tathmini za mara kwa mara na usimamizi wa hatari katika mzunguko wa maisha kwa majukwaa na wadhibiti. |
| Kuenea kwa kughushi kwa multimodal | Audio–visual synchronization, uthabiti wa hisia, ukaguzi wa biomekanika na fizikia. | Viwango vya labeling vya multimodal na majukumu ya majukwaa. |
| Kutosha kwa uamuzi wa “bandia/halisi” pekee | Fine-grained localization, model fingerprint, source attribution. | Chain of custody ya forensic, kumbukumbu za blockchain na cryptographic content provenance. |
| Utendaji usio wa haki katika lugha na tamaduni tofauti | Seti za data za lugha nyingi, tamaduni nyingi na zinazojumuisha usambazaji tofauti wa nyuso. | Ukaguzi unaolenga fairness, discrimination na ulinganifu wa viwango vya kimataifa. |
| Ugumu wa kugundua maudhui bandia baada ya kusambaa | Stable Signature, Tree-ring Watermarks, SynthID, C2PA provenance. | Labeling wakati wa uzalishaji, uthibitishaji wa chanzo na udhibiti unaotegemea hatari. |
Mapungufu yaliyo wazi ya utafiti:
- Utafiti ni preprint ambao haujapitia peer review.
- Hautoi modeli mpya ya majaribio au seti mpya ya data.
- Meta-analysis haikufanywa kwa sababu seti za data, itifaki na aina za kuripoti katika fasihi ni heterogeneous sana.
- Thamani za utendaji zilizonukuliwa hutegemea mazingira ya machapisho ya awali; ulinganisho wa moja kwa moja lazima ufanywe kwa tahadhari.
- Utambuzi unaotegemea MLLM huenda umejaribiwa kwenye subsets ndogo na curated; benchmarking kubwa ya ulimwengu halisi bado ni pungufu.
- Metrics zilizosanifiwa kwa uthabiti wa kimwili na semantiki bado hazijakomaa vya kutosha.
- Ingawa suluhisho za watermark na provenance ni zenye nguvu, counter-forensic removal, re-encoding na matatizo ya interoperability kati ya majukwaa yanaendelea.
Hitimisho la jumla: Kwa mujibu wa utafiti, mapambano dhidi ya deepfake hayawezi kutatuliwa kwa detector moja au sheria moja. Modeli za uzalishaji, mifumo ya utambuzi, seti za data, evaluation metrics, viwango vya watermark/provenance, wajibu wa majukwaa, sheria na uelewa wa umma lazima viendelee pamoja. Ulinzi halisi dhidi ya deepfake unasogea kutoka kukamata alama moja ya hitilafu kwenye picha kwenda kwenye usanifu wa kina wa uaminifu unaoanzia uzalishaji wa maudhui, unaendelea katika usambazaji na unaishia katika uthibitishaji wa forensic.
Dokezo la Chanzo na Mbinu
Makala hii imeandaliwa kwa msingi wa utafiti wenye kichwa “Adversarial Evolution of Deepfake Generation and Detection: A Systematic Review of Paradigms, Evaluation, and Governance” uliotayarishwa na Mengze Li, Gang Liang, Kui Zhao, Liangyin Chen, Junren Chen na Jiayi Liu.
Maandishi chanzo ni makala ya systematic review ya preprint inayochunguza kwa utaratibu fasihi ya uzalishaji na utambuzi wa deepfake katika kipindi cha 2014–2025. Kwa sababu maandishi yanasema wazi “This preprint research paper has not been peer reviewed”, utafiti haujapitia peer review. Kwa hiyo, matokeo yanapaswa kusomwa si kama matokeo ya mwisho yaliyothibitishwa katika jarida lililopitia peer review, bali kama usanisi mpana wa fasihi ambao bado uko wazi kwa tathmini.
Mbinu ya utafiti inategemea systematic literature review iliyorekebishwa kwa PRISMA. IEEE Xplore, ACM Digital Library, Web of Science na arXiv zilitafutwa; kutoka rekodi 1.486, tafiti 211 ziliingizwa katika usanisi wa ubora. Tafiti hizi ziliainishwa chini ya mbinu za uzalishaji, mbinu za utambuzi, seti za data/tathmini na utawala/maadili/sera.
Katika kuandaa maudhui haya, dhana kuu za utafiti, modeli ya mizunguko mitatu ya adversarial, mistari ya uzalishaji ya GAN–autoencoder–diffusion, maendeleo ya multimodal deepfake, mbinu za utambuzi, fomula za diffusion, fomula ya frequency analysis, ulinganisho wa seti za data na metrics, matrix ya tathmini ya mihimili mitatu, mfumo wa utawala wa teknolojia–sheria–maadili, mapendekezo ya watermark kwenye chanzo na C2PA provenance vimehifadhiwa. Hakuna matokeo mapya ya majaribio, ahadi ya mafanikio ya uhakika, dai kwamba deepfake zote zinaweza kutambuliwa kwa uaminifu au suluhisho moja la kisheria/kiufundi ambalo halipo katika PDF lililoongezwa.
Utafiti unapaswa kusomwa kwa uangalifu hasa kwa jambo hili: Viwango vya mafanikio vinavyoripotiwa katika utambuzi wa deepfake mara nyingi hutegemea seti ya data, kiwango cha compression, mbinu ya kukata uso, mgawanyo wa training/test, modeli ya uzalishaji na usambazaji wa ulimwengu halisi. Kwa hiyo, detector yenye mafanikio ya juu kwenye benchmark fulani haimaanishi kwamba itatambua kila maudhui mapya ya deepfake yanayosambaa kwenye mitandao ya kijamii kwa mafanikio yale yale.
Mchango wa thamani zaidi wa utafiti ni kwamba unachukulia deepfake si tu katika kiwango cha “maudhui bandia yanatambuliwaje?”, bali kama mnyororo wa uzalishaji–utambuzi–tathmini–utawala. Mnyororo huu unaonyesha kwamba ili kujenga mfumo wa kuaminika wa vyombo vya habari vya kidijitali siku zijazo, pamoja na detector za kiufundi, uthibitishaji wa chanzo, taarifa ya provenance, wajibu wa kisheria, viwango vya maadili na uelewa wa umma pia vinahitajika.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *