

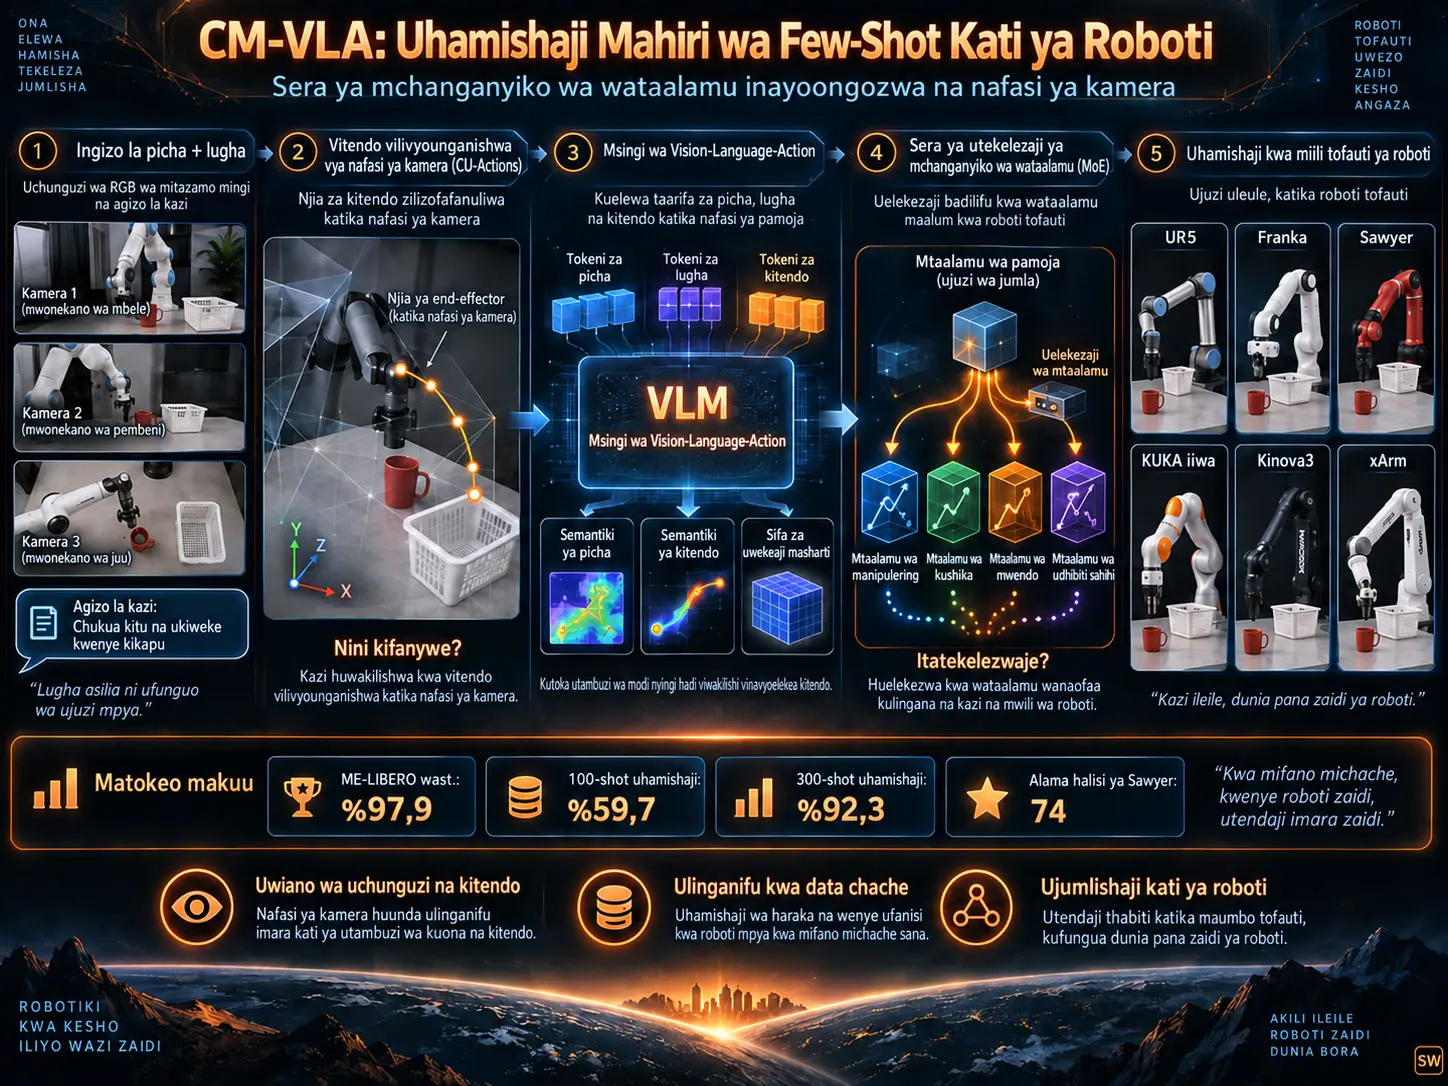
CM-VLA, kati ya miili tofauti ya roboti kwa idadi ndogo ya maonyesho mapya ili kurahisisha uhamishaji wa kazi katika nafasi ya kamera semantiki ya pamoja ya kitendo na sera ya utekelezaji mahususi kwa roboti inayotenganisha Vision-Language-Action ni usanifu. Model Camera-space Unified Actions (CU-Actions) inayoitwa kamera-nafasi vitendo VLM msingi wa usimamizi msaidizi kama hutumia; kisha embodiment-aware Mixture-of-Experts (MoE) flow policy semantiki ya pamoja roboti lengwa muundo wa kinematiki va kulingana na sifa za udhibiti huigeuza kuwa vitendo endelevu vya nafasi ya roboti. Katika utafiti CM-VLA ME-LIBERO uzarinda %97,9 mafanikio ya wastani, kwa roboti ambazo hazikuonekana 100 katika uhamishaji wa maonyesho %59,7 va 300 katika maonyesho %92,3 mafanikio ya wastani imefikia. Real Sawyer roboti tacrubalarinda alama ya wastani iliyosawazishwa %74 imeripotiwa kama. Hata hivyo matokeo mkono mmoja end-effector delta katika muktadha wa udhibiti yamepatikana va modelin iki qollu robotia, bacariqli allara va ya tofautili kitendo makanlarina eyni performansla genishlanacayi haijaonyeshwa.
Modeli ya Vision-Language-Action uchunguzi wa kuona va maelekezo ya lugha asilia ambavyo roboti inaweza kutekeleza hugeuza kuwa vitendo ni darasa la sera ya roboti ya modi nyingi. CM-VLA-nin sifa bainifu “kinachopaswa kufanywa” dair roboti arasinda inayoweza kushirikishwa semantikini katika nafasi ya kamera kujifunza va “jinsi ya kutekelezwa” dair robotia xas icrani huiacha kwa sera tofauti ya mchanganyiko wa wataalamu.
Kwa nini uhamishaji wa kazi kati ya roboti tofauti ni mgumu?
Kazi ya manipulering ya roboti hata kama inabaki sawa kisemantiki, tapshirigi yerina yetiran roboti ya kimwili inapobadilika problem huwa changamano kuliko ubadilishaji rahisi wa kuratibu. Robotlarin idadi za viungo, urefu wa viungo, nafasi za kazi, vihisi, proprioseptiv vaziyyat paylanmalari, nafasi za kamera, masafa ya udhibiti va mitambo ya gripper tofautili ola bnar.
Kwa mfano, “chukua kitambaa cha kijani na ukiweke juu ya sahani” agizo UR5, Franka Panda, Sawyer, KUKA iiwa, Kinova3 va xArm uchun hubeba semantiki ileile ya kazi. Hata hivyo kna roboti eyni sonlandirici kitendoini yerina yetirmak uchun ehtiyac duydugu amri za chini za kitendo si sawa.
Utafitiin ala aldigi kuu problem bu iki saviyyanin movcud VLA sistemlarinda kifayat qadar ayrishdirilmamasidir. Vizual kodlayici kameradan galan goruntunu emal edarkan, kitendo etiketi chox data dastinda robotiun oz koordinat sisteminda muayyan hufanywa. Belalikla model tapshirigi oyranmakla yanashi, kamera na roboti koordinat sistemi arasindaki chevrilmani da ortuk shakilda hall etmaya macbur qalir.
CM-VLA ni nini?
CM-VLA katika nafasi ya kamera muayyan edilmish mwilidan asili olmayan kitendo semantikisini vision-language onurgasinda oyranan va bu semantikini embodiment-aware Mixture-of-Experts flow policy vasitasna roboti lengwa endelevu idaraetma komandalarina cheviran cross-embodiment VLA ni usanifu. Modelin kuu tofautii katika nafasi ya kameraki qavrayish yonlu “na edilmalidir?” tamsili na roboti nafasindaki icra yonlu “neca edilmalidir?” idaraetmasini iki ayri oyranma problemi kimi ele almasidir.
Vitendo vilivyounganishwa vya nafasi ya kamera
Utafitiin kuu ara tamsili Camera-space Unified Action, yani CU-Action-dir. Har zaman addimindaki kamera-nafasi kitendoi bela muayyan hufanywa:
\[ a_t^c=(\Delta p_t^c,\Delta r_t^c,g_t) \]
Burada:
- \(\Delta p_t^c\) sonlandiricinin kamera koordinat sistemindaki translasiya dayishimini;
- \(\Delta r_t^c\) kamera koordinat sistemindaki firlanma dayishimini;
- \(g_t\) gripper komandasini tamsil edir.
Bu gostarimin kisayansi rolu robotiun oz oynaq va ya baza koordinatlarindan mumkun qadar mustaqil ara kitendo semantikisi yaratmaqdir. Kamera goruntusu da katika nafasi ya kamera mushahida edildiyi uchun kitendo usimamiziinin eyni handasi baglama dashinmasi mushahida na kitendo etiketi arasindaki uygunsuzlugu azaltmagi maqsadlayir.
Ahamiyyatli bir detal CU-Actions-in birbasha son roboti idaraetma komandasi kimi matumizi edilmamasidir. Katika utafiti discretized CU-Actions VLM onurgasinin mafunzoi uchun usimamizi msaidizi vazifasi gorur. Halisi icra edna bnan endelevu roboti kitendolari ayrica downstream policy tarafindan yaradilir.
CM-VLA hutenganishaje “nini kifanywe” na “jinsi kifanywe”?
CM-VLA-da kamera-nafasi VLM qati uchunguzi wa kuona va dil agizondan embodiment-agnostic kitendo semantikisini oyranarak “na ednacayini” tamsil edir; roboti-nafasi MoE flow policy isa robotiun proprioseptiv vaziyyati va embodiment haliindan matumizi edarak eyni semantikinin konkret roboti uzarinda “neca tatbiq ednacayini” endelevu idaraetma siqnallarina chevirir.
Msingi wa vision-language
VLM onurgasi PaliGemma kuulidir. PaliGemma SigLIP vizual kodlayicisi na Gemma dil modelini birlashdirir. Modela bir necha RGB mushahidasi va dil agizo verilir:
\[ \pi_\phi(a_t^c,\hat l_t \mid I_t^1,\ldots,I_t^n,l) \]
Burada \(a_t^c\) CU-Action, \(\hat l_t\) isa kazi plani, alt kazi ayrimi, kitendo primitive-lari va gripper movqeyi kimi alava qavrayish yonlu kazi qurulushunu tamsil edan tokenlashdirilmish reasoning chixishidir.
VLM-in sechilmish qatlarindan alinan gizli vaziyyatlar achar-dayar sifalarina proyeksiya hufanywa:
\[ K_t^{(m)}=H_t^{(m)}W_K^{(m)}, \qquad V_t^{(m)}=H_t^{(m)}W_V^{(m)} \]
Bu sifalar:
\[ C_t=\{(K_t^{(m)},V_t^{(m)})\}_{m\in M} \]
halnandirma choxlugunu huunda va cross-attention uzarindan endelevu roboti kitendoi yaradan alt seraa oturulur. Waandishiin dizayninda vacib maqam yalniz son VLM qatindan matumizi etmak avazina sechilmish qatlar uzra zangin KV halnandirmasi tamin etmakdir.
Malengo ya mafunzo ya CU-Action
Matn reasoning chixishi uchun causal attention va token-token proqnozu matumizi olunur:
\[ L_{cot}=-\sum_{k=1}^{K}\log\pi_\phi(l_t^k\mid v_t,l_t^{<k}) \]
Discretized CU-Actions uchun isa butun kitendo ardicilligindaki alaqalari birlikda modellaya bilmak lengola full-attention matumizi olunur:
\[ L_{cu\_action}=-\sum_{m=1}^{M}\log\pi_\phi(a_m^c\mid v_t,l) \]
Waandishi bu sechimin CU-Action ardicilliginda daha butov va yumshaq kechidli kitendo qurulushlari oyranmaya komak etdiyini huelezalar.
Sera ya Mixture-of-Experts ya nafasi ya roboti
Ikinci marhalada model kamera-nafasi semantikisini halisi robotiun ishlada bnacayi endelevu roboti-space action, yani RS-Actions-a chevirir. Bunun uchun flow matching kuuli Transformer serai matumizi olunur.
Serain ilk qatlari butun roboti uchun ortaq emal aparir. Daha darindaki son alti blok isa MoE bloklaridir. Embodiment halii \(e_k\) ortaq tamsilla birlashdirnarak robotia xas ekspert yonlandirmasi uchun matumizi olunur.
Har token uchun router yonlandirna bnan ekspertlar uzarinda ehtimal paylanmasi huunda:
\[ \alpha_{t,u}^{(\ell)} = \operatorname{Softmax} \left( Router_\ell( LN(\tilde z_{t,u}^{(\ell)}) ) \right) \]
Yalniz an yuksak skorlu Top-K ekspert aktivlashdirilir.
Tofauti kati ya mtaalamu wa pamoja na wataalamu wanaoelekezwa
Har MoE blokunda endelevu aktiv olan bir shared expert va embodiment tofautnarini modellayan ekspert hovuzu vardir:
\[ MoE_{\ell,u}(\tilde z) = E_{\ell}^{sh}(\tilde z) + \sum_{j\in TopK(\alpha)} \alpha_jE_{\ell,j}(\tilde z) \]
Shared expert roboti arasinda ortaq olan icra qurulushunu oyranmaya yonalib. Routed experts isa kinematik sarhadlar, idaraetma tezliyi, kitendo interfeysi va icra formasi kimi roboti arasinda dayishan sifalari udur.
Buradaki kisayansi fikir “har roboti uchun tak ekspert” yaratmaq deyil. Waandishi xususna overcomplete expert pool matumizi edir va ekspertlarin tofautili roboti arasinda qisman paylashilmasini istayirlar.
Embodiment-aware routing loss
CM-VLA-nin muhimu yeniliklarindan biri router-in yalniz kazi mazmununa deyil, roboti mwilisinin icra sifalarina da hassas ekspert sechimlari kujifunzani tashviq edan \(L_{emb}\) itkisidir.
Kuu formasi:
\[ L_{emb}=L_{intra}+\lambda_{sep}L_{inter} \]
\(L_{intra}\) eyni embodiment uchun tofautili kaznardaki yonlandirma numunalarinin bir-birina yaxin qalmasini tashviq edir. \(L_{inter}\) isa tofautili embodiment prototiplarinin muayyan margin daxilinda bir-birina haddindan artiq yaxinlashmasini cazalandirir.
Bu itkinin lengo kazi tofautii na roboti tofautiini qarishdirmadan, eyni kazi semantikisi altinda roboti icrasindan qaynaqlanan tofautnarin ekspert sechiminda gorunan hala galmasidir.
Load-balancing loss
Sparse MoE sistemlarinda bir necha ekspertin endelevu sechilmasi va digarlarinin matumizi edilmamasi “expert collapse” problemina yol acha bnar. CM-VLA bunu azaltmaq uchun ekspertlarin empirik matumizi tezliyi na gozlanan routing ehtimalini matumizi edan balanslashdirma termini tatbiq edir:
\[ L_{bal}=\sum_{j=1}^{N_E}f_jP_j \]
Chanzoda bu terminin embodiment ayrimini aradan qaldirmaq uchun deyil, ekspert hovuzunun haddindan artiq bir necha ekspertda sixlashmasinin qarshisini almaq uchun matumizi edildiyi xususna vurgulanir.
Flow-matching loss
Robot-nafasi endelevu kitendolari flow matching na yaradilir. Halisi kitendo chunk-i \(A_t^r\), Gaussian sas-kuyu \(\epsilon\) va axin zamani \(\tau\) matumizi ednarak:
\[ x_t^\tau=(1-\tau)\epsilon+\tau A_t^r \]
shaklinda sas-kuylu ara vaziyyata chevrilir. Hadaf vektor sahasi:
\[ u_t^\tau=A_t^r-\epsilon \]
kimi muayyan hufanywa va sera bu vektor sahasini oyranir:
\[ L_{fm} = \mathbb{E} \left[ \|v_\theta(x_t^\tau,\tau,q_t,e_k;C_t)-u_t^\tau\|_2^2 \right] \]
Umumi mafunzo itkisi:
\[ L=L_{fm}+\lambda_{bal}L_{bal}+\lambda_{emb}L_{emb} \]
shaklindadir. Chanzoda \(\lambda_{bal}=0.15\) va \(\lambda_{emb}=1\) kimi imetolewa.
CU-Actions huzalishwaje katika dunia halisi?
Simulyasiyada roboti sonlandirici pozu va kamera kalibrlanmasi birbasha alchatan oldugundan roboti nafasindaki pose kamera koordinatlarina chevrilir. Ardicil iki kadr arasindaki nisbi kamera-nafasi kitendoi:
\[ \Delta T_t^c=T_{t+1}^c(T_t^c)^{-1} \]
na hesablanir va translasiya, firlanma na gripper vaziyyatina ayrnaraq CU-Action etiketi yaradilir.
Halisi robotida birbasha kamera-roboti extrinsic chevrilmasindan matumizi etmak oynaq sifir surushmalari, link toleranslari, lens distorsiyasi, intrinsic xata va hand-eye kalibrlama xatalarindan tasirlana bnar. Buna gora utafiti halisi dunya etiketlarinda marker-free FEEPE metodundan yararlanir.
Alava B-da gostarildiyi kimi end-effector CAD modeli uchun 80 baxish bucagi va 12 in-plane rotasiya matumizi ednarak umumilikda 960 referans template imeundwa. DINOv2 sifalari na hadaf goruntuya an yaxin besh referans gorunush sechilmish, 2D–3D uygunluqlari va PnP na bashlangic pozu taxmin imefanywa. Temporal keyframe metodu an chox sakkiz keyframe matumizi edir va keyframe yennama bucagi 10° kimi imetolewa.
Mbinu na matokeo ya utafiti
Modeli na miundombinu ya mafunzo
- Taxmini model olchusu: 4 milyard parametr.
- VLM bashlangici: PaliGemma-3B.
- VLM qat sayi: 18.
- Gizli olchu: 2048.
- Vizual encoder: SigLIP.
- Goruntu olchusu: 224 × 224.
- Talim avadanligi: 16 NVIDIA A800, har biri 80 GB.
- On mafunzo muddati: 14 gun.
- Global batch size: 512.
- Optimizer: AdamW.
- \(\beta_1=0.9\), \(\beta_2=0.95\).
- Talim addimi: 60.000.
- Bashlangic learning rate: 5×10⁻⁵.
- Warm-up: 2.000 addim.
- Learning-rate schedule: cosine decay.
- Action horizon: H=50.
- MoE: 16 routed expert + 1 endelevu aktiv shared expert.
- Routing: Top-4.
- \(L_{inter}\) margin dayari: 0,25.
Vyanzo vya data vya mafunzo ya awali
On mafunzo data hovuzu Open X-Embodiment (OXE), LIBERO va DROID data dastlarindan imeundwa va umumilikda 19 embodiment na muxtalif manipulyasiya kaznarini ahata edir.
ME-LIBERO ni nini?
ME-LIBERO orijinal LIBERO benchmark-ini eyni kazi semantikisini tofautili roboti mwilnari altinda qiymatlandiracak shakilda genishlandiran chox-embodiment test muhitidir. Katika utafiti alti mkono mmoja roboti matumizi imefanywa:
- UR5
- Franka Panda
- Sawyer
- KUKA iiwa
- Kinova3
- xArm
Dil agizo, obyektlar, sahna duzani, kazi hadafi va bitirma halnari sabit saxlanarkan robotiun uchunguzi wa kuonasi, CU-Actions, RS-Actions, kinematik qurulushu, ish geometriyasi va proprioseptiv statistikalari dayishir. Bu dizayn embodiment heterogenliyinin kazi semantikisindan mumkun qadar ayrishdirilmasini maqsadlayir.
CM-VLA imefanikiwa kwa kiasi gani katika uhamishaji wa few-shot wa roboti?
ME-LIBERO leave-one-roboti-out tathminisinda CM-VLA-nin alti hadaf roboti uzarinda orta mafanikio nisbati 50 katika maonyesho %33,7, 100 katika maonyesho %59,7, 300 katika maonyesho %92,3, 500 katika maonyesho %93,5 va 1000 katika maonyesho %97,0-dir. Utafitiin tathmini protokolunda model 100-shot haliinda alti roboti lengwa hamisinda an yuksak matokeoni alda etmish, 300-shot haliinda isa alti robotiun dordunda an yuksak performansi imeonyesha.
LIBERO va ME-LIBERO matokeoi
| Mbinu | Wastani wa LIBERO | ME-Wastani wa LIBERO |
|---|---|---|
| OpenVLA | 76,5% | 73,2% |
| π0 | 92,1% | 84,9% |
| π0.5 | 96,9% | 94,5% |
| OC-VLA | 95,0% | 95,7% |
| CM-VLA | 97,0% | 97,9% |
Tak embodiment LIBERO muhitinda CM-VLA %97,0 na an yuksak orta matokeoni vermishdir. Chox embodiment ME-LIBERO muhitinda isa tofauti daha da aydin olmush va CM-VLA %97,9-a imefikia.
Tathmini ya roboti halisi ya Sawyer
Halisi dunya tacrubalari Sawyer robotiu uzarinda dord tofautili umumnashdirma haliinda aparilmishdir:
- tofautili makan munasibatlari,
- tofautili hadaf ranglari,
- eyni sahnada tofautili hadaflar,
- tofautili sahnalardan ibarat out-of-domain umumnashdirma.
| Mbinu | Alama ya wastani iliyosawazishwa |
|---|---|
| OpenVLA | 19 |
| π0 | 44 |
| π0.5 | 60 |
| OC-VLA | 55 |
| CM-VLA | 74 |
CM-VLA dord halisi dunya haliinin hamisinda muqayisa ednan metodlardan daha yuksak matokeo vermishdir. An boyuk nisbi ustunluyun sahnanin tam dayishdiyi out-of-domain halida mushahida olunmasi waandishiin kamera-nafasi semantikisinin vizual paylanma dayishmalarina qarshi daha mohkam transfer edna bildiyi sharhini dastaklayir.
Uhamishaji wa few-shot wa leave-one-roboti-out
Bu tacrubada alti robotidan biri mafunzo zamani tamamna kanarda saxlanir. Qalan besh robotna model oyradildikdan kisha gorunmayan hadaf robotia yalniz 50, 100, 300, 500 va ya 1000 onyesho vernarak fine-tuning aparilir.
| Idadi ya maonyesho ya roboti lengwa | Mafanikio ya wastani |
|---|---|
| 50-shot | 33,7% |
| 100-shot | 59,7% |
| 300-shot | 92,3% |
| 500-shot | 93,5% |
| 1000-shot | 97,0% |
Waandishi praktiki manaliliq haddini %90 orta mafanikio kimi goturdukda CM-VLA-nin bu hadda chatmaq uchun lazim olan onyesho sayi baximindan raqib metodlara gora taxminan %13,6–69,7 data samaraliliyi artishi tamin etdiyini huelezalar.
100-shot haliinda robotia xas CM-VLA matokeoi UR5 uchun %59,8; Franka uchun %60,9; Sawyer uchun %52,6; KUKA iiwa uchun %61,0; Kinova3 uchun %60,4 va xArm uchun %63,4 kimi imetolewa.
Je, usimamizi wa nafasi ya kamera huleta tofauti kweli?
| Usimamizi wa VLM | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Kawaida | 91,8% | 50,9% | 84,2% |
| Discretized RS-Actions | 94,1% | 55,8% | 87,3% |
| Discretized CU-Actions | 97,9% | 59,7% | 92,3% |
RS-Actions avazina CU-Actions na Usimamizi wa VLM ME-LIBERO mafanikiounu %94,1-dan %97,9-a, 100-shot transferini %55,8-dan %59,7-ya va 300-shot transferini %87,3-dan %92,3-a chixarmishdir.
Ablation ya sera ya MoE
| Sera | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Dense Flow Policy | 95,2% | 22,3% | 50,0% |
| Vanilla Sparse MoE | 98,0% | 4,8% | 15,7% |
| MoE + Shared Expert | 97,8% | 7,8% | 25,7% |
| Shared Expert + Lbal | 94,7% | 6,8% | 23,4% |
| Shared Expert + Lemb | 95,2% | 40,6% | 82,0% |
| CM-VLA kamili | 97,9% | 59,7% | 92,3% |
Bu jedwali muhimu kisayansi matokeoni ortaya qoyur: yalniz daha boyuk va ya sparse bir MoE matumizi edilmasi cross-embodiment transfer uchun yetarli deyil. Vanilla Sparse MoE mafunzo paylanmasinda yuksak matokeo versa da, gorunmayan robotida ciddi shakilda mafanikiosuz olmushdur.
An boyuk transfer yaxshnashmasi embodiment-aware routing loss alava edildikda ortaya chixmishdir. Load-balancing loss isa takbashina yuksak transfer yaratmasa da, ekspert matumizisinin bir necha eksperta chokmasinin qarshisini alan tamamlayici rol oynayir.
Je, wataalamu hubobea kweli kulingana na roboti?
Chanzonin 14-cu ukurasasindaki Kielelezo 6-da 16 routed expert-in alti roboti uchun aktivlashma statistikalari verilir. UR5 xususna E1, E6, E9 va E12; Franka Panda isa E2, E8, E10 va E11 ekspertlarini daha guclu aktivlashdirmishdir. Hata hivyo hech bir ekspert yalniz bir robotia xas deyil va butun ekspertlarda sifirdan boyuk matumizi mushahida olunur.
Bu davranish modelin “roboti kimliyi = ekspert” kimi kobud uygunlashdirma oyranmadiyini; bazi icra sifalarini roboti arasinda paylasharkan baznarini embodiment-a xas ayirdigini dushundurur.
Franka uchun MoE darinliyi boyunca aparnan analizda an six matumizi olunan dord ekspertin umumi aktivlashma payi birinci qatda taxminan %43,4 ikan altinci MoE qatinda taxminan %63,4-a yuksalmishdir. Waandishi bunu embodiment-spesifik ixtisaslashmanin erkan qatda qafil ortaya chixmadigi, kitendo tamsili darinlashdikca marhalali shakilda formalashdigi kimi sharh edirlar.
Idadi ya wataalamu na unyeti wa Top-K
Alava E-daki tacrubalarda an yaxshi kombinasiya 16 routed expert va Top-4 kimi tapilmishdir:
| Idadi ya wataalamu | Top-K | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|---|
| 8 | 2 | 96,9% | 54,2% | 88,1% |
| 8 | 4 | 97,2% | 56,4% | 89,7% |
| 16 | 2 | 97,4% | 57,9% | 90,8% |
| 16 | 4 | 97,9% | 59,7% | 92,3% |
| 32 | 8 | 97,3% | 57,9% | 90,9% |
Chox az ekspert embodiment tofautnarini modellama tutumunu imewekewa kikomolashdirarkan, haddindan artiq chox ekspert paylashimi azaldaraq routing-in parchalanmasina yol acha bnar. Banzar shakilda chox ashagi Top-K ifada tutumunu imewekewa kikomolashdirir; chox yuksak Top-K isa sparse ixtisaslashmani zaifladir.
Maudhui ya sharti la embodiment
Tam embodiment embedding \(e_k\) dord nov data ehtiva edir:
- roboti kimliyi,
- qolun sarbastlik daracasi,
- link uzunlugu statistikalari,
- gripper tipi.
Yalniz ID matumizi edildikda 100-shot matokeosi %53,9 va 300-shot matokeosi %87,0 ikan tam embodiment achiqlamasi na bu dayarlar muvafiq olaraq %59,7 va %92,3-a yuksalmishdir. Bu matokeo qazancin yalniz roboti etiketinin azbarlanmasindan qaynaqlanmadigina dair ablasion dastak tamin edir.
Utafitiin dastakladiyi matokeo
- Kamera-nafasi CU-Action usimamizii bu tacruba duzaninda roboti-space action usimamiziindan daha yuksak cross-embodiment transfer performansi tamin etmishdir.
- Paylashnan ekspert, embodiment-aware routing va load-balancing birlikda matumizi edildikda gorunmayan robotia transfer aydin shakilda yaxshnashmishdir.
- CM-VLA ham LIBERO, ham da ME-LIBERO-da muqayisa ednan kuu VLA baseline-larindan daha yuksak orta mafanikio vermishdir.
- Halisi Sawyer roboti tathminisinda CM-VLA an yuksak alama ya wastani iliyosawazishwau yaratmishdir.
- Few-shot leave-one-roboti-out tacrubalarinda xususna 50–300 onyesho araliginda guclu numuna samaraliliyi yamepatikana.
- Routing analizi tofautili robotiin tofautili, lakin qisman paylashilmish ekspert matumizi naxishlari inkishaf etdirdiyini huonyesha.
Utafitiin dastaklamadiyi matokeo
- CM-VLA-nin butun roboti novlarinda eyni mafanikiou gostaracayi subut edilmamishdir.
- Bimanual manipulyasiya qiymatlandirilmamishdir.
- Dexterous-hand usimamizii qiymatlandirilmamishdir.
- End-effector delta xaricinda yuksak olchulu kitendo makanlarinda eyni performans haijaonyeshwa.
- ME-LIBERO simulyasiya matokeoi takbashina genish miqyasli sanaye saha mafanikiou manasina galmir.
- Halisi dunya tacrubalari Sawyer robotiu va chanzoda muayyan ednan kazi halnari na imewekewa kikomodur.
- “State-of-the-art” ifadasi yalniz utafitiin sechdiyi baseline va tathmini protokollari kontekstinda sharh edilmalidir.
Vikwazo
Utafitiin ilk kuu imewekewa kikomoiyyati arxitekturanin kuuan mkono mmoja end-effector delta usimamizi problemina gora inkishaf etdirilmish olmasidir. Waandishi iki qollu manipulyasiya, dexterous hand va daha yuksak olchulu idaraetma interfeyslarini galacak ish sahalari kimi achiq huonyeshalar.
Ikinci imewekewa kikomoiyyat halisi dunyadaki CU-Action etiketlarinin FEEPE kuuli pose estimation sistemindan galmasidir. Ust gripper mustavisinin kamera baxishina taxminan paralel oldugu hallarda poz taxmin xatasi arta bnar.
Uchuncu olaraq halisi roboti tacrubalarinin ahatasi simulyasiya benchmark-ina nisbatan daha dardir. Naticalar tofautili fiziki roboti, fabrik sharaitlari, uzunmuddatli ish, tahlukasizlik baximindan kritik kaznar va ya idaraetma gecikmalarinin genish spektri uchun birbasha umumnashdirna bilmaz.
Dorduncu olaraq taxminan 4 milyard parametrli modelin 16 adad 80 GB NVIDIA A800 uzarinda 14 gun on mafunzo talab etmasi metodun hesablama xarcinin ashagi olmadigini hueleza. Maqalanin “few-shot” ustunluyu hadaf roboti uchun lazim olan yeni onyesho sayina aiddir; kuu modelin ilkin mafunzo xarcinin kichik oldugu anlamina galmir.
Dokezo la chanzo na mbinu
Kichwa asili: CM-VLA: Camera-Space-Guided Mixture-of-Experts Policy for Few-shot Cross-Embodiment Transfer
Waandishi: Bo Liu, Liming Zhang, Yuhan Wang, Yong Liu.
Mwandishi anayewajibika: Yong Liu.
Taasisi: Nanjing University of Science and Technology, Nanjing, Jiangsu, China.
Alava afiliyasiya: State Key Laboratory of Intelligent Manufacturing of Advanced Construction Machinery, Xuzhou, Jiangsu, China.
Aina ya chanzo: Preprint utafiti maqalasi; raychi tathminisindan kechmamishdir.
Jukwaa: SSRN.
SSRN DOI: 10.2139/ssrn.6915199.
Tarehe ya uchapishaji: 10 iyun 2026.
Rekodi rasmi: https://ssrn.com/abstract=6915199
Ufadhili: National Natural Science Fund of China, Grant No. 61473155.
Mgongano wa maslahi: Waandishi bilinan raqib maliyya maragi va ya ishi tasirlaya bnacak shaxsi munasibat olmadigini bayan etmishdir.
Michango ya waandishi: Bo Liu metod, utafiti, data kurasiyasi va ilk qaralama; Liming Zhang proqram taminati va data kurasiyasi; Yuhan Wang data kurasiyasi; Yong Liu konseptuallashdirma, maliyya taminati va yazi tathminisi vazifalarini uzarina goturmushdur.
Msimbo na maonyesho: Chanzo utafiti kod va demonstrasiyalarin lbycdy.github.io/CM-VLA/ unvaninda yayimlanacagini hueleza.
Mbinuik sarhad: Tapintnar mkono mmoja end-effector delta usimamizii, LIBERO/ME-LIBERO benchmark-lari va chanzoda muayyan ednan halisi Sawyer roboti tathminnarina aiddir. Daha genish embodiment va kitendo makanlarinda mustaqil dogrulama lazimdir.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *