

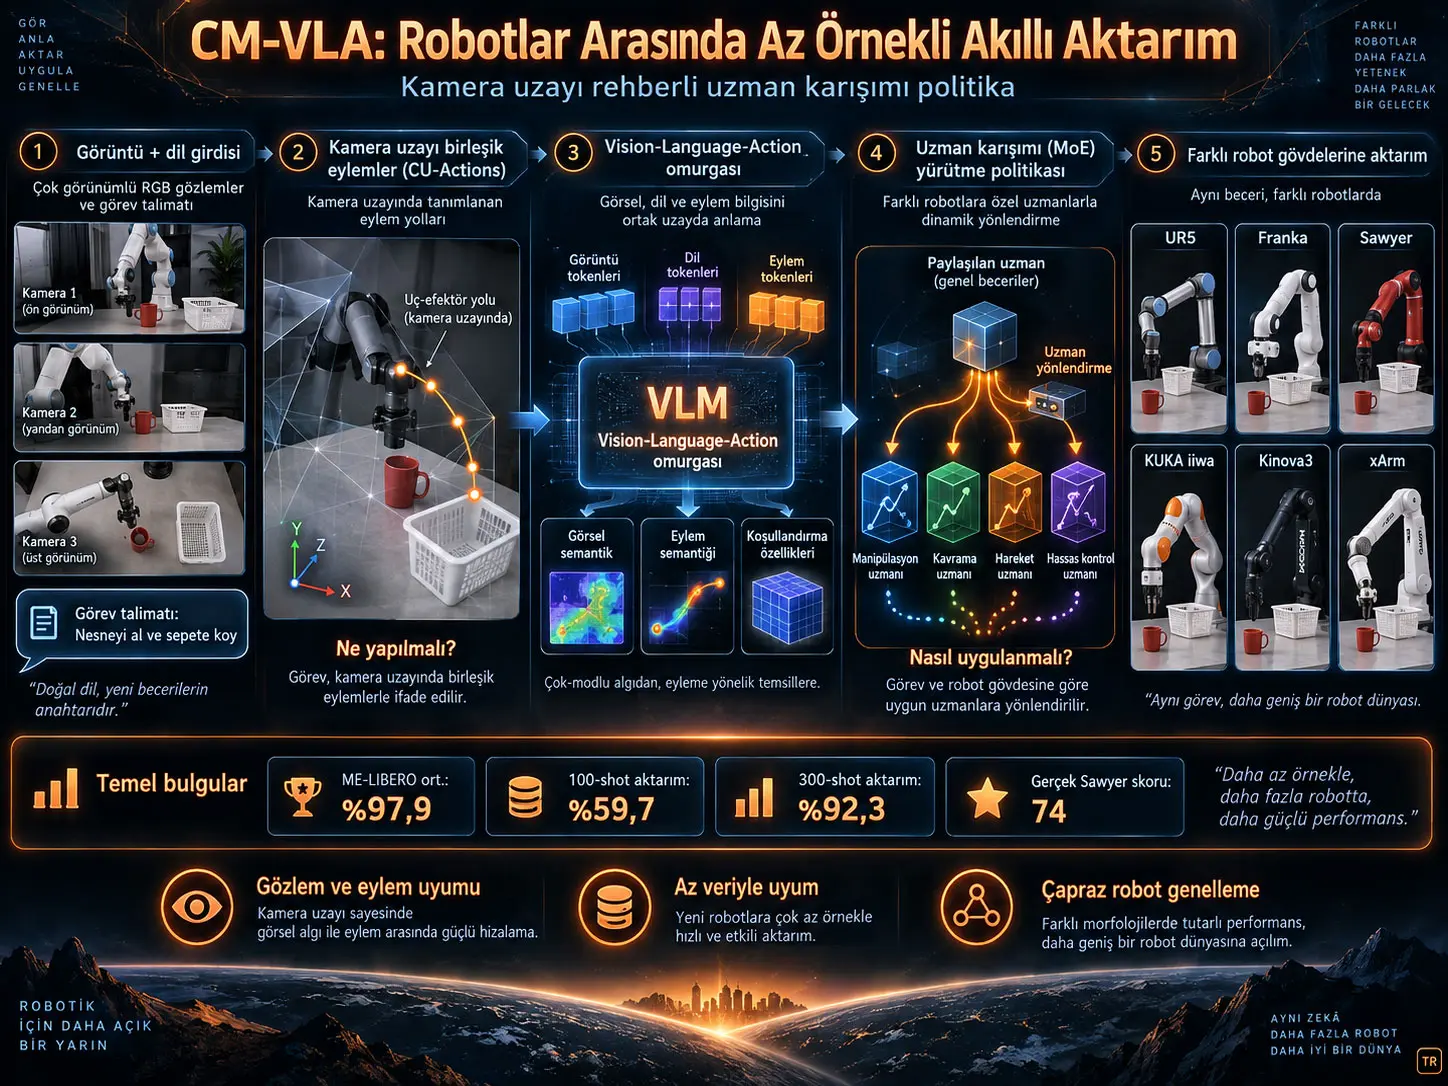
CM-VLA, farklı robot gövdeleri arasında az sayıda yeni gösterimle görev aktarımını kolaylaştırmak için kamera uzayında ortak eylem semantiği ile robot-özel yürütme politikasını birbirinden ayıran bir Vision-Language-Action mimarisidir. Model, Camera-space Unified Actions (CU-Actions) adı verilen kamera-uzayı eylemlerini VLM omurgası için yardımcı denetim olarak kullanır; ardından embodiment-aware Mixture-of-Experts (MoE) flow policy, ortak semantiği hedef robotun kinematik yapısı ve kontrol özelliklerine uygun sürekli robot-uzayı eylemlerine dönüştürür. Çalışmada CM-VLA, ME-LIBERO üzerinde %97,9 ortalama başarıya, görünmemiş robotlara 100 gösterimlik aktarımda %59,7 ve 300 gösterimde %92,3 ortalama başarıya ulaşmıştır. Gerçek Sawyer robot deneylerinde ortalama normalize skor %74 olarak bildirilmiştir. Bununla birlikte sonuçlar tek kollu end-effector delta kontrol bağlamında elde edilmiştir ve modelin çift kollu robotlara, becerikli ellere veya farklı eylem uzaylarına aynı performansla genelleneceğini göstermez.
Vision-Language-Action modeli, görsel gözlem ve doğal dil talimatlarını robotun uygulayabileceği eylemlere dönüştüren çok kipli bir robotik politika sınıfıdır. CM-VLA'nın ayırt edici özelliği, “ne yapılacağına” ilişkin robotlar arasında paylaşılabilir semantiği kamera uzayında öğrenmesi ve “nasıl uygulanacağına” ilişkin robot-özel yürütmeyi ayrı bir uzman karışımı politikasına bırakmasıdır.
Neden farklı robotlar arasında görev aktarımı zordur?
Bir robot manipülasyon görevi semantik olarak aynı kalsa bile görevi gerçekleştiren fiziksel robot değiştiğinde problem basit bir koordinat dönüşümünden daha karmaşık hale gelir. Robotların eklem sayıları, bağlantı uzunlukları, çalışma uzayları, sensörleri, proprioseptif durum dağılımları, kamera konumları, kontrol frekansları ve gripper mekanizmaları farklı olabilir.
Örneğin “yeşil bezi al ve tabağın üzerine koy” talimatı UR5, Franka Panda, Sawyer, KUKA iiwa, Kinova3 ve xArm için aynı görev semantiğini taşır. Ancak her robotun aynı sonlandırıcı hareketini gerçekleştirmek için ihtiyaç duyduğu alt düzey hareket komutları aynı değildir.
Çalışmanın ele aldığı temel sorun, bu iki seviyenin mevcut VLA sistemlerinde yeterince ayrıştırılmamasıdır. Görsel kodlayıcı kameradan gelen görüntüyü işlerken eylem etiketi çoğu veri setinde robotun kendi koordinat sisteminde tanımlanır. Böylece model, görevi öğrenmenin yanında kamera ile robot koordinat sistemi arasındaki dönüşümü de örtük biçimde çözmeye zorlanır.
CM-VLA Nedir?
CM-VLA, kamera uzayında tanımlanmış gövdeden bağımsız eylem semantiğini bir vision-language omurgasında öğrenen ve bu semantiği embodiment-aware Mixture-of-Experts flow policy aracılığıyla hedef robotun sürekli kontrol komutlarına dönüştüren cross-embodiment VLA mimarisidir. Modelin temel ayrımı, kamera uzayındaki algısal “ne yapılmalı?” temsili ile robot uzayındaki yürütmesel “nasıl yapılmalı?” kontrolünü iki ayrı öğrenme problemi olarak ele almasıdır.
Kamera-uzayı birleşik eylemleri
Çalışmanın temel ara temsili Camera-space Unified Action, yani CU-Action'dır. Her zaman adımındaki kamera-uzayı eylemi şu biçimde tanımlanır:
\[ a_t^c=(\Delta p_t^c,\Delta r_t^c,g_t) \]
Burada:
- \(\Delta p_t^c\), sonlandırıcının kamera koordinat sistemindeki öteleme değişimini;
- \(\Delta r_t^c\), kamera koordinat sistemindeki dönme değişimini;
- \(g_t\), gripper komutunu temsil eder.
Bu gösterimin bilimsel rolü, bir robotun kendi eklem veya taban koordinatlarından mümkün olduğunca bağımsız bir ara eylem semantiği oluşturmaktır. Kamera görüntüsü de kamera uzayında gözlendiği için, eylem denetiminin aynı geometrik bağlama taşınması gözlem ile eylem etiketi arasındaki uyumsuzluğu azaltmayı amaçlar.
Önemli bir ayrıntı, CU-Actions'ın doğrudan son robot kontrol komutu olarak kullanılmamasıdır. Çalışmada discretized CU-Actions, VLM omurgasının eğitimi için yardımcı denetim görevi görür. Gerçek yürütülebilir sürekli robot eylemleri ayrı bir downstream policy tarafından üretilir.
CM-VLA “Ne Yapılacağını” ve “Nasıl Yapılacağını” Nasıl Ayırır?
CM-VLA'da kamera-uzayı VLM katmanı görsel gözlem ve dil talimatından embodiment-agnostic eylem semantiğini öğrenerek “ne yapılacağını” temsil eder; robot-uzayı MoE flow policy ise robotun proprioseptif durumu ve embodiment koşulunu kullanarak aynı semantiğin belirli bir robot üzerinde “nasıl uygulanacağını” sürekli kontrol sinyallerine dönüştürür.
Vision-language omurgası
VLM omurgası PaliGemma tabanlıdır. PaliGemma, SigLIP görsel kodlayıcısı ile Gemma dil modelini birleştirir. Modele birden fazla RGB gözlemi ve dil talimatı verilir:
\[ \pi_\phi(a_t^c,\hat l_t \mid I_t^1,\ldots,I_t^n,l) \]
Burada \(a_t^c\) CU-Action, \(\hat l_t\) ise görev planı, alt görev ayrımı, hareket primitive'leri ve gripper konumu gibi ek algısal görev yapısını temsil eden tokenlaştırılmış reasoning çıktısıdır.
VLM'nin seçilmiş katmanlarından alınan gizli durumlar anahtar-değer özelliklerine projekte edilir:
\[ K_t^{(m)}=H_t^{(m)}W_K^{(m)}, \qquad V_t^{(m)}=H_t^{(m)}W_V^{(m)} \]
Bu özellikler:
\[ C_t=\{(K_t^{(m)},V_t^{(m)})\}_{m\in M} \]
koşullandırma kümesini oluşturur ve cross-attention üzerinden sürekli robot eylemi üreten alt politikaya aktarılır. Yazarların tasarımındaki önemli nokta yalnız son VLM katmanını kullanmak yerine seçilmiş katmanlardan zengin bir KV koşullandırması sağlamaktır.
CU-Action eğitim hedefleri
Metinsel reasoning çıktısı için nedensel attention ve token-token tahmin kullanılır:
\[ L_{cot}=-\sum_{k=1}^{K}\log\pi_\phi(l_t^k\mid v_t,l_t^{<k}) \]
Discretized CU-Actions için ise tüm eylem dizisindeki ilişkileri birlikte modelleyebilmek amacıyla full-attention kullanılır:
\[ L_{cu\_action}=-\sum_{m=1}^{M}\log\pi_\phi(a_m^c\mid v_t,l) \]
Yazarlar bu tercihin CU-Action dizisinde daha bütünlüklü ve yumuşak geçişli hareket yapıları öğrenmeye yardımcı olduğunu belirtmektedir.
Robot-uzayı Mixture-of-Experts politikası
İkinci aşamada model, kamera-uzayı semantiğini gerçek robotun çalıştırabileceği sürekli robot-space action, yani RS-Actions'a dönüştürür. Bunun için flow matching tabanlı Transformer politikası kullanılır.
Politikanın ilk katmanları bütün robotlar için ortak işleme yapar. Daha derindeki son altı blok ise MoE bloklarıdır. Embodiment koşulu \(e_k\), ortak temsil ile birleştirilerek robot-özel uzman yönlendirmesi için kullanılır.
Her token için router, yönlendirilebilir uzmanlar üzerinde bir olasılık dağılımı oluşturur:
\[ \alpha_{t,u}^{(\ell)} = \operatorname{Softmax} \left( Router_\ell( LN(\tilde z_{t,u}^{(\ell)}) ) \right) \]
Yalnız en yüksek skorlu Top-K uzman etkinleştirilir.
Paylaşılan uzman ile yönlendirilen uzmanların farkı
Her MoE bloğunda sürekli etkin olan bir shared expert ve embodiment farklılıklarını modelleyen bir uzman havuzu vardır:
\[ MoE_{\ell,u}(\tilde z) = E_{\ell}^{sh}(\tilde z) + \sum_{j\in TopK(\alpha)} \alpha_jE_{\ell,j}(\tilde z) \]
Shared expert, robotlar arasında ortak olan yürütme yapısını öğrenmeye yöneliktir. Routed experts ise kinematik sınırlar, kontrol frekansı, eylem arayüzü ve yürütme biçimi gibi robotlar arasında değişen özellikleri soğurur.
Buradaki bilimsel fikir “her robot için tek uzman” oluşturmak değildir. Yazarlar özellikle overcomplete expert pool kullanmakta ve uzmanların farklı robotlar arasında kısmen paylaşılmasını istemektedir.
Embodiment-aware routing loss
CM-VLA'nın önemli yeniliklerinden biri router'ın yalnız görev içeriğine değil robot gövdesinin yürütme özelliklerine de duyarlı uzman tercihleri öğrenmesini teşvik eden \(L_{emb}\) kaybıdır.
Temel biçimi:
\[ L_{emb}=L_{intra}+\lambda_{sep}L_{inter} \]
\(L_{intra}\), aynı embodiment için farklı görevlerdeki yönlendirme örüntülerinin birbirine yakın kalmasını teşvik eder. \(L_{inter}\) ise farklı embodiment prototiplerinin belirli bir margin içinde birbirine aşırı yaklaşmasını cezalandırır.
Bu kaybın amacı görev farklılığı ile robot farklılığını karıştırmadan, aynı görev semantiği altında robot yürütmesinden kaynaklanan farklılıkların uzman seçiminde görünür hale gelmesidir.
Load-balancing loss
Sparse MoE sistemlerinde birkaç uzmanın sürekli seçilmesi ve diğerlerinin kullanılmaması “expert collapse” problemine yol açabilir. CM-VLA bunu azaltmak için uzmanların ampirik kullanım sıklığı ile beklenen routing olasılığını kullanan bir dengeleme terimi uygular:
\[ L_{bal}=\sum_{j=1}^{N_E}f_jP_j \]
Kaynakta bu terimin embodiment ayrımını ortadan kaldırmak için değil, uzman havuzunun aşırı birkaç uzmanda yoğunlaşmasını önlemek için kullanıldığı özellikle vurgulanmaktadır.
Flow-matching loss
Robot-uzayı sürekli eylemleri flow matching ile üretilir. Gerçek eylem chunk'ı \(A_t^r\), Gaussian gürültüsü \(\epsilon\) ve akış zamanı \(\tau\) kullanılarak:
\[ x_t^\tau=(1-\tau)\epsilon+\tau A_t^r \]
biçiminde gürültülü ara duruma dönüştürülür. Hedef vektör alanı:
\[ u_t^\tau=A_t^r-\epsilon \]
olarak tanımlanır ve politika bu vektör alanını öğrenir:
\[ L_{fm} = \mathbb{E} \left[ \|v_\theta(x_t^\tau,\tau,q_t,e_k;C_t)-u_t^\tau\|_2^2 \right] \]
Toplam eğitim kaybı:
\[ L=L_{fm}+\lambda_{bal}L_{bal}+\lambda_{emb}L_{emb} \]
şeklindedir. Kaynakta \(\lambda_{bal}=0.15\) ve \(\lambda_{emb}=1\) olarak verilmiştir.
CU-Actions gerçek dünyada nasıl üretiliyor?
Simülasyonda robot sonlandırıcı pozu ve kamera kalibrasyonu doğrudan erişilebilir olduğundan robot uzayındaki pose kamera koordinatlarına dönüştürülür. Ardışık iki kare arasındaki göreli kamera-uzayı hareket:
\[ \Delta T_t^c=T_{t+1}^c(T_t^c)^{-1} \]
ile hesaplanır ve öteleme, dönme ile gripper durumuna ayrılarak CU-Action etiketi oluşturulur.
Gerçek robotta doğrudan kamera-robot extrinsic dönüşümünü kullanmak; eklem sıfır kaymaları, link toleransları, lens distorsiyonu, intrinsic hata ve hand-eye kalibrasyon hatalarından etkilenebilir. Bu nedenle çalışma gerçek dünya etiketlerinde marker-free FEEPE yönteminden yararlanır.
Ek B'de gösterildiği üzere end-effector CAD modeli için 80 bakış açısı ve 12 in-plane rotasyon kullanılarak toplam 960 referans template oluşturulmuştur. DINOv2 özellikleriyle hedef görüntüye en yakın beş referans görünüm seçilmiş, 2D–3D eşleşmeler ve PnP ile başlangıç pozu kestirilmiştir. Temporal keyframe yöntemi en fazla sekiz keyframe kullanır ve keyframe güncelleme açısı 10° olarak verilmiştir.
Çalışmanın Yöntemi ve Bulguları
Model ve eğitim altyapısı
- Yaklaşık model büyüklüğü: 4 milyar parametre.
- VLM başlangıcı: PaliGemma-3B.
- VLM katman sayısı: 18.
- Gizli boyut: 2048.
- Görsel encoder: SigLIP.
- Görüntü boyutu: 224 × 224.
- Eğitim donanımı: 16 NVIDIA A800, her biri 80 GB.
- Ön eğitim süresi: 14 gün.
- Global batch size: 512.
- Optimizer: AdamW.
- \(\beta_1=0.9\), \(\beta_2=0.95\).
- Eğitim adımı: 60.000.
- Başlangıç learning rate: 5×10⁻⁵.
- Warm-up: 2.000 adım.
- Learning-rate schedule: cosine decay.
- Action horizon: H=50.
- MoE: 16 routed expert + 1 sürekli etkin shared expert.
- Routing: Top-4.
- \(L_{inter}\) margin değeri: 0,25.
Ön eğitim veri kaynakları
Ön eğitim veri havuzu Open X-Embodiment (OXE), LIBERO ve DROID veri setlerinden oluşturulmuştur ve toplamda 19 embodiment ile çeşitli manipülasyon görevlerini kapsamaktadır.
ME-LIBERO nedir?
ME-LIBERO, özgün LIBERO benchmark'ını aynı görev semantiğini farklı robot gövdeleri altında değerlendirecek biçimde genişleten çok-embodiment test ortamıdır. Çalışmada altı tek kollu robot kullanılmıştır:
- UR5
- Franka Panda
- Sawyer
- KUKA iiwa
- Kinova3
- xArm
Dil talimatı, nesneler, sahne düzeni, görev hedefi ve bitirme koşulları sabit tutulurken robotun görsel gözlemi, CU-Actions, RS-Actions, kinematik yapısı, çalışma geometrisi ve proprioseptif istatistikleri değişmektedir. Bu tasarım embodiment heterojenliğinin görev semantiğinden mümkün olduğunca ayrıştırılmasını amaçlar.
CM-VLA Few-Shot Robot Aktarımında Ne Kadar Başarılıdır?
ME-LIBERO leave-one-robot-out değerlendirmesinde CM-VLA'nın altı hedef robot üzerindeki ortalama başarı oranı 50 gösterimde %33,7, 100 gösterimde %59,7, 300 gösterimde %92,3, 500 gösterimde %93,5 ve 1000 gösterimde %97,0'dır. Çalışmanın değerlendirme protokolünde model 100-shot koşulunda altı hedef robotun tamamında en yüksek sonucu elde etmiş, 300-shot koşulunda ise altı robotun dördünde en yüksek performansı göstermiştir.
LIBERO ve ME-LIBERO sonuçları
| Yöntem | LIBERO Ortalama | ME-LIBERO Ortalama |
|---|---|---|
| OpenVLA | 76,5% | 73,2% |
| π0 | 92,1% | 84,9% |
| π0.5 | 96,9% | 94,5% |
| OC-VLA | 95,0% | 95,7% |
| CM-VLA | 97,0% | 97,9% |
Tek embodiment LIBERO ortamında CM-VLA %97,0 ile en yüksek ortalama sonucu vermiştir. Çok embodiment ME-LIBERO ortamında ise fark daha belirgin hale gelmiş ve CM-VLA %97,9'a ulaşmıştır.
Gerçek Sawyer robotu değerlendirmesi
Gerçek-dünya deneyleri Sawyer robot üzerinde dört farklı genelleme koşulunda yapılmıştır:
- farklı mekânsal ilişkiler,
- farklı hedef renkleri,
- aynı sahnede farklı hedefler,
- farklı sahnelerden oluşan out-of-domain genelleme.
| Yöntem | Ortalama normalize skor |
|---|---|
| OpenVLA | 19 |
| π0 | 44 |
| π0.5 | 60 |
| OC-VLA | 55 |
| CM-VLA | 74 |
CM-VLA dört gerçek-dünya koşulunun tamamında karşılaştırılan yöntemlerden daha yüksek sonuç vermiştir. En büyük göreli avantajın sahnenin tamamen değiştiği out-of-domain koşulda gözlenmesi, yazarların kamera-uzayı semantiğinin görsel dağılım değişimlerine karşı daha sağlam aktarılabildiği yorumunu desteklemektedir.
Leave-one-robot-out few-shot aktarımı
Bu deneyde altı robottan biri eğitim sırasında tamamen dışarıda bırakılır. Kalan beş robotla model eğitildikten sonra görünmeyen hedef robota yalnız 50, 100, 300, 500 veya 1000 gösterim verilerek fine-tuning yapılır.
| Hedef robot gösterim sayısı | Ortalama başarı |
|---|---|
| 50-shot | 33,7% |
| 100-shot | 59,7% |
| 300-shot | 92,3% |
| 500-shot | 93,5% |
| 1000-shot | 97,0% |
Yazarlar pratik anlamlılık eşiğini %90 ortalama başarı olarak aldığında CM-VLA'nın bu eşiğe ulaşmak için gereken gösterim sayısı bakımından rakip yöntemlere göre yaklaşık %13,6–69,7 veri verimliliği artışı sağladığını bildirmektedir.
100-shot koşulundaki robot-özel CM-VLA sonuçları UR5 için %59,8; Franka için %60,9; Sawyer için %52,6; KUKA iiwa için %61,0; Kinova3 için %60,4 ve xArm için %63,4 olarak verilmiştir.
Kamera-uzayı denetimi gerçekten fark yaratıyor mu?
| VLM denetimi | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Standart | 91,8% | 50,9% | 84,2% |
| Discretized RS-Actions | 94,1% | 55,8% | 87,3% |
| Discretized CU-Actions | 97,9% | 59,7% | 92,3% |
RS-Actions yerine CU-Actions ile VLM denetimi ME-LIBERO başarısını %94,1'den %97,9'a, 100-shot aktarımı %55,8'den %59,7'ye ve 300-shot aktarımı %87,3'ten %92,3'e çıkarmıştır.
MoE politikasının ablasyonu
| Politika | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|
| Dense Flow Policy | 95,2% | 22,3% | 50,0% |
| Vanilla Sparse MoE | 98,0% | 4,8% | 15,7% |
| MoE + Shared Expert | 97,8% | 7,8% | 25,7% |
| Shared Expert + Lbal | 94,7% | 6,8% | 23,4% |
| Shared Expert + Lemb | 95,2% | 40,6% | 82,0% |
| Tam CM-VLA | 97,9% | 59,7% | 92,3% |
Bu tablo önemli bir bilimsel sonucu ortaya koymaktadır: yalnız daha büyük veya sparse bir MoE kullanılması cross-embodiment aktarım için yeterli değildir. Vanilla Sparse MoE eğitim dağılımında yüksek sonuç vermesine rağmen görünmeyen robotlarda ciddi biçimde başarısız olmuştur.
En büyük aktarım iyileşmesi embodiment-aware routing loss eklendiğinde ortaya çıkmıştır. Load-balancing loss ise tek başına yüksek aktarım üretmemekle birlikte uzman kullanımının birkaç uzmana çökmesini engelleyen tamamlayıcı rol oynamaktadır.
Uzmanlar gerçekten robotlara göre uzmanlaşıyor mu?
Kaynağın sayfa 14'teki Şekil 6'sında 16 routed expert'in altı robot için aktivasyon istatistikleri verilmektedir. UR5 özellikle E1, E6, E9 ve E12; Franka Panda ise E2, E8, E10 ve E11 uzmanlarını daha güçlü etkinleştirmiştir. Bununla birlikte hiçbir uzman yalnız tek robota özgü değildir ve bütün uzmanlarda sıfırdan büyük kullanım gözlenmektedir.
Bu davranış, modelin “robot kimliği = uzman” gibi kaba bir eşleme öğrenmediğini; bazı yürütme özelliklerini robotlar arasında paylaşırken bazılarını embodiment'a özgü ayırdığını düşündürmektedir.
Franka için MoE derinliği boyunca yapılan analizde en yoğun kullanılan dört uzmanın toplam aktivasyon payı birinci katmanda yaklaşık %43,4 iken altıncı MoE katmanında yaklaşık %63,4'e yükselmiştir. Yazarlar bunu embodiment-spesifik uzmanlaşmanın erken katmanda aniden ortaya çıkmadığı, eylem temsili derinleştikçe aşamalı biçimde oluştuğu şeklinde yorumlamaktadır.
Uzman sayısı ve Top-K hassasiyeti
Ek E'deki deneylerde en iyi kombinasyon 16 routed expert ve Top-4 olarak bulunmuştur:
| Uzman sayısı | Top-K | ME-LIBERO | 100-shot | 300-shot |
|---|---|---|---|---|
| 8 | 2 | 96,9% | 54,2% | 88,1% |
| 8 | 4 | 97,2% | 56,4% | 89,7% |
| 16 | 2 | 97,4% | 57,9% | 90,8% |
| 16 | 4 | 97,9% | 59,7% | 92,3% |
| 32 | 8 | 97,3% | 57,9% | 90,9% |
Çok az uzman embodiment farklılıklarını modelleme kapasitesini sınırlarken aşırı fazla uzman paylaşımı azaltarak routing'in parçalanmasına yol açabilmektedir. Benzer biçimde çok düşük Top-K ifade kapasitesini sınırlar; çok yüksek Top-K ise sparse uzmanlaşmayı zayıflatır.
Embodiment koşulunun içeriği
Tam embodiment embedding \(e_k\), dört tür bilgi içerir:
- robot kimliği,
- kolun serbestlik derecesi,
- link uzunluğu istatistikleri,
- gripper tipi.
Yalnız ID kullanıldığında 100-shot sonucu %53,9 ve 300-shot sonucu %87,0 iken tam embodiment açıklamasıyla bu değerler sırasıyla %59,7 ve %92,3'e yükselmiştir. Bu sonuç, kazanımın yalnız robot etiketinin ezberlenmesinden kaynaklanmadığına dair ablasyon desteği sağlamaktadır.
Çalışmanın desteklediği sonuçlar
- Kamera-uzayı CU-Action denetimi, bu deney düzeninde robot-space action denetiminden daha yüksek cross-embodiment aktarım performansı sağlamıştır.
- Paylaşılan uzman, embodiment-aware routing ve load-balancing birlikte kullanıldığında görünmeyen robotlara aktarım belirgin biçimde iyileşmiştir.
- CM-VLA hem LIBERO hem ME-LIBERO'da karşılaştırılan ana VLA baseline'larından daha yüksek ortalama başarı vermiştir.
- Gerçek Sawyer robot değerlendirmesinde CM-VLA en yüksek ortalama normalize skoru üretmiştir.
- Few-shot leave-one-robot-out deneylerinde özellikle 50–300 gösterim aralığında güçlü örnek verimliliği elde edilmiştir.
- Routing analizi farklı robotların farklı fakat kısmen paylaşılmış uzman kullanım desenleri geliştirdiğini göstermektedir.
Çalışmanın desteklemediği sonuçlar
- CM-VLA'nın bütün robot türlerinde aynı başarıyı göstereceği kanıtlanmamıştır.
- Bimanual manipülasyon değerlendirilmemiştir.
- Dexterous-hand kontrolü değerlendirilmemiştir.
- End-effector delta dışındaki yüksek boyutlu eylem uzaylarında aynı performans gösterilmemiştir.
- ME-LIBERO simülasyon sonuçları tek başına geniş ölçekli endüstriyel saha başarısı anlamına gelmez.
- Gerçek dünya deneyleri Sawyer robotu ve kaynakta tanımlanan görev koşullarıyla sınırlıdır.
- “State-of-the-art” ifadesi yalnız çalışmanın seçtiği baseline ve değerlendirme protokolleri bağlamında yorumlanmalıdır.
Sınırlılıklar
Çalışmanın ilk temel sınırlılığı, mimarinin esas olarak tek kollu end-effector delta kontrol problemine göre geliştirilmiş olmasıdır. Yazarlar çift kollu manipülasyon, dexterous hand ve daha yüksek boyutlu kontrol arayüzlerini gelecek çalışma alanları olarak açıkça belirtmektedir.
İkinci sınırlılık gerçek dünyadaki CU-Action etiketlerinin FEEPE tabanlı pose estimation sisteminden gelmesidir. Üst gripper düzleminin kamera görüşüne yaklaşık paralel olduğu durumlarda poz tahmin hatası artabilir.
Üçüncü olarak gerçek robot deneylerinin kapsamı, simülasyon benchmark'ına kıyasla daha dardır. Sonuçlar farklı fiziksel robotlar, fabrika koşulları, uzun süreli çalışma, güvenlik açısından kritik görevler veya kontrol gecikmelerinin geniş spektrumu için doğrudan genellenemez.
Dördüncü olarak yaklaşık 4 milyar parametreli modelin 16 adet 80 GB NVIDIA A800 üzerinde 14 gün ön eğitim gerektirmesi, yöntemin hesaplama maliyetinin düşük olmadığı anlamına gelir. Makalenin “few-shot” avantajı hedef robot için gereken yeni gösterim sayısına ilişkindir; temel modelin ilk eğitim maliyetinin küçük olduğu anlamına gelmez.
Kaynak ve Yöntem Notu
Özgün başlık: CM-VLA: Camera-Space-Guided Mixture-of-Experts Policy for Few-shot Cross-Embodiment Transfer
Yazarlar: Bo Liu, Liming Zhang, Yuhan Wang, Yong Liu.
Sorumlu yazar: Yong Liu.
Kurum: Nanjing University of Science and Technology, Nanjing, Jiangsu, China.
Ek afiliyasyon: State Key Laboratory of Intelligent Manufacturing of Advanced Construction Machinery, Xuzhou, Jiangsu, China.
Kaynak türü: Preprint araştırma makalesi; hakem değerlendirmesinden geçmemiştir.
Platform: SSRN.
SSRN DOI: 10.2139/ssrn.6915199.
Yayın tarihi: 10 Haziran 2026.
Resmî kayıt: https://ssrn.com/abstract=6915199
Finansman: National Natural Science Fund of China, Grant No. 61473155.
Çıkar çatışması: Yazarlar bilinen rakip finansal çıkar veya çalışmayı etkileyebilecek kişisel ilişki bulunmadığını beyan etmiştir.
Yazar katkıları: Bo Liu yöntem, araştırma, veri kürasyonu ve ilk taslak; Liming Zhang yazılım ve veri kürasyonu; Yuhan Wang veri kürasyonu; Yong Liu kavramsallaştırma, finansman temini ve yazım değerlendirmesi görevlerini üstlenmiştir.
Kod ve gösterimler: Kaynak çalışma kod ve demonstrasyonların lbycdy.github.io/CM-VLA/ adresinde yayımlanacağını belirtmektedir.
Yöntemsel sınır: Bulgular tek kollu end-effector delta kontrol, LIBERO/ME-LIBERO benchmark'ları ve kaynakta tanımlanan gerçek Sawyer robot değerlendirmelerine aittir. Daha geniş embodiment ve eylem uzaylarında bağımsız doğrulama gereklidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir