


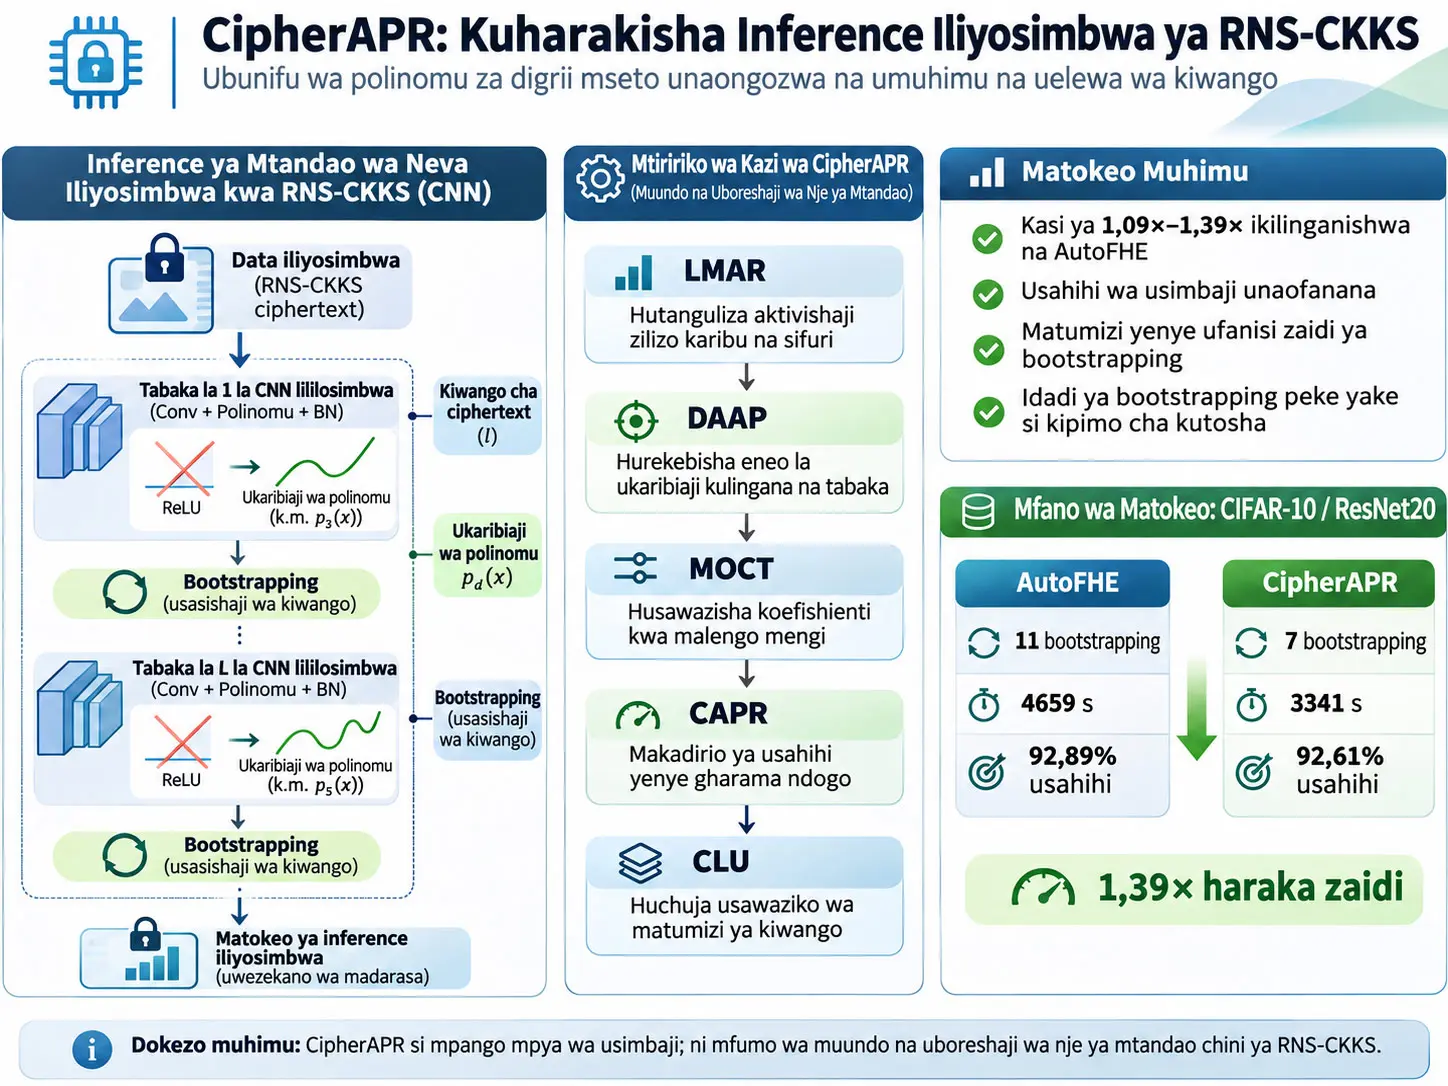
CipherAPR ni mfumo wa nje ya mtandao wa kubuni polinomu za digrii mseto unaochagua, kwa kila tabaka, digrii za polinomu zitakazotumika badala ya aktivishaji za ReLU katika mitandao ya neva inayofanya kazi chini ya usimbaji homomorfiki kamili wa RNS-CKKS, huku ukizingatia matumizi ya ciphertext-level katika uchaguzi huo. Tatizo kuu la utafiti ni kwamba makadirio ya ReLU ya digrii kubwa hutumia multiplicative depth zaidi huku yakihifadhi usahihi, na kuongeza operesheni ghali za bootstrapping. CipherAPR hailengi tu kupunguza idadi ya bootstrapping; pia hujumuisha katika uamuzi wa usanifu kiwango ambacho viwango vya ciphertext vilivyorejeshwa baada ya bootstrapping vinatumika kwa ufanisi.
Mfumo una vipengele vinne vikuu. Low-Magnitude Activation Ratio (LMAR) hutambua tabaka za aktivishaji ambazo viingizo vyake vimejikusanya katika eneo nyeti karibu na sifuri la ReLU, na kutoa kipaumbele kwa tabaka zinazopaswa kupewa digrii kubwa zaidi. Domain-Adaptive Approximation (DAAP) huunda eneo la ukadiriaji wa polinomu linalolingana na masafa ya aktivishaji yaliyoonekana katika kila tabaka. Multi-Objective Coefficient Tuning (MOCT) hujaribu kupunguza hitilafu ya ukadiriaji huku pia ikidhibiti ukubwa wa vigawo na tabia nje ya eneo kuu. Ciphertext-Level Utilization (CLU) huweka nyuma katika mchakato wa utafutaji usanidi wa wagombea unaotumia bajeti ya level iliyorejeshwa katika sehemu za bootstrapping kwa kutokuwa na uwiano.
Katika utafiti, kwenye CIFAR-10 na CIFAR-100 ilitathminiwa mitandao ya ResNet20, ResNet32, ResNet44 na VGG11. Chini ya mipangilio ileile ya RNS-CKKS, CipherAPR ilitoa speedup ya 1,09×–1,39× katika configurations zilizoripotiwa ikilinganishwa na AutoFHE, huku ikihifadhi ciphertext accuracy inayofanana. Katika mfano ulio wazi zaidi wa CIFAR-10/ResNet20, AutoFHE ikiwa na 11 bootstrapping na total latency ya sekunde 4659 ilitoa ciphertext accuracy ya %92,89, huku CipherAPR ikiwa na 7 bootstrapping na latency ya sekunde 3341 ikitoa accuracy ya %92,61.
Matokeo haya hayapaswi kufasiriwa kwamba “bootstrapping chache huwa haraka kiotomatiki katika kila hali”. Chanzo kinaonyesha kuwa level ambayo ciphertext ipo pia huathiri gharama ya operesheni kama rotation, rescaling na key-switching. Katika baadhi ya usanidi, gharama ya operesheni za mstari ya CipherAPR iliongezeka, lakini kupungua zaidi kwa muda wa bootstrapping kulipunguza tena ucheleweshaji wa jumla.
CipherAPR si primitive mpya ya usimbaji FHE na haibadilishi utaratibu wa usalama wa RNS-CKKS. LMAR, DAAP, MOCT, CAPR na CLU hufanya kazi katika usanifu wa modeli wa nje ya mtandao juu ya aktivishaji za plaintext training/calibration au vigezo vya public model. Viingizo vya mtumiaji mtandaoni hubaki vimesimbwa chini ya RNS-CKKS ya kawaida; chanzo kinasema confidentiality hurithiwa kutoka kwa vigezo vya RNS-CKKS vilivyotumika na dhana ya usalama ya Ring Learning With Errors.
Kwa nini tatizo hili linatokea?
Fully Homomorphic Encryption (FHE) huruhusu seva kufanya hesabu juu ya data iliyosimbwa bila kubadilisha data ya mtumiaji kuwa maandishi wazi. Kipengele hiki ni muhimu katika mazingira ya Machine Learning as a Service: mtumiaji husimba ingizo lake, seva huendesha inference ya mtandao wa neva juu ya ciphertext, na mtumiaji hufungua tu matokeo ya mwisho yaliyosimbwa upande wake.
RNS-CKKS inayotumiwa na utafiti ni mpango wa FHE unaosaidia aritmetiki ya makadirio ya namba halisi au changamano. Vekta ya ujumbe husimbwa katika umbo la plaintext polynomial \(m(x)\) na kusimbwa kama ciphertext. Hesabu:
hufanywa juu ya cyclotomic ring.
Hapa modulus ni:
kwa umbo hili. \(\ell\) ni thamani ya ciphertext level inayoonyesha multiplicative capacity iliyobaki ya ciphertext. Kwa sababu kila homomorphic multiplication huongeza scale ya ciphertext, kwa kawaida rescaling huhitajika. Rescaling huondoa prime ya mwisho \(q_\ell\) kutoka modulus chain:
na hivyo level moja hutumika.
Level inapokaribia sifuri, bootstrapping huhitajika ili ciphertext iweze kubeba multiplication zaidi. Bootstrapping huinua ciphertext tena hadi level ya juu inayoweza kutumika, lakini ni operesheni ghali sana katika encrypted inference ya RNS-CKKS.
Kwa Nini Kupunguza Idadi ya Bootstrapping Pekee Hakutoshi?
Ingawa idadi ya bootstrapping ni muhimu, gharama ya operesheni ya RNS-CKKS pia hutegemea level ambayo ciphertext inahesabiwa; level ya juu ina RNS prime hai nyingi zaidi, hivyo operesheni kama rotation, relinearization, multiplication na rescaling zinaweza kuwa ghali zaidi. Kwa hiyo CipherAPR haizingatii tu idadi ya bootstrapping, bali pia ufanisi wa matumizi ya bajeti ya level iliyorejeshwa baada ya bootstrapping katika sehemu mbalimbali.
Kwa nini level katika RNS-CKKS huathiri gharama ya operesheni?
Chanzo kinafafanua active RNS basis kama:
. Idadi ya prime hai ni:
kwa hiyo level inapoongezeka, modulus limb nyingi zaidi hushiriki katika hesabu.
Jumla ya gharama ya primitive homomorphic operation katika level \(\ell\) huandikwa:
.
Hapa \(\mathcal{P}\) inaonyesha aina za primitive operation kama AddCP, AddCC, MulCP, MulCC, Rot, Relin na RS; \(n_k\) idadi ya operesheni husika; na \(t_k(\ell)\) gharama ya operesheni moja katika level \(\ell\).
Utegemezi wa takriban wa level unaotumiwa na chanzo ni:
.
\(N\) ni ring degree. \(\alpha_k\) na \(\beta_k\) ni operation-dependent constants. Operesheni katika kundi la kwanza hukua takriban kwa mstari na idadi ya RNS limb hai; aina za rotation na relinearization zenye key-switching zina utegemezi mkubwa zaidi wa level katika cost model ya chanzo.
Kwa hiyo kupunguza effective level \(L_{\mathrm{eff}}\) baada ya bootstrapping kunaweza kupunguza gharama ya operesheni zinazofuata; lakini \(L_{\mathrm{eff}}\) iliyo chini sana inaweza kuacha multiplicative-depth isiyotosha na kuongeza tena idadi ya bootstrapping.
Chanzo kinaeleza kwa dhana inference latency ya jumla kama:
.
\(N_{\mathrm{boot}}\) ni idadi ya bootstrapping; \(T_{\mathrm{boot}}\) ni gharama ya bootstrapping moja; na \(T_{\mathrm{seg}}^{(j)}\) ni gharama ya hesabu ya sehemu kati ya bootstrapping mbili. Fomula inaonyesha wazi kwamba latency ya jumla haitegemei \(N_{\mathrm{boot}}\) pekee.
Kwa nini ReLU haiwezi kuhesabiwa moja kwa moja?
RNS-CKKS hutoa hasa arithmetic operations kama addition na multiplication. Katika CNN:
kazi hii si polynomial moja kwa moja. Kwa hiyo ReLU hubadilishwa na polynomial approximation inayofaa kwa homomorphic evaluation.
Chanzo kinaeleza ReLU kupitia sign function kama:
.
Sign function ni kazi ngumu kukadiriwa kwa usahihi wa juu na polynomial moja ya digrii ndogo kwa sababu ya discontinuity karibu na sifuri. Kwa hiyo utafiti hutumia composite polynomial:
.
Digrii ya kila sub-polynomial inaonyeshwa kama:
.
Multiplicative depth ya composite polynomial
Wakati Baby Step Giant Step (BSGS) polynomial evaluation inatumika, chanzo kinaweka upper bound ya depth ya sub-polynomial ya \(i\) kwa:
.
Composite depth ya jumla hukadiriwa kama:
.
| Seti ya digrii | Depth consumption | Idadi ya multiplication |
|---|---|---|
| {3, 7} | 5 | 7 |
| {7, 7} | 6 | 10 |
| {7, 15} | 7 | 13 |
| {15, 15} | 8 | 16 |
| {7, 7, 13} | 10 | 17 |
| {7, 7, 27} | 11 | 20 |
| {7, 15, 27} | 12 | 23 |
| {15, 15, 27} | 13 | 26 |
Degree set ya juu kwa kawaida huzalisha polynomial yenye nguvu zaidi ya uelezaji ambayo inaweza kuongeza ReLU approximation fidelity, lakini inaweza kuhitaji multiplicative depth zaidi na hivyo bootstrapping ya mara nyingi zaidi au katika nafasi tofauti.
CipherAPR inaboresha tatizo gani?
Tuchukulie encrypted network yenye activation layer \(L\). Digrii za polynomial zinazotolewa kwa tabaka ni:
zinazoonyeshwa na degree vector. \(\mathbb{D}\) ni polynomial degree set inayoruhusiwa kutumika.
Seti ya bootstrapping placement zinazowezekana kwa degree configuration fulani \(\mathbf{d}\) hufafanuliwa kama:
. \(\Lambda\) huwakilisha cryptographic setting ya kudumu kama ring degree, modulus chain na security level.
Thamani ya latency ya configuration:
hufafanuliwa hivyo.
Hapa \(T(\mathbf{d},\pi;\Lambda)\) ni end-to-end encrypted inference latency chini ya polynomial degrees na bootstrapping placement maalum.
Tatizo kuu la uboreshaji ni:
.
Kwa hiyo CipherAPR haitafuti tu configuration ya haraka zaidi. Hutafuta layer-wise degree assignment yenye encrypted inference latency ya chini zaidi huku ikihifadhi minimum accepted accuracy constraint.
Mchakato wa hatua tatu wa usanifu wa nje ya mtandao wa CipherAPR
LMAR: Ni tabaka gani linahitaji zaidi ongezeko la digrii?
Tabia muhimu ya ReLU iko karibu na sifuri. Ingizo likienda upande hasi, toleo la ReLU huwa sifuri; upande chanya, ingizo hupitishwa. Polynomial approximation huwa katika hatari zaidi ya kuwakilisha vibaya uamuzi wa sign/gating hasa kwa thamani zilizo karibu na sifuri.
Kwa hiyo CipherAPR hufafanua Low-Magnitude Activation Ratio kwa layer \(\ell\):
Hapa \(x_{\ell,i}\) ni ingizo katika activation layer ya \(\ell\) la neuron ya \(i\); \(k_\ell\) ni jumla ya neuron katika layer hiyo; \(\epsilon\) ni threshold inayofafanua eneo la “karibu na sifuri”; na \(\mathbf{1}(\cdot)\) ni indicator function inayotoa 1 ikiwa sharti ni kweli na 0 ikiwa si kweli.
LMAR ni uwiano usio na kipimo katika masafa ya 0–1. LMAR kubwa inaonyesha kwamba sehemu kubwa zaidi ya activation input za tabaka iko karibu na sifuri. Chanzo hutumia hili kupanga tabaka zinazoweza kufaidika zaidi na polynomial degree ya juu chini ya level budget ileile.
LMAR Inapima Nini na Kwa Nini Ni Muhimu?
LMAR ni uwiano usio na kipimo unaopima ni kiasi gani cha viingizo vya tabaka la aktivishaji kiko katika eneo nyeti karibu na sifuri la ReLU; uwiano unapoongezeka, hatari ya polynomial ya digrii ndogo kuwakilisha vibaya tabia ya gating huwa muhimu zaidi, na CipherAPR huzipa tabaka hizo kipaumbele cha juu kwa ongezeko la digrii.
Threshold ya \(\epsilon\) inaamuliwaje?
Badala ya kuweka \(\epsilon\) kwa mkono, chanzo hutumia mbinu ya Otsu kwenye usambazaji wa activation magnitude wa tabaka zote.
Within-class variance:
Between-class variance:
.
\(w_1,w_2\) zinaonyesha uwezekano wa madarasa mawili ya activation-magnitude; \(\mu_1,\mu_2\) wastani wa madarasa; na \(\sigma_1^2,\sigma_2^2\) variance ndani ya darasa.
Chanzo huchagua \(\epsilon\) bora kama threshold inayoongeza:
uwiano huo.
Je, LMAR ni heuristic ya majaribio pekee?
Appendix A pia hutoa hoja ya kinadharia ya mpaka kwa upangaji wa LMAR. Acha layer pre-activation ya \(\ell\) iwe \(X_\ell\), na polynomial approximation iwe \(p_d(x)\). Ikiwa polynomial huhifadhi sign sahihi katika eneo \(|x|\ge\epsilon\), uwezekano wa gating sign inconsistency:
huwekewa upper bound.
Mlinganyo huu hausemi kwamba LMAR ni uwezekano halisi wa sign inconsistency kutokea. LMAR ni upper bound ya hatari chini ya shape constraint iliyotajwa.
Chanzo pia hutoa mpaka kwa athari ya approximation error kwenye expected loss:
.
Hapa \(L_\ell\) ni Lipschitz constant ya sub-network inayofuata; \(L_{\mathrm{loss}}\) ni Lipschitz constant ya loss function; na \(c_{\epsilon,d}\) inawakilisha maximum polynomial deviation ndani ya approximation region iliyo karibu na sifuri. Tafsiri ya chanzo ni kwamba, mambo mengine yakiwa sawa, LMAR kubwa inaweza kuongeza mchango wa approximation error kwenye expected loss.
Degree update inachaguliwaje?
Activation layer hupangwa kutoka kubwa hadi ndogo kwa thamani za LMAR. Ikiwa rank ya layer \(\ell\) ni \(r_\ell\), na jumla ya layer ni \(M\), normalized rank score:
huhesabiwa.
Tabaka zenye LMAR kubwa hukaribia 1; zenye LMAR ndogo hukaribia 0.
Kwa IncreaseDegree na DecreaseDegree, chanzo hutumia centered hinge functions:
Hapa \(\tau_c=0.5\), na \(m\in[0,0.5)\) ni update selectivity margin.
Action probabilities:
huhesabiwa.
ID ni ongezeko la degree, DD ni upunguzaji wa degree, na KD ni kuhifadhi degree. Kwa layer iliyobadilishwa katika iteration iliyotangulia, dynamic coefficients:
hupunguzwa. Chanzo hutumia utaratibu huu wa cooling kupunguza kubadilishwa kwa layer ileile mbele na nyuma mfululizo katika iteration zinazofuatana.
DAAP — kwa nini approximation domain hubadilika kulingana na layer?
Activation distribution ya kila layer si sawa. Kutumia approximation domain ileile pana kwa layer zote kunaweza kuunda tatizo la polynomial fitting lililo gumu kuliko inavyohitajika katika baadhi ya layer.
DAAP huchukua empirical activation bounds za layer \(\ell\) kama:
na huhesabu symmetric core radius kama:
.
\(B>1\) ni global scaling factor inayotumika kwa activation-domain normalization. Chanzo kinasisitiza kuwa hii si ukubwa sawa na CKKS encryption scale. \(a>0\) ni minimum core-domain radius.
Core domain:
na extended domain ni:
hufafanuliwa hivyo.
\(\rho_{\mathrm{ext}}>1\) huunda ukingo wa usalama kwa activation tail zinazoweza kutokea nje ya normal core domain.
Kwa Nini DAAP na MOCT Hutumiwa Pamoja?
DAAP hubadilisha eneo la ukadiriaji wa polinomu kulingana na usambazaji halisi wa activation wa layer, huku MOCT ikirekebisha coefficients za polinomu hiyo kwa kuzingatia kwa pamoja core error, tabia ya extended-domain, curvature na ukubwa wa coefficient; lengo ni kupata approximation error ndogo na tabia thabiti zaidi ya namba kwa ciphertext arithmetic chini ya polynomial degree ileile.
MOCT loss function
Final ReLU approximation:
hufafanuliwa hivyo.
MOCT hutumia sehemu nne za loss.
Core Error (CE):
ni maximum approximation error ndani ya core domain.
Extended Domain Constraint (EDC):
huadhibu polynomial output inapopita nje ya kiwango salama kinachotarajiwa ndani ya extended domain.
Curvature Penalty (CP):
hutumiwa katika chanzo kama curvature regularization ili kukandamiza polynomial oscillation na tabia inayofanana na Runge.
Coefficient Regularization (CR):
hupunguza ukubwa wa polynomial coefficient.
Jumla ya loss:
hufafanuliwa hivyo.
Katika majaribio ya makala:
zilitumiwa.
MOCT hufanya trainable coefficients za odd-degree za sub-polynomial ya kwanza \(p_1(x)\) pekee; coefficients nyingine hubaki fixed. Chanzo kilitumia 10.000 MOCT epoch.
CAPR ni nini?
Cosine-scheduled Activation Progressive Replacement (CAPR) ni mbinu ya screening ya nje ya mtandao inayokadiria kwa bajeti ndogo accuracy ya mwisho ya candidate mixed-degree network kabla ya kufanya full 300-epoch training.
Tuchukulie total training budget ni \(T\), idadi ya stage ni \(Q\), na minimum stage epoch ni \(M_{\min}\). Epoch allocation ya kila stage:
hutolewa kwa namna hii.
Kwa chaguo-msingi, chanzo hutumia:
.
Idadi ya activation zinazopangwa kubadilishwa katika stage \(q\):
na idadi ya jumla ya activation zilizobadilishwa:
huamuliwa hivyo.
CAPR si final accuracy. Makala hutumia CAPR kama low-budget staged accuracy estimate kwa candidate screening pekee; configurations zilizochaguliwa baadaye hufanyiwa full training.
Latency proxy na dynamic programming
CipherAPR haijaribu kila candidate kwa encrypted inference halisi; vinginevyo search ingekuwa ghali kupita kiasi. Badala yake, huunda feasible bootstrapping positions karibu na layer fulani na kutafuta minimum proxy latency kwa dynamic programming.
DP state hufuatilia layer iliyofikiwa na ciphertext level iliyobaki. Bootstrapping ikiongezwa, level huwekwa upya kuwa \(L_{\mathrm{eff}}\) na bootstrapping cost huongezwa.
Linear operator costs huchukuliwa kutoka lookup table iliyoandaliwa kulingana na input ciphertext level. Polynomial layer cost hutumia monotonic cost model inayohusiana na degree.
Candidate score
Kwa candidate \(\mathbf{d}'\), score ni:
hufafanuliwa hivyo.
Kadiri \(\lambda\) inavyoongezeka, uzito wa preference ya accuracy huongezeka; inapopungua, uzito wa preference ya latency huongezeka. Utafiti huhifadhi candidate pool tofauti za accuracy-oriented na latency-oriented.
CLU — ciphertext-level utilization
Tuchukulie bootstrapping placements zinagawa network katika segment \(S\). Ikiwa layer set katika segment \(s\) ni \(\mathcal{L}_s\), na level consumption ya kila layer ni \(c_\ell\), basi:
ni segment depth consumption.
Segment-level utilization:
huhesabiwa hivyo.
Mabadiliko kati ya segment jirani:
na adjacent variation:
hufafanuliwa hivyo.
\(RMS_{\mathrm{adj}}\) ya chini huwakilisha matumizi ya level yaliyo sawia zaidi kati ya bootstrapping segments. CLU si objective inayotumiwa badala ya final latency au accuracy; hutumiwa kama conservative structural filter kati ya candidates waliopita score preselection.
Vigezo vya offline search
- Pool width \(W=15\).
- Maximum search iteration \(T_{\max}=30\).
- CLU retention ratio \(\eta_{\mathrm{CLU}}=0.95\).
- Initial accuracy-oriented preference weight: \(\lambda_{\mathrm{acc}}^{(0)}=1.0\).
- Initial latency-oriented preference weight: \(\lambda_{\mathrm{lat}}^{(0)}=0.1\).
- Katika iteration moja, baada ya duplicate removal, candidates wasiozidi \(2W=30\) hupelekwa kwenye CAPR evaluation.
Mbinu na Matokeo ya Utafiti
Mazingira ya majaribio
| Hatua | Mazingira yaliyoripotiwa katika chanzo |
|---|---|
| Offline training / degree allocation / polynomial instantiation | Python 3.8, PyTorch 1.13.1 |
| Offline GPU | NVIDIA RTX A6000 |
| Mfumo endeshi wa offline | Ubuntu 20.04 |
| Encrypted inference implementation | C++, miundombinu ya AutoFHE, Microsoft SEAL |
| Encrypted inference CPU | Intel Xeon Platinum 8462Y+ |
| Uwezo wa CPU | 128 vCPU |
| Kumbukumbu ya seva | 1 TiB |
| Mfumo endeshi wa encrypted inference | Ubuntu 20.04 |
Chanzo kinatenganisha wazi muda wa offline design na online encrypted inference latency. Ulinganisho wa online performance katika makala haujumuishi gharama ya training/search ndani ya inference latency.
Dataseti
| Dataseti | Picha za training | Picha za test | Ukubwa wa picha | Subset ya offline fast search |
|---|---|---|---|---|
| CIFAR-10 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
| CIFAR-100 | 50.000 | 10.000 | 32×32 pixel | 5000 training image |
Ili kupunguza muda wa offline search, subset ya 5000-image fast-training ilitumika. Tathmini ya mwisho ya ciphertext inference ilifanywa kwenye 10.000-image test set. Metriki ni top-1 accuracy.
Vigezo vya RNS-CKKS
| Kigezo | Thamani |
|---|---|
| Ring degree \(N\) | \(2^{16}\) |
| Numerical scaling factor \(B\) | 80 |
| Total modulus-chain length | 1552 bit |
| Private-key Hamming weight | 192 |
| Security level | 128-bit |
Muundo wa modulus-chain umeripotiwa katika chanzo kama:
bit.
Vigezo vya training
Original networks:
- Optimizer: SGD.
- Epoch: 200.
- Batch size: 128.
- Initial learning rate: 0,1.
- Learning-rate schedule: cosine decay.
- Momentum: 0,9.
- Weight decay: 0,0005.
- Gradient clipping: 1,0.
Kwa polynomial networks, 300 epoch na initial learning rate 0,08 zilitumika; angalau 8 epoch zilitumika kwa kila stage.
Final CipherAPR training:
- Batch size: 128.
- Learning rate: 0,01.
- Momentum: 0,9.
- Weight decay: \(5\times10^{-4}\).
- Gradient clipping: 0,1.
- KL-divergence weight: \(\tau=0.9\).
Kwa CAPR candidate evaluation, zilitumika 20 total epoch pekee na minimum 2 epoch kwa kila stage.
Vigezo vya DAAP/MOCT
- Approximation-domain minimum: \(a=0.2\).
- Extension factor: \(\rho_{\mathrm{ext}}=1.5\).
- CIFAR-10 domain estimation: 30 image.
- CIFAR-100 domain estimation: 100 image.
- Uniform perturbation: \(\epsilon=0.1\).
- MOCT training: 10.000 epoch.
Matokeo makuu ya encrypted inference
| Dataseti / Network | Mbinu / configuration | #Boot | Cipher Acc. | Latency | Amortized latency |
|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | %92,59 | 6299 s | 49,21 s |
| CIFAR-10 / ResNet20 | AutoFHE low-BT | 5 | %91,92 | 2751 s | 21,49 s |
| CIFAR-10 / ResNet20 | CipherAPR low-BT | 4 | %92,15 | 2291 s | 17,90 s |
| CIFAR-10 / ResNet20 | AutoFHE high-BT | 11 | %92,89 | 4659 s | 36,40 s |
| CIFAR-10 / ResNet20 | CipherAPR high-BT | 7 | %92,61 | 3341 s | 26,10 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | %93,39 | 10.231 s | 79,93 s |
| CIFAR-10 / ResNet32 | AutoFHE low-BT | 8 | %93,46 | 4664 s | 36,44 s |
| CIFAR-10 / ResNet32 | CipherAPR low-BT | 7 | %93,14 | 4129 s | 32,26 s |
| CIFAR-10 / ResNet32 | AutoFHE high-BT | 19 | %93,56 | 7294 s | 56,98 s |
| CIFAR-10 / ResNet32 | CipherAPR high-BT | 13 | %93,76 | 6064 s | 47,38 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | %93,57 | 15.163 s | 118,46 s |
| CIFAR-10 / ResNet44 | AutoFHE low-BT | 8 | %92,55 | 5137 s | 40,13 s |
| CIFAR-10 / ResNet44 | CipherAPR low-BT | 8 | %93,04 | 4728 s | 36,94 s |
| CIFAR-10 / ResNet44 | AutoFHE high-BT | 22 | %93,65 | 8639 s | 67,49 s |
| CIFAR-10 / ResNet44 | CipherAPR high-BT | 16 | %93,71 | 7250 s | 56,64 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | %90,41 | 3157 s | 24,66 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | %90,68 | 1931 s | 15,09 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | %90,67 | 1835 s | 14,34 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | %70,59 | 10.357 s | 80,91 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | %71,34 | 7187 s | 56,15 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | %71,48 | 5953 s | 46,51 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | %63,95 | 3200 s | 25,00 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | %64,31 | 2832 s | 22,12 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | %64,26 | 2348 s | 18,34 s |
Chanzo kinaripoti speedup ya jumla ya CipherAPR dhidi ya AutoFHE katika paired settings hizi kuwa katika kiwango cha 1,09×–1,39×.
Speedup ya CipherAPR ya 1,09×–1,39× Inamaanisha Nini?
Speedup hii inaonyesha kupungua kwa end-to-end encrypted-inference latency iliyopimwa dhidi ya AutoFHE katika configurations zilizochaguliwa za ResNet/VGG chini ya fixed RNS-CKKS cryptographic setting ileile na malengo yanayolinganishwa ya encrypted accuracy; matokeo si dhamana ya speedup ya jumla kwa network zote, vigezo vyote vya FHE au hardware zote.
Runtime breakdown: kwa nini baadhi ya linear operations huwa ghali zaidi?
| Dataseti / Network | Mbinu / configuration | #Boot | Total effective levels | Boot | Linear | Polynomial |
|---|---|---|---|---|---|---|
| CIFAR-10 / ResNet20 | MPCNN | 18 | 306 | 4813 s | 786 s | 700 s |
| CIFAR-10 / ResNet20 | AutoFHE low-BT | 5 | 85 | 1370 s | 1304 s | 77 s |
| CIFAR-10 / ResNet20 | CipherAPR low-BT | 4 | 73 | 1095 s | 1162 s | 34 s |
| CIFAR-10 / ResNet20 | AutoFHE high-BT | 11 | 150 | 2995 s | 1411 s | 253 s |
| CIFAR-10 / ResNet20 | CipherAPR high-BT | 7 | 104 | 1907 s | 1335 s | 99 s |
| CIFAR-10 / ResNet32 | MPCNN | 30 | 498 | 7813 s | 1336 s | 1082 s |
| CIFAR-10 / ResNet32 | AutoFHE low-BT | 8 | 96 | 2234 s | 2404 s | 26 s |
| CIFAR-10 / ResNet32 | CipherAPR low-BT | 7 | 118 | 1955 s | 2129 s | 45 s |
| CIFAR-10 / ResNet32 | AutoFHE high-BT | 19 | 235 | 5040 s | 1838 s | 416 s |
| CIFAR-10 / ResNet32 | CipherAPR high-BT | 13 | 195 | 3449 s | 2208 s | 407 s |
| CIFAR-10 / ResNet44 | MPCNN | 42 | 690 | 11.638 s | 1893 s | 1632 s |
| CIFAR-10 / ResNet44 | AutoFHE low-BT | 8 | 120 | 2171 s | 2940 s | 26 s |
| CIFAR-10 / ResNet44 | CipherAPR low-BT | 8 | 131 | 2149 s | 2550 s | 29 s |
| CIFAR-10 / ResNet44 | AutoFHE high-BT | 22 | 277 | 5715 s | 2492 s | 432 s |
| CIFAR-10 / ResNet44 | CipherAPR high-BT | 16 | 234 | 4157 s | 2662 s | 431 s |
| CIFAR-10 / VGG11 | MPCNN | 9 | 160 | 2326 s | 483 s | 348 s |
| CIFAR-10 / VGG11 | AutoFHE | 4 | 72 | 1125 s | 692 s | 114 s |
| CIFAR-10 / VGG11 | CipherAPR | 4 | 68 | 1131 s | 629 s | 75 s |
| CIFAR-100 / ResNet32 | MPCNN | 30 | 498 | 7809 s | 1466 s | 1082 s |
| CIFAR-100 / ResNet32 | AutoFHE | 16 | 230 | 4377 s | 2408 s | 402 s |
| CIFAR-100 / ResNet32 | CipherAPR | 12 | 176 | 3183 s | 2357 s | 413 s |
| CIFAR-100 / VGG11 | MPCNN | 9 | 160 | 2332 s | 511 s | 357 s |
| CIFAR-100 / VGG11 | AutoFHE | 7 | 104 | 1885 s | 719 s | 228 s |
| CIFAR-100 / VGG11 | CipherAPR | 6 | 86 | 1616 s | 611 s | 121 s |
Mfano wa CIFAR-10/ResNet32 high-BT unaonyesha mwingiliano huu wazi. AutoFHE ikiwa na 19 bootstrapping huzalisha 5040 s za bootstrapping na 1838 s za linear cost, huku CipherAPR ikiwa na 13 bootstrapping ikipunguza muda wa bootstrapping hadi 3449 s. Kwa upande mwingine linear cost huongezeka hadi 2208 s. Kwa kuwa faida ya bootstrapping ni kubwa zaidi, total latency bado hupungua kutoka 7294 s hadi 6064 s.
Mfano wa matumizi ya restored-level
Kwa configuration ya CIFAR-10/ResNet32 high-BT, chanzo kinasema kila bootstrapping hurejesha hadi 16 level na input ciphertext huanza katika level 18.
Jumla ya level zinazopatikana:
huhesabiwa hivyo.
Kwa AutoFHE:
level zinapatikana, na katika Table 6 total effective usage ni 235. Kwa msingi huo, chanzo kinahesabu kuwa 87 level zilibaki bila kutumika.
Kwa CipherAPR:
level zinapatikana; effective usage ni 195 na unused budget ni 31 level.
Kwa mujibu wa chanzo, katika paired AutoFHE/CipherAPR settings tisa za Table 6, CipherAPR ilionyesha unused level budget ndogo katika saba.
Matokeo ya majaribio ya LMAR
Tathmini ya LMAR ilifanywa kwenye CIFAR-10/ResNet32. Activation sites zilipobadilishwa hatua kwa hatua na polynomial, mpangilio wa LMAR ulilinganishwa na mipangilio ya Forward na Reverse-LMAR.
Matokeo makuu ya Figure 5 katika chanzo ni kwamba LMAR-based ordering hurejesha accuracy kwa haraka zaidi hasa katika hatua za mwanzo ambapo activation chache zimebadilishwa. Kwa utaratibu uleule wa fine-tuning, baadhi ya partially replaced models zilifikia %94,05 inference accuracy na kuzidi kidogo baseline ya original ReLU network. Thamani hii si matokeo yanayochukua nafasi ya jedwali kuu la encrypted-inference la CipherAPR; ni supporting experiment tofauti ya kutathmini LMAR kama degree-prioritization signal.
Matokeo ya DAAP + MOCT approximation error
| Depth | Minimax MaxE | DAAP w/o MOCT MaxE | DAAP + MOCT MaxE | Uboreshaji wa MOCT dhidi ya Minimax |
|---|---|---|---|---|
| 4 | 6,65×10⁻² | 1,42×10⁻² | 9,72×10⁻³ | %85,39 |
| 5 | 3,44×10⁻² | 7,18×10⁻³ | 6,76×10⁻³ | %80,36 |
| 6 | 1,51×10⁻² | 9,37×10⁻³ | 3,62×10⁻³ | %76,03 |
| 7 | 7,58×10⁻³ | 2,62×10⁻³ | 2,41×10⁻³ | %68,22 |
| 8 | 3,82×10⁻³ | 1,85×10⁻³ | 1,71×10⁻³ | %55,33 |
| 9 | 1,87×10⁻³ | 1,25×10⁻³ | 1,13×10⁻³ | %39,44 |
| 10 | 1,73×10⁻³ | 5,74×10⁻⁴ | 5,72×10⁻⁴ | %66,91 |
| 11 | 9,03×10⁻⁴ | 3,88×10⁻⁴ | 3,82×10⁻⁴ | %57,66 |
| 12 | 4,72×10⁻⁴ | 1,88×10⁻⁴ | 1,82×10⁻⁴ | %61,51 |
Chanzo kinaripoti kwamba DAAP + MOCT imepunguza MaxE dhidi ya Minimax kwa %39,44–%85,39 kutegemea depth.
DAAP domain trade-off
| Depth | Mpangilio | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|---|
| 6 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 2,85×10⁻³ | 2,19×10⁻³ | 3,89×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 2,91×10⁻² | 4,18×10⁻² | 2,54×101 |
| 12 | \(v=0.12,\rho_{\mathrm{ext}}=1.50\) | 1,49×10⁻⁴ | 2,55×10⁻⁷ | 2,77×10⁶ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.30,\rho_{\mathrm{ext}}=1.50\) | 4,28×10⁻⁴ | 6,72×10⁻⁴ | 4,66×10³ |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 3,87×10⁻³ | 4,21×10⁻³ | 2,46×10² |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| 6 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 1,81×10⁻² | 5,37×10⁻² | 1,86×101 |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.05\) | 1,61×10⁻⁴ | 1,63×10⁻⁶ | 8,83×10⁵ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=1.50\) | 1,88×10⁻⁴ | 4,00×10⁻⁵ | 7,84×10⁴ |
| 12 | \(v=0.20,\rho_{\mathrm{ext}}=2.50\) | 4,27×10⁻⁴ | 1,08×10⁻³ | 4,53×10³ |
Matokeo yanaonyesha approximation-stability trade-off muhimu. Kwa mfano, katika depth 6, kuongeza \(v\) kutoka 0,12 hadi 0,30 hupunguza maximum coefficient magnitude kutoka \(3,89\times10^2\) hadi \(2,54\times10^1\), huku kukiongeza Core MaxE kutoka \(2,85\times10^{-3}\) hadi \(2,91\times10^{-2}\). Chanzo hutumia \(v=0.20,\rho_{\mathrm{ext}}=1.50\) kama default iliyosawazishwa.
MOCT weight ablation
| Hali | Core MaxE | Outer MaxE | Max |ai| |
|---|---|---|---|
| DAAP baseline | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| MOCT default | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_1=0\) | 9,57×10⁻³ | 1,36×10⁻² | 8,47×101 |
| \(w_2=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
| \(w_3=0\) | 3,40×10⁻³ | 7,12×10⁻² | 1,04×10² |
| \(w_4=0\) | 6,60×10⁻³ | 1,84×10⁻² | 8,45×101 |
Matokeo ya \(w_1=0\) kurudi kwenye DAAP baseline yanaonyesha kuwa Core Error term ndiyo inayoendesha core-domain update. Ingawa \(w_3=0\) hupunguza Core MaxE, huongeza Outer MaxE hadi \(7,12\times10^{-2}\) na maximum coefficient hadi \(1,04\times10^2\). Chanzo kinatafsiri hili kuwa curvature penalty huchangia outer-domain numerical behavior kwa kuzuia overfitting kwa core region pekee.
Tathmini ya latency proxy, CAPR na CLU
Chanzo kinaripoti katika Figure 6a kwamba latency proxy huhifadhi real encrypted latency ordering ndani ya bootstrapping settings tofauti. Kazi ya proxy si kufanya global calibration ya latency kwa sekunde; ni kupanga candidates ndani ya setting ileile.
Figure 6b inaonyesha kuwa CAPR inaweza kutenganisha kwa haraka trainable configurations kutoka failure regime ndani ya training budget ndogo. Chanzo hutumia CAPR kama screening estimate badala ya final accuracy.
| Mpangilio wa pool | Best-so-far baada ya tathmini 210 za CAPR | Normalized final best | CAPR eval kufikia CLU-run best | Akiba inayotegemea path |
|---|---|---|---|---|
| Accuracy-oriented | %99,9 / %97,6 | %99,9 / %100,0 | 210 / 330 | %36,4 chini |
| Latency-oriented | %100,0 / %95,5 | %100,0 / %100,0 | 180 / 330 | %45,5 chini |
Thamani jozi katika jedwali ni katika muundo wa `CLU / without CLU`. Chanzo kinasisitiza kuwa final best scores hubaki karibu sawa. Kwa hiyo athari kuu ya CLU si “kuboresha sana final optimum”, bali kufanya early search trajectory kuelekea best configuration ya kiwango kileile kuwa na ufanisi zaidi.
Gharama ya offline search
Kila candidate hufanyiwa fine-tune kwenye 5000-image fast-training subset kwa 20 CAPR epoch na batch size 128. Hii ni sawa na 800 mini-batch update kwa kila candidate.
Chanzo hukadiria serial offline search cost kama:
.
\(N_{\mathrm{eval}}\) ni idadi ya candidate configurations zinazotathminiwa kwa CAPR; \(T_{\mathrm{CAPR}}^{20}\) ni muda wa 20-epoch CAPR kwa kila candidate.
Katika pilot measurements, muda wa CAPR kwa candidate ni takriban dakika 10–25 kwa ResNet settings na dakika 20–30 kwa VGG. Kwa CLU-guided run yenye tathmini 180–210, chanzo kinakadiria takriban siku 1–3 za serial kwa ResNet models na takriban siku 2–4 za serial kwa VGG models.
Kikomo muhimu: Hizi si full-search wall-clock times zilizopimwa end-to-end, bali serial cost estimates. Kwa kuwa candidate evaluations ni huru, utekelezaji sambamba unaweza kupunguza real wall-clock time ikiwa kuna workers wa kutosha.
Appendix B: je, mixed degree kweli hubadilika kati ya layer?
Ndiyo. Depth profiles katika Appendix B zinaonyesha kuwa CipherAPR haitumii polynomial degree moja kwa activation layer zote. Activation yenye depth 0 ni prune/identity; depth 2 ni shallow polynomial; thamani zaidi ya 2 humaanisha composite approximations za kina zaidi.
Katika mfano wa chanzo wa CIFAR-10/ResNet32, kwa depth>2 katika 7-bootstrapping setting idadi ya activation ni 2, huku katika 13-bootstrapping setting ikiongezeka hadi 12. Hata hivyo baadhi ya activation hupunguzwa au kubaki katika depth 2. Hii inaonyesha kuwa mixed-degree approach ni layer-selective kweli.
Matokeo yanayoungwa mkono na utafiti
- CipherAPR hujumuisha taarifa ya restored-level utilization katika polynomial degree design chini ya fixed RNS-CKKS backend.
- Katika ResNet na VGG configurations zilizotathminiwa, encrypted-inference speedup ya 1,09×–1,39× dhidi ya AutoFHE imeripotiwa.
- Faida kubwa zaidi iliyoripotiwa katika CIFAR-10/ResNet20 high bootstrapping setting ni kupungua kutoka 4659 s hadi 3341 s.
- CipherAPR imepunguza idadi ya bootstrapping katika paired settings nyingi.
- Katika paired AutoFHE/CipherAPR settings tisa, unused restored-level budget ndogo ilionekana katika saba.
- LMAR imeungwa mkono kama forward-only heuristic yenye manufaa kwa kuzipa activation layer kipaumbele chini ya replacement budget iliyozuiliwa.
- DAAP + MOCT imepunguza MaxE kwa %39,44–%85,39 dhidi ya Minimax chini ya approximation depth ileile.
- CLU imewezesha kufikia kiwango kilekile cha CLU-run best kwa CAPR evaluations chache katika early search trajectory bila kubadilisha sana final best score.
Matokeo ambayo utafiti hauungi mkono
- CipherAPR si FHE encryption scheme mpya au salama zaidi.
- CipherAPR haibadilishi RNS-CKKS encryption/decryption au bootstrapping primitive.
- Speedup ya 1,09×–1,39× si dhamana kwa network zote, hardware zote na cryptographic parameter sets zote.
- Haiwezi kuhitimishwa kuwa idadi ya bootstrapping peke yake huamua encrypted-inference performance.
- CAPR accuracy estimate si final fully-trained encrypted-network accuracy.
- Latency proxy si absolute seconds predictor ya real latency kati ya settings zote; hutumiwa kama within-setting ranking signal.
- Haiwezi kusemwa kuwa CLU inaboresha final optimum score kwa kiasi kikubwa; faida yake kuu iko katika search trajectory.
- Thamani za siku 1–4 zilizotolewa kwa offline search si measured end-to-end wall-clock times, bali serial estimates.
- Utafiti hauchukui nafasi ya compiler-side scheduling.
- Matokeo ya ResNet/VGG na CIFAR-10/CIFAR-100 hayawezi kuhamishwa moja kwa moja kwa Transformer architectures.
Vikwazo vya msingi na kazi ya baadaye
Utafiti unalenga offline structural design chini ya fixed encrypted backend. Mixed-degree polynomial network inayoundwa na CipherAPR haichukui nafasi ya compiler-side bootstrapping scheduling. Waandishi wanaona joint optimization ya structural design na compiler scheduling kuwa hatua ya kawaida inayofuata.
Katika CNN za kina zaidi, degree-assignment search space na CAPR evaluation cost huongezeka pamoja na idadi ya activation layer. Chanzo kinasema kuwa accuracy proxies zenye ufanisi zaidi au hybrid importance metrics zinaweza kuhitajika katika network za kina zaidi kama ResNet-110.
Kupanua kwa Transformer architectures pia ni tatizo tofauti la utafiti. Softmax, layer normalization na attention blocks zina sifa za polynomial approximation na ciphertext-level consumption tofauti na CNN ReLU. Kwa hiyo matokeo ya sasa ya ResNet/VGG hayawezi kuhamishwa moja kwa moja kwa Transformer.
Wigo wa usalama
Security discussion ya CipherAPR imewekewa mipaka ya standard FHE inference confidentiality. Katika hatua ya offline, LMAR, DAAP, MOCT, CAPR na CLU hazioni user inference ciphertexts. Katika hatua ya online, server:
hutekeleza hesabu hiyo kwenye standard RNS-CKKS.
\(\tilde{f}\) ni fixed public polynomial network iliyotengenezwa offline na CipherAPR; \(pk\) ni public evaluation key; \(ct_{\mathrm{in}}\) ni input ya mtumiaji iliyosimbwa; \(ct_{\mathrm{out}}\) ni matokeo ya inference yaliyosimbwa.
Chanzo kinasisitiza kuwa CipherAPR haiongezi cryptographic primitive mpya kwenye standard encryption, decryption, key-switching au bootstrapping mechanism. Kwa hiyo confidentiality claim imewekewa mipaka na RNS-CKKS security parameterization iliyopo na RLWE hardness assumptions.
Maelezo ya Chanzo na Mbinu
Kichwa asili: CipherAPR: Accelerating RNS-CKKS Encrypted Inference via Importance-Guided and Level-Aware Mixed-Degree Polynomial Design
Waandishi: Junping Wan; Yucen Liao; Yinglong Liao; Zejiu Tan; Jinming Xu; Zoe L. Jiang; Binxing Fang.
Mpangilio wa waandishi: Junping Wan ni wa kwanza; Yucen Liao wa pili; Yinglong Liao wa tatu; Zejiu Tan wa nne; Jinming Xu wa tano; Zoe L. Jiang wa sita; Binxing Fang wa saba.
Waandishi wa mawasiliano: Zoe L. Jiang na Binxing Fang.
Taasisi 1: School of Computer Science and Technology, Harbin Institute of Technology, Shenzhen 518055, China.
Taasisi 2: Department of Optoelectronic Engineering, Jinan University, Guangzhou 510632, China.
Taasisi 3: College of Control Science and Engineering, Zhejiang University, Hangzhou 310027, China.
Taasisi 4: School of Cyberspace Security, Guangzhou University, Guangzhou 510006, China.
Mchango sawa: Chanzo hakina tamko la uandishi wa kwanza wa pamoja au mchango sawa.
Jarida: Cryptography.
Mchapishaji: MDPI.
Juzuu / toleo / makala: 10(4), Article 44.
Idadi ya kurasa: 28.
DOI: 10.3390/cryptography10040044.
Iliwasilishwa: 11 Mei 2026.
Marekebisho: 19 Juni 2026.
Ilikubaliwa: 19 Juni 2026.
Ilichapishwa: 2 Julai 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na rika; inaunganisha offline algorithmic design/search, polynomial approximation, cryptographic execution benchmark na ablation/sensitivity analyses kwa encrypted neural-network inference chini ya FHE.
Mapitio ya rika: Cryptography ni jarida la MDPI lililopitiwa na rika; maelezo ya sasa ya mchakato wa MDPI yanasema single-anonymized peer review hutumika.
Hali ya preprint: Faili iliyoshughulikiwa na Verianla ni Version of Record iliyochapishwa; hakuna preprint tofauti iliyotumiwa kama msingi katika utafiti huu.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Maneno muhimu: encrypted inference; bootstrapping; ciphertext-level utilization; fully homomorphic encryption; RNS-CKKS.
Familia kuu ya modeli: Kwenye CIFAR-10 na CIFAR-100: ResNet20, ResNet32, ResNet44 na VGG11.
Ulinganisho mkuu: MPCNN na AutoFHE. DaCapo, Orion na ReSBM zimejadiliwa kama compiler-side execution optimizers, lakini hazikujumuishwa moja kwa moja kama baseline katika structural-design benchmark.
Miundombinu ya FHE: RNS-CKKS; Microsoft SEAL; miundombinu ya implementation ya AutoFHE.
Security setting: Ring degree \(2^{16}\); modulus-chain length 1552 bit; private-key Hamming weight 192; 128-bit security.
Hardware ya offline training: NVIDIA RTX A6000, Ubuntu 20.04.
Hardware ya encrypted inference: Intel Xeon Platinum 8462Y+, 128 vCPU, 1 TiB RAM, Ubuntu 20.04.
Software ya offline: Python 3.8, PyTorch 1.13.1.
Online encrypted execution: C++ na Microsoft SEAL.
Vipengele vikuu vya mbinu: LMAR, probabilistic degree tuning, DAAP, MOCT, latency proxy, CAPR na CLU.
Matokeo makuu ya performance: Encrypted-inference speedup ya 1,09×–1,39× katika configurations zilizotathminiwa dhidi ya AutoFHE; ciphertext accuracy inayofanana.
Mfano wa speedup kubwa zaidi iliyoripotiwa: Katika CIFAR-10/ResNet20 high bootstrapping setting, AutoFHE 4659 s na 11 bootstrapping; CipherAPR 3341 s na 7 bootstrapping.
Matokeo ya approximation: Katika Table 7, DAAP + MOCT imepunguza MaxE dhidi ya Minimax kwa %39,44–%85,39 kutegemea depth.
Matokeo ya CLU: Katika accuracy-oriented na latency-oriented search, CLU ilipunguza CAPR evaluations zinazohitajika kufikia CLU-run best hadi 210/330 na 180/330 mtawalia, bila kubadilisha sana final normalized best score.
Ufadhili: National Key R&D Program of China (2023YFB3106500); National Natural Science Foundation of China (62272131); Shenzhen Social Science Fund (SZ2025B011); Shenzhen Science and Technology Major Project (KJZD20230923114908017).
Upatikanaji wa data: Imeelezwa kuwa data zilizowasilishwa katika utafiti zinaweza kupatikana kutoka kwa corresponding author kwa ombi la busara. Public datasets zilizotumiwa ni CIFAR-10 na CIFAR-100.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna mgongano wa maslahi. Chanzo pia kinasema kuwa funding sponsors hawakuwa na jukumu katika study design, data collection/analysis/interpretation, uandishi wa makala au uamuzi wa kuchapisha.
Michango ya waandishi: Conceptualization: Junping Wan, Jinming Xu, Zoe L. Jiang, Binxing Fang; methodology: Junping Wan, Yucen Liao, Yinglong Liao, Zejiu Tan; software: Junping Wan; validation: Junping Wan, Yucen Liao, Zejiu Tan; formal analysis: Junping Wan, Yinglong Liao, Zejiu Tan; investigation na data curation: Junping Wan; resources: Zoe L. Jiang na Binxing Fang; original draft: Junping Wan; review/editing: waandishi wote; visualization: Yucen Liao, Yinglong Liao na Zejiu Tan; supervision/project administration/funding acquisition: Zoe L. Jiang na Binxing Fang.
Bodi ya maadili / ridhaa iliyoarifiwa: Katika PDF ya chanzo hakuna tamko tofauti la Institutional Review Board au Informed Consent lililoripotiwa. Utafiti unafanywa kwenye CIFAR benchmarks na majaribio ya computational encrypted inference.
Vikwazo vikuu vya kimethodolojia: Utafiti unalenga offline structural design chini ya fixed RNS-CKKS backend; hauchukui nafasi ya compiler scheduling. Gharama ya offline search huongezeka pamoja na idadi ya activation-layer. CAPR na latency proxy ni screening tools na hazichukui nafasi ya final full evaluation. Thamani za search za siku 1–4 ni serial estimates. Tathmini imewekewa mipaka ya CIFAR-10/CIFAR-100 na ResNet/VGG architectures; Transformer architectures zinahitaji kuchunguzwa tofauti.
Kikomo cha tafsiri ya security: Dai la usalama la CipherAPR si la cryptographic primitive mpya. Mfumo hutumia standard RNS-CKKS encryption/decryption/key-switching/bootstrapping mechanism; confidentiality hurithiwa kutoka RNS-CKKS parameterization inayotumiwa na RLWE assumption.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *