

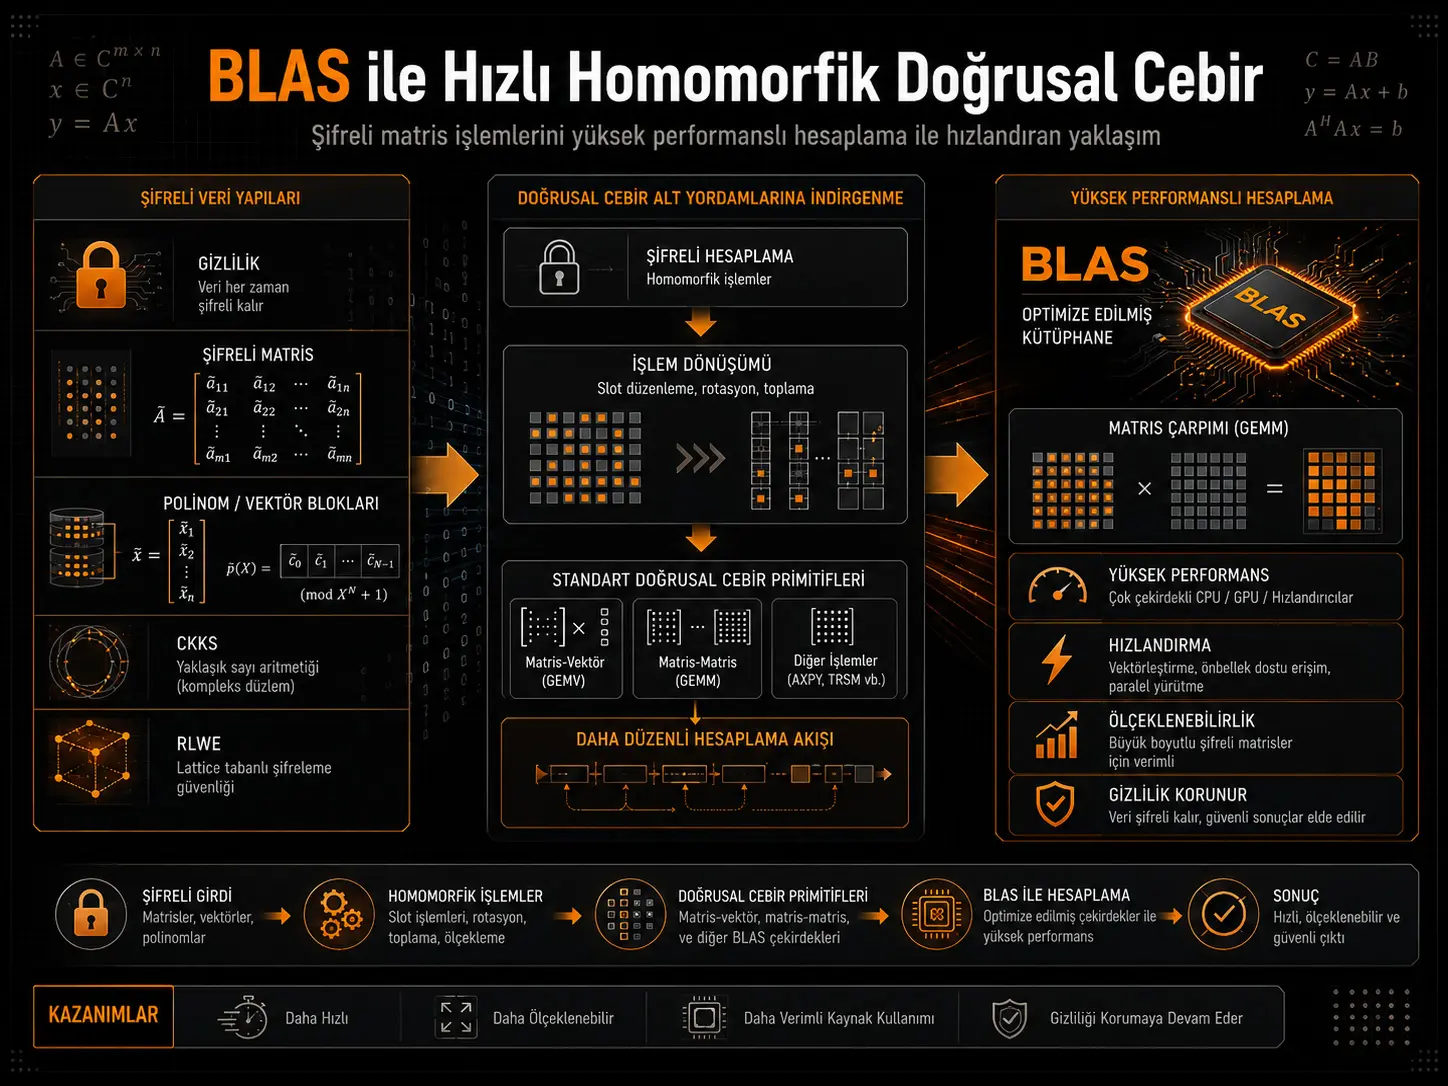
Utafiti unalenga kupunguza operesheni kubwa za matrix-vektor na matrix-matrix zinazofanywa chini ya usimbaji fiche wa homomofiki kuwa hesabu za aljebra ya mstari ya maandishi wazi zenye utendaji wa juu, badala ya kuziendesha moja kwa moja kama mlolongo mgumu wa operesheni kwenye data iliyosimbwa. Kiini cha kazi hii ni uhusiano kati ya mfumo wa usimbaji fiche kamili wa homomofiki wa CKKS, unaounga mkono arithmetiki ya takriban kwa namba halisi, na maktaba za BLAS (Basic Linear Algebra Subroutines) ambazo zimeboreshwa kwa miongo mingi. Watafiti walitumia miundo mbalimbali ya usimbaji ya RLWE, MLWE, shared-a na RGSW ili kutengeneza algoriti zinazobadilisha sehemu kubwa ya operesheni za plaintext–ciphertext, ciphertext–plaintext na ciphertext–ciphertext kuwa kuzidisha matrix kwa kawaida. Katika majaribio ya HEaaN na OpenBLAS, waandishi wanaripoti kuwa katika baadhi ya matukio ya matrix kubwa za mraba, gharama ya hesabu ya kuzidisha matrix iliyosimbwa kwa CKKS inaweza kupunguzwa hadi takriban mara 4–12 ikilinganishwa na kuzidisha matrix wazi kwa double-precision floating-point. Uwiano huu unahusu algoriti, ukubwa, muundo wa usimbaji na masharti ya precomputation; si uwiano wa jumla kwa hesabu zote za homomofiki.
Wazo kuu si kufungua data iliyosimbwa na kuipeleka kwa BLAS. Data hubaki ikiwa imesimbwa. Watafiti huiandika upya kimuundo na kialjebra matrix iliyosimbwa kwa RLWE, kisha hubadilisha sehemu kubwa ya kuzidisha matrix iliyosimbwa kuwa kuzidisha matrix kwa kawaida bila kufikia ujumbe halisi uliosimbwa. Hivyo, lengo ni kutumia miundo ya kumbukumbu na hesabu ya BLAS ambayo tayari imeboreshwa kwa CPU na GPU kwa muda mrefu.
Katika mfumo uliopendekezwa, kuzidisha plaintext–ciphertext kunaweza kupunguzwa katika baadhi ya hali kuwa kuzidisha matrix mbili za plaintext, na ikiwa precomputation inawezekana, katika hatua ya mtandaoni kunaweza kubaki kuzidisha matrix moja tu ya plaintext. Kuzidisha ciphertext–ciphertext kwa matrix kubwa za mraba kunapunguzwa kuwa kuzidisha matrix nne za modular plaintext pamoja na transposition za matrix iliyosimbwa. Mbinu ya jumla ya RGSW inasaidia ukubwa na miundo tofauti ya usimbaji, lakini ina gharama ya kudumu iliyo juu zaidi.
Majaribio yalifanywa kwa HEaaN, OpenBLAS 0.3.26 na processor ya Intel Xeon Gold 6342 2.80 GHz kwa thread moja; muda ulioripotiwa ni wastani wa majaribio 10. Vigezo vilichaguliwa ili kutoa takriban usalama wa biti 128 kulingana na lattice estimator. Kwa hiyo, matokeo yanaonyesha kuwa aljebra ya mstari ya homomofiki inaweza kuharakishwa kwa vitendo; hata hivyo hayapaswi kusomwa moja kwa moja kama utendaji wa CPU zenye cores nyingi, GPU, au inference ya mwisho-kwa-mwisho ya modeli kubwa ya lugha inayolinda faragha.
Tathmini kwa muktadha wa Afrika Mashariki/Turuki: Kazi hii ni muhimu kwa timu za utafiti na uhandisi zinazoshughulika na kriptografia, faragha ya data, kompyuta salama ya wingu na akili bandia inayolinda faragha. Kupunguza operesheni kubwa za matrix hadi kwenye ekosistemu iliyopo ya BLAS kunaonyesha kuwa inawezekana kutumia miundombinu ya sasa ya CPU/GPU kwa aljebra ya mstari kabla ya kuunda vifaa maalumu vya homomorphic computing. Hata hivyo, utafiti haujaribu kituo mahususi cha data, programu mahususi au mazingira mahususi ya sheria; kwa hiyo hauwezi kutoa moja kwa moja hitimisho la gharama au utendaji wa miundombinu ya kitaifa.
Kwa nini usimbaji fiche wa homomofiki ni muhimu?
Katika usimbaji fiche wa kawaida, ili kufanya hesabu juu ya data, mara nyingi lazima data ifunguliwe kwanza. Lengo la usimbaji fiche wa homomofiki ni kuruhusu server kufanya hesabu juu ya data iliyosimbwa bila kuona data hiyo katika hali ya wazi. Baada ya hesabu kukamilika, matokeo bado hurudi yakiwa yamesimbwa, na upande wenye ufunguo sahihi pekee ndio unaweza kuyafungua.
Sifa hii ni muhimu hasa pale mmiliki wa data hataki kumpa server data ghafi. Utafiti unataja mifano kama inference ya AI inayolinda faragha, private information retrieval, utafutaji wa vektor wa takriban, federated principal component analysis na tathmini ya faragha ya modeli kubwa za lugha.
Kwa nini kuzidisha matrix huwa kikwazo?
Mifumo mingi ya kisasa ya machine learning na scientific computing hutegemea kuzidisha matrix-vektor na matrix-matrix. Katika ulimwengu wa maandishi wazi, operesheni hizi hufanywa kwa ufanisi na maktaba za BLAS. Lakini katika usimbaji fiche wa homomofiki wa RLWE, ciphertext moja si namba moja tu; ni muundo wa polynomia unaobeba thamani nyingi pamoja.
Ili kupanga upya data iliyosimbwa ndani ya muundo huo, mara nyingi zinahitajika key-switching, automorphism ya homomofiki na operesheni zinazofanana. Waandishi wanaeleza kuwa katika mbinu nyingi za awali, idadi ya key-switching inaweza kutawala muda wa utekelezaji, na mifumo tata ya upatikanaji wa kumbukumbu hufanya uboreshaji kuwa mgumu.
Kwa hiyo swali kuu ni hili: Je, inawezekana kubadilisha sehemu kubwa ya hesabu ya kuzidisha matrix iliyosimbwa kuwa tatizo la kawaida la aljebra ya mstari ya plaintext bila kufungua usimbaji?
BLAS ni nini na kwa nini inatumika hapa?
BLAS ni kifupi cha Basic Linear Algebra Subroutines. Inafafanua interfaces za kawaida za programu kwa operesheni za msingi za aljebra ya mstari kama kuzidisha matrix-vektor na matrix-matrix. Kazi hii hutumia hasa routines za dgemm kwa kuzidisha matrix kwa ujumla na dgemv kwa kuzidisha matrix-vektor.
Thamani ya BLAS si kasi tu. Imeboreshwa kwa cache za CPU, vector instructions, parallelism na GPU kwa miaka mingi. Operesheni za homomofiki zinapobadilishwa kuwa miito ya BLAS, kazi hii inanufaika moja kwa moja na urithi huo wa optimization.
Kwa nini CKKS ilichaguliwa?
Utafiti unalenga CKKS. CKKS huunga mkono arithmetiki ya takriban ya namba halisi na kompleks, na hutoa uwezo wa kuchakata data kwa sambamba kwa mtindo unaofanana na SIMD. Hii inalingana vizuri na aljebra ya mstari ya namba na matumizi ya AI. Kwa kuwa CKKS ni ya takriban, matokeo hayapaswi kuchukuliwa kama exact integer arithmetic. Vyanzo vya makosa vinatoka kwenye encoding ya awali, kosa la kriptografia la RLWE, na makosa ya ziada kutoka rescaling na key-switching.
Ciphertext ya RLWE inaandikwaje?
Ciphertext ya msingi ya RLWE inaonyeshwa takriban kama:
\[ a\cdot sk+b\approx m\pmod q \]
Hapa \(a\) na \(b\) ni vipengele viwili vya polynomia vya ciphertext, \(sk\) ni ufunguo wa siri, \(m\) ni ujumbe uliosimbwa, na \(q\) ni modulus ya ciphertext. Alama ya takriban inaonyesha makosa ya encoding na operesheni za CKKS.
Hatua muhimu ni kuiandika upya hii kama uhusiano wa matrix:
\[ S^{*}A+B\approx \Delta M\pmod q \]
Hapa \(M\) ni matrix ya ujumbe, \(\Delta\) ni scale factor ya CKKS, \(S^{*}\) ni uwasilishaji wa matrix wa ufunguo wa siri, na \(A\), \(B\) ni matrix zinazotokana na vipengele vya ciphertext.
Kuzidisha plaintext–ciphertext kunarahisishwaje?
Ikiwa matrix \(M\) iliyosimbwa inaandikwa kama \[ S^{*}A+B\approx \Delta M \] na matrix ya wazi \(U\) inajulikana, pande zote mbili zinaweza kuzidishwa na \(U\) kutoka kulia:
\[ S^{*}(AU)+(BU)\approx \Delta(MU) \]
Kwa hivyo operesheni ya homomofiki \(M\cdot U\) hubadilika kwa kiasi kikubwa kuwa kuzidisha matrix mbili za kawaida: \(A\cdot U\) na \(B\cdot U\). Matrix hizi si ujumbe wa mtumiaji katika hali ya wazi; ni vipengele vya algebra vya ciphertext.
Muundo wa shared-a unatoa nini?
Ciphertext ya RLWE inapochukuliwa kama jozi \((a,b)\), muundo wa shared-a huruhusu ciphertext kadhaa kushiriki kipengele kimoja cha \(a\). Katika matrix kubwa, hili linaweza kupunguza ukubwa wa \(A\) na kupunguza kazi katika sehemu ghali ya kuzidisha matrix. Katika mfano wa \(2^{14}\times2^{14}\times2^{14}\) CP-MM, waandishi wanasema shared-s ingetegemewa kuchukua karibu sekunde 400, lakini structured-S shared-a ilichukua sekunde 176. Hata baada ya kuongeza karibu sekunde 60 za kubadilisha format, faida bado inaonekana.
Kwa nini MLWE hutumika kwa matrix ndogo?
Ukubwa wa matrix ukiwa mdogo kuliko degree ya ring ya RLWE \(N\), packing ya kawaida ya RLWE inaweza kuwa isiyo na ufanisi. Katika hali hiyo, Module Learning With Errors (MLWE) hutumiwa. Hivyo mfumo hauishii kwenye \(d=N\) pekee; unaweza kushughulikia \(d<N\), \(d=N\) na \(d>N\) kwa miundo tofauti inayoweza kuandikwa kwa equations za matrix.
Nini hubadilika ikiwa precomputation inawezekana?
Ikiwa matrix ya wazi, kwa mfano matrix ya weights za AI, itatumika mara nyingi, precomputation ya offline inapendekezwa. Katika structured-A shared-a, uhusiano \[ A^{*}S+B\approx \Delta M \] hubadilika kuwa \[ A^{*}(SU)+BU\approx \Delta(MU) \]. Ikiwa operesheni zinazohusiana na \(S\cdot U\) zimeandaliwa mapema, hatua ya mtandaoni inaweza kubaki na kuzidisha \(B\cdot U\) tu. Faida hii hulipa gharama yake pale tu matrix hiyo hiyo ya plaintext inapotumika tena na tena.
Kwa nini transposition ya matrix iliyosimbwa ni tatizo jipya?
Kwa matrix iliyo wazi, transposition ni kupanga upya data. Kwa matrix iliyosimbwa, kubadili kutoka mpangilio wa rows kwenda columns kunaweza kuhitaji automorphisms za homomofiki na key-switching. Waandishi wanapendekeza algoriti ya Ciphertext Matrix Transpose (C-MT). Kwa matrix iliyosimbwa ya \(N\times N\), gharama yake ya asymptotic ni \[ \widetilde{O}(N^2) \] operesheni za modular arithmetic. Mbinu ya Tweak ya divide-and-conquer hupunguza njia ya moja kwa moja ya \(O(N^3)\) hadi quasi-quadratic.
Muda wa majaribio wa transposition ulikuwa upi?
| Ukubwa wa matrix / ring N | Muda wa transposition ya matrix iliyosimbwa |
|---|---|
| 212 | 5,60 s |
| 213 | 25,4 s |
| 214 | 117 s |
Thamani hizi zinaendana na ukuaji wa quasi-quadratic. Hata hivyo, katika matokeo ya CC-MM, transposition bado ni sehemu kubwa ya muda kwa ukubwa uliopimwa, ingawa kinadharia ni chini ya gharama ya kuzidisha matrix.
Kwa nini transposition “nyepesi” ilitengenezwa?
Mbinu ya kwanza ya C-MT huhitaji \(N\) switching keys kwa \(N\) automorphisms, na ukubwa wa keys unaweza kuwa mkubwa. Ndiyo maana mbinu nyepesi inayotumia switching keys tatu tu ilitengenezwa. Ufunguo mmoja wa automorphism husasishwa wakati wa utekelezaji na kutumika tena kwa mabadiliko tofauti; complexity hubaki \(\widetilde{O}(N^2)\).
Kuzidisha ciphertext–ciphertext kunapunguzwaje?
Ikiwa matrix zote mbili zimesimbwa, tatizo ni gumu kuliko plaintext–ciphertext. Algorithm 8 hubadilisha matrix mbili za RLWE zilizofichwa kuwa miundo inayofaa ya rows na columns, kisha hutenganisha kuzidisha kuwa 4 Mod-PP-MM, 3 C-MT, operesheni za ziada za \(\widetilde{O}(N^2)\), relinearization na rescaling.
Mbinu ya jumla ya RGSW inatoa nini?
Algorithm 8 ni nzuri kwa matrix kubwa za mraba, lakini si rahisi kwa kila ukubwa. Mbinu ya RGSW inapanuliwa ili kufanya outer product ya RGSW × RLWE katika kiwango cha matrix-vektor na kusaidia degree tofauti za ring, ukubwa tofauti na miundo tofauti ya RLWE/MLWE/shared-a. Operesheni za msingi ni:
\[ a'= \left\lfloor \frac{A_1a+A_0b}{p} \right\rceil \]
\[ b'= \left\lfloor \frac{B_1a+B_0b}{p} \right\rceil \]
Modulus ya ziada \(p\) hutumiwa kuzuia makosa ya usimbaji yasiongezeke bila udhibiti wakati wa kuzidisha matrix.
Makosa na precision hushughulikiwaje?
Kwa sababu CKKS ni takriban, precision ni muhimu pamoja na muda. Waandishi hutoa upper bound ya error kwa Algorithm 9. Katika majaribio, Algorithm 6 huripoti takriban 13,4–14,0 bits, Algorithm 8 takriban 8,3–9,1 bits, na Algorithm 9 ya RGSW takriban 17,2–17,5 bits. Tofauti hizi zinatokana na budget ya modulus, idadi ya key-switching, na baadhi ya hesabu kufanywa kwenye modulus kubwa zaidi \(pq\).
Kuzidisha modular matrix hubadilishwaje kuwa BLAS?
Kuna mikakati mitatu.
Mkakati 1: Kugawanya namba vipande
Katika IEEE-754 double arithmetic, integer zilizo chini ya \(2^{53}\) zinaweza kuwakilishwa kwa usahihi. Kwa hiyo integer kubwa hugawanywa katika blocks ndogo, kila block huzidishwa na BLAS, kisha matokeo huunganishwa.
Mkakati 2: Truncation
Kwa kuwa CKKS tayari ni ya takriban, katika baadhi ya hali bits zisizo muhimu sana za ciphertext hutupwa, na sehemu muhimu zaidi huchakatwa kwa double arithmetic. Hii ni ya kasi lakini inaongeza kosa la namba linalodhibitika.
Mkakati 3: Modulus switching na CRT
Modulus ya ciphertext hubadilishwa kuwa product ya moduli ndogo, kila kuzidisha kwenye modulus ndogo hupelekwa kwa BLAS, na matokeo huunganishwa tena kwa Chinese Remainder Theorem (CRT).
Uhusiano wa kazi hii na AI ni upi?
Katika transformer, layers za attention na feed-forward zina kuzidisha matrix kubwa. Katika privacy-preserving inference, weights za modeli zinaweza kuwa plaintext na input au activations za mtumiaji zikawa ciphertext. Hivyo CP-MM huwa muhimu moja kwa moja. Utafiti unajadili GPT, BERT na LLaMA kama mifano, lakini hauendeshi modeli kamili ya GPT, BERT au LLaMA mwisho-kwa-mwisho.
Matokeo yanayoungwa mkono na utafiti
- Baadhi ya operesheni kubwa za aljebra ya mstari chini ya CKKS/RLWE zinaweza kupunguzwa kuwa kuzidisha matrix za plaintext.
- CP-MM inaweza kupunguzwa kuwa Mod-PP-MM mbili, au kuwa PP-MM moja mtandaoni ikiwa precomputation ipo.
- CC-MM kubwa ya mraba inaweza kugawanywa kuwa Mod-PP-MM nne na transposition tatu za haraka za ciphertext.
- Algoriti mpya ya C-MT ina complexity ya \(\widetilde{O}(N^2)\).
- Shared-a inapunguza gharama katika matrix kubwa.
- RGSW inatoa kubadilika kwa ukubwa na miundo tofauti ya usimbaji.
- BLAS inaunganisha homomorphic matrix computation na miundombinu iliyokomaa ya high-performance linear algebra.
- Katika baadhi ya matukio ya matrix kubwa za mraba, tofauti ya utendaji imeshushwa hadi takriban mara 4–12.
Matokeo ambayo hayajathibitishwa au hayajajaribiwa
- Haiwezi kusemwa kuwa kila operesheni ya homomofiki ni polepole mara 4–12 tu kuliko plaintext.
- Uharakishaji uleule haujaonyeshwa kwa ukubwa wote wa matrix.
- Hakuna muda wa majaribio kwenye GPU.
- Hakuna benchmark ya inference ya LLM mwisho-kwa-mwisho.
- Hakuna tathmini ya uwanja katika afya, fedha au smart contracts.
- Haijaonyeshwa kuwa Algorithm 8 au Algorithm 9 ni chaguo bora kwa kila matumizi.
Mbinu na matokeo ya utafiti
Upunguzaji mkuu wa kialgoriti
| Kazi | Mbinu kuu | Upunguzaji wa plaintext linear algebra | Sharti / dokezo |
|---|---|---|---|
| CP-MM / CP-Mv | RLWE, shared-a au MLWE | 1 au 2 PP-MM / PP-Mv | Inategemea ukubwa na precomputation |
| CP-MM yenye precomputation | Structured-A shared-a | 1 PP-MM katika hatua ya mtandaoni | Matrix ya wazi ijulikane mapema na itumike tena |
| PC-MM | C-MT + CP-MM + C-MT | Inategemea upunguzaji wa CP-MM | Inafaa kwa matrix za mraba |
| CC-MM Algorithm 8 | RLWE + C-MT | 4 Mod-PP-MM | Kwa matrix kubwa za mraba |
| CC-Mv / CC-MM ya jumla | RGSW × RLWE | Mod-PP-Mv/MM kadhaa | Ina kubadilika zaidi lakini gharama ya kudumu ni kubwa |
Verianla Live: Operesheni ya matrix iliyosimbwa hupunguzwaje hadi BLAS?
Mchakato huu unaonyesha wazo kuu la hesabu. Data iliyosimbwa haifunguliwi kuwa plaintext; BLAS hufanya kazi kwenye matrix zinazotokana na vipengele vya algebra vya ciphertext.
| Hatua | Operesheni | Maana ya kisayansi |
|---|---|---|
| 1 | Matrix ya CKKS/RLWE iliyosimbwa | Ujumbe huhifadhiwa ndani ya vipengele vya ciphertext. |
| 2 | Kuandika upya kama matrix | Uhusiano hubadilika kuwa S* A + B ≈ ΔM. |
| 3 | Format inayofaa ya ciphertext | RLWE, shared-a, MLWE au RGSW huchaguliwa kulingana na ukubwa. |
| 4 | Kupunguza tatizo | MM/Mv iliyosimbwa hugawanywa kuwa MM/Mv za modular plaintext. |
| 5 | Kubadilisha hadi BLAS | Splitting, truncation au modulus switching + CRT hutumiwa. |
| 6 | OpenBLAS dgemm / dgemv | Sehemu kubwa ya hesabu hufanywa na routines za kawaida zenye utendaji wa juu. |
| 7 | Rescale / Relin / format | Matokeo hurudishwa kwenye format inayofaa ya CKKS. |
| 8 | Matokeo yaliyosimbwa | Matokeo hubaki ciphertext kwa operesheni nyingine za FHE. |
Mazingira ya majaribio
| Kipengele | Muundo uliotumiwa |
|---|---|
| Maktaba ya FHE | HEaaN |
| BLAS | OpenBLAS 0.3.26 |
| CPU | Intel Xeon Gold 6342 @ 2,80 GHz |
| Threads | 1 |
| Kurudia | Wastani wa majaribio 10 |
| Usalama | Takriban 128 bit |
| Matrix za kuingiza | Thamani za uniform katika [−1, 1] |
Algorithm 6: plaintext–ciphertext matrix multiplication
| Ukubwa d1 × d2 × d3 | A (s) | B (s) | Jumla (s) | Precision mbaya zaidi (bit) |
|---|---|---|---|---|
| 212 × 212 × 1 | 0,178 | 0,249 | 0,427 | 13,5 |
| 212 × 212 × 26 | 0,253 | 0,270 | 0,523 | 13,5 |
| 212 × 212 × 212 | 5,00 | 1,78 | 6,78 | 13,4 |
| 213 × 213 × 213 | 19,1 | 13,3 | 32,4 | 13,7 |
| 214 × 214 × 214 | 73,7 | 102 | 176 | 13,5 |
Algorithm 8: ciphertext–ciphertext matrix multiplication ya mraba
Verianla Live: Muda wa Algorithm 8 hubadilikaje matrix inapokua?
Data inatokana na Tablo 10.
| Ukubwa wa matrix ya mraba | Transpose (s) | Mod-PP-MM (s) | Relin (s) | Rescale (s) | Jumla (s) | Precision |
|---|---|---|---|---|---|---|
| 2^12 × 2^12 | 16,8 | 22,1 | 1,17 | 1,07 | 41,2 | 9,1 |
| 2^13 × 2^13 | 73,6 | 162 | 5,17 | 4,81 | 245 | 8,8 |
| 2^14 × 2^14 | 352 | 1300 | 24,0 | 21,0 | 1710 | 8,3 |
Algorithm 9: mbinu ya jumla ya RGSW
| Ukubwa d1 × d2 × d3 | Ring degree | Muda wa Mod-PP-MM (s) | Precision mbaya zaidi |
|---|---|---|---|
| 212 × 212 × 1 | 212 | 0,882 | 17,5 |
| 212 × 212 × 212 | 212 | 42,6 | 17,4 |
| 213 × 213 × 213 | 213 | 291 | 17,3 |
| 214 × 214 × 214 | 213 | 1270 | 17,4 |
Dai la mara 4–12 lisomweje?
Dai hili linahusu baadhi ya matrix kubwa za mraba na masharti maalumu ya kupunguza hesabu hadi BLAS. Halimaanishi kuwa kila programu ya FHE, kila format conversion, bootstrapping au modeli kamili ya AI ni polepole mara 4–12 tu kuliko plaintext.
Nguvu za utafiti
- Unachanganya algoriti ya kinadharia na utekelezaji wa HEaaN/OpenBLAS.
- Unatoa formats tofauti za usimbaji kwa ukubwa tofauti wa matrix.
- Unaunganisha hesabu zilizofichwa na miundombinu iliyokomaa ya BLAS.
- Unaripoti usalama, precision na muda pamoja.
- Unatoa algoriti ya transposition ya ciphertext yenye gharama ya quasi-quadratic.
Mapungufu makuu
- Majaribio makuu yalifanywa kwenye CPU ya thread moja.
- Hakuna muda wa GPU ulioripotiwa.
- Matrix za majaribio zilitokana na usambazaji wa uniform, si data halisi ya programu.
- Hii si benchmark ya mwisho-kwa-mwisho ya transformer au LLM.
- Precomputation inaleta faida hasa pale matrix hiyo hiyo ya plaintext inapotumiwa mara nyingi.
Dokezo la chanzo na mbinu
Jina kamili la kazi asilia: Fast Homomorphic Linear Algebra with BLAS
Waandishi: Youngjin Bae, Jung Hee Cheon, Guillaume Hanrot, Jai Hyun Park na Damien Stehlé.
Mwandishi anayewajibika: Jai Hyun Park.
Taasisi: CryptoLab Inc., Seoul, Republic of Korea; Seoul National University, Seoul, Republic of Korea; CryptoLab Inc., Lyon, France.
Jarida rasmi: Journal of Cryptology.
Mchapishaji: Springer Nature.
Taarifa ya bibliografia: Journal of Cryptology, 2026, Volume 39, Article 25; Volume 39, Issue 3.
DOI:10.1007/s00145-026-09580-x
Tarehe rasmi ya kuchapishwa: 12 Mei 2026.
Toleo lililopakiwa: arXiv:2503.16080v2 [cs.CR], 27 Aprili 2026.
Aina ya chanzo na hali ya uhakiki: Faili iliyopakiwa ni toleo la mwandishi kwenye arXiv, lakini kazi ilichapishwa rasmi katika Journal of Cryptology kama makala ya utafiti.
Leseni/hakimiliki: Toleo lililopakiwa halionyeshi leseni wazi kama CC BY; kwa hiyo michoro asilia haikunakiliwa moja kwa moja katika maudhui ya Verianla.
Utekelezaji: Sehemu za Algorithm 2, 4, 6, 8 na 9 zilitekelezwa kwenye HEaaN; OpenBLAS 0.3.26 ilitumika kwa plaintext linear algebra.
Kikomo cha majaribio: Muda ulipimwa kwenye Intel Xeon Gold 6342 2,80 GHz kwa thread moja; hakuna matokeo ya GPU.
Kikomo cha usalama: Vigezo vinaunga mkono takriban usalama wa biti 128 kulingana na lattice estimator; vigezo vingine vya CKKS vinahitaji tathmini tofauti.
Kikomo cha precision: CKKS ni usimbaji wa takriban; matokeo si exact arithmetic.
Kikomo cha utendaji: Tofauti ya mara 4–12 inahusu masharti maalumu ya matrix kubwa za mraba na BLAS reduction; haiwezi kuenezwa kwa programu zote za FHE au modeli zote za AI.
Kikomo cha maudhui ya kisayansi: Matokeo ya kiufundi, algoriti, muda, thamani za precision na maoni ya utekelezaji katika makala hii ya Verianla yanategemea kazi iliyochunguzwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *