

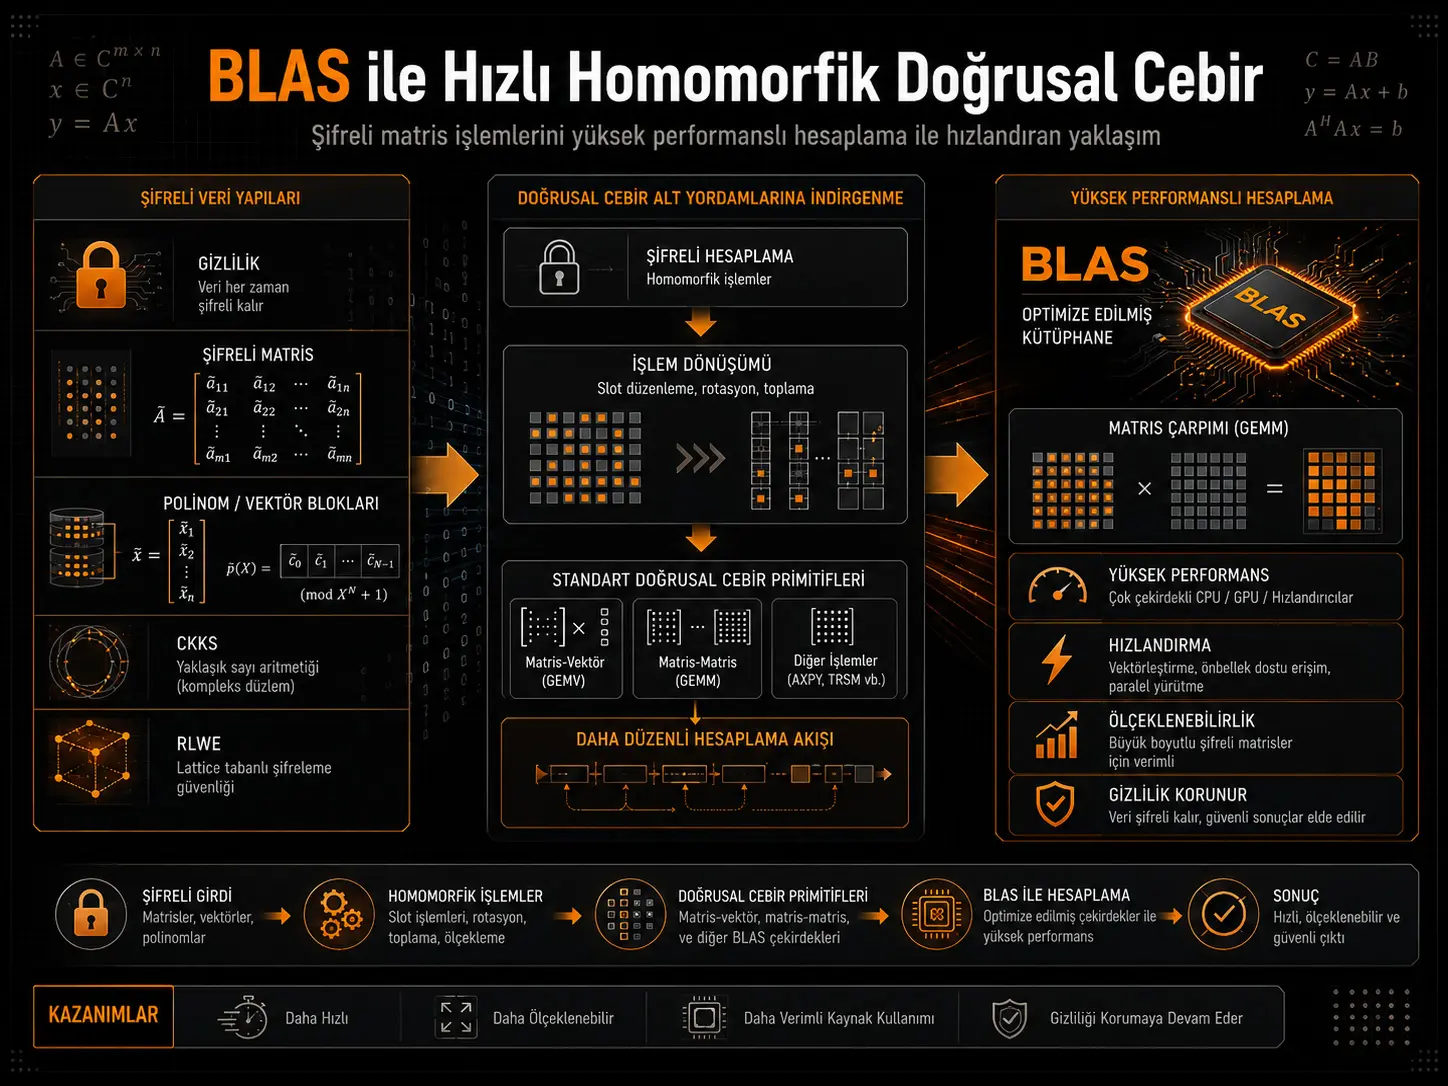
Araştırma, homomorfik şifreleme altında gerçekleştirilen büyük ölçekli matris-vektör ve matris-matris işlemlerini, doğrudan karmaşık şifreli işlem dizileriyle yürütmek yerine yüksek performanslı açık metin doğrusal cebir işlemlerine indirgemeyi amaçlamaktadır. Çalışmanın merkezinde yaklaşık reel sayı aritmetiğini destekleyen CKKS tam homomorfik şifreleme sistemi ile onlarca yıldır optimize edilen BLAS (Basic Linear Algebra Subroutines) kütüphaneleri arasındaki bağlantı bulunmaktadır. Araştırmacılar farklı RLWE, MLWE, shared-a ve RGSW tabanlı şifreleme biçimleri kullanarak plaintext–ciphertext, ciphertext–plaintext ve ciphertext–ciphertext matris işlemlerinin önemli bölümünü standart matris çarpımlarına dönüştüren algoritmalar geliştirmiştir. HEaaN ve OpenBLAS ile yapılan deneylerde yazarlar, belirli büyük kare matris senaryolarında CKKS tabanlı şifreli matris çarpımının çift duyarlıklı kayan noktalı açık metin matris çarpımına göre hesaplama kaybının yaklaşık 4–12 kat düzeyine kadar indirilebildiğini bildirmektedir. Bu performans oranı belirli algoritma, boyut, şifreleme biçimi ve ön hesaplama koşullarına aittir; bütün homomorfik hesaplamalar için evrensel bir oran değildir.
Çalışmanın temel fikri, şifreli veriyi çözerek BLAS'a vermek değildir. Veri şifreli kalmaktadır. Araştırmacılar RLWE tabanlı şifreli matris yapısını cebirsel olarak yeniden ifade ederek, şifreli matris çarpımının büyük kısmını şifreli mesajın kendisine erişmeden standart sayısal matris çarpımlarına dönüştürmektedir. Böylece BLAS'ın CPU ve GPU mimarileri için yıllardır optimize edilmiş veri erişim ve hesaplama düzenlerinden yararlanılması hedeflenmektedir.
Önerilen çerçevede plaintext–ciphertext matris çarpımı bazı durumlarda iki standart plaintext matris çarpımına, ön hesaplamanın mümkün olduğu durumda ise çevrim içi aşamada tek bir plaintext matris çarpımına kadar indirgenebilmektedir. Büyük kare ciphertext–ciphertext matris çarpımı dört modüler plaintext matris çarpımına ve şifreli matris transpozisyonlarına indirgenmiştir. Daha genel RGSW tabanlı yöntem ise farklı boyut ve şifreleme biçimlerini desteklemek karşılığında daha yüksek sabit maliyet taşımaktadır.
Deneyler HEaaN, OpenBLAS 0.3.26 ve tek iş parçacıklı Intel Xeon Gold 6342 2,80 GHz işlemci üzerinde yürütülmüş, süreler 10 çalıştırmanın ortalaması olarak verilmiştir. Kullanılan parametreler araştırmacıların lattice estimator değerlendirmesine göre yaklaşık 128 bit güvenlik sağlayacak biçimde seçilmiştir. Bu nedenle sonuçlar homomorfik doğrusal cebirin pratik olarak hızlandırılabileceğini göstermektedir; ancak doğrudan çok çekirdekli CPU, GPU veya uçtan uca gizlilik korumalı büyük dil modeli performansı olarak yorumlanmamalıdır.
Türkiye açısından değerlendirme: Çalışma, Türkiye'de kriptografi, veri mahremiyeti, güvenli bulut bilişim ve gizlilik korumalı yapay zekâ üzerinde çalışan araştırma ve mühendislik ekipleri açısından dikkat çekici bir yöntem sunmaktadır. Büyük matris işlemlerinin mevcut BLAS ekosistemine indirgenmesi, özel homomorfik donanım geliştirmeden önce mevcut CPU/GPU doğrusal cebir altyapısından yararlanılabileceğini göstermektedir. Bununla birlikte çalışma Türkiye'deki belirli bir veri merkezi, uygulama veya mevzuat ortamını test etmemiştir; dolayısıyla doğrudan ulusal altyapı performansı veya uygulama maliyeti sonucu çıkarılamaz.
Homomorfik şifreleme neden önemlidir?
Normal şifrelemede veri üzerinde işlem yapabilmek için çoğu durumda verinin önce çözülmesi gerekir. Homomorfik şifrelemenin hedefi ise sunucunun verinin açık hâlini görmeden şifreli veri üzerinde hesaplama yapabilmesidir. Hesaplama tamamlandıktan sonra sonuç hâlâ şifreli olarak kullanıcıya döner ve yalnız uygun anahtara sahip taraf sonucu çözebilir.
Bu özellik özellikle veri sahibinin ham verisini işlem yapan sunucuya vermek istemediği senaryolar için önemlidir. Araştırmada örnek olarak gizlilik korumalı yapay zekâ çıkarımı, özel bilgi erişimi, yaklaşık vektör arama, federatif temel bileşen analizi ve büyük dil modellerinin özel değerlendirilmesi ele alınmaktadır.
Matris çarpımı neden darboğaz oluşturuyor?
Modern makine öğrenmesi ve bilimsel hesaplama sistemlerinin büyük bölümü matris-vektör ve matris-matris çarpımlarına dayanır. Açık metin dünyasında bu işlemler son derece olgun BLAS kütüphaneleri tarafından gerçekleştirilebilir. Buna karşılık RLWE tabanlı homomorfik şifrelemede bir şifreli metin tek bir sayıyı değil, çok sayıda değeri birlikte taşıyan polinom yapısını içerir.
Şifreli verinin bu yapı içinde yeniden düzenlenmesi için key-switching, homomorfik otomorfizm ve benzeri işlemler gerekebilir. Araştırmacılar önceki birçok yöntemde özellikle key-switching sayısının pratik çalışma süresini domine edebildiğini ve karmaşık bellek erişim düzenlerinin optimizasyonu güçleştirdiğini belirtmektedir.
Çalışmanın temel sorusu bu nedenle şudur: Şifreli matris çarpımının büyük hesaplama bölümünü, şifreyi çözmeden, standart açık metin doğrusal cebir problemine dönüştürmek mümkün müdür?
BLAS nedir ve bu çalışmada neden kullanılıyor?
BLAS, Basic Linear Algebra Subroutines ifadesinin kısaltmasıdır. Matris-vektör ve matris-matris çarpımı gibi temel doğrusal cebir işlemleri için standart programlama arayüzleri tanımlar. Çalışmada özellikle çift duyarlıklı genel matris çarpımı dgemm ve matris-vektör çarpımı dgemv rutinleri kullanılmaktadır.
BLAS'ın araştırma açısından değeri yalnız hızlı kod olması değildir. CPU önbellekleri, vektör komutları, paralellik ve GPU mimarileri için uzun yıllardır optimize edilmiş olmasıdır. Araştırmacılar homomorfik işlemleri mümkün olduğunca BLAS çağrılarına dönüştürdüklerinde bu optimizasyon birikiminden doğrudan yararlanabilmektedir.
CKKS neden tercih edildi?
Çalışma özellikle CKKS homomorfik şifreleme sistemine odaklanmaktadır. CKKS yaklaşık reel ve karmaşık sayı aritmetiğini destekler ve SIMD benzeri paralel veri işleme kapasitesi sunar. Bu özellikler sayısal doğrusal cebir ve yapay zekâ uygulamalarıyla doğal biçimde örtüşmektedir.
CKKS yaklaşık bir sistem olduğu için hesaplanan değer tamamen hatasız tam sayı aritmetiği olarak düşünülmemelidir. Araştırmacılar üç hata kaynağını ayırmaktadır: başlangıç verisinin sayısallaştırılmasından gelen kodlama hatası, RLWE şifrelemesinden gelen kriptografik hata ve rescaling/key-switching gibi homomorfik işlemlerin ürettiği ek hata.
RLWE şifreli metni nasıl ifade ediliyor?
Temel RLWE şifreli metni çalışmada yaklaşık olarak:
\[ a\cdot sk+b\approx m\pmod q \]
şeklinde ifade edilmektedir.
Burada \(a\) ve \(b\) şifreli metnin iki polinom bileşenini, \(sk\) gizli anahtarı, \(m\) şifrelenmiş mesajı ve \(q\) şifreli metin modülünü temsil etmektedir. Yaklaşık eşitlik işareti CKKS kodlama ve homomorfik işlem hatalarının bulunduğunu gösterir.
Araştırmanın kritik adımı bu polinom ilişkisini bir matris ilişkisi olarak yeniden yazmaktır. Bir matrisin sütunları şifreli olduğunda yapı genel olarak:
\[ S^{*}A+B\approx \Delta M\pmod q \]
biçiminde ifade edilebilir. Burada \(M\) asıl mesaj matrisi, \(\Delta\) CKKS ölçek faktörü, \(S^{*}\) gizli anahtarın yapısal matris gösterimi, \(A\) ve \(B\) ise şifreli metin bileşenlerinden türetilen matrislerdir.
Bu cebirsel yeniden yazım, çalışmanın BLAS'a indirgeme yaklaşımının temelini oluşturmaktadır.
Plaintext–ciphertext matris çarpımı nasıl sadeleşiyor?
Şifreli \(M\) matrisi:
\[ S^{*}A+B\approx \Delta M \]
biçiminde ve açık metin \(U\) matrisi biliniyorsa her iki taraf sağdan \(U\) ile çarpılabilir:
\[ S^{*}(AU)+(BU)\approx \Delta(MU) \]
Böylece asıl homomorfik \(M\cdot U\) işlemi, büyük ölçüde iki standart matris çarpımına, yani \(A\cdot U\) ve \(B\cdot U\) işlemlerine dönüşmektedir.
Bu matrisler asıl kullanıcı mesajının açık hâli değildir. Şifreli metnin cebirsel bileşenleridir. Dolayısıyla yaklaşımın amacı şifrelemeyi kaldırmak değil, şifreli işlemin matematiksel yapısını standart doğrusal cebir hesaplamasına dönüştürmektir.
Shared-a biçimi ne sağlıyor?
Bir RLWE şifreli metni \((a,b)\) çifti olarak düşünüldüğünde, araştırmacılar birden fazla şifreli metnin aynı \(a\) bileşenini paylaşabildiği shared-a biçimini hesaplama amacıyla kullanmaktadır.
Büyük matrislerde bu yaklaşım özellikle \(A\) matrisinin boyutunu küçültebilmekte ve matris çarpımının pahalı kısmındaki işlem miktarını azaltabilmektedir. Çalışmanın \(2^{14}\times2^{14}\times2^{14}\) CP-MM örneğinde araştırmacılar shared-s biçimi kullanılsaydı yaklaşık 400 saniye beklediklerini, structured-S shared-a kullanımıyla hesaplama süresinin 176 saniye olduğunu bildirmektedir. Yaklaşık 60 saniyelik format dönüşüm maliyeti eklense bile shared-a yaklaşımının belirgin kazanç sağladığı belirtilmektedir.
Küçük matrislerde neden MLWE kullanılıyor?
Matris boyutu RLWE halka derecesi \(N\)'den küçük olduğunda standart RLWE paketlemesi verimsizleşebilir. Araştırmacılar bu durumda Module Learning With Errors (MLWE) biçiminden yararlanmaktadır.
Böylece çalışmanın çerçevesi yalnız \(d=N\) durumuna bağlı kalmamakta; \(d<N\), \(d=N\) ve \(d>N\) boyutları için farklı fakat ortak matris denklemleriyle ifade edilebilen şifreleme biçimleri kullanılabilmektedir.
Ön hesaplama mümkünse ne değişiyor?
Bir açık metin matrisi, örneğin bir yapay zekâ modelinin sabit ağırlık matrisi, birçok kez kullanılacaksa çalışma çevrim dışı ön hesaplama yapılmasını önermektedir.
Structured-A shared-a yaklaşımında çevrim içi CP-MM işlemi:
\[ A^{*}S+B\approx \Delta M \]
ilişkisinden:
\[ A^{*}(SU)+BU\approx \Delta(MU) \]
biçimine dönüştürülmektedir.
\(S\cdot U\) ile ilgili anahtar işlemleri daha önceden hazırlandığında çevrim içi aşamada yalnız \(B\cdot U\) matris çarpımı kalabilir. Araştırmacılar böylece ön hesaplamalı CP-MM'nin aynı boyutlardaki tek bir kayan noktalı plaintext matris çarpımına kadar indirgenebileceğini göstermektedir.
Ancak bu avantajın bedeli ön hesaplamadır. Ön hesaplama ana işlemin kendisi kadar veya daha pahalı olabilir ve ancak aynı açık metin matrisinin tekrar tekrar kullanıldığı durumlarda amorti edilebilir.
Şifreli matris transpozisyonu neden yeni bir problem?
Normal bir matrisin transpozisyonu açık metinde çok basit bir veri yeniden düzenleme işlemidir. Şifreli matrislerde ise verinin satır bazlı şifrelemeden sütun bazlı şifrelemeye geçirilmesi homomorfik otomorfizmler ve key-switching gerektirebilir.
Araştırmacılar Ciphertext Matrix Transpose (C-MT) adını verdikleri yeni bir algoritma geliştirmiştir. \(N\times N\) şifreli matris için algoritmanın asimptotik maliyeti:
\[ \widetilde{O}(N^2) \]
modüler aritmetik işlemidir.
Bu değer anlamlıdır çünkü matrisin kendisi zaten \(N^2\) veri öğesi içerir. Çalışmada geliştirilen Tweak böl-ve-yönet yaklaşımı, doğrudan yöntemin \(O(N^3)\) seviyesindeki maliyetini quasi-quadratic düzeye indirmektedir.
Transpozisyonun deneysel süresi neydi?
| Matris / halka boyutu N | Şifreli matris transpozisyon süresi |
|---|---|
| 212 | 5,60 s |
| 213 | 25,4 s |
| 214 | 117 s |
Deneysel değerler boyut büyüdükçe quasi-quadratic davranışla uyumlu bir artış göstermektedir. Ancak çalışma daha sonra CC-MM sonuçlarında transpozisyonun teorik olarak matris çarpımından daha düşük karmaşıklığa sahip olmasına rağmen test edilen boyutlarda çalışma süresinin hâlâ önemli bölümünü oluşturduğunu göstermektedir.
Neden “lightweight” transpozisyon geliştirildi?
İlk C-MT yaklaşımı \(N\) farklı otomorfizm için \(N\) switching key gerektirir ve bu anahtarların toplam boyutu büyük olabilir. Araştırmacılar bu nedenle yalnız üç switching key kullanan hafif bir yöntem geliştirmiştir.
Bu yöntemde tek bir otomorfizm anahtarı çalışma sırasında güncellenerek farklı dönüşümler için tekrar kullanılmaktadır. Ek hesaplamalar gerekse de asimptotik karmaşıklık yine \(\widetilde{O}(N^2)\) kalmaktadır.
Bu yaklaşım kullanıldığında lightweight CC-MM algoritması relinearization dahil toplam dört switching key ile çalışabilmektedir.
Ciphertext–ciphertext matris çarpımı nasıl indirgeniyor?
İki şifreli matrisin de gizli olması, plaintext–ciphertext durumundan daha zordur. Araştırmacılar Algorithm 8'de iki RLWE şifreli matrisi uygun satır ve sütun biçimlerine dönüştürerek çarpımı dört standart modüler matris çarpımına ayırmaktadır.
Büyük kare \(N\times N\) matrisler için sonuç:
- 4 adet Mod-PP-MM,
- 3 adet C-MT şifreli transpozisyon,
- \(\widetilde{O}(N^2)\) ek işlem,
- relinearization ve rescaling
bileşenlerinden oluşmaktadır.
Matris çarpımının bilinen teorik karmaşıklığı \(N^2\)'den daha hızlı büyüdüğü için C-MT'nin \(\widetilde{O}(N^2)\) maliyeti asimptotik olarak daha düşük kalmaktadır. Pratikte ise test edilen boyutlarda transpozisyon süresi henüz ihmal edilebilir değildir.
RGSW tabanlı genel yöntem ne sağlıyor?
RLWE tabanlı Algorithm 8 büyük kare matrislerde verimlidir ancak boyut esnekliği sınırlıdır. Araştırmacılar daha genel kullanım için RGSW benzeri matris şifreleme biçimini genişletmektedir.
Bu yaklaşımda klasik RGSW × RLWE dış çarpımı matris-vektör düzeyine taşınmakta ve farklı halka derecelerine, farklı matris boyutlarına ve farklı RLWE/MLWE/shared-a biçimlerine sahip veriler birlikte işlenebilmektedir.
Genel CC-Mv algoritmasının temel işlemi:
\[ a'= \left\lfloor \frac{A_1a+A_0b}{p} \right\rceil \]
ve:
\[ b'= \left\lfloor \frac{B_1a+B_0b}{p} \right\rceil \]
biçimindedir. Buradaki yardımcı \(p\) modülü, şifreleme hatalarının matris çarpımı sırasında kontrol dışı büyümesini önlemek amacıyla kullanılmaktadır.
Hata ve hassasiyet nasıl ele alınıyor?
CKKS yaklaşık hesaplama yaptığı için yalnız çalışma süresi değil, sonuç hassasiyeti de önemlidir. Araştırmacılar Algorithm 9 için hata üst sınırı türetmekte ve uygun ölçekleme ile beklenen hassasiyet kaybının matris boyutuyla logaritmik olarak ilişkili olabileceğini göstermektedir.
Deneylerde farklı algoritmalar aynı hassasiyeti üretmemektedir. Örneğin Algorithm 6 deneylerinde yaklaşık 13,4–14,0 bit, Algorithm 8'de yaklaşık 8,3–9,1 bit ve RGSW tabanlı Algorithm 9'da yaklaşık 17,2–17,5 bit raporlanmıştır.
Bu fark doğrudan “Algorithm 9 her zaman daha iyi” biçiminde yorumlanmamalıdır. Araştırmacılar seçilen modül bütçelerinin, key-switching sayısının ve bazı hesaplamaların daha büyük \(pq\) modülünde gerçekleştirilmesinin hassasiyet farklarını etkilediğini açıkça belirtmektedir.
Modüler matris çarpımı BLAS'a nasıl dönüştürülüyor?
Çalışmanın teorik indirgemeleri doğrudan modüler plaintext matris çarpımına ulaşmaktadır. Ancak standart BLAS çift duyarlıklı kayan noktalı aritmetik kullanır. Araştırmacılar bu iki yapı arasında üç strateji geliştirmiştir.
Strateji 1: Sayıları parçalara ayırma
IEEE-754 double aritmetiğinde \(2^{53}\)'ten küçük tam sayılar tam olarak temsil edilebildiği için büyük tamsayılar daha küçük basamak bloklarına ayrılmakta, her blok BLAS ile tam olarak çarpılmakta ve sonuç daha sonra birleştirilmektedir.
Strateji 2: Truncation
CKKS zaten yaklaşık bir sistem olduğu için bazı durumlarda şifreli metnin düşük anlamlı bitleri atılıp yalnız yüksek anlamlı kısım double aritmetiğiyle işlenmektedir. Bu yöntem daha hızlıdır ancak kontrollü ek sayısal hata getirir.
Strateji 3: Modulus switching ve CRT
Şifreli metin modülü daha küçük modüllerin çarpımına dönüştürülmekte, her küçük modülde matris çarpımı BLAS'a indirgenmekte ve sonuç Çin Kalan Teoremi (CRT) ile yeniden birleştirilmektedir.
Çalışmanın yapay zekâyla bağlantısı nedir?
Transformer mimarilerinde attention ve feed-forward katmanları büyük matris çarpımları içerir. Gizlilik korumalı çıkarımda model ağırlıkları açık metin, kullanıcının aktivasyon veya giriş verileri ise şifreli olabilir. Bu durumda CP-MM doğrudan önemli hâle gelir.
Çalışma GPT, BERT, LLaMA gibi transformer ailelerini örnek olarak tartışmaktadır; ancak araştırmacılar bu çalışmada uçtan uca bir GPT, BERT veya LLaMA modeli çalıştırmamıştır. Yapay zekâ bağlantısı, geliştirilen doğrusal cebir algoritmalarının bu sistemlerdeki temel matris işlemlerine uygulanabilirliğine dayanmaktadır.
Çalışmanın desteklediği sonuçlar
- CKKS/RLWE tabanlı bazı büyük şifreli doğrusal cebir işlemleri standart plaintext matris çarpımlarına indirgenebilmektedir.
- CP-MM uygun şifreleme biçiminde iki Mod-PP-MM'ye indirgenebilmektedir.
- Ön hesaplama mümkünse çevrim içi CP-MM tek bir aynı boyutlu plaintext matris çarpımına kadar indirgenebilmektedir.
- Büyük kare CC-MM dört Mod-PP-MM ve üç hızlı şifreli transpozisyona indirgenebilmektedir.
- Yeni C-MT algoritması \(\widetilde{O}(N^2)\) aritmetik karmaşıklığa sahiptir.
- Shared-a biçimi büyük matrislerde hesaplama maliyetini önemli ölçüde azaltabilmektedir.
- RGSW yaklaşımı daha geniş matris boyutu ve şifreleme biçimi kombinasyonlarına olanak vermektedir.
- BLAS kullanımı, homomorfik matris hesaplamalarının mevcut yüksek performanslı doğrusal cebir altyapısından yararlanmasını sağlamaktadır.
- Araştırmacılar belirli büyük kare matris senaryolarında homomorfik ve double-precision açık matris çarpımı arasındaki performans farkını yaklaşık 4–12 kat düzeyine kadar indirebildiklerini bildirmektedir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Her homomorfik işlem plaintext hesabın yalnız 4–12 katı sürede tamamlanmaktadır sonucu çıkarılamaz.
- Çalışma bütün matris boyutlarında aynı hızlanmayı göstermemektedir.
- GPU üzerinde deneysel hız ölçümü yapılmamıştır.
- Çok iş parçacıklı BLAS sonuçları ana deney tablosu olarak verilmemiştir; karşılaştırmalar tek iş parçacıklı CPU ortamında yapılmıştır.
- Uçtan uca özel LLM inference süresi ölçülmemiştir.
- Gerçek sağlık, finans veya akıllı sözleşme uygulaması üzerinde saha değerlendirmesi yapılmamıştır.
- Küçük matrislerde veya küçük \(d_3\) değerlerinde format dönüşümü ve veri işleme maliyetlerinin ihmal edilebilir olduğu gösterilmemiştir.
- Bütün uygulamalar için Algorithm 8 veya Algorithm 9'un tek bir evrensel olarak en iyi seçim olduğu gösterilmemiştir.
- Deneylerde kullanılan performans değerleri farklı CPU/GPU, BLAS kütüphanesi veya CKKS parametrelerinde aynı kalmak zorunda değildir.
Çalışmanın Yöntemi ve Bulguları
Temel algoritmik indirgemeler
| Görev | Temel yaklaşım | Plaintext doğrusal cebir indirgemesi | Önemli koşul / not |
|---|---|---|---|
| CP-MM / CP-Mv | RLWE, shared-a veya MLWE | 1 veya 2 PP-MM / PP-Mv | Boyuta ve ön hesaplamaya bağlı |
| Ön hesaplamalı CP-MM | Structured-A shared-a | Çevrim içi aşamada 1 PP-MM | Açık matris önceden bilinmeli ve tekrar kullanılmalı |
| PC-MM | C-MT + CP-MM + C-MT | CP-MM indirgemesine dayanır | Kare matrislerde uygulanabilir |
| CC-MM Algorithm 8 | RLWE + C-MT | 4 Mod-PP-MM | Büyük kare matrisler için |
| CC-Mv / genel CC-MM | RGSW × RLWE dış çarpımı | Birden çok Mod-PP-Mv/MM | Daha esnek; daha yüksek sabit maliyet |
Verianla Live: Şifreli matris işlemi BLAS'a nasıl indirgeniyor?
Bu süreç çalışmanın genel hesaplama fikrini özetler. Şifreli veri hiçbir aşamada kullanıcı mesajı olarak açık metne çözülmez; BLAS'ın işlediği yapılar homomorfik şifreli metnin cebirsel bileşenlerinden türetilen matrislerdir.
| Aşama | İşlem | Bilimsel anlamı |
|---|---|---|
| 1 | CKKS/RLWE şifreli matris | Mesaj matrisi şifreli metin bileşenleri içinde tutulur. |
| 2 | Matris biçiminde yeniden ifade | Şifreleme ilişkisi S* A + B ≈ ΔM biçimine dönüştürülür. |
| 3 | Uygun ciphertext formatı | Boyuta göre RLWE, shared-a, MLWE veya RGSW kullanılır. |
| 4 | Homomorfik problemin indirgenmesi | Şifreli MM/Mv işlemi standart modüler plaintext MM/Mv işlemlerine ayrılır. |
| 5 | Modüler işlemin BLAS'a dönüştürülmesi | Parçalama, truncation veya modulus switching + CRT uygulanır. |
| 6 | OpenBLAS dgemm / dgemv | Hesabın büyük bölümü yüksek performanslı standart doğrusal cebir rutinlerinde yapılır. |
| 7 | Rescale / Relin / format dönüşümü | Sonuç uygun CKKS şifreli metin biçimine ve ölçeğine getirilir. |
| 8 | Şifreli sonuç | Sonuç daha sonraki FHE işlemlerinde kullanılabilecek biçimde şifreli kalır. |
Deneysel ortam
| Deney bileşeni | Çalışmada kullanılan yapı |
|---|---|
| Homomorfik şifreleme kütüphanesi | HEaaN |
| BLAS uygulaması | OpenBLAS 0.3.26 |
| CPU | Intel Xeon Gold 6342 @ 2,80 GHz |
| İş parçacığı | 1 |
| Tekrar | Her zamanlama 10 çalıştırmanın ortalaması |
| Güvenlik hedefi | Lattice estimator'a göre yaklaşık 128 bit |
| Temel ciphertext modülü | q ≈ 254 |
| Ölçek faktörü | ≈ 220 |
| Rescale sonrası modül | q0 ≈ 234 |
| RGSW yardımcı modülü | p = 240 |
| Key-switch yardımcı modülü | P = 254 |
| Giriş matrisleri | Elemanları bağımsız ve [−1, 1] aralığında uniform örneklenen matrisler |
| Gadget rank / dnum | 2 |
Algorithm 6: plaintext–ciphertext matris çarpımı
Algorithm 6 deneylerinde A bileşeni Strategy 1 ile üç kayan noktalı PP-MM çağrısına, B bileşeni ise Strategy 2 ile tek PP-MM çağrısına indirgenmiştir. Rescaling süresi ihmal edilebilir bulunduğu için Tablo 9 yalnız Mod-PP-MM hesaplamalarını raporlamaktadır.
| Boyut d1 × d2 × d3 | A bileşeni (s) | B bileşeni (s) | Toplam (s) | En kötü hassasiyet (bit) |
|---|---|---|---|---|
| 212 × 212 × 1 | 0,178 | 0,249 | 0,427 | 13,5 |
| 212 × 212 × 26 | 0,253 | 0,270 | 0,523 | 13,5 |
| 212 × 212 × 212 | 5,00 | 1,78 | 6,78 | 13,4 |
| 213 × 213 × 1 | 0,402 | 1,20 | 1,60 | 13,8 |
| 213 × 213 × 27 | 0,699 | 1,42 | 2,12 | 13,6 |
| 213 × 213 × 213 | 19,1 | 13,3 | 32,4 | 13,7 |
| 214 × 214 × 1 | 0,914 | 6,19 | 7,10 | 14,0 |
| 214 × 214 × 27 | 1,45 | 6,74 | 8,19 | 13,5 |
| 214 × 214 × 214 | 73,7 | 102 | 176 | 13,5 |
Kare matrislerde A bileşeninin üç BLAS çarpımına indirgenmesinin etkisi belirgin biçimde görülmektedir. Küçük \(d_3\) değerlerinde ise araştırmacılar matris çarpımının kendisinden çok, modüler verinin kayan noktalı BLAS biçimine dönüştürülmesine ilişkin işleme maliyetlerinin önemli hâle geldiğini belirtmektedir.
Algorithm 8: büyük kare ciphertext–ciphertext matris çarpımı
Algorithm 8'in zamanlamaları toplam homomorfik CC-MM işlemini transpozisyon, Mod-PP-MM, relinearization ve rescaling olarak ayırmaktadır.
Verianla Live: Algorithm 8 çalışma süresi büyüyen matrislerde nasıl değişiyor?
Veriler çalışmanın Tablo 10 sonuçlarıdır. Süreler tek iş parçacıklı Intel Xeon Gold 6342 üzerinde 10 çalıştırmanın ortalamasıdır.
| Kare matris boyutu | Transpozisyon (s) | Mod-PP-MM (s) | Relinearization (s) | Rescale (s) | Toplam (s) | Hassasiyet (bit) |
|---|---|---|---|---|---|---|
| 2^12 × 2^12 | 16,8 | 22,1 | 1,17 | 1,07 | 41,2 | 9,1 |
| 2^13 × 2^13 | 73,6 | 162 | 5,17 | 4,81 | 245 | 8,8 |
| 2^14 × 2^14 | 352 | 1300 | 24,0 | 21,0 | 1710 | 8,3 |
\(2^{14}\times2^{14}\) kare matris durumunda Mod-PP-MM bölümü 1300 saniye ile toplam sürenin büyük bölümünü oluştururken transpozisyon toplam 352 saniyedir. Relinearization ve rescaling birlikte toplam sürenin küçük bir bölümünü oluşturmaktadır. Bu sonuç, C-MT'nin teorik olarak daha düşük karmaşıklığa sahip olsa da incelenen pratik boyutlarda henüz tamamen ihmal edilemediğini göstermektedir.
Algorithm 9: RGSW tabanlı genel yaklaşım
| Boyut d1 × d2 × d3 | Halka derecesi | Mod-PP-MM süresi (s) | En kötü hassasiyet (bit) |
|---|---|---|---|
| 212 × 212 × 1 | 212 | 0,882 | 17,5 |
| 212 × 212 × 26 | 212 | 1,44 | 17,4 |
| 212 × 212 × 212 | 212 | 42,6 | 17,4 |
| 213 × 213 × 1 | 213 | 4,35 | 17,2 |
| 213 × 213 × 26 | 213 | 6,47 | 17,3 |
| 213 × 213 × 213 | 213 | 291 | 17,3 |
| 214 × 214 × 1 | 213 | 10,5 | 17,4 |
| 214 × 214 × 27 | 213 | 19,0 | 17,4 |
| 214 × 214 × 214 | 213 | 1270 | 17,4 |
Algorithm 9'un ilk altı satırı RLWE, son üç satırı structured-S shared-a formatını kullanmaktadır. RGSW yaklaşımı daha fazla genel amaçlı esneklik sağlarken matrisin RGSW biçiminde hazırlanması ön hesaplama gerektirebilir.
Algorithm 8 ve Algorithm 9 karşılaştırıldığında ne görülüyor?
Kare \(2^{14}\) matris deneyinde Algorithm 8'in Mod-PP-MM bölümü yaklaşık 1300 saniye, Algorithm 9'un karşılık gelen bölümü yaklaşık 1270 saniyedir. Araştırmacılar bunun shared-a sayesinde Algorithm 9'un farklı boyutlarda BLAS çağrılarına ayrılmasından kaynaklandığını açıklamaktadır.
Ancak Algorithm 9'un daha genel olması ücretsiz değildir. RGSW biçiminin hazırlanması ve format dönüşümleri özellikle matris-vektör gibi küçük çıktı boyutlarında önemli veya baskın maliyet olabilir. Bu nedenle algoritmalar doğrudan tek bir “kazanan” sıralamasına indirgenmemelidir.
Küçük çıktı boyutlarında neden beklenen doğrusal hız artışı görülmüyor?
Teorik olarak \(d_3\) küçüldüğünde matris çarpımı maliyetinin de yaklaşık olarak buna uygun düşmesi beklenebilir. Deneylerde ise küçük \(d_3\) değerlerinde süre aynı oranda azalmamaktadır.
Araştırmacılar bunun önemli bölümünü Mod-PP-MM verisini fp-PP-MM formatına dönüştürme, int64 matrisleri float64 yapısına taşıma ve diğer temel ön işlemlerin sabit maliyetleriyle açıklamaktadır. Çalışma ayrıca BLAS uygulamalarının onlarca yıldır optimize edildiğini, kendi indirgeme kodlarının ise yeni prototip kod olduğunu açıkça belirtmektedir.
4–12 kat iddiası nasıl okunmalıdır?
Makalenin özetindeki temel performans mesajı, belirli büyük kare matris durumlarında CKKS tabanlı şifreli matris çarpımı ile çift duyarlıklı floating-point matris çarpımı arasındaki verim farkının yaklaşık 4–12 kat düzeyine indirilebilmesidir.
Bu ifade homomorfik şifrelemenin genel olarak plaintext hesaplamadan yalnız 4–12 kat yavaş olduğu anlamına gelmez. Format dönüşümleri, precomputation, C-MT, RGSW hazırlığı, key-switching, bootstrapping veya daha büyük FHE hesaplama zincirlerinin maliyeti uygulamaya göre değişebilir. Çalışmanın kendi deney tabloları da bu ek maliyetlerin bazı durumlarda önemli olduğunu göstermektedir.
Çalışmanın güçlü yönleri
- Teorik algoritma ile gerçek HEaaN/OpenBLAS uygulamasını aynı çalışmada birleştiriyor.
- Tek bir matris boyutuna bağlı kalmadan büyük, eşit ve küçük halka boyutu durumları için farklı şifreleme formatları geliştiriyor.
- Şifreli hesaplamayı BLAS gibi olgun hesaplama altyapısına bağlayan genel bir tasarım ilkesi ortaya koyuyor.
- Hata analizi ve hesaplama karmaşıklığını birlikte ele alıyor.
- Şifreli transpozisyon için ayrıca kullanılabilecek quasi-quadratic bir algoritma sunuyor.
- Evaluation-key boyutu sorununu lightweight C-MT ile ayrıca ele alıyor.
- Deneylerde güvenlik, hassasiyet ve süreyi birlikte raporluyor.
Çalışmanın temel sınırlılıkları
- Ana deneylerin tamamı tek iş parçacıklı Intel Xeon CPU üzerinde gerçekleştirilmiştir.
- BLAS'ın GPU paralelliğinden yararlanılabileceği belirtilmesine rağmen GPU zamanlaması verilmemiştir.
- Test matrislerinin elemanları gerçek uygulama verisinden değil [−1,1] aralığında bağımsız uniform dağılımdan üretilmiştir.
- Çalışma uçtan uca transformer veya LLM inference benchmark'ı değildir.
- Format dönüşümü bazı Mv ve küçük \(d_3\) problemlerinde ana hesaplama kadar önemli hâle gelebilmektedir.
- Ön hesaplamalı yöntemlerin avantajı yalnız aynı plaintext matrisinin tekrar tekrar kullanıldığı senaryolarda amorti edilebilir.
- Algorithm 8'in en verimli biçimi büyük kare matrisler ve uygun halka dereceleri için tasarlanmıştır.
- Algorithm 9 daha esnek olmakla birlikte RGSW biçimi için ek hazırlık veya ön hesaplama gerektirebilir.
- Deneysel hassasiyet algoritmalar arasında farklıdır ve kullanılan modül/ölçek parametrelerinden etkilenmektedir.
- Araştırmacılar kendi indirgeme uygulamalarının BLAS kadar optimize olmadığını açıkça kabul etmektedir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Fast Homomorphic Linear Algebra with BLAS
Yazarlar: Youngjin Bae, Jung Hee Cheon, Guillaume Hanrot, Jai Hyun Park ve Damien Stehlé.
Sorumlu yazar: Jai Hyun Park.
Eş katkı/eş birinci yazarlık: Yüklenen sürümde eş katkı veya eş birinci yazarlık beyanı bulunmamaktadır.
Kurumlar:
- CryptoLab Inc., Seoul, Republic of Korea.
- Seoul National University, Seoul, Republic of Korea.
- CryptoLab Inc., Lyon, France.
Resmî dergi: Journal of Cryptology.
Yayınevi: Springer Nature.
Bibliyografik bilgi: Journal of Cryptology, 2026, cilt 39, makale 25. Makale Volume 39, Issue 3 kapsamında listelenmektedir.
DOI:10.1007/s00145-026-09580-x
Resmî yayın tarihi: 12 Mayıs 2026.
Resmî yayın süreci: Springer kaydında çalışma 20 Mart 2025'te alınmış, 19 Mart 2026'da revize edilmiş, 25 Mart 2026'da kabul edilmiş ve 12 Mayıs 2026'da yayımlanmıştır.
Yüklenen sürüm: arXiv:2503.16080v2 [cs.CR], 27 Nisan 2026. Yüklenen dosyanın ilk sayfası bunun 19 Mart 2026'da IACR ve Springer-Verlag'a sunulan final yazar sürümü olduğunu ve resmî Springer sürümünün yukarıdaki DOI ile yayımlandığını belirtmektedir.
Kaynak türü ve hakemlik durumu: Yüklenen dosya arXiv üzerinde bulunan yazar sürümüdür; ancak çalışma resmî olarak Journal of Cryptology'de yayımlanmış araştırma makalesidir. Bu nedenle çalışma güncel bibliyografik durumu bakımından yalnız hakemlenmemiş bir preprint olarak değerlendirilmemelidir.
Önceki yayınlarla ilişki: Çalışma, aynı yazarların CRYPTO 2024'te yayımlanan plaintext–ciphertext matrix multiplication çalışması ile Jai Hyun Park'ın EUROCRYPT 2025'te yayımlanan ciphertext–ciphertext matrix multiplication çalışmasını genişletmekte ve bunları daha genel bir homomorfik doğrusal cebir çerçevesinde bir araya getirmektedir.
Lisans/telif: Yüklenen sürümde CC BY gibi açık bir yeniden kullanım lisansı belirtilmemektedir. Resmî Springer kayıtlarında yayın haklarının Springer Nature veya ilgili hak sahibine ait olduğu belirtilmektedir. Bu nedenle bu Verianla içeriğinde özgün yayın figürleri birebir kopyalanmamış; bilimsel yöntem ve tabloların mesajı metin ve kaynak veriye dayalı Verianla Live yapısıyla yeniden açıklanmıştır.
Finansman: Yüklenen sürümde ayrı bir finansman beyanı tespit edilmemiştir.
Veri erişilebilirliği: Yüklenen sürümde ayrı bir Data Availability Statement tespit edilmemiştir.
Çıkar çatışması: Yüklenen sürümde ayrı bir Conflict of Interest beyanı tespit edilmemiştir.
Yazar katkıları: Yüklenen sürümde CRediT biçiminde ayrı bir yazar katkı tablosu bulunmamaktadır.
Uygulama: Araştırmacılar Algorithm 2, Algorithm 4, Algorithm 6, Algorithm 8 ve Algorithm 9'un ilgili bölümlerini HEaaN üzerinde uygulamış; plaintext doğrusal cebir işlemleri için OpenBLAS 0.3.26 kullanmıştır.
Deney sınırı: Ana zamanlama deneyleri Intel Xeon Gold 6342 2,80 GHz işlemci üzerinde tek iş parçacığıyla yürütülmüş ve her süre 10 çalıştırmanın ortalaması olarak raporlanmıştır. GPU üzerinde deneysel performans ölçümü verilmemiştir.
Güvenlik sınırı: Araştırmacılar deney parametrelerinin lattice estimator'a göre yaklaşık 128 bit güvenliği desteklediğini belirtmektedir. Bu ifade kullanılan parametre setlerine aittir; farklı CKKS parametreleri ayrıca değerlendirilmelidir.
Hassasiyet sınırı: CKKS yaklaşık homomorfik şifreleme kullandığı için sonuçlar exact arithmetic olarak değerlendirilmemelidir. Çalışmada algoritmaya ve parametrelere bağlı olarak farklı bit hassasiyetleri raporlanmıştır.
Performans sınırı: Çalışmanın özetindeki yaklaşık 4–12 katlık performans farkı, araştırmacıların belirli büyük kare matris ve BLAS indirgeme koşullarına ilişkin sonucudur. Bütün homomorfik programların, format dönüşümlerinin, bootstrapping adımlarının veya uçtan uca yapay zekâ modellerinin plaintext hesaplamaya göre yalnız 4–12 kat yavaş olduğu sonucuna genişletilemez.
Bilimsel içerik sınırı: Bu Verianla makalesindeki teknik bulgular, algoritmalar, süreler, hassasiyet değerleri ve uygulama yorumları incelenen çalışmaya dayanmaktadır. Dış kaynak yalnız yayımlanmış sürümün DOI, dergi, yayın tarihi ve bibliyografik durumunu doğrulamak amacıyla kullanılmıştır; dışarıdan yeni deneysel veya kriptografik bulgu eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir