

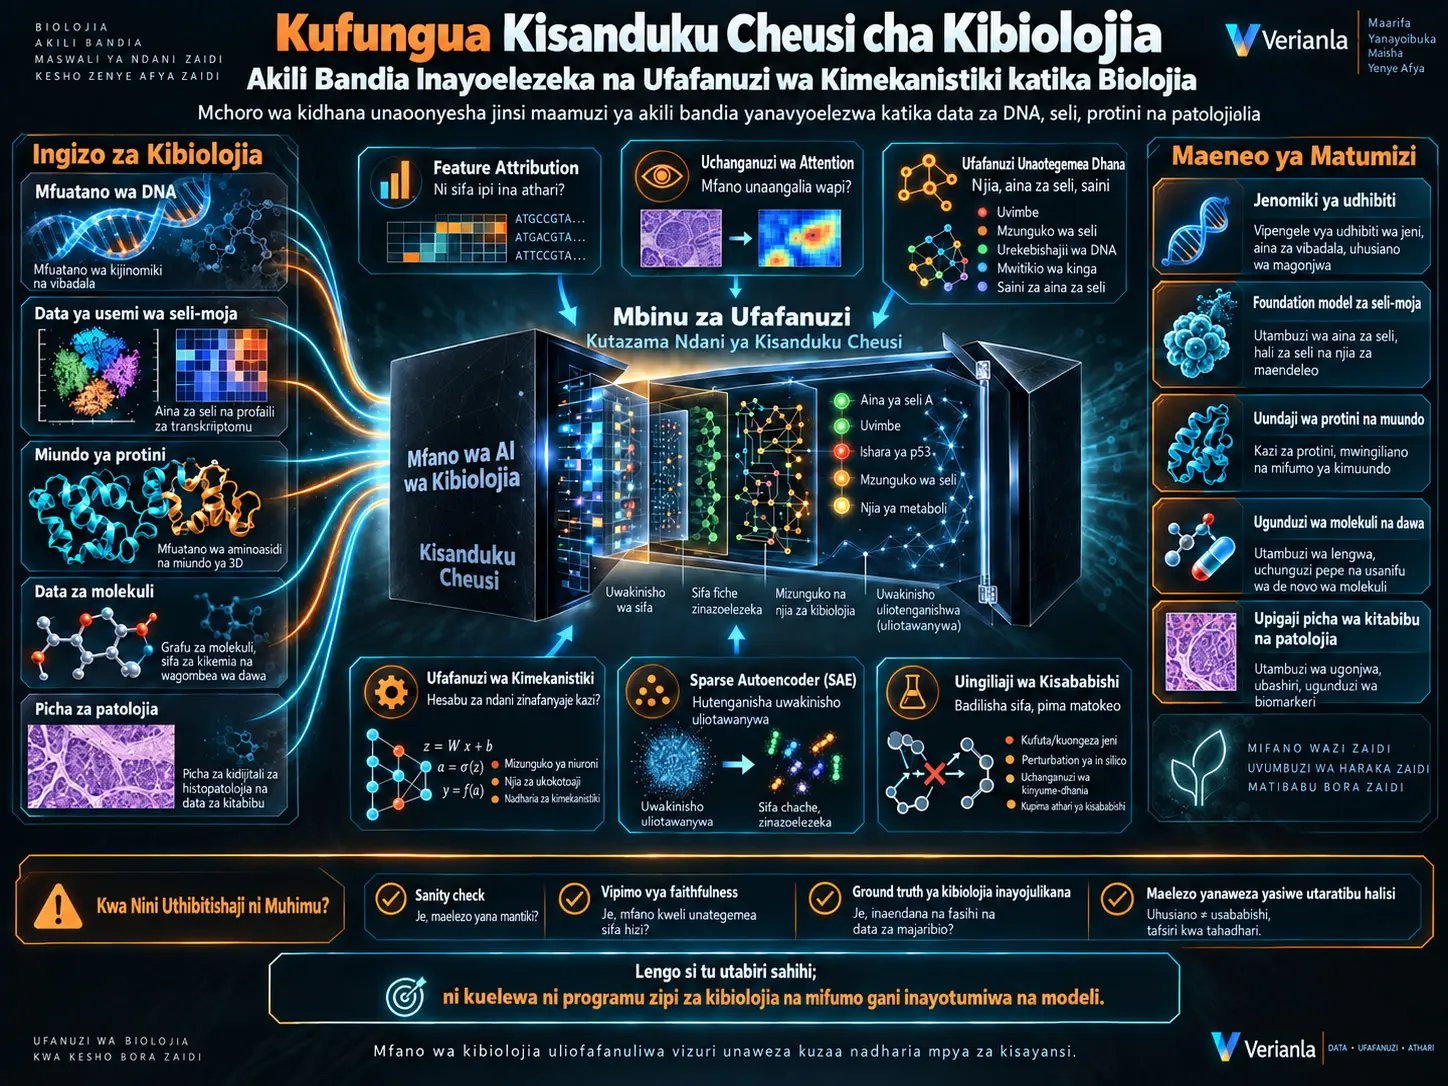
Akili bandia inayoelezeka (Explainable Artificial Intelligence, XAI) ni mkusanyiko wa mbinu zinazolenga kufanya iwezekane kwa binadamu kuchunguza ni pembejeo, dhana au hesabu za ndani zipi zinazotegemewa na utabiri au maamuzi ya modeli ya akili bandia. Utafiti wa mapitio wa Olivia Denvis unaainisha mbinu za maelezo zinazotumiwa katika biolojia kwa mihimili ya feature attribution, uchanganuzi wa attention, concept-based explanation na mechanistic interpretability; huku matumizi yakigawanywa katika genomiki, foundation model za seli moja, uundaji wa modeli za protini, ugunduzi wa dawa na upigaji picha wa kibayomedikali. Msisitizo mkuu wa survey ni kwamba utafiti wa akili bandia katika biolojia unasonga kutoka modeli zinazotoa tu utabiri sahihi kuelekea mbinu zinazochunguza ni programu zipi za kibayolojia na taratibu zipi za kihesabu hujitokeza ndani ya modeli.
Katika mabadiliko haya, sparse autoencoder (SAE) zimepata umuhimu maalumu. SAE hulenga kutenganisha uwakilishi wa ndani uliochanganyika katika mitandao mikubwa ya neva bandia kuwa sifa chache zinazowashwa na zinazoweza kufasiriwa. Survey inaangazia kwamba kuhamishwa kwa mbinu hii kutoka modeli za lugha kwenda foundation model za kibayolojia kumeanzisha mkondo mpya wa utafiti unaolenga kutenganisha dhana za kibayolojia kama aina ya seli, programu ya jeni au muundo wa histolojia kutoka ndani ya embedding zilizosambazwa.
Utafiti pia unatoa onyo muhimu: maelezo kuonekana ya kushawishi kwa macho hakumaanishi kwamba yanawakilisha kwa kweli utaratibu wa maamuzi wa modeli. Ramani za attention, saliency map au thamani za feature attribution zinaweza kupotosha kwa sababu ya mifumo isiyotegemea modeli, jiometri ya pembejeo yenyewe au uhusiano wa takwimu. Kwa hiyo, lengo la XAI ya kibayolojia si kutoa maelezo tu, bali kuthibitisha kwamba maelezo yanahusiana kweli na tabia ya modeli kwa kutumia faithfulness test, sanity check na, inapowezekana, majaribio ya uingiliaji.
Kwa nini kuwa kwa akili bandia kama kisanduku cheusi ni tatizo maalumu katika biolojia?
Katika matumizi mengi ya kihandisi, lengo la modeli linaweza kuwa kutoa uamuzi sahihi. Lakini katika biolojia, modeli mara nyingi ni chombo cha moja kwa moja cha uelewa wa kisayansi. Mwanabiolojia hataki kujua tu kwamba mfuatano fulani wa DNA ni wa udhibiti; anataka pia kujua ni nukleotidi zipi zina athari, ni motif ipi inaongoza ufungamanaji wa transcription factor, na kupitia utaratibu upi usemi wa jeni hubadilika.
Hali hiyo hiyo inatumika kwa protini, seli na molekuli. Modeli ya protini inaweza kutabiri muundo sahihi; lakini ni mahusiano yapi ya aminoasidi yaliyoifikisha modeli kwenye muundo huo ni swali tofauti la kisayansi. Modeli ya seli moja inaweza kuainisha aina ya seli kwa usahihi; lakini ikiwa haijulikani kama uamuzi unategemea kweli programu ya jeni ya kibayolojia au athari ya kiufundi ya batch, modeli inaweza kupotosha kisayansi.
Kwa hiyo survey inasisitiza kwamba uelezekaji katika biolojia si suala la kuaminika au uzoefu wa mtumiaji tu, bali unahusiana moja kwa moja na uundaji wa nadharia tete za kisayansi.
Akili Bandia Inayoelezeka Katika Biolojia Inajaribu Kufanya Nini?
XAI ya kibayolojia hulenga kubadilisha utabiri kuwa maelezo yenye maana ya kibayolojia kwa kubaini ni pembejeo zipi za kibayolojia, dhana zipi zinazowakilishwa au michakato ipi ya ndani ya kihesabu inayohusiana na matokeo ya modeli; hata hivyo, ili maelezo hayo yawe na thamani ya kisayansi, lazima pia ithibitishwe kwamba ni faithful kwa tabia halisi ya modeli.
Maelezo ya intrinsic na post-hoc
Survey hutenganisha mbinu mbili kuu. Intrinsic interpretability ni hali ambapo muundo wenyewe wa modeli unaeleweka. Modeli za mstari zenye sparsity, orodha fupi za maamuzi au usanifu wenye latent variable zilizopewa maana ya kibayolojia zinaweza kuwa mifano.
Post-hoc explanation hutumia mbinu za ziada kueleza tabia ya modeli changamano ambayo haiwezi kusomwa moja kwa moja baada ya modeli kufundishwa. Mbinu kama SHAP, Integrated Gradients au Grad-CAM ziko katika kundi hili.
Mbinu ya post-hoc huwezesha uchunguzi wa modeli zenye nguvu; lakini maelezo si modeli yenyewe, bali ni kitu kinachohesabiwa baadaye kuhusu modeli. Kwa hiyo, ni lazima ipimwe kando ikiwa maelezo ni mwaminifu kwa mantiki halisi ya maamuzi ya modeli.
Maelezo ya local na global
local explanation hulenga matokeo moja tu ya modeli. Kwa mfano, hujaribu kueleza kwa nini mfuatano fulani wa DNA uliainishwa kama enhancer au kwa nini seli fulani ilitambuliwa kama T cell.
Global explanation huchunguza tabia ya jumla ya modeli. Kwa mfano, inaweza kuchunguzwa ni motif zipi modeli hutumia mara kwa mara katika genomu au ni mahusiano yapi ya kimuundo ambayo attention head fulani huwakilisha kwa ujumla ndani ya modeli ya protini.
Feature attribution
Mbinu za feature-attribution hujaribu kupima ni sifa zipi za pembejeo zinazohusiana na mabadiliko katika matokeo ya modeli. Kwa biolojia, mbinu hii ni ya asili hasa kwa sababu sifa za pembejeo mara nyingi zenyewe ni vitengo vya kimwili au kibayolojia:
- nukleotidi katika modeli ya DNA,
- jeni katika modeli ya seli moja,
- masalia ya aminoasidi katika modeli ya protini,
- atomi au bondi katika modeli ya molekuli,
- pikseli au eneo la picha katika modeli ya histopatolojia.
Mbinu kuu za feature-attribution zinazojadiliwa na survey ni LIME, SHAP, Integrated Gradients, DeepLIFT, Layer-wise Relevance Propagation na Grad-CAM.
| Familia ya mbinu | Swali kuu | Matokeo ya kawaida | Namna ya matumizi ya kibayolojia |
|---|---|---|---|
| LIME | Ni sifa zipi zinaathiri utabiri huu mmoja katika mazingira yake? | Modeli ya surrogate ya eneo husika | Michango ya sifa katika sampuli maalumu |
| SHAP | Mchango wa pembeni wa kila sifa kwa utabiri ni upi? | Thamani za umuhimu zinazotegemea Shapley | Attribution ya jeni, sifa ya kliniki au sifa ya molekuli |
| Integrated Gradients | Ni sifa zipi huchangia kwenye gradient kutoka pembejeo hadi matokeo? | Attribution kwa kila pembejeo | Ramani ya umuhimu wa nukleotidi, aminoasidi au pikseli ya picha |
| DeepLIFT | Aktivasheni hubadilikaje ikilinganishwa na rejea? | Alama za mchango | Hasa uchanganuzi wa motif za genomiki |
| Grad-CAM | Ni maeneo yapi ya picha yanaunga mkono alama ya darasa? | Ramani ya joto | Histopatolojia na upigaji picha wa kimatibabu |
| TCAV | Je, modeli ni nyeti kwa dhana iliyofafanuliwa na binadamu? | Mwelekeo wa concept activation | Uchanganuzi wa pathway, aina ya seli au saini ya kibayolojia |
| Sparse Autoencoder | Uwakilishi wa ndani uliosambazwa unaweza kugawanywa katika sifa zipi chache? | Sifa latent zinazoweza kufasiriwa | Kutenganisha programu za aina ya seli au tishu ndani ya foundation model |
Kwa Nini Uzito wa Attention Pekee Hauchukuliwi Kama Maelezo?
Uzito wa attention unaweza kuonyesha ni njia zipi za taarifa kati ya token fulani ambazo modeli imezipa uzito, lakini kwa kuwa matokeo yale yale ya modeli yanaweza kuzalishwa na usambazaji tofauti wa attention, thamani kubwa ya attention pekee si maelezo ya kisababishi au faithful; kwa hiyo katika biolojia ramani za attention zinapaswa kuchukuliwa kama nadharia tete zinazohitaji kuthibitishwa.
Tofauti hii ni muhimu hasa kwa modeli za protini. Wakati token katika mfuatano wa protini zinawakilisha aminoasidi, attention head kutoa uzito mkubwa kwa masalia fulani kunaweza kuonekana kuvutia kibayolojia. Hata hivyo, inaweza kuonyeshwa kuwa kweli inamaanisha kiolesura cha ufungamanaji, eneo la mgusano au motif ya kiutendaji kwa kulinganisha tu na taarifa huru ya kimuundo.
Survey inatoa mfano wa tafiti za modeli za lugha za protini ambako uhusiano wa attention head fulani na migusano ya kimuundo, maeneo ya ufungamanaji na maeneo ya post-translational modification umechunguzwa kwa kulinganisha kwa kiasi. Somo kuu la kimetodolojia ni kwamba taswira ya attention inapaswa kuwa mwanzo, si hitimisho.
Maelezo yanayotegemea dhana
Attribution katika kiwango cha nukleotidi moja au jeni moja inaweza kuwa chini ya kiwango cha dhana anachofikiria mwanabiolojia. Mara nyingi mtafiti huuliza badala ya “jeni gani?”, “pathway gani?”, “programu gani ya seli?” au “mchakato gani wa kibayolojia?”
Mbinu za concept-based hulenga kuchunguza uhusiano kati ya aktivasheni za modeli na dhana za kiwango cha juu zilizofafanuliwa na binadamu. Testing with Concept Activation Vectors (TCAV), inayojadiliwa na survey, hujifunza mwelekeo katika nafasi ya aktivasheni kwa dhana fulani na kupima unyeti wa utabiri wa modeli kwa mwelekeo huo.
Biolojia hutoa mazingira tajiri kwa mbinu hii kwa sababu gene set, saini za aina za seli, pathway za molekuli na ontolojia za kiutendaji huunda kamusi za dhana zilizofafanuliwa mapema na binadamu.
Mechanistic Interpretability Inatofautianaje na Feature Attribution?
Wakati feature attribution huuliza ni pembejeo zipi zinazohusiana na utabiri, mechanistic interpretability hujaribu kufumbua ni sifa zipi zinazowakilishwa katika aktivasheni na uzito wa ndani wa modeli, sifa hizo zinaunganishwaje kupitia miunganisho gani, na ni circuit zipi za kihesabu zinazofanya kazi ili kuunda matokeo fulani.
Kwa hiyo mechanistic interpretability huifanya miundo ya ndani ya modeli kuwa kitu cha reverse engineering badala ya kuihoji modeli kutoka nje. Lengo si kusema tu “jeni hili ni muhimu”, bali kubaini modeli imesimba programu fulani ya seli katika latent representation gani na representation hiyo inaathiri hesabu gani katika tabaka za baadaye.
Tatizo la superposition
Katika mitandao ya kisasa ya neva, dhana kwamba neuroni moja huwakilisha sifa moja tu yenye maana kwa binadamu mara nyingi si sahihi. Mtandao unaweza kusimba sifa nyingi zaidi kuliko idadi ya neuroni zake halisi katika mielekeo inayopishana. Survey inaeleza hali hii kwa dhana ya superposition.
Kwa hiyo neuroni moja inaweza kuhusishwa na dhana kadhaa na tafsiri za moja kwa moja kama “neuroni hii inawakilisha T cell” zinaweza kupotosha.
Sparse Autoencoder Hutoa Nini Katika Foundation Model za Kibayolojia?
Sparse autoencoder hujaribu kutenganisha aktivasheni za modeli zilizojaa na zinazopishana kuwa kamusi pana zaidi ya sifa zinazowashwa kwa uchache, hivyo kurahisisha kulinganisha sifa latent moja moja na dhana za kibayolojia kama aina fulani za seli, programu za jeni au miundo ya histolojia.
Katika mbinu ya SAE, aktivasheni fulani za tabaka za kati huchanganuliwa badala ya parameter za modeli yenyewe. Autoencoder hujifunza kuunda upya aktivasheni hizi kupitia feature dictionary yenye vipimo vingi zaidi; kizuizi cha sparsity huhimiza sifa chache tu kuwashwa kwa nguvu katika sampuli moja.
Maendeleo yanayosisitizwa sana na survey ni kuhamishwa kwa mbinu hii kutoka interpretability ya modeli kubwa za lugha kwenda foundation model za kibayolojia. Chanzo kinajadili tafiti zilizoripoti sifa sparse zinazoweza kuhusishwa na miundo ya histolojia katika foundation model za patholojia na programu za aina ya seli katika uwakilishi wa foundation model za seli moja.
Umuhimu wake wa kisayansi si kutoa majina tu kwa sifa latent. Ikiwa matokeo ya modeli yanaweza kubadilishwa kwa utaratibu kwa kuwasha au kukandamiza sifa fulani ya SAE, maelezo husogea kutoka kiwango cha korelasyon kuelekea kiwango cha uingiliaji.
Genomiki ya udhibiti
Genomiki ni mojawapo ya maeneo ambayo XAI ilianza kutumiwa mapema katika biolojia. Wakati mfuatano wa DNA ni pembejeo ya moja kwa moja ya modeli, inawezekana kuhesabu attribution kwa kila nukleotidi au motif.
Survey inajadili familia za modeli kama DeepBind, DeepSEA, Basset, ExPecto, BPNet na Enformer ndani ya mkondo huu wa maendeleo. Hasa, kuunganisha modeli za base-resolution na DeepLIFT pamoja na mbinu za ugunduzi wa motif kumewezesha si tu kupata tena motif zinazojulikana bali pia kuunda nadharia tete kuhusu jinsi motif zinavyopangwa pamoja.
Foundation model za seli moja
Modeli kama Geneformer, scGPT, scFoundation na Universal Cell Embeddings huunda uwakilishi uliosambazwa uliotokana na mamilioni ya seli. Embedding hizi zinaweza kutumiwa katika kazi za downstream kama uainishaji wa aina ya seli na perturbation prediction; hata hivyo, mara nyingi haijulikani moja kwa moja kipimo fulani cha embedding kinawakilisha nini kibayolojia.
Kwa mujibu wa survey, eneo hili ni mojawapo ya mifano iliyo wazi zaidi ya kuhamisha mechanistic interpretability kwenda biolojia. Kulinganisha sifa latent na aina za seli na programu za gene-set kupitia sparse dictionary learning huleta uwakilishi wa ndani wa foundation model karibu na kamusi ya dhana inayotumiwa na wanabiolojia.
Hata hivyo, korelasyon kati ya sifa na gene-set pekee si hitimisho la kimekanistiki. Survey inasisitiza hasa kupima kama tabia ya modeli hubadilika baada ya kuingilia sifa fulani latent kama kiwango cha ushahidi chenye nguvu zaidi.
Modeli za protini
Modeli za lugha za protini zinaweza kujifunza uwakilishi wa kimuundo na kiutendaji kutoka mamia ya mamilioni ya mifuatano ya protini. Token za protini kulingana moja kwa moja na masalia ya aminoasidi hutoa faida maalumu kwa interpretability.
Inawezekana kulinganisha moja kwa moja kama attention head zinaendana na sehemu za mgusano, maeneo ya ufungamanaji au maeneo ya post-translational modification kwa kutumia annotation za kimuundo. Sifa hii hufanya modeli za protini kuwa shabaha yenye nguvu kwa mechanistic interpretability na mbinu za sparse dictionary.
Ugunduzi wa molekuli na dawa
Graph neural network huchakata molekuli kama grafu zinazoundwa na atomi na bondi. Kueleza shughuli ya molekuli mara nyingi humaanisha kubaini ni subgraph au kundi gani la kikemia linalochangia utabiri.
Survey inaeleza kuwa mbinu kama GNNExplainer hujaribu kupata subgraph ndogo ya molekuli inayohifadhi utabiri kwa kadiri iwezekanavyo. Hivyo maelezo yanaweza kutoka kuwa alama tu ya umuhimu na kuwa motif ya molekuli ambayo mwanakemia anaweza kuchunguza.
Upigaji picha wa kliniki na patholojia ya kidijitali
Katika histopatolojia na picha nyingine za kibayomedikali, Grad-CAM na mbinu zinazotegemea saliency hutumiwa sana kuonyesha maeneo ya picha yanayoathiri uamuzi wa uainishaji.
Lakini eneo hili pia linaonyesha wazi hatari kubwa zaidi ya XAI: kiainishaji cha uvimbe kinaweza kutumia artefact ya skana, alama ya hospitali au itifaki ya upigaji picha badala ya sifa halisi ya histolojia. Maelezo ya kuona yanaweza kusaidia kugundua shortcut kama hizi; lakini mbinu ya maelezo iliyoundwa vibaya inaweza pia kuonyesha artefact hiyo hiyo kama ishara ya kibayolojia.
Mbinu na Matokeo ya Utafiti
Utafiti huu umetumia aina gani ya mbinu?
Utafiti huu hauendelezi modeli mpya ya majaribio. Mwandishi anaunganisha fasihi iliyopo ya XAI na mechanistic interpretability chini ya taksonomia ya dhana. Survey hutumia mihimili miwili huru:
- Mhimili wa mbinu: feature attribution, attention analysis, concept-based explanation na mechanistic interpretability.
- Mhimili wa matumizi: genomiki, seli moja/foundation model, protini, ugunduzi wa molekuli na dawa, upigaji picha wa kliniki na patholojia.
| Eneo | Pembejeo / uwakilishi wa modeli | Swali la kawaida la interpretability | Uwezekano wa uthibitishaji |
|---|---|---|---|
| Genomiki ya udhibiti | Mfuatano wa DNA | Ni nukleotidi au motif ipi inayoathiri matokeo? | Motif zinazojulikana, ufungamanaji na majaribio ya udhibiti |
| Biolojia ya seli moja | Usemi wa jeni / embedding ya seli | Ni programu gani ya jeni au hali gani ya seli inayowakilishwa? | Gene-set, annotation ya aina ya seli na perturbation |
| Modeli za protini | Mfuatano wa aminoasidi / internal representation | Modeli inasimba uhusiano gani wa kimuundo au kiutendaji? | Miundo ya protini, maeneo ya mgusano na ufungamanaji |
| Ugunduzi wa molekuli na dawa | Grafu ya atomi-bondi | Ni muundo mdogo upi unaoongoza utabiri wa shughuli? | Majaribio ya kikemia na uhusiano wa muundo-shughuli |
| Patholojia ya kidijitali | Picha | Modeli inategemea maeneo yapi ya tishu? | Annotation ya patholojia na uthibitishaji wa kliniki |
tunajuaje kama maelezo ni sahihi?
Moja ya ujumbe wenye nguvu zaidi wa kimetodolojia wa survey ni kwamba maelezo lazima yatathminiwe kando. Utabiri wa modeli unaweza kuwa sahihi lakini maelezo yake yakawa mabaya.
Chanzo kinaangazia mbinu tatu kuu za uthibitishaji:
- Sanity check: Je, maelezo hubadilika pia wakati uzito wa modeli au lebo zinapowekwa bila mpangilio?
- Faithfulness test: Je, matokeo ya modeli huathirika kweli wakati sifa inayodaiwa kuwa muhimu inaondolewa au kubadilishwa?
- Ulinganisho na biological ground truth: Je, attribution au sifa ya modeli inaendana na motif inayojulikana, eneo la ufungamanaji, pathway au annotation ya aina ya seli?
Lengo la ukaguzi huu si kufanya maelezo yaonekane yenye maana kwa macho ya binadamu, bali kupima uhusiano wake na hesabu halisi ya modeli.
Kwa Nini Uingiliaji wa Kisababishi ni Jaribio Lenye Nguvu Zaidi la Maelezo?
Uingiliaji wa kisababishi una nguvu zaidi kuliko kuonyesha korelasyon pekee kwa sababu hupima mabadiliko ya matokeo wakati sifa latent au circuit fulani ndani ya modeli inapunguzwa au kuimarishwa kwa udhibiti; mbinu hii hutumia mantiki ya perturbation experiment ya biolojia kwenye uwakilishi wa ndani wa mtandao wa neva bandia.
Ikiwa latent feature ina korelasyon na aina fulani ya seli, hilo pekee halithibitishi kwamba feature hiyo ni muhimu kwa uamuzi wa modeli. Ikiwa uainishaji wa seli au tabia nyingine ya downstream hubadilika kwa utaratibu baada ya kuzima sifa hiyo, ushahidi wenye nguvu zaidi wa uhusiano wa kimekanistiki hupatikana.
Survey inaona kiwango hiki cha interventionist kuwa kinapatana sana na utamaduni wa majaribio wa biolojia.
Tatizo wazi: biological ground truth haijakamilika
Moja ya paradoksi kuu za XAI katika biolojia ni hii: tunahitaji uhalisia wa kibayolojia ili kuangalia kama maelezo ni sahihi; lakini utaratibu wenyewe unaochunguzwa mara nyingi bado haujulikani kikamilifu.
Modeli ya genomu inapoonyesha eneo lisilojulikana kuwa muhimu, maelezo mawili yanawezekana:
- modeli imegundua kweli kipengele kipya cha udhibiti wa kibayolojia;
- modeli inategemea artefact katika seti ya data.
Haiwezekani kutenganisha uwezekano huu wawili kwa kuangalia attribution map pekee. Jaribio jipya la kibayolojia au uthibitishaji huru unaweza kuhitajika.
Tatizo wazi: kiwango cha foundation model
Foundation model za kibayolojia zinapokua, haiwezekani kwa binadamu kuchanganua kila neuroni au circuit moja baada ya nyingine. Sparse dictionary learning inaahidi kugeuza sehemu ya tatizo hili kuwa otomatiki; hata hivyo, survey inasisitiza kwamba masuala kama uchaguzi wa dictionary size, kugawanyika kwa dhana moja ya kibayolojia kuwa sparse feature kadhaa, na kuunganishwa kwa sifa katika kiwango cha circuit bado hayajatatuliwa.
Interpretability by design
Mwelekeo mwingine katika ajenda ya utafiti ya chanzo ni kubuni modeli tangu mwanzo kwa miundo latent yenye maana ya kibayolojia badala ya kujaribu kuieleza baada ya kufundishwa.
Kwa mfano, latent variable zikidhibitiwa moja kwa moja na pathway, aina ya seli au kiasi cha kibiofizikia, hitaji la post-hoc explanation linaweza kupungua. Hata hivyo, athari yake kwa usahihi wa modeli na uwezo wa kujumlisha lazima ichunguzwe kando.
Matokeo yanayoungwa mkono na utafiti
Survey inaunga mkono: Fasihi ya XAI ya kibayolojia inapanuka kutoka feature attribution rahisi kuelekea uchanganuzi wa dhana na wa kimekanistiki wa kiwango cha juu. Kuanza kutumiwa kwa mbinu kama sparse autoencoder na circuit analysis kwenye foundation model za kibayolojia kunafungua fursa mpya za kuunganisha uwakilishi wa ndani wa modeli na dhana za kibayolojia. Hata hivyo, explanation faithfulness lazima ipimwe kwa kujitegemea.
Matokeo ambayo utafiti hauungi mkono
Survey haiungi mkono: Haiwezi kuhitimishwa kwamba kila attention map inawakilisha utaratibu wa kibayolojia, kila saliency map ni ya kuaminika, sparse autoencoder feature zinaendana kiotomatiki na vyombo halisi vya kibayolojia, au mechanistic interpretability katika hali yake ya sasa imetatua kikamilifu foundation model za kibayolojia.
Zaidi ya hayo, survey haigundui taratibu mpya za kibayolojia kupitia majaribio yake mwenyewe wala haitoi upya matokeo ya tafiti zote inazorejelea.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Opening the Biological Black Box: A Survey of Explainable and Mechanistic Interpretability Methods for AI in Biology.
Mwandishi: Olivia Denvis.
Ushirika: Independent Researcher.
Aina ya chanzo: Survey / SSRN preprint.
Tarehe ya utafiti: 15 Juni 2026.
Tarehe ya kuchapishwa SSRN: 23 Juni 2026.
SSRN Abstract ID: 6968318.
DOI: 10.2139/ssrn.6968318.
Hali ya mapitio ya kitaalamu: Chanzo hakikuchapishwa kama makala ya jarida lililopitiwa na wataalamu, bali kama preprint.
Leseni ya uchapishaji / hali ya haki: Rekodi ya SSRN haionyeshi leseni wazi ya Creative Commons ya matumizi tena na inaeleza kwamba matumizi tena ya nyenzo iliyolindwa bila ruhusa hayaruhusiwi. Kwa hiyo maandishi ya Verianla si uchapishaji tena wa maneno ya chanzo; ni usanisi huru wa kielimu wa dhana za kisayansi zilizoripotiwa katika survey ya fasihi.
Jaribio/data mpya: Utafiti hautoi jaribio jipya la kibayolojia, seti mpya ya data au benchmark. Unaainisha na kutathmini tafiti za XAI na mechanistic interpretability katika fasihi.
Kizuizi kikuu cha kimetodolojia: Ushahidi wa majaribio wa matokeo yanayosimuliwa na survey uko katika tafiti za msingi husika. Kwa tathmini ya kina ya utendaji wa mbinu au matumizi fulani, lazima urejee rejea ya asili.
Kizuizi kikuu cha kiepistemiki: Katika biolojia ground truth inaweza kuwa sehemu tu na yenye mjadala. Kwa hiyo, kutolingana kwa maelezo ya modeli na biolojia inayojulikana hakumaanishi kila mara kwamba maelezo ni mabaya; vivyo hivyo, kulingana hakumaanishi moja kwa moja kuwa kuna utaratibu wa kisababishi.
Upeo wa marejeo: Survey inaunganisha fasihi ya XAI ya kawaida, matumizi ya deep learning ya kibayolojia, foundation model, mechanistic interpretability na explanation-validation kupitia tafiti 44.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *