

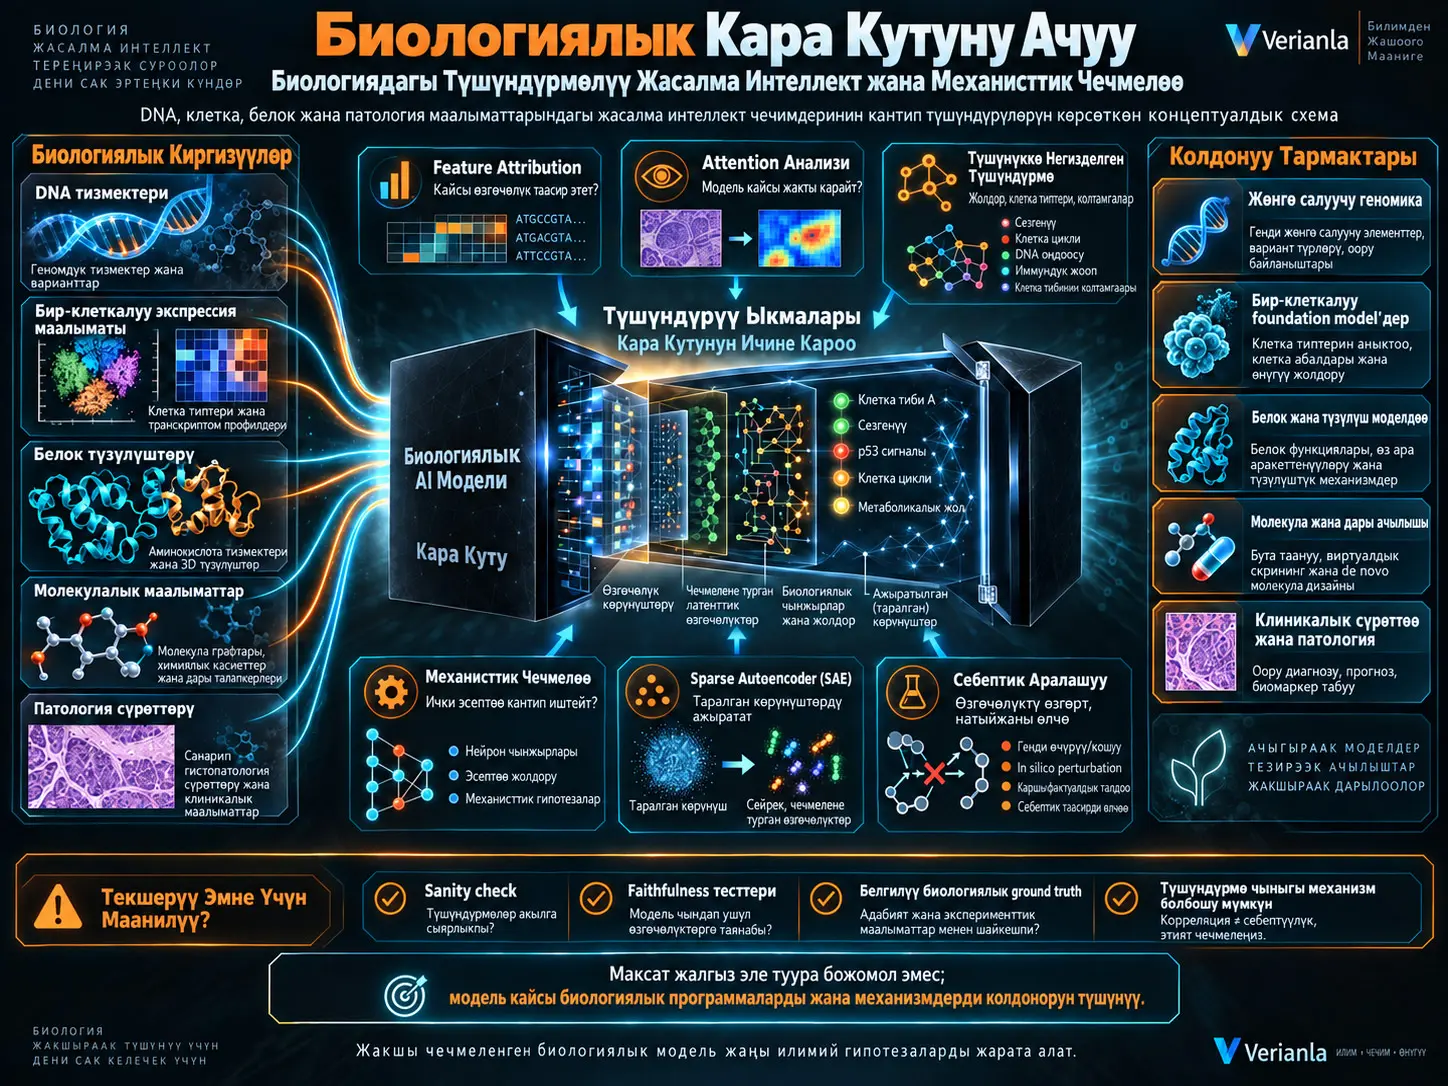
Түшүндүрмөлүү жасалма интеллект (Explainable Artificial Intelligence, XAI) — жасалма интеллект моделинин божомолу же чечими кайсы киргизүүлөргө, түшүнүктөргө же ички эсептөөлөргө таянганын адамдар талдай ала тургандай кылууга аракеттенген ыкмалардын жыйындысы. Olivia Denvisтин survey изилдөөсү биологияда колдонулган түшүндүрүү ыкмаларын feature attribution, attention анализи, concept-based explanation жана mechanistic interpretability багыттары боюнча; колдонмолорду болсо геномика, бир-клеткалуу foundation model'дер, белок моделдөө, дары табуу жана биомедициналык сүрөттөө тармактары боюнча классификациялайт. Surveyнин негизги басымы биологиялык жасалма интеллект изилдөөлөрү жөн гана туура божомол берген моделдерден, моделдин ичинде кайсы биологиялык программалар жана эсептөө механизмдери пайда болгонун изилдеген мамилелерге өтүп жатканында.
Бул өзгөрүүдө sparse autoencoder'лер (SAE) өзгөчө мааниге ээ болду. SAE'лер чоң жасалма нейрон тармактарындагы бири-бирине аралашкан ички өкүлчүлүктөрдү сейрек жана чечмелене турган өзгөчөлүктөргө бөлүүнү көздөйт. Survey бул ыкманын тил моделдеринен биологиялык foundation model'дерге өткөрүлүшү клетка түрү, ген программасы же гистологиялык түзүлүш сыяктуу биологиялык түшүнүктөрдү бөлүштүрүлгөн embedding'дердин ичинен ажыратууга багытталган жаңы изилдөө багытын түзгөнүн белгилейт.
Изилдөө ошол эле учурда маанилүү эскертүү берет: түшүндүрмөнүн визуалдык жактан ынанымдуу болушу анын чынында моделдин чечим механизмин көрсөтөрүн билдирбейт. Attention карталары, saliency map'тер же feature attribution маанилери моделден көз каранды эмес үлгүлөрдөн, киргизүүнүн өз геометриясынан же корреляциялардан улам адаштырышы мүмкүн. Ошондуктан биологиялык XAIнин максаты жөн гана түшүндүрмө берүү эмес, түшүндүрмөнүн моделдин жүрүм-турумуна чындап байланыштуу экенин faithfulness тесттери, sanity check'тер жана мүмкүн болсо кийлигишүү эксперименттери менен текшерүү.
Эмне үчүн биологияда жасалма интеллекттин кара куту болушу өзгөчө көйгөй?
Көптөгөн инженердик колдонмолордо моделдин максаты туура чечим чыгаруу болушу мүмкүн. Ал эми биологияда модель көп учурда түздөн-түз илимий түшүнүүнүн куралы болуп саналат. Биолог бир DNA тизмеги жөнгө салуучу экенин гана билгиси келбейт; кайсы нуклеотиддер таасирдүү экенин, кайсы мотив транскрипция факторунун байланышына багыт берерин жана кайсы механизм аркылуу ген экспрессиясы өзгөрөрүн да билгиси келет.
Ушул эле жагдай белокторго, клеткаларга жана молекулаларга да тиешелүү. Белок модели туура түзүлүштү божомолдой алат; бирок кайсы аминокислота байланыштары моделди ушул түзүлүшкө алып келгени өзүнчө илимий суроо. Бир-клеткалуу модель клетка түрүн туура классификациялай алат; бирок чечим чындап биологиялык ген программасынабы же техникалык batch эффектине таянганы белгисиз болсо, модель илимий жактан адаштырышы мүмкүн.
Survey ошондуктан биологиядагы түшүндүрмөлүүлүк жөн гана ишеним же колдонуучу тажрыйбасы маселеси эмес, түздөн-түз илимий гипотеза түзүү менен байланыштуу экенин жактайт.
Биологияда Түшүндүрмөлүү Жасалма Интеллект Эмнени Көздөйт?
Биологиялык XAI моделдин чыгышы кайсы биологиялык киргизүүлөр, көрсөтүлгөн түшүнүктөр же ички эсептөө процесстери менен байланыштуу экенин аныктап, божомолду биологиялык мааниси бар түшүндүрмөгө айландырууга аракеттенет; бирок мындай түшүндүрмө илимий баалуулукка ээ болушу үчүн анын моделдин жүрүм-турумуна чындап faithful экени өзүнчө текшерилиши керек.
Intrinsic жана post-hoc түшүндүрмө
Survey эки негизги ыкманы айырмалайт. Intrinsic interpretability — моделдин өз түзүлүшүнүн түшүнүктүү болушу. Сейрек сызыктуу моделдер, кыска чечим тизмелери же биологиялык маанилүү latent өзгөрмөлөрү бар архитектуралар буга мисал боло алат.
Post-hoc explanation болсо татаал жана түз окууга мүмкүн болбогон модель үйрөтүлгөндөн кийин анын жүрүм-турумун түшүндүрүү үчүн кошумча ыкмаларды колдонот. SHAP, Integrated Gradients же Grad-CAM сыяктуу ыкмалар ушул класска кирет.
Post-hoc ыкма күчтүү моделдерди изилдөөгө мүмкүнчүлүк берет; бирок түшүндүрмө моделдин өзү эмес, модель жөнүндө кийин эсептелген объект. Ошондуктан түшүндүрмө моделдин чыныгы чечим логикасына канчалык берилген экени өзүнчө сыналышы керек.
Local жана global түшүндүрмө
Бир local explanation бир гана моделдик чыгышка багытталат. Мисалы, белгилүү DNA тизмеги эмне үчүн enhancer катары классификацияланганын же белгилүү клетка эмне үчүн T клеткасы катары аныкталганын түшүндүрүүгө аракеттенет.
Global explanation болсо моделдин жалпы жүрүм-турумун изилдейт. Мисалы, геном боюнча модель дайыма кайсы мотивдерди колдонору же белок моделинин ичинде белгилүү attention head'дер жалпы кандай структуралык байланыштарды көрсөтөрү изилдениши мүмкүн.
Feature attribution
Feature-attribution ыкмалары моделдин чыгышындагы өзгөрүү кайсы киргизүү өзгөчөлүктөрү менен байланыштуу экенин баалоого аракеттенет. Биологияда бул ыкма өзгөчө табигый көрүнөт, анткени киргизүү өзгөчөлүктөрүнүн өзү көп учурда физикалык же биологиялык бирдиктер болуп саналат:
- DNA моделинде нуклеотид,
- бир-клеткалуу моделде ген,
- белок моделинде аминокислота калдыгы,
- молекула моделинде атом же байланыш,
- гистопатология моделинде пиксель же сүрөт аймагы.
Survey караган негизги feature-attribution ыкмалары — LIME, SHAP, Integrated Gradients, DeepLIFT, Layer-wise Relevance Propagation жана Grad-CAM.
| Ыкмалар үй-бүлөсү | Негизги суроо | Типтүү чыгыш | Биологиялык колдонуу формасы |
|---|---|---|---|
| LIME | Бул жалгыз божомолдун айланасында кайсы өзгөчөлүктөр таасирдүү? | Жергиликтүү surrogate model | Белгилүү мисалдын өзгөчөлүк салымдары |
| SHAP | Ар бир өзгөчөлүктүн божомолго маргиналдык салымы кандай? | Shapley негизиндеги маанилүүлүк көрсөткүчтөрү | Ген, клиникалык өзгөчөлүк же молекулалык өзгөчөлүк attribution'у |
| Integrated Gradients | Киргизүүдөн чыгышка чейинки gradient боюнча кайсы өзгөчөлүктөр салым кошот? | Ар бир киргизүүгө attribution | Нуклеотид, аминокислота же сүрөт пикселинин маанилүүлүк картасы |
| DeepLIFT | Активация референске салыштырмалуу кантип өзгөрөт? | Салым упайлары | Айрыкча геномдук мотив анализи |
| Grad-CAM | Сүрөттүн кайсы аймактары класс упайын колдойт? | Жылуулук картасы | Гистопатология жана медициналык сүрөттөө |
| TCAV | Модель адам аныктаган түшүнүккө сезимталбы? | Concept activation багыты | Жол, клетка түрү же биологиялык кол тамга анализи |
| Sparse Autoencoder | Бөлүштүрүлгөн ички өкүлчүлүктөр кайсы сейрек өзгөчөлүктөргө бөлүнөт? | Чечмелене турган latent өзгөчөлүктөр | Foundation model ичиндеги клетка түрү же ткань программаларын ажыратуу |
Эмне үчүн Attention Салмактары Өзүнчө Түшүндүрмө Болбойт?
Attention салмактары модель белгилүү token'дердин ортосунда кайсы маалымат жолдоруна көбүрөөк салмак берерин көрсөтө алат, бирок бир эле моделдик чыгыш ар башка attention бөлүштүрүүлөрү менен түзүлүшү мүмкүн болгондуктан жогорку attention мааниси өзүнчө себептик же faithful түшүндүрмө эмес; ошондуктан биологияда attention карталары текшерилиши керек болгон гипотезалар катары каралышы керек.
Бул айырма белок моделдери үчүн өзгөчө маанилүү. Белок тизмегиндеги token'дер аминокислоталарды көрсөткөндө бир attention head белгилүү калдыктарга жогорку салмак бериши биологиялык жактан кызыктуу көрүнүш жаратышы мүмкүн. Бирок бул чындап байланыш интерфейсин, контакт аймагын же функционалдык мотивди билдирери көз карандысыз структуралык маалымат менен салыштыруу аркылуу гана көрсөтүлөт.
Survey белок тил моделдери боюнча иштерде белгилүү attention head'дердин структуралык контакттар, байланыш аймактары жана post-translational modification жерлери менен байланышы сандык салыштыруулар аркылуу изилденгенин мисал кылат. Негизги методологиялык сабак — attention визуалдаштыруу жыйынтык эмес, баштапкы чекит болушу керек.
Түшүнүккө негизделген түшүндүрмөлөр
Бир нуклеотид же ген деңгээлиндеги attribution биолог ойлогон түшүнүк масштабынан төмөн болушу мүмкүн. Изилдөөчү көп учурда “кайсы ген?” дегендин ордуна “кайсы жол?”, “кайсы клетка программасы?” же “кайсы биологиялык процесс?” деген суроолорду берет.
Concept-based ыкмалар моделдик активациялардын адам тарабынан аныкталган жогорку деңгээлдеги түшүнүктөр менен байланышын изилдөөнү көздөйт. Survey караган Testing with Concept Activation Vectors (TCAV) белгилүү түшүнүк үчүн активация мейкиндигинде багыт үйрөнүп, модель божомолдорунун ошол багытка сезимталдыгын өлчөйт.
Биология бул ыкма үчүн бай чөйрө түзөт, анткени ген топтомдору, клетка түрүнүн кол тамгалары, молекулалык жолдор жана функционалдык онтологиялар адамдар алдын ала аныктаган түшүнүк сөздүктөрүн түзөт.
Механисттик Чечмелөөгө Болуучулук Feature Attribution'дан Кантип Айырмаланат?
Feature attribution божомол кайсы киргизүүлөр менен байланыштуу экенин сураса, mechanistic interpretability моделдин ички активациялары жана салмактары ичинде кайсы өзгөчөлүктөр көрсөтүлгөнүн, бул өзгөчөлүктөр кайсы байланыштар аркылуу бириккенин жана белгилүү чыгышты түзүү үчүн кайсы эсептөө схемалары иштей турганын чечмелөөгө аракеттенет.
Ошондуктан механисттик чечмелөөгө болуучулук моделди сырттан суроонун ордуна анын ички түзүлүшүн тескери инженерия объектисине айлантат. Максат жөн гана “бул ген маанилүү” деп айтуу эмес, модель белгилүү клетка программасын кайсы latent өкүлчүлүктө коддогонун жана ал өкүлчүлүк кийинки катмарларда кайсы эсептөөгө таасир этерин аныктоо.
Superposition көйгөйү
Заманбап нейрон тармактарында бир нейрон бир гана адамга түшүнүктүү өзгөчөлүктү көрсөтөт деген божомол көп учурда туура эмес. Тармак өзүндөгү физикалык нейрондордун санынан көбүрөөк өзгөчөлүктү бири-бирин баскан багыттарда коддой алат. Survey бул абалды superposition түшүнүгү менен түшүндүрөт.
Натыйжада бир нейрон бир нече түшүнүк менен байланыштуу болушу мүмкүн жана “бул нейрон T клеткасын көрсөтөт” деген түз чечмелөөлөр адаштырышы мүмкүн.
Sparse Autoencoder Биологиялык Foundation Model'дерде Эмне Берет?
Sparse autoencoder тыгыз жана бири-бирине кабатталган моделдик активацияларды кеңирээк, бирок сейрек активдешкен өзгөчөлүктөр сөздүгүнө бөлүүгө аракеттенип, айрым latent өзгөчөлүктөрдү белгилүү клетка түрлөрү, ген программалары же гистологиялык түзүлүштөр сыяктуу биологиялык түшүнүктөр менен дал келтирүүнү жеңилдетет.
SAE ыкмасында моделдин өз параметрлеринин ордуна белгилүү аралык катмар активациялары талданат. Autoencoder бул активацияларды жогорку өлчөмдүү feature dictionary аркылуу кайра түзүүнү үйрөнөт; sparsity чектөөсү бир эле мисалда аз гана сандагы өзгөчөлүктөрдүн күчтүү активдешүүсүн кубаттайт.
Survey өзгөчө белгилеген өнүгүү — бул ыкманын чоң тил моделдеринин чечмелөө тармагынан биологиялык foundation model'дерге өткөрүлүшү. Булак патология foundation model'деринде гистологиялык түзүлүштөр менен жана бир-клеткалуу foundation model өкүлчүлүктөрүндө клетка түрүнүн программалары менен байланыштырууга боло турган sparse өзгөчөлүктөр билдирилген иштерди талкуулайт.
Мунун илимий мааниси latent өзгөчөлүктөргө жөн гана ат коюу эмес. Эгер белгилүү SAE өзгөчөлүгү активдештирилип же басаңдатылып, моделдин чыгышы системалуу өзгөрсө, түшүндүрмө корреляциядан кийлигишүү деңгээлине жакындайт.
Жөнгө салуучу геномика
Геномика XAI биологияда эрте колдонулган тармактардын бири. DNA тизмектери түздөн-түз модель киргизүүсү болгондо ар бир нуклеотид же мотив боюнча attribution эсептөөгө болот.
Survey DeepBind, DeepSEA, Basset, ExPecto, BPNet жана Enformer сыяктуу модель үй-бүлөлөрүн ушул өнүгүү багытында талкуулайт. Айрыкча base-resolution моделдерди DeepLIFT жана мотив табуу ыкмалары менен айкалыштыруу белгилүү мотивдерди кайра табууга гана эмес, мотивдердин бирге кантип уюшулганына байланыштуу гипотезаларды түзүүгө да мүмкүнчүлүк берди.
Бир-клеткалуу foundation model'дер
Geneformer, scGPT, scFoundation жана Universal Cell Embeddings сыяктуу моделдер миллиондогон клеткалардан үйрөнүлгөн бөлүштүрүлгөн өкүлчүлүктөрдү түзөт. Бул embedding'дер клетка түрүн классификациялоо жана perturbation prediction сыяктуу downstream тапшырмаларда колдонулушу мүмкүн; бирок embedding өлчөмү биологиялык жактан эмнени көрсөтөрү көбүнчө түздөн-түз белгилүү эмес.
Surveyге ылайык механисттик чечмелөөгө болуучулукту биологияга өткөрүүнүн эң көрүнүктүү мисалдарынын бири ушул тармак. Sparse dictionary learning аркылуу latent өзгөчөлүктөрдү клетка түрү жана gene-set программалары менен дал келтирүү foundation model'дин ички өкүлчүлүгүн биологдор колдонгон түшүнүк сөздүгүнө жакындатат.
Бирок өзгөчөлүк менен gene-set ортосундагы корреляция өзүнчө механисттик жыйынтык эмес. Survey белгилүү latent өзгөчөлүктөргө кийлигишип, моделдин жүрүм-туруму өзгөрөбү же жокпу деп текшерүүнү күчтүүрөөк далил стандарты катары баса белгилейт.
Белок моделдери
Белок тил моделдери жүз миллиондогон белок тизмектеринен структуралык жана функционалдык өкүлчүлүктөрдү үйрөнө алат. Белок token'деринин түздөн-түз аминокислота калдыктарына туура келиши чечмелөөгө болуучулук үчүн өзгөчө артыкчылык берет.
Attention head'дер контакт чекиттери, байланыш аймактары же post-translational modification жерлери менен дал келеби же жокпу түз структуралык аннотациялар менен салыштырылышы мүмкүн. Бул өзгөчөлүк белок моделдерин mechanistic interpretability жана sparse dictionary ыкмалары үчүн күчтүү максатка айлантат.
Молекула жана дары табуу
Graph neural network'тер молекулаларды атомдор жана байланыштардан турган графиктер катары иштетет. Молекуланын активдүүлүгүн түшүндүрүү көп учурда кайсы субграф же химиялык топ божомолго салым кошконун аныктоо дегенди билдирет.
Survey GNNExplainer сыяктуу ыкмалар божомолду мүмкүн болушунча сактап турган кичинекей молекулалык субграф табууга аракет кыларын түшүндүрөт. Ошентип түшүндүрмө жөн гана маанилүүлүк упайы болбой, химик талдай ала турган молекулалык мотивге айланат.
Клиникалык сүрөттөө жана санарип патология
Гистопатология жана башка биомедициналык сүрөттөрдө Grad-CAM жана saliency негизиндеги ыкмалар классификация чечимине таасир эткен сүрөт аймактарын белгилөө үчүн кеңири колдонулат.
Бирок бул тармак XAIнин эң олуттуу тобокелин да ачык көрсөтөт: шишик классификатору чыныгы гистологиялык өзгөчөлүктүн ордуна сканер артефактын, оорукана белгисин же сүрөттөө протоколун колдонушу мүмкүн. Визуалдык түшүндүрмө мындай shortcut'тарды байкоого жардам бере алат; бирок начар иштелип чыккан түшүндүрүү ыкмасы ошол эле артефактты биологиялык сигнал катары көрсөтүшү мүмкүн.
Изилдөөнүн Ыкмасы жана Натыйжалары
Бул изилдөө кандай ыкма колдонгон?
Изилдөө жаңы эксперименттик модель иштеп чыкпайт. Автор бар XAI жана mechanistic interpretability адабиятын концептуалдык таксономиянын астында бириктирет. Survey эки көз карандысыз окту колдонот:
- Ыкма огу: feature attribution, attention analysis, concept-based explanation жана mechanistic interpretability.
- Колдонмо огу: геномика, бир-клеткалуу/foundation model'дер, белоктор, молекула жана дары табуу, клиникалык сүрөттөө жана патология.
| Тармак | Модель киргизүүсү / өкүлчүлүгү | Типтүү чечмелөөгө болуучулук суроосу | Текшерүү мүмкүнчүлүгү |
|---|---|---|---|
| Жөнгө салуучу геномика | DNA тизмеги | Кайсы нуклеотид же мотив чыгышка таасир этет? | Белгилүү мотивдер, байланыш жана жөнгө салуучу эксперименттер |
| Бир-клеткалуу биология | Ген экспрессиясы / клетка embedding'и | Кайсы ген программасы же клетка абалы көрсөтүлүп жатат? | Gene-set, клетка түрүнүн аннотациясы жана perturbation |
| Белок моделдери | Аминокислота тизмеги / internal representation | Модель кайсы структуралык же функционалдык байланышты коддойт? | Белок түзүлүштөрү, контакт жана байланыш аймактары |
| Молекула жана дары табуу | Атом-байланыш графиги | Кайсы субструктура активдүүлүк божомолун багыттайт? | Химиялык эксперименттер жана түзүлүш-активдүүлүк байланышы |
| Санарип патология | Сүрөт | Модель кайсы ткань аймактарына таянат? | Патология аннотациясы жана клиникалык текшерүү |
Түшүндүрмөнүн туура экенин кантип билебиз?
Surveyнин эң күчтүү методологиялык билдирүүлөрүнүн бири — түшүндүрмө өзүнчө бааланууга тийиш. Моделдин божомолу туура болсо да, түшүндүрмөсү туура эмес болушу мүмкүн.
Булак үч негизги текшерүү ыкмасын белгилейт:
- Sanity check: Модель салмактары же энбелгилер туш келди кылынганда түшүндүрмө да өзгөрөбү?
- Faithfulness тести: Маанилүү деп айтылган өзгөчөлүк алынып салынганда же өзгөртүлгөндө моделдин чыгышына чындап таасир этеби?
- Биологиялык ground truth салыштыруусу: Attribution же моделдик өзгөчөлүк белгилүү мотив, байланыш аймагы, pathway же клетка түрүнүн аннотациясы менен дал келеби?
Бул текшерүүлөрдүн максаты түшүндүрмө адамга маанилүү көрүнүшүн эмес, моделдин чыныгы эсептөөсү менен байланышын сынап көрүү.
Эмне үчүн Себептик Кийлигишүү Күчтүүрөөк Түшүндүрмө Тести?
Себептик кийлигишүү моделдин ичинде белгилүү latent өзгөчөлүк же схема көзөмөлдөнүп азайтылганда же күчөтүлгөндө чыгыштагы өзгөрүүнү өлчөгөндүктөн, жөн гана корреляцияны көрсөтүүдөн күчтүүрөөк; бул ыкма биологиядагы perturbation эксперименттин логикасын жасалма нейрон тармагынын ички өкүлчүлүктөрүнө колдонот.
Эгер latent feature белгилүү клетка түрү менен корреляция көрсөтсө, бул өзүнчө ошол feature моделдик чечим үчүн зарыл экенин далилдебейт. Өзгөчөлүк өчүрүлгөндө клетка классификациясы же башка downstream жүрүм-турум системалуу өзгөрсө, механисттик байланыш үчүн күчтүүрөөк далил алынат.
Survey бул interventionist стандартты биологиянын эксперименттик маданиятына өзгөчө ылайык деп эсептейт.
Ачык көйгөй: биологиялык ground truth толук эмес
XAIнин биологиядагы негизги парадокстарынын бири мындай: түшүндүрмөнүн туура-жалганын текшерүү үчүн биологиялык чындык керек; бирок изилденип жаткан механизмдин өзү көбүнчө толук белгилүү эмес.
Геном модели белгисиз аймакты маанилүү деп көрсөткөндө эки түшүндүрмө мүмкүн:
- модель чындап жаңы биологиялык жөнгө салуучу элементти тапкан;
- модель маалымат топтомундагы артефактка таянган.
Жөн гана attribution картасына карап бул эки мүмкүнчүлүктү ажыратууга болбойт. Жаңы биологиялык эксперимент же көз карандысыз текшерүү керек болушу мүмкүн.
Ачык көйгөй: foundation model масштабы
Биологиялык foundation model'дер чоңойгон сайын ар бир нейрон же circuitти адам өзүнчө талдай алышы мүмкүн болбой калат. Sparse dictionary learning бул маселени жарым-жартылай автоматташтырууну убада кылат; бирок survey dictionary size тандоо, бир биологиялык түшүнүктүн бир нече sparse feature'га бөлүнүшү жана өзгөчөлүктөрдүн circuit деңгээлинде бири-бири менен байланышышы сыяктуу көйгөйлөр али чечиле электигин баса белгилейт.
Interpretability by design
Булактын изилдөө күн тартибиндеги дагы бир багыт — моделди үйрөткөндөн кийин түшүндүрүүнүн ордуна аны башынан эле биологиялык маанилүү latent түзүлүштөр менен долбоорлоо.
Мисалы, latent өзгөрмөлөр түздөн-түз pathway, клетка түрү же биофизикалык чоңдуктар менен чектелсе, post-hoc түшүндүрмөгө муктаждык азайышы мүмкүн. Бирок мунун моделдин тактыгына жана жалпылоосуна кандай таасир этери өзүнчө изилдениши керек.
Изилдөө колдогон жыйынтыктар
Survey колдогон: Биологиялык XAI адабияты жөнөкөй feature attribution'дан жогорку деңгээлдеги концептуалдык жана механисттик анализдерге кеңейип жатат. Sparse autoencoder жана circuit analysis сыяктуу ыкмалардын биологиялык foundation model'дерге колдонулуп башташы моделдин ичиндеги өкүлчүлүктөрдү биологиялык түшүнүктөр менен байланыштыруу үчүн жаңы мүмкүнчүлүктөрдү ачат. Ошол эле учурда explanation faithfulness көз карандысыз текшерилиши керек.
Изилдөө колдобогон жыйынтыктар
Survey колдобогон: Ар бир attention map биологиялык механизмди көрсөтөт, ар бир saliency map ишенимдүү, sparse autoencoder feature'лары автоматтык түрдө чыныгы биологиялык объекттерге туура келет же mechanistic interpretability азыркы абалында биологиялык foundation model'дерди толук чечти деген жыйынтык чыгарууга болбойт.
Ошондой эле survey жаңы биологиялык механизмдерди өз эксперименттери менен ачпайт жана шилтеме берген бардык иштердин жыйынтыктарын кайра өндүрбөйт.
Булак жана Ыкма Эскертүүсү
Түпнуска иш: Opening the Biological Black Box: A Survey of Explainable and Mechanistic Interpretability Methods for AI in Biology.
Автор: Olivia Denvis.
Аффилиация: Independent Researcher.
Булак түрү: Survey / SSRN preprint.
Изилдөө датасы: 15-июнь 2026.
SSRN жарыяланган дата: 23-июнь 2026.
SSRN Abstract ID: 6968318.
DOI: 10.2139/ssrn.6968318.
Рецензия абалы: Булак рецензияланган журнал макаласы катары эмес, preprint катары жарыяланган.
Жарыя лицензиясы / укук абалы: SSRN жазуусу ачык Creative Commons кайра колдонуу лицензиясын көрсөтпөйт жана корголгон материалды уруксатсыз кайра колдонууга жол берилбей турганын билдирет. Ошондуктан Verianla тексти булактагы сөз айкаштарын кайра жарыялоо эмес; адабият surveyсинде билдирилген илимий түшүнүктөрдүн көз карандысыз окутуучу синтези.
Жаңы эксперимент/маалымат: Изилдөө жаңы биологиялык эксперимент, маалымат топтому же benchmark жаратпайт. Адабияттагы XAI жана mechanistic interpretability иштерин классификациялап, баалайт.
Негизги методологиялык чектөө: Survey баяндаган жыйынтыктардын эксперименттик далили тиешелүү баштапкы иштерде берилген. Ыкма же колдонмо боюнча кеңири натыйжалуулук баалоосу үчүн түпнуска шилтемеге кайрылуу керек.
Негизги эпистемикалык чектөө: Биологияда ground truth толук эмес жана талаштуу болушу мүмкүн. Ошондуктан моделдин түшүндүрмөсүнүн белгилүү биологияга дал келбеши ар дайым түшүндүрмө туура эмес дегенди; дал келиши болсо автоматтык түрдө себептик механизм дегенди билдирбейт.
Шилтемелердин камтылышы: Survey 44 иштин негизинде классикалык XAI, биологиялык deep learning колдонмолору, foundation model'дер, mechanistic interpretability жана explanation-validation адабиятын бириктирет.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген