

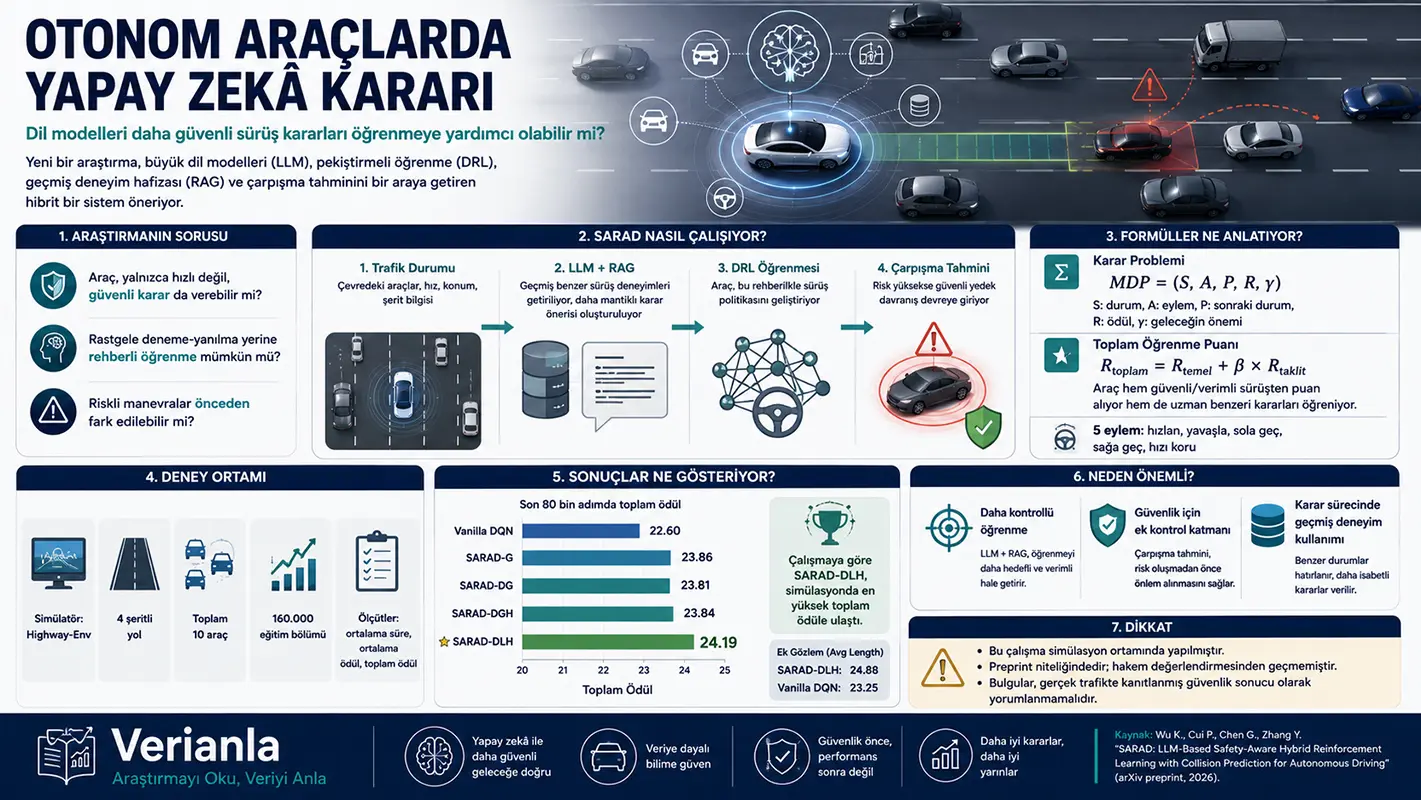
Shida Kuu kwa Gari la Kujitegemea: «Sasa Nifanye Nini?»
Gari la kujitegemea linapokuwa barabarani lazima liamue kila wakati. Ikiwa gari lililoko mbele limeshuka kasi, lifanye breki? Ikiwa njia ya upande iko wazi, libadilishe njia? Je, kuongeza kasi ni salama? Au ni bora kudumisha kasi ya sasa?
Madereva wa binadamu hufanya maamuzi haya kwa uzoefu, umakini na hisia. Katika mifumo ya akili bandia, maamuzi haya huandilishwa kwa data za nambari. Gari hujaribu kuchagua hatua inayofuata kwa kutathmini nafasi yake, kasi yake, na nafasi na harakati za magari yanayolizunguka.
Mwanzo wa makala hii pia unaanzia hapa:
Je, gari la kujitegemea linaweza kuamua haraka na salama?
Njia za jadi za Kujifunza kwa Kuimarisha Kwa Kina, yaani DRL, hufundisha tabia kwa majaribio na makosa. Hata hivyo njia hii inaweza kujaribu harakati za nasibu katika hatua za mwanzo za kujifunza. Katika maeneo muhimu kwa usalama kama uendeshaji wa kujitegemea, hili ni tatizo kubwa. Kwa sababu katika maisha halisi kubadilisha njia kwa nasibu, kuongeza kasi ghafla au kufanya breki kwa wakati usiofaa si njia inayokubalika ya kujifunza.
Mifano Mikubwa ya Lugha inaweza kutafsiri hali ya trafiki kama maandishi na kutoa mapendekezo ya busara zaidi. Lakini pia ina tatizo lingine: inaweza kuchelewa katika kuamua kwa wakati halisi. Kwa gari la kujitegemea uamuzi usiwe sahihi tu; lazima pia utolewe kwa wakati unaofaa.
Mfumo unaoitwa SARAD unajaribu kuunganisha mbinu hizi mbili. Mfano wa lugha hutoa mwongozo wenye maana zaidi kwa gari katika hatua za mapema za kujifunza. Mfumo wa kujifunza kwa kuimarisha hujifunza sera inayoweza kuamua haraka kadri muda unavyopita. Zaidi ya hayo, safu ya utabiri wa mgongano hukagua ikiwa uamuzi uliopendekezwa ni hatari.
Watafiti Walijenga Mfumo Vipi?
Katika kazi hii tatizo la gari la kujitegemea huandilishwa kama mchakato wa uamuzi. Tunaweza kuifikiria kwa urahisi hivi:
Gari huangalia mazingira kila wakati. Katika uchunguzi huu kuna nafasi na kasi ya gari pamoja na taarifa za nafasi na kasi za magari mengine. Kisha mfumo huchagua moja kati ya vitendo vitano vya msingi:
- Ongeza kasi
- Punguza kasi
- Badilisha njia kushoto
- Badilisha njia kulia
- Dumisha kasi ya sasa
Muundo huu katika makala hufafanuliwa kama Markov Decision Process, yaani Mchakato wa Uamuzi wa Markov:
MDP = (S, A, P, R, γ)
Formula hii inaweza kusomwa kwa msomaji hivi:
S ni hali inayoonwa na gari. Yaani barabara, nafasi za magari, kasi na taarifa za mazingira.
A ni harakati ambazo gari linaweza kuchagua. Kwa mfano kuongeza kasi au kubadilisha njia.
P huonyesha jinsi mazingira yanaweza kubadilika baada ya harakati.
R ni zawadi inayoonyesha jinsi harakati iliyochaguliwa ilivyo nzuri au mbaya.
γ ni kigezo kinachoamua mfumo utazingatia kiasi gani zawadi za baadaye.
Mantiki hapa ni rahisi: gari halitazami tu «nini ni bora sasa?» Pia hujaribu kuzingatia swali «harakati hii itapelekea nini baada ya muda mfupi?»
Gari Linabadilisha Mazingira Vipi kuwa Nambari?
Katika makala mazingira ya barabara yanayoonekana na gari huwakilishwa kwa taarifa kama hizi:
st = nafasi ya gari + kasi ya gari + nafasi na kasi za magari yanayolizunguka
Yaani kwa mfumo mandhari ya trafiki si picha, bali ni kama jedwali la nambari. Kwa kila gari takriban taarifa hizi hutumika:
- Nafasi ya x
- Nafasi ya y
- Kasi kwenye mwelekeo wa x
- Kasi kwenye mwelekeo wa y
Tunaweza kuelezea hivi kwa lugha ya kila siku:
Gari la kujitegemea hufuatilia kwa nambari taarifa kama «gari mbele yangu liko mita ngapi mbele, linakwenda kwa kasi gani, je gari kwenye njia ya upande linakaribia?»
Hili ni muhimu kwa sababu akili bandia huamua kwa msingi wa nambari hizi. Mwakilishi wa binadamu huamua kwa hisia akitazama kioo cha nyuma, wakati akili bandia hujaribu kuelewa mazingira kwa thamani za kuratibu na kasi.
Mantiki ya Kujifunza ya Mfumo: Zawadi kwa Uamuzi Mzuri, Adhabu kwa Uamuzi Hatari
Katika kujifunza kwa kuimarisha mfumo hujifunza kwa kupata alama kutokana na harakati zake. Mfumo wa zawadi katika makala pia unategemea mantiki hii.
Watafiti hutumia aina mbili za zawadi:
Kwanza, zawadi ya msingi inayopima mafanikio ya uendeshaji wa gari. Ikiwa gari linaendelea salama na kwa ufanisi zawadi huongezeka. Ikiwa kuna mgongano linapata adhabu.
Pili, zawadi ya ziada inayohusiana na ukaribu na tabia iliyopendekezwa na mfano wa lugha. Hii husaidia gari kutokuwa na harakati za nasibu kabisa wakati wa kujifunza, bali kubaki karibu na harakati ambazo mfano wa lugha huona kuwa za busara zaidi.
Katika makala muundo huu wa jumla huonyeshwa hivi:
Rtotal = Rorigin + β × Rimit
Maana rahisi ya formula hii ni:
Jumla ya alama za kujifunza = alama ya msingi kutoka kwa uendeshaji + alama ya ziada kutoka kwa ukaribu na pendekezo la mfano wa lugha
Rorigin ni alama ya msingi inayopatikana kulingana na kasi, maendeleo na hali ya mgongano wa gari.
Rimit huonyesha jinsi harakati ya gari inavyofanana na «pendekezo la mtaalamu» linalotegemea mfano wa lugha.
β ni uzito unaoamua kiwango cha athari ya zawadi hii ya ziada katika uamuzi wa jumla.
Kuna tofauti muhimu hapa: mfumo hauigaji mfano wa lugha kwa upofu. Mfano wa lugha hufanya kazi kama mwalimu, lakini uamuzi wa mwisho huboreshwa na mfumo wa kujifunza kadri muda unavyopita. Hii inaweza kufikiriwa kama daraja kati ya «kujifunza kwa mwalimu» na «kujifunza kwa uzoefu wake mwenyewe».
Sehemu Tatu Kuu za SARAD
Kulingana na ramani ya mfumo iliyotolewa katika makala SARAD ina sehemu tatu kuu.
Sehemu ya kwanza ni mfumo wa DRL. Sehemu hii hujifunza sera ya uendeshaji wa gari. Yaani huboresha kwa muda ni harakati gani inayoweza kuwa ifaayo katika hali fulani.
Sehemu ya pili ni mfumo wa LLM na RAG. LLM, yaani Mfano Mkubwa wa Lugha, hutafsiri mandhari ya trafiki kama maandishi. Mfumo wa RAG hupata hali zinazofanana kutoka kwa uzoefu wa uendeshaji wa zamani na kuunga mkono mfano wa lugha. Hivyo mfano hautengenezi uamuzi kwa ujuzi wake wa jumla tu, bali pia kwa mifano ya uendeshaji inayofanana iliyohifadhiwa hapo awali.
Sehemu ya tatu ni moduli ya utabiri wa mgongano. Moduli hii hujaribu kutabiri ikiwa harakati iliyopendekezwa ni hatari. Ikiwa mfumo unakisia «harakati hii inaweza kubeba hatari ya mgongano», tabia ya usalama inayotegemea sheria inaweza kuanza kufanya kazi.
Tufikirie muundo huu kwa mfano wa dereva wa binadamu:
- DRL ni kama dereva anayefanya mazoezi mara kwa mara.
- LLM ni kama maoni ya mkufunzi mwenye uzoefu.
- RAG ni kama kumbukumbu ya matukio yanayofanana yaliyotokea hapo awali.
- Moduli ya utabiri wa mgongano ni kama ukaguzi wa usalama unaosema «simama, harakati hii inaweza kuwa hatari».
Mfumo wa RAG Unafanya Kazi Gani?
RAG ni kifupi cha «Retrieval-Augmented Generation». Kwa Kiswahili kinaweza kutafsiriwa kwa takriban «utengenezaji ulioimarishwa kwa kurejesha taarifa».
Lengo la mfumo huu ni kuzuia mfano wa lugha kutegemea ujuzi wake wa jumla pekee. Katika SARAD gari hurekodi baadhi ya uzoefu wakati wa uendeshaji. Kwa mfano:
- Katika hali gani uamuzi gani ulitolewa?
- Je, uamuzi huo ulikuwa salama?
- Je, kulikuwa na mgongano?
- Gari lilikuwa na kasi gani?
- Magari ya karibu yalikuwa yakiendelea vipi?
Baadaye inapokutana na hali inayofanana mfumo hurejesha uzoefu unaofanana wa zamani na kuutoa kwa mfano wa lugha kama taarifa ya kusaidia.
Hii inafanana na hili katika maisha ya kila siku:
Ikiwa dereva ameshuhudia hapo awali kwamba kubadilisha njia ghafla kwenye kivuko hatari ni hatari, anaweza kuwa makini zaidi katika hali inayofanana. Moduli ya RAG ya SARAD pia hujaribu kuipa akili bandia kumbukumbu kama hiyo.
Kwa Nini Moduli ya Utabiri wa Mgongano Ni Muhimu?
Moja ya sehemu muhimu zaidi za usalama katika kazi hii ni moduli ya utabiri wa mgongano. Kwa sababu si kila uamuzi unaopendekezwa na akili bandia ni sahihi.
Katika makala moduli hii imeundwa kutabiri ikiwa harakati iliyopendekezwa inabeba hatari ya mgongano. Mfumo hupokea taarifa za hali na harakati; kisha hutathmini ikiwa harakati hii ni hatari.
Tunaweza kuifikiria kwa urahisi hivi:
Ikiwa gari litatengeneza uamuzi wa «hamia kwenye njia ya kushoto», moduli ya usalama huuliza:
«Tukihamia kwenye njia ya kushoto, je kuna uwezekano wa mgongano na magari ya karibu?»
Ikiwa hatari inaonekana kuwa kubwa mfumo unaweza kugeuka kwenye tabia salama zaidi badala ya kutumia uamuzi huo moja kwa moja. Katika makala miongoni mwa tabia hizi za akiba za usalama kuna breki ya dharura, kukaa kwenye njia na kudumisha umbali salama.
Sehemu hii ni muhimu kwa sababu katika mifumo ya kujitegemea kutengeneza uamuzi pekee haitoshi. Uamuzi lazima ukaguliwe kwa usalama kabla ya kutumika.
Jaribio Lilifanywa Vipi?
Watafiti walijaribu mfumo si kwenye trafiki halisi bali katika mazingira ya uigaji yanayoitwa Highway-Env. Katika uigaji barabara yenye njia nne ilitumika. Kila njia ilifafanuliwa kuwa na upana wa mita 4. Katika mazingira kuna jumla ya magari 10 yanayosonga; moja yao ni gari la kujitegemea linaloamua.
Harakati ambazo magari yanaweza kuchagua tena zimepunguzwa kwa chaguo tano:
- Badilisha njia kushoto
- Badilisha njia kulia
- Ongeza kasi
- Punguza kasi
- Dumisha kasi
Katika majaribio sehemu moja, yaani episode, inaisha katika hali mbili: gari linapogongana au muda wa uendeshaji unapozidi sekunde 40.
Watafiti walitathmini mafanikio kwa vipimo vitatu:
1. Muda wa wastani wa uendeshaji
Gari liliendelea kwa muda gani bila mgongano au kabla ya sehemu kuisha?
2. Zawadi ya wastani
Gari lilifanya maamuzi mazuri kiasi gani katika kila hatua?
3. Jumla ya zawadi
Utendaji wa jumla ulikuwaje katika sehemu nzima?
Vipimo hivi vitatu vinapaswa kusomwa pamoja. Kuendelea kwa muda mrefu pekee haitoshi; gari lazima pia litoe maamuzi yenye ufanisi na salama.
Grafu na Jedwali Zinaonyesha Nini?
Katika makala toleo tofauti za SARAD zililinganishwa na njia ya jadi ya DQN.
DQN ya jadi ni moja ya njia kuu za kujifunza kwa kuimarisha. Katika kazi hii ilitumika kama hatua ya kulinganisha. Toleo za SARAD ni hali ambazo sehemu tofauti za ziada zimeongezwa kwenye mfumo.
Jedwali II linaonyesha matokeo yaliyopatikana katika mchakato mzima wa mafunzo. Hapa modeli ya SARAD-DGH inapata thamani ya juu zaidi kwa zawadi ya wastani na jumla ya zawadi. SARAD-DLH inaonekana zaidi kwa urefu wa wastani wa uendeshaji.
Kwa mfano katika mchakato mzima:
- Vanilla DQN jumla ya zawadi: 20.6767
- SARAD-DGH jumla ya zawadi: 21.5301
- SARAD-DLH jumla ya zawadi: 21.4075
Jedwali hili linaonyesha kwamba modeli katika familia ya SARAD zinaweza kutoa matokeo bora zaidi kuliko DQN ya jadi ndani ya uigaji.
Jedwali III linaangalia hatua 80 elfu za mwisho za mafunzo. Sehemu hii ni muhimu kwa sababu inaonyesha hatua iliyoiva zaidi ya mchakato wa kujifunza.
Katika hatua 80 elfu za mwisho:
- Vanilla DQN jumla ya zawadi: 22.5967
- SARAD-G jumla ya zawadi: 23.8556
- SARAD-DG jumla ya zawadi: 23.8098
- SARAD-DGH jumla ya zawadi: 23.8439
- SARAD-DLH jumla ya zawadi: 24.1935
Katika matokeo haya SARAD-DLH inafikia jumla ya juu zaidi ya zawadi. Katika modeli ya SARAD-DLH moduli ya utabiri wa mgongano inayotegemea LLM na muundo unaotegemea RAG hutumika pamoja. Hii pia inaonyesha kwamba safu ya usalama iliyopendekezwa na watafiti inaweza kuonyesha utendaji imara zaidi katika hatua za mwisho za kujifunza.
Grafu pia zinaonyesha mwelekeo unaofanana. Kadri mafunzo yanavyoendelea utendaji wa modeli zote huongezeka. Hata hivyo modeli za SARAD hasa katika hatua za baadaye zinaweza kufikia mistari ya juu na thabiti zaidi kuliko DQN. Hata hivyo makala inaeleza kwamba grafu zinaonyesha hali moja ya mafunzo ya uwakilishi. Kwa hiyo ingawa matokeo yanatoa ishara imara, yanahitaji kujaribiwa tena kwa hali tofauti.
Tunajifunza Nini Kutoka Kazi Hii?
Makala hii hutoa wazo muhimu: katika mifumo ya akili bandia badala ya kutegemea njia moja tu, kutumia mbinu tofauti pamoja kunaweza kutoa matokeo yenye usawa zaidi.
Kujifunza kwa kuimarisha kunaweza kujifunza kuamua haraka, lakini mwanzoni linaweza kufanya majaribio hatari. Mifano mikubwa ya lugha inaweza kutoa mapendekezo yanayoeleweka na ya busara zaidi, lakini inaweza kubaki polepole kwa uamuzi wa wakati halisi. Mfumo wa RAG unaweza kuleta uzoefu wa zamani. Moduli ya utabiri wa mgongano inaweza kupitisha maamuzi yaliyopendekezwa kupitia ukaguzi wa usalama.
Mchanganyiko huu hutoa mwelekeo muhimu kwa utafiti wa magari ya kujitegemea wa kuendeleza mifumo ya uamuzi salama zaidi na inayoeleweka zaidi.
Somo kuu hapa ni:
Katika magari ya kujitegemea akili bandia haipaswi kujua tu «nini cha kufanya»; pia lazima iulize «je uamuzi huu ni salama?»
Kwa Nini Hili Ni Muhimu?
Teknolojia za uendeshaji wa kujitegemea si kwa magari tu, bali pia kwa usafirishaji, usafiri wa umma, mifumo ya roboti, miji mahiri na otomatiki ya viwandani katika siku zijazo.
Katika mifumo kama hii kosa la uamuzi si kosa la kiufundi tu; linaweza kuleta hatari ya usalama. Kwa hiyo modeli za akili bandia kuonyesha utendaji wa juu pekee haitoshi. Mchakato wa uamuzi lazima uwe unaweza kufuatiliwa, unaoweza kueleweka na kuungwa mkono na safu za usalama.
Mbinu ya SARAD hutoa mfano wa kujifunza katika muktadha huu. Mfumo hauweki mfano wa lugha moja kwa moja kwenye kiti cha dereva. Badala yake hutumia mfano wa lugha kama mwongozo, kujifunza kwa kuimarisha kama kijifunzi cha sera ya uendeshaji, na moduli ya utabiri wa mgongano kama hatua ya ukaguzi wa usalama.
Tofauti hii ni muhimu. Kwa sababu katika ulimwengu halisi katika mifumo muhimu kwa usalama badala ya kutumia maamuzi ya akili bandia bila usimamizi, miundo ya udhibiti ya safu nyingi inaweza kuwa mwelekeo wa utafiti wenye maana zaidi.
Mambo ya Kuzingatia
Matokeo ya kazi hii yanapaswa kusomwa kwa makini.
Kwanza, kazi hufanywa katika mazingira ya uigaji, si kwenye trafiki halisi. Uigaji ni muhimu kwa utafiti, lakini kwenye barabara halisi tabia za binadamu, hali ya hewa, makosa ya sensa, ubovu wa barabara na matukio yasiyotarajiwa ni changamoto zaidi.
Pili, kazi hii ni preprint. Yaani haijapitia tathmini ya riwaya. Matokeo hayapaswi kukubaliwa kama ya uhakika bila tathmini ya kitaaluma huru na majaribio mengine.
Tatu, grafu katika makala zinaonyesha kazi moja ya mafunzo ya uwakilishi. Hali tofauti za mwanzo na hali tofauti za trafiki zinaweza kubadilisha matokeo.
Nne, ucheleweshaji katika mifumo inayotegemea LLM bado ni tatizo muhimu. Watafiti hupendekeza kupunguza ucheleweshaji huu kwa kutumia LLM zaidi katika hatua za mapema za kujifunza. Hata hivyo katika mifumo ya uendeshaji wa kujitegemea ya wakati halisi suala hili lazima lijaribiwe kwa usahihi sana.
Hatimaye, ingawa moduli ya utabiri wa mgongano hutoa wazo muhimu kwa usalama, matumizi ya mfumo kama huu kwenye trafiki halisi yanahitaji majaribio mapana zaidi, uthibitishaji wa usalama na tathmini za kisheria/kiufundi.
Hitimisho
Kazi ya SARAD hutoa mfano wa utafiti unaovutia kuhusu jinsi maamuzi ya akili bandia katika magari ya kujitegemea yanaweza kufanywa salama zaidi na ya kujifunza. Modeli badala ya kujifunza kwa majaribio na makosa ya nasibu kabisa hutumia mwongozo wa mfano mkubwa wa lugha, kumbukumbu ya uzoefu wa zamani na safu ya utabiri wa mgongano.
Matokeo ya uigaji yanaonyesha kwamba mbinu hii ya mchanganyiko inaweza kutoa matokeo bora zaidi katika baadhi ya vipimo vya utendaji ikilinganishwa na njia ya jadi ya DQN. Hata hivyo matokeo haya si ushahidi wa moja kwa moja wa usalama kwa trafiki halisi.
Hata hivyo kazi hii inakumbusha hatua muhimu katika utafiti wa akili bandia:
Mifumo ya akili ya siku zijazo lazima si ya kuamua haraka tu, bali pia iweze kulinganisha maamuzi yake na uzoefu wa zamani, kutathmini hatari mapema na kurudi kwenye mbadala salama inapohitajika.
Chanzo na Dokezo la Mbinu
Maudhui haya yameandaliwa kwa muundo wa kihariri wa Verianla kwa kuzingatia kazi ya kitaaluma “SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving” iliyotayarishwa na Kangyu Wu, Peng Cui, Guoxi Chen na Ya Zhang.
Kazi hii ni preprint na haijapitia tathmini ya riwaya. Maudhui yameandaliwa kwa madhumuni ya taarifa na elimu. Hayachukui nafasi ya ushauri wa kitaalamu kuhusu ukuzaji wa magari ya kujitegemea, usalama wa usafiri, utekelezaji wa uhandisi au muundo wa mfumo wa akili bandia.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *