

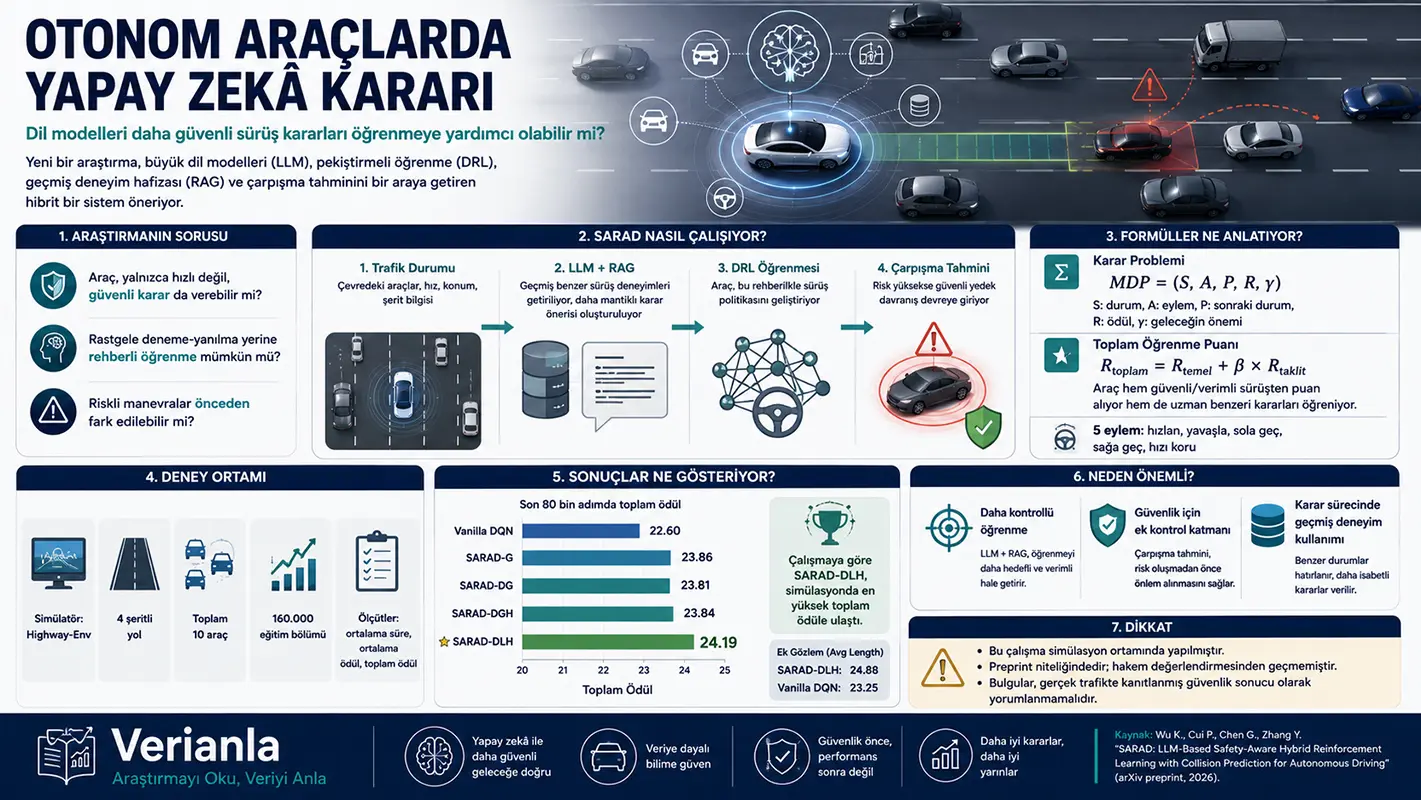
Otonom Araç İçin Asıl Problem: “Şimdi Ne Yapmalıyım?”
Otonom bir araç yolda ilerlerken sürekli karar vermek zorundadır. Önündeki araç yavaşladıysa fren yapmalı mı? Yan şerit boşsa şerit değiştirmeli mi? Hızlanmak güvenli mi? Yoksa mevcut hızını korumak mı daha doğru?
İnsan sürücüler bu kararları deneyim, dikkat ve sezgiyle verir. Yapay zekâ sistemlerinde ise bu kararlar sayısal verilerle modellenir. Araç; kendi konumunu, hızını, çevredeki araçların yerini ve hareketlerini değerlendirerek bir sonraki hareketi seçmeye çalışır.
Bu makalenin çıkış noktası da tam olarak burada başlıyor:
Bir otonom araç hem hızlı hem güvenli karar verebilir mi?
Geleneksel Derin Pekiştirmeli Öğrenme yöntemleri, yani DRL, araca deneme-yanılma yoluyla davranış öğretir. Fakat bu yöntem öğrenmenin ilk aşamalarında rastgele hareketler deneyebilir. Otonom sürüş gibi güvenlik kritik alanlarda bu ciddi bir sorundur. Çünkü gerçek hayatta rastgele şerit değiştirmek, ani hızlanmak veya yanlış zamanda fren yapmak kabul edilebilir bir öğrenme yöntemi değildir.
Büyük Dil Modelleri ise trafik durumunu metin olarak yorumlayıp daha mantıklı öneriler üretebilir. Fakat onların da başka bir sorunu vardır: Gerçek zamanlı karar vermede gecikme yaşayabilirler. Otonom araçta kararın yalnızca doğru olması yetmez; zamanında verilmesi de gerekir.
SARAD adlı sistem, bu iki yaklaşımı birleştirmeyi deniyor. Dil modeli, öğrenmenin erken aşamasında araca daha anlamlı yönlendirme sağlıyor. Pekiştirmeli öğrenme sistemi ise zamanla hızlı karar verebilen bir politika öğreniyor. Ek olarak, bir çarpışma tahmin katmanı önerilen kararın riskli olup olmadığını kontrol ediyor.
Araştırmacılar Sistemi Nasıl Kurmuş?
Çalışmada otonom araç problemi bir karar süreci olarak modelleniyor. Bunu sadeleştirerek şöyle düşünebiliriz:
Araç her anda çevreyi gözlüyor. Bu gözlemde aracın kendi konumu ve hızı ile diğer araçların konum ve hız bilgileri var. Sonra sistem beş temel eylemden birini seçiyor:
- Hızlan
- Yavaşla
- Sola şerit değiştir
- Sağa şerit değiştir
- Mevcut hızı koru
Bu yapı, makalede Markov Decision Process yani Markov Karar Süreci olarak tanımlanıyor:
MDP = (S, A, P, R, γ)
Bu formül okuyucu için şöyle okunabilir:
S, aracın gördüğü durumdur. Yani yol, araçların konumu, hızlar ve çevre bilgisi.
A, aracın seçebileceği hareketlerdir. Örneğin hızlanmak veya şerit değiştirmek.
P, bir hareketten sonra ortamın nasıl değişebileceğini temsil eder.
R, seçilen hareketin ne kadar iyi ya da kötü olduğunu gösteren ödüldür.
γ, sistemin gelecekteki ödülleri ne kadar önemseyeceğini belirleyen katsayıdır.
Buradaki mantık basittir: Araç yalnızca “şu an ne iyi?” diye bakmaz. Aynı zamanda “bu hareket biraz sonra neye yol açar?” sorusunu da hesaba katmaya çalışır.
Araç Çevreyi Nasıl Sayıya Dönüştürüyor?
Makalede aracın gördüğü yol ortamı şu tür bilgilerle temsil ediliyor:
st = aracın konumu + aracın hızı + çevredeki araçların konumu ve hızı
Yani sistem için trafik sahnesi aslında bir fotoğraf değil, sayısal bir tablo gibidir. Her araç için yaklaşık olarak şu bilgiler kullanılır:
- x konumu
- y konumu
- x yönündeki hızı
- y yönündeki hızı
Bunu günlük dille şöyle anlatabiliriz:
Otonom araç, “önümdeki araç benden kaç metre ileride, hangi hızla gidiyor, yan şeritteki araç bana yaklaşıyor mu?” gibi bilgileri sayısal olarak takip eder.
Bu önemlidir çünkü yapay zekâ kararını bu sayılar üzerinden verir. İnsan sürücü aynadan bakıp sezgisel karar verirken, yapay zekâ çevreyi koordinat ve hız değerleriyle anlamaya çalışır.
Sistemin Öğrenme Mantığı: İyi Karara Ödül, Riskli Karara Ceza
Pekiştirmeli öğrenmede sistem, yaptığı hareketlerden puan alarak öğrenir. Makaledeki ödül sistemi de bu mantığa dayanıyor.
Araştırmacılar iki tür ödül kullanıyor:
Birincisi, aracın kendi sürüş başarısını ölçen temel ödül. Araç güvenli ve verimli ilerlerse ödül artıyor. Çarpışma olursa ceza alıyor.
İkincisi, dil modelinin önerdiği davranışa yakınlıkla ilgili ek bir ödül. Bu, aracın öğrenme sırasında tamamen rastgele hareket etmek yerine, dil modelinin daha mantıklı gördüğü hareketlere yakın kalmasına yardımcı oluyor.
Makalede bu toplam yapı şu şekilde gösteriliyor:
Rtotal = Rorigin + β × Rimit
Bu formülün sade anlamı şudur:
Toplam öğrenme puanı = sürüşten gelen temel puan + dil modeli önerisine yakınlıktan gelen ek puan
Buradaki Rorigin, aracın hız, ilerleme ve çarpışma durumuna göre aldığı temel puandır.
Rimit, aracın hareketinin dil modeli destekli “uzman önerisine” ne kadar benzediğini temsil eder.
β, bu ek ödülün toplam kararda ne kadar etkili olacağını belirleyen ağırlıktır.
Bu noktada önemli bir ayrım var: Sistem dil modelini körü körüne taklit etmiyor. Dil modeli bir öğretmen gibi davranıyor, ama son karar öğrenme sistemi tarafından zamanla geliştiriliyor. Bu, “öğretmenli öğrenme” ile “kendi deneyimiyle öğrenme” arasında bir köprü gibi düşünülebilir.
SARAD’ın Üç Ana Parçası
Makalede verilen sistem şemasına göre SARAD üç ana parçadan oluşuyor.
Birinci parça, DRL sistemidir. Bu bölüm aracın sürüş politikasını öğrenir. Yani hangi durumda hangi hareketin daha uygun olabileceğini zamanla geliştirir.
İkinci parça, LLM ve RAG sistemidir. LLM, yani Büyük Dil Modeli, trafik sahnesini metin olarak yorumlar. RAG sistemi ise geçmiş sürüş deneyimlerinden benzer durumları bulup dil modeline destek verir. Böylece model yalnızca genel bilgisiyle değil, daha önce kaydedilmiş benzer sürüş örnekleriyle karar üretir.
Üçüncü parça, çarpışma tahmin modülüdür. Bu modül önerilen hareketin riskli olup olmadığını tahmin etmeye çalışır. Eğer sistem “bu hareket çarpışma riski taşıyor olabilir” sonucuna varırsa, kural tabanlı bir güvenlik davranışı devreye girebilir.
Bu yapıyı bir insan sürücü örneğiyle düşünelim:
- DRL, sürekli pratik yapan sürücü gibidir.
- LLM, deneyimli bir eğitmenin yorumları gibidir.
- RAG, geçmişte yaşanmış benzer olayların hafızası gibidir.
- Çarpışma tahmin modülü ise “dur, bu hareket tehlikeli olabilir” diyen güvenlik kontrolü gibidir.
RAG Sistemi Ne İşe Yarıyor?
RAG, “Retrieval-Augmented Generation” ifadesinin kısaltmasıdır. Türkçeye kabaca “geri getirmeyle güçlendirilmiş üretim” diye çevrilebilir.
Bu sistemin amacı, dil modelinin yalnızca kendi genel bilgisine dayanmasını önlemektir. SARAD’da araç sürüş sırasında bazı deneyimleri kaydediyor. Örneğin:
- Hangi durumda hangi karar verildi?
- Bu karar güvenli miydi?
- Çarpışma oldu mu?
- Araç hangi hızdaydı?
- Yakındaki araçlar nasıl hareket ediyordu?
Daha sonra benzer bir durumla karşılaşıldığında sistem geçmişteki benzer deneyimleri getiriyor ve dil modeline yardımcı bilgi olarak sunuyor.
Bu, günlük hayatta şuna benzer:
Bir sürücü daha önce tehlikeli bir kavşakta ani şerit değiştirmenin riskli olduğunu yaşadıysa, benzer bir durumda daha dikkatli davranabilir. SARAD’ın RAG modülü de yapay zekâya buna benzer bir hafıza kazandırmaya çalışıyor.
Çarpışma Tahmin Modülü Neden Önemli?
Bu çalışmanın en önemli güvenlik parçalarından biri çarpışma tahmin modülü. Çünkü yapay zekânın önerdiği her karar doğru olmayabilir.
Makalede bu modül, önerilen hareketin çarpışma riski taşıyıp taşımadığını tahmin etmek için tasarlanmış. Sistem, durum ve hareket bilgisini alıyor; ardından bu hareketin riskli olup olmadığını değerlendiriyor.
Sade şekilde şöyle düşünebiliriz:
Araç “sol şeride geç” kararı üretirse, güvenlik modülü şunu soruyor:
“Sol şeride geçersek, yakındaki araçlarla çarpışma ihtimali var mı?”
Eğer risk yüksek görünürse sistem doğrudan bu kararı uygulamak yerine daha güvenli bir davranışa geçebilir. Makalede bu tür yedek güvenlik davranışları arasında acil frenleme, şeritte kalma ve güvenli mesafeyi koruma gibi seçenekler belirtiliyor.
Bu bölüm önemlidir çünkü otonom sistemlerde yalnızca karar üretmek yeterli değildir. Kararın uygulanmadan önce güvenlik açısından kontrol edilmesi gerekir.
Deney Nasıl Yapılmış?
Araştırmacılar sistemi gerçek trafikte değil, Highway-Env adlı simülasyon ortamında test etmiş. Simülasyonda dört şeritli bir yol kullanılmış. Her şerit 4 metre genişliğinde tanımlanmış. Ortamda toplam 10 hareketli araç bulunuyor; bunlardan biri karar veren otonom araç.
Araçların seçebileceği hareketler yine beş seçenekle sınırlı:
- Sola şerit değiştir
- Sağa şerit değiştir
- Hızlan
- Yavaşla
- Hızı koru
Deneylerde bir bölüm, yani episode, iki durumda sona eriyor: Araç çarpışırsa veya sürüş süresi 40 saniyeyi aşarsa.
Araştırmacılar başarıyı üç ölçütle değerlendirmiş:
1. Ortalama sürüş süresi
Araç çarpışmadan veya bölüm bitmeden ne kadar süre ilerleyebildi?
2. Ortalama ödül
Araç her adımda ne kadar iyi kararlar verdi?
3. Toplam ödül
Tüm bölüm boyunca biriken genel performans ne oldu?
Bu üç ölçüt birlikte okunmalı. Yalnızca uzun süre gitmek yeterli değildir; araç aynı zamanda verimli ve güvenli kararlar da vermelidir.
Grafikler ve Tablolar Ne Gösteriyor?
Makalede farklı SARAD sürümleri klasik DQN yöntemiyle karşılaştırılmış.
Klasik DQN, pekiştirmeli öğrenmenin temel yöntemlerinden biridir. Bu çalışmada karşılaştırma noktası olarak kullanılmıştır. SARAD sürümleri ise sisteme farklı ek parçalar eklenmiş hallerdir.
Tablo II, tüm eğitim süreci boyunca alınan sonuçları gösteriyor. Burada SARAD-DGH modeli ortalama ödül ve toplam ödül açısından en yüksek değeri alıyor. SARAD-DLH ise ortalama sürüş uzunluğu açısından öne çıkıyor.
Örneğin tüm süreçte:
- Vanilla DQN toplam ödül: 20.6767
- SARAD-DGH toplam ödül: 21.5301
- SARAD-DLH toplam ödül: 21.4075
Bu tablo, SARAD ailesindeki modellerin simülasyon içinde klasik DQN’ye göre daha iyi sonuçlar üretebildiğini düşündürüyor.
Tablo III ise eğitimin son 80 bin adımına bakıyor. Bu bölüm önemli çünkü modelin öğrenme sürecinin daha olgunlaştığı aşamayı gösteriyor.
Son 80 bin adımda:
- Vanilla DQN toplam ödül: 22.5967
- SARAD-G toplam ödül: 23.8556
- SARAD-DG toplam ödül: 23.8098
- SARAD-DGH toplam ödül: 23.8439
- SARAD-DLH toplam ödül: 24.1935
Bu sonuçlarda SARAD-DLH en yüksek toplam ödüle ulaşıyor. SARAD-DLH modelinde LLM tabanlı çarpışma tahmin modülü ve RAG destekli yapı birlikte kullanılıyor. Bu da araştırmacıların önerdiği güvenlik katmanının öğrenmenin son aşamalarında daha güçlü performans gösterebildiğini düşündürüyor.
Grafiklerde de benzer bir eğilim görülüyor. Eğitim ilerledikçe tüm modellerin performansı artıyor. Ancak SARAD modelleri özellikle ilerleyen aşamalarda DQN’ye göre daha yüksek ve daha istikrarlı çizgilere ulaşabiliyor. Yine de makale, grafiklerin tek bir temsilî eğitim koşusunu gösterdiğini belirtiyor. Bu nedenle sonuçlar güçlü bir işaret sunsa da farklı senaryolarla yeniden test edilmesi gerekir.
Bu Çalışmadan Ne Öğreniyoruz?
Bu makale bize önemli bir fikir veriyor: Yapay zekâ sistemlerinde tek bir yönteme güvenmek yerine, farklı yöntemleri birlikte kullanmak daha dengeli sonuçlar verebilir.
Pekiştirmeli öğrenme hızlı karar almayı öğrenebilir, fakat başlangıçta riskli denemeler yapabilir. Büyük dil modelleri daha açıklanabilir ve mantıklı öneriler sunabilir, fakat gerçek zamanlı karar için yavaş kalabilir. RAG sistemi geçmiş deneyimi devreye sokabilir. Çarpışma tahmin modülü ise önerilen kararları güvenlik kontrolünden geçirebilir.
Bu birleşim, otonom araç araştırmalarında daha güvenli ve daha açıklanabilir karar sistemleri geliştirmek için önemli bir yön sunuyor.
Buradaki ana ders şudur:
Otonom araçlarda yapay zekâ yalnızca “ne yapacağını” bilmemeli; aynı zamanda “bu karar güvenli mi?” sorusunu da sormalıdır.
Bu Neden Önemli?
Otonom sürüş teknolojileri yalnızca otomobiller için değil, gelecekte lojistik, toplu taşıma, robotik sistemler, akıllı şehirler ve endüstriyel otomasyon için de önem taşıyor.
Bu tür sistemlerde karar hatası yalnızca teknik bir hata değildir; güvenlik riski doğurabilir. Bu nedenle yapay zekâ modellerinin sadece yüksek performans göstermesi yeterli değildir. Karar süreçlerinin izlenebilir, açıklanabilir ve güvenlik katmanlarıyla desteklenmiş olması gerekir.
SARAD yaklaşımı, bu açıdan öğretici bir örnek sunuyor. Sistem, dil modelini doğrudan sürücü koltuğuna oturtmuyor. Bunun yerine dil modelini bir rehber, pekiştirmeli öğrenmeyi bir sürüş politikası öğrenicisi, çarpışma tahmin modülünü de güvenlik kontrol noktası olarak kullanıyor.
Bu ayrım önemlidir. Çünkü gerçek dünyada güvenlik kritik sistemlerde yapay zekâ kararlarının denetimsiz şekilde uygulanması yerine, katmanlı kontrol yapıları daha anlamlı bir araştırma yönü olabilir.
Dikkat Edilmesi Gereken Noktalar
Bu çalışmanın sonuçları dikkatli okunmalıdır.
İlk olarak, çalışma gerçek trafikte değil simülasyon ortamında yapılmıştır. Simülasyonlar araştırma için yararlıdır, ancak gerçek yolda insan davranışları, hava koşulları, sensör hataları, yol bozuklukları ve beklenmeyen olaylar çok daha karmaşıktır.
İkinci olarak, çalışma preprinttir. Yani hakem değerlendirmesinden geçmemiştir. Bulgular, bağımsız akademik değerlendirme ve farklı deneylerle desteklenmeden kesin kabul edilmemelidir.
Üçüncü olarak, makaledeki grafikler tek bir temsilî eğitim çalışmasını göstermektedir. Farklı başlangıç koşulları ve farklı trafik senaryoları sonuçları değiştirebilir.
Dördüncü olarak, LLM tabanlı sistemlerde gecikme hâlâ önemli bir problemdir. Araştırmacılar bu gecikmeyi azaltmak için LLM kullanımını daha çok öğrenmenin erken aşamasında kullanmayı öneriyor. Fakat gerçek zamanlı otonom sürüş sistemlerinde bu konu çok hassas biçimde test edilmelidir.
Son olarak, çarpışma tahmin modülü güvenlik açısından önemli bir fikir sunsa da bu tür bir sistemin gerçek trafikte kullanılabilmesi için çok daha geniş testlere, güvenlik doğrulamalarına ve yasal/teknik değerlendirmelere ihtiyaç vardır.
Sonuç
SARAD çalışması, otonom araçlarda yapay zekâ kararlarının nasıl daha güvenli ve öğretici hale getirilebileceğine dair dikkat çekici bir araştırma örneği sunuyor. Model, aracın tamamen rastgele deneme-yanılma ile öğrenmesi yerine, büyük dil modeli yönlendirmesi, geçmiş deneyim hafızası ve çarpışma tahmin katmanı kullanıyor.
Simülasyon sonuçları, bu hibrit yaklaşımın klasik DQN yöntemine göre bazı performans ölçütlerinde daha iyi sonuçlar verebildiğini gösteriyor. Ancak bu sonuçlar gerçek trafik için doğrudan güvenlik kanıtı değildir.
Yine de çalışma, yapay zekâ araştırmalarında önemli bir noktayı hatırlatıyor:
Geleceğin akıllı sistemleri yalnızca hızlı karar veren değil, kararlarını geçmiş deneyimle karşılaştıran, riskleri önceden değerlendiren ve gerektiğinde güvenli alternatife dönebilen sistemler olmak zorunda.
Kaynak ve Yöntem Notu
Bu içerik, Kangyu Wu, Peng Cui, Guoxi Chen ve Ya Zhang tarafından hazırlanan “SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving” başlıklı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Bu çalışma preprint niteliğindedir ve hakem değerlendirmesinden geçmemiştir. İçerik bilgilendirme ve eğitim amacı taşır. Otonom araç geliştirme, ulaşım güvenliği, mühendislik uygulaması veya yapay zekâ sistemi tasarımı konusunda profesyonel danışmanlık yerine geçmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir