

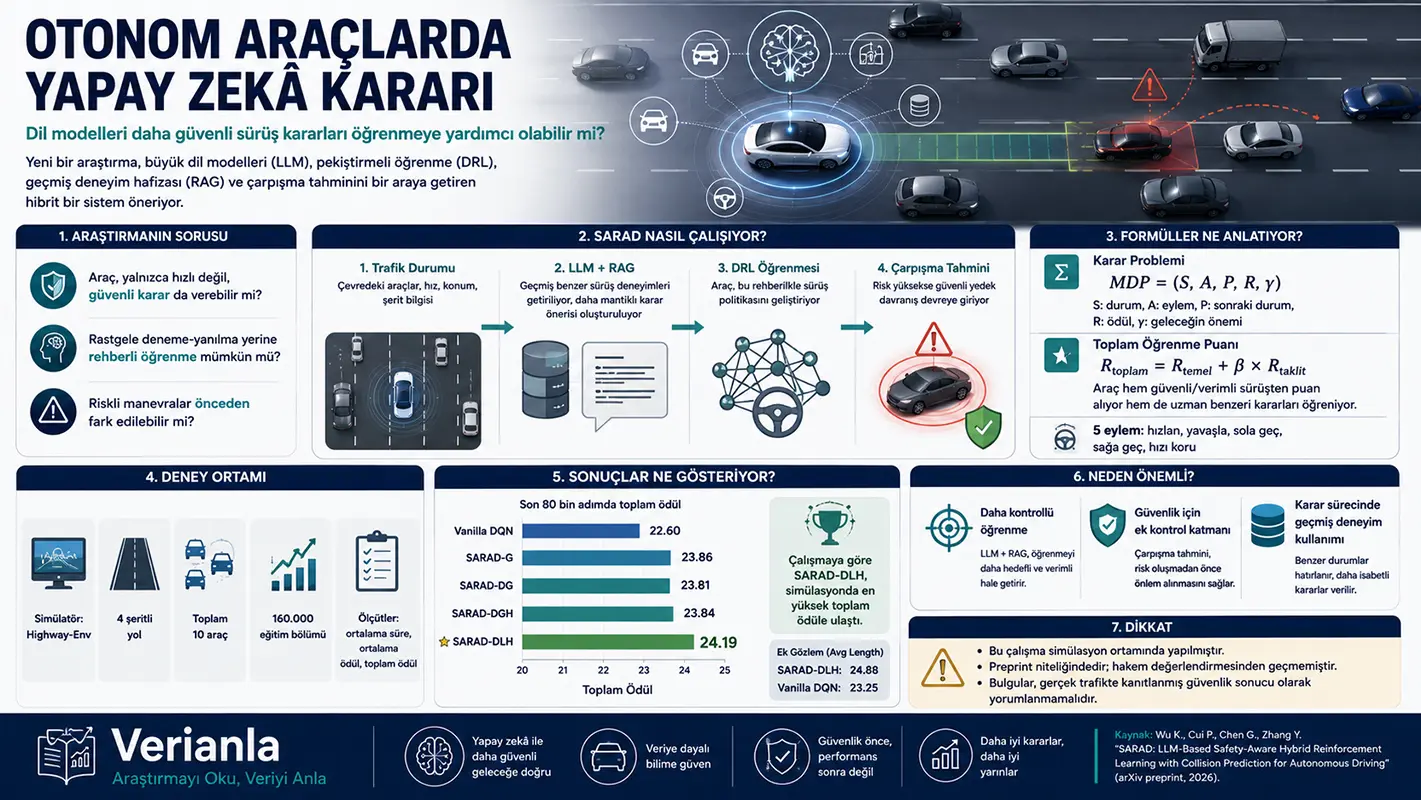
Avtonom Avtomobil Üçün Əsas Problem: “İndi Nə Etməliyəm?”
Avtonom avtomobil yolda hərəkət edərkən fasiləsiz qərar verməlidir. Qarşıdakı avtomobil yavaşlayıbsa, əyləcləməlidirmi? Yan zolaq boşdursa, zolağı dəyişməlidirmi? Sürəti artırmaq təhlükəsizdirmi? Yoxsa mövcud sürəti saxlamaq daha doğrudur?
İnsan sürücülər bu qərarları təcrübə, diqqət və intuisiya ilə verir. Süni intellekt sistemlərində isə bu qərarlar rəqəmsal məlumatlarla modelləşdirilir. Avtomobil öz mövqeyini, sürətini, ətrafdakı avtomobillərin yerini və hərəkətini qiymətləndirərək növbəti hərəkəti seçməyə çalışır.
Bu məqalənin çıxış nöqtəsi də məhz buradan başlayır:
Avtonom avtomobil həm sürətli, həm də təhlükəsiz qərar verə bilərmi?
Ənənəvi Dərin Möhkəmləndirici Öyrənmə üsulları, yəni DRL, avtomobilə sınaq-səhv yolu ilə davranış öyrədir. Lakin bu üsul öyrənmənin ilk mərhələlərində təsadüfi hərəkətlər sınaya bilər. Avtonom sürmə kimi təhlükəsizlik baxımından kritik sahələrdə bu ciddi problemdir. Çünki real həyatda təsadüfi zolaq dəyişmək, qəfil sürətlənmək və ya yanlış anda əyləcləmək qəbul edilə bilən öyrənmə üsulu deyil.
Böyük Dil Modelləri isə yol vəziyyətini mətn kimi şərh edib daha məntiqli təkliflər verə bilər. Lakin onların da başqa problemi var: real vaxt rejimində qərarvermədə gecikmə yarana bilər. Avtonom avtomobildə qərarın yalnız düzgün olması kifayət deyil; vaxtında verilməsi də vacibdir.
SARAD adlı sistem bu iki yanaşmanı birləşdirməyə çalışır. Dil modeli öyrənmənin erkən mərhələsində avtomobilə daha mənalı istiqamətləndirmə verir. Möhkəmləndirici öyrənmə sistemi isə zamanla sürətli qərar verə bilən siyasət öyrənir. Əlavə olaraq, toqquşma proqnozu qatı təklif olunan qərarın riskli olub-olmadığını yoxlayır.
Tədqiqatçılar Sistemi Necə Qurublar?
İşdə avtonom avtomobil problemi qərar prosesi kimi modelləşdirilir. Sadələşdirərək belə düşünə bilərik:
Avtomobil hər an ətraf mühiti müşahidə edir. Bu müşahidədə avtomobilin öz mövqeyi və sürəti ilə digər avtomobillərin mövqe və sürət məlumatları var. Sonra sistem beş əsas hərəkətdən birini seçir:
- Sürəti artır
- Sürəti azaldır
- Sola zolaq dəyiş
- Sağa zolaq dəyiş
- Mövcud sürəti saxla
Bu quruluş məqalədə Markov Decision Process, yəni Markov Qərar Prosesi kimi təsvir edilir:
MDP = (S, A, P, R, γ)
Bu formulu oxucu üçün belə izah etmək olar:
S avtomobilin gördüyü vəziyyətdir. Yəni yol, avtomobillərin mövqeyi, sürətlər və ətraf mühit məlumatı.
A avtomobilin seçə biləcəyi hərəkətlərdir. Məsələn, sürəti artırmaq və ya zolağı dəyişmək.
P bir hərəkətdən sonra mühitin necə dəyişə biləcəyini təmsil edir.
R seçilən hərəkətin nə qədər yaxşı və ya pis olduğunu göstərən mükafatdır.
γ sistemin gələcək mükafatlara nə qədər əhəmiyyət verəcəyini müəyyən edən əmsaldır.
Buradakı məntiq sadədir: avtomobil yalnız “indi nə yaxşıdır?” sualına baxmır. Eyni zamanda “bu hərəkət bir az sonra nəyə səbəb olacaq?” sualını da nəzərə almağa çalışır.
Avtomobil Ətraf Mühiti Necə Rəqəmlərə Çevirir?
Məqalədə avtomobilin gördüyü yol mühiti aşağıdakı məlumatlarla təmsil olunur:
st = avtomobilin mövqeyi + avtomobilin sürəti + ətrafdakı avtomobillərin mövqeyi və sürəti
Yəni sistem üçün yol səhnəsi əslində fotoşəkil deyil, rəqəmsal cədvəl kimidir. Hər avtomobil üçün təxminən bu məlumatlardan istifadə olunur:
- x mövqeyi
- y mövqeyi
- x istiqamətində sürəti
- y istiqamətində sürəti
Bunu gündəlik dillə belə izah edə bilərik:
Avtonom avtomobil “qarşımdakı avtomobil məndən neçə metr irəlidədir, hansı sürətlə gedir, yan zolaqdakı avtomobil mənə yaxınlaşırmı?” kimi məlumatları rəqəmsal şəkildə izləyir.
Bu vacibdir, çünki süni intellekt qərarını bu rəqəmlər əsasında verir. İnsan sürücü güzgüyə baxıb intuitiv qərar verdiyi halda, süni intellekt ətraf mühiti koordinat və sürət dəyərləri ilə anlamağa çalışır.
Sistemin Öyrənmə Məntiqi: Yaxşı Qərara Mükafat, Riskli Qərara Cəza
Möhkəmləndirici öyrənmədə sistem etdiyi hərəkətlərdən bal alaraq öyrənir. Məqalədəki mükafat sistemi də bu məntiqə əsaslanır.
Tədqiqatçılar iki növ mükafatdan istifadə edirlər:
Birincisi, avtomobilin öz sürmə uğurunu ölçən əsas mükafatdır. Avtomobil təhlükəsiz və səmərəli irəliləyərsə, mükafat artır. Toqquşma baş verərsə, cəza alır.
İkincisi, dil modelinin təklif etdiyi davranışa yaxınlıqla bağlı əlavə mükafatdır. Bu, avtomobilin öyrənmə zamanı tamamilə təsadüfi hərəkətlər etmək əvəzinə dil modelinin daha məntiqli hesab etdiyi hərəkətlərə yaxın qalmasına kömək edir.
Məqalədə bu ümumi quruluş belə göstərilir:
Rtotal = Rorigin + β × Rimit
Bu formulun sadə mənası belədir:
Ümumi öyrənmə balı = sürmədən gələn əsas bal + dil modelinin təklifinə yaxınlıqdan gələn əlavə bal
Buradakı Rorigin avtomobilin sürət, irəliləyiş və toqquşma vəziyyətinə görə aldığı əsas baldır.
Rimit avtomobilin hərəkətinin dil modeli ilə dəstəklənən “ekspert təklifinə” nə qədər bənzədiyini göstərir.
β bu əlavə mükafatın ümumi qərarda nə qədər təsirli olacağını müəyyən edən çəkidir.
Burada mühüm fərq var: sistem dil modelini kor-koranə təqlid etmir. Dil modeli müəllim kimi davranır, lakin son qərar zamanla öyrənmə sistemi tərəfindən inkişaf etdirilir. Bunu “müəllim dəstəkli öyrənmə” ilə “öz təcrübəsindən öyrənmə” arasında körpü kimi düşünmək olar.
SARAD-ın Üç Əsas Hissəsi
Məqalədə verilən sistem sxeminə görə SARAD üç əsas hissədən ibarətdir.
Birinci hissə DRL sistemidir. Bu bölmə avtomobilin sürmə siyasətini öyrənir. Yəni hansı vəziyyətdə hansı hərəkətin daha uyğun ola biləcəyini zamanla inkişaf etdirir.
İkinci hissə LLM və RAG sistemidir. LLM, yəni Böyük Dil Modeli, yol səhnəsini mətn kimi şərh edir. RAG sistemi isə əvvəlki sürmə təcrübələrindən oxşar vəziyyətləri taparaq dil modelinə dəstək verir. Beləliklə, model yalnız ümumi biliyi ilə deyil, əvvəllər qeydə alınmış oxşar sürmə nümunələri ilə də qərar yaradır.
Üçüncü hissə toqquşma proqnozu moduludur. Bu modul təklif olunan hərəkətin riskli olub-olmadığını proqnozlaşdırmağa çalışır. Sistem “bu hərəkət toqquşma riski daşıya bilər” nəticəsinə gələrsə, qayda əsaslı təhlükəsizlik davranışı işə düşə bilər.
Bu quruluşu insan sürücüsü nümunəsi ilə düşünək:
- DRL davamlı məşq edən sürücü kimidir.
- LLM təcrübəli təlimatçının şərhləri kimidir.
- RAG keçmişdə baş vermiş oxşar hadisələrin yaddaşı kimidir.
- Toqquşma proqnozu modulu isə “dayan, bu hərəkət təhlükəli ola bilər” deyən təhlükəsizlik yoxlaması kimidir.
RAG Sistemi Nəyə Xidmət Edir?
RAG “Retrieval-Augmented Generation” ifadəsinin qısaltmasıdır. Azərbaycan dilində təxminən “geri gətirmə ilə gücləndirilmiş generasiya” kimi ifadə oluna bilər.
Bu sistemin məqsədi dil modelinin yalnız öz ümumi biliyinə əsaslanmasının qarşısını almaqdır. SARAD-da avtomobil sürmə zamanı bəzi təcrübələri qeydə alır. Məsələn:
- Hansı vəziyyətdə hansı qərar verildi?
- Bu qərar təhlükəsiz idimi?
- Toqquşma baş verdimi?
- Avtomobil hansı sürətdə idi?
- Yaxınlıqdakı avtomobillər necə hərəkət edirdi?
Daha sonra oxşar vəziyyət yarandıqda sistem keçmişdəki oxşar təcrübələri tapıb dil modelinə əlavə məlumat kimi təqdim edir.
Bu, gündəlik həyatda belə bir vəziyyətə bənzəyir:
Sürücü əvvəl təhlükəli yolayrıcında qəfil zolaq dəyişməyin riskli olduğunu yaşayıbsa, oxşar vəziyyətdə daha ehtiyatlı davrana bilər. SARAD-ın RAG modulu da süni intellektə buna bənzər yaddaş qazandırmağa çalışır.
Toqquşma Proqnozu Modulu Niyə Vacibdir?
Bu işin ən mühüm təhlükəsizlik hissələrindən biri toqquşma proqnozu moduludur. Çünki süni intellektin təklif etdiyi hər qərar düzgün olmaya bilər.
Məqalədə bu modul təklif olunan hərəkətin toqquşma riski daşıyıb-daşımadığını proqnozlaşdırmaq üçün hazırlanıb. Sistem vəziyyət və hərəkət məlumatını qəbul edir, sonra bu hərəkətin riskli olub-olmadığını qiymətləndirir.
Sadə şəkildə belə düşünə bilərik:
Avtomobil “sol zolağa keç” qərarı verərsə, təhlükəsizlik modulu bu sualı verir:
“Sol zolağa keçsək, yaxınlıqdakı avtomobillərlə toqquşma ehtimalı varmı?”
Risk yüksək görünərsə, sistem bu qərarı birbaşa tətbiq etmək əvəzinə daha təhlükəsiz davranışa keçə bilər. Məqalədə belə ehtiyat təhlükəsizlik davranışları arasında təcili əyləcləmə, zolaqda qalma və təhlükəsiz məsafəni qoruma kimi seçimlər göstərilir.
Bu hissə vacibdir, çünki avtonom sistemlərdə yalnız qərar yaratmaq kifayət deyil. Qərar tətbiq edilməzdən əvvəl təhlükəsizlik baxımından yoxlanmalıdır.
Təcrübə Necə Aparılıb?
Tədqiqatçılar sistemi real yol hərəkətində deyil, Highway-Env adlı simulyasiya mühitində sınaqdan keçiriblər. Simulyasiyada dörd zolaqlı yol istifadə olunub. Hər zolağın eni 4 metr müəyyən edilib. Mühitdə ümumilikdə 10 hərəkətdə olan avtomobil var; onlardan biri qərar verən avtonom avtomobildir.
Avtomobilin seçə biləcəyi hərəkətlər yenə beş seçimlə məhdudlaşdırılıb:
- Sola zolaq dəyiş
- Sağa zolaq dəyiş
- Sürəti artır
- Sürəti azaldır
- Sürəti saxla
Təcrübələrdə bir epizod iki halda başa çatır: avtomobil toqquşarsa və ya sürmə müddəti 40 saniyəni keçərsə.
Tədqiqatçılar uğuru üç meyarla qiymətləndiriblər:
1. Orta sürmə müddəti
Avtomobil toqquşmadan və ya epizod bitmədən nə qədər müddət hərəkət edə bildi?
2. Orta mükafat
Avtomobil hər addımda nə qədər yaxşı qərar verdi?
3. Ümumi mükafat
Bütün epizod ərzində toplanan ümumi performans nə oldu?
Bu üç meyar birlikdə oxunmalıdır. Yalnız uzun müddət hərəkət etmək kifayət deyil; avtomobil eyni zamanda səmərəli və təhlükəsiz qərarlar da verməlidir.
Qrafiklər və Cədvəllər Nə Göstərir?
Məqalədə SARAD-ın müxtəlif versiyaları klassik DQN üsulu ilə müqayisə olunub.
Klassik DQN möhkəmləndirici öyrənmənin əsas üsullarından biridir. Bu işdə müqayisə bazası kimi istifadə olunub. SARAD versiyaları isə sistemə müxtəlif əlavə hissələrin qoşulduğu variantlardır.
Cədvəl II bütün təlim prosesi ərzində əldə olunan nəticələri göstərir. Burada SARAD-DGH modeli orta mükafat və ümumi mükafat baxımından ən yüksək dəyəri alır. SARAD-DLH isə orta sürmə uzunluğu baxımından seçilir.
Məsələn, bütün proses üzrə:
- Vanilla DQN ümumi mükafat: 20.6767
- SARAD-DGH ümumi mükafat: 21.5301
- SARAD-DLH ümumi mükafat: 21.4075
Bu cədvəl SARAD ailəsindəki modellərin simulyasiya daxilində klassik DQN ilə müqayisədə daha yaxşı nəticələr verə bildiyini düşündürür.
Cədvəl III isə təlimin son 80 min addımına baxır. Bu hissə vacibdir, çünki modelin öyrənmə prosesinin daha yetkin mərhələsini göstərir.
Son 80 min addımda:
- Vanilla DQN ümumi mükafat: 22.5967
- SARAD-G ümumi mükafat: 23.8556
- SARAD-DG ümumi mükafat: 23.8098
- SARAD-DGH ümumi mükafat: 23.8439
- SARAD-DLH ümumi mükafat: 24.1935
Bu nəticələrdə SARAD-DLH ən yüksək ümumi mükafata çatır. SARAD-DLH modelində LLM əsaslı toqquşma proqnozu modulu ilə RAG dəstəkli quruluş birlikdə istifadə olunur. Bu da tədqiqatçıların təklif etdiyi təhlükəsizlik qatının öyrənmənin son mərhələlərində daha güclü performans göstərə bildiyini düşündürür.
Qrafiklərdə də oxşar tendensiya görünür. Təlim irəlilədikcə bütün modellərin performansı artır. Lakin SARAD modelləri xüsusilə sonrakı mərhələlərdə DQN ilə müqayisədə daha yüksək və daha sabit xətlərə çata bilir. Bununla belə, məqalə qrafiklərin yalnız bir təmsilçi təlim gedişini göstərdiyini bildirir. Buna görə nəticələr güclü işarə versə də, fərqli ssenarilərlə yenidən sınaqdan keçirilməlidir.
Bu İşdən Nə Öyrənirik?
Bu məqalə mühüm bir fikir verir: süni intellekt sistemlərində yalnız bir üsula güvənmək əvəzinə müxtəlif üsulları birlikdə istifadə etmək daha balanslı nəticələr verə bilər.
Möhkəmləndirici öyrənmə sürətli qərar verməyi öyrənə bilər, lakin başlanğıcda riskli sınaqlar edə bilər. Böyük dil modelləri daha izaholunan və məntiqli təkliflər verə bilər, lakin real vaxt qərarı üçün ləng qala bilər. RAG sistemi keçmiş təcrübəni işə sala bilər. Toqquşma proqnozu modulu isə təklif olunan qərarları təhlükəsizlik yoxlamasından keçirə bilər.
Bu birləşmə avtonom avtomobil tədqiqatlarında daha təhlükəsiz və daha izaholunan qərar sistemlərinin hazırlanması üçün mühüm istiqamət təqdim edir.
Buradakı əsas dərs budur:
Avtonom avtomobillərdə süni intellekt yalnız “nə edəcəyini” bilməməli, eyni zamanda “bu qərar təhlükəsizdirmi?” sualını da verməlidir.
Bu Niyə Vacibdir?
Avtonom sürmə texnologiyaları yalnız avtomobillər üçün deyil, gələcəkdə logistika, ictimai nəqliyyat, robot sistemləri, ağıllı şəhərlər və sənaye avtomatlaşdırması üçün də əhəmiyyət daşıyır.
Belə sistemlərdə qərar xətası yalnız texniki xəta deyil; təhlükəsizlik riski yarada bilər. Buna görə süni intellekt modellərinin sadəcə yüksək performans göstərməsi kifayət deyil. Qərar proseslərinin izlənilə bilən, izaholunan və təhlükəsizlik qatları ilə dəstəklənən olması lazımdır.
SARAD yanaşması bu baxımdan öyrədici nümunə təqdim edir. Sistem dil modelini birbaşa sürücü yerinə yerləşdirmir. Əvəzində dil modelini bələdçi, möhkəmləndirici öyrənməni sürmə siyasətini öyrənən komponent, toqquşma proqnozu modulunu isə təhlükəsizlik nəzarət nöqtəsi kimi istifadə edir.
Bu fərq vacibdir. Çünki real dünyada təhlükəsizlik baxımından kritik sistemlərdə süni intellekt qərarlarının nəzarətsiz tətbiqi əvəzinə, çoxqatlı nəzarət quruluşları daha mənalı tədqiqat istiqaməti ola bilər.
Diqqət Edilməli Məqamlar
Bu işin nəticələri ehtiyatla oxunmalıdır.
Birincisi, iş real yol hərəkətində deyil, simulyasiya mühitində aparılıb. Simulyasiyalar tədqiqat üçün faydalıdır, lakin real yolda insan davranışı, hava şəraiti, sensor xətaları, yol qüsurları və gözlənilməz hadisələr daha mürəkkəbdir.
İkincisi, iş preprintdir. Yəni rəyçi qiymətləndirməsindən keçməyib. Nəticələr müstəqil akademik qiymətləndirmə və müxtəlif təcrübələrlə dəstəklənmədən qəti qəbul edilməməlidir.
Üçüncüsü, məqalədəki qrafiklər yalnız bir təmsilçi təlim işini göstərir. Fərqli başlanğıc şərtləri və müxtəlif yol ssenariləri nəticələri dəyişə bilər.
Dördüncüsü, LLM əsaslı sistemlərdə gecikmə hələ də mühüm problemdir. Tədqiqatçılar bu gecikməni azaltmaq üçün LLM-dən daha çox öyrənmənin erkən mərhələsində istifadə etməyi təklif edirlər. Lakin real vaxt avtonom sürmə sistemlərində bu məsələ çox həssas şəkildə sınaqdan keçirilməlidir.
Nəhayət, toqquşma proqnozu modulu təhlükəsizlik baxımından mühüm fikir versə də, belə sistemin real yol hərəkətində istifadəsi üçün daha geniş sınaqlara, təhlükəsizlik doğrulamalarına və hüquqi/texniki qiymətləndirmələrə ehtiyac var.
Nəticə
SARAD işi avtonom avtomobillərdə süni intellekt qərarlarının necə daha təhlükəsiz və öyrədici hala gətirilə biləcəyinə dair diqqətçəkən tədqiqat nümunəsi təqdim edir. Model avtomobilin tamamilə təsadüfi sınaq-səhvlə öyrənməsi əvəzinə böyük dil modeli istiqamətləndirməsi, keçmiş təcrübə yaddaşı və toqquşma proqnozu qatından istifadə edir.
Simulyasiya nəticələri bu hibrid yanaşmanın klassik DQN üsulu ilə müqayisədə bəzi performans meyarlarında daha yaxşı nəticələr verə bildiyini göstərir. Lakin bu nəticələr real yol hərəkəti üçün birbaşa təhlükəsizlik sübutu deyil.
Bununla belə, iş süni intellekt tədqiqatlarında mühüm məqamı xatırladır:
Gələcəyin ağıllı sistemləri yalnız sürətli qərar verən deyil, qərarlarını keçmiş təcrübə ilə müqayisə edən, riskləri əvvəlcədən qiymətləndirən və lazım gəldikdə təhlükəsiz alternativə keçə bilən sistemlər olmalıdır.
Mənbə və Metod Qeydi
Bu məzmun Kangyu Wu, Peng Cui, Guoxi Chen və Ya Zhang tərəfindən hazırlanmış “SARAD: LLM-Based Safety-Aware Hybrid Reinforcement Learning with Collision Prediction for Autonomous Driving” adlı akademik işdən istifadə edilməklə Verianla redaksiya formatında orijinal şəkildə hazırlanıb.
Bu iş preprint xarakterlidir və rəyçi qiymətləndirməsindən keçməyib. Məzmun məlumatlandırma və təhsil məqsədi daşıyır. Avtonom avtomobil hazırlanması, nəqliyyat təhlükəsizliyi, mühəndislik tətbiqi və ya süni intellekt sistemi dizaynı üzrə peşəkar məsləhəti əvəz etmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib