

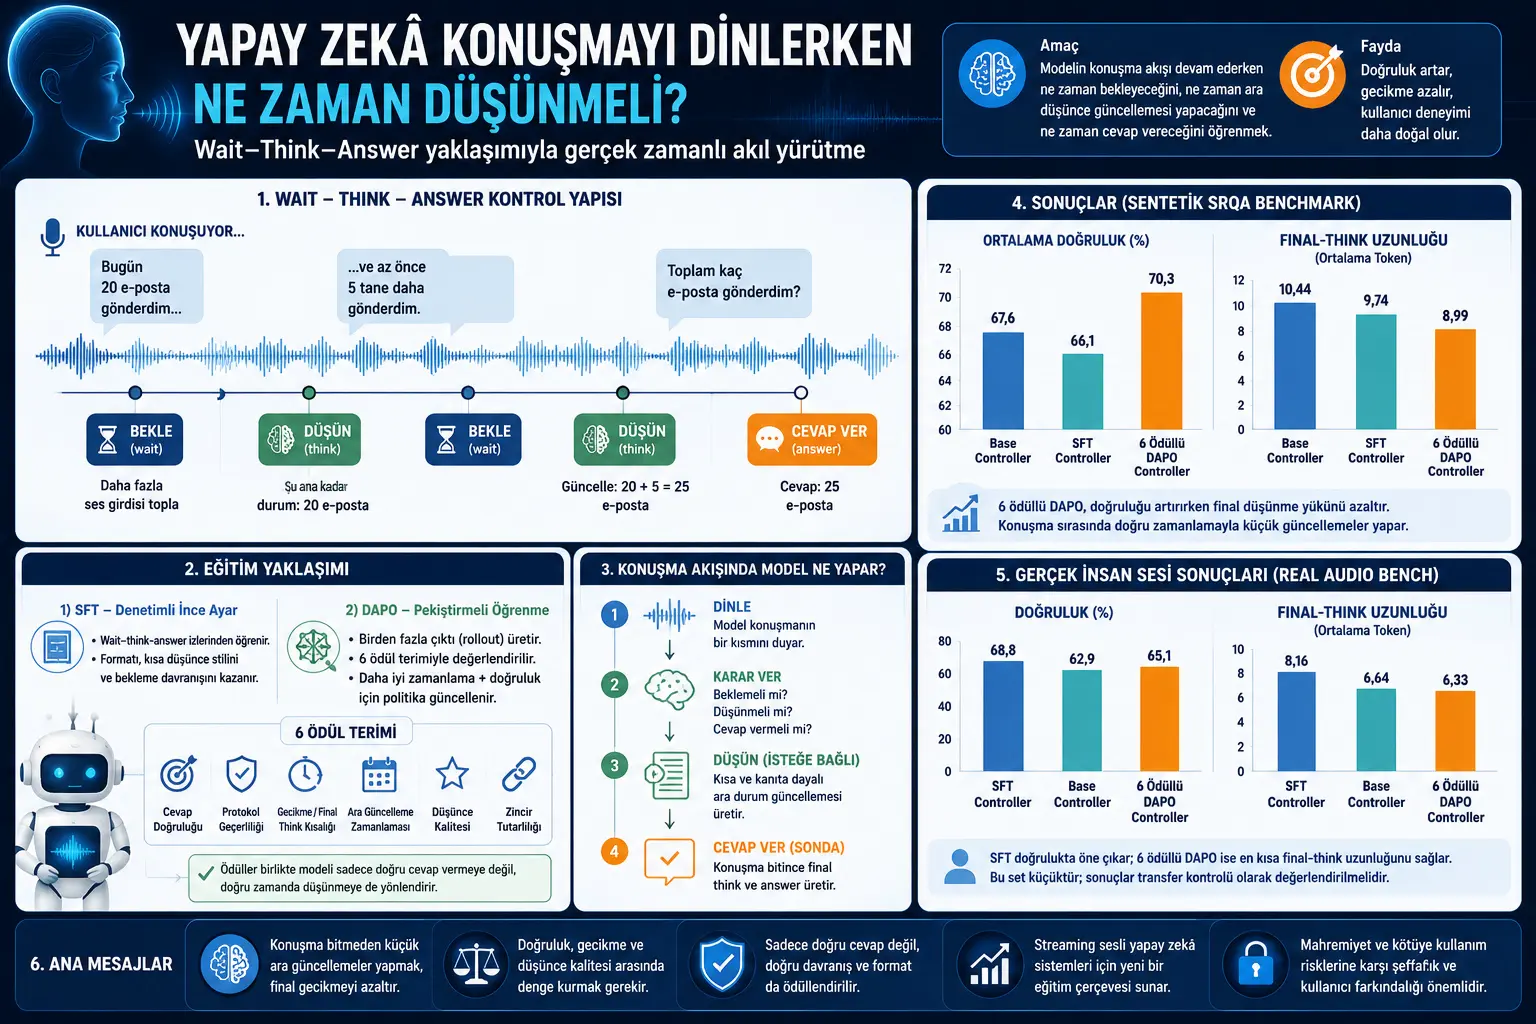
Güncel büyük ses-dil modelleri, konuşmayı algılayıp metin veya sesli cevap üretebiliyor. Ancak gerçek zamanlı konuşma etkileşiminde yalnızca doğru cevap vermek yeterli değildir. Model çok geç cevap verirse kullanıcı uzun bir sessizlik yaşar. Çok erken cevap verirse, konuşmanın sonundaki kritik bilgiyi kaçırabilir.
Bu çalışma, bu dengeyi wait-think-answer adı verilen bir kontrol yapısıyla ele alıyor. Modelin üç temel eylemi var: bekle, ara düşünce/güncelleme üret, cevap ver. Bekleme eylemi daha fazla ses girdisi toplamayı sağlar. Think eylemi, o ana kadar duyulan bilgiye dayalı kısa bir ara durum güncellemesi üretir. Answer eylemi ise nihai cevabı verir.
Önerilen yaklaşım, Qwen2.5-Omni-7B tabanlı bir ses-dil modeli üzerinde deneniyor. Önce denetimli ince ayar yani SFT ile model bu eylem dilini öğreniyor. Ardından DAPO adlı reinforcement learning tabanlı politika optimizasyonuyla modelin yalnızca doğru cevap vermesi değil; doğru zamanda düşünmesi, gereksiz uzun düşünmemesi, formatı bozmaması ve cevapla ara düşünceler arasında tutarlılık kurması ödüllendiriliyor.
Sonuçlar, streaming konuşma modellerinde “düşünmeyi sona bırakmak” yerine, konuşma sırasında küçük ve anlamlı ara güncellemeler yapmanın cevap doğruluğu ile gecikme arasındaki dengeyi iyileştirebileceğini gösteriyor.
Problem Ne?
Klasik sesli soru-cevap sistemlerinde model genellikle kullanıcı konuşmasını tamamen dinler, sonra düşünür ve cevap verir. Bu yöntem değerlendirme için kolaydır; çünkü model tüm girdiyi gördükten sonra tek bir cevap üretir. Ancak gerçek zamanlı asistan deneyiminde bu doğal değildir.
Canlı konuşmada kullanıcı cümlesini parça parça kurar. Bazen kritik bilgi en başta gelir, bazen son anda gelen bir ifade cevabı değiştirir. Örneğin kullanıcı “Bugün 20 e-posta gönderdim…” dedikten sonra model erken cevap verirse 20 diyebilir; ama kullanıcı “...ve az önce 5 tane daha gönderdim” diye devam ederse doğru cevap 25 olur.
Bu durumda sesli yapay zekâ için üçlü bir gerilim oluşur:
1. Doğruluk: Model yeterli kanıt gelmeden cevap verirse hata yapabilir.
2. Gecikme: Model bütün konuşma bittikten sonra uzun uzun düşünürse kullanıcı bekler.
3. Ara akıl yürütme kalitesi: Model konuşma sırasında ara güncelleme yapacaksa bu güncellemeler kısa, doğru, kanıta bağlı ve sonraki cevabı destekler nitelikte olmalıdır.
Makalenin temel sorusu şudur: Büyük ses-dil modeli, konuşma akışı devam ederken ne zaman bekleyeceğini, ne zaman kısa ara güncelleme yapacağını ve ne zaman nihai cevap vereceğini öğrenebilir mi?
Yöntem Ne Öneriyor?
Çalışma, streaming konuşma akıl yürütmesini bir online kontrol problemi olarak tanımlıyor. Model, ses akışı boyunca belirli karar anlarında o ana kadar duyduğu ses ön ekini ve daha önce ürettiği ara durum güncellemelerini görür. Sonra üç eylemden birini seçer:
<wait/>: Model cevap veya düşünce üretmez, daha fazla ses girdisi bekler.
<think>...</think>: Model o ana kadar duyduğu kanıta dayalı kısa bir ara durum güncellemesi üretir. Bu, modelin iç hesaplamasını tamamen açması anlamına gelmez; sistemin görünür, kısa ve görev odaklı bir durum notu üretmesidir.
<answer>...</answer>: Model nihai cevabı verir. Bu çalışmada cevap verme eylemi konuşma sonrasına kapılanmıştır; yani deneylerde model konuşma bitmeden final cevap vermeyi öğrenmiyor, asıl odak konuşma sırasında bekleme ve ara güncelleme yapma zamanlamasıdır.
Yöntem iki aşamalı eğitim kullanıyor:
1. SFT yani supervised fine-tuning: Model, hazırlanmış wait-think-answer izleriyle eylem formatını, kısa düşünce stilini, bekleme davranışını ve final cevap yapısını öğreniyor.
2. DAPO policy optimization: Model, daha sonra ödül fonksiyonuyla optimize ediliyor. Ödül yalnızca final cevabın doğruluğuna bakmıyor. Format geçerliliği, cevap gecikmesi, ara güncelleme zamanlaması, düşünce kalitesi ve zincir tutarlılığı da birlikte değerlendiriliyor.
Bu yaklaşımın amacı, modelin tüm akıl yürütmeyi konuşma bittikten sonraya yığmasını engellemek. Eğer model kritik bilgiler geldikçe kısa ara güncellemeler yaparsa, final cevap öncesinde kalan düşünme yükü azalabilir.
Formüller Ne Anlatıyor?
PDF’teki formüller, wait-think-answer kontrol yapısını, ödül fonksiyonunu ve DAPO optimizasyonunu açıklıyor. Aşağıdaki formüller MathJax uyumlu biçimde verilmiştir.
1. Kontrolcü gözlemi ve eylem seçimi
\[ o_k=(x_{1:t_k},z_{
Burada \(o_k\), \(k\). karar anındaki kontrolcü gözlemidir. \(x_{1:t_k}\), o ana kadar duyulan ses ön ekini; \(z_{
2. Geçerli trajectory için şekillendirilmiş ödül
Bu formül, geçerli bir wait-think-answer akışı için toplam ödülü gösterir. \(R_a\) cevap doğruluğunu, \(R_f\) format geçerliliğini, \(R_s\) gecikme/final-think kısalığını, \(R_u\) ara güncelleme zamanlamasını, \(R_t\) düşünce kalitesini, \(R_c\) ise düşünce zinciri ile final cevap arasındaki tutarlılığı temsil eder.
Önemli ayrıntı şudur: Tutarlılık bonusu yalnızca cevap doğruysa devreye girer. Yani model yanlış bir cevaba tutarlı ama hatalı bir açıklama ürettiği için ekstra ödül alamaz.
3. Protokol kapılı final ödül
Bu formül, format/protokol geçerliliğinin öncelikli olduğunu gösterir. Eğer model yanlış sırada cevap verirse, gerekli etiketleri bozarsa veya geçersiz bir eylem dizisi üretirse final cevabın doğru olması onu kurtarmaz. Önce etkileşim protokolü doğru olmalıdır.
4. Kullanılan ödül ağırlıkları
Bu ağırlıklar, ödül bileşenlerinin göreli önemini belirler. Özellikle \(\lambda_u=3.0\), ara güncelleme zamanlamasına güçlü ağırlık verildiğini gösterir. Yani modelin yalnızca düşünce üretmesi değil, doğru anda düşünce üretmesi önemlidir.
5. DAPO grup-göreli avantaj hesabı
Bu formül, aynı prompt için üretilen \(G\) rollout arasında \(i\). rollout’un göreli avantajını hesaplar. Bir çıktı gruptaki ortalamadan daha iyi ödül aldıysa pozitif avantaj alır; daha kötüyse negatif avantaj alır. Bu, modelin hangi eylem dizilerinin daha iyi olduğunu grup içinde öğrenmesine yardım eder.
6. Token düzeyli DAPO hedefi
Bu formül, DAPO’nun token düzeyinde kırpılmış politika güncellemesini gösterir. \(M\), tamamlanma tokenlarının maskesidir. \(r_{i,t}\), yeni politika ile eski politika arasındaki olasılık oranıdır. Pozitif avantajlı tokenlar güçlendirilir; negatif avantajlı tokenlar zayıflatılır. Kırpma, güncellemenin aşırı büyümesini engeller.
7. Politika oranı
Bu ifade, yeni politikanın belirli bir tokenı üretme olasılığının eski politikaya göre ne kadar değiştiğini gösterir. Büyük değişimler kırpma mekanizmasıyla sınırlanır. Bu, RL eğitimini daha kararlı hâle getirir.
Grafik, Tablo ve Şema Ana Mesajı
Sayfa 3’teki Figure 1: Şema, modelin konuşmayı parça parça dinlediğini ve her karar adımında ya beklediğini, ya kısa bir ara düşünce güncellemesi yaptığını ya da en sonda cevap verdiğini gösteriyor. “20 e-posta gönderdim, 5 tane daha gönderdim” örneği üzerinden modelin önce “şu ana kadar 20” diye ara durum tuttuğu, sonra “20 + 5 = 25” güncellemesiyle final cevaba hazırlandığı anlatılıyor. Ana mesaj: Model tüm düşünmeyi konuşma sonrasına bırakmak yerine, konuşma sırasında küçük ve doğru durum güncellemeleri biriktirebilir.
Sayfa 5’teki Table 1: Ödül terimleri altı başlıkta özetleniyor: cevap doğruluğu, protokol geçerliliği, gecikme, ara güncelleme zamanlaması, düşünce kalitesi ve zincir tutarlılığı. Tablo, çalışmanın yalnızca “doğru cevap ver” ödülüyle yetinmediğini; konuşma boyunca doğru davranış biçimini de eğittiğini gösteriyor.
Sayfa 6’daki Figure 2: Ödül sisteminin bir wait-think-answer akışını nasıl değerlendirdiği gösteriliyor. Kural tabanlı terimler formatı, zamanlamayı, doğruluğu ve final gecikmeyi kontrol ediyor; judge destekli terimler ise ara düşünce kalitesi ve final cevaba destek veren tutarlılığı değerlendiriyor. Ana mesaj: İyi model, sadece doğru final cevabı veren değil; doğru zamanda, kısa ve işe yarar ara güncellemeler yapan modeldir.
Sayfa 8’deki Table 2: Sentetik konuşmalı SRQA sonuçlarında altı ödüllü DAPO kontrolcü, Qwen streaming controller ailesinde en iyi ortalama doğruluğu veriyor. Base controller ortalama %67,6 doğruluk ve 10,44 final-think token uzunluğu gösterirken, altı ödüllü DAPO %70,3 doğruluk ve 8,99 final-think uzunluğu sağlıyor. Bu tablo, modelin hem doğruluk hem de residual reasoning yükü açısından iyileştiğini gösteriyor.
Sayfa 8’deki Figure 3: Base controller ile altı ödüllü DAPO’nun görev bazlı doğrulukları karşılaştırılıyor. DAPO özellikle ARC-E, SIQA, PIQA ve GSM8K gibi görevlerde iyileşme gösteriyor. GSM8K ayrı panelde veriliyor çünkü genel doğruluk seviyesi diğer görevlere göre daha düşük kalıyor.
Sayfa 9’daki Table 3: Real Audio Bench sonuçları, insan kaydıyla oluşturulmuş 186 örnek üzerinde aktarılıyor. SFT controller %68,8 doğrulukla en yüksek sonucu verirken, altı ödüllü DAPO %65,1 doğruluk ve 6,33 final-think uzunluğuyla base controller’dan daha kısa final düşünme üreten tek öğrenilmiş varyant olarak öne çıkıyor. Ana mesaj: Gerçek insan sesi testinde sonuçlar daha karmaşık; doğruluk ve düşük gecikme her zaman aynı varyantta birleşmiyor.
Sayfa 14’teki Figure 4: SFT eğitim eğrileri, eğitim ve doğrulama kaybının düştüğünü, token doğruluğunun yükseldiğini gösteriyor. Bu, SFT aşamasının DAPO için sağlam bir başlangıç politikası oluşturduğunu destekliyor.
Sayfa 18’deki ablation tablosu: Ödül terimleri artırıldıkça sentetik SRQA doğruluğu yükseliyor. Base controller %67,6, SFT %66,1, dört ödüllü DAPO %68,5, beş ödüllü DAPO %69,2, altı ödüllü DAPO %70,3 olarak raporlanıyor. Bu tablo, ödül bileşenlerinin kademeli katkısını gösteriyor.
Deneyler Nasıl Yapılmış?
Çalışmada iki ana değerlendirme ortamı kullanılıyor.
1. Sentetik konuşmalı SRQA benchmark: ARC-Easy, ARC-Challenge, PIQA, SocialIQA, GSM8K ve LLaMA-QS olmak üzere altı görev ailesi kullanılıyor. Toplam 8.959 örnek bulunuyor. Metin soruları konuşma biçimine dönüştürülüyor, TTS ile ses hâline getiriliyor ve model bu ses girdileri üzerinden değerlendiriliyor.
2. Real Audio Bench: İnsanlar tarafından kaydedilmiş gerçek seslerden oluşan küçük bir transfer benchmark’ı kullanılıyor. Beş konuşmacı 200 aday örnek kaydediyor; belirsiz veya hatalı örnekler çıkarıldıktan sonra 186 kayıt kalıyor. Bu set büyük ölçekli kullanıcı çalışması değil, TTS dışına aktarım kontrolü olarak değerlendiriliyor.
Model ailesi olarak Qwen2.5-Omni-7B kullanılıyor. SFT aşamasında LoRA ile ince ayar yapılıyor. DAPO aşamasında ise streaming controller rollouts üretiliyor, bu çıktılar altı ödül terimiyle puanlanıyor ve politika token düzeyinde güncelleniyor.
Değerlendirmede iki protokol var:
Offline mode: Model tam konuşmayı dinledikten sonra tek seferde düşünür ve cevap verir. Bu, klasik tam-audio değerlendirme biçimidir.
Deployment mode: Ses 0,5 saniyelik karar ızgarasında gelir. Model her adımda mevcut ses ön ekini ve önceki görünür düşünce durumlarını görür. Konuşma bitmeden bekleme veya ara düşünce üretme eylemlerinden birini seçer. Konuşma sonunda final think ve answer üretir.
Karşılaştırılan modeller arasında Qwen2.5-Omni-7B base controller, SFT controller, dört/beş/altı ödüllü DAPO controller, Audio Flamingo 3, GLM-4-Voice-9B ve literatürde raporlanan Moshi varyantları yer alır. Ancak üçüncü taraf modeller aynı streaming controller arayüzünü açmadığı için doğrudan deployment mode kıyaslaması yalnızca Qwen ailesi içinde yapılır.
Sonuçlar Ne Gösteriyor?
1. Streaming sesli akıl yürütme bir kontrol problemi olarak eğitilebilir. Model yalnızca final cevabı üretmeyi değil, konuşma akışı sırasında ne zaman bekleyeceğini ve ne zaman kısa ara durum güncellemesi yapacağını öğrenebiliyor.
2. Altı ödüllü DAPO sentetik benchmark’ta en iyi dengeyi veriyor. Base controller %67,6 ortalama doğrulukta kalırken, altı ödüllü DAPO %70,3’e çıkıyor. Aynı zamanda final-think uzunluğu 10,44’ten 8,99 token’a iniyor. Bu, düşünmenin bir kısmının konuşma sırasında daha erken ve kısa biçimde yapılabildiğini gösteriyor.
3. SFT tek başına formatı öğretse de görev ödülü kadar yeterli değil. SFT controller, wait-think-answer dilini öğreniyor; ancak sentetik ortalama doğrulukta base controller’ın gerisine düşüyor. DAPO aşaması, göreve hizalı ödül sağlayarak performansı yeniden yukarı taşıyor.
4. Gerçek insan sesinde sonuçlar daha temkinli yorumlanmalı. Real Audio Bench küçük bir veri setidir. SFT en yüksek doğruluğu verirken, altı ödüllü DAPO en kısa final-think uzunluğunu sağlar. Güven aralıkları çakıştığı için bu set kesin model sıralaması yerine transfer kontrolü olarak okunmalıdır.
5. Gecikme yalnızca sistem hızı değildir. Makale final-think uzunluğunu, kullanıcı konuşması bittikten sonra kalan akıl yürütme yükünün bir göstergesi olarak kullanıyor. Yani burada gecikme sadece donanım veya servis süresi değil, modelin düşünmeyi ne kadar sona bıraktığıyla da ilgilidir.
6. Cache-native üretim hâlâ gelecek çalışma alanıdır. Makale, resmi Qwen serving yolunun bu kontrol döngüsü için doğrudan cache-native arayüz sunmadığını; bu nedenle benchmark’ta full-prefix replay kullanıldığını belirtiyor. Ayrı bir prototip, aynı bilgi akışının cache-native uygulanabileceğini gösterse de üretim düzeyinde optimize edilmiş bir konuşma sistemi iddia edilmiyor.
Bu Neden Önemli?
Sesli yapay zekâ asistanları giderek daha gerçek zamanlı hâle geliyor. Kullanıcılar artık sadece metin kutusuna soru yazmıyor; konuşuyor, düzeltiyor, yarım cümleyle başlıyor, son anda kritik bilgi ekliyor. Bu ortamda modelin yalnızca iyi cevap üretmesi değil, konuşma akışını iyi yönetmesi gerekir.
Bu çalışma, sesli asistanlarda “düşünme zamanlaması” problemini görünür kılıyor. Model konuşma bitene kadar hiçbir şey yapmazsa sonradan uzun düşünebilir. Konuşma devam ederken kısa, kanıta dayalı ara güncellemeler yaparsa final gecikme azalabilir. Ancak bu güncellemelerin gereksiz, uzun veya hatalı olmaması gerekir.
Bu fikir; canlı eğitim asistanları, erişilebilirlik araçları, gerçek zamanlı çeviri, toplantı asistanları, çağrı merkezi destek sistemleri ve sesli kullanıcı arayüzleri için önemlidir. Özellikle engelli kullanıcılar, anlık altyazı veya konuşma destek sistemleri kullanan kişiler için gecikme daha büyük kullanıcı deneyimi sorunu yaratabilir.
Aynı zamanda güvenlik ve etik açıdan da önemlidir. Konuşma sırasında düşünebilen sistemler, fark edilmeden dinleyen ve konuşmayı önceden analiz eden araçlara dönüşürse mahremiyet ve manipülasyon riski doğurabilir. Makale bu nedenle eylem alanını bekle/düşün/cevap olarak sınırlıyor ve gereksiz düşünce üretimini cezalandırıyor.
Dikkat Noktaları
1. Çalışma preprinttir. Bulgular nihai hakemli sürüm kesinliğiyle değerlendirilmemelidir.
2. Bu tam optimize edilmiş üretim sistemi değildir. Makale, cache-native serving yerine full-prefix replay tabanlı benchmark kullanır. Bu nedenle gerçek ürün performansı için ek mühendislik gerekir.
3. Real Audio Bench küçüktür. 186 kayıt, aksan, ortam gürültüsü, konuşma stili ve kullanıcı çeşitliliğini tam temsil etmek için yeterli değildir.
4. Ara düşünce görünürlüğü dikkatli tasarlanmalıdır. Modelin görünür ara güncelleme üretmesi, kullanıcıya açıklanabilirlik sağlayabilir; ancak gereksiz veya yanlış ara yorumlar kullanıcıyı yanıltabilir.
5. Final cevap konuşma sonrasına kapılanmıştır. Bu çalışmada modelin konuşma bitmeden nihai cevap vermesi esas öğrenme hedefi değildir. Asıl odak, konuşma sırasında ara düşünce güncellemelerinin zamanlamasıdır.
6. İnsan konuşması çok çeşitlidir. Duraksamalar, aksanlar, hızlı konuşma, gürültü, konu değiştirme ve yarım cümleler gerçek kullanımda model davranışını zorlaştırabilir.
7. Mahremiyet ve kötüye kullanım riski vardır. Kısmi konuşmayı analiz eden sistemler, kullanıcı farkındalığı ve izin mekanizmaları olmadan kullanılmamalıdır. Gerçek zamanlı konuşma analizinde açık bilgilendirme ve güvenlik sınırları önemlidir.
Riskli alan notu: Çalışma, konuşmayı gerçek zamanlı dinleyen ve kısmi ses girdisi üzerinden ara akıl yürütme güncellemeleri yapan yapay zekâ sistemleriyle ilgilidir. Bu tür sistemler erişilebilirlik, canlı çeviri, eğitim ve sesli asistanlar için faydalı olabilir; ancak kullanıcı farkındalığı olmadan konuşmayı izleme, sosyal mühendislik veya mahremiyet ihlali gibi riskler de doğurabilir. Bu yazı teknik bilgilendirme amacı taşır.
Genel değerlendirme: Makale, sesli yapay zekâ asistanlarının önemli bir sorununa odaklanıyor: Kullanıcı konuşurken model beklemeli mi, ara bilgi güncellemesi yapmalı mı, yoksa hemen cevap mı vermeli? İnsan konuşmasında dinleyici çoğu zaman konuşma bitmeden cevaba hazırlanır. Bu çalışma, benzer fikri büyük ses-dil modellerine taşıyarak “dinlerken ne zaman düşünmeli?” sorusunu öğrenilebilir bir kontrol problemi olarak ele alıyor.
Sonuç
Bu makale, büyük ses-dil modelleri için önemli bir soruyu ele alıyor: Model konuşmayı dinlerken ne zaman düşünmeli? Klasik yaklaşımda model tüm sesi bekler, sonra düşünür ve cevap verir. Ancak gerçek zamanlı konuşmada bu yaklaşım gecikme yaratabilir. Erken cevap ise hataya yol açabilir.
Wait-think-answer kontrolü bu dengeye pratik bir çerçeve getiriyor. Model, konuşma sırasında bekleme ve kısa ara durum güncellemesi yapma arasında seçim yapıyor. Kritik bilgiler geldikçe küçük ve görev odaklı düşünce güncellemeleri biriktiriyor. Böylece final cevap aşamasında kalan düşünme yükü azalabiliyor.
Sonuçlar, altı ödüllü DAPO kontrolcünün sentetik konuşmalı benchmark’ta hem doğruluğu artırdığını hem de final-think uzunluğunu azalttığını gösteriyor. Gerçek insan sesi testinde ise sonuçlar daha temkinli: öğrenilmiş kontrolcüler çalışıyor, fakat doğruluk ve kısa final düşünme aynı varyantta her zaman birleşmiyor.
Verianla okuru için ana mesaj şudur: Geleceğin sesli yapay zekâ asistanları yalnızca “ne cevap vereceğini” değil, “konuşma akarken ne zaman bekleyeceğini, ne zaman kısa güncelleme yapacağını ve ne zaman cevap vereceğini” de öğrenmek zorunda kalacak. Bu çalışma, bu zamanlama problemini ölçülebilir ve eğitilebilir bir kontrol görevi hâline getiriyor.
Kaynak ve Yöntem Notu
Bu yazı, “Learning When to Think While Listening in Large Audio-Language Models” başlıklı akademik PDF temel alınarak hazırlanmış özgün Türkçe editoryal içeriktir. Metin birebir çeviri değildir; çalışmadaki problem, yöntem, formüller, görseller, tablolar, deney protokolü, sonuçlar ve sınırlılıklar sadeleştirilerek anlatılmıştır.
Yazıda “düşünme” ifadesi, modelin kullanıcıya görünür kısa durum güncellemesi üretmesini anlatır; gerçek dünyadaki insan düşüncesiyle birebir aynı anlamda değerlendirilmemelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir