

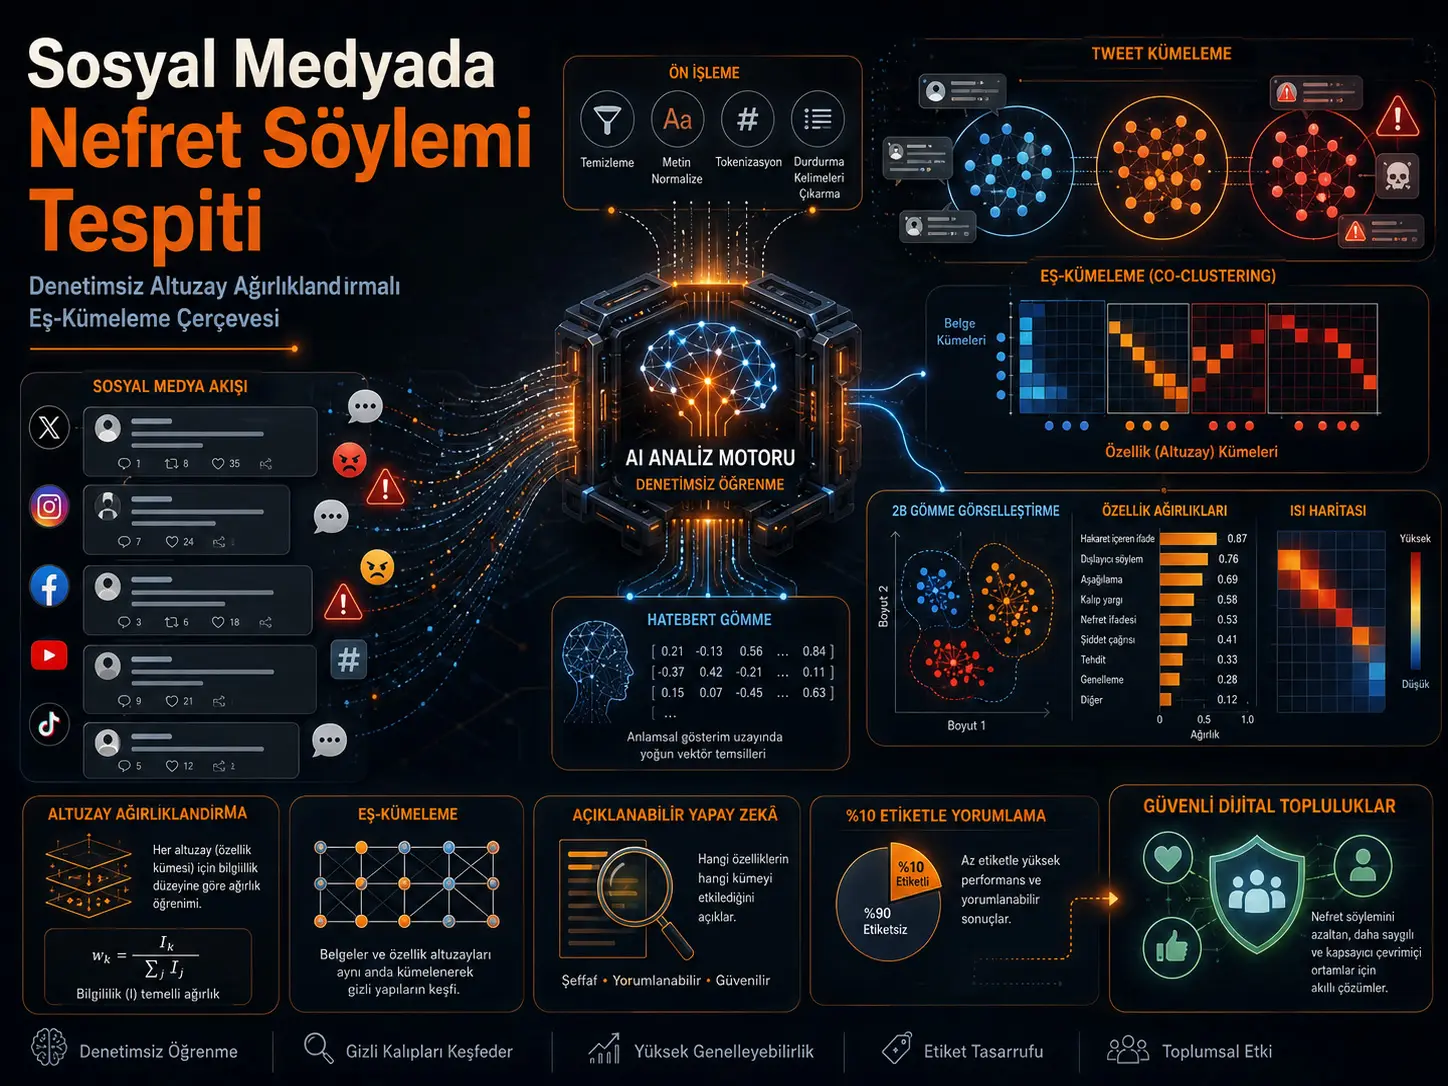
Bu çalışma, sosyal medyadaki İngilizce nefret söylemi örüntülerini büyük miktarda etiketli eğitim verisine ihtiyaç duymadan keşfetmek amacıyla Subspace Weighting Co-Clustering (SWCC; Altuzay Ağırlıklandırmalı Eş-Kümeleme) adlı bir yöntem öneriyor. Sistem, metinleri 768 boyutlu bağlamsal gömmelere dönüştüren BERT-tabanlı bir dil modeliyle başlıyor; ardından tweetleri ve bu gömme uzayındaki özellik boyutlarını eş zamanlı olarak kümeliyor ve her küme için farklı altuzay ağırlıkları öğreniyor. Yazarların raporuna göre SWCC, iç kümeleme değerlendirmesinde 0,68 Silhouette, 0,85 Davies–Bouldin, 1580,5 Calinski–Harabasz ve 0,43 Dunn değerlerine ulaşıyor. Waseem veri setindeki dış değerlendirmede ise kümeler oluşturulduktan sonra etiketlerin %10'u kategori eşlemesi için kullanıldığında %93,1 doğruluk ve %93,5 F1 skoru rapor ediliyor. Bununla birlikte çalışma tamamen etiketsiz bir uçtan uca sınıflandırıcı değildir; kategori isimlerinin atanması için etiketli bir doğrulama altkümesi gerekmektedir. Ayrıca kullanılan model kimliği ve veri setlerinin sınıf dağılımları konusunda kaynak metinde yeniden üretilebilirliği etkileyebilecek tutarsızlıklar bulunmaktadır.
Çalışmanın temel fikri, nefret söyleminin bütün türlerinin aynı dilsel özelliklere eşit ölçüde dayanmadığı varsayımıdır. Irk temelli nefret, cinsiyetçi söylem ve nefret içermeyen saldırgan dil farklı anlamsal boyutlarda yoğunlaşabilir. SWCC bu nedenle yalnız tweetleri kümelere ayırmakla kalmaz; 768 boyutlu embedding uzayını da altuzaylara böler ve her tweet kümesi için bu altuzaylara uyarlanabilir önem ağırlıkları atar. Ablation deneyinde öğrenilmiş ağırlıklandırma kaldırıldığında Silhouette skoru 0,68'den 0,55'e, ağırlıklar rastgele seçildiğinde 0,47'ye ve eşit tutulduğunda 0,51'e düşmektedir. Bu sonuç, incelenen veri ve deney düzeninde adaptif ağırlıklandırmanın küme ayrımına katkıda bulunduğunu desteklemektedir.
Bununla birlikte makalenin “örtük nefret söylemi” ve “düşük kaynaklı diller” için daha geniş kullanım iddiaları henüz deneysel olarak doğrulanmamıştır. Deneyler İngilizce Twitter verileri üzerinde ve yazarların kendi ifadesiyle explicit hate veri setlerinde gerçekleştirilmiştir. Bu nedenle çalışma, farklı platformlara, farklı dillere veya doğrudan implicit hate veri setlerine genellenmiş bir başarı kanıtı sunmamaktadır.
Neden klasik denetimli nefret söylemi tespitinden farklı bir yaklaşım aranıyor?
Nefret söylemi tespitinde yaygın yöntem, önceden insanlar tarafından sınıflandırılmış binlerce veya milyonlarca metni kullanarak bir sınıflandırıcı eğitmektir. Bu yaklaşım yüksek performans verebilse de yeni diller, yeni topluluklar, hızla değişen argo ve yeni nefret söylemi biçimleri için sürekli anotasyon maliyeti doğurur.
Çalışmanın hedeflediği boşluk tam olarak burada ortaya çıkmaktadır: etiketlerin modelin küme oluşturma aşamasında kullanılmadığı, ancak anlamsal olarak anlamlı tweet gruplarının yine de keşfedilebildiği bir yapı kurulabilir mi?
Yazarların önerisi iki tekniği birleştirir:
- Bağlamsal dil temsilcisi: tweetin anlamını sabit kelime listelerinden ziyade çok boyutlu embedding uzayına dönüştürmek.
- Altuzay ağırlıklandırmalı eş-kümeleme: hem belgeleri hem embedding boyutlarını birlikte düzenlemek ve her belge kümesinde hangi altuzayların daha ayırt edici olduğunu öğrenmek.
“Denetimsiz” sözcüğü burada tam olarak ne anlama geliyor?
Çalışmada document cluster'larının oluşturulması sırasında insan tarafından verilmiş nefret söylemi sınıfları kullanılmamaktadır. Bu bakımdan SWCC'nin esas kümeleme aşaması denetimsizdir.
Ancak elde edilen Cluster 1, Cluster 2 veya Cluster 3 gibi kümelerin hangisinin “ırkçı”, “cinsiyetçi”, “nefret içermeyen saldırgan dil” veya veri setinin başka bir resmî sınıfına karşılık geldiğini belirlemek için etiketlerin en az %10'u kullanılmıştır.
Bu nedenle yöntem için en dikkatli tanımlama şudur:
SWCC kümeleme aşamasında denetimsiz, kategori isimlendirme ve dış performans değerlendirmesinde minimal etiket kullanan bir çerçevedir.
Bu ayrım önemlidir. %93,1 doğruluk veya %93,5 F1 skoru, hiçbir etikete bakmadan otomatik olarak anlamlı kategori isimleri üreten tamamen etiketsiz bir sistemin performansı değildir.
HateBERT neden kullanılıyor?
Basit kelime sayımları aynı kelimenin farklı bağlamlardaki anlamını ayırt etmekte zorlanabilir. BERT-tabanlı modeller ise bir kelimenin temsilini çevresindeki kelimelere göre değiştirebilir.
Çalışmanın kavramsal modelinde HateBERT, sosyal medya saldırganlığı ve nefret söylemiyle ilişkili dil örüntülerine uyarlanmış bağlamsal temsil üreticisi olarak kullanılmaktadır.
Her metin, toplam:
\[ M=768 \]
boyutlu latent anlamsal uzaya dönüştürülmektedir. Bütün veri kümesi:
\[ X\in\mathbb{R}^{N\times768} \]
matrisiyle temsil edilir. Burada \(N\) belge/tweet sayısıdır.
Embedding boyutları kelime midir?
Hayır. 768 embedding boyutunun her biri doğrudan “ırk”, “cinsiyet”, “hakaret” veya belirli bir kelime anlamına gelmez. Bunlar model içinde dağıtık biçimde öğrenilmiş latent sayısal özelliklerdir.
Makale yorumlanabilirlik oluşturabilmek için daha sonra yüksek ağırlıklı embedding boyutlarının veri kümesinde en fazla aktive olduğu token'ları belirliyor ve bunları semantik kategorilere eşliyor.
Bu nedenle özellik yorumlama iki aşamalıdır:
- SWCC hangi latent boyut/altuzayın önemli olduğunu belirler.
- Post hoc analiz bu latent boyutları insanın anlayabileceği token veya kavramlarla ilişkilendirmeye çalışır.
Dolayısıyla tabloda görülen sözcükler doğrudan BERT'in 768 kolonunun doğal isimleri değildir; çalışma tarafından yapılan sonradan yorumlama katmanının sonucudur.
Eş-kümeleme neyi farklı yapıyor?
Klasik K-means yalnız satırları, yani bu örnekte tweetleri kümeler. SWCC ise iki ekseni aynı anda düzenlemektedir:
- Satırlar: tweetler / belgeler.
- Sütunlar: embedding özellik boyutları.
Tweet küme ataması:
\[ U\in\{0,1\}^{N\times K} \]
matrisiyle; feature-subspace üyeliği ise:
\[ V\in\{0,1\}^{M\times L} \]
matrisiyle ifade edilmektedir.
Çalışmanın nihai deney ayarlarında:
\[ K=3 \]
tweet kümesi ve:
\[ L=32 \]
özellik altuzayı seçilmiştir.
Altuzay ağırlığı ne işe yarıyor?
Her nefret söylemi kategorisinin aynı semantik boyutlara aynı derecede ihtiyaç duyduğu varsayılmamaktadır. Bunun yerine:
\[ C\in\mathbb{R}^{K\times L} \]
şeklinde bir ağırlık matrisi tanımlanır.
\[ c_{g,h} \]
değeri, \(g\). tweet kümesi için \(h\). altuzayın önemini gösterir.
Örneğin bir kümede kimlik/grup hedeflemesine karşı duyarlı latent özellikler güçlü olabilirken başka bir kümede genel saldırganlık veya aşağılayıcı dil örüntülerini taşıyan boyutlar daha yüksek ağırlık alabilir.
Bu yaklaşımın teorik avantajı, 768 boyutun tamamına tek ve küresel bir önem değeri vermek yerine küme-bağımlı özellik önemi öğrenebilmesidir.
SWCC amaç fonksiyonu nasıl çalışıyor?
Makalenin verdiği temel amaç fonksiyonu:
\[ J(U,V,Z,C) = \frac{1}{NM} \sum_{g=1}^{K} \sum_{h=1}^{L} \sum_{i=1}^{N} \sum_{j=1}^{M} u_{i,g}v_{j,h}c_{g,h} (x_{i,j}-z_{g,h})^2 + \eta \sum_{g=1}^{K} \sum_{h=1}^{L} c_{g,h}\log(c_{g,h}) \]
şeklindedir.
İlk terim, her tweetin ait olduğu kümenin ilgili altuzay merkezine olan ağırlıklı karesel uzaklığını küçültmeye çalışır. Bir tweet ile centroid birbirine ne kadar yakınsa reconstruction/clustering hatası o kadar küçüktür.
İkinci terim entropi temelli regularization bileşenidir:
\[ R_{\mathrm{entropy}} = \eta \sum_{g,h} c_{g,h}\log c_{g,h}. \]
Buradaki:
\[ \eta>0 \]
parametresi ağırlıkların ne kadar konsantre veya dengeli olacağını etkiler.
Entropi düzenlileştirmesi neden gerekli?
Ağırlıklar tamamen serbest bırakılırsa model bütün önemi birkaç feature'a yığarak aşırı keskin ve kararsız çözümler oluşturabilir. Entropi terimi bu davranışı kontrol etmeye çalışmaktadır.
Çalışmanın duyarlılık deneyinde:
| \(\eta\) | Silhouette | Kaynağın yorumu |
|---|---|---|
| 0,01 | 0,52 | Ağırlıklar fazla seyrek |
| 0,1 | 0,61 | Yetersiz düzenlileştirme |
| 0,5 | 0,68 | En iyi denge |
| 1,0 | 0,65 | Aşırı düzenlileştirme |
| 2,0 | 0,58 | Aşırı düzenlileştirme |
| 5,0 | 0,49 | Şiddetli aşırı düzenlileştirme |
Bu deney kapsamında:
\[ \eta=0{,}5 \]
en yüksek Silhouette değerini üretmiştir.
Algoritmanın iteratif akışı nasıl?
Makaledeki SWCC algoritması alternating minimization yaklaşımı izler:
- Tweet ve feature kümeleri başlangıçta atanır.
- Tweetler ağırlıklı uzaklığa göre yeniden kümelenir.
- Cluster centroid'leri güncellenir.
- Feature boyutları ilgili altuzaylara yeniden atanır.
- Her cluster–subspace çifti için dağılıma bağlı ağırlıklar güncellenir.
- Atamalar kararlı hâle gelince veya maksimum iterasyon sayısına ulaşınca işlem durur.
Böylece belge kümeleri, feature altuzayları, centroid'ler ve altuzay ağırlıkları birbirinden bağımsız olarak bir defa hesaplanmaz; birbirlerini iteratif biçimde etkiler.
Hesaplama maliyeti nedir?
Makale bir iterasyon için yaklaşık karmaşıklığı:
\[ O(NKML) \]
olarak vermektedir.
\[ K=3,\qquad L=32,\qquad M=768 \]
olduğunda belge başına yaklaşık:
\[ 7{,}4\times10^4 \]
temel işlem ölçeği hesaplanmaktadır.
Yazarların ölçek tahminine göre \(N=10^6\) ve 50 iterasyon düzeyinde toplam işlem sayısı yaklaşık:
\[ 3{,}7\times10^{12} \]
olabilir. Çalışma bu nedenle milyonlarca belge ölçeğinde dağıtık uygulamanın gerekebileceğini belirtmektedir.
Gerçek deney ne kadar sürdü?
Yeniden üretilebilirlik bölümünde Davidson veri kümesi için embedding çıkarımının:
\[ 2887\ \text{saniye} \]
yani yaklaşık 48 dakika sürdüğü raporlanmıştır.
SWCC için 30 iterasyon kullanılmış ve iterasyon başına yaklaşık 2–3 saniye bildirilmiştir. Tam pipeline süresi yaklaşık 50–55 dakika olarak verilmiştir.
Embedding matrisinin:
\[ 24.783\times768 \]
boyutunda olduğu ve yaklaşık 72,61 MB bellek tuttuğu belirtilmektedir.
Hangi veri setleri kullanıldı?
Çalışma iki İngilizce Twitter veri setini kullanmaktadır:
| Veri seti | Kaynakta raporlanan büyüklük | Kullanım amacı |
|---|---|---|
| Davidson ve ark. (2017) | 24.783 tweet | Nefret söylemi / saldırgan dil / nötr içerik üzerine deneyler |
| Waseem (2016) | 16.000 tweet olarak raporlanıyor | Irkçılık / cinsiyetçilik / diğer sınıflar üzerinde değerlendirme |
Buradaki sınıf dağılımları için kaynak metinde yeniden üretilebilirlik açısından önemli uyuşmazlıklar bulunduğundan, oranlar sorgulanmadan “doğru veri seti dağılımı” olarak yeniden yayınlanmamalıdır. Makalenin yöntemsel sonuçları değerlendirilirken bu nokta ayrıca dikkate alınmalıdır.
Veri ön işleme nasıl yapılmış?
Tweetlerde bulunan URL'ler, kullanıcı adları, hashtag işaretleri, noktalama, stop-word'ler ve çeşitli sosyal medya gürültülerinin temizlenmesi hedeflenmiştir. Slang ve kısaltmaların anlam karşılıklarıyla değiştirildiği, emoticon'ların da açıklayıcı sözcüklere dönüştürüldüğü belirtilmektedir.
Çalışmanın ön işleme analizinde tweet başına ortalama yaklaşık:
\[ 19{,}1 \]
karakterin kaldırıldığı raporlanmaktadır.
Bu işlem embedding modeline daha standartlaştırılmış metin vermeyi amaçlamaktadır. Bununla birlikte hashtag veya sosyal medya işaretlerinin bazı durumlarda nefret söylemi bağlamı taşıyabileceği göz önüne alındığında, temizleme kararlarının bilgi kaybı yaratıp yaratmadığı çalışma içinde ayrı bir ablation deneyiyle sınanmamıştır.
\(K=3\) neden seçilmiş?
Tweet cluster sayısı için:
\[ K=2,\ldots,10 \]
aralığında Within-Cluster Sum of Squares değerlendirmesi yapılmıştır. Çalışma, \(K=2\)'den \(K=3\)'e geçerken WCSS'nin %23,7 azaldığını bildirerek elbow noktasını \(K=3\) olarak seçmektedir.
Şekil 7 ayrıca Silhouette, Davies–Bouldin ve Calinski–Harabasz ölçütlerini göstermektedir. Ancak bu yardımcı indekslerin grafik üzerindeki optimumları tamamen aynı noktada birleşmemektedir. Bu nedenle \(K=3\) tercihini en doğru biçimde elbow analizinin tercih ettiği üçlü kümeleme çözümü olarak tanımlamak gerekir.
Neden \(L=32\)?
Embedding boyut sayısı:
\[ M=768 \]
olduğundan çalışma feature-subspace sayısını square-root heuristic ile:
\[ L\approx\sqrt{768}\approx32 \]
olarak belirlemektedir.
Bu seçim veri tarafından öğrenilmiş kesin bir optimum değildir; kullanılan heuristic'ten gelen hiperparametre seçimidir.
İç kümeleme kalitesi ne gösterdi?
SWCC için çalışma dört temel iç doğrulama metriği raporlamaktadır:
| Metrik | SWCC sonucu | Yorum yönü |
|---|---|---|
| Silhouette | 0,68 | Yüksek değer daha iyi ayrışma |
| Davies–Bouldin | 0,85 | Düşük değer daha iyi |
| Calinski–Harabasz | 1580,5 | Yüksek değer daha iyi |
| Dunn | 0,43 | Yüksek değer daha iyi ayrışma |
On tekrarlı karşılaştırmada raporlanan Silhouette değerleri şöyledir:
| Yöntem | Silhouette |
|---|---|
| K-means + BERT | 0,45 ± 0,03 |
| LDA | 0,38 ± 0,04 |
| Spectral Clustering | 0,52 ± 0,02 |
| BERTopic | 0,58 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 |
| SWCC | 0,68 ± 0,01 |
Kaynakta aynı tablo için SWCC'nin DB, CH ve Dunn değerlerinde de karşılaştırılan yöntemlerden daha iyi sonuç verdiği raporlanmaktadır.
Dış değerlendirmede ne elde edildi?
Kümeler oluşturulduktan sonra etiketlerin %10'u cluster-to-category mapping için kullanılmış ve Waseem veri setinde:
\[ \mathrm{Accuracy}=93{,}1\% \]
ve:
\[ F1=93{,}5\% \]
raporlanmıştır.
Çalışma ayrıca sınıf bazında macro F1 için:
\[ 0{,}89 \]
değeri ve racism, neither ve sexism için sırasıyla yaklaşık:
\[ 0{,}85,\quad0{,}94,\quad0{,}89 \]
F1 değerleri bildirmektedir.
Ancak kaynakta tam confusion matrix yayınlanmamış; “istek üzerine edinilebilir” denmiştir. Ayrıca veri seti sınıf oranlarının raporlanmasındaki sorun nedeniyle sınıf bazlı sonuçların yeniden üretilmesi özellikle önemlidir.
Denetimli modelleri geçtiği söylenebilir mi?
Makalenin Tablo 7'sinde SWCC'nin F1 değeri bazı denetimli literatür sonuçlarından daha yüksek görünmektedir. Örneğin kaynakta GLTR+BERT için %93,1 F1, BERTweet-large için %90,9 ve bazı diğer yöntemler için daha düşük değerler verilmektedir.
Fakat aynı çalışma, tam denetimli yöntemlerle doğrudan karşılaştırmanın uygun olmadığını da belirtmektedir. Bunun nedeni:
- etiket kullanım oranlarının farklı olması,
- train/test protokollerinin aynı olmaması,
- farklı makalelerde farklı veri işleme kararlarının bulunması,
- SWCC'de etiketlerin cluster mapping amacıyla sonradan kullanılmasıdır.
Bu nedenle en güvenli sonuç:
“SWCC raporlanan skorlar bakımından bazı literatür sonuçlarıyla rekabetçi görünmektedir.”
şeklindedir.
“Eşit deney koşullarında bütün denetimli modellerden daha başarılı olduğu kanıtlanmıştır.”
sonucu bu deney tasarımından çıkarılamaz.
Ablation çalışması asıl mekanizma hakkında ne gösteriyor?
Çalışmanın en temiz kontrollü karşılaştırmalarından biri aynı SWCC sisteminin feature-weighting mekanizmasını değiştirerek yapılan ablation deneyidir.
Tam model:
\[ S=0{,}68 \]
Silhouette değerine ulaşırken:
\[ S_{\mathrm{no\ weighting}}=0{,}55, \]
\[ S_{\mathrm{random}}=0{,}47, \]
\[ S_{\mathrm{equal}}=0{,}51 \]
raporlanmıştır.
Bu sonuç, incelenen deney ortamında yalnız co-clustering yapısının değil, öğrenilmiş ve cluster'a özgü subspace weighting mekanizmasının da performansa katkı sağladığını desteklemektedir.
Yorumlanabilirlik gerçekten sağlanıyor mu?
SWCC'nin avantajlarından biri, her cluster için hangi altuzayların yüksek ağırlık aldığını gösterebilmesidir. Kaynak daha sonra bu embedding boyutlarını yüksek aktivasyon gösteren token'larla ilişkilendirerek ırk temelli nefret, cinsiyetçi söylem ve nefret dışı saldırgan dil için karakteristik sözcük kümeleri çıkarmaktadır.
Ancak iki bilimsel sınır korunmalıdır.
Birincisi, embedding dimension ile insanın anlayacağı kavram arasında doğrudan bire bir semantik eşitlik bulunmaz. Haritalama post hoc'tur.
İkincisi, yazarlar gelecekte yüksek ağırlıklı özelliklerin bağımsız insan değerlendiriciler tarafından incelenmesi gerektiğini bizzat açık araştırma sorusu olarak bırakmaktadır.
Dolayısıyla çalışma “tam açıklanabilir AI” geliştirdiğini kanıtlamaktan ziyade, klasik black-box embedding'e göre özellik ağırlığı düzeyinde ek yorumlama kanalı sunmaktadır.
Implicit nefret söylemi gerçekten test edilmiş mi?
Hayır. Çalışmanın girişinde örtük nefret söyleminin sarcasm, kodlanmış dil veya doğrudan hakaret içermeyen dolaylı ifadelerle ortaya çıkabileceği anlatılmaktadır.
Ancak yazarlar açıkça:
deneysel değerlendirmenin Davidson ve Waseem explicit-hate veri setleri üzerinde yapıldığını
ve dedicated implicit-hate veri setlerinin gelecekte kullanılacağını belirtmektedir.
Bu nedenle çalışmanın:
“örtük nefret söylemini başarıyla tespit ettiği”
sonucu mevcut deneyden çıkarılamaz.
Düşük kaynaklı diller için sonuç var mı?
Çalışma, anotasyon ihtiyacını azaltmasının düşük kaynaklı diller için yararlı olabileceğini öne sürmektedir. Ancak deneylerin tamamı İngilizcedir ve kullanılan embedding modeli de İngilizce odaklıdır.
Yazarların gelecek çalışma planında XLM-RoBERTa ve mBERT gibi çok dilli modeller ile dil tanıma + dile özgü subspace weighting yapısının araştırılması önerilmektedir.
Dolayısıyla düşük kaynaklı diller için kullanım şu anda potansiyel uygulama yönüdür, doğrulanmış bulgu değildir.
Türkiye ve Türkçe açısından ne anlama geliyor?
Çalışmada Türkçe veri kullanılmadığı için Türkiye'deki sosyal medya içerikleri için doğrudan performans sonucu bulunmamaktadır.
Türkçeye aktarılacak bir sürümde yalnız İngilizce modeli Türkçe tweetlere uygulamak yeterli olmaz. Türkçenin eklemeli yapısı, yerel argo, bağlama bağlı örtük ayrımcılık, kod değiştirme, yazım varyasyonları ve Türkiye'deki sosyal medya dilinin kendine özgü özellikleri için yeni bir embedding ve insan doğrulama çalışması gerekir.
Bu nedenle çalışma Türkiye açısından hazır bir moderasyon modeli değil; Türkçe için ayrıca sınanabilecek bir clustering mimarisi sunmaktadır.
Çalışmanın desteklediği sonuçlar
- İncelenen İngilizce Twitter veri setlerinde SWCC, raporlanan iç kümeleme metriklerinde karşılaştırılan denetimsiz yöntemlerden daha iyi sonuç vermiştir.
- Ablation çalışması, adaptif subspace weighting kaldırıldığında veya bozulduğunda clustering kalitesinin düştüğünü göstermektedir.
- Küme oluşturma işlemi ground-truth label'lar kullanılmadan yürütülmüştür.
- %10 etiketle yapılan post hoc cluster mapping sonrasında Waseem değerlendirmesinde yüksek Accuracy ve F1 değerleri raporlanmıştır.
- Cluster-specific subspace weights, farklı kümelerde farklı feature bölgelerinin önem kazanabildiğini göstermektedir.
- Çerçevenin hesaplama ve yeniden üretilebilirlik parametrelerinin önemli bir bölümü kaynakta açık olarak raporlanmıştır.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- Sistem uçtan uca tamamen etiketsiz değildir; category mapping için %10 label kullanılır.
- Implicit hate speech başarısı doğrudan test edilmemiştir.
- Türkçe veya başka düşük kaynaklı dillerde başarı gösterilmemiştir.
- Facebook, YouTube, TikTok veya başka platformlarda cross-platform genellenebilirlik test edilmemiştir.
- Tablo 7, eşit train/test protokolünde yapılmış kontrollü bir head-to-head supervised benchmark değildir.
- Feature ağırlıkları doğrudan insan tarafından tanımlanmış anlam boyutları değildir.
- Cluster'ların insanın nefret söylemi taksonomisiyle tam örtüştüğü bağımsız kullanıcı çalışmasıyla doğrulanmamıştır.
- Sistem gerçek zamanlı, milyonlarca kullanıcılı sosyal medya üretim altyapısında saha testi görmemiştir.
- Hard assignment nedeniyle bir tweetin aynı anda birden fazla nefret kategorisine ait olma olasılığı mevcut sürümde modellenmemektedir.
Çalışmanın Yöntemi ve Bulguları
Yöntem akışının dört ana aşaması
Kaynak çalışmanın 5. sayfasındaki Şekil 1 ve Şekil 2, sistemi dört aşamalı bir pipeline olarak göstermektedir:
- Veri ön işleme: sosyal medya metninin temizlenmesi ve normalize edilmesi.
- Feature embedding: metnin BERT-tabanlı modelle 768 boyutlu anlamsal temsile dönüştürülmesi.
- SWCC: tweet ve feature altuzaylarının birlikte kümelenmesi, cluster-specific ağırlıkların öğrenilmesi.
- Değerlendirme: iç clustering metrikleri ve %10 etiketli post hoc category mapping ile dış değerlendirme.
Modelin dört temel çıktısı
| Nesne | Anlamı | Kaynakta raporlanan deney boyutu |
|---|---|---|
| \(U\) | Tweet → cluster üyelik matrisi | \((19.971,3)\) olarak raporlanıyor |
| \(V\) | Feature dimension → subspace üyelik matrisi | \((768,32)\) |
| \(Z\) | Centroid yapısı | Deney bölümünde \((3,768)\) olarak raporlanıyor |
| \(C\) | Cluster → subspace ağırlıkları | \((3,32)\) |
Buradaki \(U=(19.971,3)\) ile çalışmanın başka bölümlerinde verilen 24.783 tweetlik embedding matrisi arasında kaynakta açıklanmamış bir örnek sayısı farkı bulunmaktadır.
İç metriklerin karşılaştırması
| Yöntem | Silhouette ↑ | DB ↓ | CH ↑ | Dunn ↑ |
|---|---|---|---|---|
| K-means (BERT) | 0,45 ± 0,03 | 1,42 ± 0,15 | 980,2 ± 45,3 | 0,28 ± 0,02 |
| LDA | 0,38 ± 0,04 | 1,65 ± 0,18 | 720,5 ± 38,2 | 0,21 ± 0,03 |
| Spectral Clustering | 0,52 ± 0,02 | 1,18 ± 0,12 | 1205,7 ± 52,1 | 0,35 ± 0,02 |
| BERTopic | 0,58 ± 0,02 | 1,05 ± 0,10 | 1350,8 ± 48,7 | 0,39 ± 0,02 |
| HateLex-Baseline | 0,41 ± 0,03 | 1,55 ± 0,16 | 850,3 ± 42,5 | 0,25 ± 0,02 |
| SWCC | 0,68 ± 0,01 | 0,85 ± 0,08 | 1580,5 ± 35,2 | 0,43 ± 0,01 |
Kaynak bu değerlerin 10 çalıştırmanın ortalama ± standart sapması olduğunu belirtmektedir.
Verianla Live: Adaptif ağırlıklandırmanın ablation sonucuna etkisi
Aynı ablation tablosunda full SWCC için:
\[ DB=0{,}85,\qquad CH=1580{,}5,\qquad Dunn=0{,}43 \]
raporlanmıştır. Ağırlıklandırmasız modelde bu değerler sırasıyla:
\[ 1{,}10,\qquad1250{,}3,\qquad0{,}36 \]
olmuştur.
Bu kontrollü deney, çalışmanın en güçlü mekanizma kanıtlarından biridir; çünkü karşılaştırılan şey farklı makalelerden gelen sistemler değil, aynı mimarinin weighting bileşeni değiştirilmiş varyantlarıdır.
Waseem dış değerlendirmesi
| Model | Accuracy | F1 |
|---|---|---|
| SWCC | %93,1 | %93,5 |
| GLTR with BERT | %92,7 | %93,1 |
| BERTweet-large | Kaynakta verilmemiş | %90,90 |
| CAT Boost | %89,03 | %87,74 |
| RoBERTa-based transformer | %86 | %86 |
| AAEBERT | Kaynakta verilmemiş | %46,2 |
| BERTweet trained on GPT-4 | Kaynakta verilmemiş | %90,1 |
Bu tabloyu değerlendirirken yöntemlerin etiket kullanımı ve deney protokollerinin aynı olmadığı unutulmamalıdır. Kaynağın kendi dipnotu, SWCC'nin label'ların %10'unu post hoc cluster mapping için kullandığını, supervised karşılaştırmaların ise tipik olarak daha büyük etiketli train bölümleri kullandığını vurgulamaktadır.
Yeniden üretilebilirlik için verilen yazılım ortamı
| Bileşen | Kaynakta verilen değer |
|---|---|
| Python | 3.9.12 |
| PyTorch | 1.12.1 |
| Transformers | 4.21.1 |
| NumPy | 1.21.5 |
| Scikit-learn | 1.0.2 |
| Random seed | 42 |
| HateBERT maksimum uzunluk | 512 token |
| Embedding batch size | 8 |
| \(K\) | 3 |
| \(L\) | 32 |
| \(\eta\) | 0,5 |
| SWCC iterasyon sayısı | 30 |
Donanım ortamı
Çalışma Google Colab ortamını; yaklaşık 12–25 GB RAM, 2 vCPU Intel Xeon ve oturum tahsisine bağlı olarak NVIDIA Tesla V100 veya T4 GPU ile raporlamaktadır.
Bu bilgiler yeniden üretilebilirlik açısından yararlıdır. Ancak kullanılan embedding modelinin adı farklı bölümlerde farklı verildiği için aynı yazılım ve seed değerlerini kullanmak tek başına bire bir replikasyonu garanti etmemektedir.
Kaynak içindeki model kimliği uyuşmazlığı
Yöntem bölümünde kullanılan model:
GroNLP/HateBERT
olarak belirtilirken, yeniden üretilebilirlik bölümünde:
Hate-speech-CNERG/bert-base-uncased-hatexplain
yazılmaktadır.
Bunlar farklı model kaynakları olduğu için şu sorular kaynak metinden kesin biçimde cevaplanamamaktadır:
- Raporlanan 768 boyutlu embeddingler hangi checkpoint'ten üretildi?
- Model fallback'i hangi koşullarda devreye girdi?
- Son performans tabloları hangi checkpoint'e aittir?
- Farklı checkpoint'lerin SWCC sonuçları ayrı ayrı test edildi mi?
Bu nedenle Verianla metni bütün sonuçları sessizce “özgün GroNLP HateBERT sonucu” olarak yeniden etiketlememektedir.
Kaynak içindeki veri seti uyuşmazlıkları
Waseem veri seti için kaynakta verilen sınıf yüzdeleri kendi içinde toplam %100'ü aşmaktadır. Davidson veri seti için raporlanan %22,8 / %51,8 / %25,4 dağılımı da çalışmanın referans verdiği standart Davidson veri setinin yaygın sınıf dağılımıyla uyuşmamaktadır.
Bu sorun doğrudan clustering yönteminin matematiksel tanımını geçersiz kılmaz; ancak Accuracy/F1 sonuçlarının hangi tam label dağılımı ve hangi veri versiyonu üzerinde üretildiğinin bağımsız yeniden üretimi açısından önemlidir.
Centroid ve başlangıç ağırlığı gösterimindeki uyuşmazlık
Matematiksel notation tablosu centroid'i:
\[ Z\in\mathbb R^{K\times L} \]
olarak tanımlarken uygulama bölümünde:
\[ Z=(3,768) \]
şeklinde \(K\times M\) boyutu verilmektedir.
Aynı şekilde algoritma öncesindeki açıklamada başlangıç ağırlığının \(1/K\) olduğu belirtilirken Algorithm 1 içinde:
\[ C^{(0)}\leftarrow[1/L] \]
yazmaktadır.
Bu ayrımlar özellikle yöntemi koddan yeniden gerçekleştirmek isteyen araştırmacılar için açıklığa kavuşturulması gereken noktalardır.
Modelin başlıca güçlü yönleri
- Küme oluştururken ground-truth sınıflarına ihtiyaç duymaması.
- Tweet ve feature subspace yapılarını aynı anda modellemesi.
- Her küme için ayrı feature/subspace önem ağırlıkları öğrenmesi.
- Ağırlıklandırma mekanizmasının ablation ile test edilmiş olması.
- Birden fazla iç clustering metriği raporlaması.
- Hiperparametre duyarlılık analizi sunması.
- Yazılım sürümü, seed, donanım ve runtime bilgilerinin önemli bölümünü paylaşması.
- Küme sonucunu yalnız tek Accuracy değerine indirgemeyip iç yapı metrikleriyle de değerlendirmesi.
Başlıca sınırlılıklar
- Deneyler yalnız İngilizce Twitter verisidir.
- Implicit hate için dedicated bir test seti kullanılmamıştır.
- Kategori isimlendirmesi için %10 label gerekir.
- Hard cluster assignment kullanılır; çoklu/örtüşen kategori üyelikleri modellenmez.
- Embedding kalitesi seçilen dil modeline bağımlıdır.
- Feature-to-word yorumlama işlemi post hoc'tur ve bağımsız insan doğrulaması yapılmamıştır.
- Cross-platform test bulunmamaktadır.
- Veri seti sınıf oranlarında kaynak-içi tutarsızlıklar vardır.
- Kullanılan transformer checkpoint'inin kimliği iki farklı biçimde raporlanmıştır.
- 24.783 embedding ile 19.971 cluster-assignment satırı arasındaki fark açıklanmamıştır.
- Supervised modellerle tablolu karşılaştırmalar tek ortak deney protokolünden gelmemektedir.
Gelecek araştırmalar
Yazarlar dört ana yön önermektedir:
- Çok dillilik: mBERT veya XLM-RoBERTa gibi modellerle dil-özel ve ortak nefret söylemi altuzaylarının araştırılması.
- İnsan tarafından yorumlanabilir doğrulama: annotator'ların yüksek ağırlıklı feature'ları inceleyerek cluster anlamını doğrulaması.
- Embedding model karşılaştırması: domain specificity, hesaplama maliyeti ve bağlamsal anlama arasında denge kuran alternatif modellerin sınanması.
- Fuzzy clustering: bir tweetin birden fazla kategoriye kısmi üyelik gösterebilmesini sağlayan probabilistic/fuzzy uzantılar.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: An Unsupervised Subspace Weighting Co-Clustering Framework for Hate Speech Detection Patterns in Social Media
Yazarlar: Maya Sultan ALGhafri; Imran Khan; Abdelhamid Abdesselam.
Eş birinci/eş katkı: Kaynakta eş birinci veya eş katkı beyanı bulunmamaktadır.
Sorumlu yazar: Maya Sultan ALGhafri.
Kurum: Department of Computer Science, Sultan Qaboos University, Muscat 123, Oman.
Kaynak türü: Hakemli özgün araştırma makalesi; doğal dil işleme, makine öğrenmesi ve kümeleme çalışması.
Dergi: AI.
Yayınevi: MDPI, Basel, İsviçre.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 6, Makale 204.
DOI: 10.3390/ai7060204.
Alınma / revizyon / kabul / yayın: 26 Nisan 2026 / 20 Mayıs 2026 / 27 Mayıs 2026 / 4 Haziran 2026.
Hakemlik durumu: Hakemli dergi yayınıdır.
Lisans: Creative Commons Attribution (CC BY).
Akademik editörler: Michal Ptaszynski; Rafal Rzepka; Hisami Suzuki.
Ana yöntem: BERT-tabanlı bağlamsal embeddingler ile Subspace Weighting Co-Clustering (SWCC).
SWCC yapısı: Tweet kümeleri \(U\), feature-subspace atamaları \(V\), centroid yapısı \(Z\) ve cluster-specific subspace weighting matrisi \(C\) birlikte iteratif biçimde optimize edilmektedir.
Deneysel embedding boyutu: 768.
Tweet cluster sayısı: \(K=3\).
Feature-subspace sayısı: \(L=32\).
Regularization: \(\eta=0,5\).
Ana veri setleri: Davidson et al. (2017) Hate Speech and Offensive Language veri seti ve Waseem/Hovy İngilizce Twitter hate-speech veri seti.
Etiket kullanımı: Cluster formation sırasında ground-truth label kullanılmadığı belirtilmektedir. Dış category mapping ve evaluation için label'ların en az %10'u post hoc kullanılmaktadır. Bu nedenle sistemin clustering çekirdeği denetimsiz olmakla birlikte uçtan uca kategori üretimi tamamen etiketsiz değildir.
En önemli iç clustering sonucu: SWCC için Silhouette 0,68 ± 0,01; Davies–Bouldin 0,85 ± 0,08; Calinski–Harabasz 1580,5 ± 35,2; Dunn 0,43 ± 0,01.
Waseem üzerinde raporlanan dış sonuç: %93,1 Accuracy ve %93,5 F1; %10 label ile post hoc cluster-to-category mapping sonrasında.
Ablation sonucu: Silhouette tam SWCC'de 0,68; weighting olmadan 0,55; random weighting ile 0,47; equal weighting ile 0,51.
Hesaplama karmaşıklığı: Kaynak bir SWCC iterasyonunu \(O(NKML)\) olarak vermektedir.
Kaynakta verilen runtime: Embedding üretimi yaklaşık 2887 saniye; SWCC 30 iterasyon; iterasyon başına yaklaşık 2–3 saniye; tam pipeline yaklaşık 50–55 dakika.
Deney ortamı: Python 3.9.12; PyTorch 1.12.1; Transformers 4.21.1; NumPy 1.21.5; Scikit-learn 1.0.2; Google Colab; seed 42.
Finansman: Çalışma dış finansman almadığını bildirmektedir.
Etik kurul: Uygulanabilir değil olarak belirtilmiştir.
Bilgilendirilmiş onam: Uygulanabilir değil olarak belirtilmiştir.
Veri erişilebilirliği: Kaynak, Davidson ve Waseem veri setlerinin açık repository'lerden edinildiğini belirtmektedir.
Yazar katkıları: Kavramsallaştırma M.S.A.; metodoloji M.S.A. ve I.K.; yazılım, doğrulama, formal analiz, araştırma, kaynaklar, veri kürasyonu, ilk taslak ve görselleştirme M.S.A.; gözden geçirme ve düzenleme M.S.A.; danışmanlık I.K. ve A.A.; proje yönetimi ve finansman edinimi M.S.A. olarak bildirilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Kaynak sadakati açısından kritik yeniden üretilebilirlik notları
Çalışmanın yöntem bölümünde embedding modeli GroNLP/HateBERT olarak tanımlanırken yeniden üretilebilirlik bölümünde Hate-speech-CNERG/bert-base-uncased-hatexplain adı verilmektedir. Bu iki checkpoint aynı model değildir. Bu nedenle hangi checkpoint'in nihai performans tablolarını ürettiği kaynak metinden kesinleştirilememektedir.
Ayrıca kullanılan veri setlerinin sınıf dağılımları konusunda kaynak içi ve özgün veri kaynaklarıyla uyumsuzluklar bulunmaktadır. Waseem için Tablo 4'teki oranlar toplamda %100'ü aşmaktadır. Davidson için bildirilen sınıf oranları da standart açık veri dosyasındaki label dağılımıyla uyuşmamaktadır. Bu nedenle özellikle external Accuracy/F1 değerlerinin bağımsız replikasyonu sırasında ham veri sürümü ve preprocessing çıktısı doğrulanmalıdır.
Matematiksel notation'da \(Z\) centroid matrisinin boyutu ve başlangıç subspace ağırlığı için de farklı ifadeler bulunmaktadır. Ayrıca Algorithm 1 sonrasında yayımlanmış metinde kalan “Please remove it from the final published version.” ifadesi bir editoryal üretim artığıdır.
Bu tutarsızlıklar Verianla metninde sessizce tek bir “doğru” sürüme dönüştürülmemiştir. Çünkü hangi alternatifin yazarların gerçek deney kodunu temsil ettiği kaynak çalışma tarafından kesin biçimde açıklanmamaktadır.
Bilimsel yorum sınırı
Bu çalışmadaki %93,1 Accuracy ve %93,5 F1 değerleri, sıfır insan etiketi kullanan tamamen otonom bir nefret söylemi kategorilendirme sisteminin sonucu değildir. Etiketlerin %10'u post hoc kategori eşlemesi için kullanılmaktadır.
Çalışmanın implicit hate speech hakkındaki motivasyonu önemli olsa da deneysel sonuçlar explicit-hate odaklı Davidson ve Waseem veri setlerine dayanmaktadır. Dolayısıyla implicit hate başarı oranı raporlanmamıştır.
Supervised modellerle Tablo 7'de yapılan karşılaştırmalar da ortak train/test split, ortak preprocessing ve ortak label bütçesiyle yürütülen tek bir benchmark deneyi değildir. Bu nedenle SWCC'nin bazı yayımlanmış skorları aşması, bütün bu modeller üzerinde kontrollü istatistiksel üstünlük kanıtı olarak yorumlanmamalıdır.
Son olarak model yalnız İngilizce Twitter verilerinde değerlendirilmiştir. Başka diller, başka sosyal medya platformları ve gerçek zamanlı üretim moderasyon sistemleri için ayrı doğrulama gereklidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir