

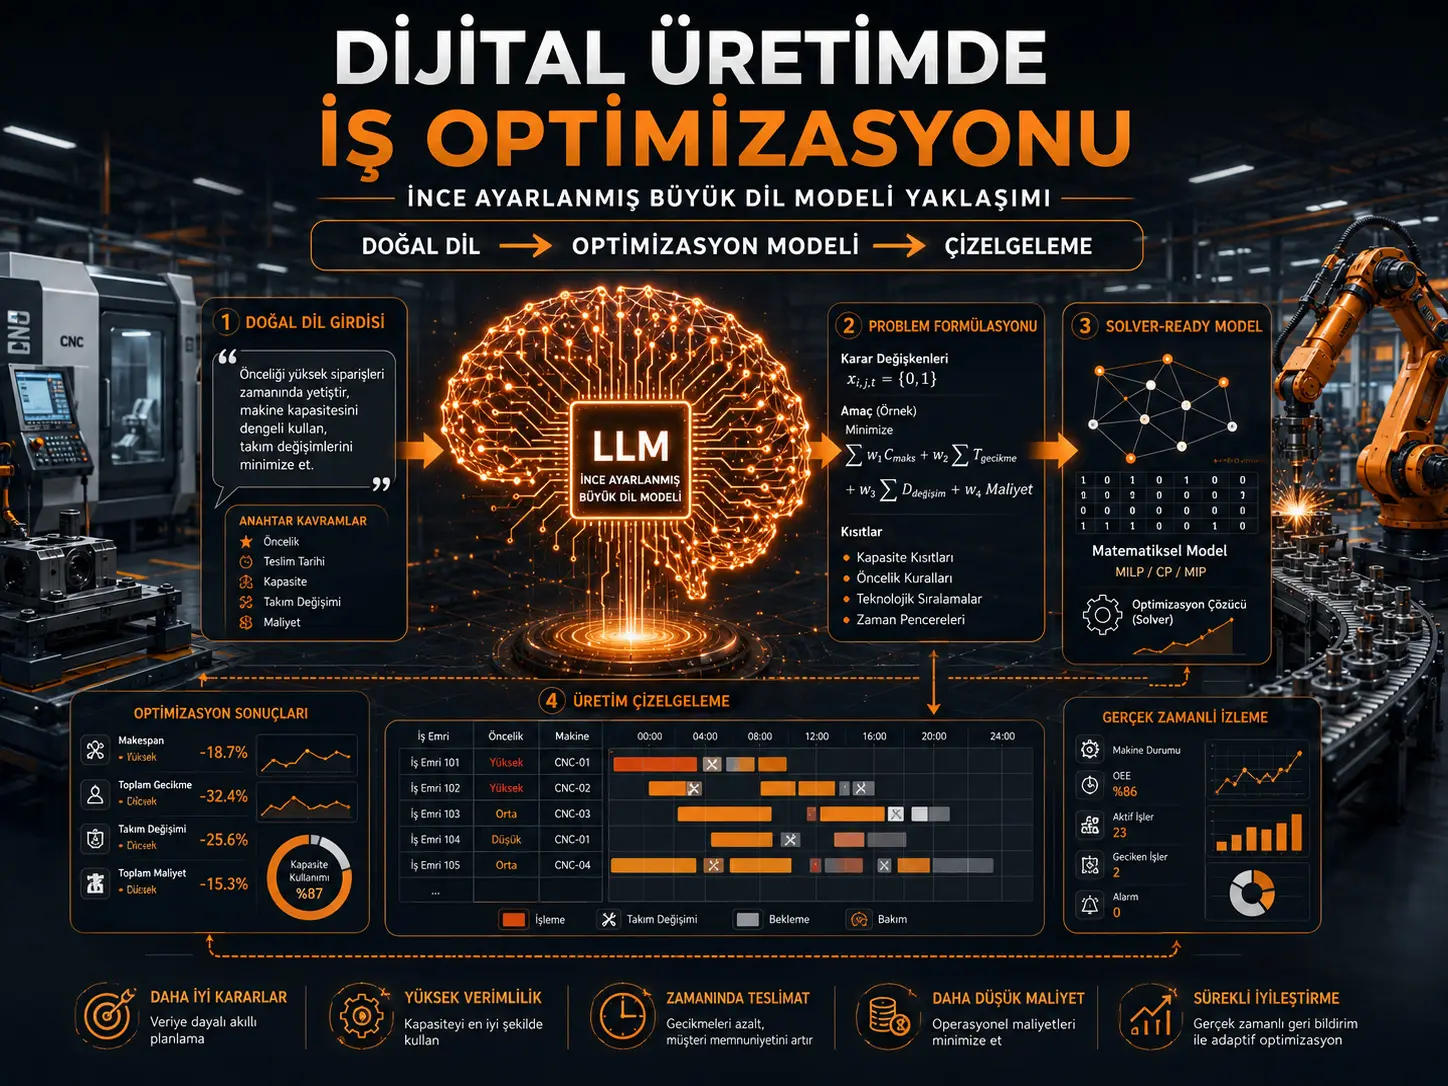
Bir üretim yöneticisinin “şu siparişleri şu makinelerde, bu teslim tarihlerine göre ve en kısa toplam sürede üret” demesi kolaydır; bu talebi bir optimizasyon çözücüsünün anlayacağı karar değişkenlerine, amaç fonksiyonlarına ve matematiksel kısıtlara dönüştürmek ise çoğu zaman yöneylem araştırması uzmanlığı gerektirir. Bu çalışma, dijital üretimdeki bu uzmanlık darboğazını azaltmak için doğal dille yazılan üretim problemlerini otomatik olarak çözücüye hazır optimizasyon modellerine dönüştüren ince ayarlanmış bir büyük dil modeli çerçevesi geliştiriyor.
Yaklaşımın merkezinde, genel amaçlı çok büyük ve pahalı bir ticari model kullanmak yerine kod üretme yeteneğine sahip görece küçük bir önceden eğitilmiş modeli alan bilgisine özgü verilerle fine-tune etmek bulunuyor. Modelin sınırlı çıktı uzunluğu, problem formülasyonunun tek seferde üretilmesi yerine değişkenler, kısıtlar, amaç fonksiyonu, çözüm ve görselleştirme gibi bağımsız kod modüllerine ayrılmasıyla aşılmaya çalışılıyor. Böylece doğal dil problemi, farklı talimatlarla parça parça modelleniyor ve ortaya çıkan modüller daha sonra birleştirilerek çalıştırılabilir optimizasyon modeli elde ediliyor.
Araştırmacılar sistemi üç düzeyde sınamıştır: klasik job-shop scheduling problemi, Avustralya'daki gerçek bir nakış fabrikasının yapısına ve işletme kurallarına dayalı daha karmaşık flexible job-shop scheduling problemi ve 288 optimizasyon probleminden oluşan LPWP doğrusal programlama benchmark'ı. Uygun eğitim konfigürasyonlarında iki üretim planlama vakasında %95'in üzerinde yürütme başarısı raporlanırken LPWP testinde önerilen fine-tuned yaklaşım %72 başarıya ulaşmıştır. Standard GPT ve Chain-of-Experts (CoE) yöntemleri aynı karşılaştırmada %43 başarı göstermiştir. Bu fark 29 yüzde puanıdır.
Sonuçların önemli sınırı şudur: çalışma yapay zekânın bir fabrikanın tüm operasyonlarını kendi başına yönetebildiğini göstermemektedir. Modelin görevi, insan tarafından doğal dille tanımlanan optimizasyon problemini matematiksel/kodlanmış forma dönüştürmektir; gerçek optimum çözümü hesaplayan bileşen hâlâ OR-Tools gibi bir optimizasyon çözücüsüdür. Ayrıca gerçek fabrika vaka çalışmasında bazı üretim kuralları gerçek işletmeden alınırken teslim tarihleri ve bazı miktarlar ERP verisine erişim olmadığı için sentetik olarak oluşturulmuştur.
Üretimdeki asıl sorun yapay zekânın problemi çözmesi mi, problemi doğru tanımlaması mı?
Çalışmanın çıkış noktası bu ayrımdır. Bir optimizasyon çözücüsü matematiksel olarak tanımlanmış bir problemi çözebilir; ancak gerçek işletmedeki problemi matematiksel modele dönüştürmek ayrı bir uzmanlık alanıdır.
Bir üretim planlama problemi genellikle en az üç temel bileşen içerir:
- Karar değişkenleri: Hangi iş hangi makineye atanacak? İş ne zaman başlayacak?
- Amaç fonksiyonu: Toplam üretim süresi mi, gecikme mi, enerji maliyeti mi veya başka bir ölçüt mü minimize edilecek?
- Kısıtlar: Aynı makinede iki iş aynı anda çalışabilir mi? İşlemler hangi sırayla gerçekleşmeli? Hangi makine hangi işlemi yapabilir?
Bu model daha sonra MiniZinc, GAMS, AMPL veya çalışmada kullanılan CPMpy gibi bir modelleme ortamında kodlanır ve Gurobi, CPLEX, SCIP ya da OR-Tools gibi bir çözücüye aktarılır.
Araştırmacıların “problem formulation” olarak adlandırdığı süreç, gerçek işletme talebinin bu matematiksel ve çalıştırılabilir yapıya dönüştürülmesidir.
LLM burada tam olarak ne yapıyor?
LLM doğrudan optimum üretim çizelgesini tahmin etmeye zorlanmıyor. Bunun yerine doğal dildeki problem açıklamasını bir optimizasyon modeline çeviriyor.
Çalışmanın Şekil 2'sindeki işlem zinciri sadeleştirildiğinde:
Doğal dilde problem → Fine-tuned LLM → Karar değişkenleri + kısıtlar + amaç fonksiyonu → Solver → Optimum/uygun çözüm
biçimindedir.
Bu ayrım önemlidir. LLM matematiksel optimizasyon çözücüsünün yerine geçmemekte; çözücü için gerekli modelin oluşturulmasını otomatikleştirmektedir.
Neden genel amaçlı LLM yerine fine-tuning?
Yazarlar mevcut çalışmaların önemli bölümünün prompt engineering veya in-context learning kullandığını, ancak karmaşık üretim optimizasyon problemlerinde bunun yeterli doğruluk sağlamayabileceğini savunmaktadır.
Fine-tuning yaklaşımında modele yalnız “optimizasyon uzmanı gibi davran” denmiyor. Model, doğal dildeki üretim problemi ile doğru problem formülasyonunun eşleştirildiği özel örnekler üzerinde yeniden eğitiliyor.
Fine-tuning sırasında üretilen model ile hedef kod arasındaki fark cross-entropy loss kullanılarak azaltılıyor. Kaynakta kayıp fonksiyonu genel olarak:
\[ l(x,y)=\frac{1}{N}\sum_{n=1}^{N}l_n \]
ve token düzeyindeki terim:
\[ l_n= -\log \frac{\exp(x_{n,y_n})} {\sum_{q=1}^{Q}\exp(x_{n,q})} \]
şeklinde verilmektedir.
Ancak araştırmacılar yalnız düşük cross-entropy loss değerinin doğru optimizasyon modeli üretildiğini kanıtlamayacağını özellikle kabul etmektedir. Bu nedenle oluşturulan kod gerçekten çalıştırılmaktadır.
“Çalıştırarak doğrulama” neden önemli?
Bir LLM sözdizimi açısından etkileyici görünen fakat matematiksel olarak yanlış kod üretebilir. Araştırmacılar bunu önlemek için oluşturulan formülasyonu OR-Tools ile çalıştırmaktadır.
Üç olası sonuç tanımlanmıştır:
- Success: Formülasyon çalışır ve doğru çözümü verir.
- Failure: Formülasyon çalışır fakat yanlış çözüm verir.
- Exception: Formülasyon çalıştırılamaz veya yürütme hatası verir.
Başarı oranı:
\[ Success=\frac{CR}{I}\times100 \]
hata oranı:
\[ Failure=\frac{RE}{I}\times100 \]
ve istisna oranı:
\[ Exception=\frac{CE}{I}\times100 \]
olarak tanımlanmıştır.
Burada I toplam formülasyon sayısı, CR doğru çözüm üretenler, RE yanlış çözüm üretenler ve CE çalıştırılamayan modellerdir.
İlk test: klasik Job-Shop Scheduling
İlk vaka, üretim planlamanın klasik problemlerinden Job-Shop Scheduling'dir. Çok sayıda iş belirli makinelerden belirli sırayla geçmek zorundadır ve aynı makine aynı anda yalnız bir operasyon işleyebilir.
Çalışma üç farklı amaç fonksiyonunu ele almaktadır:
- makespan, yani son iş tamamlanana kadar geçen toplam süre,
- maksimum gecikme,
- öncelik ağırlıklı toplam gecikme.
Örneğin makespan:
\[ \min C_{max} \]
olarak minimize edilir ve her işin son operasyonunun bitiş zamanı için:
\[ C_{max}\geq e_{j,n_j} \]
kısıtı uygulanır.
Ayrıca aynı makinedeki iki operasyonun çakışmaması ve bir iş içindeki operasyonların doğru sırayla ilerlemesi gerekir.
İlk veri seti nasıl üretildi?
Araştırmacılar klasik JSS için başlangıçta 100 problem açıklamasını ve karşılık gelen problem formülasyonlarını manuel olarak oluşturmuştur.
Problem formülasyonlarının uzunluğu yaklaşık 1200–1800 token arasında değişmektedir. Problem açıklamaları ise 600 tokenın altındadır.
Modelin tek seferde üretebildiği çıktının bu problem formülasyonlarından daha kısa olması nedeniyle kod dokuz farklı işlevsel bölüme ayrılmıştır. Dokuz ayrı talimat kullanıldığı için 100 temel problemden:
100 × 9 = 900 eğitim örneği
elde edilmiştir.
Token sınırı neden önemliydi?
Çalışmanın metni kullanılan küçük kod üretim modelinin yaklaşık 600 tokenlık çıktı sınırlamasına sahip olduğunu belirtmektedir. Tam üretim planlama modeli bunun birkaç katı uzunluğundadır.
Araştırmacılar daha büyük ve pahalı bir model kullanmak yerine kodu modülerleştiriyor.
Örneğin ayrı talimatlar:
- gerekli kütüphaneleri üret,
- karar değişkenlerini oluştur,
- çakışma kısıtlarını yaz,
- öncelik kısıtlarını ekle,
- amaç fonksiyonunu tanımla,
- modeli çöz,
- sonuçları görselleştir
gibi alt görevlere karşılık gelebilmektedir.
Her alt problem modelin token sınırı içinde kalır; son aşamada modüller bir araya getirilir.
Klasik JSS deneyinde sonuç ne oldu?
Sonuçlar eğitim süresinin ve başarının batch size ile epoch sayısına güçlü biçimde bağlı olduğunu göstermektedir.
Örneğin:
| Batch | Epoch | Loss | Eğitim süresi (s) | Başarı | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0056 | 1083,78 | %16 | %23 | %61 |
| 1 | 8 | 0,0008 | 8561,05 | %96 | %0 | %4 |
| 2 | 4 | 0,0014 | 2554,93 | %100 | %0 | %0 |
| 4 | 4 | 0,0017 | 1733,71 | %97 | %0 | %3 |
Dolayısıyla “model %95'ten yüksek başarı sağladı” ifadesi her eğitim aşaması için geçerli değildir. Yeterli fine-tuning yapıldığında uygun konfigürasyonlarda bu düzeye ulaşılmıştır.
Gerçek fabrika vakası neydi?
İkinci vaka Melbourne'de faaliyet gösteren ve makalede gizlilik nedeniyle XYZ olarak adlandırılan bir nakış üreticisidir.
Şekil 1 fabrikanın gerçek üretim düzenini göstermektedir. Tesiste yedi makine grubu bulunmaktadır:
- Flat,
- Hanging,
- Cap Front,
- Patch,
- Little Fang,
- Packaging,
- 7-Head.
Şekilde verilen gerçek bir örnek iş akışı:
Cap Machine → Flat Machine → Flat Machine → Hanging Machine
şeklindedir.
Neden bu problem klasik JSS'den daha zor?
Standart JSS'de bir operasyonun çalışacağı makine çoğunlukla önceden bellidir. XYZ fabrikasında ise bazı işlemler birden fazla uygun makinede gerçekleştirilebilir.
Bu nedenle yapay zekâ tarafından oluşturulacak formülasyon iki kararı aynı anda modellemelidir:
- operasyon hangi makineye atanacak,
- o makinede hangi sırada çalışacak?
Bu yapı Flexible Job-Shop Scheduling Problem (FJSS) olarak sınıflandırılır.
Gerçek işletme kuralları matematiksel kısıta nasıl dönüştürülüyor?
Fabrikada örneğin dört parçadan az siparişler Little Fang makinelerine, dört ile yedi parça arasındakiler 7-Head makinelerine yönlendirilmektedir.
7-Head kuyruğunda bekleme iki iş gününü aşarsa iş başka uygun makineye aktarılabilmektedir.
LLM'nin görevi bu tür doğal dil kurallarını:
- makine uygunluk değişkenlerine,
- atama değişkenlerine,
- başlangıç zamanlarına,
- operasyon önceliklerine,
- makespan amaç fonksiyonuna
dönüştürmektir.
“Gerçek dünya” ifadesinin sınırı nedir?
Fabrika, makine grupları ve işletme kuralları gerçek bir üretim ortamına dayanmaktadır. Ancak araştırmacılar ERP verisine erişemedikleri için teslim tarihlerini uniform dağılımdan rastgele üretmiştir. Bazı iş miktarları da farklı makine senaryolarını simüle etmek için rastgele oluşturulmuştur.
Ayrıca makineler arasındaki taşıma süreleri modele dahil edilmemiştir.
Bu nedenle vaka gerçek fabrika yapısından türetilmiş, kısmen sentetik deney senaryosu olarak değerlendirilmelidir.
Gerçek-dünya vaka veri seti nasıl büyütüldü?
Araştırmacılar başlangıçta 50 temel üretim planlama problemi ve doğru formülasyonlarını oluşturmuştur.
Bu kez karmaşıklık daha yüksek olduğu için 16 farklı modüler talimat kullanılmıştır:
50 × 16 = 800 örnek.
Ayrıca problem açıklamalarının dil çeşitliliğini artırmak amacıyla ChatGPT sentetik veri üreticisi olarak kullanılmıştır.
Örneğin aynı problem:
- üretim yöneticisinin bakış açısından,
- fabrika operatörünün bakış açısından,
- makine kullanımına odaklanan bir yöneticinin diliyle
yeniden yazdırılarak anlamsal olarak benzer fakat dilsel olarak farklı eğitim örnekleri oluşturulmuştur.
Bu veri artırma neden önemli?
Gerçek çalışanların aynı üretim problemini aynı kelimelerle anlatması beklenemez. Bir üretim yöneticisi “makine kullanım oranını yükselt” diyebilirken operatör “7-Head kuyruğunda iş kalmasın” diyebilir.
Model yalnız belirli bir cümle kalıbını ezberlerse gerçek ortamda başarısız olabilir. Sentetik yeniden yazım, farklı paydaşların aynı operasyonel problemi farklı dille ifade etmesini taklit etmeyi amaçlamaktadır.
Ancak bu çeşitlilik ChatGPT tarafından sentezlenmiştir; farklı görevlerde gerçek fabrika çalışanlarından toplanmış geniş bir doğal dil korpusu değildir.
Gerçek-dünya senaryosunda başarı neydi?
Tablo 4'te bazı eğitim konfigürasyonları şöyledir:
| Batch | Epoch | Loss | Süre (s) | Başarı | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0029 | 864,64 | %6 | %0 | %94 |
| 1 | 4 | 0,0003 | 3454,53 | %100 | %0 | %0 |
| 2 | 4 | 0,0004 | 2141,21 | %100 | %0 | %0 |
| 4 | 4 | 0,0013 | 1445,31 | %23 | %20 | %57 |
| 4 | 8 | 0,0003 | 2902,65 | %100 | %0 | %0 |
Bu tablo fine-tuning'in yalnız “birkaç örnek göstermekten” ibaret olmadığını açıkça göstermektedir. Örneğin batch 4 ile dört epoch sonunda başarı yalnız %23 iken sekiz epoch sonunda %100'e yükselmektedir.
Model ezberlemiş olabilir mi?
Araştırmacılar bu riski eğitim ve doğrulama loss eğrilerini karşılaştırarak değerlendirmiştir.
Şekil 4 klasik JSS, Şekil 8 ise gerçek-dünya FJSS için eğitim ve validation loss eğrilerini gösteriyor. Yazarlar eğrilerin eğitim ilerledikçe birbirine yaklaşmasını ve büyük kalıcı ayrışmalar göstermemesini aşırı öğrenme bulunmadığı yönünde yorumlamaktadır.
Bununla birlikte bu sonuç aynı dağılımdan ayrılan validation/test verileri için genelleme kanıtıdır; tamamen farklı fabrika türleri veya görülmemiş optimizasyon yapıları için evrensel genelleme kanıtı değildir.
PCA embedding analizleri ne gösteriyor?
Araştırmacılar fine-tuned modelin encoder ve decoder embedding'lerini PCA ile iki boyuta indirgemiştir.
Klasik JSS'de problem açıklamalarının farklı talimatlara göre daha belirgin kümeler oluşturduğu görülmektedir. Gerçek-dünya vakasında ise noktalar daha dağınıktır; bu durum dilsel ve yapısal çeşitliliğin arttığı şeklinde yorumlanmaktadır.
Decoder embedding'lerinde farklı kod modülleri de ayrı kümeler oluşturmaktadır. Örneğin:
- imports,
- configurations,
- constraints,
- objective,
- visualisation,
- solution
gibi bölümlerin farklı temsil bölgelerine ayrılması, modelin yalnız tüm kodu tek bir kalıp olarak kopyalamadığını destekleyen yardımcı bir analiz olarak sunulmaktadır.
LPWP benchmark neden kullanıldı?
İlk iki deney doğrudan üretim planlamaya yöneliktir. Araştırmacılar yöntemin yalnız kendi ürettikleri veri setlerinde başarılı olmadığını sınamak için LPWP adlı standart doğrusal programlama veri setine de geçmiştir.
LPWP toplam 288 problem açıklaması içermektedir.
Karşılaştırılan yöntemler:
- Standard GPT,
- Chain-of-Thought (CoT),
- Progressive-Hint Prompting (PHP),
- Chain-of-Experts (CoE),
- önerilen fine-tuned framework.
LPWP'de sonuç ne oldu?
| Yöntem | Başarı | Failure | Exception |
|---|---|---|---|
| Standard | %43 | %24 | %33 |
| CoT | %7 | %7 | %86 |
| PHP | %2 | %3 | %95 |
| CoE | %43 | %31 | %26 |
| Fine-tuned framework | %72 | %26 | %2 |
“Yaklaşık %30 daha iyi” ne demek?
Makale bu tabloyu “approximately 30% performance improvement” olarak tanımlamaktadır.
Ancak ham değerler:
\[ 72\%-43\%=29 \text{ yüzde puanı} \]
fark göstermektedir.
Bu nedenle en açık ifade, başarı oranında 29 yüzde puanlık artıştır.
Göreli artış hesaplanırsa:
\[ \frac{72-43}{43}\times100 \approx 67,4\% \]
elde edilir. Bu Verianla yazısında kaynak iddiası olduğundan güçlü veya zayıf gösterilmemesi için “yaklaşık %30 göreli iyileşme” yerine ham başarı oranları ve yüzde puanı farkı kullanılmaktadır.
LPWP verisinin hazırlanmasında önemli bir ayrıntı
LPWP problem açıklamalarını ve beklenen sonuçları içerirken gerekli problem formülasyonlarını içermiyordu.
Araştırmacılar başlangıç formülasyonlarını GPT-3.5 kullanarak oluşturmuş, daha sonra beklenen sonuçlarla uyuşmayan örnekleri manuel olarak incelemiştir.
Makale, bazı uyuşmazlıklarda LPWP'nin beklenen değerlerinin yanlış olduğunu ve bazı GPT-3.5 formülasyonlarında da sorun bulunduğunu belirtmektedir. Düzeltilmiş LPWP sürümü ayrıca yayımlanmıştır.
Dolayısıyla benchmark hazırlığında yalnız otomatik üretim değil insan doğrulaması da kullanılmıştır.
Bir küçük model neden tercih edildi?
Araştırmanın temel tasarım hedeflerinden biri hesaplama maliyetini azaltmaktır. Yazarlar büyük ticari modeller yerine açık kaynaklı ve daha küçük bir kod üretim modelini fine-tune ederek alan bilgisini modele gömmeyi amaçlamaktadır.
Tablo 2'de eğitim sistemi:
- GPU: NVIDIA Tesla V100 SXM2 32 GB,
- model tanımı: Salesforce/codet5-large-ntp-py,
- tokenizer: Salesforce/codet5-large-ntp-py,
- learning rate: 5×10⁻⁵,
- gradient checkpointing: açık,
- evaluation steps: 10
olarak verilmektedir.
Metin ise yaklaşımı CodeRL üzerinden açıklamaktadır. CodeRL'nin CodeT5 tabanlı bir mimari olduğunu belirtse de kullanılan tam checkpoint'in CodeRL adıyla mı yoksa doğrudan CodeT5 checkpoint'iyle mi başlatıldığı kaynakta yeterince ayrıştırılmamıştır.
SME/KOBİ'ler gerçekten bu sistemi hemen kullanabilir mi?
Çalışma küçük modellerin hesaplama ve lisans maliyetlerini azaltabileceğini, şirket içi veya edge kullanım için veri gizliliği avantajı sağlayabileceğini ve optimizasyon uzmanlığı sınırlı KOBİ'lerin ileri optimizasyon araçlarına erişimini kolaylaştırabileceğini savunmaktadır.
Bununla birlikte çalışmada:
- bir KOBİ'de tam üretim devreye alma çalışması,
- yatırım geri dönüşü hesabı,
- bulut ile şirket içi sunucu maliyet karşılaştırması,
- operatör eğitim maliyeti,
- bakım ve model güncelleme maliyeti
ölçülmemiştir.
Dolayısıyla “maliyet-etkin” sonucu, mimari ve hesaplama gereksinimlerinin büyük ticari modellere kıyasla azaltılmasına dayalı teknik bir iddiadır; doğrulanmış ticari ROI sonucu değildir.
Bu yaklaşımın üretimde en önemli potansiyeli nedir?
En önemli fikir, üretim çalışanının matematiksel optimizasyon modelini baştan yazmak zorunda kalmamasıdır.
Örneğin yönetici:
“Acil sipariş geldi, yedi kafalı makine iki gün dolu, bu işi başka uygun makineye geçir ve toplam üretim süresini en aza indir.”
gibi doğal dilde bir işletme talebi verebilir.
İdeal durumda fine-tuned model bunu yeni karar değişkeni veya kısıt olarak formüle eder ve solver güncellenmiş çizelgeyi hesaplar.
Ancak kaynak çalışma bu tip tüm beklenmedik durumları gerçek fabrika operasyonunda uzun dönem boyunca deneysel olarak sınamamıştır. Bu nedenle söz konusu kullanım senaryosu çalışmanın desteklediği mimari potansiyel olarak değerlendirilmelidir.
Çalışma neyi destekliyor?
- Doğal dildeki optimizasyon problemleri alan-özel fine-tuning ile solver-ready formülasyonlara dönüştürülebilir.
- Modülerleştirme, sınırlı token kapasitesine sahip daha küçük modellerle uzun optimizasyon kodlarının oluşturulmasına yardımcı olabilir.
- Execution-based değerlendirme, yalnız dilsel benzerlikten daha doğrudan bir formülasyon doğruluk kontrolü sağlar.
- Uygun fine-tuning konfigürasyonlarında klasik ve daha karmaşık üretim planlama vakalarında %95'in üzerinde başarı elde edilmiştir.
- LPWP testinde fine-tuned yaklaşım %72 başarıya ulaşmış ve aynı tabloda Standard/CoE'nin %43'lük sonuçlarını aşmıştır.
- Sentetik problem açıklamaları alan verisinin yetersiz olduğu durumlarda eğitim veri setini genişletmek için kullanılabilir.
- Gerçek üretim işletmesinin kuralları doğal dilden formal optimizasyon kısıtlarına dönüştürülebilir.
Çalışma neyi kanıtlamıyor?
- LLM'nin bütün üretim problemlerini insan denetimi olmadan doğru modelleyebileceğini kanıtlamıyor.
- Fine-tuned model bütün fabrika türlerinde %95'in üzerinde başarı garantisi vermiyor.
- LLM optimizasyon çözücüsünün yerini almıyor.
- Gerçek-dünya vaka verilerinin tamamı gerçek ERP üretim geçmişinden gelmiyor.
- Doğal dil arayüzünün gerçek operatörlerin çalışma süresini ne kadar azalttığı ölçülmemiştir.
- KOBİ'lerde ekonomik yatırım geri dönüşü hesaplanmamıştır.
- Enerji kullanımı, atık veya karbon emisyonu doğrudan ölçülmemiştir.
- Çok büyük üretim ağlarında veya tamamen farklı optimizasyon sınıflarında aynı başarının korunacağı gösterilmemiştir.
- Model çıktılarının uzman denetimini tamamen gereksiz kıldığı gösterilmemiştir.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımının özeti
| Bileşen | Uygulama |
|---|---|
| Ana görev | Doğal dilden optimizasyon problem formülasyonu üretmek |
| Ana yaklaşım | Alan-özel LLM fine-tuning + prompt engineering + kod modülerleştirme |
| Model ailesi | Metinde CodeRL/CodeT5 tabanlı yaklaşım |
| Model kimliği, Tablo 2 | Salesforce/codet5-large-ntp-py |
| Problem modelleme kütüphanesi | CPMpy |
| Çözücü | OR-Tools |
| Fine-tuning | HuggingFace trainer |
| Eğitim / validation / test | %70 / %10 / %20 |
| GPU | NVIDIA Tesla V100 SXM2 32 GB |
| Learning rate | 5 × 10⁻⁵ |
| Ana değerlendirme | Success / Failure / Exception |
Vaka 1: Klasik Job-Shop Scheduling
| Özellik | Değer |
|---|---|
| Manuel temel problem | 100 |
| Modüler talimat | 9 |
| Toplam örnek | 900 |
| Problem açıklaması | <600 token |
| Tam problem formülasyonu | 1200–1800 token |
| Öne çıkan konfigürasyon | Batch 2, epoch 4 |
| Eğitim başarı oranı | %100 |
| Failure | %0 |
| Exception | %0 |
Vaka 2: Gerçek fabrika yapısına dayalı FJSS
| Özellik | Değer |
|---|---|
| Temel problem | 50 |
| Modüler talimat | 16 |
| Toplam örnek | 800 |
| Problem açıklaması | <600 token |
| Formülasyon uzunluğu | 1800–3400 token |
| Makine grubu | 7 |
| ERP teslim tarihleri | Mevcut değil; sentetik olarak üretildi |
| Taşıma süresi | Modele dahil edilmedi |
Neden flexible job-shop daha güçlü bir test?
Klasik JSS'de esas problem operasyonların sıralanmasıdır. Flexible JSS'de buna makine seçimi de eklenir.
Her operasyon için:
\[ y_{i,j,h}\in\{0,1\} \]
değişkeni, operasyonun makine i'ye atanıp atanmadığını gösterir.
Her operasyonun yalnız bir makineye atanması:
\[ \sum_i y_{i,j,h}=1 \]
ile sağlanmaktadır.
Ayrıca operasyon yalnız yetkin olduğu makineye atanabilir:
\[ y_{i,j,h}\leq a_{i,j,h} \]
Bu yapı, doğal dille ifade edilen fabrika kurallarının ikili karar değişkenlerine dönüştürülmesini gerektirir.
LPWP karşılaştırmasının bilimsel anlamı
LPWP deneyinin önemi, çalışma ekibinin kendi üretim veri setlerinin dışına çıkılmasıdır.
Önerilen yöntem %72 başarıya ulaşırken:
- Standard: %43,
- CoE: %43,
- CoT: %7,
- PHP: %2
olarak raporlanmıştır.
Aynı zamanda önerilen yöntemin Exception oranı yalnız %2'dir. Bu, oluşturulan kodun büyük bölümünün en azından yürütülebilir olmasını sağlayan önemli bir sonuçtur.
Bununla birlikte benchmark protokolünde fine-tuned yaklaşım eğitim verisine ihtiyaç duyarken prompt tabanlı yöntemlerin aynı biçimde fine-tune edilmediği unutulmamalıdır. Karşılaştırma bu iki farklı geliştirme paradigmasının çalışma tarafından uygulanan hâllerini karşılaştırmaktadır.
Başarı metriğinin sınırı
Execution-based değerlendirme önemli bir güçlü yön olmakla birlikte, başarı kriteri formülasyonun doğru çözüm vermesine dayanmaktadır.
Bu nedenle sonuç, oluşturulan modelin verilen test örneğinde doğru sonucu ürettiğini doğrular. Bu tek başına iki matematiksel formülasyonun her olası veri örneğinde tamamen semantik olarak eşdeğer olduğunu kanıtlayan biçimsel doğrulama değildir.
Bu ayrım, özellikle güvenlik-kritik veya yüksek maliyetli üretim uygulamalarında insan veya otomatik model doğrulama katmanlarının neden hâlâ önemli olabileceğini göstermektedir.
Çalışmanın güçlü yönleri
- Yalnız LLM çıktısının metinsel benzerliğini değil gerçek solver yürütmesini ölçmesi.
- Klasik benchmark ile gerçek üretim ortamından türetilen vakayı birlikte incelemesi.
- Fine-tuning veri setlerinin hazırlanma sürecini açıklaması.
- %70/%10/%20 veri ayrımını açıkça raporlaması.
- Token sınırını modülerleştirme ile sistematik olarak ele alması.
- Sentetik veri artırma sürecini açıkça belirtmesi.
- Veri setleri ve üretilen artefaktların önemli bölümünü açık depolarda paylaşması.
- Embedding analiziyle yalnız son doğruluğu değil iç temsil davranışını da incelemesi.
Çalışmanın başlıca sınırlılıkları
Yazarların kendi sonuç bölümünde belirttiği ilk sınırlılık, performansın eğitim verisinin kalite ve çeşitliliğine bağlı olmasıdır. Eğitim dağılımından önemli ölçüde farklı yeni problemler ek fine-tuning veya insan doğrulaması gerektirebilir.
İkinci sınırlılık token sorunudur. Modülerleştirme mevcut problemi azaltmaktadır ancak çok büyük veya çok karmaşık optimizasyon problemlerinde mevcut küçük LLM mimarileri yine yetersiz kalabilir.
Üçüncü sınırlılık vaka kapsamıdır. Deneyler ağırlıklı olarak üretim çizelgeleme problemlerine odaklanmıştır. Ağ tasarımı, portföy optimizasyonu veya başka optimizasyon sınıflarına genelleme ayrıca doğrulanmalıdır.
Dördüncü sınırlılık uzun dönemli saha doğrulamasıdır. Fabrika koşulları zamanla değişebilir; yeni makineler, yeni ürünler, yeni iş kuralları ve farklı personel ifade biçimleri model dağılımını değiştirebilir. Yazarlar bu nedenle uzunlamasına saha çalışmalarını gelecekteki araştırma yönü olarak önermektedir.
Türkiye'deki imalat işletmeleri açısından ne ifade ediyor?
Çalışmada Türkiye'deki bir fabrikadan veri bulunmamaktadır. Bu nedenle bildirilen %95 veya %72 başarı oranlarının Türkiye'deki üretim ortamlarına doğrudan aktarılması bilimsel olarak doğru olmaz.
Bununla birlikte yöntem Türkiye'deki ERP/MES kullanan üretim işletmeleri için test edilebilir bir mimari sunmaktadır. Yerel bir uygulama için şirketin gerçek:
- makine grupları,
- operasyon sıraları,
- iş emirleri,
- kapasite sınırları,
- vardiya kuralları,
- teslim tarihleri,
- bakım pencereleri,
- öncelikli müşteri kuralları
kullanılarak alan-özel veri seti hazırlanması ve modelin bağımsız test verisi üzerinde yeniden doğrulanması gerekir.
Özellikle üretim planlama personelinin kuralları doğal Türkçeyle ifade ettiği bir sistem kurulmak istenirse Türkçe üretim terminolojisinin de fine-tuning veri setinde yeterli çeşitlilikte temsil edilmesi gerekir. Kaynak çalışma İngilizce problemler üzerinde yürütüldüğünden Türkçe performans konusunda doğrudan sonuç sunmamaktadır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Business optimization for digital manufacturing: A fine-tuned large language model approach
Yazarlar: Pivithuru Thejan Amarasinghe, Su Nguyen, Yuan Sun, Sobhan (Sean) Arisian, Damminda Alahakoon.
Yazar sırası: Kaynak çalışmadaki sıra aynen korunmuştur.
Eş katkı/eş birinci yazar: Kaynakta eş katkı veya eş birinci yazar işareti bulunmamaktadır.
Sorumlu yazar: Sobhan (Sean) Arisian.
Kurum 1: Research Center for Data Analytics and Cognition, La Trobe University, Melbourne, Victoria 3086, Australia.
Kurum 2: College of Business and Law, RMIT University, Melbourne, Victoria 3000, Australia.
Kurum 3: ARC Training Centre in Optimization Technologies, Integrated Methodologies, and Applications, University of Melbourne, Melbourne, Victoria 3053, Australia.
Dergi: International Journal of Production Economics.
Yayınevi: Elsevier B.V.
Cilt: 295.
Makale numarası: 109934.
DOI: 10.1016/j.ijpe.2026.109934
Gönderim: 23 Haziran 2025.
Revizyon: 12 Ocak 2026.
Kabul: 19 Ocak 2026.
Çevrim içi yayın: 29 Ocak 2026.
Kaynak türü: Hakemli, açık erişimli araştırma makalesi; hesaplamalı/yapay zekâ ve üretim optimizasyonu çalışması.
Özel sayı: Enhancing digital manufacturing via AI-LLM.
Resmî yayın bağlantısı: https://doi.org/10.1016/j.ijpe.2026.109934
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint durumu: İncelenen belge nihai International Journal of Production Economics dergi makalesidir; preprint olarak sunulmamıştır.
Finansman: İncelenen PDF'de ayrı bir Funding Statement bulunmamaktadır. CRediT bölümünde Pivithuru Thejan Amarasinghe için “Funding acquisition” katkısı belirtilmiştir.
Veri erişilebilirliği: Ayrı bir Data Availability Statement bulunmamakla birlikte çalışma veri setlerini ve oluşturulan problem formülasyonlarını açık GitHub depolarında paylaşmaktadır. Kaynakta verilen depolar arasında AI-Copilot-Data, AI-Copilot-Artifacts, AI-Copilot-Data-Real-World-Scenario, AI-Copilot-Artifacts-Real-World-Scenario ve düzeltilmiş LPWP veri deposu bulunmaktadır.
Çıkar çatışması: İncelenen PDF'de ayrı bir Declaration of Competing Interest beyanı görülmemektedir.
CRediT katkıları: Pivithuru Thejan Amarasinghe: ilk taslak, yöntem, araştırma, finansman edinimi, veri kürasyonu ve kavramsallaştırma. Su Nguyen: ilk taslak, doğrulama, danışmanlık/gözetim, yöntem, araştırma ve kavramsallaştırma. Yuan Sun: ilk taslak, doğrulama, danışmanlık/gözetim, kaynaklar, yöntem ve kavramsallaştırma. Sobhan (Sean) Arisian: gözden geçirme/düzenleme, doğrulama, danışmanlık/gözetim, kaynaklar ve proje yönetimi. Damminda Alahakoon: gözden geçirme/düzenleme, doğrulama, danışmanlık/gözetim, kaynaklar ve kavramsallaştırma.
Üretken yapay zekâ beyanı: ChatGPT, çalışmanın veri oluşturma aşamasında gerçek-dünya üretim planlama problem açıklamalarının farklı paydaş perspektiflerinden sentetik varyantlarını üretmek için kullanılmıştır. Ayrıca yazarlar makalenin bazı bölümlerinde dil ve okunabilirliği iyileştirmek amacıyla ChatGPT kullandıklarını, daha sonra çıktıları kendilerinin gözden geçirip düzenlediğini ve içeriğin sorumluluğunu üstlendiklerini belirtmiştir. LPWP problem formülasyonlarının ilk oluşturulmasında GPT-3.5 kullanılmış ve uyuşmazlıklar manuel olarak incelenmiştir.
Model kimliği notu: Kaynak metin deneylerde CodeRL'nin önceden eğitilmiş model olarak kullanıldığını belirtirken Tablo 2 model ve tokenizer kimliğini Salesforce/codet5-large-ntp-py olarak vermektedir. CodeRL'nin CodeT5 üzerine kurulu olduğu açıklansa da kullanılan kesin checkpoint ayrımı metinde tam olarak netleştirilmemektedir; bu nedenle iki ifade burada ayrı biçimde korunmuştur.
Gerçek-dünya veri sınırı: Melbourne'deki nakış fabrikasının fiziksel/makine yapısı ve operasyonel kuralları gerçek işletmeden alınmıştır. Bununla birlikte ERP verisine erişim olmadığı için teslim tarihleri rastgele atanmış, bazı üretim miktarları simüle edilmiş ve makineler arasındaki taşıma süreleri hesaba katılmamıştır. Sonuçlar tam tarihsel ERP replay çalışması olarak yorumlanmamalıdır.
“%30 iyileşme” notu: LPWP Tablo 5'te önerilen framework %72, en iyi Standard ve CoE sonuçları %43 başarı göstermektedir. Ham fark 29 yüzde puanıdır. Kaynağın “approximately 30% performance improvement” ifadesi bu mutlak yüzde-puanı farkıyla uyumludur; göreli artış yaklaşık %67'dir.
Maliyet sınırı: Kaynak küçük/fine-tuned model yaklaşımını maliyet-etkin olarak tanımlamaktadır; ancak doğrudan parasal TCO, ROI veya gerçek KOBİ işletme maliyeti karşılaştırması sunmamaktadır.
Sürdürülebilirlik sınırı: Makalenin sonuç bölümünde daha iyi üretim verimliliğinin atık, enerji tüketimi ve karbon ayak izini azaltma potansiyeli tartışılmaktadır. Bunlar bu çalışmada doğrudan ölçülmüş çevresel sonuçlar değildir.
Bilimsel içerik sınırı: Bu Verianla içeriğindeki yöntem, model, formüller, veri setleri, eğitim parametreleri, fabrika vakası, başarı oranları ve sınırlılıklar özgün çalışmaya dayanmaktadır. Dış kaynaklar yalnız bibliyografik kimlik, yayın kaydı, hakemlik ve yayınevi bilgisinin doğrulanmasında kullanılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir