

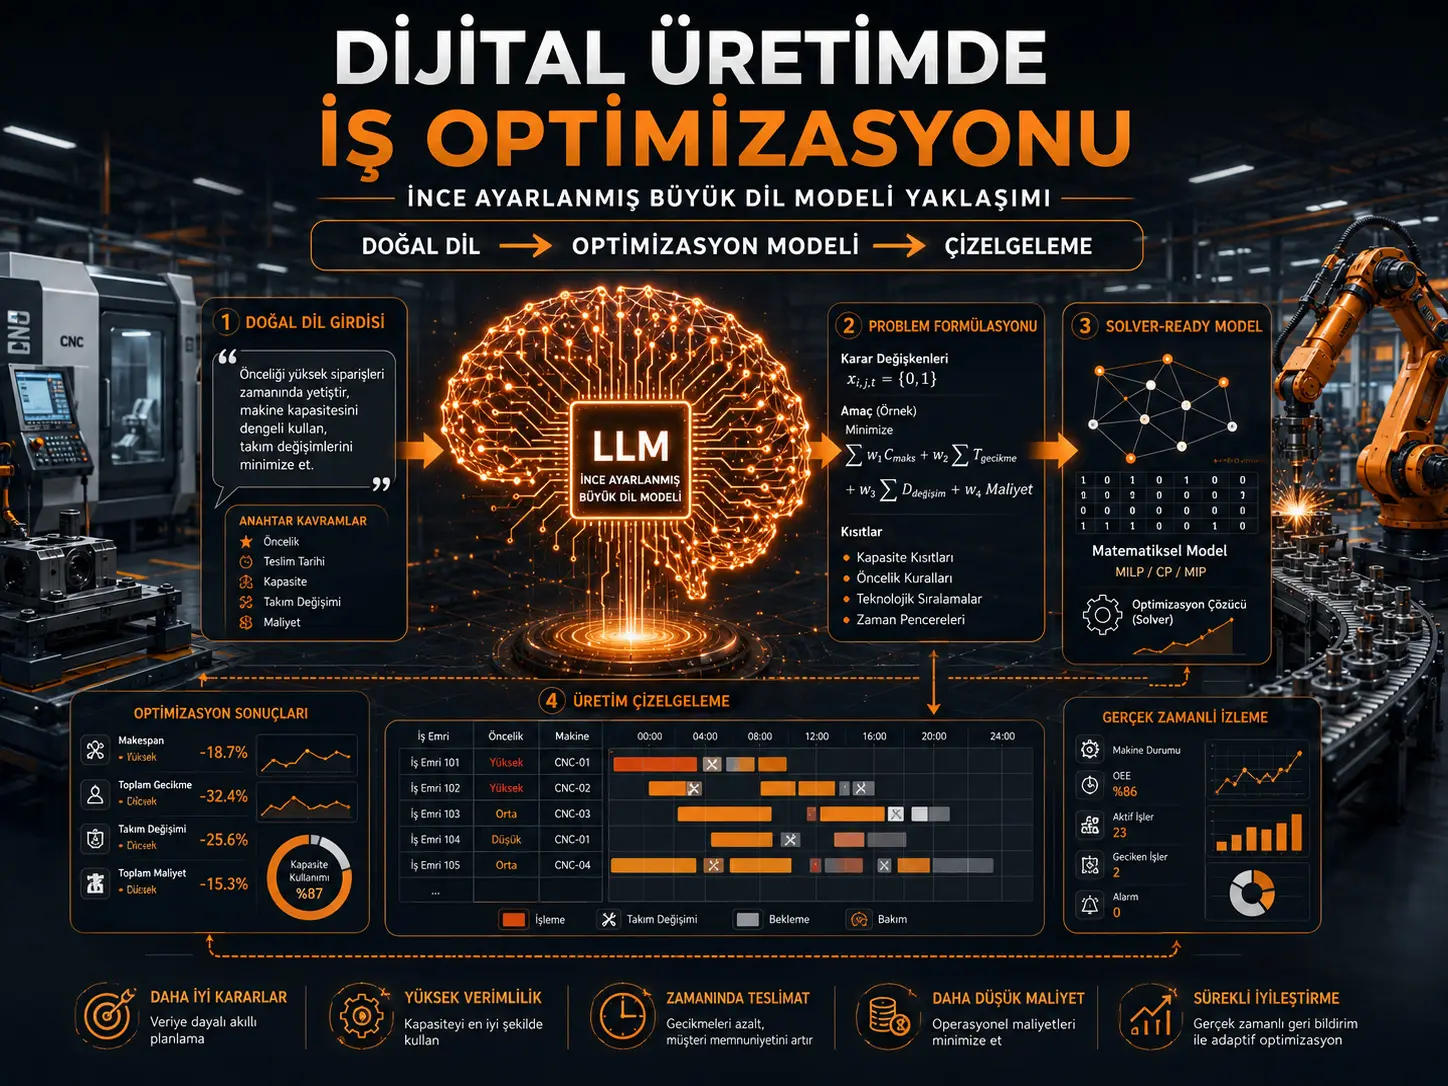
Ni rahisi kwa meneja wa uzalishaji kusema, “zalisha oda hizi kwenye mashine hizi, kwa tarehe hizi za utoaji na kwa muda mfupi zaidi kwa jumla”; lakini kubadilisha ombi hilo kuwa vigezo vya maamuzi, malengo na vikwazo vya kihisabati vinavyoeleweka na kisuluhishi cha uboreshaji mara nyingi huhitaji utaalamu wa utafiti wa uendeshaji. Utafiti huu unatengeneza mfumo wa modeli kubwa ya lugha uliosanifiwa kwa fine-tuning ili kupunguza kikwazo hiki cha utaalamu katika uzalishaji wa kidijitali kwa kubadilisha matatizo ya uzalishaji yaliyoandikwa kwa lugha ya kawaida kuwa miundo ya uboreshaji iliyo tayari kwa kisuluhishi.
Kiini cha mbinu ni kuchukua modeli ndogo kiasi iliyofunzwa awali yenye uwezo wa kutengeneza msimbo na kuifanyia fine-tune kwa data maalum ya eneo badala ya kutumia modeli kubwa sana na ya gharama kubwa ya kibiashara ya matumizi ya jumla. Kikomo cha urefu wa matokeo ya modeli kinajaribiwa kushughulikiwa kwa kugawa uundaji wa tatizo katika moduli huru za msimbo kama vigezo, vikwazo, kazi ya lengo, suluhisho na uonyeshaji, badala ya kuunda uundaji mzima mara moja. Hivyo tatizo la lugha ya kawaida linamodeliwa hatua kwa hatua kwa maagizo tofauti na moduli zinazotokana huunganishwa baadaye ili kupata modeli ya uboreshaji inayoweza kuendeshwa.
Watafiti walijaribu mfumo katika viwango vitatu: tatizo la kawaida la job-shop scheduling, tatizo tata zaidi la flexible job-shop scheduling linalotokana na muundo na sheria za uendeshaji wa kiwanda halisi cha urembeshaji nchini Australia, na benchmark ya upangaji mstari ya LPWP yenye matatizo 288 ya uboreshaji. Katika usanidi unaofaa wa mafunzo, mafanikio ya utekelezaji ya zaidi ya %95 yaliripotiwa katika kesi mbili za upangaji uzalishaji, huku katika jaribio la LPWP mbinu ya fine-tuned iliyopendekezwa ikifikia mafanikio ya %72. Standard GPT na Chain-of-Experts (CoE) zilionyesha mafanikio ya %43 katika ulinganisho huo huo. Tofauti hii ni pointi 29 za asilimia.
Kikomo muhimu cha matokeo ni hiki: utafiti hauonyeshi kwamba akili bandia inaweza kusimamia shughuli zote za kiwanda peke yake. Kazi ya modeli ni kubadilisha tatizo la uboreshaji lililoelezwa na binadamu kwa lugha ya kawaida kuwa fomu ya kihisabati/iliyowekwa katika msimbo; sehemu inayohesabu suluhisho halisi bora bado ni kisuluhishi cha uboreshaji kama OR-Tools. Aidha, katika utafiti wa kiwanda halisi, baadhi ya sheria za uzalishaji zilitoka katika biashara halisi, lakini tarehe za utoaji na baadhi ya kiasi zilitengenezwa kwa njia ya sintetiki kwa sababu hakukuwa na ufikiaji wa data za ERP.
Je, tatizo kuu katika uzalishaji ni AI kutatua tatizo au kufafanua tatizo kwa usahihi?
Hii ndiyo tofauti inayotumiwa kama msingi wa utafiti. Kisuluhishi cha uboreshaji kinaweza kutatua tatizo lililofafanuliwa kihisabati; lakini kubadilisha tatizo halisi la biashara kuwa modeli ya kihisabati ni utaalamu tofauti.
Tatizo la kupanga uzalishaji kwa kawaida lina angalau vipengele vitatu vya msingi:
- Vigezo vya maamuzi: Ni kazi gani itapangiwa mashine ipi? Kazi itaanza lini?
- Kazi ya lengo: Je, muda wa jumla wa uzalishaji, ucheleweshaji, gharama ya nishati au kipimo kingine ndicho kitakachopunguzwa?
- Vikwazo: Je, kazi mbili zinaweza kuendeshwa kwa wakati mmoja kwenye mashine hiyo hiyo? Operesheni zinapaswa kufuata mpangilio gani? Ni mashine ipi inaweza kufanya operesheni ipi?
Modeli hii kisha huandikwa katika mazingira ya uundaji kama MiniZinc, GAMS, AMPL au CPMpy iliyotumiwa katika utafiti na kupelekwa kwa kisuluhishi kama Gurobi, CPLEX, SCIP au OR-Tools.
Mchakato ambao watafiti wanauita “problem formulation” ni kubadilisha mahitaji halisi ya biashara kuwa muundo huu wa kihisabati unaoweza kuendeshwa.
LLM inafanya nini hasa hapa?
LLM hailazimishwi kukisia moja kwa moja ratiba bora ya uzalishaji. Badala yake, hubadilisha maelezo ya tatizo ya lugha ya kawaida kuwa modeli ya uboreshaji.
Mlolongo wa mchakato katika Kielelezo 2 ukirahisishwa:
Tatizo kwa lugha ya kawaida → Fine-tuned LLM → Vigezo vya maamuzi + vikwazo + kazi ya lengo → Solver → Suluhisho bora/linalofaa
ndivyo unavyoonekana.
Tofauti hii ni muhimu. LLM haichukui nafasi ya kisuluhishi cha uboreshaji wa kihisabati; inaendesha kiotomatiki uundaji wa modeli inayohitajika na kisuluhishi.
Kwa nini fine-tuning badala ya LLM ya matumizi ya jumla?
Waandishi wanasema kwamba sehemu kubwa ya kazi zilizopo hutumia prompt engineering au in-context learning, lakini hii inaweza kutotoa usahihi wa kutosha katika matatizo changamano ya uboreshaji wa uzalishaji.
Katika mbinu ya fine-tuning, modeli haiambiwi tu “tenda kama mtaalamu wa uboreshaji”. Modeli hufundishwa upya kwa mifano maalum ambapo tatizo la uzalishaji kwa lugha ya kawaida limeoanishwa na uundaji sahihi wa tatizo.
Wakati wa fine-tuning, tofauti kati ya modeli inayozalishwa na msimbo lengwa hupunguzwa kwa kutumia cross-entropy loss. Katika chanzo, kazi ya hasara imepewa kwa ujumla kama:
\[ l(x,y)=\frac{1}{N}\sum_{n=1}^{N}l_n \]
na kipengele cha kiwango cha token:
\[ l_n= -\log \frac{\exp(x_{n,y_n})} {\sum_{q=1}^{Q}\exp(x_{n,q})} \]
.
Hata hivyo, watafiti wanakubali wazi kwamba thamani ndogo ya cross-entropy loss pekee haithibitishi kwamba modeli sahihi ya uboreshaji imeundwa. Ndiyo maana msimbo unaozalishwa unaendeshwa kweli.
Kwa nini “uthibitishaji kwa kuendesha” ni muhimu?
LLM inaweza kutengeneza msimbo unaoonekana kuvutia kisintaksia lakini usio sahihi kihisabati. Ili kuzuia hili, watafiti huendesha uundaji uliotengenezwa kwa OR-Tools.
Matokeo matatu yanayowezekana yamefafanuliwa:
- Success: Uundaji unaendeshwa na kutoa suluhisho sahihi.
- Failure: Uundaji unaendeshwa lakini kutoa suluhisho lisilo sahihi.
- Exception: Uundaji hauwezi kuendeshwa au una hitilafu ya utekelezaji.
Kiwango cha mafanikio:
\[ Success=\frac{CR}{I}\times100 \]
kiwango cha kutofaulu:
\[ Failure=\frac{RE}{I}\times100 \]
na kiwango cha exception:
\[ Exception=\frac{CE}{I}\times100 \]
vimefafanuliwa.
Hapa I ni idadi ya jumla ya formulering, CR ni zile zinazotoa suluhisho sahihi, RE ni zinazotoa suluhisho lisilo sahihi, na CE ni modeli zisizoweza kuendeshwa.
Jaribio la kwanza: Job-Shop Scheduling ya kawaida
Kesi ya kwanza ni mojawapo ya matatizo ya kawaida ya upangaji uzalishaji, Job-Shop Scheduling. Kazi nyingi lazima zipitie mashine maalum kwa mpangilio maalum na mashine hiyo hiyo inaweza kushughulikia operesheni moja tu kwa wakati mmoja.
Utafiti unazingatia kazi tatu tofauti za lengo:
- makespan, yaani muda wa jumla hadi kazi ya mwisho ikamilike,
- ucheleweshaji wa juu zaidi,
- jumla ya ucheleweshaji uliopimwa kwa uzito wa kipaumbele.
Kwa mfano makespan:
\[ \min C_{max} \]
hupunguzwa na kwa muda wa mwisho wa operesheni ya mwisho ya kila kazi:
\[ C_{max}\geq e_{j,n_j} \]
kikwazo hutumika.
Pia, operesheni mbili kwenye mashine moja hazipaswi kugongana na operesheni ndani ya kazi moja lazima ziende kwa mpangilio sahihi.
Seti ya kwanza ya data iliundwaje?
Kwa JSS ya kawaida, watafiti awali waliunda kwa mkono maelezo 100 ya matatizo na formulering zake zinazolingana.
Urefu wa formulering za matatizo ulikuwa takriban token 1200–1800. Maelezo ya matatizo yalikuwa chini ya token 600.
Kwa sababu matokeo ambayo modeli inaweza kuunda kwa mkupuo mmoja yalikuwa mafupi kuliko formulering hizi, msimbo uligawanywa katika sehemu tisa tofauti za kazi. Kwa kuwa maagizo tisa tofauti yalitumika, kutoka matatizo 100 ya msingi:
100 × 9 = mifano 900 ya mafunzo
ilipatikana.
Kwa nini kikomo cha token kilikuwa muhimu?
Maandishi ya utafiti yanaeleza kwamba modeli ndogo ya kuzalisha msimbo iliyotumiwa ilikuwa na kikomo cha matokeo cha takriban token 600. Modeli kamili ya upangaji uzalishaji ni ndefu mara kadhaa zaidi.
Badala ya kutumia modeli kubwa na ghali zaidi, watafiti hufanya msimbo kuwa wa moduli.
Kwa mfano maagizo tofauti yanaweza kuwakilisha kazi ndogo kama:
- tengeneza maktaba zinazohitajika,
- unda vigezo vya maamuzi,
- andika vikwazo vya kutogongana,
- ongeza vikwazo vya kipaumbele,
- fafanua kazi ya lengo,
- tatua modeli,
- onyesha matokeo
.
Kila tatizo dogo hubaki ndani ya kikomo cha token cha modeli; katika hatua ya mwisho moduli huunganishwa.
Matokeo ya jaribio la JSS ya kawaida yalikuwa nini?
Matokeo yanaonyesha kwamba muda wa mafunzo na mafanikio hutegemea sana batch size na idadi ya epoch.
Kwa mfano:
| Batch | Epoch | Loss | Muda wa mafunzo (s) | Mafanikio | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0056 | 1083,78 | %16 | %23 | %61 |
| 1 | 8 | 0,0008 | 8561,05 | %96 | %0 | %4 |
| 2 | 4 | 0,0014 | 2554,93 | %100 | %0 | %0 |
| 4 | 4 | 0,0017 | 1733,71 | %97 | %0 | %3 |
Kwa hiyo, kauli kwamba “modeli ilipata mafanikio ya zaidi ya %95” si sahihi kwa kila hatua ya mafunzo. Kiwango hicho kilifikiwa katika usanidi unaofaa baada ya fine-tuning ya kutosha.
Kesi halisi ya kiwanda ilikuwa nini?
Kesi ya pili ni mtengenezaji wa urembeshaji anayefanya kazi Melbourne na kuitwa XYZ katika makala kwa sababu za usiri.
Kielelezo 1 kinaonyesha mpangilio halisi wa uzalishaji wa kiwanda. Kuna vikundi saba vya mashine:
- Flat,
- Hanging,
- Cap Front,
- Patch,
- Little Fang,
- Packaging,
- 7-Head.
Mtiririko halisi wa mfano ulioonyeshwa katika kielelezo ni:
Cap Machine → Flat Machine → Flat Machine → Hanging Machine
.
Kwa nini tatizo hili ni gumu zaidi kuliko JSS ya kawaida?
Katika JSS ya kawaida, mashine itakayotekeleza operesheni mara nyingi hujulikana mapema. Katika kiwanda cha XYZ, baadhi ya operesheni zinaweza kufanywa kwenye zaidi ya mashine moja inayofaa.
Kwa hiyo formulering itakayoundwa na AI lazima imodelli maamuzi mawili kwa wakati mmoja:
- operesheni itapangiwa mashine ipi,
- itaendeshwa kwa mpangilio gani kwenye mashine hiyo?
Muundo huu unaainishwa kama Flexible Job-Shop Scheduling Problem (FJSS).
Sheria halisi za biashara hubadilishwaje kuwa vikwazo vya kihisabati?
Katika kiwanda, kwa mfano, oda zenye vipande chini ya vinne zinaelekezwa kwa mashine za Little Fang, na oda zenye vipande vinne hadi saba zinaelekezwa kwa mashine za 7-Head.
Ikiwa muda wa kusubiri kwenye foleni ya 7-Head unazidi siku mbili za kazi, kazi inaweza kuhamishiwa kwenye mashine nyingine inayofaa.
Kazi ya LLM ni kubadilisha sheria hizi za lugha ya kawaida kuwa:
- vigezo vya uhalali wa mashine,
- vigezo vya ugawaji,
- muda wa kuanza,
- vipaumbele vya operesheni,
- kazi ya lengo ya makespan
.
Kikomo cha neno “ulimwengu halisi” ni kipi?
Kiwanda, vikundi vya mashine na sheria za uendeshaji vinatokana na mazingira halisi ya uzalishaji. Hata hivyo, kwa kuwa watafiti hawakuwa na ufikiaji wa data za ERP, tarehe za utoaji zilitengenezwa kwa nasibu kutoka kwenye usambazaji uniform. Baadhi ya kiasi cha kazi pia kiliundwa kwa nasibu ili kuiga hali tofauti za mashine.
Aidha, muda wa usafirishaji kati ya mashine haukujumuishwa katika modeli.
Kwa hiyo kesi hii inapaswa kutathminiwa kama senario ya majaribio ya sehemu ya sintetiki inayotokana na muundo halisi wa kiwanda.
Seti ya data ya kesi ya ulimwengu halisi ilipanuliwaje?
Watafiti awali waliunda matatizo 50 ya msingi ya upangaji uzalishaji na formulering zake sahihi.
Kwa sababu ugumu ulikuwa mkubwa zaidi wakati huu, maagizo 16 tofauti ya moduli yalitumika:
50 × 16 = mifano 800.
Aidha, ChatGPT ilitumiwa kama jenereta ya data sintetiki ili kuongeza utofauti wa lugha katika maelezo ya matatizo.
Kwa mfano tatizo hilo hilo liliandikwa upya:
- kutoka mtazamo wa meneja wa uzalishaji,
- kutoka mtazamo wa operator wa kiwanda,
- kwa lugha ya meneja anayelenga matumizi ya mashine
na hivyo mifano ya mafunzo yenye maana inayofanana lakini lugha tofauti iliundwa.
Kwa nini kuongeza data huku ni muhimu?
Haiwezi kutarajiwa kwamba wafanyakazi halisi wataelezea tatizo moja la uzalishaji kwa maneno yale yale. Meneja wa uzalishaji anaweza kusema “ongeza kiwango cha matumizi ya mashine”, huku operator akisema “usiache kazi kwenye foleni ya 7-Head”.
Ikiwa modeli itakariri tu muundo mmoja wa sentensi, inaweza kushindwa katika mazingira halisi. Uandishi upya wa sintetiki unalenga kuiga namna wadau tofauti wanavyoweza kuelezea tatizo lile lile la uendeshaji kwa lugha tofauti.
Hata hivyo, utofauti huu umetengenezwa na ChatGPT; si korpasi kubwa ya lugha ya kawaida iliyokusanywa kutoka kwa wafanyakazi halisi wa kiwanda katika majukumu tofauti.
Mafanikio katika senario ya ulimwengu halisi yalikuwa yapi?
Baadhi ya usanidi wa mafunzo katika Jedwali 4 ni:
| Batch | Epoch | Loss | Muda (s) | Mafanikio | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0029 | 864,64 | %6 | %0 | %94 |
| 1 | 4 | 0,0003 | 3454,53 | %100 | %0 | %0 |
| 2 | 4 | 0,0004 | 2141,21 | %100 | %0 | %0 |
| 4 | 4 | 0,0013 | 1445,31 | %23 | %20 | %57 |
| 4 | 8 | 0,0003 | 2902,65 | %100 | %0 | %0 |
Jedwali hili linaonyesha wazi kwamba fine-tuning si suala la “kuonyesha mifano michache” tu. Kwa mfano, kwa batch 4 mafanikio yalikuwa %23 pekee baada ya epoch nne lakini yakafikia %100 baada ya epoch nane.
Je, modeli inaweza kuwa imekariri?
Watafiti walitathmini hatari hii kwa kulinganisha mikunjo ya training loss na validation loss.
Kielelezo 4 kinaonyesha mikunjo ya training na validation loss kwa JSS ya kawaida, na Kielelezo 8 kwa FJSS ya ulimwengu halisi. Waandishi wanatafsiri kukaribiana kwa mikunjo kadiri mafunzo yanavyoendelea na kutokuwepo kwa utengano mkubwa wa kudumu kama ushahidi dhidi ya overfitting.
Hata hivyo, matokeo haya ni ushahidi wa ujanibishaji kwa data za validation/test zilizotenganishwa kutoka usambazaji huohuo; si ushahidi wa ujanibishaji wa ulimwengu wote kwa aina tofauti kabisa za viwanda au miundo ya uboreshaji ambayo haijawahi kuonekana.
Uchambuzi wa PCA embedding unaonyesha nini?
Watafiti walipunguza encoder na decoder embedding za modeli ya fine-tuned hadi vipimo viwili kwa kutumia PCA.
Katika JSS ya kawaida, maelezo ya matatizo yanaonekana kuunda makundi yaliyo wazi zaidi kulingana na maagizo tofauti. Katika kesi ya ulimwengu halisi, pointi zimetawanyika zaidi; hili linatafsiriwa kama ongezeko la utofauti wa lugha na muundo.
Katika decoder embedding, moduli tofauti za msimbo pia huunda makundi tofauti. Kwa mfano:
- imports,
- configurations,
- constraints,
- objective,
- visualisation,
- solution
kutenganishwa katika maeneo tofauti ya uwakilishi kunawasilishwa kama uchambuzi msaidizi unaounga mkono wazo kwamba modeli haikunakili tu msimbo wote kama kiolezo kimoja.
Kwa nini benchmark ya LPWP ilitumika?
Majaribio mawili ya kwanza yanaelekezwa moja kwa moja kwenye upangaji uzalishaji. Ili kujaribu kama mbinu haifanikiwi tu kwenye seti zao wenyewe za data, watafiti pia walitumia seti ya kawaida ya upangaji mstari inayoitwa LPWP.
LPWP ina jumla ya maelezo 288 ya matatizo.
Mbinu zilizolinganishwa:
- Standard GPT,
- Chain-of-Thought (CoT),
- Progressive-Hint Prompting (PHP),
- Chain-of-Experts (CoE),
- fine-tuned framework iliyopendekezwa.
Matokeo katika LPWP yalikuwa nini?
| Mbinu | Mafanikio | Failure | Exception |
|---|---|---|---|
| Standard | %43 | %24 | %33 |
| CoT | %7 | %7 | %86 |
| PHP | %2 | %3 | %95 |
| CoE | %43 | %31 | %26 |
| Fine-tuned framework | %72 | %26 | %2 |
“Takriban %30 bora zaidi” inamaanisha nini?
Makala inaelezea jedwali hili kama “approximately 30% performance improvement”.
Hata hivyo, thamani ghafi:
\[ 72\%-43\%=29 \text{ yüzde puanı} \]
zinaonyesha tofauti.
Kwa hiyo, usemi ulio wazi zaidi ni ongezeko la pointi 29 za asilimia katika kiwango cha mafanikio.
Ikiwa ongezeko la jamaa linahesabiwa:
\[ \frac{72-43}{43}\times100 \approx 67,4\% \]
hupatikana. Katika makala hii ya Verianla, ili kutofanya dai la chanzo lionekane lenye nguvu au dhaifu kuliko lilivyo, viwango ghafi vya mafanikio na tofauti ya pointi za asilimia hutumiwa badala ya “takriban %30 ya uboreshaji wa jamaa”.
Maelezo muhimu katika maandalizi ya data za LPWP
LPWP ilikuwa na maelezo ya matatizo na matokeo yaliyotarajiwa lakini haikuwa na formulering za matatizo zinazohitajika.
Watafiti waliunda formulering za awali kwa kutumia GPT-3.5 na kisha wakakagua kwa mkono mifano ambayo haikulingana na matokeo yaliyotarajiwa.
Makala inaeleza kwamba katika baadhi ya kutokulingana, thamani zilizotarajiwa za LPWP zilikuwa zisizo sahihi, na baadhi ya formulering za GPT-3.5 pia zilikuwa na matatizo. Toleo lililosahihishwa la LPWP lilichapishwa kando.
Kwa hiyo, maandalizi ya benchmark yalitumia si uzalishaji otomatiki pekee bali pia uthibitishaji wa binadamu.
Kwa nini modeli ndogo ilichaguliwa?
Mojawapo ya malengo makuu ya muundo wa utafiti ni kupunguza gharama za kompyuta. Waandishi wanalenga kuingiza maarifa ya eneo katika modeli kwa kufanyia fine-tune modeli ndogo na huria ya kuzalisha msimbo badala ya kutumia modeli kubwa za kibiashara.
Katika Jedwali 2 mfumo wa mafunzo umepewa kama:
- GPU: NVIDIA Tesla V100 SXM2 32 GB,
- maelezo ya modeli: Salesforce/codet5-large-ntp-py,
- tokenizer: Salesforce/codet5-large-ntp-py,
- learning rate: 5×10⁻⁵,
- gradient checkpointing: imewashwa,
- evaluation steps: 10
.
Maandishi, hata hivyo, yanaeleza mbinu kupitia CodeRL. Ingawa yanasema kwamba CodeRL ni usanifu unaotegemea CodeT5, chanzo hakitenganishi kwa uwazi wa kutosha kama checkpoint halisi ilianzishwa kwa jina la CodeRL au moja kwa moja kwa checkpoint ya CodeT5.
Je, SME/KOBI zinaweza kutumia mfumo huu mara moja?
Utafiti unasema kwamba modeli ndogo zinaweza kupunguza gharama za kompyuta na leseni, kutoa faida ya faragha ya data kwa matumizi ya ndani ya kampuni au edge, na kurahisisha ufikiaji wa zana za hali ya juu za uboreshaji kwa KOBI zenye utaalamu mdogo wa uboreshaji.
Hata hivyo, utafiti haukupima:
- utekelezaji kamili wa uzalishaji katika KOBI,
- hesabu ya faida kwa uwekezaji,
- ulinganisho wa gharama kati ya cloud na seva ya ndani ya kampuni,
- gharama ya mafunzo ya operator,
- gharama ya matengenezo na kusasisha modeli
.
Kwa hiyo, hitimisho la “cost-effective” ni dai la kiufundi linalotegemea kupungua kwa mahitaji ya usanifu na kompyuta ikilinganishwa na modeli kubwa za kibiashara; si matokeo ya ROI ya kibiashara yaliyothibitishwa.
Ni uwezo gani muhimu zaidi wa mbinu hii katika uzalishaji?
Wazo muhimu zaidi ni kwamba mfanyakazi wa uzalishaji hahitaji kuandika modeli ya uboreshaji wa kihisabati kutoka mwanzo.
Kwa mfano, meneja anaweza kutoa hitaji la biashara kwa lugha ya kawaida kama:
“Oda ya dharura imekuja, mashine ya vichwa saba imejaa kwa siku mbili, hamisha kazi hii kwenye mashine nyingine inayofaa na punguza muda wa jumla wa uzalishaji.”
.
Katika hali bora, modeli ya fine-tuned huiunda hii kama kigezo kipya cha maamuzi au kikwazo, na solver huhesabu ratiba iliyosasishwa.
Hata hivyo, utafiti chanzo haukujaribu kwa majaribio aina zote za hali zisizotarajiwa kwa muda mrefu katika shughuli halisi za kiwanda. Kwa hiyo, senario hii ya matumizi inapaswa kutathminiwa kama uwezo wa usanifu unaoungwa mkono na utafiti.
Utafiti unaunga mkono nini?
- Matatizo ya uboreshaji yaliyo katika lugha ya kawaida yanaweza kubadilishwa kuwa formulering za solver-ready kwa fine-tuning maalum ya eneo.
- Modularization inaweza kusaidia kuzalisha msimbo mrefu wa uboreshaji kwa modeli ndogo zenye uwezo mdogo wa token.
- Tathmini ya execution-based hutoa ukaguzi wa moja kwa moja zaidi wa usahihi wa formulering kuliko kufanana kwa lugha pekee.
- Katika usanidi unaofaa wa fine-tuning, mafanikio ya zaidi ya %95 yalipatikana katika kesi za kawaida na ngumu zaidi za upangaji uzalishaji.
- Katika jaribio la LPWP, mbinu ya fine-tuned ilifikia mafanikio ya %72 na kuzidi matokeo ya %43 ya Standard/CoE katika jedwali hilo hilo.
- Maelezo sintetiki ya matatizo yanaweza kutumika kupanua seti ya mafunzo wakati data za eneo hazitoshi.
- Sheria za biashara halisi za uzalishaji zinaweza kubadilishwa kutoka lugha ya kawaida kuwa vikwazo rasmi vya uboreshaji.
Utafiti hauthibitishi nini?
- Haithibitishi kwamba LLM inaweza kumodeli kwa usahihi matatizo yote ya uzalishaji bila usimamizi wa binadamu.
- Modeli ya fine-tuned haitoi dhamana ya mafanikio ya zaidi ya %95 katika aina zote za viwanda.
- LLM haichukui nafasi ya kisuluhishi cha uboreshaji.
- Data zote za kesi ya ulimwengu halisi hazikutoka kwenye historia halisi ya uzalishaji ya ERP.
- Haijapimwa ni kiasi gani kiolesura cha lugha ya kawaida kinapunguza muda wa kazi wa waendeshaji halisi.
- ROI ya kiuchumi katika KOBI haijahesabiwa.
- Matumizi ya nishati, taka au uzalishaji wa kaboni hayakupimwa moja kwa moja.
- Haijaonyeshwa kwamba mafanikio yale yale yataendelea katika mitandao mikubwa sana ya uzalishaji au madaraja tofauti kabisa ya uboreshaji.
- Haijaonyeshwa kwamba usimamizi wa mtaalamu wa matokeo ya modeli hauna umuhimu kabisa.
Mbinu na Matokeo ya Utafiti
Muhtasari wa muundo wa utafiti
| Kipengele | Matumizi |
|---|---|
| Kazi kuu | Kuzalisha formulering ya tatizo la uboreshaji kutoka lugha ya kawaida |
| Mbinu kuu | Fine-tuning ya LLM maalum ya eneo + prompt engineering + modularization ya msimbo |
| Familia ya modeli | Mbinu inayotegemea CodeRL/CodeT5 katika maandishi |
| Utambulisho wa modeli, Jedwali 2 | Salesforce/codet5-large-ntp-py |
| Maktaba ya uundaji wa tatizo | CPMpy |
| Kisuluhishi | OR-Tools |
| Fine-tuning | HuggingFace trainer |
| Mafunzo / validation / test | %70 / %10 / %20 |
| GPU | NVIDIA Tesla V100 SXM2 32 GB |
| Learning rate | 5 × 10⁻⁵ |
| Tathmini kuu | Success / Failure / Exception |
Kesi 1: Job-Shop Scheduling ya kawaida
| Sifa | Thamani |
|---|---|
| Tatizo msingi la mkono | 100 |
| Agizo la moduli | 9 |
| Jumla ya mifano | 900 |
| Maelezo ya tatizo | <600 token |
| Formulering kamili ya tatizo | 1200–1800 token |
| Usanidi unaojitokeza | Batch 2, epoch 4 |
| Kiwango cha mafanikio ya mafunzo | %100 |
| Failure | %0 |
| Exception | %0 |
Kesi 2: FJSS inayotegemea muundo halisi wa kiwanda
| Sifa | Thamani |
|---|---|
| Tatizo msingi | 50 |
| Agizo la moduli | 16 |
| Jumla ya mifano | 800 |
| Maelezo ya tatizo | <600 token |
| Urefu wa formulering | 1800–3400 token |
| Kundi la mashine | 7 |
| Tarehe za utoaji za ERP | Hazipo; zimetengenezwa kwa njia ya sintetiki |
| Muda wa usafirishaji | Haukuchukuliwa katika modeli |
Kwa nini flexible job-shop ni jaribio lenye nguvu zaidi?
Katika JSS ya kawaida, tatizo kuu ni kupanga mpangilio wa operesheni. Katika Flexible JSS, uchaguzi wa mashine pia huongezwa.
Kwa kila operesheni:
\[ y_{i,j,h}\in\{0,1\} \]
kigezo kinaonyesha kama operesheni imepangiwa mashine i au la.
Kuhakikisha kila operesheni imepangiwa mashine moja tu:
\[ \sum_i y_{i,j,h}=1 \]
hutekelezwa.
Aidha, operesheni inaweza kupangiwa tu mashine inayoweza kuifanya:
\[ y_{i,j,h}\leq a_{i,j,h} \]
Muundo huu unahitaji kubadilisha sheria za kiwanda zilizoelezwa kwa lugha ya kawaida kuwa vigezo vya maamuzi vya binary.
Maana ya kisayansi ya ulinganisho wa LPWP
Umuhimu wa jaribio la LPWP ni kwamba timu ya utafiti ilitoka nje ya seti zao wenyewe za data za uzalishaji.
Mbinu iliyopendekezwa ilifikia mafanikio ya %72, huku:
- Standard: %43,
- CoE: %43,
- CoT: %7,
- PHP: %2
zikiripotiwa.
Wakati huo huo, kiwango cha Exception cha mbinu iliyopendekezwa ni %2 pekee. Hili ni matokeo muhimu yanayoonyesha kwamba sehemu kubwa ya msimbo uliotengenezwa angalau inaweza kuendeshwa.
Hata hivyo, ni muhimu kukumbuka kwamba katika protocol ya benchmark, mbinu ya fine-tuned inahitaji data za mafunzo huku mbinu za prompt-based hazikufanyiwa fine-tune kwa njia hiyo hiyo. Ulinganisho unalinganisha aina mbili tofauti za paradigms za maendeleo kama zilivyotekelezwa katika utafiti huu.
Kikomo cha kipimo cha mafanikio
Ingawa tathmini ya execution-based ni nguvu muhimu, kigezo cha mafanikio kinategemea formulering kutoa suluhisho sahihi.
Kwa hiyo, matokeo yanathibitisha kwamba modeli iliyotengenezwa inatoa matokeo sahihi kwa mfano wa jaribio uliotolewa. Hili peke yake si uthibitishaji rasmi unaothibitisha kwamba formulering mbili za kihisabati ni sawa kabisa kisemantiki kwa kila mfano wa data unaowezekana.
Tofauti hii inaonyesha kwa nini, hasa katika matumizi ya uzalishaji ya safety-critical au yenye gharama kubwa, tabaka za uthibitishaji wa modeli za binadamu au otomatiki bado zinaweza kuwa muhimu.
Nguvu za utafiti
- Kupima si kufanana kwa maandishi ya matokeo ya LLM pekee bali pia utekelezaji halisi wa solver.
- Kuchunguza pamoja benchmark ya kawaida na kesi inayotokana na mazingira halisi ya uzalishaji.
- Kueleza mchakato wa kuandaa seti za data za fine-tuning.
- Kuripoti wazi mgawanyo wa data wa %70/%10/%20.
- Kushughulikia kikomo cha token kwa modularization kwa njia ya kimfumo.
- Kueleza wazi mchakato wa kuongeza data sintetiki.
- Kushiriki sehemu kubwa ya seti za data na artefakti zilizoundwa katika hazina huria.
- Kuchunguza si usahihi wa mwisho pekee bali pia tabia ya uwakilishi wa ndani kwa uchambuzi wa embedding.
Mapungufu makuu ya utafiti
Kikomo cha kwanza ambacho waandishi wenyewe wanataja katika sehemu ya hitimisho ni kwamba utendaji hutegemea ubora na utofauti wa data za mafunzo. Matatizo mapya yanayotofautiana sana na usambazaji wa mafunzo yanaweza kuhitaji fine-tuning ya ziada au uthibitishaji wa binadamu.
Kikomo cha pili ni tatizo la token. Modularization hupunguza tatizo la sasa lakini katika matatizo makubwa sana au changamano sana ya uboreshaji, usanifu mdogo wa LLM wa sasa bado unaweza kutotosha.
Kikomo cha tatu ni wigo wa kesi. Majaribio yamelenga hasa matatizo ya ratiba za uzalishaji. Ujanibishaji kwa muundo wa mtandao, uboreshaji wa portfolio au madaraja mengine ya uboreshaji unahitaji kuthibitishwa kando.
Kikomo cha nne ni uthibitishaji wa muda mrefu wa uwanjani. Hali za kiwanda zinaweza kubadilika kwa muda; mashine mpya, bidhaa mpya, sheria mpya za kazi na njia tofauti za kujieleza za wafanyakazi zinaweza kubadilisha usambazaji wa modeli. Kwa hiyo waandishi wanapendekeza tafiti za muda mrefu za uwanjani kama mwelekeo wa utafiti wa baadaye.
Ina maana gani kwa biashara za utengenezaji nchini Uturuki?
Utafiti hauna data kutoka kiwanda nchini Uturuki. Kwa hiyo, si sahihi kisayansi kuhamisha moja kwa moja viwango vya mafanikio vya %95 au %72 vilivyoripotiwa kwenda mazingira ya uzalishaji nchini Uturuki.
Hata hivyo, mbinu inatoa usanifu unaoweza kujaribiwa kwa biashara za utengenezaji nchini Uturuki zinazotumia ERP/MES. Kwa matumizi ya ndani, seti ya data maalum ya eneo inapaswa kuandaliwa kwa kutumia data halisi za kampuni kuhusu:
- vikundi vya mashine,
- mfuatano wa operesheni,
- maagizo ya kazi,
- vikomo vya uwezo,
- sheria za zamu,
- tarehe za utoaji,
- madirisha ya matengenezo,
- sheria za wateja wa kipaumbele
na modeli lazima ithibitishwe tena kwenye data huru za majaribio.
Hasa ikiwa mfumo utaundwa ambapo wafanyakazi wa upangaji uzalishaji wanaeleza sheria kwa Kituruki cha kawaida, istilahi za uzalishaji za Kituruki zinapaswa pia kuwakilishwa kwa utofauti wa kutosha katika seti ya data ya fine-tuning. Kwa kuwa utafiti chanzo ulifanywa kwenye matatizo ya Kiingereza, hautoi matokeo ya moja kwa moja kuhusu utendaji katika Kituruki.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti wa awali: Business optimization for digital manufacturing: A fine-tuned large language model approach
Waandishi: Pivithuru Thejan Amarasinghe, Su Nguyen, Yuan Sun, Sobhan (Sean) Arisian, Damminda Alahakoon.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa kama ulivyo.
Mchango sawa/uandishi wa kwanza wa pamoja: Hakuna alama ya mchango sawa au uandishi wa kwanza wa pamoja katika chanzo.
Mwandishi anayewajibika: Sobhan (Sean) Arisian.
Taasisi 1: Research Center for Data Analytics and Cognition, La Trobe University, Melbourne, Victoria 3086, Australia.
Taasisi 2: College of Business and Law, RMIT University, Melbourne, Victoria 3000, Australia.
Taasisi 3: ARC Training Centre in Optimization Technologies, Integrated Methodologies, and Applications, University of Melbourne, Melbourne, Victoria 3053, Australia.
Jarida: International Journal of Production Economics.
Mchapishaji: Elsevier B.V.
Juzuu: 295.
Nambari ya makala: 109934.
DOI: 10.1016/j.ijpe.2026.109934
Kuwasilishwa: 23 Juni 2025.
Marekebisho: 12 Januari 2026.
Kukubaliwa: 19 Januari 2026.
Kuchapishwa mtandaoni: 29 Januari 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao na yenye ufikiaji wazi; utafiti wa kompyuta/akili bandia na uboreshaji wa uzalishaji.
Toleo maalum: Enhancing digital manufacturing via AI-LLM.
Kiungo rasmi cha uchapishaji: https://doi.org/10.1016/j.ijpe.2026.109934
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Hali ya preprint: Hati iliyokaguliwa ni makala ya mwisho ya International Journal of Production Economics; haijawasilishwa kama preprint.
Ufadhili: Hakuna Funding Statement tofauti katika PDF iliyokaguliwa. Katika sehemu ya CRediT, “Funding acquisition” imeorodheshwa kama mchango wa Pivithuru Thejan Amarasinghe.
Upatikanaji wa data: Ingawa hakuna Data Availability Statement tofauti, utafiti unashiriki seti za data na formulering za matatizo zilizoundwa katika hazina huria za GitHub. Hazina zilizotajwa katika chanzo ni pamoja na AI-Copilot-Data, AI-Copilot-Artifacts, AI-Copilot-Data-Real-World-Scenario, AI-Copilot-Artifacts-Real-World-Scenario na hazina iliyosahihishwa ya LPWP.
Mgongano wa maslahi: Hakuna Declaration of Competing Interest tofauti inayoonekana katika PDF iliyokaguliwa.
Michango ya CRediT: Pivithuru Thejan Amarasinghe: rasimu ya kwanza, mbinu, uchunguzi, upatikanaji wa ufadhili, uratibu wa data na uundaji wa dhana. Su Nguyen: rasimu ya kwanza, uthibitishaji, ushauri/usimamizi, mbinu, uchunguzi na uundaji wa dhana. Yuan Sun: rasimu ya kwanza, uthibitishaji, ushauri/usimamizi, rasilimali, mbinu na uundaji wa dhana. Sobhan (Sean) Arisian: mapitio/uhariri, uthibitishaji, ushauri/usimamizi, rasilimali na usimamizi wa mradi. Damminda Alahakoon: mapitio/uhariri, uthibitishaji, ushauri/usimamizi, rasilimali na uundaji wa dhana.
Kauli kuhusu AI zalishaji: ChatGPT ilitumika katika hatua ya uundaji data kutoa tofauti za sintetiki za maelezo ya matatizo ya upangaji uzalishaji ya ulimwengu halisi kutoka mitazamo tofauti ya wadau. Waandishi pia wanasema walitumia ChatGPT kuboresha lugha na usomaji katika baadhi ya sehemu za makala, kisha wakakagua na kuhariri matokeo wenyewe na kuchukua wajibu wa maudhui. GPT-3.5 ilitumika katika uundaji wa awali wa formulering za LPWP na kutokulingana kulikaguliwa kwa mkono.
Maelezo ya utambulisho wa modeli: Ingawa maandishi ya chanzo yanasema CodeRL ilitumika kama modeli iliyofunzwa awali katika majaribio, Jedwali 2 linatoa utambulisho wa modeli na tokenizer kama Salesforce/codet5-large-ntp-py. Ingawa inaelezwa kwamba CodeRL imejengwa juu ya CodeT5, tofauti ya checkpoint halisi haijawekwa wazi kikamilifu katika maandishi; kwa hiyo kauli zote mbili zimehifadhiwa kando hapa.
Kikomo cha data za ulimwengu halisi: Muundo wa kimwili/mashine na sheria za uendeshaji za kiwanda cha urembeshaji cha Melbourne zilitoka kwa biashara halisi. Hata hivyo, kwa sababu data za ERP hazikupatikana, tarehe za utoaji zilitolewa kwa nasibu, baadhi ya kiasi cha uzalishaji kilisimuliwa na muda wa usafirishaji kati ya mashine haukuhesabiwa. Matokeo hayapaswi kutafsiriwa kama utafiti kamili wa replay wa historia ya ERP.
Maelezo ya “%30 improvement”: Katika Jedwali 5 la LPWP, framework iliyopendekezwa ina mafanikio ya %72 na matokeo bora ya Standard na CoE yana %43. Tofauti ghafi ni pointi 29 za asilimia. Kauli ya chanzo ya “approximately 30% performance improvement” inaendana na tofauti hii ya pointi za asilimia; ongezeko la jamaa ni takriban %67.
Kikomo cha gharama: Chanzo kinaeleza mbinu ya modeli ndogo/fine-tuned kuwa cost-effective; lakini hakitoi TCO ya fedha, ROI au ulinganisho wa gharama halisi za uendeshaji wa KOBI.
Kikomo cha uendelevu: Sehemu ya hitimisho ya makala inajadili uwezo wa ufanisi bora wa uzalishaji kupunguza taka, matumizi ya nishati na alama ya kaboni. Haya si matokeo ya mazingira yaliyopimwa moja kwa moja katika utafiti huu.
Kikomo cha maudhui ya kisayansi: Mbinu, modeli, fomula, seti za data, vigezo vya mafunzo, kesi ya kiwanda, viwango vya mafanikio na mapungufu katika maudhui haya ya Verianla vinategemea utafiti wa awali. Vyanzo vya nje vilitumika tu kuthibitisha utambulisho wa kibibliografia, rekodi ya uchapishaji, mapitio na taarifa za mchapishaji.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *