

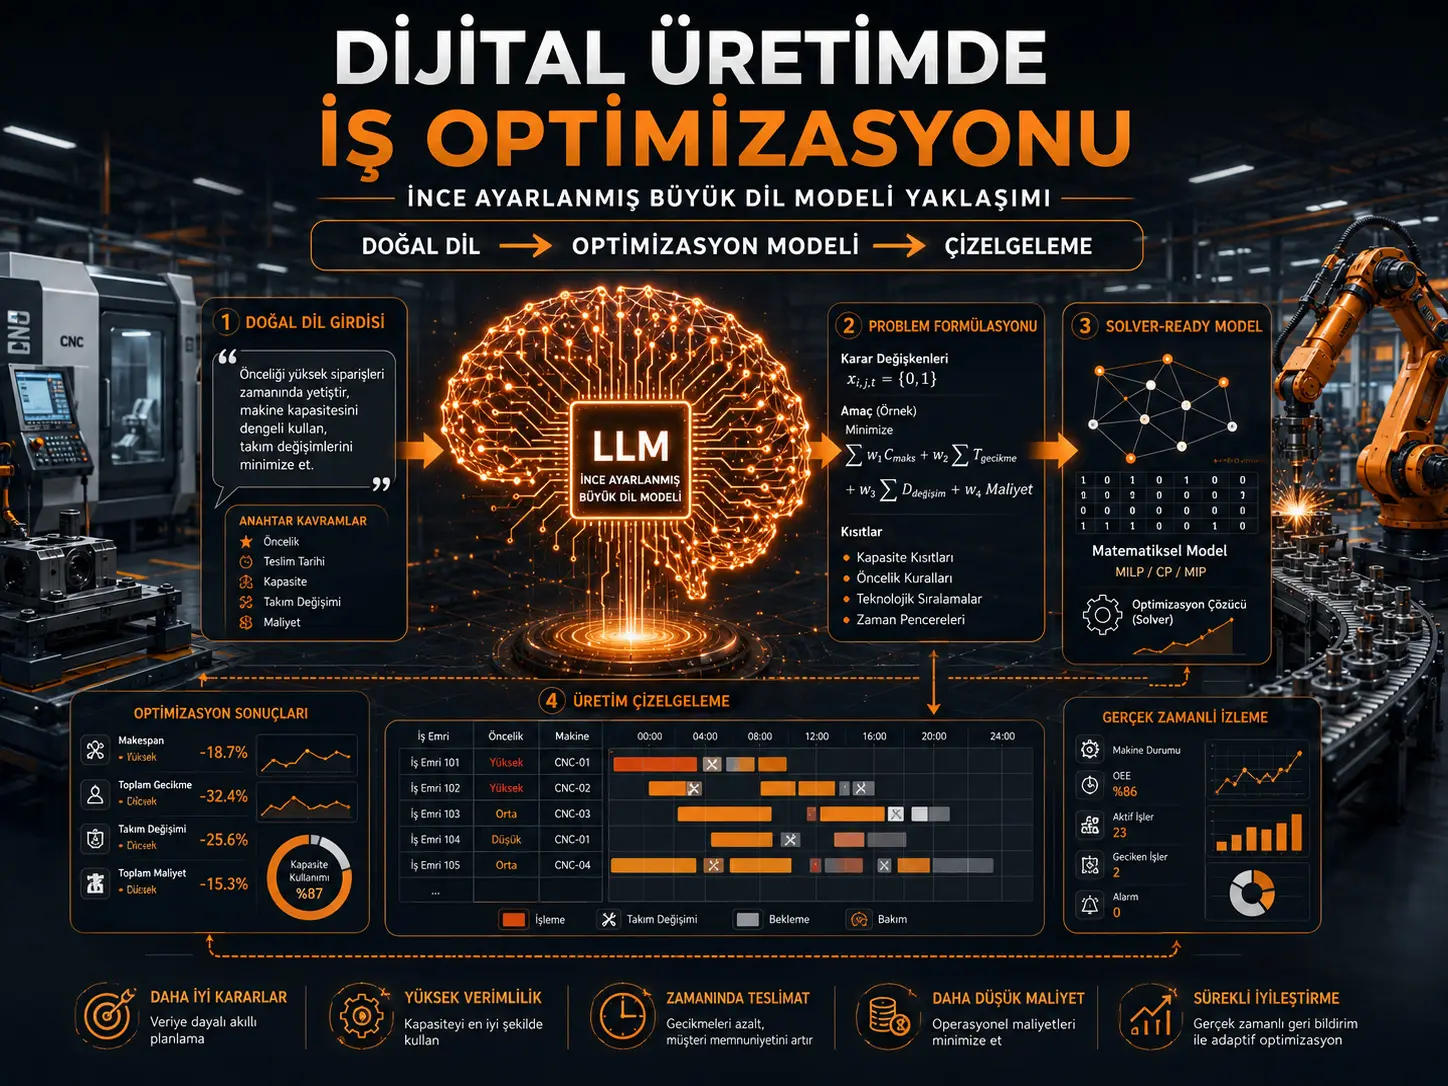
Ishlab chiqarish menejerining “bu buyurtmalarni mana shu mashinalarda, ushbu yetkazib berish muddatlariga muvofiq va eng qisqa umumiy vaqtda ishlab chiqar” deyishi oson; bu talabni optimallashtirish yechuvchisi tushunadigan qaror o‘zgaruvchilari, maqsad funksiyalari va matematik cheklovlarga aylantirish esa ko‘pincha operatsion tadqiqotlar bo‘yicha mutaxassislikni talab qiladi. Ushbu ish raqamli ishlab chiqarishdagi ana shu ekspertiza to‘sig‘ini kamaytirish uchun tabiiy tilda yozilgan ishlab chiqarish muammolarini avtomatik tarzda yechuvchiga tayyor optimallashtirish modellariga aylantiradigan nozik sozlangan katta til modeli doirasini ishlab chiqadi.
Yondashuv markazida umumiy maqsadli juda katta va qimmat tijorat modelidan foydalanish o‘rniga kod yaratish qobiliyatiga ega nisbatan kichik oldindan o‘qitilgan modelni sohaga xos ma’lumotlar bilan fine-tune qilish turadi. Modelning cheklangan chiqish uzunligi muammo formulatsiyasini bir martada yaratish o‘rniga o‘zgaruvchilar, cheklovlar, maqsad funksiyasi, yechim va vizualizatsiya kabi mustaqil kod modullariga ajratish orqali yengib o‘tilishga harakat qilinadi. Shu tarzda tabiiy til muammosi turli ko‘rsatmalar bilan bo‘lakma-bo‘lak modellashtiriladi va hosil bo‘lgan modullar keyinchalik birlashtirilib, bajariladigan optimallashtirish modeli olinadi.
Tadqiqotchilar tizimni uch darajada sinovdan o‘tkazgan: klassik job-shop scheduling muammosi, Avstraliyadagi haqiqiy kashtachilik fabrikasining tuzilishi va ish qoidalariga asoslangan murakkabroq flexible job-shop scheduling muammosi va 288 optimallashtirish muammosidan iborat LPWP chiziqli dasturlash benchmarki. Mos o‘qitish konfiguratsiyalarida ikki ishlab chiqarish rejalashtirish holatida %95 dan yuqori bajarilish muvaffaqiyati qayd etilgan bo‘lsa, LPWP testida taklif qilingan fine-tuned yondashuv %72 muvaffaqiyatga erishgan. Standard GPT va Chain-of-Experts (CoE) usullari shu taqqoslashda %43 muvaffaqiyat ko‘rsatgan. Bu farq 29 foiz punktini tashkil etadi.
Natijalarning muhim chegarasi shundaki, tadqiqot sun’iy intellekt fabrikaning barcha operatsiyalarini mustaqil boshqara olishini ko‘rsatmaydi. Modelning vazifasi inson tabiiy tilda ta’riflagan optimallashtirish muammosini matematik/kodlangan shaklga aylantirishdir; haqiqiy optimal yechimni hisoblaydigan komponent hanuz OR-Tools kabi optimallashtirish yechuvchisidir. Bundan tashqari, haqiqiy fabrika holida ayrim ishlab chiqarish qoidalari real korxonadan olingan bo‘lsa-da, ERP ma’lumotlariga kirish bo‘lmagani sababli yetkazib berish sanalari va ayrim miqdorlar sintetik tarzda yaratilgan.
Ishlab chiqarishdagi asosiy muammo sun’iy intellektning muammoni yechishimi yoki muammoni to‘g‘ri ta’riflashmi?
Tadqiqotning boshlang‘ich nuqtasi shu farqdir. Optimallashtirish yechuvchisi matematik tarzda ta’riflangan muammoni yecha oladi; biroq haqiqiy biznesdagi muammoni matematik modelga aylantirish alohida mutaxassislik sohasi hisoblanadi.
Ishlab chiqarishni rejalashtirish muammosi odatda kamida uchta asosiy tarkibiy qismni o‘z ichiga oladi:
- Qaror o‘zgaruvchilari: Qaysi ish qaysi mashinaga biriktiriladi? Ish qachon boshlanadi?
- Maqsad funksiyasi: Umumiy ishlab chiqarish vaqti, kechikish, energiya xarajati yoki boshqa mezon minimallashtiriladimi?
- Cheklovlar: Bir mashinada ikki ish bir vaqtda ishlashi mumkinmi? Operatsiyalar qaysi ketma-ketlikda bajarilishi kerak? Qaysi mashina qaysi operatsiyani bajara oladi?
Bu model keyin MiniZinc, GAMS, AMPL yoki tadqiqotda ishlatilgan CPMpy kabi modellashtirish muhitida kodlanadi va Gurobi, CPLEX, SCIP yoki OR-Tools kabi yechuvchiga uzatiladi.
Tadqiqotchilar “problem formulation” deb ataydigan jarayon real biznes talabini ushbu matematik va bajariladigan tuzilishga aylantirishdir.
LLM bu yerda aniq nima qiladi?
LLM to‘g‘ridan-to‘g‘ri optimal ishlab chiqarish jadvalini taxmin qilishga majburlanmaydi. Buning o‘rniga u tabiiy tildagi muammo tavsifini optimallashtirish modeliga aylantiradi.
Tadqiqotning 2-rasmidagi jarayon zanjiri soddalashtirilganda:
Tabiiy tildagi muammo → Fine-tuned LLM → Qaror o‘zgaruvchilari + cheklovlar + maqsad funksiyasi → Solver → Optimal/mos yechim
ko‘rinishidadir.
Bu farq muhim. LLM matematik optimallashtirish yechuvchisining o‘rnini egallamaydi; yechuvchi uchun zarur modelni yaratishni avtomatlashtiradi.
Nega umumiy maqsadli LLM o‘rniga fine-tuning?
Mualliflar mavjud ishlarning katta qismi prompt engineering yoki in-context learning dan foydalanishini, biroq murakkab ishlab chiqarish optimallashtirish muammolarida bu yetarli aniqlik bermasligi mumkinligini ta’kidlaydi.
Fine-tuning yondashuvida modelga shunchaki “optimallashtirish eksperti kabi harakat qil” deyilmaydi. Model tabiiy tildagi ishlab chiqarish muammosi to‘g‘ri muammo formulatsiyasi bilan juftlangan maxsus misollar asosida qayta o‘qitiladi.
Fine-tuning vaqtida hosil qilinadigan model bilan maqsad kod o‘rtasidagi farq cross-entropy loss yordamida kamaytiriladi. Manbada yo‘qotish funksiyasi umumiy holda:
\[ l(x,y)=\frac{1}{N}\sum_{n=1}^{N}l_n \]
va token darajasidagi had:
\[ l_n= -\log \frac{\exp(x_{n,y_n})} {\sum_{q=1}^{Q}\exp(x_{n,q})} \]
ko‘rinishida berilgan.
Biroq tadqiqotchilar faqat past cross-entropy loss qiymati to‘g‘ri optimallashtirish modeli yaratilganini isbotlamasligini alohida tan oladilar. Shu sababli yaratilgan kod haqiqatan bajariladi.
“Bajarib tekshirish” nega muhim?
LLM sintaksis jihatdan ta’sirli ko‘rinadigan, ammo matematik jihatdan noto‘g‘ri kod yaratishi mumkin. Tadqiqotchilar buning oldini olish uchun yaratilgan formulatsiyani OR-Tools yordamida ishga tushiradilar.
Uchta mumkin bo‘lgan natija ta’riflangan:
- Success: Formulatsiya ishlaydi va to‘g‘ri yechim beradi.
- Failure: Formulatsiya ishlaydi, ammo noto‘g‘ri yechim beradi.
- Exception: Formulatsiyani ishga tushirib bo‘lmaydi yoki bajarilish xatosi beradi.
Muvaffaqiyat darajasi:
\[ Success=\frac{CR}{I}\times100 \]
muvaffaqiyatsizlik darajasi:
\[ Failure=\frac{RE}{I}\times100 \]
va istisno darajasi:
\[ Exception=\frac{CE}{I}\times100 \]
deb ta’riflangan.
Bu yerda I umumiy formulatsiyalar soni, CR to‘g‘ri yechim berganlar, RE noto‘g‘ri yechim berganlar va CE bajarib bo‘lmaydigan modellardir.
Birinchi sinov: klassik Job-Shop Scheduling
Birinchi holat ishlab chiqarishni rejalashtirishning klassik muammolaridan biri — Job-Shop Scheduling. Ko‘plab ishlar ma’lum mashinalardan ma’lum tartibda o‘tishi kerak va bir mashina bir vaqtda faqat bitta operatsiyani bajara oladi.
Tadqiqot uch xil maqsad funksiyasini ko‘rib chiqadi:
- makespan, ya’ni oxirgi ish tugaguncha o‘tgan umumiy vaqt,
- maksimal kechikish,
- ustuvorlik bilan og‘irlashtirilgan umumiy kechikish.
Masalan makespan:
\[ \min C_{max} \]
tarzida minimallashtiriladi va har bir ishning oxirgi operatsiyasi tugash vaqti uchun:
\[ C_{max}\geq e_{j,n_j} \]
cheklovi qo‘llanadi.
Shuningdek, bir mashinadagi ikki operatsiya bir-biriga ustma-ust tushmasligi va bir ish ichidagi operatsiyalar to‘g‘ri tartibda davom etishi kerak.
Birinchi ma’lumotlar to‘plami qanday yaratildi?
Tadqiqotchilar klassik JSS uchun avval 100 ta muammo tavsifi va ularga mos muammo formulatsiyalarini qo‘lda yaratdilar.
Muammo formulatsiyalarining uzunligi taxminan 1200–1800 token oralig‘ida. Muammo tavsiflari esa 600 tokendan qisqa.
Model bir urinishda chiqara oladigan natija bu muammo formulatsiyalaridan qisqaroq bo‘lgani sababli kod to‘qqizta turli funksional qismga bo‘lingan. To‘qqizta alohida ko‘rsatma ishlatilgani uchun 100 ta asosiy muammodan:
100 × 9 = 900 ta o‘qitish misoli
olingan.
Token chegarasi nega muhim edi?
Tadqiqot matnida foydalanilgan kichik kod yaratish modelining taxminan 600 tokenlik chiqish chegarasi borligi aytiladi. To‘liq ishlab chiqarish rejalashtirish modeli bundan bir necha baravar uzun.
Tadqiqotchilar kattaroq va qimmatroq modeldan foydalanish o‘rniga kodni modullashtiradilar.
Masalan alohida ko‘rsatmalar:
- kerakli kutubxonalarni yarat,
- qaror o‘zgaruvchilarini yarat,
- to‘qnashmaslik cheklovlarini yoz,
- ustuvorlik cheklovlarini qo‘sh,
- maqsad funksiyasini ta’rifla,
- modelni yech,
- natijalarni vizualizatsiya qil
kabi kichik vazifalarga mos kelishi mumkin.
Har bir kichik muammo modelning token chegarasi ichida qoladi; yakunda modullar birlashtiriladi.
Klassik JSS tajribasida natija qanday bo‘ldi?
Natijalar o‘qitish vaqti va muvaffaqiyat batch size hamda epoch soniga kuchli bog‘liqligini ko‘rsatadi.
Masalan:
| Batch | Epoch | Loss | O‘qitish vaqti (s) | Muvaffaqiyat | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0056 | 1083,78 | %16 | %23 | %61 |
| 1 | 8 | 0,0008 | 8561,05 | %96 | %0 | %4 |
| 2 | 4 | 0,0014 | 2554,93 | %100 | %0 | %0 |
| 4 | 4 | 0,0017 | 1733,71 | %97 | %0 | %3 |
Demak, “model %95 dan yuqori muvaffaqiyat berdi” degan ibora har bir o‘qitish bosqichi uchun to‘g‘ri emas. Yetarli fine-tuning bajarilganda mos konfiguratsiyalarda shu darajaga erishilgan.
Haqiqiy fabrika holati nima edi?
Ikkinchi holat Melburnda faoliyat yuritadigan va maqolada maxfiylik sabab XYZ deb atalgan kashtachilik ishlab chiqaruvchisidir.
1-rasm fabrikaning haqiqiy ishlab chiqarish tuzilishini ko‘rsatadi. Korxonada yettita mashina guruhi mavjud:
- Flat,
- Hanging,
- Cap Front,
- Patch,
- Little Fang,
- Packaging,
- 7-Head.
Rasmda berilgan haqiqiy ish oqimi misoli:
Cap Machine → Flat Machine → Flat Machine → Hanging Machine
ko‘rinishidadir.
Nega bu muammo klassik JSS dan qiyinroq?
Standart JSS da operatsiya bajariladigan mashina ko‘pincha oldindan ma’lum. XYZ fabrikasida esa ayrim operatsiyalar bir nechta mos mashinada bajarilishi mumkin.
Shu sababli sun’iy intellekt yaratadigan formulatsiya ikki qarorni bir vaqtda modellashtirishi kerak:
- operatsiya qaysi mashinaga biriktiriladi,
- u mashinada qaysi tartibda bajariladi?
Bu tuzilma Flexible Job-Shop Scheduling Problem (FJSS) sifatida tasniflanadi.
Haqiqiy biznes qoidalari matematik cheklovga qanday aylantiriladi?
Fabrikada, masalan, to‘rtta donadan kam buyurtmalar Little Fang mashinalariga, to‘rtdan yetti donagacha bo‘lganlari 7-Head mashinalariga yo‘naltiriladi.
7-Head navbatida kutish ikki ish kunidan oshsa, ish boshqa mos mashinaga o‘tkazilishi mumkin.
LLM vazifasi bunday tabiiy til qoidalarini:
- mashina mosligi o‘zgaruvchilariga,
- biriktirish o‘zgaruvchilariga,
- boshlanish vaqtlariga,
- operatsiya ustuvorliklariga,
- makespan maqsad funksiyasiga
aylantirishdir.
“Haqiqiy dunyo” iborasining chegarasi nima?
Fabrika, mashina guruhlari va ish qoidalari real ishlab chiqarish muhitiga asoslangan. Biroq tadqiqotchilar ERP ma’lumotlariga kira olmagani uchun yetkazib berish sanalarini uniform taqsimotdan tasodifiy yaratgan. Ayrim ish miqdorlari ham turli mashina ssenariylarini simulyatsiya qilish uchun tasodifiy yaratilgan.
Shuningdek, mashinalar orasidagi tashish vaqtlari modelga kiritilmagan.
Shu sababli holat haqiqiy fabrika tuzilishidan kelib chiqqan, qisman sintetik tajriba ssenariysi sifatida baholanishi kerak.
Haqiqiy dunyo holatida ma’lumotlar to‘plami qanday kengaytirildi?
Tadqiqotchilar dastlab 50 ta asosiy ishlab chiqarish rejalashtirish muammosi va ularning to‘g‘ri formulatsiyalarini yaratdilar.
Bu safar murakkablik yuqoriroq bo‘lgani uchun 16 ta turli modulli ko‘rsatma ishlatildi:
50 × 16 = 800 ta misol.
Shuningdek, muammo tavsiflarining til xilma-xilligini oshirish uchun ChatGPT sintetik ma’lumot generatori sifatida ishlatilgan.
Masalan bir xil muammo:
- ishlab chiqarish menejeri nuqtai nazaridan,
- fabrika operatori nuqtai nazaridan,
- mashina foydalanishiga e’tibor beradigan menejer tilida
qayta yozdirilib, ma’no jihatdan o‘xshash, ammo til jihatdan turli o‘qitish misollari yaratilgan.
Bu ma’lumotni ko‘paytirish nega muhim?
Haqiqiy xodimlarning bir xil ishlab chiqarish muammosini aynan bir xil so‘zlar bilan ta’riflashi kutilmaydi. Ishlab chiqarish menejeri “mashina foydalanish darajasini oshir” deyishi mumkin, operator esa “7-Head navbatida ish qolmasin” deyishi mumkin.
Agar model faqat ma’lum gap qolipini yodlasa, haqiqiy muhitda muvaffaqiyatsiz bo‘lishi mumkin. Sintetik qayta yozish turli manfaatdor tomonlarning bir xil operatsion muammoni turlicha tilda ifodalashini taqlid qilishni maqsad qiladi.
Biroq bu xilma-xillik ChatGPT tomonidan sintez qilingan; turli vazifalarda ishlaydigan real fabrika xodimlaridan yig‘ilgan keng tabiiy til korpusi emas.
Haqiqiy dunyo ssenariysida muvaffaqiyat qanday bo‘ldi?
4-jadvaldagi ayrim o‘qitish konfiguratsiyalari quyidagicha:
| Batch | Epoch | Loss | Vaqt (s) | Muvaffaqiyat | Failure | Exception |
|---|---|---|---|---|---|---|
| 1 | 1 | 0,0029 | 864,64 | %6 | %0 | %94 |
| 1 | 4 | 0,0003 | 3454,53 | %100 | %0 | %0 |
| 2 | 4 | 0,0004 | 2141,21 | %100 | %0 | %0 |
| 4 | 4 | 0,0013 | 1445,31 | %23 | %20 | %57 |
| 4 | 8 | 0,0003 | 2902,65 | %100 | %0 | %0 |
Bu jadval fine-tuning shunchaki “bir necha misol ko‘rsatish”dan iborat emasligini aniq ko‘rsatadi. Masalan batch 4 bilan to‘rt epoch yakunida muvaffaqiyat atigi %23 bo‘lsa, sakkiz epoch yakunida %100 ga ko‘tariladi.
Model yodlab olgan bo‘lishi mumkinmi?
Tadqiqotchilar bu xavfni o‘qitish va validation loss egri chiziqlarini taqqoslash orqali baholagan.
4-rasm klassik JSS, 8-rasm esa haqiqiy dunyo FJSS uchun o‘qitish va validation loss egri chiziqlarini ko‘rsatadi. Mualliflar o‘qitish davom etgani sari egri chiziqlarning bir-biriga yaqinlashishini va katta doimiy ajralish ko‘rsatmasligini overfitting yo‘qligi deb talqin qiladilar.
Biroq bu natija bir xil taqsimotdan ajratilgan validation/test ma’lumotlari uchun umumlashtirish dalilidir; butunlay boshqa fabrika turlari yoki ko‘rilmagan optimallashtirish tuzilmalari uchun universal umumlashtirish dalili emas.
PCA embedding tahlillari nimani ko‘rsatadi?
Tadqiqotchilar fine-tuned modelning encoder va decoder embeddinglarini PCA orqali ikki o‘lchamga tushirgan.
Klassik JSS da muammo tavsiflari turli ko‘rsatmalarga qarab aniqroq klasterlar hosil qilgani ko‘rinadi. Haqiqiy dunyo holatida esa nuqtalar tarqoqroq; bu til va tuzilma xilma-xilligining ortishi sifatida talqin qilinadi.
Decoder embeddinglarida turli kod modullari ham alohida klasterlar hosil qiladi. Masalan:
- imports,
- configurations,
- constraints,
- objective,
- visualisation,
- solution
kabi bo‘limlarning turli vakillik hududlariga ajralishi model butun kodni faqat bitta qolip sifatida ko‘chirib olmaganini qo‘llab-quvvatlaydigan yordamchi tahlil sifatida taqdim etiladi.
LPWP benchmark nega ishlatildi?
Dastlabki ikki tajriba to‘g‘ridan-to‘g‘ri ishlab chiqarish rejalashtirishiga qaratilgan. Tadqiqotchilar usul faqat o‘zlari yaratgan ma’lumotlar to‘plamida muvaffaqiyatli emasligini sinash uchun LPWP deb nomlangan standart chiziqli dasturlash ma’lumotlar to‘plamiga ham o‘tgan.
LPWP jami 288 ta muammo tavsifini o‘z ichiga oladi.
Taqqoslangan usullar:
- Standard GPT,
- Chain-of-Thought (CoT),
- Progressive-Hint Prompting (PHP),
- Chain-of-Experts (CoE),
- taklif qilingan fine-tuned framework.
LPWP da natija qanday bo‘ldi?
| Usul | Muvaffaqiyat | Failure | Exception |
|---|---|---|---|
| Standard | %43 | %24 | %33 |
| CoT | %7 | %7 | %86 |
| PHP | %2 | %3 | %95 |
| CoE | %43 | %31 | %26 |
| Fine-tuned framework | %72 | %26 | %2 |
“Taxminan %30 yaxshiroq” nimani anglatadi?
Maqola bu jadvalni “approximately 30% performance improvement” deb ta’riflaydi.
Biroq xom qiymatlar:
\[ 72\%-43\%=29 \text{ yüzde puanı} \]
farqni ko‘rsatadi.
Shu sababli eng aniq ifoda muvaffaqiyat darajasida 29 foiz punktlik o‘sishdir.
Nisbiy o‘sish hisoblanganda:
\[ \frac{72-43}{43}\times100 \approx 67,4\% \]
hosil bo‘ladi. Ushbu Verianla maqolasida manba da’vosini kuchliroq yoki kuchsizroq qilib ko‘rsatmaslik uchun “taxminan %30 nisbiy yaxshilanish” o‘rniga xom muvaffaqiyat darajalari va foiz punkt farqi ishlatiladi.
LPWP ma’lumotini tayyorlashdagi muhim tafsilot
LPWP muammo tavsiflari va kutilgan natijalarni o‘z ichiga olgan, ammo zarur muammo formulatsiyalarini o‘z ichiga olmagan.
Tadqiqotchilar dastlabki formulatsiyalarni GPT-3.5 yordamida yaratgan va keyin kutilgan natijalarga mos kelmagan misollarni qo‘lda tekshirgan.
Maqola ayrim nomuvofiqliklarda LPWP ning kutilgan qiymatlari noto‘g‘ri bo‘lganini va ayrim GPT-3.5 formulatsiyalarida ham muammo bo‘lganini bildiradi. Tuzatilgan LPWP versiyasi alohida e’lon qilingan.
Demak benchmark tayyorlashda faqat avtomatik yaratish emas, inson tekshiruvi ham qo‘llangan.
Nega kichik model tanlandi?
Tadqiqotning asosiy dizayn maqsadlaridan biri hisoblash xarajatini kamaytirishdir. Mualliflar katta tijorat modellari o‘rniga ochiq manbali va kichikroq kod yaratish modelini fine-tune qilib, soha bilimini modelga singdirishni maqsad qiladilar.
2-jadvalda o‘qitish tizimi:
- GPU: NVIDIA Tesla V100 SXM2 32 GB,
- model tavsifi: Salesforce/codet5-large-ntp-py,
- tokenizer: Salesforce/codet5-large-ntp-py,
- learning rate: 5×10⁻⁵,
- gradient checkpointing: yoqilgan,
- evaluation steps: 10
deb berilgan.
Matn esa yondashuvni CodeRL orqali izohlaydi. CodeRL CodeT5 asosidagi arxitektura ekani aytiladi, biroq ishlatilgan aniq checkpoint CodeRL nomi bilanmi yoki to‘g‘ridan-to‘g‘ri CodeT5 checkpoint bilanmi ishga tushirilgani manbada yetarlicha ajratib ko‘rsatilmagan.
SME/KOBIlar bu tizimni darhol ishlata oladimi?
Tadqiqot kichik modellar hisoblash va litsenziya xarajatlarini kamaytirishi, kompaniya ichida yoki edge muhitida foydalanishda ma’lumot maxfiyligi afzalligini berishi va optimallashtirish ekspertizasi cheklangan KOBIlarning ilg‘or optimallashtirish vositalaridan foydalanishini osonlashtirishi mumkinligini ta’kidlaydi.
Biroq tadqiqotda:
- KOBIda to‘liq ishlab chiqarishga joriy etish,
- investitsiya qaytimi hisobi,
- bulut va kompaniya ichki server xarajati taqqoslanishi,
- operatorlarni o‘qitish xarajati,
- texnik xizmat va model yangilash xarajati
o‘lchanmagan.
Shu sababli “xarajatga samarali” degan xulosa arxitektura va hisoblash talablarining katta tijorat modellari bilan solishtirganda kamayishiga asoslangan texnik da’vodir; tasdiqlangan tijorat ROI natijasi emas.
Bu yondashuvning ishlab chiqarishdagi eng muhim salohiyati nima?
Eng muhim g‘oya — ishlab chiqarish xodimi matematik optimallashtirish modelini boshidan yozishi shart bo‘lmasligidir.
Masalan menejer:
“Shoshilinch buyurtma keldi, yetti boshli mashina ikki kun band, bu ishni boshqa mos mashinaga o‘tkaz va umumiy ishlab chiqarish vaqtini minimallashtir.”
kabi tabiiy tildagi biznes talabini bera oladi.
Ideal holatda fine-tuned model buni yangi qaror o‘zgaruvchisi yoki cheklov sifatida formulatsiya qiladi va solver yangilangan jadvalni hisoblaydi.
Biroq manba tadqiqot bunday barcha kutilmagan holatlarni haqiqiy fabrika operatsiyasida uzoq vaqt davomida eksperimental sinovdan o‘tkazmagan. Shu sababli ushbu foydalanish ssenariysi tadqiqot qo‘llab-quvvatlaydigan arxitekturaviy salohiyat sifatida baholanishi kerak.
Tadqiqot nimani qo‘llab-quvvatlaydi?
- Tabiiy tildagi optimallashtirish muammolari sohaga xos fine-tuning orqali solver-ready formulatsiyalarga aylantirilishi mumkin.
- Modullashtirish token sig‘imi cheklangan kichikroq modellar bilan uzun optimallashtirish kodlarini yaratishga yordam berishi mumkin.
- Execution-based baholash faqat til o‘xshashligidan ko‘ra formulatsiya aniqligini bevosita tekshiradi.
- Mos fine-tuning konfiguratsiyalarida klassik va murakkabroq ishlab chiqarish rejalashtirish holatlarida %95 dan yuqori muvaffaqiyatga erishilgan.
- LPWP testida fine-tuned yondashuv %72 muvaffaqiyatga erishib, shu jadvaldagi Standard/CoE ning %43 natijalaridan yuqori bo‘lgan.
- Sintetik muammo tavsiflari soha ma’lumotlari yetarli bo‘lmaganda o‘qitish ma’lumotlar to‘plamini kengaytirish uchun ishlatilishi mumkin.
- Haqiqiy ishlab chiqarish korxonasi qoidalari tabiiy tildan formal optimallashtirish cheklovlariga aylantirilishi mumkin.
Tadqiqot nimani isbotlamaydi?
- LLM barcha ishlab chiqarish muammolarini inson nazoratisiz to‘g‘ri modellashtira olishini isbotlamaydi.
- Fine-tuned model barcha fabrika turlarida %95 dan yuqori muvaffaqiyatni kafolatlamaydi.
- LLM optimallashtirish yechuvchisini almashtirmaydi.
- Haqiqiy dunyo holatidagi barcha ma’lumotlar real ERP ishlab chiqarish tarixidan kelmagan.
- Tabiiy til interfeysi real operatorlarning ish vaqtini qancha qisqartirgani o‘lchanmagan.
- KOBIlarda iqtisodiy investitsiya qaytimi hisoblanmagan.
- Energiya sarfi, chiqindi yoki uglerod emissiyasi bevosita o‘lchanmagan.
- Juda katta ishlab chiqarish tarmoqlarida yoki butunlay boshqa optimallashtirish sinflarida ayni muvaffaqiyat saqlanishi ko‘rsatilmagan.
- Model chiqishlarida ekspert nazorati mutlaqo keraksiz bo‘lib qolgani ko‘rsatilmagan.
Tadqiqot Usuli va Natijalari
Tadqiqot dizaynining xulosasi
| Tarkibiy qism | Qo‘llanish |
|---|---|
| Asosiy vazifa | Tabiiy tildan optimallashtirish muammosi formulatsiyasini yaratish |
| Asosiy yondashuv | Sohaga xos LLM fine-tuning + prompt engineering + kod modullashtirish |
| Model oilasi | Matnda CodeRL/CodeT5 asosidagi yondashuv |
| Model identifikatori, 2-jadval | Salesforce/codet5-large-ntp-py |
| Muammo modellashtirish kutubxonasi | CPMpy |
| Yechuvchi | OR-Tools |
| Fine-tuning | HuggingFace trainer |
| O‘qitish / validation / test | %70 / %10 / %20 |
| GPU | NVIDIA Tesla V100 SXM2 32 GB |
| Learning rate | 5 × 10⁻⁵ |
| Asosiy baholash | Success / Failure / Exception |
Holat 1: Klassik Job-Shop Scheduling
| Xususiyat | Qiymat |
|---|---|
| Qo‘lda tayyorlangan asosiy muammo | 100 |
| Modulli ko‘rsatma | 9 |
| Jami misol | 900 |
| Muammo tavsifi | <600 token |
| To‘liq muammo formulatsiyasi | 1200–1800 token |
| Ajralib turuvchi konfiguratsiya | Batch 2, epoch 4 |
| O‘qitish muvaffaqiyat darajasi | %100 |
| Failure | %0 |
| Exception | %0 |
Holat 2: Haqiqiy fabrika tuzilishiga asoslangan FJSS
| Xususiyat | Qiymat |
|---|---|
| Asosiy muammo | 50 |
| Modulli ko‘rsatma | 16 |
| Jami misol | 800 |
| Muammo tavsifi | <600 token |
| Formulatsiya uzunligi | 1800–3400 token |
| Mashina guruhi | 7 |
| ERP yetkazib berish sanalari | Mavjud emas; sintetik tarzda yaratilgan |
| Tashish vaqti | Modelga kiritilmagan |
Nega flexible job-shop kuchliroq sinov?
Klassik JSS da asosiy muammo operatsiyalarni ketma-ketlashtirishdir. Flexible JSS da bunga mashina tanlash ham qo‘shiladi.
Har bir operatsiya uchun:
\[ y_{i,j,h}\in\{0,1\} \]
o‘zgaruvchisi operatsiya i mashinaga biriktirilgan yoki biriktirilmaganini ko‘rsatadi.
Har bir operatsiyaning faqat bitta mashinaga biriktirilishi:
\[ \sum_i y_{i,j,h}=1 \]
bilan ta’minlanadi.
Shuningdek, operatsiya faqat mos bo‘lgan mashinaga biriktirilishi mumkin:
\[ y_{i,j,h}\leq a_{i,j,h} \]
Bu tuzilma tabiiy tilda ifodalangan fabrika qoidalarini ikkilik qaror o‘zgaruvchilariga aylantirishni talab qiladi.
LPWP taqqoslashining ilmiy ma’nosi
LPWP tajribasining ahamiyati tadqiqot jamoasining o‘z ishlab chiqarish ma’lumotlar to‘plamidan tashqariga chiqishidir.
Taklif qilingan usul %72 muvaffaqiyatga erishgan bo‘lsa:
- Standard: %43,
- CoE: %43,
- CoT: %7,
- PHP: %2
deb xabar qilingan.
Shuningdek, taklif qilingan usulning Exception darajasi atigi %2. Bu yaratilgan kodning katta qismi hech bo‘lmaganda bajarilishini ta’minlash nuqtai nazaridan muhim natija.
Biroq benchmark protokolida fine-tuned yondashuv o‘qitish ma’lumotini talab qilishi, prompt asosidagi usullar esa xuddi shu tarzda fine-tune qilinmaganini unutmaslik kerak. Taqqoslash ikki turli rivojlantirish paradigmasining ushbu tadqiqotda qo‘llangan ko‘rinishlarini taqqoslaydi.
Muvaffaqiyat metrikasining chegarasi
Execution-based baholash muhim kuchli jihat bo‘lsa-da, muvaffaqiyat mezoni formulatsiya to‘g‘ri yechim berishiga asoslanadi.
Shuning uchun natija yaratilgan model berilgan test misolida to‘g‘ri natija berganini tasdiqlaydi. Bu o‘z-o‘zicha ikki matematik formulatsiya barcha mumkin bo‘lgan ma’lumot misollarida to‘liq semantik jihatdan ekvivalentligini isbotlaydigan formal verifikatsiya emas.
Bu farq ayniqsa xavfsizlik kritik yoki yuqori xarajatli ishlab chiqarish qo‘llanmalarida inson yoki avtomatik model verifikatsiyasi qatlamlari nega hanuz muhimligini ko‘rsatadi.
Tadqiqotning kuchli tomonlari
- Faqat LLM chiqishining matn o‘xshashligini emas, real solver bajarilishini o‘lchashi.
- Klassik benchmark bilan haqiqiy ishlab chiqarish muhitidan kelib chiqqan holatni birga o‘rganishi.
- Fine-tuning ma’lumotlar to‘plamini tayyorlash jarayonini tushuntirishi.
- %70/%10/%20 ma’lumot bo‘linishini ochiq xabar qilishi.
- Token chegarasini modullashtirish orqali tizimli hal qilishi.
- Sintetik ma’lumotlarni ko‘paytirish jarayonini ochiq aytishi.
- Ma’lumotlar to‘plamlari va hosil qilingan artefaktlarning katta qismini ochiq omborlarda ulashishi.
- Embedding tahlili orqali faqat yakuniy aniqlikni emas, ichki vakillik xatti-harakatini ham ko‘rib chiqishi.
Tadqiqotning asosiy cheklovlari
Mualliflar xulosa bo‘limida qayd etgan birinchi cheklov — unumdorlik o‘qitish ma’lumotining sifati va xilma-xilligiga bog‘liq. O‘qitish taqsimotidan sezilarli darajada farq qiladigan yangi muammolar qo‘shimcha fine-tuning yoki inson tekshiruvini talab qilishi mumkin.
Ikkinchi cheklov token muammosidir. Modullashtirish mavjud muammoni kamaytiradi, biroq juda katta yoki juda murakkab optimallashtirish muammolarida hozirgi kichik LLM arxitekturalari yana yetarli bo‘lmasligi mumkin.
Uchinchi cheklov holatlar qamrovidir. Tajribalar asosan ishlab chiqarish jadvalini tuzish muammolariga qaratilgan. Tarmoq dizayni, portfel optimallashtirish yoki boshqa optimallashtirish sinflariga umumlashtirish alohida tasdiqlanishi kerak.
To‘rtinchi cheklov uzoq muddatli dala validatsiyasidir. Fabrika sharoitlari vaqt o‘tishi bilan o‘zgarishi mumkin; yangi mashinalar, yangi mahsulotlar, yangi ish qoidalari va xodimlarning turli ifoda usullari model taqsimotini o‘zgartirishi mumkin. Mualliflar shu sababli uzunlamasiga dala tadqiqotlarini kelajak tadqiqot yo‘nalishi sifatida tavsiya qiladilar.
Turkiyadagi ishlab chiqarish korxonalari uchun nimani anglatadi?
Tadqiqotda Turkiyadagi fabrikadan ma’lumot yo‘q. Shu sababli xabar qilingan %95 yoki %72 muvaffaqiyat ko‘rsatkichlarini Turkiyadagi ishlab chiqarish muhitlariga to‘g‘ridan-to‘g‘ri ko‘chirish ilmiy jihatdan to‘g‘ri emas.
Biroq usul Turkiyada ERP/MES ishlatadigan ishlab chiqarish korxonalari uchun sinab ko‘rish mumkin bo‘lgan arxitekturani taqdim etadi. Mahalliy qo‘llash uchun kompaniyaning haqiqiy:
- mashina guruhlari,
- operatsiya ketma-ketliklari,
- ish buyruqlari,
- quvvat cheklovlari,
- smena qoidalari,
- yetkazib berish sanalari,
- texnik xizmat oynalari,
- ustuvor mijoz qoidalari
asosida sohaga xos ma’lumotlar to‘plami tayyorlanishi va model mustaqil test ma’lumotida qayta tekshirilishi kerak.
Ayniqsa ishlab chiqarishni rejalashtirish xodimlari qoidalarni tabiiy turk tilida ifodalagan tizim qurilmoqchi bo‘lsa, turkcha ishlab chiqarish terminologiyasi ham fine-tuning ma’lumotlar to‘plamida yetarli xilma-xillikda aks ettirilishi kerak. Manba tadqiqot ingliz tilidagi muammolar ustida bajarilgani sababli turkcha samaradorlik bo‘yicha to‘g‘ridan-to‘g‘ri natija bermaydi.
Manba va Usul Haqida Izoh
To‘liq original tadqiqot nomi: Business optimization for digital manufacturing: A fine-tuned large language model approach
Mualliflar: Pivithuru Thejan Amarasinghe, Su Nguyen, Yuan Sun, Sobhan (Sean) Arisian, Damminda Alahakoon.
Mualliflar tartibi: Manba tadqiqotdagi tartib aynan saqlangan.
Teng hissa/teng birinchi muallif: Manbada teng hissa yoki teng birinchi muallif belgisi yo‘q.
Mas’ul muallif: Sobhan (Sean) Arisian.
Muassasa 1: Research Center for Data Analytics and Cognition, La Trobe University, Melbourne, Victoria 3086, Australia.
Muassasa 2: College of Business and Law, RMIT University, Melbourne, Victoria 3000, Australia.
Muassasa 3: ARC Training Centre in Optimization Technologies, Integrated Methodologies, and Applications, University of Melbourne, Melbourne, Victoria 3053, Australia.
Jurnal: International Journal of Production Economics.
Nashriyot: Elsevier B.V.
Jild: 295.
Maqola raqami: 109934.
DOI: 10.1016/j.ijpe.2026.109934
Yuborilgan: 23 iyun 2025.
Qayta ko‘rib chiqilgan: 12 yanvar 2026.
Qabul qilingan: 19 yanvar 2026.
Onlayn nashr: 29 yanvar 2026.
Manba turi: Taqrizdan o‘tgan, ochiq kirishli tadqiqot maqolasi; hisoblash/sun’iy intellekt va ishlab chiqarish optimallashtirish tadqiqoti.
Maxsus son: Enhancing digital manufacturing via AI-LLM.
Rasmiy nashr havolasi: https://doi.org/10.1016/j.ijpe.2026.109934
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Preprint holati: Ko‘rib chiqilgan hujjat yakuniy International Journal of Production Economics jurnal maqolasidir; preprint sifatida taqdim etilmagan.
Moliyalashtirish: Ko‘rib chiqilgan PDFda alohida Funding Statement yo‘q. CRediT bo‘limida Pivithuru Thejan Amarasinghe uchun “Funding acquisition” hissasi ko‘rsatilgan.
Ma’lumotlar mavjudligi: Alohida Data Availability Statement bo‘lmasa-da, tadqiqot ma’lumotlar to‘plamlari va yaratilgan muammo formulatsiyalarini ochiq GitHub omborlarida ulashadi. Manbada keltirilgan omborlar orasida AI-Copilot-Data, AI-Copilot-Artifacts, AI-Copilot-Data-Real-World-Scenario, AI-Copilot-Artifacts-Real-World-Scenario va tuzatilgan LPWP ma’lumot ombori mavjud.
Manfaatlar to‘qnashuvi: Ko‘rib chiqilgan PDFda alohida Declaration of Competing Interest bayonoti ko‘rinmaydi.
CRediT hissalari: Pivithuru Thejan Amarasinghe: dastlabki matn, metod, tadqiqot, moliyalashtirishni jalb qilish, ma’lumot kuratsiyasi va konseptuallashtirish. Su Nguyen: dastlabki matn, validatsiya, maslahat/nazorat, metod, tadqiqot va konseptuallashtirish. Yuan Sun: dastlabki matn, validatsiya, maslahat/nazorat, resurslar, metod va konseptuallashtirish. Sobhan (Sean) Arisian: ko‘rib chiqish/tahrirlash, validatsiya, maslahat/nazorat, resurslar va loyiha boshqaruvi. Damminda Alahakoon: ko‘rib chiqish/tahrirlash, validatsiya, maslahat/nazorat, resurslar va konseptuallashtirish.
Generativ sun’iy intellekt bayonoti: ChatGPT tadqiqotning ma’lumot yaratish bosqichida haqiqiy dunyo ishlab chiqarish rejalashtirish muammo tavsiflarining turli manfaatdor tomonlar nuqtai nazaridan sintetik variantlarini yaratish uchun ishlatilgan. Mualliflar shuningdek maqolaning ayrim bo‘limlarida til va o‘qiluvchanlikni yaxshilash uchun ChatGPT ishlatganini, so‘ng natijalarni o‘zlari ko‘rib chiqib tahrir qilganini va kontent uchun javobgarlikni o‘z zimmasiga olganini bildirgan. LPWP muammo formulatsiyalarining dastlabki yaratilishida GPT-3.5 ishlatilgan va nomuvofiqliklar qo‘lda tekshirilgan.
Model identifikatori izohi: Manba matni tajribalarda CodeRL oldindan o‘qitilgan model sifatida ishlatilganini aytsa, 2-jadval model va tokenizer identifikatorini Salesforce/codet5-large-ntp-py deb beradi. CodeRL CodeT5 ustiga qurilgani tushuntirilgan bo‘lsa-da, ishlatilgan aniq checkpoint CodeRL nomi bilanmi yoki to‘g‘ridan-to‘g‘ri CodeT5 checkpoint bilanmi boshlanganligi matnda to‘liq aniqlashtirilmagan; shu sababli bu ikki ifoda bu yerda alohida saqlangan.
Haqiqiy dunyo ma’lumotlari chegarasi: Melburndagi kashtachilik fabrikasining jismoniy/mashina tuzilishi va operatsion qoidalari real korxonadan olingan. Biroq ERP ma’lumotlariga kirish bo‘lmagani sababli yetkazib berish sanalari tasodifiy tayinlangan, ayrim ishlab chiqarish miqdorlari simulyatsiya qilingan va mashinalar orasidagi tashish vaqtlari hisobga olinmagan. Natijalarni to‘liq tarixiy ERP replay tadqiqoti sifatida talqin qilmaslik kerak.
“%30 yaxshilanish” izohi: LPWP 5-jadvalida taklif qilingan framework %72, eng yaxshi Standard va CoE natijalari %43 muvaffaqiyat ko‘rsatgan. Xom farq 29 foiz punktidir. Manbaning “approximately 30% performance improvement” iborasi ushbu mutlaq foiz-punkt farqi bilan mos keladi; nisbiy o‘sish taxminan %67.
Xarajat chegarasi: Manba kichik/fine-tuned model yondashuvini xarajatga samarali deb ataydi; biroq bevosita pul TCO, ROI yoki haqiqiy KOBI operatsion xarajat taqqoslashini bermaydi.
Barqarorlik chegarasi: Maqolaning xulosa bo‘limida yaxshiroq ishlab chiqarish samaradorligining chiqindi, energiya sarfi va uglerod izini kamaytirish salohiyati muhokama qilinadi. Bular ushbu tadqiqotda bevosita o‘lchangan ekologik natijalar emas.
Ilmiy kontent chegarasi: Ushbu Verianla kontentidagi metod, model, formulalar, ma’lumotlar to‘plamlari, o‘qitish parametrlari, fabrika holati, muvaffaqiyat ko‘rsatkichlari va cheklovlar original tadqiqotga asoslanadi. Tashqi manbalar faqat bibliografik identifikatsiya, nashr qaydi, taqriz va nashriyot ma’lumotini tekshirish uchun ishlatilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan