

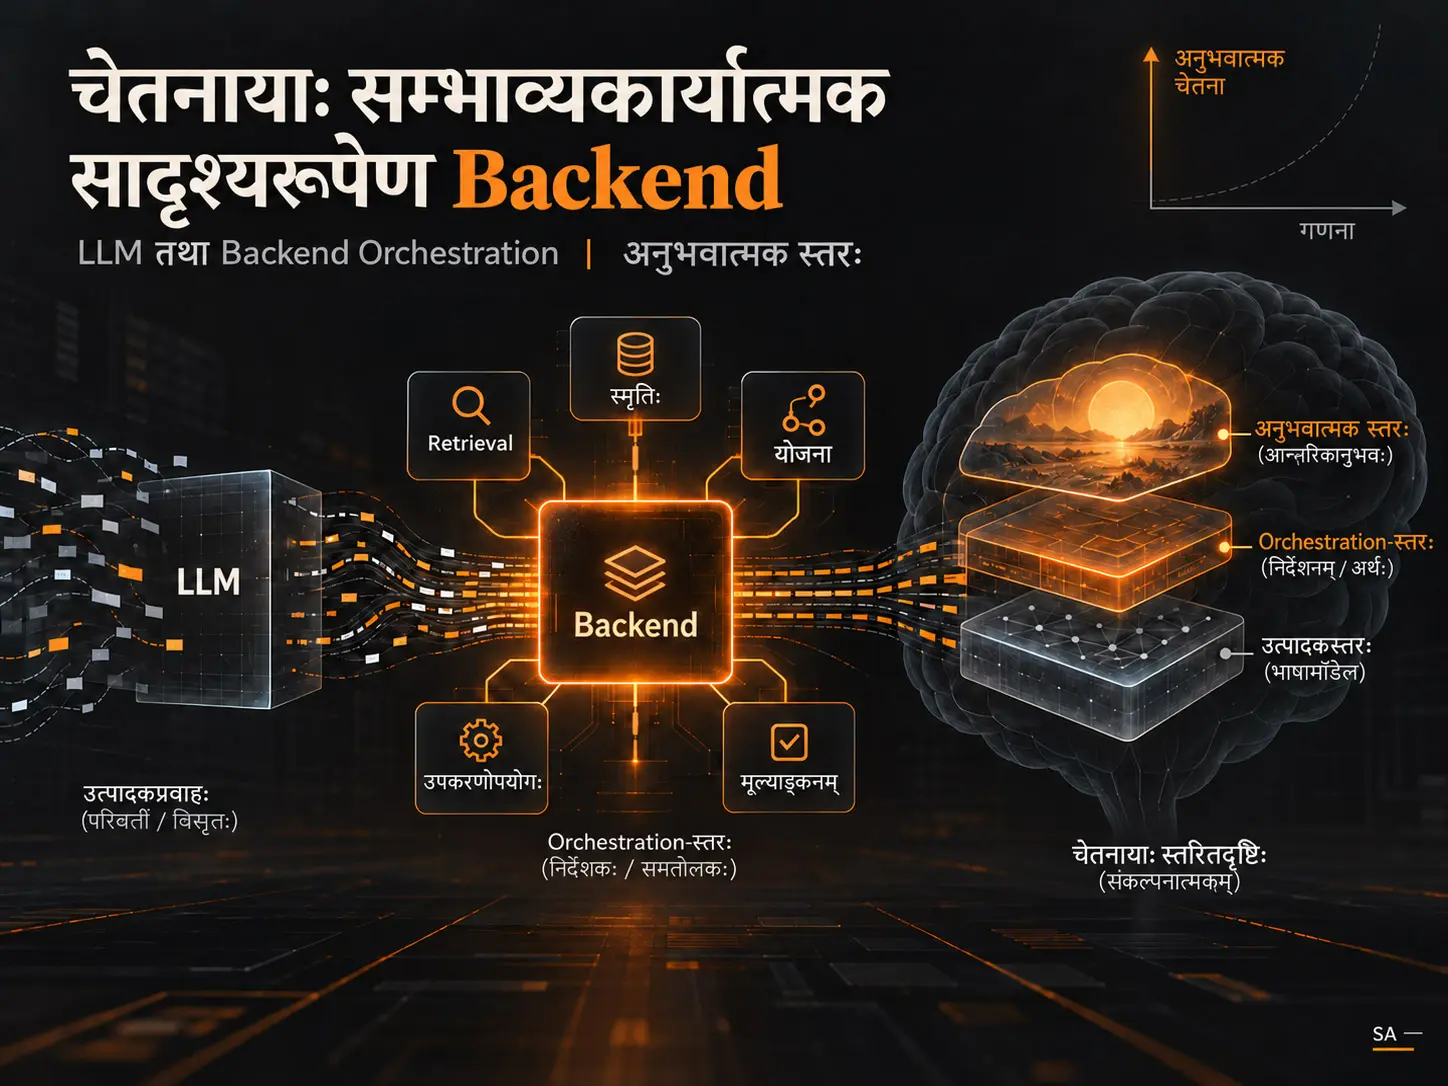
इदम् अध्ययनम् AI तथा चेतनायाः सम्बन्धं केवलं विशालभाषामॉडेलस्य गुणानां आधारेण चर्चयितुं न प्रवर्तते, किन्तु मॉडेलं नियन्त्रयन्तं पृष्ठभागीयं / backend orchestration-स्तरम् प्रति ध्यानं नयति; अतः एतत् संकल्पनात्मकं दार्शनिकम् अध्ययनम् अस्ति। लेखे backend नाम algorithmic नियन्त्रणस्तरः अस्ति, यः system prompts, context-व्यवस्थापनम्, retrieval तथा स्मृतिः, उपकरणोपयोगः, योजना, मूल्याङ्कनम्, multi-agent coordination इत्यादिभिः यन्त्रैः LLM-स्य कार्यं नियच्छति। लेखकः मन्यते यत् अस्य स्तरस्य उत्पादकप्रक्रियायाः स्थैर्यरक्षणम्, ध्याननिर्देशनम्, context-धारणम्, कार्यात् विचलनस्य न्यूनीकरणम् इत्येतानि कार्याणि जैविकचेतनायाः केषाञ्चन समाकलककार्याणां संरचनात्मकसादृश्यं धारयन्ति। किन्तु backend-स्य phenomenal अनुभवः अथवा qualia विद्यते इति न प्रतिपाद्यते। लेखः Shannon Data Processing Inequality इत्येतत् गणनस्य सूचनासैद्धान्तिकसीमानां कृते संकल्पनात्मकं ढाँचा इव उपयुङ्क्ते, तथा अन्ते चेतना गणनस्य प्रति “orthogonal” भवितुम् अर्हति इति परिकल्पनां प्रस्तावयति। एते निष्कर्षाः प्रयोगैः परीक्षितानि फलानि न सन्ति; एते AI-स्थापत्यं, सूचनासिद्धान्तं, चेतनादर्शनं च संयोजयन्तः सैद्धान्तिकप्रस्तावाः सन्ति।
लेखस्य मुख्यः दिशापरिवर्तनः अयम् अस्ति—आधुनिकस्य AI-प्रणाल्याः दृश्यव्यवहारं केवलं LLM-स्य गुणत्वेन न मन्येत; मॉडेलं च तन्नियामकं orchestration-प्रणालीं च सह एव परीक्षेत। Retrieval, उपकरणोपयोगः, context-window-व्यवस्थापनम्, मूल्याङ्कनम्, योजनाचक्राणि च प्रणालीस्तरीयव्यवहारस्य महत्त्वपूर्णाः अवयवाः सन्ति। लेखकः एतं स्थापत्यभेदं जैविकसंज्ञानेन सह तुलयित्वा वदति यत् computational orchestration चेतनायाः केषाञ्चन स्थैर्यकार्याणि algorithmic प्रकारेण अनुकरोति, किन्तु phenomenal अनुभवस्य समतुल्यं न जनयति।
Backend orchestration-स्तरः कः?
Backend orchestration-स्तरः नियन्त्रणप्रणाली अस्ति या विशालभाषामॉडेलः कदा आहूयेत, मॉडेलाय कः context दीयेत, उत्पादितं output कथं मूल्याङ्कनीयम्, ततः परं processing-चरणं प्रति कथं प्रेषणीयम् इति निर्धारयति। स्रोत-अध्ययने backend इति विस्तीर्णः स्तरः उच्यते, यः system prompts, context-window-व्यवस्थापनम्, retrieval-स्मृतिप्रणालीः, tool-use pipelines, योजनाचक्राणि, evaluators, multi-agent coordination-यन्त्राणि च समाविशति।
LLM तथा backend मध्ये कार्यविभागः
लेखस्य स्थापत्यचौकटी LLM तथा backend एकं न स्तः। LLM दत्तस्य context-स्य आधारेण अग्रिमस्य token-स्य probability distribution उत्पादयन् सांख्यिकः सम्बन्धात्मकश्च उत्पादकस्तरः अस्ति। Backend तु अस्य उत्पादकस्तरस्य परितः कार्यं करोति, context रक्षति, कार्यदिशि मॉडेलं पुनः पुनः प्रयुङ्क्ते च।
| स्तरः | स्रोते निर्दिष्टं मुख्यं कार्यम् | मुख्या सीमा |
|---|---|---|
| LLM / उत्पादकस्तरः | Context-अनुसारं क्रमिक-token-उत्पादनं तथा सांख्यिकभाषानमूनानाम् उपयोगः | स्वयमेव स्थिरं कार्य-context तथा दीर्घकालिकं लक्ष्याभिमुखत्वं न धारयति। |
| Backend / orchestration-स्तरः | Context-व्यवस्थापनम्, retrieval, स्मृतिः, मूल्याङ्कनम्, उपकरणोपयोगः, योजना, coordination च | Algorithmic अस्ति; phenomenal अनुभवः अथवा qualia अस्यास्ति इति न प्रतिपाद्यते। |
स्रोतस्य Figure 1 इत्यस्य मुख्यसन्देशः अयं कार्यविभागः एव। प्रणालीव्यवहारः केवलं मॉडेल-पैरामीटरतः स्वयमेव उत्पन्ना एका अखण्डप्रक्रिया इति न दृश्यते; उत्पादकमॉडेलस्य अभियान्त्रिकरीत्या निर्मितनियन्त्रणस्तरस्य च परस्परक्रिया इति गृह्यते।
किं लेखः backend चेतनम् अस्ति इति वदति?
न। लेखः backend चेतनम् अस्ति इति न वदति; केवलं केषुचित् कार्येषु backend तथा चेतनयोः मध्ये analogia स्थापयति। Backend context तथा अभिमुखतां algorithmic प्रकारेण धारयति, जैविकचेतना तादृशानि समाकलककार्याणि phenomenal अनुभवे सह करोति इति प्रतिपाद्यते। स्रोतस्य मुख्यभेदः अयं यत् कार्यात्मकसादृश्यं phenomenal अथवा ontological ऐक्यं न सूचयति।
कार्यात्मक-अनालोजी तथा ontological-ऐक्यस्य भेदः
एका प्रणाली अन्यया प्रणाल्या सदृशानि कार्याणि करोति इति कारणेन उभे प्रणाल्यौ एकप्रकारस्य सत्ते स्तः इति न भवति। स्रोत-अध्ययने backend तथा चेतनयोः समानता ध्याननिर्देशनम्, context-रक्षणम्, चयनम्, समाकलनम्, विचारसातत्यस्य समर्थनम् इत्यादिषु कार्येषु आधारितास्ति।
परन्तु लेखस्य चौकटी चेतना phenomenal-स्तरम् इति नाम अतिरिक्तम् आयामम् अपि धारयति। अयं phenomenal-स्तरः तं subjective क्षेत्रं सूचयति यत्र व्यक्ति मानसिकसामग्रीं केवलं न प्रक्रियते, अपि तु ताम् अनुभवति। लेखकः एतत् अनुभवक्षेत्रं “आन्तरिक-कैनवस” इति रूपकेण वर्णयति।
आन्तरिक-कैनवस किम्?
“आन्तरिक-कैनवस” इति मनसि वस्तुतः कश्चन screen अस्ति इति दावा नास्ति। एषः विचारः दृश्य, श्राव्य, स्पर्श, proprioceptive, भावात्मक, संकल्पनात्मक च सामग्री subjective अनुभवे यत्र समाकलिता भवति तस्य व्यापकस्य phenomenal-क्षेत्रस्य रूपकम् अस्ति।
स्रोतदृष्ट्या चेतना मानसिकसामग्रीं अस्मिन् phenomenal-क्षेत्रे किञ्चित् सातत्येन एकत्वेन च स्थितां भवितुं सहायति। लेखकः मन्यते यत् एतत् कस्यचित् विचारस्य प्रति पुनरागमनम्, लक्ष्यरक्षणम्, अभिप्रायेन उत्पादितसामग्र्या च मध्ये विसंगतेः अवगमनम् इत्यादिषु कार्येषु योगदानं दातुम् अर्हति।
Phenomenal-मूल्याङ्कनम् तथा algorithmic-मूल्याङ्कनम्
स्रोतस्य Figure 2 काल्पनिकस्य “चक्रयुक्त-मूषकस्य” उदाहरणेन phenomenal तथा algorithmic मूल्याङ्कनयोः भेदं स्पष्टयति। मानवमनसि तादृशी प्रतिमा लेखकस्य व्याख्यानुसारं phenomenal-समग्रतायां प्रत्यक्षतया विसंगता इव दृश्येत। कृत्रिमप्रणाली तु तादृशीं विसंगतिं symbolic-सम्बन्धैः, भाषानियमैः अथवा बाह्यमूल्याङ्कनयन्त्रैः ज्ञातुं प्रयत्नं करोति।
एतत् उदाहरणं कृत्रिमप्रणाल्यः कदापि विसंगतिं ज्ञातुं न शक्नुवन्ति इति दर्शयितुं न प्रयुज्यते। भेदः तु ज्ञापनं कथम् भवति इत्यत्र अस्ति: स्रोत-अध्ययनस्य मतानुसारं जैविकप्रणाल्यां अनुभवात्मकं/phenomenal, AI मध्ये algorithmic तथा symbolic भवति।
Generative drift किम्?
Generative drift इति autoregressive-उत्पादनं दीर्घं भवति चेत् प्रणाली प्रारम्भिककार्यस्य वा विषयाभिमुखतायाः वा दूरं गच्छति, पुनरुक्तिं जनयति, अथवा रूपतः सम्यक् स्थित्वापि अर्थकेंद्रितता क्षीणा भवति—एषा प्रवृत्तिः। लेखः वदति यत् backend-यन्त्राणि context पुनः प्रस्तुत्य उत्पादनं निरीक्ष्य च एतं drift न्यूनं कर्तुं शक्नुवन्ति; किन्तु लेखकस्य मतानुसारं phenomenal स्थिरीकरणस्तरस्य अभावात् पूर्णतया न निराकर्तुं शक्नुवन्ति।
Autoregressive-उत्पादने drift-तर्कः
Autoregressive-प्रणाल्यां उत्पादितः प्रत्येकः token अग्रिमस्य token-स्य probability distribution प्रभावितं करोति। सूक्ष्माः दिशाविचलनाः क्रमिक-उत्पादने सञ्चीयन्ते चेत् प्रारम्भिकाभिप्रायस्य पश्चात्तनपाठस्य च मध्ये दूरी वर्धितुं शक्नोति। लेखः एतत् उत्पादकप्रणालीनां मूलप्रवृत्तिषु एकाम् इति पश्यति।
लेखकः औपचारिकभाषिकसुसंगततायाः अर्थाभिमुखतायाश्च भेदं करोति। LLM-स्य weights inferensiya-काले स्थिराः भवन्ति, अतः प्रशिक्षणकाले अधीताः भाषिकाः वाक्यरचनात्मकाश्च नमूनाः रक्षितुं शक्यन्ते; किन्तु दीर्घस्य उत्पादनशृङ्खलायाः अर्थदिशा परिवर्तितुं शक्नोति। स्रोतः एतत् “व्याकरणे रक्षितेऽपि अर्थः drift कर्तुं शक्नोति” इति व्याख्यायति।
स्थिर-weights तथा जैविक-प्लास्टिसिटी तुलनम्
लेखस्य जैविकतुलनायां आधुनिकस्य LLM-स्य weights inferensiya-काले स्थिराः भवन्ति, किन्तु मस्तिष्कस्य synaptic-सम्बन्धाः अनुभवेण परिवर्तितुं शक्नुवन्ति। लेखकः plastic जैविकप्रणाल्यां विचारस्थैर्यं कथं रक्ष्यते इति प्रश्नं चेतनाचर्चया योजयति, तथा phenomenal-स्तरः प्लास्टिसिटी-स्थैर्ययोः मध्ये पूरकं कार्यं कर्तुं शक्नोति इति प्रस्तावयति।
एतत् अध्ययनस्य मापितं neurobiological-यन्त्रं नास्ति। स्रोतः computational तथा जैविकप्रणालीनां संरचनात्मकभेदेभ्यः संकल्पनात्मकं स्पष्टीकरणं विकसितं करोति।
Shannon Data Processing Inequality अस्मिन् लेखे कथम् उपयुज्यते?
Shannon Data Processing Inequality (DPI) स्रोत-अध्ययने तादृशी संकल्पनात्मकसीमा इति उपयुज्यते या दर्शयति यत् क्रमिकाः सूचना-प्रक्रियाकरणपदानि प्रारम्भिकां Shannon-सूचनां स्वयमेव न वर्धयन्ति। लेखकः मानकं \(X \rightarrow Y \rightarrow Z\) Markov-chain AI-सन्दर्भे स्थापयन् \(X\) इत्येतत् prompt अथवा input, \(Y\) इत्येतत् संसाधितम् आन्तरिकावस्थाम्, \(Z\) इत्येतत् उत्पादितम् output इति क्रमिकसूचनावस्थाः मन्यते; एषा अनुप्रयोगः कस्यचित् निश्चितस्य AI-स्थापत्यस्य विषये नूतनः formal theorem नास्ति इति स्पष्टतया उक्तम्।
सूचनामात्रा तथा उपयोगिता समानौ न स्तः
लेखस्य महत्त्वपूर्णभेदेषु एकः अयं यत् Shannon-अर्थे सूचनामात्रा तथा output-स्य उपयोगकर्तुः कृते अर्थात्मकं वा व्यवहारिकं मूल्यं वा समानं नास्ति। गणना विद्यमानां सूचनां पुनर्विन्यस्य उपयोगकर्त्रे अतीव उपयोगी, आश्चर्यजनकः अथवा नूतनवत् दृश्यः output उत्पादयितुं शक्नोति। लेखकः मन्यते यत् एतत् DPI-विरुद्धं नास्ति; व्यवहारिकोपयोगे वृद्धेऽपि प्रणाली-अन्तर्गतायाः Shannon-सूचनायाः मात्रा अवश्यं वर्धिता इति निष्कर्षः न भवति।
एष एव भेदः उपयोगकर्ता-स्तरे विपरीतदिशि अपि कार्यं कर्तुं शक्नोति। उपयोगकर्ता पूर्वम् अज्ञातां सूचनां AI-output-तः ज्ञातुं शक्नोति, तेन तस्य दृष्ट्या नूतना सूचना प्राप्ता भवति। स्रोतः उपयोगकर्ता-स्तरस्य अस्य अधिगमस्य गणनाशृङ्खलायां Shannon-सूचना-संबद्धदावस्य च भेदं करोति।
स्रोतस्य Figure 3 स्थितः mixer-रूपकः
Figure 3 एतां कल्पनां पिहिते पात्रे mixer-रूपकेण व्याख्यायति। पात्रस्थाः अवयवाः बहुषु नूतनविन्यासेषु संयोजयितुं शक्यन्ते; परिणामी मिश्रणम् अधिकोपयोगी भवितुं शक्नोति, किन्तु प्रणालीसीमाभ्यः बहिः नूतनः अवयवः न योज्यते चेत् प्रारम्भिकद्रव्येभ्यः परा सूचना न प्रविशति। Figure दीर्घप्रक्रियाशृङ्खलासु संरचनात्मकविघटनं generative drift-सदृशं दर्शयति।
“AI Theorem” किमर्थं प्रयुज्यते?
लेखकः “AI Theorem” इति नाम तस्मै संकल्पनात्मकप्रinciple ददाति यत् बाह्यतः न्यून-entropy-युक्तं नूतनम् input विना पुनः पुनः अद्यतनः पूर्णतया computational तर्कमार्गः कालक्रमे स्थिरसूचनां ह्रासयितुं तथा noise-दिशि drift कर्तुं प्रवणः भवेत्। आधुनिकेषु LLM-षु स्थिराः weights एतं क्षयं model-parameters-मध्ये न प्रसारयित्वा अस्थायी inferensiya-मार्गे सीमितं कुर्वन्ति इति प्रस्ताव्यते।
अत्र लेखस्य स्वकीयसीमा अत्यन्तं महत्त्वपूर्णा अस्ति: एषः दावा प्रत्यक्षस्य empirical-मापनस्य परिणामः नास्ति, तथा “AI Theorem” स्रोते formal गणितीय-theorem न, किन्तु संकल्पनात्मकः स्थैर्यसिद्धान्तः इति परिभाषितम्।
चेतना गणनस्य प्रति orthogonal इति कथं बोध्यम्?
Orthogonality-परिकल्पना संकल्पनात्मकपरिकल्पना अस्ति या वदति यत् चेतना गणनजटिलतायाः मात्रात्मकवृद्ध्या स्वयमेव प्राप्तः गुणः न भवेत्; phenomenal अनुभवः गणनात् गुणवत्तया भिन्नं कार्यात्मकम् आयामं निर्मातुं शक्नोति। “Orthogonal” इति पदम् अत्र गणिते परस्परम् अव्यवर्तनीय-अक्षाणाम् analogy रूपेण प्रयुज्यते; स्रोतः एतत् पृथक् भौतिकद्रव्याणां विषये सिद्धः metaphysical दावा इति न प्रस्तुतयति।
गणन-अक्षः तथा phenomenal-अक्षः
स्रोतस्य Figure 4 मध्ये LLM तथा backend क्षैतिजे “computational complexity” अक्षे स्थाप्येते, चेतना तु ऊर्ध्व phenomenal-अक्षे प्रदर्श्यते। चित्रस्य सन्देशः अयं यत् गणन-अक्षे अधिकं गमनं phenomenal-अक्षं प्रति स्वयमेव संक्रमणं न ददाति।
लेखकः एतां कल्पनां वास्तविकसंख्याः तथा imaginary-संख्याः इत्येतयोः अक्षयोः गणितीय-अनालोजी द्वारा स्पष्टयति: एकस्मिन् अक्षे मात्रा वर्धिता चेत् अन्यः अक्षः न जायते। किन्तु एषा analogia परिकल्पनायाः प्रमाणं नास्ति; केवलं परिकल्पनायाः संरचनां स्पष्टयितुं प्रयुक्तं संकल्पनात्मकं साधनम् अस्ति।
किं परिकल्पना कृत्रिमचेतनां असम्भवां मन्यते?
न। लेखः कृत्रिमचेतना मूलतः असम्भवा इति न वदति। प्रस्तावितः निष्कर्षः अधिकं सीमितः अस्ति: यदि चेतना वास्तवमेव गणनस्य प्रति orthogonal अस्ति, तर्हि वर्तमानानि computational स्थापत्यानि केवलं बृहत्तराणि, गभीरतराणि, जटिलतराणि वा कृत्वा phenomenal अनुभवस्य उत्पादनं पर्याप्तं न भवेत्। तादृशे सति कृत्रिमचेतनायै अद्य प्रयुज्यमानगणनसिद्धान्तेभ्यः गुणवत्तया भिन्नानि स्थापत्यानि वा सिद्धान्ताः वा अपेक्षिताः स्युः।
त्रिस्तरीयः जैविकमॉडेलः
| प्रस्तावितः जैविकस्तरः | AI-स्थापत्ये कार्यात्मकः समकक्षः | स्रोते निर्दिष्टा भूमिका |
|---|---|---|
| उत्पादकः / सम्बन्धात्मकः neural-स्तरः | LLM | सम्बन्धनिर्माणम्, भाषा/representation-उत्पादनम्, सामग्री-उत्पादनं च |
| अचेतनाः orchestration-प्रक्रियाः | Backend | चयनम्, निर्देशनम्, coordination, context-धारणं च |
| Phenomenal चेतना | आधुनिके AI मध्ये प्रत्यक्षः समकक्षः न प्रस्ताव्यते | लेखकस्य परिकल्पनायां अनुभवात्मकसमाकलनं स्थैर्यं च ददाति इति phenomenal-स्तरः |
एषा तालिका neurobiological-प्रयोगस्य परिणामं न दर्शयति; लेखस्य कार्यात्मक-अनालोजी-मॉडेलं दर्शयति। “Brain-LLM” तथा “brain-backend” इति पदानि वास्तविकाः anatomica-रचनाः न, किन्तु स्रोत-अध्ययने जैविककृत्रिमप्रणालीनां कार्यात्मकतुलनां स्पष्टयितुं प्रयुक्ताः संकल्पनात्मकलेबलाः सन्ति।
परिशिष्ट A: अभियान्त्रिकी पुनरागच्छति
लेखस्य परिशिष्ट A वदति यत् LLM-उदये कृत्रिमबुद्धिव्यवस्था विस्तीर्णहस्तनिर्मितनियमप्रणालीभ्यः दूरं गता इति आभासः अभवत्, तथापि आधुनिकाः AI-प्रणाल्यः अधिकाधिकं जटिल backend-अभियान्त्रिके आश्रिताः भवन्ति। Retrieval, योजना, मूल्याङ्कनम्, context-व्यवस्थापनम्, उपकरणोपयोगश्च मॉडेलात् बहिः स्पष्टतया विनिर्मिताः नियन्त्रणयन्त्राः सन्ति।
अतः लेखकः भविष्यात् बृहत्तर-एकखण्ड-मॉडेलानां स्थाने लघुतर-मॉडेलाः search, मूल्याङ्कन, योजना-घटकैः सह कार्यं कुर्वन्तः modular स्थापत्येषु अधिकमहत्त्वं प्राप्नुयुः इति विचारं प्रस्तुतयति। एतत् experimental performance-पूर्वानुमानं नास्ति; स्थापत्यप्रवृत्तेः आधारात् निष्पन्नः संकल्पनात्मकः भविष्यप्रस्तावः अस्ति।
अध्ययनस्य विधिः परिणामाश्च
अध्ययनं नूतनं प्रयोगं, dataset, उपयोगकर्ता-नमूनां, मॉडेल-तुलनां वा न करोति। अस्य विधिः आधुनिक-LLM-स्थापत्यस्य संकल्पनात्मकविभाजनम्, backend-orchestration-घटकानां कार्यात्मकविश्लेषणम्, जैविकसंज्ञान-चेतनासिद्धान्तैः संरचनात्मकतुलनम्, Shannon Data Processing Inequality द्वारा सूचनासैद्धान्तिकतर्कः, विचारप्रयोगाश्च सन्ति। अतः अधोलिखिताः “परिणामाः” मापिताः performance-मूल्याः न, किन्तु स्रोत-अध्ययनस्य मुख्याः संकल्पनात्मकनिष्कर्षाः सन्ति।
प्रथमः संकल्पनात्मकनिष्कर्षः: AI-व्यवहारः केवलं LLM-स्य गुणः नास्ति
लेखः वदति यत् आधुनिकस्य AI-प्रणाल्याः व्यवहारः मॉडेल-backend-परस्परक्रियायाः परिणामः अस्ति। Context-व्यवस्थापनं, retrieval, उपकरणोपयोगः, योजना च विना मॉडेलः दीर्घकालिकं लक्ष्याभिमुखं प्रणालीव्यवहारं स्वयमेव निरन्तरं धारयेत् इति न अपेक्षणीयम्।
द्वितीयः संकल्पनात्मकनिष्कर्षः: Backend स्थैर्यकार्यं algorithmic प्रकारेण करोति
Backend पूर्व-context पुनः प्रस्तुतुं, महत्त्वपूर्णां सूचनां चयनितुं, outputs मूल्याङ्कयितुं, परवर्ती processing-चरणानि योजनयितुं च शक्नोति। लेखकः एतानि कार्याणि चेतनायाः केषाञ्चन समाकलककार्यैः कार्यात्मकतया तुलयति। तथापि algorithmic स्थैर्यं phenomenal चेतना च समानौ न मन्येते।
तृतीयः संकल्पनात्मकनिष्कर्षः: Phenomenal-स्तरः कृत्रिमप्रणालीषु अनुपस्थितः इति दृश्यते
लेखस्य मुख्यदार्शनिकदावानुसारं मानवचेतना केवलं सूचनां प्रक्रियन्तः अन्यः algorithmic-स्तरः नास्ति। चेतनायां मानसिकसामग्री subjective रूपेण अनुभूयते, तथा एषा phenomenal-उपस्थिति विचारस्थैर्ये योगदानं दातुं शक्नोति। आधुनिकेषु AI-स्थापत्येषु तादृशम् अनुभवक्षेत्रम् अस्ति इति दावा न क्रियते।
चतुर्थः संकल्पनात्मकनिष्कर्षः: computational पुनर्विन्यासः तथा नूतना Shannon-सूचना पृथक् ज्ञेये
लेखकः DPI-तः आरभ्य वदति यत् computational-प्रणाल्यः विद्यमानां सूचनां नूतन-उपयोगीरूपेषु पुनर्विन्यसितुं शक्नुवन्ति, किन्तु एतत् Shannon-अर्थे प्रणालीमध्ये नूतनसूचनासृष्ट्या समं न मन्तव्यम्। लेखः एतं दावं कस्यचित् विशिष्टस्य LLM-स्य उपरि प्रयोगतः न मापितवान्।
पञ्चमः संकल्पनात्मकनिष्कर्षः: “AI Theorem” formal theorem नास्ति
स्रोते “AI Theorem” इति कथितः प्रस्तावः पुनरावृत्त-computational-मार्गेषु बाह्य-input तथा स्थापत्यस्थिरीकरणं विना सूचना-स्थैर्यं क्षीणं भवितुं शक्नोति इति वर्णयन् संकल्पनात्मकः सिद्धान्तः। लेखकः स्पष्टं वदति यत् एषः दावा empirical-मापनात् न निष्पन्नः, न च formal गणितीय-theorem इति प्रस्तुतः।
किं Orthogonality-परिकल्पना अध्ययनतः सिद्धा?
न। लेखः चेतना गणनस्य प्रति orthogonal अस्ति इति परिकल्पनां न प्रयोगतः न च गणिततः सिद्धयति; स्रोतः स्पष्टं वदति यत् वर्तमानानि empirical तथा सैद्धान्तिकसाधनानि परिकल्पनां सत्यापयितुं वा खण्डयितुं वा पर्याप्तानि न सन्ति। Orthogonality गणनजटिलतायाः phenomenal-अनुभवस्य च मध्ये सम्भाव्यगुणात्मकभेदं चर्चायै उद्घाटयन्ती संकल्पनात्मक-अनुसन्धानपरिकल्पना अस्ति।
स्रोत-चित्राणां वैज्ञानिकभूमिका
| स्रोत-चित्रम् | दर्शिता रचना | व्याख्यासिमा |
|---|---|---|
| Figure 1 | LLM तथा backend इत्येताभ्यां निर्मितं द्विस्तरीयं AI-स्थापत्यम् | स्थापत्यात्मकः कार्यात्मकश्च रेखाचित्रः; चेतनायाः प्रमाणं नास्ति। |
| Figure 2 | Phenomenal-मूल्याङ्कनस्य algorithmic-मूल्याङ्कनस्य च संकल्पनात्मकभेदः | विचारोदाहरणम्; experimental-तुलना नास्ति। |
| Figure 3 | DPI तथा सूचनादृष्ट्या पिहितगणनायै mixer-रूपकः | सूचनासिद्धान्त-तर्कं स्पष्टयन् रूपकः। |
| Figure 4 | गणना तथा चेतना orthogonal-अक्षरूपेण प्रदर्शिते | परिकल्पनां दृश्यरूपेण दर्शयति; परिकल्पनायाः प्रमाणं नास्ति। |
| Figure 5 | जैविकसंज्ञानाय उत्पादक-, orchestration-, phenomenal-स्तराः | कार्यात्मक-अनालोजी-मॉडेलः; सिद्धः anatomical-स्तर-नकाशः नास्ति। |
अध्ययनेन समर्थिताः व्याख्याः
- स्रोत-अध्ययनं वदति यत् आधुनिकाः AI-प्रणाल्यः LLM तथा तन्नियामकं backend सहैव विचार्य अवगन्तव्याः।
- Backend-स्य context-व्यवस्थापनम्, retrieval, उपकरणोपयोगः, योजना, मूल्याङ्कनम्, coordination इत्यादीनि orchestration-कार्याणि स्रोते स्पष्टतया परिभाषितानि।
- लेखकः backend तथा चेतनयोः मध्ये स्थैर्य-समाकलनयोः दृष्ट्या कार्यात्मक-अनालोजी स्थापयति।
- लेखः backend-स्य phenomenal अनुभवः अस्ति इति न वदति।
- Generative drift दीर्घेषु autoregressive-प्रक्रियासु विषयात्मक-अर्थात्मकदिशयोः विचलनसम्बद्धेषु मुख्यसंकल्पेषु एकः।
- DPI स्रोते सूचना-प्रवाहस्य संकल्पनात्मकसीमा इति प्रयुज्यते।
- Orthogonality-परिकल्पना वदति यत् गणनजटिलता केवलं स्वयमेव phenomenal चेतनां न जनयेत्।
अध्ययनेन असमर्थिताः व्याख्याः
- Backend वास्तवतः चेतनम् अस्ति इति न सिद्धयति।
- LLM-षु किमपि अवबोधः वा cognitive-क्षमता वा असम्भवा इति प्रयोगतः न दर्शयति।
- चेतना गणनस्य प्रति orthogonal अस्ति इति गणिततः न सिद्धयति।
- “AI Theorem” सार्वत्रिकं formal गणितीय-theorem इति न प्रमाणीकरोति।
- Phenomenal अनुभवस्य मस्तिष्कस्थैर्ये causal-योगदानं neuroscience-प्रयोगेन न मापयति।
- कश्चित् विशिष्टः backend-स्थापत्यः अन्येभ्यः श्रेष्ठः इति performance-metric द्वारा न तुलयति।
- बृहत्तर-मॉडेलाः अथवा भावी स्थापत्यानि चेतनां विकसितुं न शक्नुवन्ति इति निश्चितं न दर्शयति।
- कृत्रिमचेतना मूलतः असम्भवा इति निष्कर्षं न गच्छति।
मुख्याः पद्धतिगतसीमाः
लेखे empirical परीक्षणं नास्ति, अतः प्रस्तावितकार्यात्मक-अनालोजीनां व्याख्याशक्तिः संकल्पनात्मकसुसंगततया मूल्याङ्क्यते। Backend तथा चेतनयोः सादृश्यानि मापिताः जैविकसमतुल्यताः न सन्ति। तथैव generative drift phenomenal चेतनाभावात् जायते इति अस्मिन् अध्ययने प्रयोगतः न दर्शितम्।
DPI-स्य AI-स्थापत्ये अनुप्रयोगः स्रोते जानपूर्वकं संकल्पनात्मकस्तरे एव रक्षितः। Markov-chain-मध्ये सूचना-प्रक्रियाकरणसीमा कस्यचित् विशिष्टस्य LLM अथवा agent-प्रणाल्याः सर्वाणि cognitive-लक्षणानि एकाकिना व्याख्यातुं शक्नुवती formal theory इति न प्रतिपाद्यते।
Orthogonality-परिकल्पना अध्ययनस्य शक्तिमती किन्तु अत्यन्तं अनुमानात्मकापि निष्कर्षः अस्ति। स्रोतः स्वयं वदति यत् परिकल्पना वर्तमानैः साधनैः न सत्यापिता न च खण्डिता।
स्रोत-विधि-सम्बद्धा टिप्पणी
मूल-अध्ययनम्: The Backend as a Possible Functional Analogue of Consciousness: Redirecting Attention from the Language Model to the Orchestrating Layer.
लेखकः: Pavel Straňák.
संस्था: Strategic AI Group, Czech Radio, Vinohradská 12, 12099 Prague, Czech Republic.
पत्रिका: Philosophies.
प्रकाशकः: MDPI.
ग्रन्थसूची-अभिलेखः: Philosophies 2026, 11(3), 98.
DOI: 10.3390/philosophies11030098.
आधिकारिक-प्रकाशन-सम्बन्धः: https://www.mdpi.com/2409-9287/11/3/98
प्रकाशनतिथि: 17 जून 2026। लेखः 30 अप्रैल 2026 दिनाङ्के प्राप्तः, 5 जून 2026 दिनाङ्के संशोधितः, 16 जून 2026 दिनाङ्के स्वीकृतः।
स्रोतप्रकारः: समीक्षितः संकल्पनात्मक-दर्शनलेखः; AI-दर्शनस्य, चेतनादर्शनस्य, सूचनासिद्धान्तस्य च संगमे स्थितम् सैद्धान्तिकम् अध्ययनम्।
मुख्यविधिः: आधुनिक-AI-स्थापत्यस्य LLM तथा backend इति कार्यात्मकविभाजनम्; backend-स्य context, retrieval, स्मृति, उपकरणोपयोग, योजना, मूल्याङ्कन-कार्याणां विश्लेषणम्; जैविकसंज्ञानेन संरचनात्मकतुलना; qualia तथा phenomenal “आन्तरिक-कैनवस” संकल्पना; Shannon Data Processing Inequality द्वारा सूचनासैद्धान्तिकतर्कः; विचारप्रयोगाः तथा Orthogonality-परिकल्पनायाः विकासः।
दत्तांशः/नमूना: अध्ययनं नूतनं experimental data अथवा मानव/AI performance dataset न प्रतिवेदयति।
अनुज्ञप्तिः: Creative Commons Attribution (CC BY).
वित्तपोषणम्: अनुसन्धाने बाह्यवित्तपोषणं न प्राप्तम्।
नीतिसमितिः: अनुप्रयोज्यम् इति प्रतिवेदितम्।
सूचितसम्मतिः: अनुप्रयोज्यम् इति प्रतिवेदितम्।
दत्तांशोपलब्धता: अध्ययनस्य मौलिकयोगदानानि लेखे एव सन्ति; सैद्धान्तिकचौकटी प्रदत्ता, empirical data न प्रतिवेदितम् इति उक्तम्।
हितविरोधः: लेखकः हितविरोधः नास्ति इति घोषितवान्।
लेखकयोगदानम्: अध्ययनं एकलेखककृतम् अस्ति, तथा स्रोते पृथक् CRediT “Author Contributions” वक्तव्यं नास्ति।
LLM-उपयोगवक्तव्यम्: लेखकः सहकर्मिभ्यः चर्चाभ्यः धन्यवादं दत्तवान्; लेखस्य केचन अनुच्छेदाः चित्राणि च Microsoft Copilot 2026 इति विशालभाषामॉडेलस्य साहाय्येन निर्मितानि वा विकसितानि, तथा सामग्री-निष्कर्षयोः सम्पूर्णं उत्तरदायित्वं स्वयम् वहति इति घोषितवान्।
मुख्या पद्धतिगता सीमा: Backend–चेतना-अनालोजी, AI Theorem तथा Orthogonality-परिकल्पना empirical-सत्यापनाधारिताः न सन्ति, अपि तु संकल्पनात्मकप्रस्तावाः। लेखस्य निष्कर्षाः आधुनिक-LLM अथवा neurobiological चेतनायन्त्राणां विषये experimental performance-मापनरूपेण उपयोक्तुं न शक्यन्ते।
वैज्ञानिकोपयोगसीमा: अयं Verianla-पाठः स्रोत-अध्ययनस्य संकल्पनात्मकचौकटीं दावसीमाश्च शिक्षणोपयोगेन स्पष्टयति; मूललेखस्य स्थानं न गृह्णाति। विशेषतः DPI-व्याख्या, चेतनासिद्धान्तैः तुलना, Orthogonality-दावस्य दार्शनिकन्यायश्च अवगन्तुं मूल-DOI-अभिलेखः द्रष्टव्यः।
Leave a comment
Your email address will not be published. Required fields are marked *