

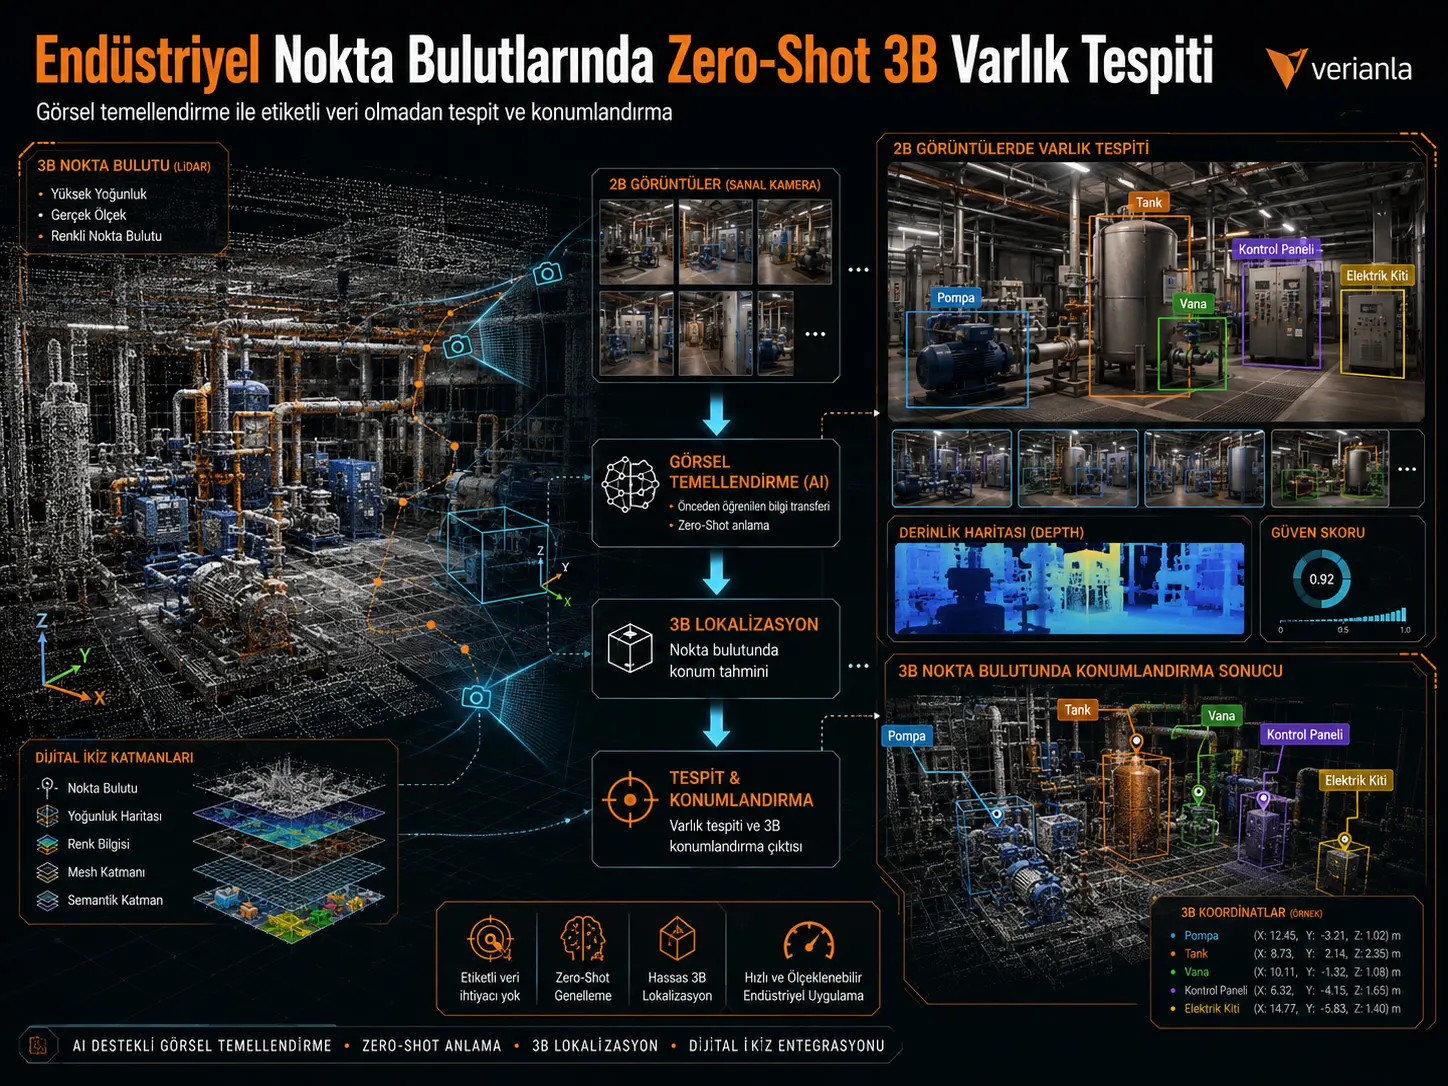
Bu çalışma, güncel CAD modeli veya endüstriyel varlıklara ait büyük etiketli eğitim veri seti bulunmayan mevcut tesislerde, yalnızca tek bir 3B nokta bulutundan ekipmanları tespit edip yaklaşık mekânsal konumlarını belirlemeyi amaçlayan zero-shot bir çerçeve öneriyor. Sistem nokta bulutunu doğrudan bir 3B nesne dedektörüne vermek yerine önce sanal kameralarla farklı yükseklik ve yakınlaştırma düzeylerinde sahne görüntüleri üretiyor. Görüntüler GPT-4o ile semantik olarak yorumlanıyor, oluşturulan nesne açıklamaları Grounding DINO'ya aktarılıyor, 2B bounding box'lar tespit ediliyor ve derinlik ile kamera parametreleri kullanılarak sonuçlar yeniden 3B yerel koordinat sistemine taşınıyor. Sabit görüş noktalarının yetersiz kaldığı durumlarda sistem nesnenin görüntüdeki büyüklüğü, kadrajdan taşması ve diğer nesnelerle çakışması gibi ölçütleri kullanarak kamerayı yeniden konumlandırıp görüntüyü tekrar üretiyor.
Melbourne'deki karmaşık bir plant room'dan Leica BLK360 lazer tarayıcıyla elde edilen 271.348.287 noktalık veri üzerinde önerilen yöntem, aynı görsel temellendirme altyapısıyla değerlendirilen OpenIns3D başlangıcındaki AP25 değerini 35,84'ten 48,13'e, AP50 değerini 26,89'dan 34,98'e çıkardı. Özellikle başlangıç sisteminin AP25'te hiç tespit edemediği gas/oil burner sınıfı önerilen sistemde 41,3 AP25'e ulaştı; electrical kit, control panel, fire extinguisher ve diğer bazı sınıflarda da belirgin artışlar raporlandı. 3B lokalizasyon tablosunda 11 varlık için tekil Öklid konum hataları 0,105 ile 0,312 metre arasında değişmektedir. Ancak sonuçlar yalnız tek bir endüstriyel ortamda elde edilmiştir ve yöntem yüksek hassasiyetli geometrik yeniden yapılandırma sistemi olarak değil, varlık envanteri, dijital ikiz başlangıç katmanı, uzaktan izleme ve inspeksiyon planlama gibi yaklaşık mekânsal bilginin yeterli olduğu kullanım senaryoları için değerlendirilmiştir.
Endüstriyel tesislerde 3B varlık tespiti neden zor?
Asıl sorun yalnız “nokta bulutunda nesne bulmak” değildir. Endüstriyel tesislerde pompalar, vanalar, tanklar, elektrik panoları, duct sistemleri, merdivenler, burner'lar ve yoğun boru hatları farklı boyutlarda, farklı yüksekliklerde ve çoğu zaman birbirlerini örtecek biçimde konumlanır. Bir ekipmanın ön yüzü görünürken diğer yüzü borular veya duvar tarafından kapanabilir; küçük bir vana geniş açıdaki bir sahne görüntüsünde birkaç piksele kadar küçülebilir.
Klasik denetimli 3B nesne tespit yöntemleri bu problemi büyük ve etiketli veri setleriyle çözmeye çalışır. Ancak belirli bir endüstriyel tesise özgü ekipman çeşitliliği nedeniyle bu tür veri setlerini üretmek pahalı ve zaman alıcıdır. Standart otonom sürüş veya iç mekân veri setlerinde otomobil, yaya, sandalye ve masa gibi sınıflar bulunurken bir plant room'daki gas/oil burner veya özel electrical kit gibi ekipmanların temsili genellikle yoktur.
Araştırmanın temel sorusu bu nedenle şudur: yalnız mevcut nokta bulutundan, tesise özel etiketli model eğitmeden, endüstriyel varlıkları tespit edip 3B konuma geri yerleştirmek mümkün mü?
“Zero-shot” burada tam olarak ne anlama geliyor?
Çalışmada zero-shot ifadesi, önerilen sistem için yeni endüstriyel tesise özel etiketli bir eğitim veri seti hazırlanmadığını ifade etmektedir. GPT-4o ve Grounding DINO gibi önceden eğitilmiş foundation modelleri kullanılmaktadır.
Dolayısıyla sistem “hiçbir şey öğrenmemiş” değildir. Önceden büyük veri üzerinde eğitilmiş modellerden yararlanır; sıfır olan, bu plant room'daki ekipmanları tespit etmek için yapılan domain-specific supervised training işlemidir.
Ayrıca GPT-4o görüntülerdeki nesneleri çalışmada tanımlanan önceden belirlenmiş endüstriyel varlık sözlüğünden aramaktadır. Bu nedenle uygulama düzeyindeki zero-shot kabiliyeti, önceden belirlenen endüstriyel sınıflar ve foundation model bilgisinin bileşimi olarak anlaşılmalıdır.
Yöntem neden doğrudan nokta bulutunu sınıflandırmıyor?
Araştırmacıların yaklaşımı, güçlü 2B vision–language modellerinin görsel anlama kabiliyetinden yararlanabilmek için 3B nokta bulutunu farklı sanal kameralardan 2B sahne görüntülerine dönüştürmektir.
Bu tasarımın mantığı şöyledir:
- Nokta bulutunda sanal kameralar yerleştirilir.
- Bu kameralardan 2B sahne görüntüleri ve depth map'ler render edilir.
- Foundation modeller görüntülerde hangi endüstriyel varlıkların bulunduğunu belirler.
- 2B tespitler, görüntünün depth bilgisi ve kamera parametreleri kullanılarak tekrar 3B sahneye projekte edilir.
Bu nedenle çalışma “2B veya 3B” arasında seçim yapmıyor; 3B geometrik veri ile 2B foundation-model görsel anlayışını aynı pipeline'da birleştiriyor.
Beş aşamalı sistem nasıl çalışıyor?
Makalenin temel yöntemi beş ana aşamadan oluşmaktadır:
- Virtual Camera Positioning: Sanal kameraların endüstriyel sahnenin uygun bölgelerine ve farklı yüksekliklere yerleştirilmesi.
- Image Generation: Nokta bulutundan farklı görüş ve zoom düzeylerinde sahne görüntülerinin üretilmesi.
- Visual Grounding: GPT-4o ile semantik tanımlama ve Grounding DINO ile 2B bounding box üretimi.
- Recognition-Aware Refinement: Yetersiz görünen nesneler için kamera parametrelerinin otomatik yeniden ayarlanması ve görüntünün tekrar render edilmesi.
- Asset Localisation: 2B tespitlerin depth, intrinsics ve extrinsics kullanılarak yerel 3B koordinatlara geri taşınması.
Çalışmanın yöntem şemasındaki önemli özellik, dördüncü aşamanın tek yönlü bir işlem olmamasıdır. Tanıma kalitesi düşükse kamera tekrar düzenlenir ve yeni görüntüler oluşturulur. Böylece nesne dedektörü yalnız kendisine verilen görüntüyle yetinmek yerine, sistem nesnenin daha iyi görüneceği yeni bir görüş üretmeye çalışır.
Sanal kamera yerleşimi neden farklı yüksekliklerde yapılıyor?
OpenIns3D'nin geniş açılı sabit sahne görüşleri daha basit iç mekânlarda yeterli olabilir; ancak endüstriyel plant room'da tavana yakın çok sayıda boru hattı, alt seviyedeki ekipmanları örtebilir. Benzer biçimde yüksek bir ekipman yalnız alçak kameralardan bakıldığında eksik görünebilir.
Önerilen yaklaşım bu nedenle kameraları tek bir yükseklikte tutmuyor. Üst yükseklik sınırı yükseltilerek yüksek ekipmanların, alt sınır değiştirilerek zemin seviyesindeki ekipmanların farklı açılardan görünürlüğü artırılıyor.
Ancak çalışma bu değişken yükseklik stratejisinin katkısını tek başına ayrı bir ablation deneyiyle ölçmemektedir. Dolayısıyla “multi-height kamera yerleşimi tek başına X AP kazandırdı” biçiminde bir sayı kaynakta bulunmamaktadır.
Normal, orta ve yakın zoom neden birlikte kullanılıyor?
Endüstriyel sahnede bir tank ile küçük bir vana aynı fiziksel ölçeğe sahip değildir. Tek bir sabit zoom seviyesi kullanıldığında ya genel sahne kaybolur ya da küçük ekipmanların görsel ayrıntısı yetersiz kalır.
Çalışma bu problemi:
- normal,
- medium,
- close-up
olmak üzere üç ölçekli zoom mekanizmasıyla ele almaktadır. Böylece aynı sahnenin hem çevresel bağlamı hem de küçük ekipman ayrıntıları foundation modele gösterilebilir.
Duvar kaldırma ne anlama geliyor?
Burada fiziksel tesisteki duvarın silinmesi söz konusu değildir. Nokta bulutu render edilirken dış sınır duvarları belirli bir eşik kullanılarak görüntü üretiminden çıkarılmaktadır. Amaç, dış duvarın arkasında veya yakınında bulunan varlıkları sanal kameraların görebilmesini sağlamaktır.
Makalenin duvar kaldırma öncesi/sonrası karşılaştırmaları, duvar tarafından örtülen pump ve tank gibi ekipmanların sanal görüntülerde daha görünür hâle gelebildiğini göstermektedir.
Hangi sahne görüntüsünün “iyi” olduğuna nasıl karar veriliyor?
İlk render edilen aday görüntüler eşit kabul edilmiyor. Her görüntü için iki ölçüt hesaplanıyor:
- Edge density: Canny edge detection sonrası görüntüdeki kenar piksel oranı.
- Texture variance: gri seviye piksel yoğunluklarının varyansı.
Kaynakta görüntü skoru:
\[ score_i= 0.6\times\text{edge density} + 0.4\times\text{texture variance} \]
olarak tanımlanmaktadır.
En yüksek skoru alan aday görüntünün intrinsic kamera parametreleri sonraki görüşlerin üretiminde tekrar kullanılır. Buradaki fikir, geometrik ve dokusal bilgi bakımından daha zengin bir görüntü ayarını seçmektir.
Depth-based filtering ne yapıyor?
Bir görüntü görsel olarak üretilmiş olsa bile büyük bölümü boş, occluded veya geçerli 3B yüzey bilgisi içermiyor olabilir. Bu nedenle her render'ın depth map'i değerlendirilir.
Görünürlük oranı:
\[ V= \frac{|D_{\mathrm{valid}}|}{|D|} \]
olarak tanımlanır. \(D_{\mathrm{valid}}\), geçerli depth değerine sahip pikselleri; \(D\) ise bütün görüntü piksellerini temsil eder.
Yalnız:
\[ V\geq\sigma \]
koşulunu sağlayan görüntüler korunur.
Çalışmanın düşük ve yüksek görünürlüklü örneklerinde düşük kaliteli görüşlerin depth map'lerinde yalnız küçük ve kopuk renkli bölgeler görülürken, yüksek görünürlükte depth haritası daha yoğun ve süreklidir. Bu filtreleme, daha sonraki 3B geri izdüşümün eksik geometriden etkilenmesini azaltmayı amaçlar.
GPT-4o ile Grounding DINO neden birlikte kullanılıyor?
Pipeline'ın iki modelinin görevleri farklıdır.
GPT-4o, render edilen sahne görüntüsünü semantik olarak analiz eder ve çalışmanın önceden tanımladığı endüstriyel varlık sözlüğünden görünür nesneleri belirler. Her örnek için:
- varlık kategorisi,
- örnek sayısı,
- görüntüdeki kaba konum,
- göreli büyüklük,
- görünüş ve bağlam açıklaması
üretir.
Bu aşamada henüz kesin bounding box yoktur.
Grounding DINO ise GPT-4o'nun oluşturduğu doğal dil açıklamasını görsel grounding prompt'una dönüştürerek ilgili nesne için axis-aligned 2B bounding box üretir.
Birden fazla aynı sınıf nesne bulunduğunda prompt'a konum ve büyüklük bilgisi eklenerek örneklerin birbirinden ayrılması amaçlanmaktadır.
Neden Grounding DINO tek başına yeterli görülmedi?
Çalışmanın nitel karşılaştırmasında ODISE ve YOLO-World karmaşık endüstriyel varlıkların önemli bölümünü kaçırmıştır. Grounding DINO daha iyi lokalizasyon üretmekle birlikte belirli özel ekipman sınıflarında tek başına sınırlı kalmıştır.
Şekil 2'de özellikle üçüncü örnekteki gas oil burner ve control panel, GPT-4o + Grounding DINO kombinasyonu tarafından tespit edilirken diğer karşılaştırılan modeller tarafından kaçırılmıştır. Pump sınıfının farklı görüşlerde tekrar tespit edilmesi de önerilen kombinasyonun sahne bağlamından yararlanabildiği örneklerden biridir.
Recognition-aware viewpoint refinement neden gerekli?
Çok sayıda kamera ve zoom seviyesi üretmek bile her nesnenin iyi görüntüleneceğini garanti etmez. Bir nesne:
- görüntüde çok küçük kalabilir,
- kenarda kesilebilir,
- başka nesnelerle örtüşebilir,
- uygunsuz açıdan görüntülenebilir.
Çalışmanın farkı, bu başarısızlıkları ölçüp kameraya geri beslemesidir.
Nesnenin görüntüdeki büyüklüğü nasıl ölçülüyor?
Kaynakta projected area ratio için şu ifade basılmıştır:
\[ A_i= \frac{ (x_2-x_1)-(y_2-y_1) }{ W\cdot H }. \]
\((x_1,y_1,x_2,y_2)\) bounding box koordinatlarını, \(W,H\) görüntü genişliği ve yüksekliğini temsil eder.
Kaynak sadakati notu: Makale bunu “projected area ratio” olarak tanımlamasına rağmen genişlik ve yüksekliği çarpmak yerine aralarında çıkarma işareti basmaktadır. Verianla metni formülü standart dikdörtgen alan formülüne sessizce çevirmemektedir; kaynaktaki gösterim aynen korunmaktadır.
Nesnenin kadrajdan taşması nasıl kontrol ediliyor?
Truncation indicator:
\[ T_i= \begin{cases} 1, & x_1\leq\delta \ \text{veya}\ y_1\leq\delta \ \text{veya}\ x_2\geq W-\delta \ \text{veya}\ y_2\geq H-\delta,\\ 0, & \text{aksi durumda} \end{cases} \]
olarak tanımlanmaktadır.
Nesnenin bounding box'ı görüntünün kenarlarına belirlenen \(\delta\) marjından daha fazla yaklaşıyorsa görüş “truncated” olarak işaretlenir.
View suitability skoru nasıl hesaplanıyor?
Nesne ölçeği ve truncation birlikte:
\[ J_{\mathrm{view},i} = \beta\ln(1+A_i)-\gamma T_i \]
ifadesine dönüştürülür.
Daha büyük ve tamamen görüntü içine sığmış nesne daha yüksek uygunluk skoru üretirken kadrajdan taşan nesne cezalandırılır.
Kalabalık sahnelerde üst üste binen kutular nasıl hesaba katılıyor?
Bir görüşteki bounding box çiftlerinin IoU değerleri hesaplanarak belirli:
\[ \tau_{\mathrm{IoU}} \]
eşiğini geçen çiftlerin oranından clutter score \(C_v\) elde edilmektedir.
Yüksek \(C_v\), çok sayıda nesnenin görüntüde üst üste geldiğini ve görüşün grounding için uygun olmayabileceğini gösterir.
Kameranın yeniden ayarlanması ne zaman tetikleniyor?
Kaynağa göre:
- \(A_i<\tau_A\): nesne çok küçük → zoom-in veya kamera mesafesini azalt.
- \(T_i=1\): nesne kadrajdan taşıyor → field of view genişlet veya kamerayı kaydır.
- \(J_{\mathrm{view},i}<\tau_J\): görüş açısı yetersiz → yaw/pitch değiştir.
- \(C_v>\tau_C\): sahne çok kalabalık → yükseklik veya kamera yönünü değiştir.
Öncelik ayrıca:
\[ S_i= w_1\max(0,\tau_A-A_i) + w_2\max(0,\tau_J-J_{\mathrm{view},i}) + w_3T_i \]
severity score'uyla belirlenmektedir.
Field of view ve kamera pozu nasıl değiştiriliyor?
Kaynakta odak uzunluğu güncellemesi:
\[ f'_x= f_z \left( 1-\frac{\Delta FOV}{100} \right), \qquad f'_y= f_y \left( 1-\frac{\Delta FOV}{100} \right) \]
olarak basılmıştır.
Ancak hemen ardından metin başlangıç focal length'leri:
\[ f_x,\;f_y \]
olarak tanımlar ve \(f_z\)'yi açıklamaz. Bu nedenle \(f'_x\) denklemindeki \(f_z\) kaynak-içi bir notasyon tutarsızlığı veya tipografik hata adayıdır. Kaynakta olmayan bir düzeltme yapılmamıştır.
Kamera yönelimi:
\[ P'= P\cdot R_{\mathrm{yaw}}(\theta) \cdot R_{\mathrm{pitch}}(\phi) \]
ile değiştirilirken radial kamera hareketi:
\[ p'_{\mathrm{cam}} = p_{\mathrm{scene}} + (1+\Delta r) \frac{ p_{\mathrm{cam}}-p_{\mathrm{scene}} }{ \|p_{\mathrm{cam}}-p_{\mathrm{scene}}\| } \]
şeklinde verilmektedir.
2B bounding box tekrar 3B konuma nasıl dönüyor?
Visual grounding nesneyi görüntüde bulur; ancak dijital ikiz için nesnenin fabrika koordinatında nerede olduğu gerekir.
Bir görüntü pikseli:
\[ (u,v) \]
ve karşılık gelen depth:
\[ d \]
bilindiğinde kamera koordinatı:
\[ P_C= K^{-1} [u,v,1]^T d \]
ile hesaplanır.
Ardından kamera extrinsic parametreleri kullanılarak:
\[ P_L= R P_C+t \]
dönüşümü uygulanır.
Burada \(P_L\), nesnenin yerel plant coordinate system içindeki 3B konumudur.
Bu yaklaşım 3B CAD modelinin yerini tamamen alıyor mu?
Hayır. Çalışmanın tartışma bölümü bunu açık biçimde sınırlamaktadır. Önerilen yöntem high-precision geometric reconstruction amacıyla tasarlanmamıştır.
Hedeflenen kullanım örnekleri:
- asset inventory oluşturma,
- brownfield dijital ikizini başlatmak için temel mekânsal katman üretme,
- inspection planning,
- remote monitoring,
- varlıkların yaklaşık mekânsal ilişkilerini belirleme
gibi görevlerdir.
Dolayısıyla elde edilen koordinatların üretim toleransı veya hassas reverse engineering ölçümü olarak yorumlanması kaynak tarafından desteklenmemektedir.
Türkiye açısından ne ifade ediyor?
Yöntem özellikle güncel BIM/CAD modeli eksik olan brownfield tesisleri hedeflediği için Türkiye'deki uzun süredir işletilen üretim tesisleri, enerji tesisleri veya karmaşık mekanik odalar açısından araştırmaya değer bir yaklaşım sunabilir. Ancak çalışma Melbourne'de tek bir plant room üzerinde yapılmıştır.
Türkiye'deki bir tesis için aynı AP veya konum hata değerlerinin elde edileceği söylenemez. Yerel doğrulamada nokta bulutu yoğunluğu, tarama kalitesi, tesisin varlık sınıfları, borulama yoğunluğu, küçük komponentlerin boyutu ve foundation modelin ilgili ekipman terminolojisini tanıyıp tanımadığı ayrıca test edilmelidir.
Çalışmanın desteklediği sonuçlar
- Tek bir endüstriyel nokta bulutundan, tesise özel etiketli eğitim veri seti hazırlanmadan 3B varlık tespiti ve yaklaşık lokalizasyon yapılabileceğini bu deney ortamında göstermektedir.
- Önerilen tam pipeline, aynı karşılaştırmada OpenIns3D başlangıcından daha yüksek AP25 ve AP50 vermiştir.
- Duvar kaldırma, çoklu zoom ve recognition-aware refinement aşamalarının kümülatif eklenmesi performansı adım adım yükseltmiştir.
- GPT-4o + Grounding DINO kombinasyonu incelenen endüstriyel görüntülerde diğer test edilen görsel grounding seçeneklerinden daha iyi nitel tespitler göstermiştir.
- Recognition-aware refinement'ın eklenmesi, Tablo 2'deki en büyük son AP artışını oluşturmuştur.
- 11 varlık için yerel koordinat sistemine geri projeksiyon sonucunda 0,105–0,312 m arasında tekil 3B lokalizasyon hataları raporlanmıştır.
- ±%10 parametre duyarlılık analizinde kullanılan bütün perturbation'lar AP25'i düşürmüş; özellikle \(\tau_J\) eşiği en yüksek hassasiyeti göstermiştir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Bütün endüstriyel tesislerde aynı performansı göstereceği test edilmemiştir.
- Farklı ülkeler, endüstri sektörleri veya tarayıcı sistemleri üzerinde cross-site generalisation deneyi yapılmamıştır.
- Yüksek hassasiyetli CAD/reverse-engineering kalitesinde geometrik yeniden yapılandırma gösterilmemiştir.
- “Zero-shot” sonuçlar foundation models olmadan elde edilmemiştir; tesise özgü yeni supervised training yapılmamıştır.
- Herhangi bir tamamen bilinmeyen varlık kategorisinin sınırsız biçimde keşfedileceği gösterilmemiştir; GPT-4o aşamasında önceden tanımlanmış endüstriyel varlık sözlüğü kullanılmaktadır.
- AP farklarının istatistiksel anlamlılığı için tekrarlı deney, confidence interval veya hipotez testi raporlanmamıştır.
- Variable-height camera positioning etkisi diğer geliştirmelerden bağımsız bir ablation satırında ölçülmemiştir.
- Point-cloud downsampling etkisi nicel olarak test edilmemiştir.
- Prompt varyasyonlarının performans üzerindeki etkisi sistematik bir robustness deneyiyle ölçülmemiştir.
Çalışmanın Yöntemi ve Bulguları
Deney ortamı
Değerlendirme, Melbourne'deki bir bina içinde yer alan karmaşık plant room üzerinde gerçekleştirilmiştir.
| Deney bileşeni | Kaynakta verilen bilgi |
|---|---|
| 3B tarayıcı | Leica BLK360 |
| Toplam nokta sayısı | 271.348.287 |
| Nokta bulutu işleme | CloudCompare v2.13.2 |
| GPU | 2 × NVIDIA L40, her biri 48 GB VRAM |
| CPU kaynağı | 16 vCPU |
| Sistem belleği | 241 GB |
| İşletim sistemi | Ubuntu 20.04 |
| Foundation model | GPT-4o, gpt-4o-2024-11-20 |
| 2B grounding | Grounding DINO |
OpenIns3D ile tam sistemin sonuçları
| Varlık | OpenIns3D AP25 | Önerilen AP25 | OpenIns3D AP50 | Önerilen AP50 |
|---|---|---|---|---|
| Ortalama | 35,84 | 48,13 | 26,89 | 34,98 |
| Cabinet | 44,6 | 58,3 | 40,2 | 42,8 |
| Control Panel | 52,3 | 65,4 | 43,3 | 49,2 |
| Electrical Kit | 18,3 | 35,1 | 7,8 | 20,3 |
| Gas/Oil Burner | 0 | 41,3 | 0 | 24,4 |
| Ladder | 74,3 | 76,1 | 50,9 | 51,2 |
| Pump | 16,1 | 21,3 | 6,4 | 15,9 |
| Tank | 78,8 | 80,4 | 68,1 | 69,8 |
| Valve | 33,4 | 36,4 | 27,6 | 29,1 |
| Duct | 7,3 | 10,7 | 0 | 6,2 |
| Fire Extinguisher | 33,3 | 56,3 | 24,6 | 40,9 |
En çarpıcı fark gas/oil burner sınıfında görülmektedir. OpenIns3D başlangıcı hem AP25 hem AP50'de 0 verirken önerilen framework sırasıyla 41,3 ve 24,4 değerlerine ulaşmıştır.
Electrical kit için AP25 18,3'ten 35,1'e, AP50 7,8'den 20,3'e; fire extinguisher için AP25 33,3'ten 56,3'e ve AP50 24,6'dan 40,9'a çıkmıştır.
Buna karşılık her sınıfta aynı büyüklükte artış görülmez. Örneğin tank ve ladder zaten başlangıç yönteminde güçlü sınıflardır ve artışları daha sınırlıdır. Bu durum sistemin temel avantajının özellikle karmaşık, küçük, gizlenen veya foundation model için daha zor varlıklarda ortaya çıkabildiğini göstermektedir; ancak bu yorum yalnız bu test sahasına aittir.
Aşamalı iyileştirmelerin etkisi
Duvar kaldırma başlangıç AP25 değerini 35,84'ten 38,22'ye çıkarırken AP50 yalnız 26,89'dan 27,10'a yükselmiştir.
Çoklu zoom eklendiğinde AP25 42,63, AP50 28,82 olmuştur.
Son recognition-aware refinement aşamasıyla AP25:
\[ 42{,}63\rightarrow48{,}13 \]
ve AP50:
\[ 28{,}82\rightarrow34{,}98 \]
düzeyine çıkmıştır.
Tablo 2 başlangıçtan finale toplam farkı AP25 için 12,29, AP50 için 8,09 olarak vermektedir. Bunlar başlangıç ve son AP değerlerinin aritmetik farklarıdır.
Recognition-aware refinement parametreleri ne kadar hassas?
Kaynağın temel parametre seti:
| Parametre | Varsayılan değer |
|---|---|
| \(\delta\) | 10 px |
| \(\beta\) | 1,0 |
| \(\gamma\) | 0,3 |
| \(\tau_A\) | 0,01 |
| \(\tau_J\) | 0,1 |
| \(\tau_{\mathrm{IoU}}\) | 0,3 |
| \(\tau_C\) | 0,15 |
Her parametre ayrı ayrı ±%10 değiştirildiğinde raporlanan AP25 farkları şöyledir:
| Parametre | −%10 için ΔAP25 | +%10 için ΔAP25 |
|---|---|---|
| Image boundary margin \(\delta\) | −0,09 | −0,11 |
| Area contribution weight \(\beta\) | −0,10 | −0,14 |
| Truncation penalty \(\gamma\) | −0,09 | −0,12 |
| Minimum projected area \(\tau_A\) | −0,10 | −0,11 |
| View suitability threshold \(\tau_J\) | −0,65 | −0,55 |
| IoU overlap threshold \(\tau_{\mathrm{IoU}}\) | −0,06 | −0,08 |
| View clutter threshold \(\tau_C\) | −0,05 | −0,06 |
Bütün perturbation'ların negatif olması yazarların seçtiği temel konfigürasyonun bu yerel aralıkta en iyi denenen nokta olduğunu göstermektedir. En belirgin hassasiyet:
\[ \tau_J \]
view suitability threshold'unda görülmektedir. Buna karşılık clutter modelini belirleyen \(\tau_{\mathrm{IoU}}\) ve \(\tau_C\) değişiklikleri daha küçük etki göstermiştir.
3B lokalizasyon hataları ne düzeyde?
Çalışma 11 lokalize varlık için ground-truth koordinatıyla tespit edilen konum arasındaki 3B Öklid mesafesini tek tek raporlamaktadır:
| Varlık ID | 3B mutlak lokalizasyon hatası (m) |
|---|---|
| 1 | 0,180 |
| 2 | 0,121 |
| 3 | 0,122 |
| 4 | 0,202 |
| 5 | 0,162 |
| 6 | 0,227 |
| 7 | 0,312 |
| 8 | 0,135 |
| 9 | 0,114 |
| 10 | 0,105 |
| 11 | 0,174 |
En düşük raporlanan hata 0,105 m, en yüksek hata 0,312 m'dir. Kaynak bu tablo için ayrı bir ortalama lokalizasyon hata metriği raporlamamakta; sonuçları tekil varlık bazında göstermektedir.
Yazarlar bu doğruluk seviyesini hassas geometrik reverse engineering için değil, geniş ölçekli operasyon ve bakım uygulamalarında varlığın mevcudiyeti, yaklaşık geometrik kapsamı ve mekânsal ilişkilerinin belirlenmesi açısından yeterli görmektedir.
Point cloud yoğunluğu neden hâlâ kritik?
Zero-shot foundation model kullanılması, giriş geometrisinin kalitesini önemsiz hâle getirmiyor. Kaynak, point-cloud fidelity'nin tespit performansını doğrudan etkileyebileceğini belirtmektedir.
Moderate down-sampling'in işlem maliyetini azaltabileceğine ilişkin nitel gözlemler bulunurken aşırı point reduction küçük valve ve duct gibi nesnelerin ince geometrisini kaybettirebilir.
Ancak çalışma down-sampling oranı ile AP veya lokalizasyon hatası arasında nicel bir deney sunmamaktadır.
Hesaplama maliyeti ne kadar önemli?
271 milyondan fazla noktalı büyük sahnelerden yüksek çözünürlüklü çok sayıda sanal görüntü üretmek hesaplama açısından maliyetlidir. Araştırmacılar büyük point cloud'ları daha küçük bölgelere ayırarak yükü azaltmayı önermektedir.
Bunun da bir bedeli vardır: bölme sınırlarında bulunan geometrik bağlam ve mekânsal bilgi kaybolabilir. Dolayısıyla ölçeklenebilirlik yalnız GPU eklemek değil, sahneyi nasıl parçalayacağını da çözmeyi gerektirmektedir.
Prompt engineering neden bir sınırlılık?
GPT-4o ve Grounding DINO'ya gönderilen prompt'un sözcük seçimi, ayrıntı seviyesi ve ifade biçimi sonuçları değiştirebilir. Kaynak, prompt engineering'i açık bir sınırlılık olarak belirtmektedir.
Gelecek çalışma önerilerinden biri, retrieval-augmented generation kullanarak varlık bilgisini haricî knowledge base'den çekmek ve prompt'u bağlama göre otomatik olarak zenginleştirmektir.
Çalışmanın gelecek araştırma yönleri
Makale üç temel alanı öne çıkarıyor:
- Spatial zoning: IFC veri modelleri ve knowledge graph kullanarak büyük endüstriyel nokta bulutlarının anlamlı mekânsal bölgelere ayrılması.
- Adaptive image rendering: Küçük valve/flange gibi varlıklarda daha yüksek kalite, büyük varlıklarda daha ekonomik rendering kullanılması.
- RAG destekli prompt engineering: Endüstriyel varlık bilgisinin retrieval ile prompt'a dinamik olarak dahil edilmesi.
En önemli metodolojik sınırlılıklar
- Değerlendirme yalnız tek bir endüstriyel plant room'da yapılmıştır.
- Asset ve çevre çeşitliliğinin farklı tesislere aktarılabilirliği deneysel olarak gösterilmemiştir.
- Toz, nem, aydınlatma, sensor noise ve occlusion gibi farklı saha koşulları point-cloud kalitesini değiştirebilir.
- Büyük point cloud rendering yüksek hesaplama maliyetine sahiptir.
- Point-cloud segmentasyonu bölge sınırlarında bilgi kaybına yol açabilir.
- Küçük ve özel endüstriyel ekipmanların tespiti hâlâ zordur.
- Prompt engineering sonuç üzerinde önemli etkiye sahiptir.
- Down-sampling etkisi nicel olarak ölçülmemiştir.
- AP farkları için uncertainty veya istatistiksel anlamlılık analizi verilmemiştir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Zero-Shot 3D Asset Detection and Localisation Through Visual Grounding in Industrial Point Clouds
Yazarlar: Masoud Kamali; Behnam Atazadeh; Abbas Rajabifard; Yiqun Chen.
Eş birinci/eş katkı: Kaynakta eş birinci yazar veya eş katkı beyanı bulunmamaktadır.
Sorumlu yazar: Behnam Atazadeh.
Kurum: The Centre for Spatial Data Infrastructures and Land Administration, Department of Infrastructure Engineering, The University of Melbourne, Melbourne, Victoria, Australia.
Kaynak türü: Hakemli özgün araştırma makalesi; bilgisayarlı görü, 3B sahne anlama ve endüstriyel varlık lokalizasyonu çalışması.
Dergi: AI.
Yayınevi: MDPI, Basel, İsviçre.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 6, Makale 205.
DOI: 10.3390/ai7060205.
Alınma / revizyon / kabul / yayın: 2 Mart 2026 / 18 Mayıs 2026 / 26 Mayıs 2026 / 5 Haziran 2026.
Hakemlik durumu: Hakemli dergi yayınıdır.
Lisans: Creative Commons Attribution (CC BY).
Academic Editors: Miguel Angel Cazorla; Emanuele Frontoni.
Temel araştırma problemi: Etiketli endüstriyel eğitim veri seti veya güncel CAD modeli bulunmayan karmaşık endüstriyel ortamlarda yalnız point cloud verisinden zero-shot varlık tespiti ve yaklaşık 3B lokalizasyon.
Giriş verisi: Leica BLK360 ile elde edilen 271.348.287 noktalık endüstriyel point cloud.
Temel yöntem: Virtual camera positioning → image generation → GPT-4o semantic interpretation → Grounding DINO visual grounding → recognition-aware camera refinement → depth/intrinsic/extrinsic tabanlı 3B asset localisation.
Foundation model: GPT-4o, kaynakta `gpt-4o-2024-11-20` sürüm etiketiyle belirtilmiştir.
Visual grounding modeli: Grounding DINO.
Baseline: OpenIns3D; kontrollü karşılaştırmada GPT-4o + Grounding DINO görsel grounding yapılandırması baseline ve önerilen yöntemde tutarlı biçimde kullanılmıştır.
Ana detection sonucu: Ortalama AP25 35,84'ten 48,13'e, AP50 26,89'dan 34,98'e yükselmiştir.
Incremental sonuç: OpenIns3D → wall removal → multiple zoom + wall removal → recognition-aware refinement sırasıyla AP25 35,84 → 38,22 → 42,63 → 48,13 ve AP50 26,89 → 27,10 → 28,82 → 34,98.
Lokalizasyon değerlendirmesi: Ground-truth'a karşı 11 varlığın 3B Öklid konum hataları tek tek verilmiş ve 0,105–0,312 m aralığında gerçekleşmiştir.
Parametre duyarlılığı: Recognition-aware refinement parametreleri ±%10 değiştirilmiş; bütün perturbation'lar AP25'te düşüş üretmiş ve en hassas parametre \(\tau_J\) view suitability threshold olmuştur.
Donanım: 2 × NVIDIA L40 48 GB VRAM; 16 vCPU; 241 GB RAM.
İşletim sistemi: Ubuntu 20.04.
Point-cloud yazılımı: CloudCompare v2.13.2.
Finansman: Australian Research Council, IH210100048 ve DE220100094 numaralı hibeler.
Veri erişilebilirliği: Çalışmada kullanılan veriler daha geniş ve devam eden bir araştırma/geliştirme projesi nedeniyle sorumlu yazardan makul talep üzerine edinilebilir olarak bildirilmiştir.
Etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
Teşekkür: University of Melbourne Research Computing Services ve Petascale Campus Initiative desteğinin yanı sıra Emerson ve Rockfield sektör ortaklarının desteği belirtilmiştir; yazarlar makaledeki görüşlerin kendilerine ait olduğunu ayrıca ifade etmektedir.
Yazar katkıları: Kavramsallaştırma M.K. ve B.A.; metodoloji M.K., B.A. ve Y.C.; yazılım M.K.; doğrulama M.K. ve B.A.; formal analiz M.K.; araştırma M.K., B.A. ve Y.C.; kaynaklar M.K., B.A. ve Y.C.; veri kürasyonu M.K.; ilk taslak M.K.; gözden geçirme ve düzenleme bütün yazarlar; görselleştirme M.K.; danışmanlık B.A., A.R. ve Y.C.; proje yönetimi A.R. ve Y.C.; finansman edinimi B.A. ve A.R. tarafından gerçekleştirilmiştir.
Kaynak içi formül ve raporlama notları
Recognition-aware refinement bölümündeki projected-area formülü kaynakta:
\[ A_i= \frac{(x_2-x_1)-(y_2-y_1)}{W H} \]
olarak yazılmıştır. “Alan oranı” açıklamasıyla matematiksel ifade arasında olası bir tutarsızlık vardır; Verianla metninde standart bounding-box alan formülüne sessizce değiştirilmemiştir.
Benzer biçimde field-of-view güncellemesinde \(f'_x\) için \(f_z\) kullanılmış, fakat açıklama \(f_x,f_y\)'yi başlangıç focal length'leri olarak tanımlamıştır. Kaynak \(f_z\)'yi bu bağlamda açıklamamaktadır.
Tablo 2, başlangıç ile nihai yöntem arasındaki AP25 farkını 12,29 olarak gösterir. Sonuç bölümündeki “%12,29” ifadesi bu aritmetik AP farkını yüzde işaretiyle yazmaktadır. Bu nedenle burada “12,29 AP puanı” ile “%12,29 göreli iyileşme” aynı şeymiş gibi kullanılmamıştır.
Kaynağın özetindeki “significantly outperforming” ifadesine karşın karşılaştırma için tekrarlı değerlendirme belirsizliği, confidence interval veya formal istatistiksel significance testi raporlanmamaktadır. Verianla anlatımı performans farkını sayısal değerleriyle verir; istatistiksel anlamlılık sonucu eklemez.
Bilimsel yorum sınırı
Bu araştırmanın temel başarısı, tek bir karmaşık plant room'daki point cloud verisini foundation models ve adaptif sanal kamera üretimiyle birleştirerek etiketli domain-specific eğitim gerektirmeden daha yüksek tespit başarısı ve kullanılabilir yaklaşık 3B lokalizasyon göstermesidir.
Bununla birlikte sonuç tek tesis doğrulamasına dayanmaktadır. Endüstriyel varlıkların geometrisi, sensör gürültüsü, tarama yoğunluğu, occlusion yapısı ve foundation modelin varlık terminolojisini tanıma kapasitesi başka ortamlarda farklı olacaktır.
Bu nedenle AP25 48,13 ve AP50 34,98 değerleri “endüstriyel tesislerde genel başarı oranı” olarak değil, bu çalışmanın tanımladığı test sahası, varlık sınıfları, point cloud ve değerlendirme protokolüne ait model performansı olarak okunmalıdır.
Aynı biçimde 0,105–0,312 m lokalizasyon hataları da yüksek hassasiyetli survey/CAD doğruluğu garantisi değildir. Kaynak yöntemi açıkça asset inventory, digital-twin initialisation ve inspection planning gibi yaklaşık mekânsal konumun operasyonel değer taşıdığı uygulamalara konumlandırmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir