

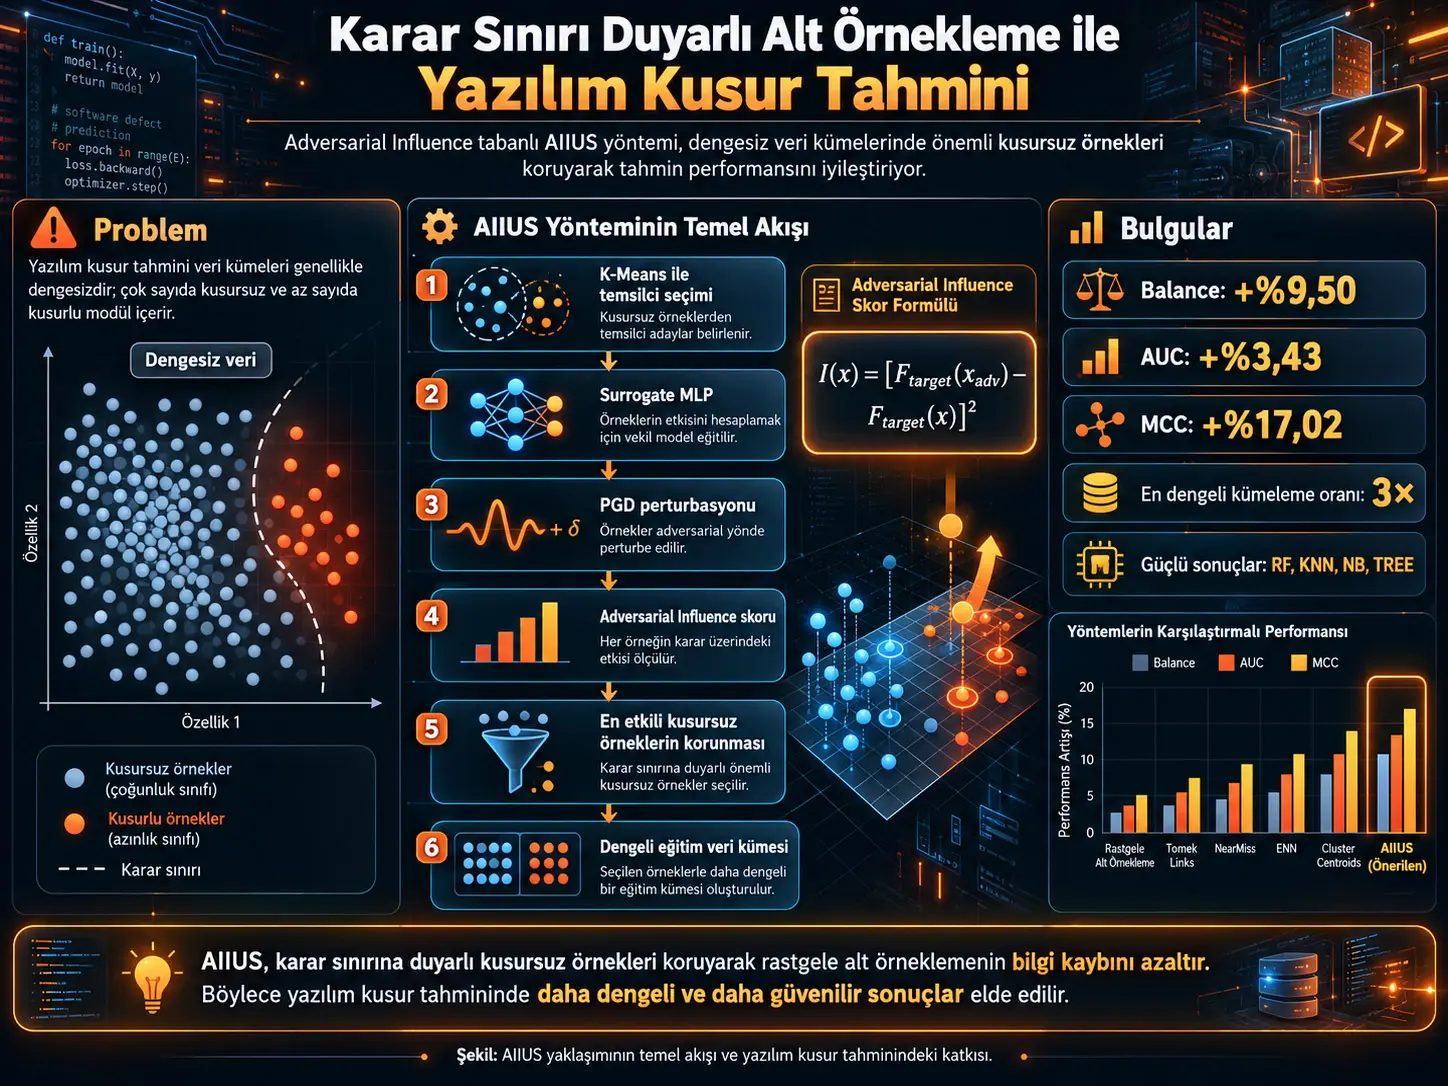
Yazılım kusur tahmini sistemleri, hangi kod modüllerinin kusur içerme olasılığının daha yüksek olduğunu belirleyerek test ve inceleme kaynaklarının daha verimli kullanılmasına yardımcı olabilir. Ancak gerçek yazılım veri kümelerinde kusursuz modüller genellikle kusurlu modüllerden çok daha fazladır. Bu sınıf dengesizliği, bir sınıflandırıcının genel doğruluğu yüksek görünmesine rağmen kusurlu örnekleri kaçırmasına veya çok fazla yanlış alarm üretmesine yol açabilir.
Bu çalışma, çoğunluk sınıfındaki kusursuz örnekleri rastgele azaltmak yerine karar sınırı açısından daha önemli görünen örnekleri korumayı amaçlayan Adversarial Influence-Based Intelligent Undersampling (AIIUS) yöntemini öneriyor. Yöntemin temel yeniliği olan Adversarial Influence, bir örneğe küçük ve hedefli bir perturbasyon uygulandığında hedef sınıflandırıcının kusur olasılığı tahmininin ne kadar değiştiğini ölçüyor. Tahmin değişimi yüksek olan çoğunluk örnekleri, modelin karar davranışı açısından daha bilgilendirici adaylar olarak önceliklendiriliyor.
AIIUS üç temel aşamadan oluşuyor. Önce kusursuz örnekler K-Means ile kümelenerek veri dağılımını temsil eden daha küçük bir aday havuzu oluşturuluyor. Daha sonra diferansiyellenebilir bir surrogate MLP üzerinde PGD perturbasyonları üretiliyor ve bu özgün/adversarial örnekler hedef black-box sınıflandırıcıya verilerek Adversarial Influence hesaplanıyor. Son aşamada adaylar influence skoruna göre sıralanıyor ve kusurlu örnek sayısına eşit sayıda en yüksek etkili kusursuz örnek tutuluyor.
Yöntem 18 kamuya açık yazılım kusur veri kümesi ve beş farklı sınıflandırıcı üzerinde altı yeniden örnekleme yöntemiyle karşılaştırılıyor. Kaynak, temsilî baseline'lara göre ortalama olarak Balance'ta %9,50, AUC'de %3,43 ve MCC'de %17,02 iyileşme raporluyor. Bununla birlikte AIIUS bütün sınıflandırıcılarda ve bütün metriklerde en yüksek sonucu vermiyor; avantaj özellikle MCC ve Balance gibi sınıf dengesizliğine daha dayanıklı ölçütlerde belirginleşiyor.
Yazılım kusur tahmininde sınıf dengesizliği neden sorun oluşturuyor?
Bir yazılım projesindeki modüllerin büyük kısmı kusursuz olabilir. Bu durumda eğitim verisindeki çoğunluk sınıfı, yani kusursuz örnekler, kusurlu örneklerin sayısını birkaç kat hatta onlarca kat aşabilir.
Kaynakta incelenen veri kümelerinde dengesizlik oranı
\[ IR=\frac{N_{\mathrm{maj}}}{N_{\mathrm{min}}} \]
ile tanımlanır. Burada \(N_{\mathrm{maj}}\) kusursuz çoğunluk örneklerinin, \(N_{\mathrm{min}}\) ise kusurlu azınlık örneklerinin sayısıdır.
Çalışmadaki 18 veri kümesinde bu oran yaklaşık 3,50 ile 25,08 arasında değişir.
Böyle bir dağılımda yalnız toplam doğruluğu optimize eden bir model, çoğunluk sınıfını çok sık seçerek görünürde yüksek başarı gösterebilir. Ancak operasyonel açıdan iki hata önemlidir:
- Kusurlu bir modülün kusursuz kabul edilmesi, yani false negative, gerçek kusurun gözden kaçmasına neden olabilir.
- Kusursuz bir modülün kusurlu ilan edilmesi, yani false positive, gereksiz test ve inceleme maliyeti yaratabilir.
Oversampling ve undersampling arasındaki fark
Oversampling azınlık sınıfını büyütmeye çalışır. SMOTE gibi yöntemler mevcut kusurlu örneklerin arasında sentetik noktalar üretir. Bu yöntem sınıf oranını dengeleyebilir ancak sentetik örneklerin gürültü veya sınıf örtüşmesini artırma riski bulunur.
Undersampling ise çoğunluk sınıfından bazı örnekleri kaldırır. Avantajı sentetik kusurlu örnek üretmemesidir; ancak hangi çoğunluk örneklerinin silindiği kritik hale gelir.
Rastgele bir undersampling, karar sınırını tanımlayan önemli kusursuz örnekleri de kaldırabilir. AIIUS'un çıkış noktası tam olarak budur: çoğunluk örneklerinin hepsi eşit derecede gereksiz değildir.
Adversarial Influence Neyi Ölçüyor?
Adversarial Influence, küçük bir hedefli perturbasyon sonrasında hedef sınıflandırıcının tahmin olasılığının ne kadar değiştiğini ölçen model-tepkisi tabanlı bir örnek önem skorudur. Amaç, yalnız veri geometrisine veya sınıflandırıcının tek noktadaki belirsizliğine bakmak yerine, modelin lokal değişime verdiği tepkiyi kullanmaktır.
Bir kusursuz örnek \(x\) ve bu örneğin adversarial karşılığı \(x_{\mathrm{adv}}\) için:
\[ \boxed{ I(x)= \left( F_{\mathrm{target}}(x_{\mathrm{adv}}) - F_{\mathrm{target}}(x) \right)^2 } \]
tanımlanır.
Burada:
- \(F_{\mathrm{target}}(x)\): hedef sınıflandırıcının özgün örnek için ürettiği kusur olasılığı,
- \(F_{\mathrm{target}}(x_{\mathrm{adv}})\): perturbasyon uygulanmış örnek için üretilen olasılık,
- \(I(x)\): tahmin değişiminin karesiyle tanımlanan Adversarial Influence değeridir.
Değer büyüdükçe hedef modelin o örneğin yakın çevresindeki perturbasyona daha duyarlı olduğu anlaşılır. Çalışma bu duyarlılığı karar sınırı açısından örnek önemine ilişkin bir vekil sinyal olarak kullanır.
Belirsizlik ölçümünden farkı nedir?
Standart uncertainty yaklaşımı çoğu zaman sınıflandırıcının mevcut tahmininin 0,5 gibi karar eşiğine ne kadar yakın olduğuna bakar.
Adversarial Influence ise farklı bir soru sorar:
“Bu noktaya küçük ve yönlendirilmiş bir değişiklik yaptığımda modelin tahmini ne kadar hareket ediyor?”
Dolayısıyla ölçüm statik bir tahmin olasılığından ziyade modelin lokal tepki davranışına dayanır.
Önemli yorum sınırı
Adversarial Influence doğrudan matematiksel karar-sınırı uzaklığı değildir ve bir örnek veri kümesinden çıkarıldığında yeniden eğitilmiş model sınırının ne kadar değişeceğini doğrudan hesaplamaz. Bu çalışma onu, karar davranışına yönelik lokal duyarlılıktan türetilmiş bir instance-importance ölçütü olarak kullanmaktadır.
Çalışmanın Yöntemi ve Bulguları
AIIUS'un üç aşaması
| Aşama | İşlem | Amaç |
|---|---|---|
| 1 | K-Means ile temsilci seçimi | Çoğunluk sınıfındaki fazlalığı azaltırken genel dağılımı korumaya çalışmak |
| 2 | Surrogate tabanlı PGD ve Adversarial Influence | Her adayın hedef model açısından lokal karar duyarlılığını ölçmek |
| 3 | Influence-guided undersampling | En yüksek influence değerine sahip kusursuz örnekleri koruyarak dengeli veri oluşturmak |
Birinci aşama: K-Means ile aday havuzu
Kusursuz çoğunluk sınıfı
\[ S_{\mathrm{maj}} \]
üzerinde K-Means uygulanır.
Küme sayısı:
\[ K=\lambda|S_{\mathrm{min}}| \]
olarak belirlenir.
Ana deneylerde:
\[ \lambda=3 \]
kullanılır.
Her kümenin sentroidine en yakın gerçek kusursuz örnek seçilir. Böylece yaklaşık
\[ 3|S_{\mathrm{min}}| \]
büyüklüğünde bir aday çoğunluk havuzu elde edilir.
Bu aşamanın amacı doğrudan nihai undersampling yapmak değildir. K-Means burada adversarial değerlendirmeye girecek örneklerin sayısını düşürürken çoğunluk sınıfının farklı bölgelerinden temsilciler tutmaya yarar.
İkinci aşama: surrogate model
KNN ve Random Forest gibi hedef modellerde gerekli giriş gradyanları doğrudan bulunmayabilir. Bu nedenle çalışma:
\[ F_{\mathrm{surrogate}} \]
ile gösterilen diferansiyellenebilir bir MLP eğitir.
Surrogate, hedef modelin karar davranışını yaklaşık temsil etmek ve PGD perturbasyonunun hangi yönde üretileceğini belirlemek için kullanılır.
Ancak nihai Adversarial Influence yalnız surrogate çıktısından hesaplanmaz. Özgün ve adversarial örnekler tekrar hedef sınıflandırıcıya verilerek gerçek hedef-model tahmin değişimi ölçülür.
PGD perturbasyonu
Bir örnek için başlangıç:
\[ x_0=x \]
olarak alınır ve PGD iterasyonu:
\[ x_{t+1} = \Pi_{\|\delta\|_\infty\leq\epsilon} \left[ x_t+ \alpha\, \mathrm{sign} \left( \nabla_x \mathcal L(F_{\mathrm{surrogate}}(x_t)) \right) \right] \]
biçiminde uygulanır.
Burada:
- \(\epsilon\): maksimum perturbasyon büyüklüğü,
- \(\alpha\): adım büyüklüğü,
- \(T\): PGD iterasyon sayısıdır.
Bu üç parametre elle sabitlenmek yerine Differential Evolution kullanılarak seçilir. Optimizasyon hedefi eğitim verisi üzerindeki cross-validated MCC'dir.
Üçüncü aşama: influence-guided selection
Bütün temsilci kusursuz örneklerin \(I(x)\) skorları hesaplandıktan sonra örnekler büyükten küçüğe sıralanır.
En yüksek influence değerine sahip
\[ |S_{\mathrm{min}}| \]
adet kusursuz örnek seçilir:
\[ |\widetilde S_{\mathrm{maj}}| = |S_{\mathrm{min}}|. \]
Nihai dengeli veri kümesi:
\[ D_{\mathrm{balance}} = \widetilde S_{\mathrm{maj}} \cup S_{\mathrm{min}} \]
biçiminde kurulur.
AIIUS algoritmasının özeti
- Veriyi kusurlu ve kusursuz sınıflara ayır.
- \(K=\lambda|S_{\mathrm{min}}|\) belirle.
- Kusursuz örnekleri K-Means ile \(K\) kümeye böl.
- Her kümenin sentroidine en yakın gerçek örneği seç.
- Surrogate MLP'yi eğit.
- PGD parametrelerini Differential Evolution ile belirle.
- Her temsilci için adversarial örnek üret.
- Target classifier üzerinden Adversarial Influence hesapla.
- Örnekleri influence skoruna göre sırala.
- En yüksek skorlu \(|S_{\mathrm{min}}|\) kusursuz örneği tut.
- Kusurlu örneklerle birleştirerek 1:1 dengeli eğitim kümesi oluştur.
Deney veri kümeleri
Çalışma dört açık veri kaynağından 18 veri kümesi kullanır:
- AEEEM: JDT, LC, ML, PDE
- NASA: CM1, MW1, PC1, PC3, PC4
- PROMISE: ant-1.3, camel-1.0, synapse-1.0, xalan-2.4
- SOFTLAB: AR1, AR3, AR4, AR5, AR6
Özellik sayıları yaklaşık 20 ile 61 arasında değişmektedir.
En yüksek dengesizlik oranı PROMISE camel-1.0 veri kümesinde:
\[ IR=25.08 \]
olarak raporlanır.
Beş hedef sınıflandırıcı
- K-Nearest Neighbors (KNN)
- Random Forest (RF)
- Decision Tree (TREE)
- Logistic Regression (LR)
- Naive Bayes (NB)
Kaynak bunları scikit-learn'deki varsayılan parametreleriyle kullanır.
Altı baseline
- UFIDSF
- SB-GAN
- Cluster-based undersampling
- Random Undersampling
- Borderline-SMOTE
- SMOTE
Deney protokolü
Önce her sayısal özellik:
\[ x_i^{(j)} \leftarrow \log(x_i^{(j)}+1) \]
dönüşümünden geçirilir.
Daha sonra stratified 5-fold cross-validation uygulanır. Resampling yalnız eğitim fold'u üzerinde yapılır. Test fold'u özgün sınıf dağılımıyla değerlendirilir.
Bütün prosedür 10 farklı random initialization ile tekrar edilir ve sonuçların ortalaması alınır.
Kullanılan performans ölçüleri
Probability of Detection / Recall:
\[ PD= \frac{TP}{TP+FN} \]
Probability of False Alarm:
\[ PF= \frac{FP}{TN+FP} \]
Balance:
\[ Balance = 1- \frac{ \sqrt{ PF^2+(1-PD)^2 } }{ \sqrt2 } \]
Ayrıca AUC ve MCC kullanılır.
MCC özellikle dengesiz sınıflandırmada yararlıdır çünkü TP, TN, FP ve FN'nin tamamını birlikte dikkate alır:
\[ MCC= \frac{ TP\times TN-FP\times FN }{ \sqrt{ (TP+FP)(TP+FN)(TN+FP)(TN+FN) } }. \]
AIIUS Diğer Yeniden Örnekleme Yöntemlerine Göre Ne Sonuç Veriyor?
Kaynağın genel özetine göre AIIUS, temsilî baseline yöntemlerine karşı ortalama olarak Balance'ta %9,50, AUC'de %3,43 ve MCC'de %17,02 kazanç sağlıyor. En tutarlı avantaj MCC ve Balance üzerinde görülüyor; ancak yöntem her classifier-metric kombinasyonunda birinci değildir.
Balance sonuçları
| Classifier | AIIUS Balance | Sonucun konumu |
|---|---|---|
| KNN | 0,688 | En yüksek ortalama |
| LR | 0,698 | En yüksek ortalama |
| NB | 0,650 | En yüksek değil |
| RF | 0,732 | En yüksek ortalama |
| TREE | 0,662 | En yüksek ortalama |
Örneğin RF üzerinde UFIDSF'nin PD değeri yüksek olmasına rağmen PF değeri de 0,350'ye çıkıyor. AIIUS ise PD=0,768 ve PF=0,189 kombinasyonuyla daha yüksek Balance=0,732 sağlıyor.
Bu sonuç AIIUS'un yalnız daha fazla kusur bulmayı değil, kusur yakalama ile yanlış alarm arasındaki dengeyi hedeflediğini gösterir.
AUC sonuçları
AIIUS'un ortalama AUC değerleri:
- KNN: 0,723
- LR: 0,755
- NB: 0,691
- RF: 0,760
- TREE: 0,689
RF ve TREE'de AIIUS en yüksek ortalama AUC'yi verir. KNN, LR ve NB'de ise bazı baseline'lar daha yüksek değer elde eder.
MCC sonuçları
AIIUS'un ortalama MCC değerleri:
| Classifier | AIIUS MCC |
|---|---|
| KNN | 0,316 |
| LR | 0,330 |
| NB | 0,299 |
| RF | 0,387 |
| TREE | 0,274 |
AIIUS KNN, NB, RF ve TREE üzerinde en yüksek ortalama MCC'yi elde eder. LR'de en yüksek sonuç SMOTE'un 0,338 değeridir; AIIUS 0,330 ile bunun biraz altında kalır.
Random Forest altında dikkat çeken sonuç
Random Forest için ortalama MCC:
| Yöntem | Ortalama MCC |
|---|---|
| AIIUS | 0,387 |
| UFIDSF | 0,310 |
| SB-GAN | 0,323 |
| Cluster | 0,269 |
| RUS | 0,325 |
| Borderline-SMOTE | 0,335 |
| SMOTE | 0,337 |
AIIUS, UFIDSF ile yapılan veri-kümesi bazlı karşılaştırmada RF altında 18/0/0 Win/Draw/Loss sonucu elde eder.
K-Means Aşaması Neden Gerekli?
K-Means yalnız hesaplama maliyetini azaltmak için kullanılmıyor. Çalışmanın gerekçesi, yalnız karar sınırına çok yakın örnekleri tutmanın çoğunluk sınıfının güvenli ve yoğun bölgelerini tamamen temsil dışı bırakabilmesidir. Önce dağılımın farklı bölgelerinden temsilci almak, daha sonra bunların arasından influence tabanlı seçim yapmak bu iki hedefi birleştirmeye çalışır.
Clustering-ratio deneyi
Kaynak şu ayarları karşılaştırır:
- No-cluster
- \(1\times|S_{\mathrm{min}}|\)
- \(2\times|S_{\mathrm{min}}|\)
- \(3\times|S_{\mathrm{min}}|\)
- \(3.5\times|S_{\mathrm{min}}|\)
Genel sonuç:
\[ \boxed{\lambda=3} \]
ayarının ortalama performans ile veri-kümesi arası kararlılık arasında en dengeli seçenek olduğudur.
Bu sonuç bütün classifier'lar için monoton değildir. Örneğin KNN no-cluster durumunda bazı ortalamalarda daha iyi olabilir; ancak standart sapmasının daha yüksek olması yöntemin veri bölünmesine daha duyarlı hale geldiğini gösterir.
PCA görselleştirmesi
NASA PC4 örneğinde kaynak üç aşamalı bir PCA görselleştirmesi sunar:
- Özgün dengesiz veri,
- K-Means sonrasında temsilci kusursuz örnekler,
- Adversarial Influence seçimi sonrasında dengeli veri.
Bu görsel, AIIUS'un “çoğunluk sınıfını rastgele kesmek” yerine iki aşamalı dağılım + karar-duyarlılığı yaklaşımı kullandığını anlatır.
Daha Karmaşık Bir Surrogate Model AIIUS'u İyileştiriyor mu?
Kaynakta standart MLP; Deep-MLP, CNN ve ResNet surrogate mimarileriyle karşılaştırılıyor. Sonuçlar, daha karmaşık surrogate modellerin MCC açısından tutarlı ve büyük bir üstünlük sağlamadığını gösteriyor. Bu veri ölçeğinde standart MLP yeterli bir karar-fonksiyonu yaklaşımı olarak kullanılıyor.
| Classifier | MLP | Deep-MLP | CNN | ResNet |
|---|---|---|---|---|
| KNN | 0,316 | 0,316 | 0,314 | 0,315 |
| LR | 0,330 | 0,298 | 0,316 | 0,311 |
| NB | 0,299 | 0,301 | 0,301 | 0,299 |
| RF | 0,387 | 0,390 | 0,382 | 0,385 |
| TREE | 0,274 | 0,279 | 0,281 | 0,275 |
Burada amaç surrogate'ın hedef modelle birebir aynı olması değildir; adversarial perturbasyon üretmek için hedef karar davranışını yeterli ölçüde yaklaşık temsil etmesidir.
AIIUS'un hesaplama maliyeti
İlk aşamada K-Means yaklaşık olarak:
\[ O( |S_{\mathrm{maj}}| K d I_{\mathrm{km}} ) \]
maliyetindedir.
Surrogate eğitimi:
\[ O(ENd) \]
ve PGD kısmı yaklaşık:
\[ O(KT) \]
olarak verilir.
Target classifier sorguları:
\[ O(KC_{\mathrm{target}}) \]
ve influence skorlarının sıralanması:
\[ O(K\log K) \]
maliyetindedir.
Kaynak, K-Means ve öğrenme iterasyonlarını pratikte küçük sabitler olarak ele alarak genel yapıyı yaklaşık
\[ O\!\left( (|S_{\mathrm{maj}}||S_{\mathrm{min}}|+N)d \right) \]
şeklinde özetler.
Çalışmanın desteklediği sonuçlar
- Karar sınırı duyarlılığı, çoğunluk-sınıfı örneklerini seçmek için kullanılabilir bir sinyal olarak işlev görebilir.
- AIIUS, 18 SDP veri kümesinde çok sayıda baseline'a karşı özellikle MCC ve Balance üzerinde güçlü sonuçlar üretmiştir.
- K-Means ile orta büyüklükte bir aday havuzu oluşturmak performans ile kararlılığı birlikte iyileştirebilir.
- Kaynakta \(3\times\) clustering oranı genel olarak en dengeli çalışma noktasıdır.
- Standart MLP surrogate, bu deneylerde daha karmaşık surrogate mimarilerinden tutarlı biçimde daha kötü değildir.
- Black-box hedef sınıflandırıcılarda surrogate üzerinden üretilen perturbasyonlar instance ranking amacıyla kullanılabilir.
Çalışmanın desteklemediği yorumlar
- AIIUS her veri kümesi, classifier ve metrikte en iyi yöntem değildir.
- Adversarial Influence karar sınırına kesin geometrik uzaklığı ölçmez.
- Yüksek influence bir örneğin çıkarılmasının yeniden eğitilmiş karar sınırını kesin olarak ne kadar değiştireceğini doğrudan göstermez.
- Çalışma adversarial saldırı geliştirme amacı taşımamaktadır; perturbasyonlar örnek önemini ölçmek için kullanılmaktadır.
- Sonuçlar bütün dengesiz sınıflandırma problemlerine otomatik olarak genellenemez.
- Daha büyük veya zaman-kritik veri ortamlarında ek PGD ve surrogate maliyetinin önemsiz olduğu gösterilmemiştir.
- Surrogate model hedef karar davranışını yeterince temsil edemezse influence sıralamasının kalitesi düşebilir.
Kaynak ve Yöntem Notu
Özgün başlık: Decision-Boundary Aware Undersampling via Adversarial Influence for Imbalanced Software Defect Prediction
Yazarlar: Shuo Feng, Rongping Li, Jacky Keung, Xiao Yu, Yucheng Shi, Mingliang Xu.
Corresponding author: Yucheng Shi.
Kurumlar: School of Computer Science and Artificial Intelligence, Zhengzhou University; Department of Computer Science, City University of Hong Kong; State Key Laboratory of Blockchain and Data Security, Zhejiang University.
Kaynak türü: Yazılım mühendisliği ve makine öğrenmesi alanında deneysel araştırma preprinti.
Platform: SSRN.
SSRN Abstract ID: 6963912.
DOI: 10.2139/ssrn.6963912.
SSRN yayın tarihi: 18 Haziran 2026.
Hakemlik durumu: Kaynak PDF açıkça hakem değerlendirmesinden geçmemiş preprint olduğunu belirtmektedir.
Telif/lisans yaklaşımı: Çalışma Haziran 2026'da SSRN'ye yüklenmiştir. SSRN'nin daha sonra yayımladığı lisans açıklaması, açık lisans seçeneği getirilmeden önce varsayılan korumanın all-rights-reserved olduğunu belirtmektedir. Kaynak üzerinde açık bir CC lisansı gösterilmediği için Verianla metni korumacı yeniden-kullanım yaklaşımıyla hazırlanmış; kaynak cümleleri ve özgün figür düzenleri yeniden yayımlanmamıştır.
Veri: 18 kamuya açık software defect prediction veri kümesi; AEEEM, NASA, PROMISE ve SOFTLAB.
Sınıflandırıcılar: KNN, Random Forest, Decision Tree, Logistic Regression, Naive Bayes.
Baseline yöntemleri: UFIDSF, SB-GAN, Cluster, Random Undersampling, Borderline-SMOTE ve SMOTE.
Değerlendirme: Stratified 5-fold cross-validation, 10 tekrarlı deney, MCC, AUC, Balance, PD ve PF.
İstatistik: Wilcoxon signed-rank testi, Cliff's delta ve Win/Draw/Loss analizi.
Ana yöntemsel sınır: Adversarial Influence, surrogate üzerinden oluşturulan perturbasyonların target classifier tahmininde oluşturduğu değişime dayanır. Bu nedenle surrogate-target karar fonksiyonu uyumu yöntemin temel varsayımlarından biridir.
Görsel yeniden inşa: Çok uygundur. Tamamen özgün bir Verianla şemasıyla dengesiz feature-space, K-Means temsilcileri, karar sınırı, adversarial perturbasyon okları, influence ranking ve dengeli son veri kümesi gösterilebilir.
Verianla Live / Live Figure: Uygundur. Örneklerin karar uzayında nasıl azaltıldığı ve yalnız yüksek-influence çoğunluk örneklerinin nasıl korunduğu sabit bir kavramsal veri seti üzerinde animasyonla anlatılabilir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir