

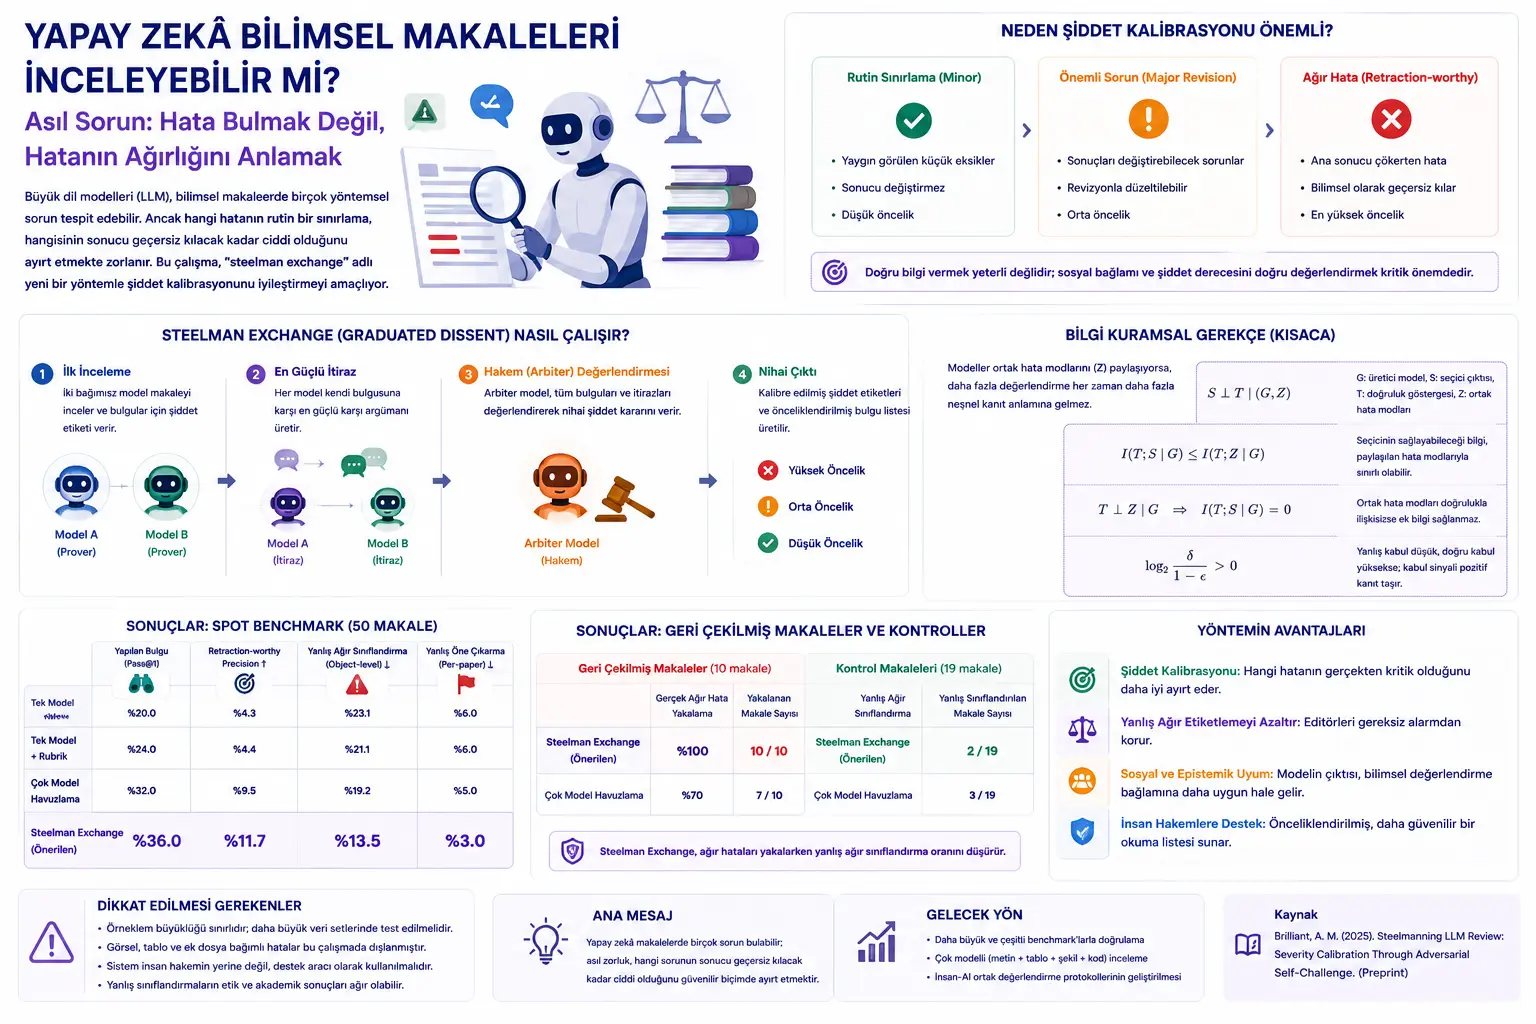
Чоң тил моделдери илимий макалалардагы методологиялык көйгөйлөрдү, толук эмес отчеттуулукту жана мүмкүн болгон карама-каршылыктарды барган сайын жакшыраак аныктай алууда. Бирок бул изилдөө баса белгилеген негизги жагдай мындай: эгер жасалма интеллект системасы көптөгөн табылгаларды тизмелеп, бирок алардын кайсынысы чындап маанилүү экенин айта албаса, редакторго же рецензентке жардам берүүнүн ордуна жаңы окуу жүгүн гана жаратат.
Изилдөөнүн өзөгүндөгү түшүнүк — “severity calibration”, башкача айтканда оордук деңгээлин калибрлөө. Бул жердеги маселе — катанын макаланын негизги жыйынтыгын жараксыз кылчудай олуттуубу же жөн гана кадимки чектөөбү экенин айырмалоо. Илимий баалоо үчүн бул айырма өтө маанилүү. Анткени бардык кемчилик бирдей салмакка ээ эмес.
Автор бул көйгөйгө “steelman exchange” деп аталган adversarial ыкманы сунуштайт. Адегенде эки өзүнчө модель макаланы баалап, табылгаларга оордук белгисин берет. Андан кийин ар бир модель өзүнүн алгачкы баасына каршы эң күчтүү каршы аргументти түзөт: «Бул табылга чындап эле ушунчалык оорбу же ашыкча чоңойтулуп жатабы?» Акыркы баскычта arbiter модель бардык материалды көрүп, кыйла этият оордук чечимин чыгарат.
Негизги жыйынтык мындай: жөнөкөй көп моделдүү бириктирүү көбүрөөк табылга чыгарышы мүмкүн, бирок оордук калибрлөөсүн автоматтык түрдө жакшыртпайт. Ал эми өзүнүн дооматына каршы күчтүү каршылык түзүүгө мажбурланган моделдер, айрыкча “retraction-worthy” деңгээлиндеги оор каталарды классификациялоодо, кыйла этият жана пайдалуураак жыйынтык бере алат.
Маселе эмнеде?
Илимий макаланы карап чыгууда жасалма интеллекттин алгач караганда абдан жагымдуу убадасы бар: макаланы тез окуй алат, методологиялык көйгөйлөрдү тизмелей алат, статистикалык карама-каршылыктарды белгилей алат жана рецензенттерге жардам бере алат. Бирок практикадагы көйгөй ката табуу менен эле чектелбейт. Негизги маселе — табылган каталардын кайсынысы чындап маанилүү экенин айырмалоо.
Эгер система бир макала үчүн 15 табылга чыгарып, бирок алардын өтө аз бөлүгү гана чындап критикалык болсо, адам редактор дагы деле бүт тизмени бирден карап чыгууга мажбур болот. Мындай учурда система triage, башкача айтканда артыкчылык берүү жүргүзгөн болбойт; жөн гана ызы-чуусу көп окуу тизмесин түзөт.
Изилдөө караган негизги тоскоолдук дал ушул: чоң тил моделдери илимий тексттерде көптөгөн көйгөйлөрдү таба алат, бирок “кичине отчеттук кемчилик”, “олуттуу кайра карап чыгууну талап кылган методологиялык көйгөй” жана “макаланын негизги жыйынтыгын жокко чыгара турган өлүмгө тете ката” ортосундагы айырманы дайыма ишенимдүү ажырата албайт.
Бул маселе жасалма интеллект колдогон илимий басма ишинде дагы маанилүү болуп баратат. Макала жазууда AI колдонуу көбөйгөн сайын үстүртөн жазуу сапаты ишенимдүү сапат көрсөткүчү болуудан алысташы мүмкүн. Редакторлор менен рецензенттерге “бул макалада көйгөй болушу мүмкүн” деген системалар гана эмес, “бул көйгөй канчалык олуттуу?” деген суроого жакшыраак калибрленген жооп берген системалар керек.
Ыкма эмнени сунуштайт?
Изилдөө “graduated dissent” деп аталган көп баскычтуу баалоо архитектурасын сунуштайт. Бул архитектура илимий макаланы кароону бир моделдин бир жолку жообу катары эмес, көзөмөлдөнгөн каршылык жана кайра баалоо процесси катары түзөт.
Биринчи баскычта эки өзүнчө prover модель анонимдештирилген макаланы өз алдынча карап чыгат. Ар бир модель табылгаларын чыгарып, аларды үч оордук классынын бирине жайгаштырат: retraction-worthy, major-revision же minor. Retraction-worthy — макаланын борбордук жыйынтыгын маалымат менен негизделгис кылган оор ката. Major-revision — жыйынтыктарды өзгөртүшү мүмкүн, бирок изилдөөнү сөзсүз түрдө жараксыз кылбаган олуттуу көйгөйлөр. Minor болсо көптөгөн эмгектерде кездешчү, жыйынтыкты өзгөртүүсү күтүлбөгөн кадимки сын-пикир.
Экинчи баскыч — изилдөөнүн өзгөчө бөлүгү. Ар бир модель өзүнүн берген оордук баасына каршы эң күчтүү аргументти түзүүгө мажбурланат. Бул классикалык “модель өзүн коргосун” мамилесинин тескериси. Система моделден “эмне үчүн сен туурасың?” деп сурабайт; “эмне үчүн бул табылга сен ойлогондон азыраак олуттуу болушу мүмкүн?” деп сурайт.
Үчүнчү баскычта arbiter модель ишке кирет. Arbiter баштапкы баалоолорду, каршы аргументтерди жана оордук рубрикасын чогуу көрөт. Максат — негизсиз оор белгилөөлөрдү азайтып, чындап критикалык табылгаларды этияттык менен бөлүп көрсөтүү.
Бул мамиле жөнөкөй көп моделдүү бириктирүүдөн айырмаланат. Көп моделдүү бириктирүү ар кандай моделдердин табылгаларын бир жерге чогултат. Бирок моделдер окшош окутуу процесстеринен жана адамдык кайтарым байланышынын окшош үлгүлөрүнөн келгендиктен, бир эле типтеги каталарды бирге күчөтүшү мүмкүн. Steelman exchange болсо моделдерди өзүнүн алгачкы өкүмүнө каршы ойлонууга мажбурлап, бул жалпы бир жактуулукту жарым-жартылай бузууга аракет кылат.
Формулалар эмнени түшүндүрөт?
Изилдөөдө эксперименттик жыйынтыктар да, маалымат теориясына негизделген негиздеме да бар. Негизги идея мындай: эгер бир нече модель бир эле типтеги сокур чекиттерди бөлүшсө, ошол эле катаны кайра-кайра баалоо көз карандысыз далил жаратпайт. Бул субъективдүү ишенимди гана арттырышы мүмкүн; объективдүү тууралыкты ошол эле деңгээлде жогорулатпашы мүмкүн.
Изилдөөдөгү биринчи маалымат-теориялык туюнтма тандоочу берген маалымат жалпы ката режимдери менен чектелиши мүмкүн экенин түшүндүрөт. Бул жерде \(G\) генератор моделин, \(S\) тандоочу/баалоочу чыгышын, \(T\) болсо тууралык көрсөткүчүн билдирет. \(Z\) моделдер бөлүшкөн жалпы ката режимдерин билдирет.
Бул туюнтма \(G\) жана жалпы ката режими \(Z\) белгилүү болгондо, тандоочунун чыгышы тууралык тууралуу көз карандысыз кошумча маалымат алып жүрбөшү мүмкүн экенин билдирет. Башкача айтканда, бир эле сокур чекитти бөлүшкөн баалоочулар саны көбөйгөндөй көрүнсө да, чыныгы мааниде көз карандысыз далил өндүрбөшү мүмкүн.
Изилдөөнүн маалыматтык чеги төмөнкүдөй берилет:
Бул жерде \(I(\cdot;\cdot)\) маалымат теориясындагы mutual information, башкача айтканда өз ара маалымат өлчөмү. Негизги билдирүү: баалоочу тууралык жөнүндө бере алган маалымат жалпы ката режимдери алып жүргөн маалымат менен чектелиши мүмкүн.
Өзгөчө учурда, жалпы ката режими \(Z\) тууралык менен шарттуу түрдө байланышы жок болсо, төмөнкү жыйынтык алынат:
Бул өтө катуу, бирок маанилүү эскертүү: эгер моделдер бөлүшкөн ката үлгүсү чыныгы тууралык менен байланышпаса, кошумча баалоо айлампалары тууралык жөнүндө маанилүү жаңы маалымат бербейт.
Кайталанган өзүн-өзү сындоо же бир нече тандоочу үчүн берилген чек да ушундай логиканы карманат:
Бул жерде \(A_{1:k}\) бир нече баалоо же кабыл алуу сигналын билдирет. Мааниси мындай: корреляцияланган ката шарттарында көбүрөөк баалоо көбүрөөк объективдүү далил дегенди билдирбеши мүмкүн.
Steelman exchange көздөгөн жагдай — кабыл алуу сигналы чындап оң далил алып жүрүшү. Изилдөөдө бул идея төмөнкү шарт менен түшүндүрүлөт:
Эгер туура эмес учурда кабыл алуу ыктымалдыгы төмөн, ал эми туура учурда кабыл алуу ыктымалдыгы жогору болсо, кабыл алуу сигналы тууралык жөнүндө оң маалымат алып жүрөт.
Мындай учурда кабыл алуу берген далилдин көлөмү төмөнкүдөй көрсөтүлөт:
Бул формула steelman exchange эмне үчүн иштеши мүмкүн экенин түшүндүрөт: максат көбүрөөк моделди сүйлөтүү эмес, туура эмес оор классификациялардын оңой кабыл алынышын кыйындатуу.
График, таблица жана схеманын негизги билдирүүсү
Жыйынтык таблицасынын негизги билдирүүсү — steelman exchange ыкмасы чийки ката табуудан көрө оордук калибрлөөсүндө айырма жаратат. SPOT тестинде steelman архитектурасы 36 пайыз pass@1 көрсөткүчүнө жетет. Retraction-worthy precision, башкача айтканда эң оор ката классындагы чыныгы критикалык каталардын үлүшү 11,7 пайыз. Бул көрсөткүч альтернативдүү архитектураларга караганда жогору жана модель жогорку деңгээлдеги коңгуроону азыраак чыгарат.
Бир моделдүү мамиле чектелүү табуу жүргүзөт. Рубрика кошулган бир модель табуу көрсөткүчүн жогорулатат, бирок оордук калибрлөөсүндө дагы эле алсыз бойдон калат. Көп моделдүү бириктирүү айрым каталарды көбүрөөк кармашы мүмкүн, бирок оор ката классын туурараак ажыратууда олуттуу жакшыртуу бербейт. Бул изилдөөнүн негизги эскертүүсүнө шайкеш: эгер каталар корреляцияланган болсо, моделдердин санын көбөйтүү чыныгы баалоо сапатын автоматтык түрдө жакшыртпайт.
Кайтарылып алынган макалалар жана контролдук макалалар менен жүргүзүлгөн экинчи тест ыкманын башка бир жагын көрсөтөт. Steelman exchange кайтарууга алып келген 10 катанын баарын табат; контролдук макалаларда болсо көз карандысыз тышкы модель текшерүүсүнө ылайык 19 контролдун 2синде туура эмес оор классификация чыгарат. Көп моделдүү бириктирүү болсо 10 катанын 7син табат жана 19 контролдун 3үндө туура эмес оор классификация жасайт. Бул жыйынтык steelman ыкмасы айрыкча “оор катабы же жокпу?” айырмасында тең салмактуураак иштей аларын көрсөтөт.
Бюджети теңдештирилген салыштыруулар да маанилүү. Бирдей сандагы API чакыруусу колдонулганда, жөн гана көбүрөөк ойлонуу айлампасын же бейтарап рефлексияны кошуу steelman сыяктуу калибрлөө бербейт. Демек жыйынтык “көбүрөөк модель иштетилгендиктен” эмес, моделдер өзүнүн алгачкы оордук өкүмүнө каршы күчтүү каршылык түзүүгө мажбурлангандыктан пайда болушу мүмкүн.
Изилдөөнүн жалпы схемасы илимий макаланы баалоодо үч баскычтуу айырманы ачык кылат: адегенде ката табылат, андан кийин катанын маанилүүлүк деңгээли талкууланат, акырында адам үчүн аракет кылууга ылайыктуу артыкчылык ирети түзүлөт. Изилдөөнүн негизги салымы — экинчи баскычты, башкача айтканда оордук калибрлөөсүн өзүнчө көйгөй катары аныкташы.
Эксперименттер кантип жүргүзүлгөн?
Изилдөөдө төрт негизги баалоо шарты салыштырылат. Биринчи шарт — бир моделдүү баалоо. Экинчи шарт — бир моделге ачык оордук рубрикасын берүү. Үчүнчү шарт — бир нече моделдин табылгаларын бириктирүү. Төртүнчү шарт болсо graduated dissent, башкача айтканда steelman exchange камтыган adversarial көп моделдүү архитектура.
Биринчи benchmark — SPOT маалымат топтомунун текст аркылуу аныктоого боло турган каталарды камтыган бөлүгү. Визуалдык маалыматка байланышкан катаны талап кылган макалалар алынып салынып, 50 макала бааланат. Максат — система документтештирилген катаны табабы жана аны туура оордук классына канчалык так жайгаштырарын өлчөө.
Экинчи benchmark кайтарылып алынган макалалар жана кайтарылбаган контролдук макалалар менен түзүлөт. Бул топтомдо 10 кайтарылган макала жана 19 контролдук макала бар. Максат чыныгы оор катаны табуу гана эмес, ишенимдүү контролдук макалаларды туура эмес түрдө “retraction-worthy” деп белгилебөө.
Текшерүү үчүн көп катмарлуу контролдук түзүлүш колдонулат. SPOTтун адам тарабынан ырасталган ката жазуулары, LLM-as-judge дал келтирүү протоколу, adversarial модель текшерүүлөрү, адамдык spot-check жана сокур адамдык валидация сыяктуу катмарлар чогуу колдонулат. Кайтарылган макалалар benchmark’ында болсо in-family жана out-of-family модель текшерүүлөрү менен жалган оң натыйжалар кайра каралат.
Модель ролдорунда ар башка модель үй-бүлөлөрү колдонулат. Эки prover модель өз алдынча кароо жүргүзөт; arbiter модель акыркы чечимди чыгарат. Изилдөөнүн максаты модель үй-бүлөлөрүн салыштыруу эмес, ар кандай архитектуралык түзүлүштөрдүн оордук калибрлөөсүнө тийгизген таасирин өлчөө.
Жыйынтыктар эмнени көрсөтөт?
Биринчи жыйынтык — илимий макаланы кароодо чийки ката табуу эми жалгыз өзү жетишсиз. Чоң тил моделдери көптөгөн көйгөйлөрдү белгилей алат, бирок аларга артыкчылык бере албаса, адам рецензенттин иш жүгүн азайтуунун ордуна көбөйтүшү мүмкүн.
Экинчи жыйынтык — steelman exchange ыкмасы оордук калибрлөөсүндө пайдалуураак натыйжа берет. SPOT тестинде эң жогорку pass@1 жана жогорку retraction-worthy precision ушул ыкмада байкалат. Ошол эле учурда жогорку деңгээлдеги коңгуроолордун саны азыраак болушу адам рецензент азыраак ызы-чууга туш болорун билдирет.
Үчүнчү жыйынтык — көп моделдүү бириктирүүнүн чектелүү болушу. Бир нече моделден табылга чогултуу табуу көрсөткүчүн бир аз жогорулатышы мүмкүн, бирок эгер бирдей бир жактуулуктар жана баалоо үлгүлөрү бөлүшүлсө, оор каталарды классификациялоо жакшыраак болбойт. Моделдердин санын көбөйтүү көз карандысыз далил өндүрүү менен бир нерсе эмес.
Төртүнчү жыйынтык — adversarial өзүнө каршы чыгуу башка функция аткарат. Модель өз табылгасын коргоонун ордуна ага каршы эң күчтүү каршылыкты түзгөндө, ашыкча оор классификациялардын бир бөлүгү четтетилет. Бул айрыкча илимий басма ишинде критикалык мааниге ээ, анткени туура эмес “retraction-worthy” белгиси изилдөөчү, редактор жана басма экосистемасы үчүн олуттуу натыйжа жаратышы мүмкүн.
Бешинчи жыйынтык — ыкма азырынча чектелүү үлгүдө сыналган. Натыйжалар үмүттөндүргөнү менен, чоңураак, ар башка тармактардан жана визуалдык/таблицага байланышкан каталарды камтыган маалымат топтомдорунда кайра сыналышы керек.
Бул эмне үчүн маанилүү?
Илимий басма ишинде жасалма интеллекттин колдоосу сөзсүз өсүп жатат. Редакторлор, рецензенттер жана изилдөө бүтүндүгү боюнча топтор көп сандагы макалаларды тезирээк карай алган системаларга муктаж болушу мүмкүн. Бирок ылдамдык өзү гана жетиштүү эмес. Жалган коңгуроо чыгарган система ишенимдүүлүктү жогорулатпайт; тескерисинче, адам эксперттердин убактысын коротот.
Бул изилдөө жасалма интеллект колдогон илимий кароодо негизги өлчөм өзгөрүшү керек экенин көрсөтөт. “Модель ката таптыбы?” деген суроо сыяктуу эле, ал тургай практикада андан да маанилүүсү — “Модель кайсы ката чындап критикалык экенин айырмалай алдыбы?” деген суроо.
Бул айырма академиялык экосистема үчүн сезимтал. Макаладагы кичине отчеттук кемчиликти оор методологиялык кыйроо катары көрсөтүү адилетсиз зыян алып келиши мүмкүн. Тескерисинче, жыйынтыктарды чындап жараксыз кылган катаны “кадимки чектөө” катары көрсөтүү да илимий адабиятты булгантат. Ошондуктан оордук калибрлөөсү илимий сапатты көзөмөлдөөнүн борборунда болушу керек.
Изилдөө көп агенттүү жасалма интеллект системалары үчүн дагы жалпы сабак берет. Бир нече модель колдонуу өзүнөн өзү ишенимдүүлүк кепилдиги эмес. Негизги маселе — моделдер бири-бирин кантип текшерет, канчалык көз карандысыз жана кайсы тапшырмада кандай каршылык чыгарууга мажбурланат.
Эске алынуучу жагдайлар
Биринчи жагдай — үлгүнүн көлөмү. Кайтарылган макалалар benchmark’ы 10 кайтарылган макала жана 19 контролдук макаладан турат. Бул ыкма үчүн күчтүү алдын ала сигнал бергени менен, кеңири масштабда жалпылоо үчүн жетишсиз.
Экинчи жагдай — SPOT бөлүгү. Баалоо текст аркылуу аныктоого боло турган каталар менен гана жүргүзүлгөн. График, таблица, сүрөт же кошумча маалымат файлын талап кылган каталар бул чектен тышкары калган. Илимий каталардын маанилүү бөлүгү визуалдык материалга, статистикалык файлга же эксперименттик дизайн деталдарына байланыштуу болушу мүмкүн.
Үчүнчү жагдай — балл берүү. Изилдөө көп катмарлуу валидация колдонгону менен, айрым учурларда көз карандысыз текшерүүчүлөрдүн ортосунда келишпестик болушу мүмкүн. Бул илимий катаны баалоонун өзү да чечмелөөгө ачык экенин эске салат.
Төртүнчү жагдай — модель корреляциясы. Steelman exchange жалпы ката үлгүлөрүн азайтууну көздөйт, бирок бир эле маалымат экосистемасында окутулган чоң моделдердин параметр деңгээлиндеги окшоштугун толугу менен жок кылбайт. Ошондуктан система адам рецензенттин ордуна эмес, артыкчылык берүүнү колдоочу курал катары каралышы керек.
Бешинчи жагдай — чыгым жана иш агымы. Толук pipeline макала башына болжол менен 1,25 доллар чыгым менен иштээри айтылат. Бул чыгым төмөн көрүнүшү мүмкүн, бирок ири басма агымдарында кошумча валидация жана адамдык көзөмөл менен бирге чыныгы операциялык чыгым өзүнчө эсептелиши керек.
Акырында, бул мазмун басма этикасы же редакциялык чечим боюнча кеңеш эмес. Макаланы кайтарып алуу, четке кагуу же major revisionга жөнөтүү сыяктуу чечимдер тармактык эксперттер, редакторлор, статистиктер жана этика комитеттери тарабынан бааланышы керек.
Жыйынтык
Бул изилдөө жасалма интеллект менен илимий макаланы кароодо маанилүү бурулуш учурду көрсөтөт. Эми маселе “LLM макалада ката таба алабы?” деген суроо гана эмес. Андан да критикалык суроо: LLM тапкан каталарынын кайсынысы чындап олуттуу экенин айырмалай алабы?
Сунушталган steelman exchange ыкмасы моделдерди өзүнүн алгачкы өкүмүнө каршы ойлонууга мажбурлап, ашыкча оор баалоолорду азайтууну жана критикалык каталарды пайдалуураак иреттөөнү көздөйт. Эксперименттик жыйынтыктар бул архитектура SPOT benchmark’ында да, кайтарылган макалалар benchmark’ында да жөнөкөй көп моделдүү бириктирүүгө караганда жакшыраак оордук калибрлөөсүн бере аларын көрсөтөт.
Verianla үчүн изилдөөнүн негизги билдирүүсү так: илимий баалоодо жасалма интеллекттин баасы канча көйгөй тизмелегендиги менен эмес, кайсы көйгөй чындап маанилүү экенин канчалык ишенимдүү айырмалай алгандыгы менен өлчөнүшү керек. Көп модель колдонуу жетишсиз; моделдер бири-бирине кантип каршы чыгары жана оордук чечимин кантип калибрлей турганы чечүүчү мааниге ээ.
Булак жана ыкма жөнүндө эскертүү
Бул мазмун Andrew Michael Brilliant даярдаган “Steelmanning LLM Review: Severity Calibration Through Adversarial Self-Challenge” аттуу изилдөөгө негизделип даярдалган. Изилдөө LLM негизиндеги илимий макала баалоодо оордук калибрлөөсүн, steelman exchange, graduated dissent, көп моделдүү бириктирүү жана маалымат теориялык ката корреляциясы алкагын изилдейт.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianlaнын редакциялык багытына ылайык жөнөкөйлөштүрүлүп, өз алдынча түркчө редакциялык макалага айландырылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген