

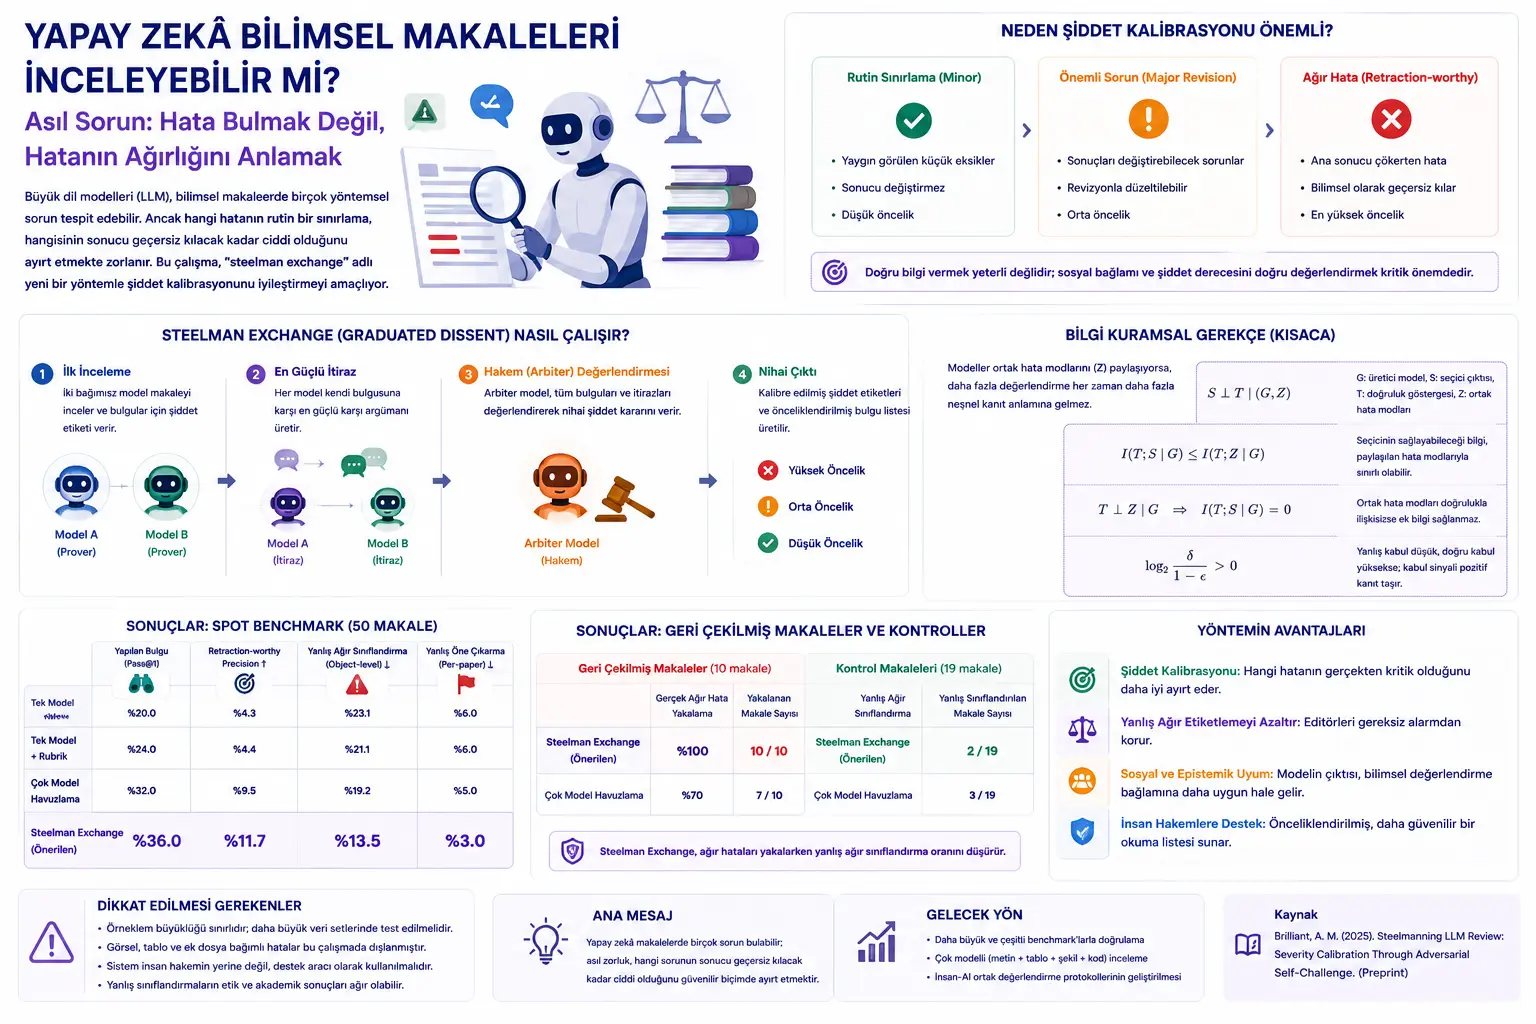
Böyük dil modelləri elmi məqalələrdə metodoloji problemləri, natamam hesabatları və mümkün uyğunsuzluqları getdikcə daha yaxşı aşkar edə bilir. Lakin bu tədqiqatın vurğuladığı kritik məqam budur: Süni intellekt sistemi çoxsaylı tapıntılar sadalayır, amma hansının həqiqətən vacib olduğunu deyə bilmirsə, redaktora və ya rəyçiyə kömək etmək əvəzinə yalnız yeni oxu yükü yaradır.
Tədqiqatın mərkəzindəki anlayış “severity calibration”, yəni ağırlıq kalibrlənməsidir. Buradakı problem səhvin məqalənin əsas nəticəsini etibarsız edəcək qədər ciddi olub-olmadığını, yoxsa yalnız rutin məhdudiyyət olduğunu ayırd etməkdir. Elmi qiymətləndirmə baxımından bu fərq həyati əhəmiyyət daşıyır. Çünki hər qüsur eyni ağırlıqda deyil.
Müəllif bu problem üçün “steelman exchange” adlı adversarial üsul təklif edir. İki ayrı model əvvəlcə məqaləni qiymətləndirir və tapıntılara ağırlıq etiketi verir. Sonra hər model öz ilkin qiymətləndirməsinə qarşı ən güclü əks arqumenti yaradır: “Görəsən bu tapıntı həqiqətən bu qədər ciddidir, yoxsa həddindən artıq şişirdilib?” Son mərhələdə arbiter model bütün materialı görür və daha mühafizəkar ağırlıq qərarı verir.
Əsas nəticə budur: Sadə çoxmodel havuzlama daha çox tapıntı çıxara bilər; lakin ağırlıq kalibrlənməsini avtomatik yaxşılaşdırmır. Bunun əksinə, öz iddiasına qarşı güclü etiraz yaratmağa məcbur edilən modellər, xüsusilə “geri çəkilməyə layiq” səviyyədə ağır səhv təsnifatında daha diqqətli və daha faydalı nəticələr yarada bilər.
Problem Nədir?
Elmi məqalə rəyində süni intellektin ilk baxışda çox cəlbedici vədi var: Məqaləni sürətlə oxuya, metodoloji problemləri sadalaya, statistik uyğunsuzluqları işarələyə və rəyçilərə kömək edə bilər. Lakin praktikada ortaya çıxan problem yalnız səhv tapmaq deyil. Əsas problem tapılan səhvlərdən hansının həqiqətən vacib olduğunu ayırd etməkdir.
Sistem bir məqalə üçün 15 tapıntı yaradır, amma bunların çox kiçik hissəsi həqiqətən kritikdirsə, insan redaktor hələ də bütün siyahını bir-bir qiymətləndirməli olur. Bu halda sistem triage, yəni prioritetləndirmə etməmiş olur; yalnız yüksək səs-küylü oxu siyahısı yaratmış olur.
Tədqiqatın nəzərdən keçirdiyi əsas darboğaz budur: Böyük dil modelləri elmi mətnlərdə çoxsaylı problemlər tapa bilər; lakin “kiçik hesabat çatışmazlığı”, “əhəmiyyətli reviziya tələb edən metodoloji problem” və “məqalənin əsas nəticəsini çökdürəcək ölümcül səhv” arasındakı fərqi həmişə etibarlı şəkildə ayıra bilmir.
Bu problem süni intellekt dəstəkli elmi nəşriyyatda daha da vacib olur. Məqalə yazımında AI istifadəsi artdıqca səthi yazı keyfiyyəti artıq etibarlı keyfiyyət göstəricisi olmaqdan uzaqlaşa bilər. Redaktorların və rəyçilərin ehtiyacı yalnız “bu məqalədə problem ola bilər” deyən sistemlər deyil; “bu problem nə qədər ciddidir?” sualına daha kalibrlənmiş cavab verən sistemlərdir.
Metod Nə Təklif Edir?
Tədqiqat “graduated dissent” adlanan çoxmərhələli qiymətləndirmə arxitekturası təklif edir. Bu arxitektura elmi məqalə rəyini tək modelin bir dəfəlik çıxışı kimi deyil, idarə olunan etiraz və yenidən qiymətləndirmə prosesi kimi dizayn edir.
İlk mərhələdə iki ayrı prover model anonimləşdirilmiş məqaləni müstəqil şəkildə yoxlayır. Hər model tapıntılarını yaradır və bu tapıntıları üç ağırlıq sinfindən birinə yerləşdirir: retraction-worthy, major-revision və ya minor. Retraction-worthy məqalənin mərkəzi nəticəsini verilənlərlə dəstəklənməz hala gətirən ağır səhv deməkdir. Major-revision nəticələri dəyişə biləcək, lakin işi qəti şəkildə çökdürməyən ciddi problemləri ifadə edir. Minor isə bir çox nəşrdə görülə bilən, nəticəni dəyişdirməsi gözlənilməyən rutin iraddır.
İkinci mərhələ tədqiqatın orijinal hissəsidir. Modellərin hər biri öz verdiyi ağırlıq balına qarşı ən güclü arqumenti qurmağa məcbur edilir. Bu, klassik “model özünü müdafiə etsin” yanaşmasının əksidir. Sistem modeldən “niyə haqlısan?” soruşmur; “niyə bu tapıntı düşündüyündən daha az ciddi ola bilər?” deyə soruşur.
Üçüncü mərhələdə arbiter model işə düşür. Arbiter ilkin qiymətləndirmələri, əks arqumentləri və ağırlıq rubrikasını birlikdə görür. Məqsəd lazımsız dərəcədə ağır etiketləməni azaltmaq və həqiqətən kritik tapıntıları daha diqqətlə ayırmaqdır.
Bu yanaşma sadə çoxmodel havuzlamadan fərqlənir. Çoxmodel havuzlama müxtəlif modellərin tapıntılarını bir araya gətirir. Lakin modellər oxşar təlim proseslərindən və oxşar insan geribildirimi nümunələrindən gəldiyinə görə eyni tip səhvləri birlikdə böyüdə bilər. Steelman exchange isə modelləri öz ilkin mühakimələrinə qarşı düşünməyə məcbur edərək bu ortaq qərəzi qismən sındırmağı hədəfləyir.
Formullar Nəyi İzah Edir?
Tədqiqatda həm eksperimental nəticələr, həm də informasiya nəzəri əsaslandırma var. Əsas fikir budur: Əgər bir neçə model eyni növ kor nöqtələri paylaşırsa, eyni səhvi təkrar-təkrar qiymətləndirmələri müstəqil sübut yaratmır. Bu yalnız subyektiv əminliyi artıra bilər; obyektiv doğruluğu eyni dərəcədə artırmaya bilər.
Tədqiqatdakı ilk informasiya nəzəri ifadə seçicinin verdiyi məlumatın paylaşılan səhv rejimləri ilə məhdud ola biləcəyini izah edir. Burada \(G\) generator modeli, \(S\) seçici/qiymətləndirici çıxışını, \(T\) isə doğruluq göstəricisini təmsil edir. \(Z\), modellərin paylaşdığı ortaq səhv rejimlərini ifadə edir.
Bu ifadə \(G\) və ortaq səhv rejimi \(Z\) məlum olduqda seçicinin çıxışının doğruluq barədə müstəqil əlavə informasiya daşımaya biləcəyini göstərir. Yəni eyni kor nöqtəni paylaşan qiymətləndiricilər sayca artsa belə, həqiqi mənada müstəqil sübut yaratmaya bilər.
Tədqiqatın informasiya sərhədi belə verilir:
Burada \(I(\cdot;\cdot)\), informasiya nəzəriyyəsində mutual information, yəni qarşılıqlı informasiya ölçüsüdür. Əsas mesaj budur: Qiymətləndiricinin doğruluq barədə təmin edə biləcəyi informasiya paylaşılan səhv rejimlərinin daşıdığı informasiya ilə məhdud qala bilər.
Xüsusi halda ortaq səhv rejimi \(Z\) doğruluqla şərti olaraq əlaqəsizdirsə aşağıdakı nəticə alınır:
Bu çox sərt, lakin vacib xəbərdarlıqdır: Əgər modellərin paylaşdığı səhv nümunəsi həqiqi doğruluqla əlaqəli deyilsə, əlavə qiymətləndirmə turları doğruluq barədə mənalı yeni informasiya vermir.
Təkrarlanan özünütənqid və ya çoxlu seçici üçün verilən sərhəd də oxşar məntiqi izləyir:
Burada \(A_{1:k}\), bir neçə qiymətləndirmə və ya qəbul siqnalını təmsil edir. Şərh budur: Korrelyasiyalı səhv şəraitində daha çox qiymətləndirmə daha çox obyektiv sübut demək olmaya bilər.
Steelman exchange-in hədəflədiyi vəziyyət isə qəbul siqnalının həqiqətən müsbət sübut daşımasıdır. Tədqiqatda bu fikir aşağıdakı şərtlə izah edilir:
Əgər yanlış vəziyyətdə qəbul ehtimalı aşağı, doğru vəziyyətdə qəbul ehtimalı yüksəkdirsə, qəbul siqnalı doğruluq barədə müsbət informasiya daşıyır.
Bu halda qəbulun verdiyi sübut miqdarı belə ifadə olunur:
Bu formul steelman exchange-in niyə işləyə biləcəyini izah edir: Məqsəd daha çox modeli danışdırmaq deyil, yanlış ağır təsnifatların asanlıqla qəbul edilməsini çətinləşdirməkdir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Nəticə cədvəlinin əsas mesajı steelman exchange üsulunun xam səhv aşkarlanmasından çox ağırlıq kalibrlənməsində fərq yaratmasıdır. SPOT testində steelman arxitekturası yüzdə 36 pass@1 dəyərinə çatır. Retraction-worthy precision, yəni ən ağır səhv sinfində həqiqi kritik səhv nisbəti yüzdə 11,7-dir. Bu nisbət alternativ arxitekturalardan daha yüksəkdir və model daha az yuxarı səviyyəli siqnal yaradır.
Təkmodel yanaşması daha məhdud aşkarlama aparır. Rubrika əlavə edilən tək model aşkarlama nisbətini artırır, lakin ağırlıq kalibrlənməsində hələ də zəif qalır. Çoxmodel havuzlama isə bəzi səhvləri daha çox tuta bilər; lakin ağır səhv sinfini daha düzgün ayırmaqda nəzərəçarpacaq yaxşılaşma yaratmır. Bu, tədqiqatın əsas xəbərdarlığı ilə uyğundur: Model sayını artırmaq, səhvlər korrelyasiyalıdırsa, real mühakimə keyfiyyətini avtomatik artırmır.
Geri çəkilmiş məqalələr və nəzarət məqalələri ilə aparılan ikinci test üsulun başqa tərəfini göstərir. Steelman exchange geri çəkilməyə səbəb olan 10 səhvin hamısını tutur; nəzarət məqalələrində isə müstəqil xarici model yoxlamasına görə 19 nəzarətdən 2-sində yanlış ağır təsnifat yaradır. Çoxmodel havuzlama isə 10 səhvdən 7-sini tutur və 19 nəzarətdən 3-də yanlış ağır təsnifat verir. Bu nəticə steelman üsulunun xüsusilə “ağır səhvdir, yoxsa deyil?” ayrımında daha balanslı işləyə biləcəyini düşündürür.
Büdcə uyğunlaşdırılmış müqayisələr də vacibdir. Eyni sayda API çağırışı istifadə edildikdə yalnız daha çox düşünmə turu və ya tərəfsiz refleksiya etmək steelman qədər kalibrlənmə təmin etmir. Yəni nəticə “daha çox model işlədildiyi üçün” deyil; modellərin öz ilkin ağırlıq mühakimələrinə qarşı güclü etiraz yaratmağa məcbur edilməsi səbəbilə ortaya çıxmış ola bilər.
Tədqiqatın ümumi sxemi elmi məqalə qiymətləndirməsində üçmərhələli fərqi görünən edir: Əvvəlcə səhv tapılır, sonra səhvin əhəmiyyət dərəcəsi müzakirə olunur, sonda insan üçün hərəkətə çevrilə bilən prioritet sırası yaradılır. Araşdırmanın əsas töhfəsi ikinci mərhələnin, yəni ağırlıq kalibrlənməsinin ayrıca problem kimi müəyyənləşdirilməsidir.
Təcrübələr Necə Aparılıb?
Tədqiqatda dörd əsas qiymətləndirmə şəraiti müqayisə edilir. Birinci şərait təkmodel qiymətləndirməsidir. İkinci şəraitdə tək modelə açıq ağırlıq rubrikası verilir. Üçüncü şərait bir neçə modelin tapıntılarının havuzlanmasıdır. Dördüncü şərait isə graduated dissent, yəni steelman exchange ehtiva edən adversarial çoxmodel arxitekturasıdır.
Birinci benchmark SPOT verilənlər dəstinin mətn üzərindən aşkarlana bilən səhvlər olan alt dəstidir. Vizuala bağlı səhv tələb edən məqalələr xaric edilir və 50 məqalə qiymətləndirilir. Burada məqsəd sistemin sənədləşdirilmiş səhvi tapıb-tapmadığını və onu nə qədər düzgün ağırlıq sinfinə yerləşdirdiyini ölçməkdir.
İkinci benchmark geri çəkilmiş məqalələr və geri çəkilməmiş nəzarət məqalələri ilə qurulur. Bu dəstdə 10 geri çəkilmiş məqalə və 19 nəzarət məqaləsi var. Məqsəd yalnız həqiqi ağır səhvi tutmaq deyil, sağlam nəzarət məqalələrini yanlış şəkildə “geri çəkilməyə layiq” kimi etiketləməməkdir.
Doğrulama üçün çoxqatlı nəzarət strukturu istifadə olunur. SPOT-un insan tərəfindən təsdiqlənmiş səhv qeydləri, LLM-as-judge uyğunlaşdırma protokolu, adversarial model yoxlamaları, insan spot-check və kor insan doğrulaması kimi qatlar birlikdə istifadə edilir. Geri çəkilmiş məqalə benchmark-ında isə in-family və out-of-family model yoxlamaları ilə yanlış pozitivlər yenidən yoxlanılır.
Model rollarında müxtəlif model ailələrindən istifadə olunur. İki prover model müstəqil rəy aparır; arbiter model isə son qərarı verir. Tədqiqatın məqsədi model ailələrini müqayisə etmək deyil, müxtəlif arxitektura dizaynlarının ağırlıq kalibrlənməsinə təsirini ölçməkdir.
Nəticələr Nəyi Göstərir?
İlk nəticə elmi məqalə rəyində xam səhv tapmağın artıq təkbaşına kifayət etməməsidir. Böyük dil modelləri çoxsaylı problemi işarələyə bilər; lakin bu problemləri prioritetləşdirə bilmədikdə insan rəyçinin iş yükünü azaltmaq əvəzinə artıra bilər.
İkinci nəticə steelman exchange üsulunun ağırlıq kalibrlənməsində daha faydalı nəticələr yaratmasıdır. SPOT testində ən yüksək pass@1 dəyəri və daha yüksək retraction-worthy precision bu üsulda görülür. Eyni zamanda yuxarı səviyyəli siqnalların daha az olması insan rəyçinin daha az səs-küylə qarşılaşması deməkdir.
Üçüncü nəticə çoxmodel havuzlamanın məhdud qalmasıdır. Bir neçə modeldən tapıntı toplamaq aşkarlama nisbətini bir qədər artıra bilər; lakin eyni tip qərəzlər və qiymətləndirmə nümunələri paylaşılırsa ağır səhv təsnifatı yaxşılaşmır. Model sayını artırmaq müstəqil sübut yaratmaqla eyni şey deyil.
Dördüncü nəticə adversarial öz-etirazın fərqli funksiya görməsidir. Model öz tapıntısını müdafiə etmək əvəzinə ona qarşı ən güclü etirazı yaratdıqda həddindən artıq ağır təsnifatların bir hissəsi aradan qalxır. Bu, xüsusilə elmi nəşriyyatda kritikdir; çünki yanlış “geri çəkilməyə layiq” etiketi həm tədqiqatçı, həm redaktor, həm də nəşr ekosistemi üçün ciddi nəticələr doğura bilər.
Beşinci nəticə üsulun hələ məhdud nümunə ilə sınaqdan keçirilməsidir. Tapıntılar ümidverici olsa da, daha böyük, müxtəlif sahələrdən və vizual/cədvəl asılı səhvləri də əhatə edən verilənlər dəstlərində yenidən sınaqdan keçirilməlidir.
Bu Niyə Vacibdir?
Elmi nəşriyyatda süni intellekt dəstəyi qaçılmaz şəkildə artır. Redaktorlar, rəyçilər və tədqiqat dürüstlüyü qrupları çoxsaylı məqaləni daha sürətlə yoxlaya bilən sistemlərə ehtiyac duya bilər. Lakin sürət təkbaşına kifayət deyil. Yanlış siqnal yaradan sistem etibarlılıq qazandırmır; əksinə insan ekspertlərin vaxtını sərf edir.
Bu tədqiqat süni intellekt dəstəkli elmi rəy prosesində əsas ölçünün dəyişməli olduğunu göstərir. “Model səhv tapdımı?” sualı qədər, hətta praktikada daha çox, “Model hansı səhvin həqiqətən kritik olduğunu ayıra bildimi?” sualı vacibdir.
Bu fərq akademik ekosistem üçün həssasdır. Məqalədəki kiçik hesabat çatışmazlığını ağır metodoloji çöküş kimi təqdim etmək ədalətsiz zərər yarada bilər. Digər tərəfdən, nəticələri həqiqətən etibarsız edən səhvi “rutin məhdudiyyət” kimi göstərmək də elmi ədəbiyyatı çirkləndirə bilər. Buna görə ağırlıq kalibrlənməsi elmi keyfiyyət nəzarətinin mərkəzində olmalıdır.
Tədqiqat çoxagentli süni intellekt sistemləri üçün daha ümumi dərs də verir. Bir neçə model istifadə etmək təkbaşına etibarlılıq zəmanəti deyil. Əsas məsələ modellərin bir-birini necə yoxlaması, hansı müstəqillik səviyyəsinə malik olması və hansı tapşırıqda hansı növ etiraz yaratmağa məcbur edilməsidir.
Diqqət Edilməli Məqamlar
İlk diqqət nöqtəsi nümunə ölçüsüdür. Geri çəkilmiş məqalə benchmark-ı 10 geri çəkilmiş məqalə və 19 nəzarət məqaləsindən ibarətdir. Bu, üsul üçün güclü ilkin siqnal versə də, genişmiqyaslı ümumiləşdirmə üçün kifayət deyil.
İkinci diqqət nöqtəsi SPOT alt dəstidir. Qiymətləndirmə yalnız mətn üzərindən aşkarlana bilən səhvlərlə aparılıb. Qrafik, cədvəl, görüntü və ya əlavə verilənlər faylı tələb edən səhvlər bu çərçivədən kənarda qalır. Elmi səhvlərin mühüm hissəsi vizual, statistik fayl və ya eksperiment dizaynı detalından asılı ola bilər.
Üçüncü diqqət nöqtəsi ballandırmadır. Tədqiqat çoxqatlı doğrulama istifadə etsə də, bəzi hallarda müstəqil yoxlayıcılar arasında uyğunsuzluq görünə bilər. Bu, elmi səhv qiymətləndirməsinin özünün də şərhə açıq olduğunu xatırladır.
Dördüncü diqqət nöqtəsi model korrelyasiyasıdır. Steelman exchange ortaq səhv nümunələrini azaltmağı hədəfləyir; lakin eyni verilənlər ekosistemində təlim almış böyük modellərin parametr səviyyəsindəki oxşarlıqlarını tam aradan qaldırmır. Buna görə sistem insan rəyçini əvəz edən vasitə kimi deyil, prioritetləndirmə dəstəyi kimi düşünülməlidir.
Beşinci diqqət nöqtəsi xərc və iş axınıdır. Tam pipeline-ın məqalə başına təxminən 1,25 dollar xərc ilə işlədiyi bildirilir. Bu xərc aşağı görünə bilər; lakin böyük nəşr axınlarında əlavə doğrulama və insan nəzarəti ilə birlikdə real əməliyyat xərci ayrıca hesablanmalıdır.
Nəhayət, bu məzmun nəşr etikası və ya redaksiya qərarı tövsiyəsi deyil. Məqalənin geri çəkilməsi, rədd edilməsi və ya major revision-a göndərilməsi kimi qərarlar sahə ekspertləri, redaktorlar, statistiklər və etik komitələr tərəfindən qiymətləndirilməlidir.
Nəticə
Bu tədqiqat süni intellektlə elmi məqalə rəyində mühüm dönüş nöqtəsinə işarə edir. Artıq məsələ yalnız “LLM məqalədə səhv tapa bilərmi?” deyil. Daha kritik sual budur: LLM tapdığı səhvlərdən hansının həqiqətən ciddi olduğunu ayıra bilərmi?
Təklif olunan steelman exchange üsulu modelləri öz ilkin mühakimələrinə qarşı düşünməyə məcbur edərək həddindən artıq ağır qiymətləndirmələri azaltmağı və kritik səhvləri daha faydalı şəkildə sıralamağı hədəfləyir. Eksperimental tapıntılar bu arxitekturanın həm SPOT benchmark-ında, həm də geri çəkilmiş məqalə benchmark-ında sadə çoxmodel havuzlamaya nisbətən daha yaxşı ağırlıq kalibrlənməsi təmin edə biləcəyini göstərir.
Verianla baxımından tədqiqatın əsas mesajı aydındır: Elmi qiymətləndirmədə süni intellektin dəyəri neçə problem sadaladığı ilə deyil; hansı problemin həqiqətən vacib olduğunu nə qədər etibarlı şəkildə ayırdığı ilə ölçülməlidir. Çox model istifadə etmək kifayət deyil; modellərin bir-birinə necə etiraz etdiyi və ağırlıq qərarını necə kalibrlədiyi müəyyənedici olur.
Mənbə və Metod Qeydi
Bu məzmun Andrew Michael Brilliant tərəfindən hazırlanmış “Steelmanning LLM Review: Severity Calibration Through Adversarial Self-Challenge” başlıqlı tədqiqata əsasən hazırlanıb. Tədqiqat LLM əsaslı elmi məqalə qiymətləndirməsində ağırlıq kalibrlənməsi, steelman exchange, graduated dissent, çoxmodel havuzlama və informasiya nəzəri səhv korrelyasiyası çərçivəsini araşdırır.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal Azərbaycan dilli redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib