

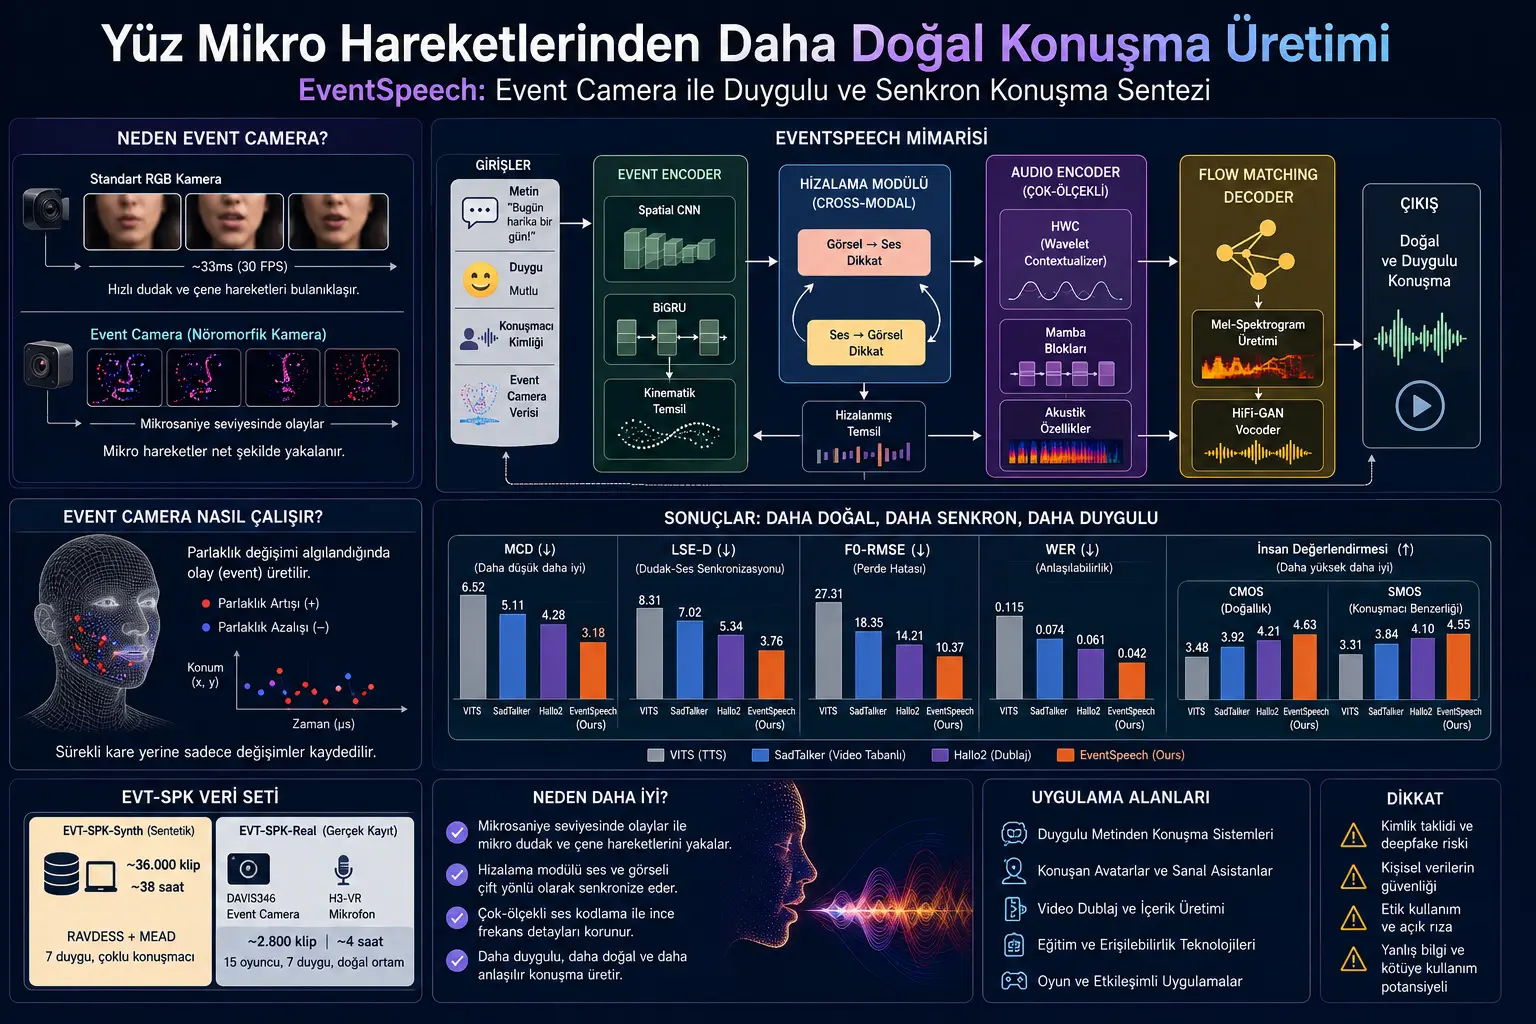
Жасалма интеллект менен сүйлөө чыгаруу азыр бир кыйла өнүккөн. Текстти үнгө айландыра алган системалар адамдын үнүнө жакын жыйынтыктарды бере алат. Бирок дагы деле маанилүү көйгөй бар: Чыгарылган үн көп учурда түшүнүктүү болсо да, чыныгы адам сүйлөөсүндөгү майда сезим өтүүлөрүн, басым өзгөрүүлөрүн жана бет кыймылдары менен шайкеш ритмди толук кармай албай калышы мүмкүн.
Jingping Fang жана кесиптештери даярдаган бул макала бул көйгөйгө башка жактан мамиле кылат. Изилдөөчүлөр стандарттык RGB камера сүрөттөрүнүн ордуна event camera же нейроморфтук окуя камерасын колдонууну сунуштайт. Бул камералар классикалык видеокамералардай катуу кадрларды тартпастан, сүрөттөгү жарыктык өзгөрүүлөрүн микросекундалык тактыкта каттайт.
Изилдөөчүлөргө караганда бул өзгөчөлүк эрин, жаак жана бет булчуңдарындагы өтө тез жана кичине кыймылдарды кармоодо артыкчылык бере алат. Бул микрокыймылдар адам сүйлөөсүндөгү сезим, басым жана ритм менен байланыштуу болушу мүмкүн.
Макала EventSpeech деп аталган системаны сунуштайт. Бул система текст, сезим маалыматы, үн белгилери жана event camera маалыматтарын колдонуп, дагы табигый, дагы синхрондуу жана дагы сезимдүү сүйлөө чыгарууну максат кылат. Мындан тышкары изилдөөчүлөр бул тармак үчүн EVT-SPK деп аталган жаңы маалымат топтомун да түзөт.
Тексттен сүйлөө чыгаруу, башкача айтканда TTS системалары, жазуу текстин үнгө айландырат. Бүгүнкү күндө бул системалар бир кыйла түшүнүктүү сүйлөөлөрдү чыгара алат. Бирок «түшүнүктүү сүйлөө» менен «сезимдүү, жандуу жана адамдай сүйлөө» бир эле нерсе эмес.
Чыныгы адам сүйлөөсүндө сөздөр гана жок. Үн тону, дем алуу, басым, темп, эрин кыймылдары, жаактын ачылып-жабылышы, бет булчуңдарындагы майда өзгөрүүлөр жана микроыраңдар да сүйлөөнүн табигыйлыгына таасир этет.
Видео менен колдоого алынган сүйлөө чыгаруу системалары ошондуктан бет сүрөттөрүнөн пайдаланат. Бирок стандарттык камералардын маанилүү чеги бар: Видео секундасына белгилүү сандагы кадрлардан турат. Мисалы, 30 FPS камера болжол менен ар бир 33 миллисекундада бир кадр чыгарат. Бул убакыт ичинде тез эрин титирөөлөрү, күтүлбөгөн жаак кыймылдары же микроыраңдар бүдөмүктөнүшү мүмкүн.
Макала бул көйгөйгө Temporal Granularity Mismatch деп ат коёт. Кыргызча жөнөкөйлөтсөк:
Убакыттык майда-чүйдө дал келбөөчүлүк.
Башкача айтканда үн толкуну өтө тез жана үзгүлтүксүз өзгөрүп жатканда, стандарттык камера сүрөтү бул өзгөрүүлөрдү жетиштүү майда убакыттык ажыратуу менен кармай албай калышы мүмкүн. Натыйжада жасалма интеллект модели да бет кыймылдарынан келген майда белгилерди өткөрүп жибериши жана дагы «орточо», азыраак жандуу сүйлөө чыгарышы мүмкүн.
Ыкма эмне сунуштайт?
Изилдөөчүлөр бул көйгөйдү чечүү үчүн EventSpeech деп аталган жаңы сүйлөө чыгаруу системасын сунуштайт.
Бул системанын негизги идеясы төмөнкүдөй:
Стандарттык камера сүрөттөрүнүн ордуна, сүйлөө учурунда бетте пайда болгон өтө кичине жана тез кыймылдарды event camera менен кармоо. Ошентип система эрин, жаак, баш кыймылы жана бет ыраңындагы тез өзгөрүүлөрдү такыраак окуй алат.
Event camera деген эмне?
Классикалык камера ар бир кадрда бүтүндөй сүрөттү жазат. Event camera болсо сүрөттө өзгөрүү болгондо гана жооп берет. Мисалы, эрин четинде, жаакта же бетте кичине жарыктык өзгөрүшү болсо, аны окуя катары каттайт. Бул окуялар өтө жогорку убакыттык тактык менен сакталышы мүмкүн.
Ошондуктан event camera, айрыкча тез кыймылдарда жана төмөн жарык сыяктуу кыйын шарттарда артыкчылык бере алат. Стандарттык камерадагы кыймыл бүдөмүктөшүүсүнө азыраак көз каранды.
EventSpeech системасы жалпысынан төмөнкү бөлүктөрдү камтыйт:
1. Event Encoder
Бет кыймылдарынан келген event маалыматтарын иштетет. Эрин кыймылы, бет аракеттери, баш позасы, сүйлөө ритми жана визуалдык прозодия сыяктуу белгилерди бөлүүгө аракет кылат.
2. Multi-Scale Audio Encoder
Үндүн ар кандай масштабдагы түзүлүшүн иштетет. Бул жерде максат жалпы сүйлөө агымын да, майда жыштык майда-чүйдөлөрүн да сактоо. Макалада HWC же Hierarchical Wavelet Contextualizer деп аталган түзүлүш колдонулат.
3. Cross-Modal Alignment Module
Визуалдык кыймылдар менен үн белгилерин тегиздейт. Жөнөкөй айтканда, эрин кыймылы качан болсо, үндүн да ошого ылайык убакытта пайда болушун камсыздоого аракет кылат.
4. Text Processing Backbone
Текст, сезим маалыматы жана үн стили сыяктуу маалыматтарды алат. Ошентип система визуалдык кыймылга гана эмес, айтыла турган текстке жана керектүү сезимге да байланат.
5. Flow Matching Decoder
Акыркы этапта бул маалыматтардан mel-spektrogram чыгарылат жана vocoder жардамы менен сүйлөө толкунуна айландырылат.
Макаладагы негизги идея төмөнкүдөй:
Сүйлөө чыгаруу текстти окуу гана эмес. Беттеги физикалык кыймылдар да үндүн табигый жана сезимдүү чыгышына жардам бере алат. Event camera бул кыймылдарды стандарттык видеодогудан майдараак кармай алат.
Формулалар эмнени түшүндүрөт?
Макаладагы формулалар системанын ар кандай маалымат булактарын кантип бириктиргенин жана үн–сүрөт шайкештигин кантип үйрөнгөнүн түшүндүрөт. Окурман үчүн жөнөкөйлөтүп эки негизги идеяны айта алабыз.
Биринчи формула: Үн белгилерин бириктирүү
Макаладагы биринчи формула үндүн жергиликтүү жана жалпы белгилерин бирге бириктирет.
Бул жердеги негизги белгилер төмөнкүдөй түшүнүлүшү мүмкүн:
- Fa: Модель түзгөн акыркы акустикалык representation
- Hτ: Үндүн кыска мөөнөттүү, жергиликтүү өзгөрүүлөрүн чагылдырган маалымат
- Hω: Үндүн дагы жалпы, спектралык түзүлүшүн чагылдырган маалымат
- α: Моделдин бул эки маалымат түрүнө канчалык салмак берерин үйрөнгөн дарбаза механизми
- etmb: Сүйлөөчүнүн тембри же үн кимдиги жөнүндөгү маалымат
- Wf: Бул маалыматтарды бириктирген үйрөнүлүүчү өзгөртүү катмары
Бул формуланын негизги билдирүүсү төмөнкүдөй:
Модель сүйлөөнү чыгарганда жалпы үн тонуна гана карабайт. Кыска мөөнөттүү майда-чүйдөлөрдү да, жалпы тембрди да бирге колдонот. Ошентип сүйлөөнүн да түшүнүктүү, да табигый угулушу көздөлөт.
Экинчи формула: Үн менен визуалдык кыймылдын тегиздөөсү
Макаладагы InfoNCE жоготуусу туура үн–сүрөт жуптарын бири-бирине жакындатууну, туура эмес дал келүүлөрдү болсо алыстатууну максат кылат.
Жөнөкөй айтканда мындай ойлосок болот:
- Бир адамдын бет кыймылы менен ага тиешелүү үн бири-бири менен шайкеш болушу керек.
- Башка адамдын үнү же туура эмес убакыттагы үн бул визуалдык кыймыл менен шайкеш эсептелбеши керек.
- Модель туура дал келүүлөрдү үйрөнүп, эрин кыймылы, сезим жана үн ортосунда күчтүүрөөк байланыш курууга аракет кылат.
Бул формуланын негизги билдирүүсү төмөнкүдөй:
Модель «текстти үнгө айлант» деп гана айтпайт; «бул беттеги кыймыл менен бул үн чын эле бири-бирине дал келеби?» деген суроону да үйрөнөт.
График / Таблица / Схема болсо негизги билдирүү эмне?
Макаладагы сүрөттөр жана таблицалар системанын да архитектурасын, да эмне үчүн event camera колдонулганын түшүндүрөт.
Макаладагы биринчи схема:
Биринчи беттеги система сүрөтү EventSpeechтин окутуу учурунда да үн, да event маалыматтарынан үйрөнгөнүн; чыгаруу этабында болсо текст менен же бар болсо визуалдык event маалыматы менен сүйлөө чыгара аларын көрсөтөт. Негизги билдирүү төмөнкүдөй: Система бет кыймылдарынан келген майда убакыттык маалыматты сүйлөөнүн табигый ритми менен байланыштырууга аракет кылат.
Негизги архитектура схемасы:
Макаладагы чоң архитектура схемасы Event Encoder, Audio Encoder, тегиздөө модулу жана Flow Matching Decoder бөлүктөрүн көрсөтөт. Фигуранын негизги билдирүүсү төмөнкүдөй: Бул иш бир жөнөкөй TTS модели эмес; визуалдык кыймыл, текст, сезим, сүйлөөчү тембри жана үн белгилерин бириктирген көп модалдуу системаны сунуштайт.
Тегиздөө схемасы:
Макаладагы үн–сүрөт тегиздөө схемасы визуалдык жана акустикалык белгилердин өз ара көңүл механизми менен бири-бирин көзөмөлдөгөнүн түшүндүрөт. Башкача айтканда модель сүрөттөн үнгө бир багытта гана өтпөйт; үн жана сүрөт representationдерин чогуу жөнгө салат.
EVT-SPK маалымат топтомунун графиги:
Макаладагы маалымат топтомунун сүрөтү эки бөлүктү көрсөтөт. Синтетикалык бөлүк болжол менен 36 миң клип жана 38 сааттык маалыматты камтыйт. Чыныгы аппарат менен жазылган бөлүк болсо болжол менен 2.8 миң клип жана 4 сааттык маалыматты камтыйт. Чыныгы жазуулар DAVIS346 event camera жана жогорку сапаттуу үн жаздыруучу түзүлүш менен алынган. Негизги билдирүү төмөнкүдөй: Изилдөөчүлөр симуляцияга гана ишенбестен, чыныгы сенсор маалыматын да чогулткан.
Жыйынтык таблицасы:
Макаладагы негизги салыштыруу таблицасы EventSpeechтин көптөгөн өлчөмдөрдө башка ыкмалардан жакшыраак жыйынтык бергенин көрсөтөт. Айрыкча чыныгы event camera маалыматы колдонулган EVT-SPK-Real бөлүмүндө EventSpeech; MCD, F0-RMSE, WER жана адам баалоосу сыяктуу метрикаларда күчтүү жыйынтыктар берет.
Mel-spektrogram салыштыруусу:
Макаладагы түстүү mel-spektrogram сүрөтү ар кандай ыкмалар чыгарган үндүн убакыт–жыштык түзүлүшүн салыштырат. Негизги билдирүү төмөнкүдөй: EventSpeech, айрыкча сезим өтүүлөрү жана майда прозодиялык термелүүлөр сыяктуу жерлерде чыныгы үнгө жакыныраак үлгүлөрдү чыгара алат.
Аблация таблицалары:
Макаланын аягындагы таблицалар event camera маалыматынын жогорку FPS RGB камерага салыштырмалуу артыкчылык бере аларын көрсөтөт. 25, 60 жана 120 FPS RGB варианттарында натыйжалуулук жакшырса да, event негизиндеги ыкма жакшыраак метрикаларга жетет. Бул жыйынтык изилдөөчүлөрдүн «стандарттык камеранын убакыттык ажыратуусу сүйлөөнүн майда кыймылдарын өткөрүп жибериши мүмкүн» деген ырастоосун колдойт.
Тажрыйбалар кантип жүргүзүлгөн?
Изилдөөчүлөр алгач EVT-SPK деп аталган жаңы benchmark түзөт. Бул benchmark эки бөлүктөн турат:
EVT-SPK-Synth
Синтетикалык event маалыматтарын камтыйт. RAVDESS жана MEAD сыяктуу сезимдүү сүйлөө маалымат топтомдорунан пайдаланылат. Бул бөлүк болжол менен 36 миң клип жана 38 сааттык маалыматты камтыйт.
EVT-SPK-Real
Чыныгы event camera аппараты менен чогултулган маалыматты камтыйт. DAVIS346 event camera жана H3-VR үн жаздыруучу түзүлүш колдонулган. Жазууларда 15 актёр, 7 сезим жана болжол менен 4 сааттык чыныгы жазуу бар. Изилдөөчүлөр төмөн жарык жана тез бет кыймылы сыяктуу кыйын шарттарды да атайын киргизет.
Система 113 миллион параметрлүү EventSpeech модели менен окутулат. Окутууда NVIDIA A100 GPU'лар колдонулган. Чыгаруу этабында 8 секундалык үн клиптери чыгарылганы жана системанын бир кыйла тез иштегени белгиленет.
Салыштыруу үчүн ар кандай түрлөгү ыкмалар колдонулган:
- Тексттен сүйлөө чыгаруу системалары
- Видео менен колдоого алынган сүйлөө чыгаруу системалары
- Дубляж жана визуалдык үн клондоо системалары
- RGB видеодогудан eventке окшош сигнал чыгаруучу ыкмалар
- EventSpeechтин текстти гана колдонгон версиясы
Баалоо метрикалары да көп өлчөмдүү тандалган:
- MCD: Үндүн спектралык айырмасын өлчөйт. Төмөн болушу жакшыраак.
- LSE-D / LSE-C: Эрин–үн синхрондоштуруусун өлчөйт.
- F0-RMSE: Негизги жыштык катасын өлчөйт. Сүйлөө пердеси жана басым жагынан маанилүү.
- KL: Сезим–прозодия бөлүштүрүлүшүнүн канчалык сакталганын өлчөө үчүн колдонулат.
- WER: Чыгарылган сүйлөөнүн текст жагынан канчалык туура түшүнүлөрүн өлчөйт.
- CMOS / SMOS: Адам баалоосуна негизделген кабыл алуу сапаты жана сүйлөөчү окшоштугу упайлары.
Жыйынтыктар эмнени көрсөтөт?
Макаланын жыйынтыктарына караганда EventSpeech да синтетикалык, да чыныгы маалымат топтомунда көптөгөн өлчөмдөрдө күчтүү натыйжалуулук көрсөтөт.
Синтетикалык маалымат топтомунда EventSpeech башка ыкмаларга салыштырмалуу төмөнүрөөк MCD, жакшыраак үн–сүрөт синхрондоштуруусу, жакшыраак перде тактыгы жана төмөнүрөөк сөз ката үлүшүн жетишет. Бул системанын текстти окуу менен гана чектелбестен, бет кыймылдарынан келген маалыматты да сүйлөөгө чагылдыра аларын көрсөтөт.
Чыныгы event camera маалыматында жыйынтыктар дагы көңүл бурарлык. EventSpeech EVT-SPK-Real үстүндө MCD маанисин 3.18ке чейин түшүрөт жана F0-RMSE маанисинде да күчтүү жыйынтык берет. Бул чыныгы сенсор маалыматынын сүйлөө табигыйлыгы жана эрин–үн шайкештиги жагынан пайда бере аларын көрсөтөт.
Макала мындан тышкары EventSpeechтин текстти гана колдонгон версиясын да сынайт. Бул версия да күчтүү жыйынтыктар берсе да, event маалыматы кошулган толук модель жакшыраак натыйжалуулук көрсөтөт. Бул айырма нейроморфтук event маалыматынын чын эле салым кошконун көрсөткөн маанилүү белги.
Жогорку FPS камера салыштыруусунда да көңүл бурарлык жыйынтык бар. RGB камеранын 25 FPS, 60 FPS жана 120 FPS версиялары натыйжалуулукту жогорулатса да, event негизиндеги система жакшыраак жыйынтык берет. Изилдөөчүлөр муну классикалык камералардын дагы деле экспозиция жана кадр логикасына байланганына; event камералардын болсо кыймыл өзгөрүүлөрүн дагы үзгүлтүксүз жана майда кармашына байланыштырат.
Бул эмне үчүн маанилүү?
Бул иш сүйлөө чыгарууда жаңы көз карашты сунуштайт. Бүгүнкүгө чейин көптөгөн системалар текстке, үнгө же стандарттык видео кадрларга көңүл бурган. EventSpeech болсо «сүйлөө физикалык кыймыл» идеясын алдыга чыгарат.
Адам сүйлөгөндө сөздөрдү гана айтпайт. Эриндер, жаак, бет булчуңдары жана микроыраңдар сүйлөөнүн ритмине жана сезимине таасир этет. Эгер бул кыймылдар такыраак өлчөнсө, жасалма интеллект дагы табигый жана дагы сезимдүү үндөрдү чыгара алат.
Бул технология келечекте төмөнкү тармактарда изилдөө баалуулугуна ээ болушу мүмкүн:
- Дагы табигый тексттен сүйлөө чыгаруу
- Видео дубляж системалары
- Сүйлөгөн аватарлар
- Сезим өткөрүүсү күчтүүрөөк үн чыгаруу
- Төмөн жарыкта же тез бет кыймылдарында бекемдирээк визуалдык–үн тегиздөөсү
- Жардамчы байланыш технологиялары
Бирок ошол эле учурда этият болууну талап кылган тармак. Анткени адамдын үнү жана бет кыймылдары жеке кимдик элементтери. Мындай системалар кыянаттык менен колдонулса жасалма үн, уруксатсыз дубляж же кимдикти тууроо сыяктуу коркунучтар пайда болушу мүмкүн.
Көңүл буруу керек болгон жактар
Бул макала таасирдүү жыйынтыктар сунуштаса да, айрым чектөөлөрдү камтыйт.
Биринчиден, иш arXiv preprint катары көрүнөт. Акыркы рецензияланган басылма абалы өзүнчө текшерилиши керек.
Экинчиден, чыныгы event camera маалымат топтому азырынча чектелген масштабда. Макалада чыныгы маалымат топтому болжол менен 2.8 миң клип жана 4 сааттык жазууну камтыйт. Бул маанилүү башталыш болсо да, ар кандай тилдер, акценттер, жаш топтору, бет түрлөрү, жарык шарттары жана жазуу чөйрөлөрү үчүн чоңураак маалымат керек.
Үчүнчүдөн, системанын айрым бөлүктөрү синтетикалык event маалыматтарына таянат. Синтетикалык маалыматтар пайдалуу болсо да, чыныгы сенсор ызы-чуусун, жарык өзгөрүшүн жана түзүлүш өзгөчөлүктөрүн толук чагылдырбай калышы мүмкүн.
Төртүнчүдөн, event camera аппараты ар ким оңой жеткиликтүү түзүлүш эмес. Ошондуктан ыкманын кеңири колдонулушу үчүн аппарат баасы жана практикалык орнотуу маанилүү маселе.
Бешинчиден, сүйлөө чыгаруу этика жана коопсуздук жагынан сезимтал тармак. Чыныгы адамдардын үнү, бет кыймылы же кимдик белгилери колдонулса, ачык макулдук, маалымат коопсуздугу жана кыянаттыктын алдын алуу механизмдери керек.
Жыйынтык
EventSpeech иши жасалма интеллект менен сүйлөө чыгарууда стандарттык камера сүрөттөрүнөн тышкары чыккан жаңы ыкманы сунуштайт. Изилдөөчүлөр event camera маалыматтарынын эрин жана бет кыймылдарындагы тез микроөзгөрүүлөрдү такыраак кармай аларын жана бул дагы табигый, дагы синхрондуу, дагы сезимдүү сүйлөө чыгарууга салым кошо аларын коргойт.
Макаладагы тажрыйбалар EventSpeechтин да синтетикалык, да чыныгы event camera маалыматтарында күчтүү жыйынтыктар бергенин көрсөтөт. Айрыкча кыймыл бүдөмүктөшүүсү, төмөн жарык жана тез артикуляция сыяктуу кыйын шарттарда event негизиндеги ыкманын пайдалуу болушу мүмкүндүгү көрүнөт.
Verianla көз карашынан бул макаланын негизги билдирүүсү төмөнкүдөй:
Келечектеги сүйлөө чыгаруу системалары текстти окуу менен гана чектелбеши мүмкүн. Адам сүйлөөсүн жакшыраак тууроо үчүн бет кыймылдарынын өтө кичине жана тез физикалык издерин да колдоно алат. Бирок бул илгерилөө этикалык колдонуу жана кимдик коопсуздугу жоопкерчилиги менен бирге ойлонулушу керек.
Булак жана ыкма эскертмеси
Бул мазмун Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai жана Xiaoming Chen тарабынан даярдалган “Can We Hear from Events? Generating Speech from Event Camera” деп аталган академиялык иштен пайдаланылып Verianla редакциялык форматында өзгөчө даярдалган.
Бул жазуу сөзмө-сөз котормо эмес; макаладагы ыкма, система архитектурасы, маалымат топтому, таблицалар, графиктер жана жыйынтыктар жөнөкөйлөтүлүп кыргыз окурмандары үчүн кайра жазылган. Мазмун маалымат жана билим берүү максатын көздөйт. Адам үнүн чыгаруу, дубляж, сүйлөөчүнү тууроо, биометрикалык маалымат же жасалма интеллект негизиндеги медиа чыгаруу сыяктуу тармактарда этикалык, укуктук жана коопсуздук талаптары эске алынышы керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген