

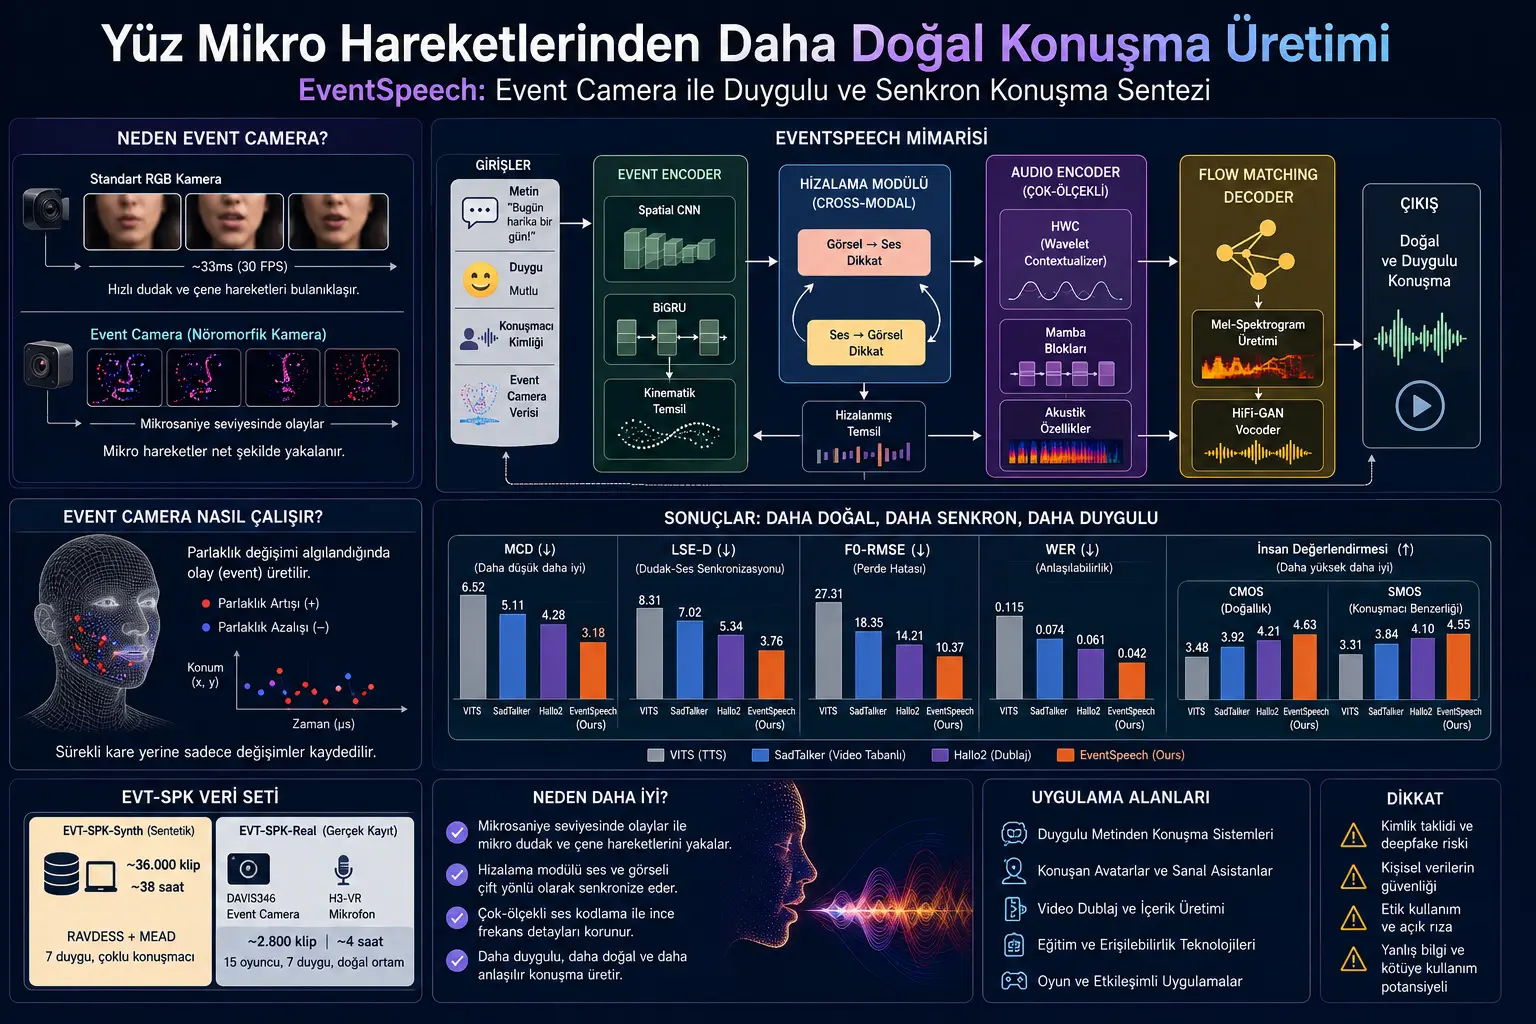
Тавлиди нутқ бо зеҳни сунъӣ ҳоло хеле пешрафт кардааст. Системаҳое, ки матнро ба овоз табдил медиҳанд, метавонанд натиҷаҳое наздик ба овози инсон бароранд. Аммо ҳанӯз як мушкили муҳим вуҷуд дорад: Овози тавлидшуда аксар вақт фаҳмо бошад ҳам, гузаришҳои нозуки эҳсосӣ, тағйири таъкид ва ритми ҳамоҳанг бо ҳаракатҳои рӯйро дар нутқи воқеии инсон пурра дарк карда наметавонад.
Ин мақолае, ки Jingping Fang ва ҳамкоронаш омода кардаанд, ба ин мушкил аз ҷойи дигар наздик мешавад. Муҳаққиқон ба ҷои тасвирҳои камераи стандартии RGB истифодаи event camera яъне камераи ҳодисавии нейроморфикӣ-ро пешниҳод мекунанд. Ин камераҳо ба ҷои гирифтани кадрҳои собити камераҳои классикии видео, тағйироти равшании тасвирро бо дақиқии микросония сабт мекунанд.
Ба гуфтаи муҳаққиқон ин хусусият метавонад дар дарк кардани ҳаракатҳои хеле тез ва хурди лаб, ҷоғ ва мушакҳои рӯй бартарӣ диҳад. Ин микроҳаракатҳо метавонанд бо эҳсос, таъкид ва ритми нутқи инсон алоқаманд бошанд.
Мақола системаеро бо номи EventSpeech пешниҳод мекунад. Ин система бо истифодаи матн, маълумоти эҳсосӣ, хусусиятҳои овоз ва маълумоти event camera ҳадафи тавлиди нутқи табиӣтар, синхронтар ва эҳсоситарро дорад. Илова бар ин муҳаққиқон барои ин соҳа маҷмӯаи нави маълумоте бо номи EVT-SPK низ эҷод мекунанд.
Тавлиди нутқ аз матн, яъне системаҳои TTS, матни навиштаро ба овоз табдил медиҳанд. Имрӯз ин системаҳо метавонанд нутқҳои хеле фаҳмо тавлид кунанд. Аммо «нутқи фаҳмо» ва «нутқи эҳсосӣ, зинда ва мисли инсон» як чиз нестанд.
Дар нутқи воқеии инсон танҳо калимаҳо нестанд. Тонҳои овоз, нафас, таъкид, темп, ҳаракатҳои лаб, кушодаву пӯшида шудани ҷоғ, тағйироти хурди мушакҳои рӯй ва микроифодаҳо низ ба табиӣ будани нутқ таъсир мерасонанд.
Системаҳои тавлиди нутқи бо видео дастгиришуда аз ҳамин сабаб аз тасвирҳои рӯй истифода мебаранд. Аммо камераҳои стандартӣ як ҳадди муҳим доранд: Видео аз шумораи муайяни кадрҳо дар як сония иборат аст. Масалан, камераи 30 FPS тақрибан ҳар 33 миллисония як кадр тавлид мекунад. Дар ин муддат ларзишҳои тезӣ лаб, ҳаракатҳои ногаҳонии ҷоғ ё микроифодаҳо метавонанд хира шаванд.
Мақола ба ин мушкил номи Temporal Granularity Mismatch медиҳад. Агар ба тоҷикӣ содда кунем:
Номутобиқатии ҷузъиёти замонӣ.
Яъне вақте мавҷи овоз хеле тез ва пайваста тағйир меёбад, тасвири камераи стандартӣ метавонад ин тағйиротро бо ҳалкунии кофии нозуки замонӣ дарк накунад. Дар натиҷа модели зеҳни сунъӣ низ метавонад нишонаҳои нозукро аз ҳаракатҳои рӯй аз даст диҳад ва нутқи «миёна», камтар зинда тавлид кунад.
Усул чӣ пешниҳод мекунад?
Муҳаққиқон барои ҳалли ин мушкил системаи нави тавлиди нутқро бо номи EventSpeech пешниҳод мекунанд.
Идеяи асосии ин система чунин аст:
Ба ҷои тасвирҳои камераи стандартӣ, ҳаракатҳои хеле хурд ва тези рӯйро ҳангоми суханронӣ бо event camera дарк кардан. Ҳамин тавр система метавонад тағйироти тези ҳаракати лаб, ҷоғ, сар ва ифодаи рӯйро дақиқтар хонад.
Event camera чист?
Камераи классикӣ дар ҳар кадр тамоми тасвирро сабт мекунад. Event camera бошад танҳо вақте ки дар тасвир тағйир рӯй диҳад, вокуниш нишон медиҳад. Масалан, агар дар канори лаб, ҷоғ ё рӯй тағйироти хурди равшанӣ бошад, онро ҳамчун ҳодиса сабт мекунад. Ин ҳодисаҳо метавонанд бо дақиқии баланди замонӣ нигоҳ дошта шаванд.
Аз ҳамин сабаб event camera, махсусан дар ҳаракатҳои тез ва шароитҳои душвор мисли равшании паст, метавонад бартарӣ диҳад. Он ба хирашавии ҳаракат дар камераи стандартӣ камтар вобаста аст.
Системаи EventSpeech умуман қисмҳои зеринро дар бар мегирад:
1. Event Encoder
Маълумоти event-ро, ки аз ҳаракатҳои рӯй меояд, коркард мекунад. Кӯшиш мекунад хусусиятҳоеро мисли ҳаракати лаб, амалҳои рӯй, позаи сар, ритми нутқ ва прозодияи визуалӣ ҷудо кунад.
2. Multi-Scale Audio Encoder
Сохтори овозиро дар миқёсҳои гуногун коркард мекунад. Дар ин ҷо ҳадаф ҳифз кардани ҳам ҷараёни умумии нутқ ва ҳам ҷузъиёти хурди басомад аст. Дар мақола сохторе бо номи HWC яъне Hierarchical Wavelet Contextualizer истифода мешавад.
3. Cross-Modal Alignment Module
Ҳаракатҳои визуалиро бо хусусиятҳои овоз ҳамоҳанг мекунад. Ба таври содда, кӯшиш мекунад ки ҳар вақт ҳаракати лаб рӯй диҳад, овоз низ дар ҳамон вақти мувофиқ пайдо шавад.
4. Text Processing Backbone
Матн, маълумоти эҳсосӣ ва услуби овозро қабул мекунад. Ҳамин тавр система на танҳо ба ҳаракати визуалӣ, балки ба матни гуфташаванда ва эҳсоси дилхоҳ низ вобаста мемонад.
5. Flow Matching Decoder
Дар марҳилаи охир аз ин маълумотҳо mel-spektrogram тавлид мешавад ва бо ёрии vocoder ба мавҷи нутқ табдил меёбад.
Идеяи асосии мақола чунин аст:
Тавлиди нутқ танҳо хондани матн нест. Ҳаракатҳои ҷисмонии рӯй низ метавонанд ба табиӣ ва эҳсосӣ баромадани овоз кӯмак кунанд. Event camera метавонад ин ҳаракатҳоро аз видеои стандартӣ нозуктар дарк кунад.
Формулаҳо чӣ мегӯянд?
Формулаҳои мақола шарҳ медиҳанд, ки система чӣ гуна манбаъҳои гуногуни маълумотро муттаҳид мекунад ва чӣ гуна ҳамоҳангии овоз–тасвирро меомӯзад. Барои хонанда метавонем ду идеяи асосиро соддатар зикр кунем.
Формулаи аввал: Муттаҳид кардани хусусиятҳои овоз
Формулаи аввали мақола хусусиятҳои маҳаллӣ ва умумии овозиро якҷо мекунад.
Аломатҳои асосии ин ҷо чунин фаҳмида мешаванд:
- Fa: Намояндагии ниҳоии акустикие, ки модел эҷод кардааст
- Hτ: Маълумоте, ки тағйироти кӯтоҳмуддат ва маҳаллии овозиро нишон медиҳад
- Hω: Маълумоте, ки сохтори умумитар ва спектралии овозиро нишон медиҳад
- α: Механизми дарвозае, ки меомӯзад модел ба ин ду намуди маълумот чӣ қадар вазн диҳад
- etmb: Маълумот дар бораи тембри гӯянда ё ҳувияти овоз
- Wf: Қабати табдилдиҳии омӯхташавандае, ки ин маълумотҳоро муттаҳид мекунад
Паёми асосии ин формула чунин аст:
Модел ҳангоми тавлиди нутқ танҳо ба тони умумии овоз нигоҳ намекунад. Ҳам ҷузъиёти кӯтоҳмуддат ва ҳам тембри умумиро якҷо истифода мебарад. Ҳамин тавр ҳадаф он аст, ки нутқ ҳам фаҳмо ва ҳам табиӣ шунида шавад.
Формулаи дуюм: Ҳамоҳангсозии овоз ва ҳаракати визуалӣ
Талафоти InfoNCE дар мақола ҳадаф дорад ҷуфтҳои дурусти овоз–тасвирро ба ҳам наздик кунад ва мутобиқати нодурустро дур созад.
Ба таври содда чунин андешидан мумкин аст:
- Ҳаракати рӯйи як шахс бо овози ба ӯ тааллуқдошта бояд бо ҳам ҳамоҳанг бошад.
- Овози шахси дигар ё овози нодурусти замонӣ набояд бо ин ҳаракати визуалӣ ҳамоҳанг ҳисобида шавад.
- Модел бо омӯхтани мутобиқати дуруст кӯшиш мекунад байни ҳаракати лаб, эҳсос ва овоз пайванди қавитар барқарор кунад.
Паёми асосии ин формула чунин аст:
Модел танҳо намегӯяд «матнро ба овоз табдил диҳ»; инчунин меомӯзад, ки «оё ин ҳаракати рӯй ва ин овоз воқеан ба ҳам мувофиқанд?»
Агар график / ҷадвал / схема бошад, паёми асосӣ чист?
Тасвирҳо ва ҷадвалҳои мақола ҳам меъмории система ва ҳам сабаби истифодаи event camera-ро шарҳ медиҳанд.
Схемаи аввали мақола:
Тасвири система дар саҳифаи аввал нишон медиҳад, ки EventSpeech ҳангоми омӯзиш ҳам аз овоз ва ҳам аз маълумоти event меомӯзад; дар марҳилаи хулосабарорӣ бошад метавонад бо матн ё агар мавҷуд бошад бо маълумоти визуалии event нутқ тавлид кунад. Паёми асосӣ чунин аст: Система кӯшиш мекунад маълумоти нозуки замониро аз ҳаракатҳои рӯй бо ритми табиии нутқ алоқаманд кунад.
Схемаи меъмории асосӣ:
Схемаи калони меъморӣ дар мақола қисмҳои Event Encoder, Audio Encoder, модули ҳамоҳангсозӣ ва Flow Matching Decoder-ро нишон медиҳад. Паёми асосии шакл чунин аст: Ин кор як модели оддии TTS нест; системаи бисёрмодалиеро пешниҳод мекунад, ки ҳаракати визуалӣ, матн, эҳсос, тембри гӯянда ва хусусиятҳои овозиро муттаҳид мекунад.
Схемаи ҳамоҳангсозӣ:
Схемаи ҳамоҳангсозии овоз–тасвир дар мақола шарҳ медиҳад, ки хусусиятҳои визуалӣ ва акустикӣ бо механизми диққати мутақобил якдигарро назорат мекунанд. Яъне модел танҳо аз тасвир ба овоз якҷониба намеравад; намояндагии овоз ва тасвирро якҷо танзим мекунад.
Графики маҷмӯаи маълумоти EVT-SPK:
Тасвири маҷмӯаи маълумот дар мақола ду қисмро нишон медиҳад. Қисми синтетикӣ тақрибан 36 ҳазор клип ва 38 соат маълумотро дар бар мегирад. Қисми бо сахтафзори воқеӣ сабтшуда бошад тақрибан 2.8 ҳазор клип ва 4 соат маълумотро дар бар мегирад. Сабтҳои воқеӣ бо event camera-и DAVIS346 ва дастгоҳи сабти овози босифат гирифта шудаанд. Паёми асосӣ чунин аст: Муҳаққиқон танҳо ба симулятсия такя накардаанд, маълумоти воқеии сенсорро низ ҷамъ овардаанд.
Ҷадвали натиҷа:
Ҷадвали асосии муқоиса дар мақола нишон медиҳад, ки EventSpeech дар бисёр андозаҳо натиҷаи беҳтар аз дигар усулҳо додааст. Махсусан дар қисми EVT-SPK-Real, ки маълумоти воқеии event camera истифода шудааст, EventSpeech дар метрикаҳое мисли MCD, F0-RMSE, WER ва арзёбии инсонӣ натиҷаҳои қавӣ медиҳад.
Муқоисаи mel-spektrogram:
Тасвири рангаи mel-spektrogram дар мақола сохтори замон–басомади овозиро, ки усулҳои гуногун тавлид кардаанд, муқоиса мекунад. Паёми асосӣ чунин аст: EventSpeech, махсусан дар минтақаҳои гузаришҳои эҳсосӣ ва лаппиши нозуки прозодӣ, метавонад нақшҳои наздиктар ба овози воқеӣ тавлид кунад.
Ҷадвалҳои аблятсия:
Ҷадвалҳои охири мақола нишон медиҳанд, ки маълумоти event camera метавонад нисбат ба камераи RGB бо FPS-и баланд бартарӣ диҳад. Дар вариантҳои RGB бо 25, 60 ва 120 FPS самаранокӣ беҳтар мешавад, аммо усули бар асоси event ба метрикаҳои беҳтар мерасад. Ин натиҷа даъвои муҳаққиқонро тасдиқ мекунад, ки «ҳалкунии замонии камераи стандартӣ метавонад ҳаракатҳои нозуки нутқро аз даст диҳад».
Таҷрибаҳо чӣ гуна гузаронида шудаанд?
Муҳаққиқон аввал benchmark-и наверо бо номи EVT-SPK эҷод мекунанд. Ин benchmark аз ду қисм иборат аст:
EVT-SPK-Synth
Маълумоти синтетикии event-ро дар бар мегирад. Аз маҷмӯаҳои маълумоти нутқи эҳсосӣ мисли RAVDESS ва MEAD истифода мешавад. Ин қисм тақрибан 36 ҳазор клип ва 38 соат маълумотро дар бар мегирад.
EVT-SPK-Real
Маълумоти бо сахтафзори воқеии event camera ҷамъоваришударо дар бар мегирад. Event camera-и DAVIS346 ва дастгоҳи сабти овози H3-VR истифода шудаанд. Дар сабтҳо 15 бозигар, 7 эҳсос ва тақрибан 4 соат сабти воқеӣ ҳаст. Муҳаққиқон шароитҳои душвор мисли равшании паст ва ҳаракати тези рӯйро низ махсус ворид мекунанд.
Система бо модели EventSpeech, ки 113 миллион параметр дорад, омӯзонда мешавад. Дар омӯзиш GPU-ҳои NVIDIA A100 истифода шудаанд. Дар марҳилаи хулосабарорӣ зикр шудааст, ки клипҳои овозии 8-сониягӣ тавлид шудаанд ва система хеле тез кор мекунад.
Барои муқоиса усулҳои гуногун истифода шудаанд:
- Системаҳои тавлиди нутқ аз матн
- Системаҳои тавлиди нутқи бо видео дастгиришуда
- Системаҳои дубляж ва клони овози визуалӣ
- Усулҳое, ки аз видеои RGB сигнали шабеҳи event мебароранд
- Версияи EventSpeech, ки танҳо матнро истифода мебарад
Метрикаҳои арзёбӣ низ бисёрҷанба интихоб шудаанд:
- MCD: Фарқи спектралии овозиро месанҷад. Паст буданаш беҳтар аст.
- LSE-D / LSE-C: Синхронизатсияи лаб–овозро месанҷад.
- F0-RMSE: Хатои басомади асосиро месанҷад. Аз ҷиҳати пардаи нутқ ва таъкид муҳим аст.
- KL: Барои санҷидани он ки тақсимоти эҳсос–прозодия чӣ қадар ҳифз шудааст, истифода мешавад.
- WER: Месанҷад, ки нутқи тавлидшуда аз ҷиҳати матн чӣ қадар дуруст фаҳмида мешавад.
- CMOS / SMOS: Холҳои сифати идрокӣ ва шабоҳати гӯянда бар асоси арзёбии инсонӣ.
Натиҷаҳо чӣ нишон медиҳанд?
Ба гуфтаи натиҷаҳои мақола EventSpeech ҳам дар маҷмӯаи маълумоти синтетикӣ ва ҳам дар маҷмӯаи воқеӣ дар бисёр андозаҳо самаранокии қавӣ нишон медиҳад.
Дар маҷмӯаи маълумоти синтетикӣ EventSpeech нисбат ба дигар усулҳо MCD-и пасттар, синхронизатсияи беҳтари овоз–тасвир, дақиқии беҳтари парда ва қисмати пасттари хатои калима ба даст меорад. Ин нишон медиҳад, ки система на танҳо матнро мехонад, балки маълумотро аз ҳаракатҳои рӯй низ ба нутқ инъикос карда метавонад.
Дар маълумоти воқеии event camera натиҷаҳо бештар ҷолибтаранд. EventSpeech дар EVT-SPK-Real қимати MCD-ро то 3.18 поён меорад ва дар қимати F0-RMSE низ натиҷаи қавӣ медиҳад. Ин нишон медиҳад, ки маълумоти воқеии сенсор метавонад аз ҷиҳати табиии нутқ ва ҳамоҳангии лаб–овоз фоида диҳад.
Мақола инчунин версияи EventSpeech-ро, ки танҳо матнро истифода мебарад, низ меозмояд. Ин версия низ натиҷаҳои қавӣ медиҳад, аммо модели пуррае, ки маълумоти event илова шудааст, самаранокии беҳтар нишон медиҳад. Ин фарқ нишонаи муҳимест, ки маълумоти нейроморфикии event воқеан саҳм гузоштааст.
Дар муқоисаи камераи FPS-и баланд низ натиҷаи ҷолиб ҳаст. Версияҳои камераи RGB бо 25 FPS, 60 FPS ва 120 FPS самаранокӣро баланд мекунанд, аммо системаи бар асоси event натиҷаи беҳтар медиҳад. Муҳаққиқон инро ба он вобаста мекунанд, ки камераҳои классикӣ ҳанӯз ба мантиқи экспозисия ва кадр вобастаанд; камераҳои event бошад тағйироти ҳаракатро пайвастатар ва нозуктар дарк мекунанд.
Чаро ин муҳим аст?
Ин кор дар тавлиди нутқ дидгоҳи наверо пешниҳод мекунад. То имрӯз бисёр системаҳо ба матн, овоз ё кадрҳои стандартии видео таваҷҷуҳ кардаанд. EventSpeech бошад идеяи «нутқ ҳаракати ҷисмонӣ аст»-ро пеш меорад.
Вақте инсон сухан мегӯяд, танҳо калимаҳоро намегӯяд. Лабҳо, ҷоғ, мушакҳои рӯй ва микроифодаҳо ба ритм ва эҳсоси нутқ таъсир мерасонанд. Агар ин ҳаракатҳо дақиқтар чен карда шаванд, зеҳни сунъӣ метавонад овозҳои табиӣтар ва эҳсоситар тавлид кунад.
Ин технология дар оянда метавонад дар соҳаҳои зерин арзиши таҳқиқотӣ дошта бошад:
- Тавлиди табиӣтари нутқ аз матн
- Системаҳои дубляжи видео
- Аватарҳои сухангӯ
- Тавлиди овози бо интиқоли қавитари эҳсос
- Ҳамоҳангсозии устуворитар визуалӣ–овоз дар равшании паст ё ҳаракатҳои тези рӯй
- Технологияҳои ёрирасони алоқа
Аммо ҳамзамон ин соҳае аст, ки бояд эҳтиёткор буд. Зеро овози инсон ва ҳаракатҳои рӯй унсурҳои ҳувияти шахсӣ мебошанд. Агар чунин системаҳо сӯистифода шаванд, хатарҳое мисли овози қалбакӣ, дубляжи беиҷозат ё тақлиди ҳувият пайдо шуда метавонанд.
Нуктаҳое, ки бояд ба онҳо диққат дод
Ин мақола ҳарчанд натиҷаҳои таъсирбахш пешниҳод мекунад, баъзе маҳдудиятҳоро дар бар мегирад.
Аввалан, кор ҳамчун preprint-и arXiv намоён аст. Вазъияти нашри ниҳоии ҳакамӣ бояд алоҳида тасдиқ шавад.
Дуюм, маҷмӯаи маълумоти воқеии event camera ҳанӯз дар миқёси маҳдуд аст. Дар мақола маҷмӯаи маълумоти воқеӣ тақрибан 2.8 ҳазор клип ва 4 соат сабтро дар бар мегирад. Ин оғози муҳим аст, аммо барои забонҳои гуногун, лаҳҷаҳо, гурӯҳҳои синнусолӣ, намудҳои рӯй, шароитҳои равшанӣ ва муҳитҳои сабт маълумоти калонтар лозим аст.
Сеюм, баъзе қисмҳои система ба маълумоти синтетикии event такя мекунанд. Маълумоти синтетикӣ ҳарчанд фоиданок аст, метавонад садои сенсори воқеӣ, тағйироти равшанӣ ва хусусиятҳои дастгоҳро пурра инъикос накунад.
Чорум, сахтафзори event camera дастгоҳе нест, ки ҳар кас ба осонӣ дастрас кунад. Аз ҳамин сабаб барои истифодаи васеи усул арзиши сахтафзор ва насби амалӣ масъалаи муҳим аст.
Панҷум, тавлиди нутқ аз ҷиҳати ахлоқӣ ва амниятӣ соҳаи ҳассос аст. Агар овози одамони воқеӣ, ҳаракати рӯй ё хусусиятҳои ҳувият истифода шаванд, розигии ошкор, амнияти маълумот ва механизмҳои пешгирии сӯистифода лозиманд.
Хулоса
Кори EventSpeech дар тавлиди нутқ бо зеҳни сунъӣ равиши наверо пешниҳод мекунад, ки аз тасвирҳои камераи стандартӣ фаротар меравад. Муҳаққиқон ҳимоя мекунанд, ки маълумоти event camera метавонад тағйироти тези микродар ҳаракатҳои лаб ва рӯйро дақиқтар дарк кунад ва ин метавонад ба тавлиди нутқи табиӣтар, синхронтар ва эҳсоситар саҳм гузорад.
Таҷрибаҳои мақола нишон медиҳанд, ки EventSpeech ҳам дар маълумоти синтетикӣ ва ҳам дар маълумоти воқеии event camera натиҷаҳои қавӣ додааст. Махсусан дар шароитҳои душвор мисли хирашавии ҳаракат, равшании паст ва артикулятсияи тез равиши бар асоси event метавонад бартарӣ дошта бошад.
Аз назари Verianla паёми асосии ин мақола чунин аст:
Системаҳои ояндаи тавлиди нутқ метавонанд танҳо бо хондани матн қаноат накунанд. Барои беҳтар тақлид кардани нутқи инсон онҳо метавонанд аз изҳои хеле хурд ва тези ҷисмонии ҳаракатҳои рӯй низ истифода баранд. Аммо ин пешрафт бояд ҳамроҳ бо истифодаи ахлоқӣ ва масъулияти амнияти ҳувият андешида шавад.
Ёддошти манбаъ ва усул
Ин муҳтаво бо истифода аз кори академии “Can We Hear from Events? Generating Speech from Event Camera”, ки аз ҷониби Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai ва Xiaoming Chen омода шудааст, дар формати таҳририи Verianla ба таври аслӣ омода гардидааст.
Ин навишта тарҷумаи калима ба калима нест; усул, меъмории система, маҷмӯаи маълумот, ҷадвалҳо, графикҳо ва натиҷаҳои мақола содда карда барои хонандагони тоҷик аз нав навишта шудаанд. Муҳтаво ҳадафи иттилоотӣ ва таълимӣ дорад. Дар соҳаҳое мисли тавлиди овози инсон, дубляж, тақлиди гӯянда, маълумоти биометрӣ ё тавлиди медиаи бар асоси зеҳни сунъӣ талаботи ахлоқӣ, ҳуқуқӣ ва амниятӣ бояд ба назар гирифта шаванд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд