

Süni intellektlə danışıq istehsalı artıq xeyli inkişaf edib. Mətni səsə çevirə bilən sistemlər insan səsinə yaxın nəticələr yarada bilir. Lakin hələ də vacib problem qalır: yaradılan səs çox vaxt anlaşılan olsa da, real insan danışığındakı incə emosional keçidləri, vurğu dəyişikliklərini və üz hərəkətləri ilə uyğun ritmi tam şəkildə tuta bilmir.
Jingping Fang və həmkarlarının hazırladığı bu məqalə problemə fərqli tərəfdən yanaşır. Tədqiqatçılar standart RGB kamera görüntüləri əvəzinə event camera yəni neyromorfik hadisə kamerası istifadə etməyi təklif edirlər. Bu kameralar klassik video kameralar kimi sabit kadrlar çəkmək əvəzinə, görüntüdəki parlaqlıq dəyişikliklərini mikrosaniyə dəqiqliyi ilə qeydə alır.
Tədqiqatçıların fikrincə, bu xüsusiyyət dodaq, çənə və üz əzələlərindəki çox sürətli və kiçik hərəkətləri tutmaqda üstünlük verə bilər. Bu mikrohərəkətlər insan danışığındakı emosiya, vurğu və ritmlə əlaqəli ola bilər.
Məqalə EventSpeech adlı sistem təklif edir. Bu sistem mətn, emosiya məlumatı, səs xüsusiyyətləri və event camera verilənlərindən istifadə edərək daha təbii, daha sinxron və daha emosional danışıq yaratmağı hədəfləyir. Bundan əlavə, tədqiqatçılar bu sahə üçün EVT-SPK adlı yeni verilənlər toplusu da yaradırlar.
Mətndən danışıq istehsalı, yəni TTS sistemləri yazılı mətni səsə çevirir. Bu gün bu sistemlər kifayət qədər anlaşılan danışıq yarada bilir. Lakin “anlaşılan danışıq” ilə “emosional, canlı və insan kimi danışıq” eyni şey deyil.
Real insan danışığında yalnız sözlər yoxdur. Səs tonu, nəfəs, vurğu, temp, dodaq hərəkətləri, çənənin açılıb-bağlanması, üz əzələlərindəki kiçik dəyişikliklər və mikroifadələr də danışığın təbiiliyinə təsir edir.
Video dəstəkli danışıq istehsalı sistemləri buna görə üz görüntülərindən istifadə edir. Lakin standart kameraların mühüm məhdudiyyəti var: video saniyədə müəyyən sayda kadrdan ibarətdir. Məsələn, 30 FPS kamera təxminən hər 33 millisaniyədə bir kadr yaradır. Bu müddət ərzində sürətli dodaq titrəmələri, qəfil çənə hərəkətləri və ya mikroifadələr bulanıqlaşa bilər.
Məqalə bu problemə Temporal Granularity Mismatch adını verir. Sadə şəkildə Azərbaycan dilinə çevirsək:
Zaman detallılığının uyğunsuzluğu.
Yəni səs dalğası çox sürətli və fasiləsiz dəyişdiyi halda, standart kamera görüntüsü bu dəyişiklikləri kifayət qədər incə zaman ayırdetməsi ilə tuta bilməyə bilər. Nəticədə süni intellekt modeli də üz hərəkətlərindən gələn incə ipuclarını qaçıra və daha “orta”, daha az canlı danışıq yarada bilər.
Üsul Nə Təklif Edir?
Tədqiqatçılar bu problemi həll etmək üçün EventSpeech adlı yeni danışıq istehsalı sistemi təklif edirlər.
Bu sistemin əsas fikri budur:
Standart kamera görüntüləri əvəzinə, danışıq zamanı üzdə yaranan çox kiçik və sürətli hərəkətləri event camera ilə tutmaq. Beləliklə, sistem dodaq, çənə, baş hərəkəti və üz ifadəsindəki sürətli dəyişiklikləri daha həssas oxuya bilər.
Event camera nədir?
Klassik kamera hər kadrda bütün görüntünü qeydə alır. Event camera isə yalnız görüntüdə dəyişiklik olduqda reaksiya verir. Məsələn, dodaq kənarında, çənədə və ya üzdə kiçik parlaqlıq dəyişməsi olarsa, bunu hadisə kimi qeydə alır. Bu hadisələr çox yüksək zaman dəqiqliyi ilə saxlanıla bilər.
Buna görə event camera xüsusilə sürətli hərəkətlərdə və zəif işıq kimi çətin şəraitdə üstünlük verə bilər. Standart kameradakı hərəkət bulanıqlığından daha az asılıdır.
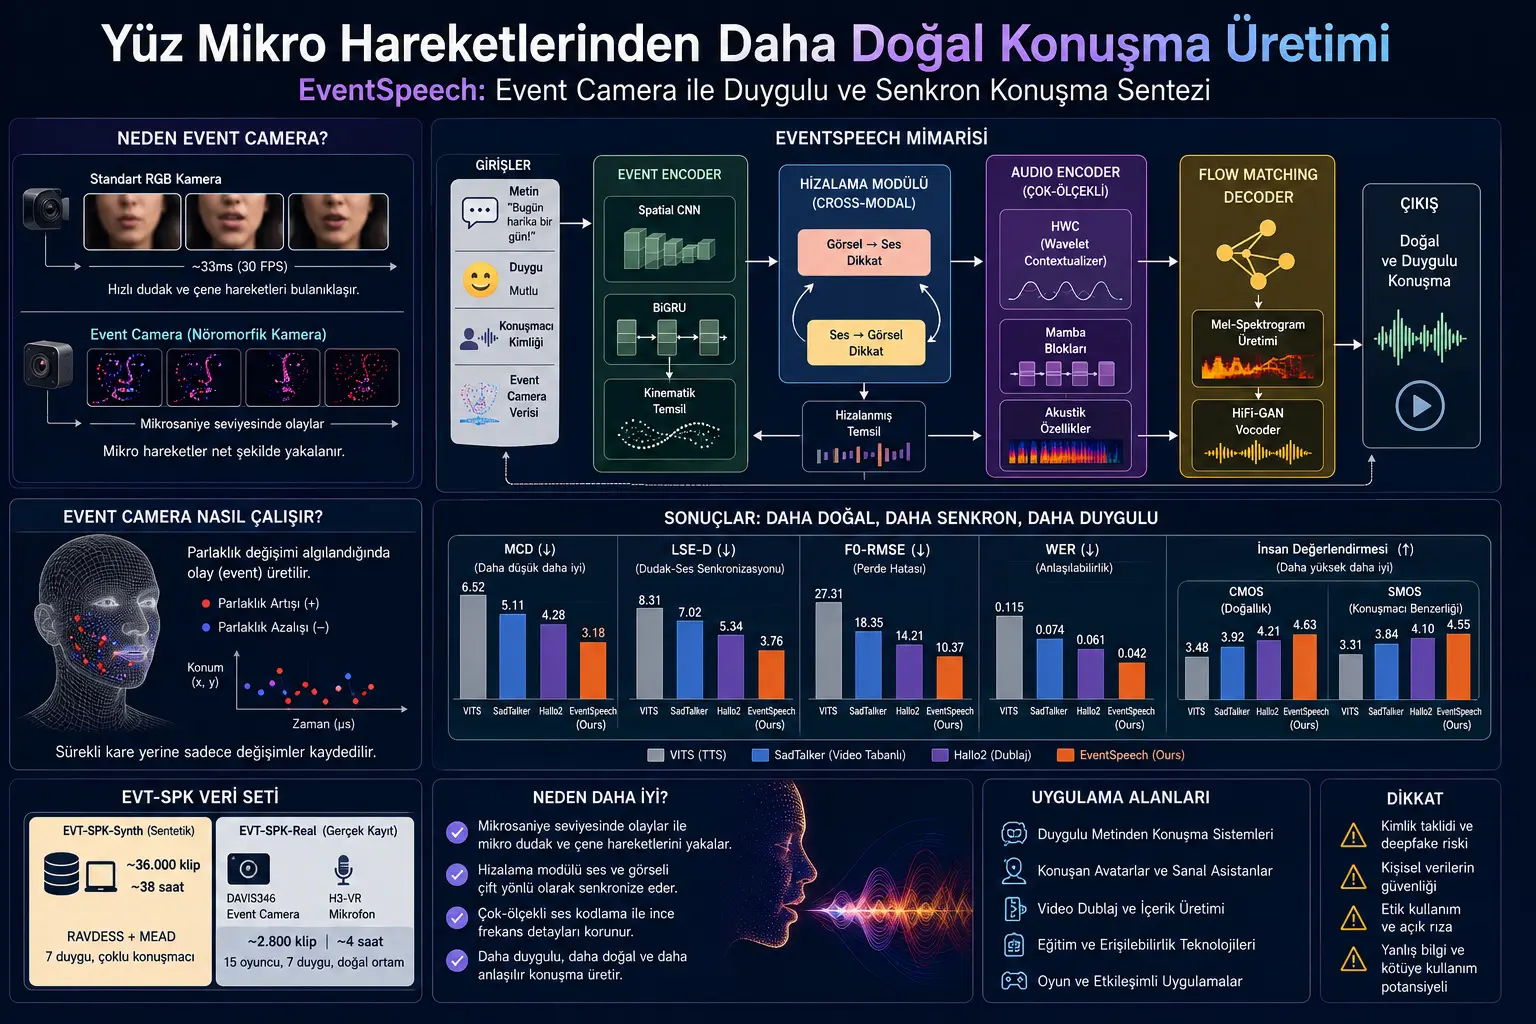
EventSpeech sistemi ümumilikdə aşağıdakı hissələrdən ibarətdir:
1. Event Encoder
Üz hərəkətlərindən gələn event verilənlərini emal edir. Dodaq hərəkəti, üz hərəkət vahidləri, baş pozası, danışıq ritmi və vizual prosodiya kimi xüsusiyyətləri ayırmağa çalışır.
2. Multi-Scale Audio Encoder
Səsin müxtəlif miqyaslardakı quruluşunu emal edir. Burada məqsəd həm ümumi danışıq axınını, həm də kiçik tezlik detallarını qorumaqdır. Məqalədə HWC, yəni Hierarchical Wavelet Contextualizer adlı strukturdan istifadə olunur.
3. Cross-Modal Alignment Module
Vizual hərəkətlərlə səs xüsusiyyətlərini hizalayır. Sadə desək, dodaq hərəkəti nə vaxt baş verirsə, səsin də uyğun zamanda yaranmasını təmin etməyə çalışır.
4. Text Processing Backbone
Mətn, emosiya məlumatı və səs üslubu kimi məlumatları qəbul edir. Beləliklə, sistem yalnız vizual hərəkətə deyil, deyiləcək mətnə və istənilən emosiyaya da bağlı qalır.
5. Flow Matching Decoder
Son mərhələdə bu məlumatlardan mel-spektroqram yaradılır və vocoder vasitəsilə danışıq dalğasına çevrilir.
Məqalədəki əsas fikir budur:
Danışıq istehsalı yalnız mətni oxumaq deyil. Üzdəki fiziki hərəkətlər də səsin təbii və emosional çıxmasına kömək edə bilər. Event camera bu hərəkətləri standart videodan daha incə tuta bilər.
Formullar Nə Anladır?
Məqalədəki formullar sistemin müxtəlif məlumat mənbələrini necə birləşdirdiyini və səs-görüntü uyğunluğunu necə öyrəndiyini izah edir. Oxucu üçün sadələşdirərək iki əsas fikirdən danışmaq olar.
Birinci formul: Səs xüsusiyyətlərinin birləşdirilməsi
Məqalədəki ilk formul səsin yerli və ümumi xüsusiyyətlərini bir araya gətirir.
Buradakı əsas simvolları belə düşünmək olar:
- Fa: Modelin yaratdığı yekun akustik təmsil
- Hτ: Səsin qısa zamanlı, yerli dəyişikliklərini təmsil edən məlumat
- Hω: Səsin daha ümumi, spektral quruluşunu təmsil edən məlumat
- α: Modelin bu iki məlumat növünə nə qədər çəki verəcəyini öyrənən qapı mexanizmi
- etmb: Danışanın tembri və ya səs kimliyi məlumatı
- Wf: Bu məlumatları birləşdirən öyrənilə bilən çevirmə qatı
Bu formulun əsas mesajı budur:
Model danışığı yaradarkən yalnız ümumi səs tonuna baxmır. Həm qısamüddətli detalları, həm də ümumi tembri birlikdə istifadə edir. Beləliklə, danışığın həm anlaşılan, həm də təbii səslənməsi hədəflənir.
İkinci formul: Səs və vizual hərəkətin hizalanması
Məqalədəki InfoNCE itkisi düzgün səs-görüntü cütlərini bir-birinə yaxınlaşdırmağı, yanlış uyğunluqları isə uzaqlaşdırmağı hədəfləyir.
Sadə şəkildə belə düşünə bilərik:
- Bir şəxsin üz hərəkəti ilə ona aid səs bir-biri ilə uyğun olmalıdır.
- Başqa şəxsin səsi və ya yanlış zamanlı səs bu vizual hərəkətlə uyğun hesab edilməməlidir.
- Model düzgün uyğunluqları öyrənərək dodaq hərəkəti, emosiya və səs arasında daha güclü əlaqə yaratmağa çalışır.
Bu formulun əsas mesajı budur:
Model yalnız “mətni səsə çevir” demir; “bu üzdəki hərəkətlə bu səs həqiqətən bir-birinə uyğundurmu?” sualını da öyrənir.
Qrafik / Cədvəl / Sxem Varsa Əsas Mesajı Nədir?
Məqalədəki təsvirlər və cədvəllər sistemin həm arxitekturasını, həm də niyə event camera istifadə etdiyini izah edir.
Məqalədəki ilk sxem:
Birinci səhifədəki sistem təsviri EventSpeech-in təlim zamanı həm səs, həm də event verilənlərindən öyrəndiyini; çıxarım mərhələsində isə mətnlə və ya varsa vizual event məlumatı ilə danışıq yarada bildiyini göstərir. Əsas mesaj budur: sistem üz hərəkətlərindən gələn incə zaman məlumatını danışığın təbii ritmi ilə əlaqələndirməyə çalışır.
Əsas arxitektura sxemi:
Məqalədəki böyük arxitektura sxemi Event Encoder, Audio Encoder, hizalama modulu və Flow Matching Decoder hissələrini göstərir. Şəklin əsas mesajı budur: bu tədqiqat tək bir sadə TTS modeli deyil; vizual hərəkəti, mətni, emosiyanı, danışan tembrini və səs xüsusiyyətlərini birləşdirən çoxmodallı sistem təklif edir.
Hizalama sxemi:
Məqalədəki səs-görüntü hizalama sxemi vizual və akustik xüsusiyyətlərin qarşılıqlı diqqət mexanizmi vasitəsilə bir-birini yoxladığını izah edir. Yəni model yalnız görüntüdən səsə bir istiqamətdə getmir; səs və görüntü təmsillərini birlikdə tənzimləyir.
EVT-SPK verilənlər toplusu qrafiki:
Məqalədəki verilənlər toplusu təsviri iki bölmə göstərir. Sintetik hissədə təxminən 36 min klip və 38 saatlıq verilən var. Real avadanlıqla qeydə alınan hissədə isə təxminən 2.8 min klip və 4 saatlıq verilən var. Real qeydlər DAVIS346 event camera və yüksək keyfiyyətli səs yazma cihazı ilə aparılıb. Əsas mesaj budur: tədqiqatçılar yalnız simulyasiyaya güvənməyib, real sensor verilənləri də toplayıblar.
Nəticələr cədvəli:
Məqalədəki əsas müqayisə cədvəli EventSpeech-in bir çox meyarda digər üsullardan daha yaxşı nəticə verdiyini göstərir. Xüsusilə real event camera verilənlərinin istifadə olunduğu EVT-SPK-Real bölməsində EventSpeech MCD, F0-RMSE, WER və insan qiymətləndirməsi kimi metriklərdə güclü nəticələr göstərir.
Mel-spektroqram müqayisəsi:
Məqalədəki rəngli mel-spektroqram təsviri müxtəlif üsulların yaratdığı səsin zaman-tezlik quruluşunu müqayisə edir. Əsas mesaj budur: EventSpeech xüsusilə emosiya keçidləri və incə prosodik dalğalanmalar kimi sahələrdə real səsə daha yaxın nümunələr yarada bilir.
Ablasiya cədvəlləri:
Məqalənin sonundakı cədvəllər event camera məlumatının yüksək FPS RGB kamera ilə müqayisədə üstünlük verə bildiyini göstərir. 25, 60 və 120 FPS RGB variantlarında performans yaxşılaşsa da, event əsaslı üsul daha yaxşı metriklərə çatır. Bu nəticə tədqiqatçıların “standart kameranın zaman ayırdetməsi danışığın incə hərəkətlərini qaçıra bilər” iddiasını dəstəkləyir.
Təcrübələr Necə Aparılıb?
Tədqiqatçılar əvvəlcə EVT-SPK adlı yeni benchmark yaradırlar. Bu benchmark iki bölmədən ibarətdir:
EVT-SPK-Synth
Sintetik event verilənləri ehtiva edir. RAVDESS və MEAD kimi emosional danışıq verilənlər toplusundan istifadə olunur. Bu bölmə təxminən 36 min klip və 38 saatlıq verilən ehtiva edir.
EVT-SPK-Real
Real event camera avadanlığı ilə toplanmış verilənləri ehtiva edir. DAVIS346 event camera və H3-VR səs yazma cihazından istifadə olunub. Qeydlərdə 15 aktyor, 7 emosiya və təxminən 4 saatlıq real qeyd var. Tədqiqatçılar zəif işıq və sürətli üz hərəkəti kimi çətin şəraiti də xüsusi olaraq daxil ediblər.
Sistem 113 milyon parametrli EventSpeech modeli ilə təlim edilir. Təlimdə NVIDIA A100 GPU-lardan istifadə olunub. Çıxarım mərhələsində 8 saniyəlik səs kliplərinin yaradıldığı və sistemin kifayət qədər sürətli işlədiyi bildirilir.
Müqayisə üçün müxtəlif növ üsullardan istifadə olunub:
- Mətndən danışıq istehsalı sistemləri
- Video dəstəkli danışıq istehsalı sistemləri
- Dublaj və vizual səs klonlama sistemləri
- RGB videodan event bənzəri siqnal çıxaran üsullar
- EventSpeech-in yalnız mətn istifadə edən versiyası
Qiymətləndirmə metrikləri də çoxölçülü seçilib:
- MCD: Səsin spektral fərqini ölçür. Aşağı olması daha yaxşıdır.
- LSE-D / LSE-C: Dodaq-səs sinxronizasiyasını ölçür.
- F0-RMSE: Əsas tezlik xətasını ölçür. Danışıq tonu və vurğu baxımından vacibdir.
- KL: Emosiya-prosodiya paylanmasının nə dərəcədə qorunduğunu ölçmək üçün istifadə olunur.
- WER: Yaradılan danışığın mətn baxımından nə dərəcədə düzgün başa düşüldüyünü ölçür.
- CMOS / SMOS: İnsan qiymətləndirməsinə əsaslanan qavrayış keyfiyyəti və danışan oxşarlığı ballarıdır.
Nəticələr Nə Göstərir?
Məqalənin nəticələrinə görə EventSpeech həm sintetik, həm də real verilənlər toplusunda bir çox meyarda güclü performans göstərir.
Sintetik verilənlər toplusunda EventSpeech digər üsullarla müqayisədə daha aşağı MCD, daha yaxşı səs-görüntü sinxronizasiyası, daha yaxşı ton dəqiqliyi və daha aşağı söz xəta nisbəti əldə edir. Bu, sistemin yalnız mətni oxumaqla kifayətlənməyib üz hərəkətlərindən gələn məlumatı da danışığa əks etdirə bildiyini düşündürür.
Real event camera verilənlərində nəticələr daha diqqətçəkəndir. EventSpeech EVT-SPK-Real üzərində MCD dəyərini 3.18-ə qədər azaldır və F0-RMSE dəyərində də güclü nəticə verir. Bu, real sensor verilənlərinin danışıq təbiiliyi və dodaq-səs uyğunluğu baxımından fayda verə biləcəyini göstərir.
Məqalə həmçinin EventSpeech-in yalnız mətn istifadə edən versiyasını da sınaqdan keçirir. Bu versiya da güclü nəticələr versə də, event verilənləri əlavə olunan tam model daha yaxşı performans göstərir. Bu fərq neyromorfik event məlumatının həqiqətən töhfə verdiyini göstərən mühüm əlamətdir.
Yüksək FPS kamera müqayisəsində də diqqətçəkən nəticə var. RGB kameranın 25 FPS, 60 FPS və 120 FPS versiyaları performansı artırsa da, event əsaslı sistem daha yaxşı nəticə verir. Tədqiqatçılar bunu klassik kameraların hələ də ekspozisiya və kadr məntiqindən asılı olmasına, event kameraların isə hərəkət dəyişikliklərini daha fasiləsiz və incə tutmasına bağlayırlar.
Bu Niyə Vacibdir?
Bu tədqiqat danışıq istehsalında yeni baxış bucağı təklif edir. İndiyədək bir çox sistem mətnə, səsə və ya standart video kadrlarına yönəlib. EventSpeech isə “danışıq fiziki hərəkətdir” fikrini önə çıxarır.
İnsan danışarkən yalnız sözləri demir. Dodaqlar, çənə, üz əzələləri və mikroifadələr danışığın ritminə və emosiyasına təsir edir. Əgər bu hərəkətlər daha həssas ölçülə bilsə, süni intellekt daha təbii və daha emosional səslər yarada bilər.
Bu texnologiya gələcəkdə aşağıdakı sahələrdə tədqiqat dəyəri daşıya bilər:
- Daha təbii mətndən danışıq istehsalı
- Video dublaj sistemləri
- Danışan avatarlar
- Emosiya ötürülməsi daha güclü səs istehsalı
- Zəif işıqda və ya sürətli üz hərəkətlərində daha dayanıqlı vizual-səs hizalanması
- Köməkçi kommunikasiya texnologiyaları
Lakin bu, eyni zamanda ehtiyatla yanaşılmalı sahədir. Çünki insan səsi və üz hərəkətləri şəxsi kimlik elementləridir. Belə sistemlərdən sui-istifadə olunarsa saxta səs, icazəsiz dublaj və ya kimlik təqlidi kimi risklər yarana bilər.
Diqqət Edilməli Məqamlar
Bu məqalə təsirli nəticələr təqdim etsə də, bəzi məhdudiyyətlər ehtiva edir.
Birincisi, tədqiqat arXiv preprinti kimi görünür. Yekun rəyli nəşr statusu ayrıca doğrulanmalıdır.
İkincisi, real event camera verilənlər toplusu hələ məhdud miqyasdadır. Məqalədə real verilənlər toplusu təxminən 2.8 min klip və 4 saatlıq qeyd ehtiva edir. Bu mühüm başlanğıc olsa da, fərqli dillər, aksentlər, yaş qrupları, üz tipləri, işıq şəraiti və qeyd mühitləri üçün daha böyük verilənlər lazımdır.
Üçüncüsü, sistemin bəzi hissələri sintetik event verilənlərinə əsaslanır. Sintetik verilənlər faydalı olsa da, real sensor səs-küyünü, işıq dəyişikliklərini və cihaz xüsusiyyətlərini tam əks etdirməyə bilər.
Dördüncüsü, event camera avadanlığı hər kəsin asanlıqla əldə edə biləcəyi cihaz deyil. Buna görə üsulun geniş istifadəsi üçün avadanlıq xərci və praktik quraşdırma mühüm məsələdir.
Beşincisi, danışıq istehsalı etik və təhlükəsizlik baxımından həssas sahədir. Real şəxslərin səsi, üz hərəkəti və ya kimlik xüsusiyyətləri istifadə olunursa, açıq razılıq, verilənlərin təhlükəsizliyi və sui-istifadənin qarşısını alma mexanizmləri tələb olunur.
Nəticə
EventSpeech tədqiqatı süni intellektlə danışıq istehsalında standart kamera görüntülərindən kənara çıxan yeni yanaşma təklif edir. Tədqiqatçılar event camera verilənlərinin dodaq və üz hərəkətlərindəki sürətli mikro dəyişiklikləri daha həssas tuta biləcəyini və bunun daha təbii, daha sinxron, daha emosional danışıq istehsalına töhfə verə biləcəyini irəli sürürlər.
Məqalədəki təcrübələr EventSpeech-in həm sintetik, həm də real event camera verilənlərində güclü nəticələr verdiyini göstərir. Xüsusilə hərəkət bulanıqlığı, zəif işıq və sürətli artikulyasiya kimi çətin şəraitdə event əsaslı yanaşmanın üstünlüklü ola biləcəyi görünür.
Verianla baxımından bu məqalənin əsas mesajı budur:
Gələcəyin danışıq istehsalı sistemləri yalnız mətni oxumaqla kifayətlənməyə bilər. İnsan danışığını daha yaxşı təqlid etmək üçün üz hərəkətlərinin çox kiçik və sürətli fiziki izlərindən də istifadə edə bilər. Lakin bu irəliləyiş etik istifadə və kimlik təhlükəsizliyi məsuliyyəti ilə birlikdə düşünülməlidir.
Mənbə və Metod Qeydi
Bu məzmun Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai və Xiaoming Chen tərəfindən hazırlanmış “Can We Hear from Events? Generating Speech from Event Camera” adlı akademik tədqiqatdan istifadə edilməklə Verianla redaksiya formatında orijinal şəkildə hazırlanıb.
Bu yazı sözbəsöz tərcümə deyil; məqalədəki üsul, sistem arxitekturası, verilənlər toplusu, cədvəllər, qrafiklər və nəticələr sadələşdirilərək Azərbaycan dilində oxucu üçün yenidən izah olunub. Məzmun məlumatlandırma və təhsil məqsədi daşıyır. İnsan səsinin yaradılması, dublaj, danışan şəxsin təqlidi, biometrik verilənlər və ya süni intellekt əsaslı media istehsalı kimi sahələrdə etik, hüquqi və təhlükəsizlik tələbləri nəzərə alınmalıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib