

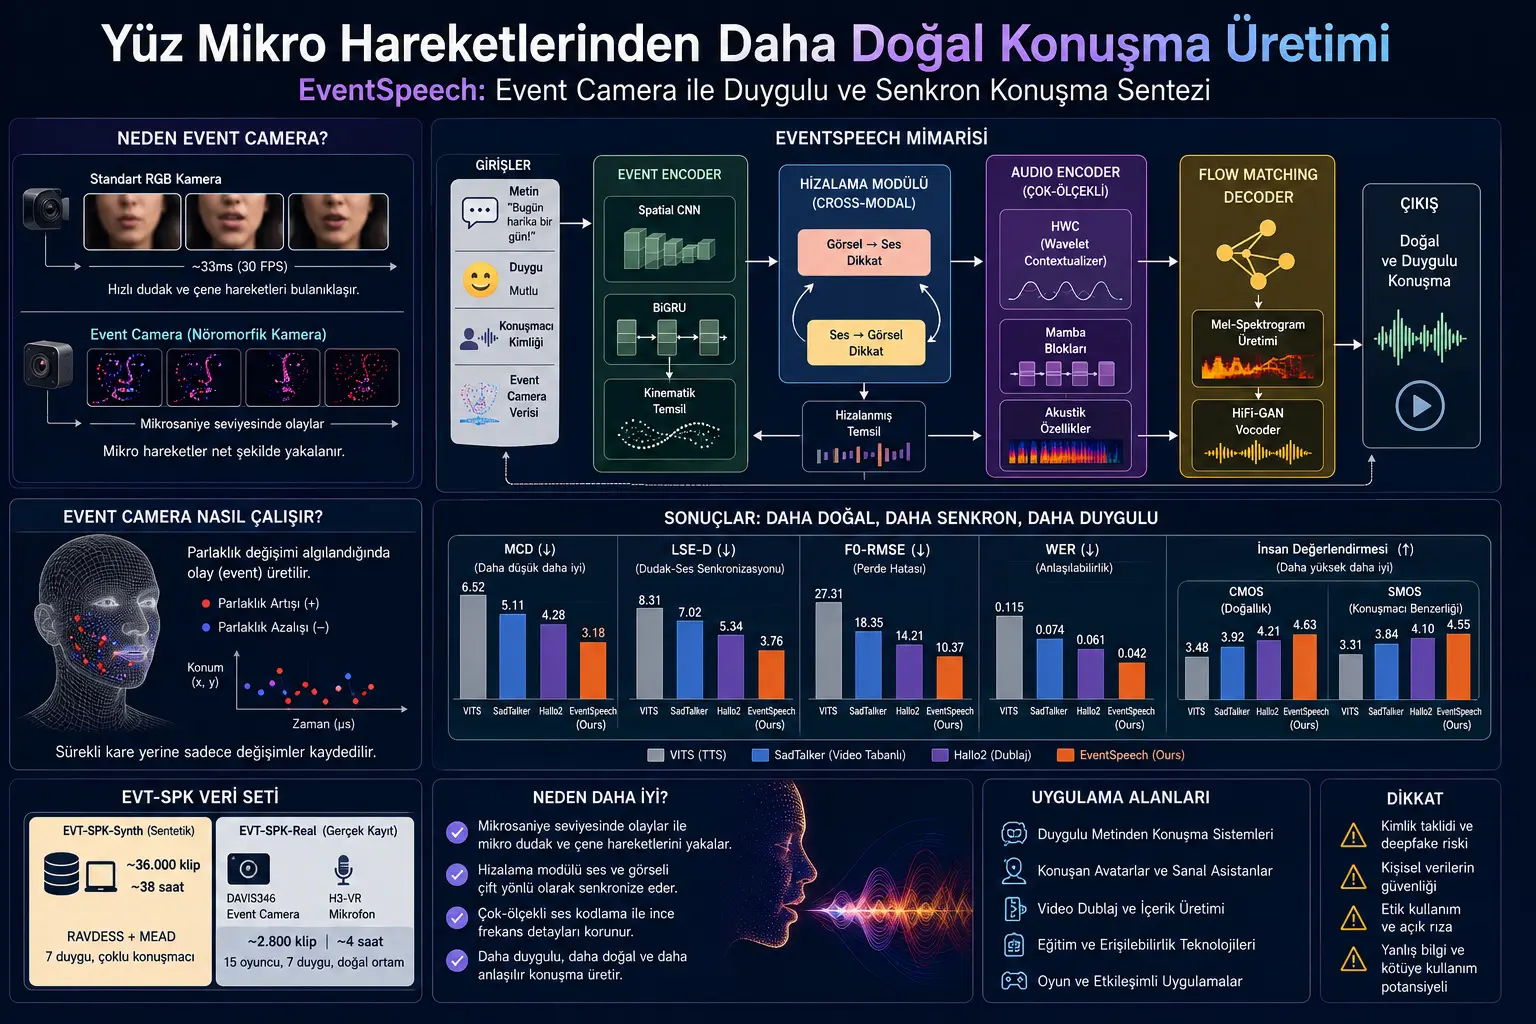
Yapay zekâ ile konuşma üretimi artık oldukça gelişti. Metni sese çevirebilen sistemler, insan sesine yakın çıktılar üretebiliyor. Fakat hâlâ önemli bir sorun var: Üretilen ses çoğu zaman anlaşılır olsa da, gerçek insan konuşmasındaki ince duygu geçişlerini, vurgu değişimlerini ve yüz hareketleriyle uyumlu ritmi tam yakalayamayabiliyor.
Jingping Fang ve çalışma arkadaşlarının hazırladığı bu makale, bu soruna farklı bir yerden yaklaşıyor. Araştırmacılar standart RGB kamera görüntüleri yerine event camera yani nöromorfik olay kamerası kullanmayı öneriyor. Bu kameralar klasik video kameralar gibi sabit kareler çekmek yerine, görüntüdeki parlaklık değişimlerini mikro saniye hassasiyetinde kaydediyor.
Araştırmacılara göre bu özellik, dudak, çene ve yüz kaslarındaki çok hızlı ve küçük hareketleri yakalamada avantaj sağlayabilir. Bu mikro hareketler, insan konuşmasındaki duygu, vurgu ve ritimle bağlantılı olabilir.
Makale, EventSpeech adlı bir sistem öneriyor. Bu sistem; metin, duygu bilgisi, ses özellikleri ve event camera verilerini kullanarak daha doğal, daha senkron ve daha duygulu konuşma üretmeyi hedefliyor. Ayrıca araştırmacılar, bu alan için EVT-SPK adlı yeni bir veri seti de oluşturuyor.
Metinden konuşma üretimi, yani TTS sistemleri, yazılı metni sese dönüştürür. Günümüzde bu sistemler oldukça anlaşılır konuşmalar üretebiliyor. Ancak “anlaşılır konuşma” ile “duygulu, canlı ve insan gibi konuşma” aynı şey değildir.
Gerçek insan konuşmasında sadece kelimeler yoktur. Ses tonu, nefes, vurgu, tempo, dudak hareketleri, çene açılıp kapanması, yüz kaslarındaki küçük değişimler ve mikro ifadeler de konuşmanın doğallığını etkiler.
Video destekli konuşma üretimi sistemleri bu yüzden yüz görüntülerinden yararlanır. Fakat standart kameraların önemli bir sınırı vardır: Video, saniyede belli sayıda kareden oluşur. Örneğin 30 FPS bir kamera, yaklaşık her 33 milisaniyede bir kare üretir. Bu süre içinde hızlı dudak titremeleri, ani çene hareketleri veya mikro ifadeler bulanıklaşabilir.
Makale bu soruna Temporal Granularity Mismatch adını veriyor. Türkçeye sadeleştirirsek:
Zamansal ayrıntı uyuşmazlığı.
Yani ses dalgası çok hızlı ve sürekli değişirken, standart kamera görüntüsü bu değişimleri yeterince ince zaman çözünürlüğüyle yakalayamayabilir. Sonuçta yapay zekâ modeli de yüz hareketlerinden gelen ince ipuçlarını kaçırabilir ve daha “ortalama”, daha az canlı konuşma üretebilir.
Yöntem Ne Öneriyor?
Araştırmacılar bu sorunu çözmek için EventSpeech adlı yeni bir konuşma üretim sistemi öneriyor.
Bu sistemin temel fikri şu:
Standart kamera görüntüleri yerine, konuşma sırasında yüzde oluşan çok küçük ve hızlı hareketleri event camera ile yakalamak. Böylece sistem dudak, çene, baş hareketi ve yüz ifadesindeki hızlı değişimleri daha hassas okuyabilir.
Event camera nedir?
Klasik kamera her karede tüm görüntüyü kaydeder. Event camera ise yalnızca görüntüde değişim olduğunda tepki verir. Örneğin dudak kenarında, çenede veya yüzde küçük bir parlaklık değişimi olursa bunu olay olarak kaydeder. Bu olaylar çok yüksek zaman hassasiyetiyle tutulabilir.
Bu nedenle event camera, özellikle hızlı hareketlerde ve düşük ışık gibi zor koşullarda avantaj sağlayabilir. Standart kameradaki hareket bulanıklığına daha az bağımlıdır.
EventSpeech sistemi genel olarak şu parçaları içeriyor:
1. Event Encoder
Yüz hareketlerinden gelen event verilerini işler. Dudak hareketi, yüz aksiyonları, baş pozu, konuşma ritmi ve görsel prozodi gibi özellikleri ayırmaya çalışır.
2. Multi-Scale Audio Encoder
Sesin farklı ölçeklerdeki yapısını işler. Burada amaç, hem genel konuşma akışını hem de küçük frekans ayrıntılarını korumaktır. Makalede HWC yani Hierarchical Wavelet Contextualizer adlı yapı kullanılıyor.
3. Cross-Modal Alignment Module
Görsel hareketlerle ses özelliklerini hizalar. Basitçe söylemek gerekirse, dudak hareketi ne zaman oluyorsa sesin de buna uygun zamanda oluşmasını sağlamaya çalışır.
4. Text Processing Backbone
Metin, duygu bilgisi ve ses stili gibi bilgileri alır. Böylece sistem yalnızca görsel harekete değil, söylenecek metne ve istenen duyguya da bağlı kalır.
5. Flow Matching Decoder
Son aşamada bu bilgilerden mel-spektrogram üretilir ve vocoder yardımıyla konuşma dalgasına dönüştürülür.
Makaledeki ana fikir şudur:
Konuşma üretimi sadece metni okumak değildir. Yüzdeki fiziksel hareketler de sesin doğal ve duygulu çıkmasına yardım edebilir. Event camera bu hareketleri standart videodan daha ince yakalayabilir.
Formüller Ne Anlatıyor?
Makaledeki formüller, sistemin farklı bilgi kaynaklarını nasıl birleştirdiğini ve ses-görüntü uyumunu nasıl öğrendiğini anlatıyor. Okuyucu için sadeleştirerek iki ana fikirden bahsedebiliriz.
Birinci formül: Ses özelliklerini birleştirme
Makaledeki ilk formül, sesin yerel ve genel özelliklerini bir araya getiriyor.
Buradaki ana semboller şöyle düşünülebilir:
- Fa: Modelin oluşturduğu nihai akustik temsil
- Hτ: Sesin kısa zamanlı, yerel değişimlerini temsil eden bilgi
- Hω: Sesin daha genel, spektral yapısını temsil eden bilgi
- α: Modelin bu iki bilgi türüne ne kadar ağırlık vereceğini öğrenen kapı mekanizması
- etmb: Konuşmacı tınısı veya ses kimliği bilgisi
- Wf: Bu bilgileri birleştiren öğrenilebilir dönüştürme katmanı
Bu formülün ana mesajı şu:
Model, konuşmayı üretirken yalnızca genel ses tonuna bakmıyor. Hem kısa süreli ayrıntıları hem de genel tınıyı birlikte kullanıyor. Böylece konuşmanın hem anlaşılır hem de doğal duyulması hedefleniyor.
İkinci formül: Ses ve görsel hareketin hizalanması
Makaledeki InfoNCE kaybı, doğru ses-görüntü çiftlerini birbirine yaklaştırmayı, yanlış eşleşmeleri ise uzaklaştırmayı amaçlıyor.
Basitçe şöyle düşünebiliriz:
- Bir kişinin yüz hareketiyle ona ait ses birbiriyle uyumlu olmalı.
- Başka bir kişinin sesi veya yanlış zamanlı ses, bu görsel hareketle uyumlu sayılmamalı.
- Model, doğru eşleşmeleri öğrenerek dudak hareketi, duygu ve ses arasında daha güçlü bağlantı kurmaya çalışıyor.
Bu formülün ana mesajı şu:
Model yalnızca “metni sese çevir” demiyor; “bu yüzdeki hareket ve bu ses birbirine gerçekten uyuyor mu?” sorusunu da öğreniyor.
Grafik / Tablo / Şema Varsa Ana Mesajı Ne?
Makaledeki görseller ve tablolar, sistemin hem mimarisini hem de neden event camera kullandığını anlatıyor.
Makaledeki ilk şema:
İlk sayfadaki sistem görseli, EventSpeech’in eğitim sırasında hem ses hem de event verilerinden öğrendiğini; çıkarım aşamasında ise metinle veya varsa görsel event bilgisiyle konuşma üretebildiğini gösteriyor. Ana mesaj şu: Sistem, yüz hareketlerinden gelen ince zaman bilgisini konuşmanın doğal ritmiyle ilişkilendirmeye çalışıyor.
Ana mimari şeması:
Makaledeki büyük mimari şeması; Event Encoder, Audio Encoder, hizalama modülü ve Flow Matching Decoder parçalarını gösteriyor. Şeklin ana mesajı şu: Bu çalışma tek bir basit TTS modeli değil; görsel hareket, metin, duygu, konuşmacı tınısı ve ses özelliklerini birleştiren çok modlu bir sistem öneriyor.
Hizalama şeması:
Makaledeki ses-görüntü hizalama şeması, görsel ve akustik özelliklerin karşılıklı dikkat mekanizmasıyla birbirini kontrol ettiğini anlatıyor. Yani model sadece görüntüden sese tek yönlü gitmiyor; ses ve görüntü temsilini birlikte düzenliyor.
EVT-SPK veri seti grafiği:
Makaledeki veri seti görseli iki bölüm gösteriyor. Sentetik kısım yaklaşık 36 bin klip ve 38 saatlik veri içeriyor. Gerçek donanımla kaydedilen kısım ise yaklaşık 2.8 bin klip ve 4 saatlik veri içeriyor. Gerçek kayıtlar DAVIS346 event camera ve yüksek kaliteli ses kayıt cihazı ile alınmış. Ana mesaj şu: Araştırmacılar yalnızca simülasyona güvenmemiş, gerçek sensör verisi de toplamış.
Sonuç tablosu:
Makaledeki ana karşılaştırma tablosu, EventSpeech’in birçok ölçütte diğer yöntemlerden daha iyi sonuç verdiğini gösteriyor. Özellikle gerçek event camera verisi kullanılan EVT-SPK-Real bölümünde EventSpeech; MCD, F0-RMSE, WER ve insan değerlendirmesi gibi metriklerde güçlü sonuçlar veriyor.
Mel-spektrogram karşılaştırması:
Makaledeki renkli mel-spektrogram görseli, farklı yöntemlerin ürettiği sesin zaman-frekans yapısını karşılaştırıyor. Ana mesaj şu: EventSpeech, özellikle duygu geçişleri ve ince prozodik dalgalanmalar gibi bölgelerde gerçek sese daha yakın desenler üretebiliyor.
Ablasyon tabloları:
Makalenin sonundaki tablolar, event camera bilgisinin yüksek FPS RGB kameraya göre avantaj sağlayabildiğini gösteriyor. 25, 60 ve 120 FPS RGB varyantlarında performans iyileşse de, event tabanlı yöntem daha iyi metriklere ulaşıyor. Bu sonuç, araştırmacıların “standart kamera zaman çözünürlüğü konuşmanın ince hareketlerini kaçırıyor olabilir” iddiasını destekliyor.
Deneyler Nasıl Yapılmış?
Araştırmacılar önce EVT-SPK adlı yeni bir benchmark oluşturuyor. Bu benchmark iki bölümden oluşuyor:
EVT-SPK-Synth
Sentetik event verileri içeriyor. RAVDESS ve MEAD gibi duygulu konuşma veri setlerinden yararlanılıyor. Bu bölüm yaklaşık 36 bin klip ve 38 saatlik veri içeriyor.
EVT-SPK-Real
Gerçek event camera donanımıyla toplanmış veri içeriyor. DAVIS346 event camera ve H3-VR ses kayıt cihazı kullanılmış. Kayıtlarda 15 oyuncu, 7 duygu ve yaklaşık 4 saatlik gerçek kayıt bulunuyor. Araştırmacılar düşük ışık ve hızlı yüz hareketi gibi zor koşulları da özellikle dahil ediyor.
Sistem 113 milyon parametreli EventSpeech modeliyle eğitiliyor. Eğitimde NVIDIA A100 GPU’lar kullanılmış. Çıkarım aşamasında 8 saniyelik ses klipleri üretildiği ve sistemin oldukça hızlı çalıştığı belirtiliyor.
Karşılaştırma için farklı türde yöntemler kullanılmış:
- Metinden konuşma üretimi sistemleri
- Video destekli konuşma üretimi sistemleri
- Dublaj ve görsel ses klonlama sistemleri
- RGB videodan event benzeri sinyal çıkaran yöntemler
- EventSpeech’in yalnızca metin kullanan versiyonu
Değerlendirme metrikleri de çok boyutlu seçilmiş:
- MCD: Sesin spektral farkını ölçer. Düşük olması daha iyidir.
- LSE-D / LSE-C: Dudak-ses senkronizasyonunu ölçer.
- F0-RMSE: Temel frekans hatasını ölçer. Konuşma perdesi ve vurgu açısından önemlidir.
- KL: Duygu-prozodi dağılımının ne kadar korunduğunu ölçmek için kullanılır.
- WER: Üretilen konuşmanın metin açısından ne kadar doğru anlaşılabildiğini ölçer.
- CMOS / SMOS: İnsan değerlendirmesine dayalı algısal kalite ve konuşmacı benzerliği skorlarıdır.
Sonuçlar Ne Gösteriyor?
Makalenin sonuçlarına göre EventSpeech, hem sentetik hem de gerçek veri setinde birçok ölçütte güçlü performans gösteriyor.
Sentetik veri setinde EventSpeech, diğer yöntemlere göre daha düşük MCD, daha iyi ses-görüntü senkronizasyonu, daha iyi perde doğruluğu ve daha düşük kelime hata oranı elde ediyor. Bu, sistemin yalnızca metni okumakla kalmayıp yüz hareketlerinden gelen bilgiyi de konuşmaya yansıtabildiğini düşündürüyor.
Gerçek event camera verisinde sonuçlar daha dikkat çekici. EventSpeech, EVT-SPK-Real üzerinde MCD değerini 3.18’e kadar düşürüyor ve F0-RMSE değerinde de güçlü sonuç veriyor. Bu, gerçek sensör verisinin konuşma doğallığı ve dudak-ses uyumu açısından fayda sağlayabileceğini gösteriyor.
Makale ayrıca EventSpeech’in yalnızca metin kullanan versiyonunu da test ediyor. Bu versiyon da güçlü sonuçlar verse de, event verisi eklenen tam model daha iyi performans gösteriyor. Bu fark, nöromorfik event bilgisinin gerçekten katkı verdiğini gösteren önemli bir işaret.
Yüksek FPS kamera karşılaştırmasında da dikkat çekici bir sonuç var. RGB kameranın 25 FPS, 60 FPS ve 120 FPS versiyonları performansı artırsa da, event tabanlı sistem daha iyi sonuç veriyor. Araştırmacılar bunu, klasik kameraların hâlâ pozlama ve kare mantığına bağlı olmasına; event kameraların ise hareket değişimlerini daha sürekli ve ince yakalamasına bağlıyor.
Bu Neden Önemli?
Bu çalışma, konuşma üretiminde yeni bir bakış açısı öneriyor. Bugüne kadar birçok sistem metne, sese veya standart video karelerine odaklandı. EventSpeech ise “konuşma bir fiziksel harekettir” fikrini öne çıkarıyor.
Bir insan konuşurken sadece kelimeleri söylemez. Dudaklar, çene, yüz kasları ve mikro ifadeler konuşmanın ritmini ve duygusunu etkiler. Eğer bu hareketler daha hassas ölçülebilirse, yapay zekâ daha doğal ve daha duygulu sesler üretebilir.
Bu teknoloji gelecekte şu alanlarda araştırma değeri taşıyabilir:
- Daha doğal metinden konuşma üretimi
- Video dublaj sistemleri
- Konuşan avatarlar
- Duygu aktarımı daha güçlü ses üretimi
- Düşük ışıkta veya hızlı yüz hareketlerinde daha sağlam görsel-ses hizalaması
- Yardımcı iletişim teknolojileri
Ancak aynı zamanda dikkatli olunması gereken bir alan. Çünkü insan sesi ve yüz hareketleri kişisel kimlik unsurlarıdır. Bu tür sistemler kötüye kullanılırsa sahte ses, izinsiz dublaj veya kimlik taklidi gibi riskler doğabilir.
Dikkat Edilmesi Gereken Noktalar
Bu makale etkileyici sonuçlar sunsa da bazı sınırlamalar içeriyor.
İlk olarak, çalışma arXiv preprint olarak görünmektedir. Nihai hakemli yayın durumu ayrıca doğrulanmalıdır.
İkinci olarak, gerçek event camera veri seti henüz sınırlı ölçekte. Makalede gerçek veri seti yaklaşık 2.8 bin klip ve 4 saatlik kayıt içeriyor. Bu önemli bir başlangıç olsa da, farklı diller, aksanlar, yaş grupları, yüz tipleri, ışık koşulları ve kayıt ortamları için daha büyük veri gerekir.
Üçüncü olarak, sistemin bazı bölümleri sentetik event verilerine dayanıyor. Sentetik veriler yararlı olsa da gerçek sensör gürültüsü, ışık değişimi ve cihaz özelliklerini tamamen yansıtmayabilir.
Dördüncü olarak, event camera donanımı herkesin kolayca erişebileceği bir cihaz değildir. Bu nedenle yöntemin yaygın kullanımı için donanım maliyeti ve pratik kurulum önemli bir konudur.
Beşinci olarak, konuşma üretimi etik ve güvenlik açısından hassas bir alandır. Gerçek kişilerin sesi, yüz hareketi veya kimlik özellikleri kullanılıyorsa açık rıza, veri güvenliği ve kötüye kullanım önleme mekanizmaları gerekir.
Sonuç
EventSpeech çalışması, yapay zekâ ile konuşma üretiminde standart kamera görüntülerinin ötesine geçen yeni bir yaklaşım öneriyor. Araştırmacılar, event camera verilerinin dudak ve yüz hareketlerindeki hızlı mikro değişimleri daha hassas yakalayabileceğini ve bunun daha doğal, daha senkron, daha duygulu konuşma üretimine katkı sağlayabileceğini savunuyor.
Makaledeki deneyler, EventSpeech’in hem sentetik hem de gerçek event camera verilerinde güçlü sonuçlar verdiğini gösteriyor. Özellikle hareket bulanıklığı, düşük ışık ve hızlı artikülasyon gibi zor koşullarda event tabanlı yaklaşımın avantajlı olabileceği görülüyor.
Verianla açısından bu makalenin ana mesajı şu:
Geleceğin konuşma üretim sistemleri yalnızca metni okumakla yetinmeyebilir. İnsan konuşmasını daha iyi taklit etmek için yüz hareketlerinin çok küçük ve hızlı fiziksel izlerini de kullanabilir. Ancak bu ilerleme, etik kullanım ve kimlik güvenliği sorumluluğuyla birlikte düşünülmelidir.
Kaynak ve Yöntem Notu
Bu içerik, Jingping Fang, Lin Chen, Chenyang Xu, Tong Zhao, Weidong Cai ve Xiaoming Chen tarafından hazırlanan “Can We Hear from Events? Generating Speech from Event Camera” adlı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Bu yazı birebir çeviri değildir; makaledeki yöntem, sistem mimarisi, veri seti, tablolar, grafikler ve sonuçlar sadeleştirilerek Türkçe okuyucu için yeniden anlatılmıştır. İçerik bilgilendirme ve eğitim amacı taşır. İnsan sesi üretimi, dublaj, konuşmacı taklidi, biyometrik veri veya yapay zekâ tabanlı medya üretimi gibi alanlarda etik, hukuki ve güvenlik gereklilikleri dikkate alınmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir