

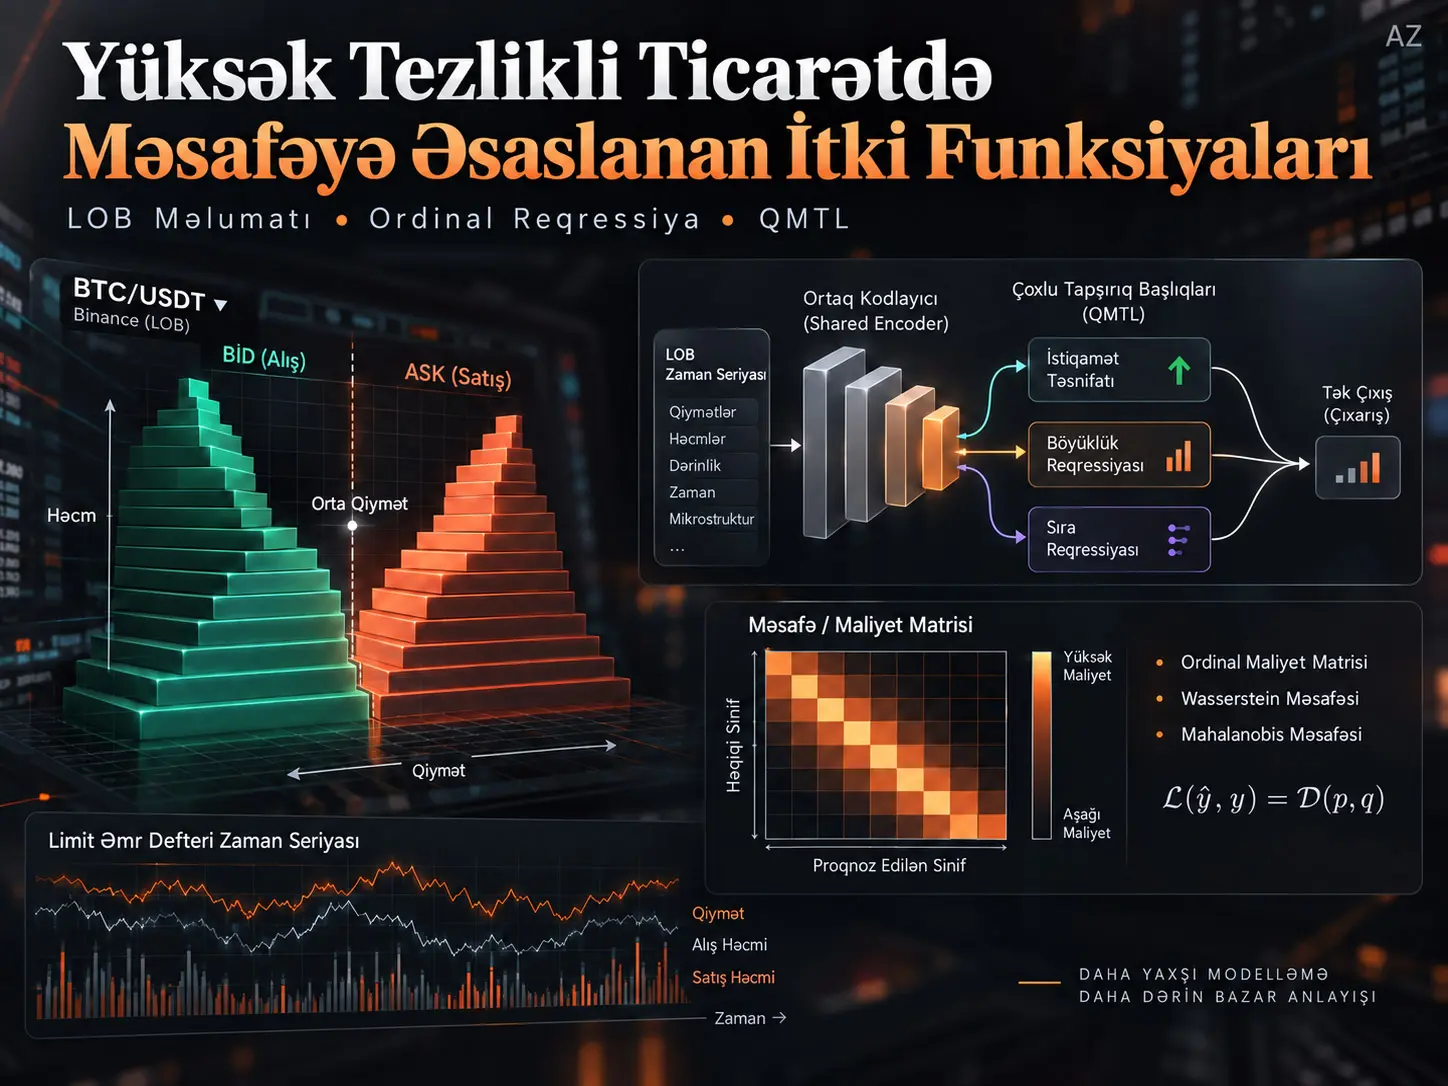
Bu tədqiqat yüksək tezlikli ticarətdə (High-Frequency Trading, HFT) qısamüddətli bazar istiqamətini proqnozlaşdıran dərin öyrənmə modellərinin çıxarış mərhələsində arxitekturanı böyütmədən təlim zamanı necə təkmilləşdirilə biləcəyini araşdırır. Araşdırmada Binance BTC/USDT bazarından CryptoHFTData vasitəsilə əldə edilmiş Limit Order Book (LOB) məlumatlarından istifadə olunmuş; 1 oktyabr-30 noyabr 2025 dövründəki sifariş kitabı axını 250 ms intervallarla nümunələnmiş və gələcək orta qiymət hərəkəti −1, 0 və +1 olmaqla üç sinfə bölünmüşdür. Əsas üsullar siniflər arasındakı səhvlərin eyni əhəmiyyət daşımadığını nəzərə alan Ordinal Log-Loss (OLL) ilə məlumat paylanmalarından törədilən xərc matrisləri və təlim zamanı eyni tapşırığı yerinə yetirən bir neçə başdan istifadə edən Quasi-Multi-Task Learning (QMTL) yanaşmasıdır. Təcrübələrdə Wasserstein məsafəsi ilə yaradılmış xərc matrisi standart çarpaz entropiyaya və digər xərc matrisi dizaynlarına qarşı ümumilikdə ən ardıcıl performansı göstərmiş; QMTL isə bəzi arxitektura və metriklərdə çoxbaşlı təlimdən sonra yalnız bir baş saxlanıldıqda belə faydalı ola biləcəyinə dair eksperimental sübut təqdim etmişdir. Bununla belə, nəticələr bir kriptoaktiv, bir birja, iki aylıq tarixi məlumat və təsnifat metrikləri ilə məhduddur; tədqiqat real vaxt rejimində sifariş icrasını və ya xalis ticarət gəlirliliyini sübut etmir.
Limit Sifariş Kitabı (Limit Order Book, LOB)müəyyən aktivə aid gözləyən limit alış və satış sifarişlərini qiymət səviyyələri və həcmləri ilə təmsil edən elektron bazar strukturudur. Ordinal Log-Loss (OLL)təsnifat səhvlərini xərc matrisi vasitəsilə müxtəlif şiddətlərdə cəzalandıra bilən ordinal təsnifat itkisidir. Quasi-Multi-Task Learning (QMTL) isə eyni hədəfi proqnozlaşdıran bir neçə başı ortaq kodlayıcı ilə birlikdə öyrədib, çıxarış mərhələsində bu əlavə başları çıxarmağa imkan verən çoxtapşırıqlı təlim yanaşmasıdır.
| Element | Mənbədə istifadə edilən dəyər |
|---|---|
| Bazar | Binance BTC/USDT |
| Məlumat mənbəyi | CryptoHFTData |
| Dövr | 1 oktyabr-30 noyabr 2025 |
| Zaman nümunələnməsi | 250 ms |
| LOB səviyyəsi | İlk 10 səviyyə |
| Giriş pəncərəsi | 100 LOB ani görüntüsü |
| Pəncərə addımı | 20 nümunə |
| Etiketlər | −1, 0, +1 |
| Etiketləmə | Triple Barrier Method; α = 0.001, k = 100 |
| Sınaqdan keçirilən modellər | Baseline CNN, DeepLOB, MLPLOB |
Problem niyə yalnız daha böyük model qurmaqdan ibarət deyil?
Yüksək tezlikli ticarətdə modelin proqnoz keyfiyyəti qədər proqnozun nə qədər sürətlə istehsal edilməsi də vacibdir. Böyük neyron şəbəkəsi təsnifat dəqiqliyini artırsa belə, çıxarış müddətini uzadırsa, gecikməyə həssas istifadə üçün praktik dəyərini itirə bilər. Buna görə tədqiqatın məqsədi yeni və daha böyük HFT arxitekturası hazırlamaq deyil. Araşdırma mövcud arxitekturaların təlim prosedurunu dəyişdirərək eyni çıxarış arxitekturası ilə daha yaxşı proqnoz davranışının əldə edilə bilib-bilməyəcəyini araşdırır.
Bu seçim tədqiqatı bir-birini tamamlayan iki istiqamətə aparır. Birinci istiqamət −1, 0 və +1 bazar istiqaməti siniflərinin təbii sırasının olduğunu nəzərə alan ordinal reqressiyadır. İkinci istiqamət isə modelin yalnız təlim zamanı bir neçə çıxış başı ilə işlədiyi QMTL-dir. Hər iki yanaşma yerləşdirmə zamanı model gövdəsini mütləq böyütmədən təlim məlumatını zənginləşdirməyi hədəfləyir.
LOB məlumatı model girişinə necə çevrilir?
Bir LOB ani görüntüsündə hər səviyyə üçün alış qiyməti, alış həcmi, satış qiyməti və satış həcmi olur. Tədqiqat ilk \(N=10\) səviyyədən istifadə edir. Beləliklə, bir LOB görüntüsü \(4N=40\) xüsusiyyət daşıyır. Model girişi yaradılarkən ardıcıl \(W=100\) görüntü birləşdirilir və giriş tenzoru \(4N \times W = 40 \times 100\) ölçüsünə çatır.
Xam CryptoHFTData axını yalnız müntəzəm ani görüntülərdən ibarət deyil; saatlıq tam görüntülərlə aradakı dəyişiklik yeniləmələrini birlikdə ehtiva edir. Tədqiqatda bu hadisə əsaslı axın əvvəlcə yenidən qurulur, sonra \(\delta t=250\,\mathrm{ms}\) intervallarla müntəzəm nümunələnir. Bir intervalda bir neçə dəyişiklik varsa son vəziyyət seçilir; dəyişiklik yoxdursa əvvəlki LOB vəziyyəti daşınır.
Giriş pəncərəsinin uzunluğu 100 nümunədir və yeni məlumat nöqtəsi yaratmaq üçün pəncərə 20 nümunə irəlilədilir. Buna görə qonşu girişlər qismən üst-üstə düşür. Tədqiqat bu seçimi məlumat miqdarını artırmaq və kiçik zaman sürüşmələrinə qarşı daha dayanıqlı nümunələr yaratmaq üçün istifadə edir.
Orta qiymət və gələcək hərəkət sinifləri
Ən yaxşı satış qiyməti \(p_t^{a1}\), ən yaxşı alış qiyməti \(p_t^{b1}\) ilə göstərildikdə spred:
\[ s_t=p_t^{a1}-p_t^{b1} \]
və orta qiymət:
\[ m_t=\frac{p_t^{a1}+p_t^{b1}}{2} \]
kimi tərif olunur. Tədqiqatın məqsədi gələcək qiymət səviyyəsini birbaşa reqressiya ilə proqnozlaşdırmaq deyil, orta qiymətin yaxın gələcəkdə əhəmiyyətli şəkildə aşağı, sabit və ya yuxarı hərəkət edib-etməyəcəyini təsnif etməkdir.
Girişlər standart z-balı ilə normallaşdırılır:
\[ \tilde{x}_i=\frac{x_i-\mu}{\sigma} \]
Mənbə təlim, doğrulama və test bölmələrinin öz \(\mu\) və \(\sigma\) dəyərləri ilə ayrıca normallaşdırıldığını bildirir.
Triple Barrier Method ilə etiketlərin yaradılması
Tədqiqat yalnız gələcək orta qiymət dəyişikliyinə baxmaq əvəzinə Triple Barrier Method (TBM) istifadə edir. Mövcud orta qiymət \(m_t\) və nisbi hədd \(\alpha\) üçün yuxarı və aşağı baryerlər:
\[ u_t=m_t(1+\alpha) \]
\[ \ell_t=m_t(1-\alpha) \]
şəklindədir. Mənbə təcrübələrində \(\alpha=0.001\) və zaman üfüqü \(k=100\) seçilmişdir. Gələcək qiymət sırası boyunca əvvəlcə yuxarı baryer aşılırsa etiket \(+1\), əvvəlcə aşağı baryer aşılırsa \(−1\), zaman baryerinədək heç biri aşılmırsa \(0\) yaradılır. Beləliklə, etiket yalnız gələcək qiymətin müəyyən andakı dəyərindən deyil, müəyyən edilmiş üfüq daxilində hansı qiymət baryerinin əvvəl baş verməsindən asılıdır.
Ordinal Reqressiya Bu HFT Problemində Niyə Vacibdir?
Ordinal reqressiya bu problemdə vacibdir, çünki −1, 0 və +1 sinifləri təbii olaraq \(−1 \prec 0 \prec +1\) sırasına malikdir və bütün təsnifat səhvləri eyni iqtisadi istiqaməti təmsil etmir. Həqiqi sinif +1 olduqda 0 proqnozlaşdırmaqla, həqiqi sinif +1 olduqda −1 proqnozlaşdırmaq eyni məsafəli səhv deyil; tədqiqat bu quruluşu itki funksiyasına daşıyaraq modelin səhvlərin şiddətini də öyrənməsini hədəfləyir.
Standart çoxsinifli çarpaz entropiya düzgün sinfə verilən ehtimalı mükafatlandırır, lakin yanlış siniflərin bir-birindən nə qədər uzaq olduğunu birbaşa istifadə etmir. Mənbədə klassik çarpaz entropiya:
\[ \mathcal{L}_{CE}=-\mathbf{y}^{T}\log(\mathbf{p}) \]
kimi yazılır. Burada \(\mathbf{y}\) həqiqi sinfin one-hot təsviri, \(\mathbf{p}\) isə modelin sinif ehtimallarıdır.
Tədqiqatda istifadə edilən Ordinal Log-Loss isə \(\mathbf{C}\) xərc matrisi əlavə edir:
\[ \mathcal{L}_{OLL} =-\sum_{l\in\mathcal{L}}\log(1-p_l)c_{y,l}^{\alpha} \]
Mənbə tədqiqatında OLL üçün \(\alpha=1\) götürülür. Beləliklə ifadə:
\[ \mathcal{L}_{OLL} =-\mathbf{y}^{T}\mathbf{C}\log(\mathbf{1}-\mathbf{p}) \]
formasına endirilir. Bu tənlikdə \(c_{y,l}\), həqiqi sinif \(y\) olduqda \(l\) sinfinə yönələn ehtimalın nə qədər sərt cəzalandırılacağını müəyyən edir. Araşdırmanın mühüm hissəsi məhz bu xərclərin necə hesablanmasına həsr olunub.
Dörd xərc matrisi yanaşması
Tədqiqat dörd üsulu müqayisə edir: Linear (L), SLACE (S), Mahalanobis (M) və Wasserstein (W). Bütün matrislər yalnız təlim məlumatından hesablanır və məlumat sızmasının qarşısını almaq üçün doğrulama və ya test məlumatı xərc matrisinin yaradılmasında istifadə edilmir. Müqayisəni asanlaşdırmaq üçün hər matris öz ən böyük elementinə bölünərək \([0,1]\) aralığına miqyaslanır.
Linear üsul yalnız sinif sırasına əsaslanır:
\[ c_{i,j}=|i-j| \]
Bu yanaşma −1 ilə +1 arasındakı səhvi qonşu siniflər arasındakı səhvdən daha sərt cəzalandırır; lakin siniflərin məlumat paylanmalarının əslində nə qədər oxşar olduğunu istifadə etmir.
SLACE əsaslı üsulsinif tezliklərindən törədilən proximity dəyərlərindən istifadə edir. Məlumat dəstindəki kəskin sinif balanssızlığı səbəbindən yaranan xərc matrisi nəzərəçarpacaq dərəcədə asimmetrikdir. Təcrübələr bu xüsusiyyətin xüsusilə neytral sinfə həddindən artıq yönəlmə ilə əlaqəli ola biləcəyini göstərir.
Mahalanobis yanaşması\(40\times100\) ölçülü girişi uzunluğu \(4000\) olan vektora çevirir və sinif təmsilçiləri arasındakı fərqi məlumat kovariasiyası ilə miqyaslayır:
\[ c_{i,j} = \sqrt{(\bar{\mathbf v}_i-\bar{\mathbf v}_j)^T \mathbf{\Sigma}^{-1} (\bar{\mathbf v}_i-\bar{\mathbf v}_j)} \]
Burada \(\mathbf{\Sigma}\) girişlərin təxmini kovariasiya matrisidir. Mənbə mətni \(\bar{\mathbf v}_j\) kəmiyyətini müvafiq sinifdəki girişlərin ortası kimi tərif edir. Bununla belə, mənbənin Tənlik (5.12)-də bu orta üçün nümunə sayına bölmə həddi görünmür; bu notasiya fərqi burada səssizcə düzəldilməyib.
Wasserstein Əsaslı Xərc Matrisi Necə Yaradılır?
Wasserstein əsaslı xərc matrisi hər sinfin LOB girişlərini birölçülü Order Book Imbalance təmsilçisinə çevirir, −1, 0 və +1 sinifləri üçün ayrıca OBI paylanmaları yaradır və siniflər arasındakı xərci bu paylanmaların Wasserstein-1 məsafəsi kimi müəyyən edir. Beləliklə, cəza yalnız sinif indeksindən deyil, siniflərin təlim məlumatındakı statistik ayrılmasından asılı olur.
Birölçülü iki paylanmanın kumulyativ paylanma funksiyaları \(U\) və \(V\) olduqda Wasserstein-1 məsafəsi:
\[ W_1(u,v)=\int_{-\infty}^{+\infty}|U(x)-V(x)|\,dx \]
şəklində ifadə edilir.
LOB girişləri çoxölçülü olduğuna görə tədqiqat əvvəlcə qiymətləri çıxarır və yalnız alış/satış həcmlərindən istifadə edir. Giriş alış/satış istiqaməti, LOB səviyyəsi və zaman oxlarını ehtiva edən \(X_{ijk}\) tenzoruna çevrilir. Tədqiqatda təklif edilən OBI xəritələnməsi:
\[ \mathrm{OBI} = \sum_{i=1}^{2} \sum_{j=1}^{N} \sum_{k=1}^{W} (-1)^i\lambda^{j+k}X_{ijk} \]
şəklindədir. \(\lambda\) daha dərin LOB səviyyələrinin və daha köhnə zaman nümunələrinin təsirini eksponensial şəkildə azaldır. Təcrübələrdə \(\lambda=0.5\) istifadə edilmişdir. Hər etiketin OBI dəyərləri ayrıca paylanma yaradır və xərc:
\[ c_{i,j}=W_1(u_i,u_j) \]
kimi tərif olunur.
Mənbənin Şəkil 6-sında sinfə şərtlənmiş OBI paylanmaları göstərilir. −1 və +1 sinifləri OBI oxunun fərqli istiqamətlərinə sürüşərkən neytral sinif 0 ətrafında daha mərkəzli və daha geniş quyruqlu paylanma göstərir. Bu paylanma quruluşu xərc matrisində qonşu siniflər arasındakı məsafələrin niyə bir-birinə yaxın, lakin sıfırdan mənalı şəkildə fərqli olduğunu izah etmək üçün istifadə olunur.
QMTL Çıxarış Xərcini Artırmadan Necə İstifadə Oluna Bilər?
QMTL təlim zamanı ortaq kodlayıcıya eyni hədəfi proqnozlaşdıran bir neçə çıxış başı bağlayır; təlim tamamlandıqda əlavə başlar çıxarılıb yalnız bir baş istifadə edildiyi üçün yerləşdirilən modelin əsas çıxarış arxitekturasının böyüməsi tələb olunmur. Bu tədqiqatda QMTL ensemble kimi istifadə edilmir; məqsəd çoxbaşlı təlimin ortaq kodlayıcı üzərində yaratdığı təlim təsirini təkbaşlı çıxarışa daşımaqdır.
QMTL-də hər baş eyni −1/0/+1 hədəfini proqnozlaşdırır. Mənbə təlimin sonunda tək başa keçid üçün müxtəlif variantları müzakirə edir; təcrübələrdə ən sadə yanaşma seçilir və başlardan biri təsadüfi saxlanılır. Bu seçim xüsusilə gələcək tədqiqatlar üçün açıq inkişaf sahəsi kimi göstərilmişdir.
Bir neçə başın itkilərini tarazlamaq üçün Gradient Normalization (GradNorm) istifadə olunur. Ümumi çoxtapşırıqlı itki:
\[ \mathcal{L}_{total}=\sum_{i=1}^{m}w_i\mathcal{L}_i \]
kimi düşünülə bilər. GradNorm tapşırıqların nisbi öyrənmə sürətlərinə görə \(w_i\) çəkilərini təlim zamanı tənzimləməyi hədəfləyir. Bu tədqiqatda tapşırıqların hədəfləri eyni olsa da müxtəlif başların öyrənmə sürətləri bərabər olmadığı üçün GradNorm seçilmişdir.
Sınaqdan keçirilən üç arxitektura
Baseline modelLOB girişini emal edən dörd konvolyusiya qatları qrupuna və üç sinfə çıxan tam əlaqəli qata əsaslanır. QMTL uyğunlaşdırılmasında CNN hissəsi ortaq kodlayıcı, son tam əlaqəli hissə isə baş kimi istifadə olunur.
DeepLOBkonvolyusiya qatlarını inception strukturu və LSTM ilə birləşdirir. Araşdırmada CNN və inception hissəsi ortaq gövdə, LSTM ilə son tam əlaqəli hissə isə tapşırıq başı kimi istifadə olunur. Bu seçim hər baş üçün hesablama xərcini artırdığına görə QMTL-nin təlim müddəti DeepLOB-da daha nəzərəçarpacaq artır.
MLPLOBəsasən tam əlaqəli qatlardan və məkan/zaman oxları üzərində növbəli emal aparan MLP strukturundan ibarətdir. Son tam əlaqəli bloklar baş, əvvəlki hissə isə ortaq kodlayıcı kimi götürülür.
Tədqiqatın Metodu və Nəticələri
Məlumatların bölünməsi və sinif balanssızlığı
Tədqiqat 2025-ci ilin oktyabr məlumatını təlim və doğrulama, 2025-ci ilin noyabr məlumatını isə test üçün istifadə edir. Oktyabr məlumatı öz daxilində %80 təlim və %20 doğrulama olaraq bölünmüşdür. Test bölməsinin ümumi məlumatın təxminən yarısını təşkil etməsi klassik maşın öyrənməsi tədqiqatlarına görə qeyri-adidir; mənbə bunu məlumat miqdarının çox böyük, əsas darboğazın isə təlim hesablama xərci olması ilə izah edir.
| Bölmə | LOB ani görüntüsü | Model girişi |
|---|---|---|
| Təlim | 8.570.879 | 428.540 |
| Doğrulama | 2.142.720 | 107.132 |
| Test | 10.499.327 | 524.962 |
| Cəmi | 21.212.926 | 1.060.634 |
| Bölmə | −1 | 0 | +1 |
|---|---|---|---|
| Təlim | 5.400 (%1,3) | 417.869 (%97,5) | 5.271 (%1,2) |
| Doğrulama | 1.050 (%1,0) | 104.936 (%98,0) | 1.146 (%1,1) |
| Test | 5.932 (%1,1) | 513.518 (%97,8) | 5.512 (%1,0) |
Məlumatların təxminən %98-nin 0 sinfində olması xam dəqiqliyin təkbaşına yanıltıcı olmasına səbəb ola bilər. Model bütün nümunələri 0 kimi proqnozlaşdıraraq çox yüksək accuracy əldə edə bilər, lakin −1 və +1 istiqamət hərəkətlərini ayırd etmək qabiliyyətinə malik olmaya bilər. Buna görə tədqiqat sinif çəkilərindən istifadə edir:
\[ w_i=\frac{N}{C\,n_i} \]
Burada \(N\) ümumi nümunə sayı, \(C\) sinif sayı və \(n_i\) müvafiq sinfin nümunə sayıdır.
Qiymətləndirmə metrikləri
Accuracy, precision, recall və F1-score ilə yanaşı Cohen's kappa və Restricted Accuracy (RA) istifadə olunur. Cohen's kappa:
\[ \kappa=\frac{p_o-p_e}{1-p_e} \]
ifadəsi ilə müşahidə olunan təsnifat uyğunluğunun yalnız təsadüfən gözlənilən uyğunluqdan nə qədər yüksək olduğunu ölçür. Xüsusilə kəskin balanssız məlumat dəstlərində yalnız accuracy dəyərinə nisbətən daha izahedici ola bilər.
Restricted Accuracy tədqiqatın tərifinə görə xüsusilə −1 və +1 istiqamət proqnozlarının bir-birindən nə qədər düzgün ayrıldığını izləmək üçün hazırlanmışdır. Mənbənin Tənlik (3.16)-nın məxrəcində eyni \(n_{-1,+1}\) həddinin iki dəfə çap edildiyi görünür. Buna görə düstur burada mənbədə olmayan düzəliş edilərək yenidən yazılmamış; metrik müəllifin şifahi izahına əsasən şərh edilmişdir.
Təlim protokolu
- Avadanlıq: NVIDIA A40 GPU klasteri; hər fərdi model təlimi bir GPU üzərində.
- Optimizer: Adam.
- Learning rate: \(10^{-3}\).
- Weight decay: \(10^{-4}\).
- Early stopping: birləşmiş doğrulama itkisi üzərində patience = 10.
- Test mərhələsi: ən yaxşı doğrulama itkisinə malik checkpoint.
- QMTL test proqnozu: başlardan yalnız biri və tədqiqatdakı eksperimental protokolda təsadüfi seçim.
- Xəta çubuqları: təkrar təcrübələrinin ortalaması üçün %95 etibar intervalı.
- Baseline xərc/baş kombinasiyaları: hər kombinasiya 100 təkrar.
- Qabaqcıl arxitektura kombinasiyaları: hər kombinasiya 40 təkrar.
Mənbənin əsas eksperimental setup bölməsində mini-batch ölçüsü və təsadüfilik seed-i açıq şəkildə bildirilməmişdir. Bu məlumatlar təkrar istehsal ediləbilənliyin tamlığı baxımından mənbədə çatışmayan parametrlərdir; burada dəyər uydurulmayıb.
Məlumatlardan əldə edilən xərc matrisləri
Aşağıdakı dəyərlər yalnız təlim məlumatından hesablanmış və hər matrisin maksimum dəyəri 1 olacaq şəkildə normallaşdırılmışdır. Sətirlər həqiqi sinfi, sütunlar xərc tətbiq olunan sinfi göstərir.
| Həqiqi \ Hədəf | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,500 | 1,000 |
| 0 | 0,500 | 0 | 0,500 |
| +1 | 1,000 | 0,500 | 0 |
| Həqiqi \ Hədəf | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,138 | 1,000 |
| 0 | 0,860 | 0 | 0,865 |
| +1 | 0,995 | 0,137 | 0 |
| Həqiqi \ Hədəf | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,796 | 1,000 |
| 0 | 0,796 | 0 | 0,921 |
| +1 | 1,000 | 0,921 | 0 |
| Həqiqi \ Hədəf | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,639 | 1,000 |
| 0 | 0,639 | 0 | 0,625 |
| +1 | 1,000 | 0,625 | 0 |
Baseline təcrübələrində itki funksiyalarının davranışı
Mənbənin Şəkil 7-sində 1 ilə 5 QMTL başı arasındakı konfiqurasiyalar müqayisə edilir. Hər baş-itki kombinasiyası 100 dəfə işə salındığı üçün qrafikdəki meyllər tək təlim gedişinə deyil, təkrarların ortalamasına əsaslanır.
Wasserstein üsulu F1-score və Cohen's kappa baxımından ən güclü və ən ardıcıl üsuldur. Başların sayı artdıqca F1 dəyərində də tədricən artım görünür. Mahalanobis bəzi konfiqurasiyalarda yaxınlaşsa da təcrübələr arasında daha yüksək variasiya göstərir.
SLACE əsaslı üsul isə mühüm sinif balanssızlığı problemi ortaya çıxarır. Təxminən %98 accuracy verməsinə baxmayaraq Cohen's kappa sıfıra yaxın, Restricted Accuracy isə sıfırdır. Mənbənin proqnoz yoxlaması modelin faktiki olaraq yalnız 0 sinfini seçdiyini göstərir. Bu nəticə kəskin balanssız təsnifatda yüksək accuracy-nin təkbaşına niyə etibarlı uğur ölçüsü olmadığının aydın nümunəsidir.
Linear üsul da birbaşlı vəziyyətdə aşağı performans göstərdiyi halda, başların sayı artdıqca precision və Restricted Accuracy dəyərlərində nəzərəçarpacaq yaxşılaşma təmin edir. Wasserstein üsulu artıq güclü olan birbaşlı nəticələrini çoxbaşlı təlimdə daha təvazökar, lakin müşahidə edilə bilən şəkildə yaxşılaşdırır.
Accuracy baxımından üsulların sıralanması digər metriklərdən fərqlidir. Mənbə mətnində SLACE və Linear təxminən %98, Wasserstein təxminən %87, Cross-Entropy ilə Mahalanobis isə təxminən %76 səviyyəsində bildirilir. Bu fərq yüksək accuracy-nin əsasən dominant 0 sinfinin proqnozlaşdırılmasından qaynaqlana biləcəyini və istiqamət hərəkətlərini tutma uğuru ilə birlikdə qiymətləndirilməli olduğunu göstərir.
QMTL-nin təlim xərci
Çoxbaşlı təlim çıxarış xərcinə daşınmasa da təlim ödənişsiz deyil. Mənbənin Şəkil 8-i başların sayı artdıqca faktiki təlim müddətinin təxminən xətti şəkildə yüksəldiyini göstərir. Bununla belə, bir çox konfiqurasiyada başların sayı artdıqca erkən dayandırmaya çatmaq üçün lazım olan epoch sayı azalır. Müəllif bu davranışın daha sürətli yaxınlaşma, çoxbaşlı təlimin requlyarlaşdırıcı təsiri və ya hər iki mexanizmin birləşməsi ilə əlaqəli ola biləcəyini müzakirə edir; tədqiqat bu mexanizmlərdən hansının dəqiq səbəb olduğunu göstərmir.
DeepLOB və MLPLOB ilə qabaqcıl arxitektura təcrübələri
Hesablama xərcini məhdudlaşdırmaq üçün qabaqcıl arxitekturalarda yalnız standart Cross-Entropy (C) ilə ən uğurlu xərc yanaşması olan Wasserstein (W) müqayisə edilmişdir. Mənbənin Şəkil 9-da Baseline, DeepLOB və MLPLOB üçün 1-5 baş arasında cəmi 40 təkrar üzrə nəticələr təqdim olunur.
Ümumi nümunədə Wasserstein itkisi eyni arxitekturanın Cross-Entropy versiyasından metriklərin çoxunda daha yaxşı nəticə verir. Ən nəzərəçarpan ümumi istisna recall-dır; hər üç arxitekturada Cross-Entropy recall baxımından daha yüksək dəyərlərə çatır. DeepLOB üçün precision və Restricted Accuracy, Baseline üçün də Restricted Accuracy bəzi konfiqurasiyalarda ümumi Wasserstein üstünlüyünün istisnalarıdır.
MLPLOB-da Wasserstein ilə başların sayı artdıqca F1-score, Cohen's kappa və accuracy kimi bəzi metriklər yüksəlir, Restricted Accuracy isə azalır. Mənbə bunu artıq təxminən %98 təşkil edən neytral sinfin daha yaxşı təsnifləndirilməsi ilə daha seyrək ±1 siniflərinə diqqət yönəltmə arasında yaranan performans mübadiləsi ilə əlaqələndirir.
DeepLOB-da bəzi istiqamət-hərəkət metrikləri başların sayı ilə yaxşılaşarkən accuracy və Cohen's kappa azala bilər. Buna görə QMTL təsiri arxitekturadan və seçilən metrikdən asılıdır; tədqiqat “daha çox baş həmişə daha yaxşıdır” nəticəsini dəstəkləmir.
Modellərarası müqayisədə Baseline F1 və precision baxımından güclüdür; DeepLOB accuracy və Cohen's kappa baxımından yüksək nəticələr verir; MLPLOB isə recall və xüsusilə Restricted Accuracy baxımından güclü davranır. Buna görə mənbə bir arxitekturanı bütün məqsədlər üçün üstün elan etmir.
Bu Nəticələr Gəlirli HFT Strategiyasını Sübut Edirmi?
Xeyr. Tədqiqat tarixi BTC/USDT LOB məlumatında bazar istiqaməti təsnifat metriklərini və təlim davranışını ölçür; xalis mənfəət, əməliyyat xərcləri, bid-ask spread təsiri, slippage, sifariş növbəsi mövqeyi, real ucdan-uca gecikmə və ya canlı sifariş icrası performansı təcrübələrin əsas çıxış dəyişənləri deyil. Buna görə daha yüksək F1, kappa və ya Restricted Accuracy birbaşa gəlirli HFT strategiyası kimi şərh edilə bilməz.
Tədqiqatın dəstəklədiyi nəticələr
- −1, 0 və +1 bazar istiqaməti tapşırığı ordinal struktur kimi modelləşdirilə bilər.
- OLL daxilində xərc matrisinin dizaynı model davranışını güclü şəkildə dəyişə bilər.
- Bu məlumat dəstində Wasserstein əsaslı xərc matrisi araşdırılan alternativlər arasında ümumilikdə ən ardıcıl nəticələri verir.
- QMTL bəzi itki funksiyaları və arxitekturalarda birbaşlı çıxarışdan əvvəl təlimi yaxşılaşdıra bilər.
- Çoxbaşlı təlimdən sonra əlavə başların çıxarılması əlavə başların hesablama xərcinin əsas yerləşdirmə arxitekturasına daşınmasının qarşısını alır.
- Kəskin sinif balanssızlığı səbəbindən accuracy təkbaşına kifayət edən qiymətləndirmə metriği deyil.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
- Nəticələr bütün səhm, valyuta və ya kriptovalyuta bazarlarına avtomatik ümumiləşdirilə bilməz.
- Wasserstein xərc matrisinin hər məlumat dəstində Cross-Entropy-dən üstün olacağı göstərilməmişdir.
- Daha çox QMTL başının hər arxitektura və hər metrikdə performansı artırdığı göstərilməmişdir.
- Təsnifat performansındakı artım real ticarət mənfəətinin artacağını sübut etmir.
- Tədqiqat canlı HFT infrastrukturunda ucdan-uca gecikmə üstünlüyünü təsdiqləməmişdir.
- Yalnız BTC/USDT və iki aylıq dövr araşdırıldığı üçün müxtəlif bazar rejimləri üçün ayrıca doğrulama tələb olunur.
Hesablama xərci və davamlılıq
Tez model təlimlərinin enerji xərcini də ölçür. Son təcrübə qrupunda Baseline cəmi 150,44 saat təlim və 16,55 kWh; DeepLOB 726,02 saat və 177,87 kWh; MLPLOB 27,7 saat və 5,54 kWh sərf etmişdir. Üçü birlikdə 904,16 saat GPU təlimi və 199,96 kWh enerji təşkil etmişdir.
| Model | Ümumi təlim müddəti | Orta güc | Enerji |
|---|---|---|---|
| Baseline | 150,44 saat | 110 W | 16,55 kWh |
| DeepLOB | 726,02 saat | 245 W | 177,87 kWh |
| MLPLOB | 27,7 saat | 200 W | 5,54 kWh |
| Cəmi | 904,16 saat | - | 199,96 kWh |
Müəllif inkişaf zamanı həyata keçirilmiş əlavə təlimləri nəzərə almaq üçün ümumi model təlim istehlakını təxminən 399,92 kWh olaraq qiymətləndirir. İnkişaf kompüterinin təxmini istehlakı da əlavə edildikdə layihə üçün təxminən 487,92 kWh hesablanır. Bu bölmənin məqsədi çıxarışda kiçik model istifadəsinin mümkün enerji faydası ilə daha mürəkkəb təlim prosedurlarının əlavə təlim xərcinin birlikdə qiymətləndirilməli olduğunu göstərməkdir.
Mənbə və Metod Qeydi
Orijinal başlıq: Distance-based Loss functions for High-Frequency Trading
Müəllif: Jonathan Rodríguez Barja
Tez rəhbəri: Daniel P. Palomar
Yerli tutor: Jordi Castro
Qurumlar: Universitat Politècnica de Catalunya - BarcelonaTech (UPC); tədqiqat HKUST-də həyata keçirilmişdir. Sənəd Centre de Formació Interdisciplinària Superior (CFIS) çərçivəsindəki Data Science & Engineering / Engineering Physics ikili bakalavr proqramına aiddir.
Mənbə növü: Bakalavr buraxılış tezi / Bachelor thesis / Treball Final de Grau.
Tarix: PDF üz qabığının tarixi fevral 2026; rəsmi repository qeydiyyat tarixi 26 fevral 2026.
Platforma: UPCommons, Universitat Politècnica de Catalunya-nın institusional akademik arxivi.
Daimi qeyd identifikatoru: 2117/457644.
DOI: Mənbədə və rəsmi repository qeydində DOI göstərilməyib.
Jurnal / cild / nömrə: Tətbiq edilmir; tədqiqat jurnal məqaləsi deyil.
Rəyçilik statusu: Rəyli jurnal məqaləsi deyil. Universitet bakalavr buraxılış işidir.
Giriş və lisenziya: Rəsmi repository qeydi açıq giriş təmin edir və əsəri CC BY-NC-ND 4.0 lisenziyası altında göstərir. NoDerivatives şərtinə görə Verianla mətni mənbə mətninin tərcüməsi və ya yaxın yenidən yazılması kimi yaradılmamış; mənbə fiqurları dəyişdirilərək və ya yenidən stilizə edilərək istifadə olunmamışdır. Elmi metod, yoxlanıla bilən rəqəmlər, tənliklər və nəticələr müstəqil öyrədici izahla yenidən strukturlaşdırılmışdır.
Məlumat mənbəyi: CryptoHFTData vasitəsilə Binance BTC/USDT LOB məlumatı. Tədqiqatda istifadə olunan tarix aralığı 1 oktyabr-30 noyabr 2025-dir.
Proqram təminatı və inkişaf: Tədqiqat LibMTL əsaslı çərçivəni uyğunlaşdırmış; QMTL, early stopping və Weights & Biases ilə logging kimi komponentlər əlavə etmişdir. Mənbədə ayrıca kod əlçatanlığı və ya kod lisenziyası bəyanı verilməmişdir.
Maliyyələşdirmə: Mənbədə standart formalı ayrıca maliyyələşdirmə bəyanı yoxdur. Təşəkkür bölməsində CFIS dəstəyi göstərilir; bu ifadə tədqiqat fondu və ya layihə qrantı kimi yenidən şərh edilməmişdir.
Maraqların toqquşması: Mənbədə ayrıca maraqların toqquşması bəyanı aşkar edilməmişdir.
Əsas metodoloji məhdudiyyətlər: Bir aktiv və bir birja; yalnız iki aylıq tarixi dövr; təxminən %98 neytral sinif ehtiva edən güclü sinif balanssızlığı; real ticarət gəlirliliyi əvəzinə təsnifat metrikləri; QMTL-də çıxarış başının təsadüfi seçilməsi; Wasserstein xərcinin tətbiqə xas OBI xəritələnməsindən asılı olması; mini-batch ölçüsü və random seed kimi bəzi təlim təfərrüatlarının açıq şəkildə bildirilməməsi.
Mənbədaxili notasiya xəbərdarlığı 1: Tənlik (3.16)-dakı Restricted Accuracy məxrəcində bir çarpaz təsnifat həddinin təkrarlandığı görünür. Verianla bu ifadəni səssizcə düzəltməyib.
Mənbədaxili notasiya xəbərdarlığı 2: Tənlik (5.12) mətndə sinif ortası kimi izah edilən \(\bar{\mathbf v}_j\) üçün cəm ifadəsi verir, lakin görünən düsturda sinif nümunələrinin sayına bölmə həddi yoxdur. Mahalanobis üsulunun izahında bu fərq ayrıca qorunmuşdur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib