

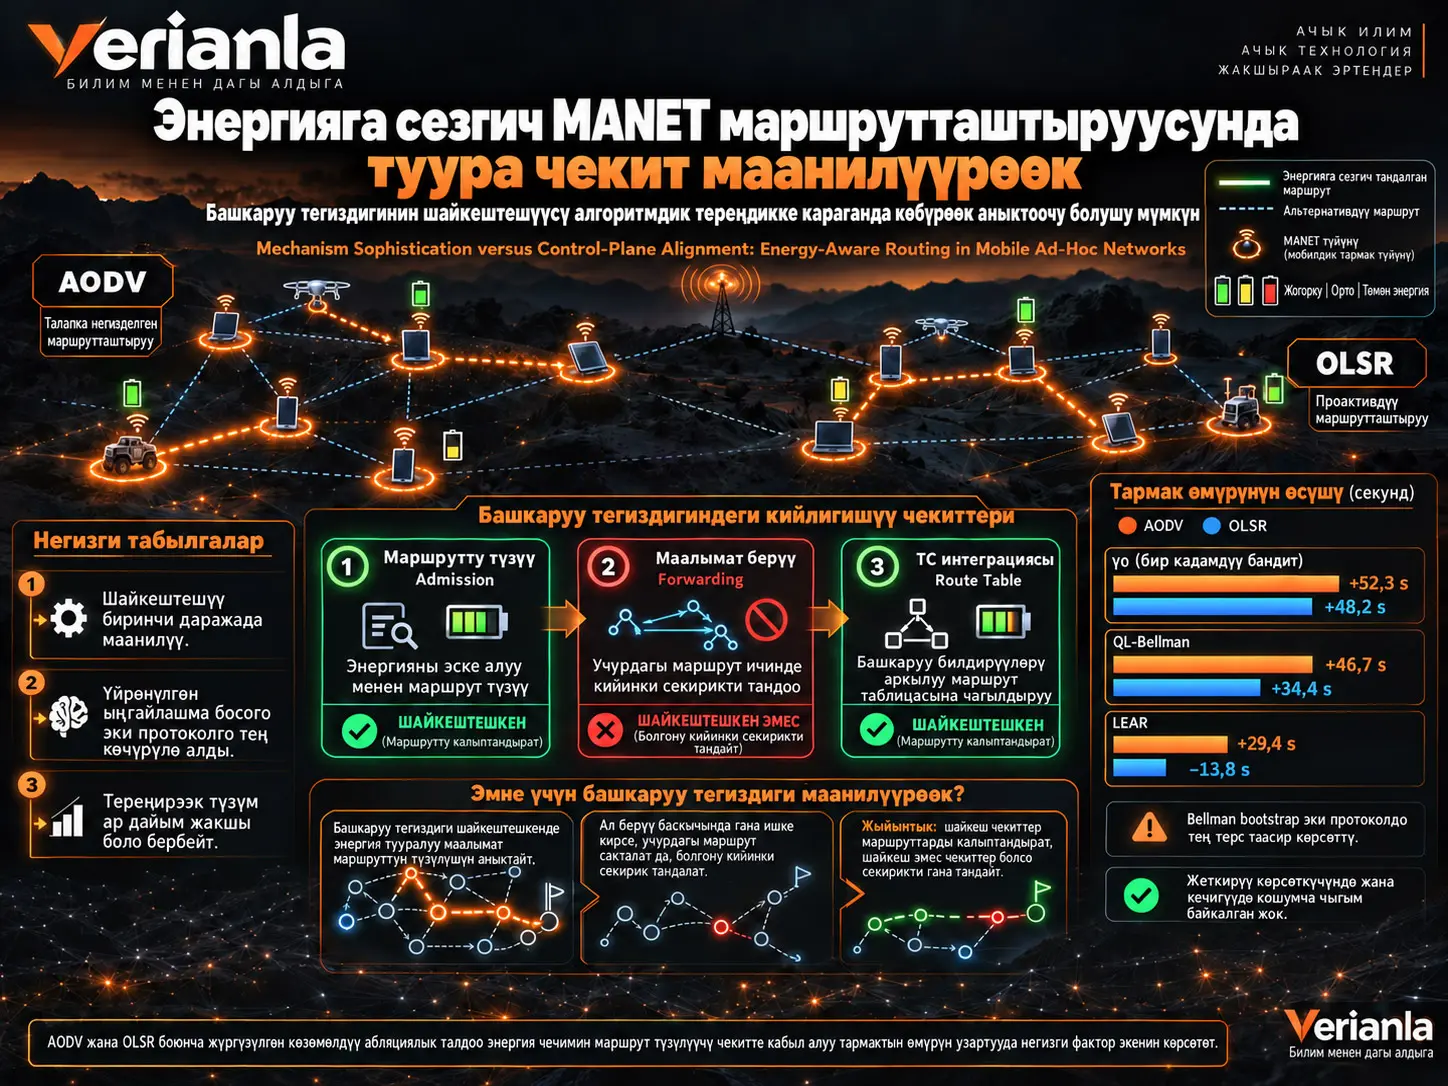
Мобилдик ad hoc тармактарда энергияны үнөмдөө үчүн иштелип чыккан маршрутташтыруу механизмдери улам барган сайын татаал үйрөнүү ыкмаларын колдоно алат. Бирок механизмдин тармактын иштөө мөөнөтүн узартышы анын чындап канчалык өнүккөндүгүнө байланыштуубу, же энергия боюнча чечимди маршрутташтыруу протоколунун туура чекитинде колдонуу маанилүүрөөкпү? Бул изилдөө ушул эки таасирди бири-биринен ажыратуу үчүн AODV жана OLSR протоколдорунда көзөмөлдөнгөн абляциялык талдоо жүргүзөт.
Изилдөөнүн негизги түшүнүгү — башкаруу тегиздигинин шайкештешүүсү. Энергия боюнча чечим протокол маршруттарды түзгөн же route table-ды калыптандырган чекитте колдонулса, ал шайкештештирилген деп эсептелет. AODV-де бул чекит RREQ билдирүүлөрүн кабыл алуу жана кайра жайылтуу учурунда пайда болот. OLSR-де болсо энергия боюнча чечим MPR тандоосуна таасир эткен willingness механизми же topology-control маалыматынын route table-га интеграциясы менен байланышышы керек. Ал эми маалымат пакетин өткөрүү учурунда жасалган next-hop өзгөртүүсү маршрут буга чейин түзүлүп калгандыктан, түзүмдүк жактан кечирээк кийлигишүү болуп саналат.
Авторлор шайкештештирилген жана үйрөнүүчү энергия veto механизми болгон QL-Bellman-ды баштапкы чекит катары алышат. Андан соң аракет, энергия маалыматы, шайкештешүү, үйрөнүү жана Bellman bootstrap сыяктуу компоненттерди бирден алып салып, тармактын иштөө мөөнөтүндөгү утушту кайсы өзгөчөлүк алып келерин өлчөшөт. Эксперименттер ns-3 чөйрөсүндө 50 мобилдик түйүн, алты трафик жүгү жана ар бир шарт үчүн 20 жупташтырылган кокустук seed менен жүргүзүлөт.
Натыйжалар механизмдин туура башкаруу чекитинде жайгашуусу биринчи даражада маанилүү экенин көрсөтөт. Үйрөнүлгөн адаптивдүү энергия босогосу AODV жана OLSR экөөндө тең иштөө мөөнөтүн көбөйтсө, туруктуу босоголуу LEAR AODV-де пайдалуу болгону менен OLSR-де иштөө мөөнөтүн кыскартат. Андан да маанилүүсү, кошуна түйүндүн маанисин келечекке алып өтүүчү Bellman bootstrap эки протоколдо тең көрсөткүчтү начарлатат. Бул эксперименттик режимде эң жогорку орточо иштөө мөөнөтү bootstrap-ты алып салган \(\gamma=0\) бир кадамдуу bandit версиясы менен алынат.
Башкаруу тегиздиги менен маалыматтар тегиздигинин айырмасы
Маршрутташтыруу протоколунда башкаруу тегиздиги кайсы маршруттар бар болорун жана тармактагы маршрутташтыруу маалыматы кантип түзүлөрүн аныктаган механизмдерден турат. Маалыматтар тегиздиги болсо түзүлгөн маршрутташтыруу чечимдерин колдонуп, чыныгы пакеттерди ташууну жүзөгө ашырат.
Ошондуктан энергияга сезгич механизм кайсы тегиздикте жана кайсы баскычта иштегени маанилүү. Түйүн энергиясы аз болгондуктан маршрут түзүлө электе талапкер жолдон чыгарылса, андан кийинки бардык маалымат трафиги колдоно турган маршруттардын топтому өзгөрөт. Ошол эле энергия маалыматы пакет өткөрүлүп жатканда колдонулса, механизм мындан ары кайсы маршруттар бар экенин өзгөртө албайт; ал мурда түзүлгөн варианттардын арасынан гана чечим чыгара алат.
Башкаруу Тегиздигинин Шайкештешүүсү Эмнени Билдирет?
Изилдөөдө механизмдин аракет чекити протоколдун маршрут түзүү же route-state түзүү баскычы менен дал келсе, ал шайкештештирилген деп эсептелет. Бул жөн гана жакшы орун тандоо эмес; аракет чекити механизмдин себептик функциясын өзгөртөт деген пикир айтылат.
AODV-деги шайкештешүү
AODV — реактивдүү протокол. Зарыл болгондо маршрут издөө жүргүзүлүп, RREQ билдирүүлөрү тармакка жайылтылып мүмкүн болгон жолдор түзүлөт.
Энергия veto механизми түйүн RREQ билдирүүсүн кабыл алып кайра жайылтабы же жокпу аныктаса, энергиясы төмөн түйүн талапкер жолдун курамына таптакыр кирбей калышы мүмкүн. Ошентип, энергия боюнча чечим түздөн-түз кайсы маршруттар бар болорун калыптандырат.
Изилдөөдөгү шайкештештирилген AODV механизмдери дал ушул чекитте иштейт.
OLSR-деги шайкештешүү
OLSR болсо проактивдүү протокол. Маршруттарды талап боюнча издебестен, топология тууралуу маалыматты дайыма сактап, Multipoint Relay (MPR) түзүмүн колдонот.
Ошондуктан AODV-деги RREQ veto механизмин OLSR-ге сөзмө-сөз көчүрүү мүмкүн эмес. Функциялык жактан дал келген башкаруу чекиттери — энергия деңгээлин MPR тандоосуна таасир эткен willingness механизми жана topology-control маалыматынын жергиликтүү route table-га интеграциясы менен байланыштыруу.
Бул айырма макаланын негизги оюн түзөт: алгоритмдин протоколдор арасында көчүрүлмөлүүлүгүн чечим эрежеси бирдей экенине гана карап баалоо жетишсиз; чечим жаңы протоколдо дагы эле маршрут түзүү чекитине тийип-тиеби текшерилиши керек.
Туура эмес жерде иштеген механизм
Булакта override варианты энергия боюнча чечимди AODV-де data-forwarding баскычына жылдырат. Бул жерде энергия маалыматы дагы эле бар жана үйрөнүү механизми дагы эле иштей алат; бирок маршрут буга чейин түзүлүп калган.
Бул вариант учурдагы маршруттардын арасында гана next-hop reselection жасай алат. Эксперименттерде иштөө мөөнөтүндөгү утуштун басымдуу бөлүгү жоголушу авторлордун шайкештешүүнү жөн гана гиперпараметр эмес, механизм эмнени жасай аларын аныктаган түзүмдүк өзгөчөлүк катары түшүндүрүшүнүн негизги далилдеринин бири болуп саналат.
QL-Bellman Энергия Veto Механизми Кантип Иштейт?
Эталондук механизм энергия абалын бир нече ири класска бөлүп, эки аракеттин ортосунда онлайн үйрөнүүнү жүргүзгөн бөлүштүрүлгөн admission-control системасы болуп саналат. Аракеттер жөнөкөй: келген башкаруу билдирүүсүн кабыл алуу же veto кылуу.
Энергия абалын дискреттештирүү
Нормалдаштырылган энергия
\[ e\in[0,1] \]
төрт ири абалга бөлүнөт:
\[ s=\lfloor 4e\rfloor. \]
Төрт абалды колдонуу — атайын тандоо. Абалдар өтө майда бөлүнсө, ар бир абалга азыраак кайрылуу болуп, онлайн үйрөнүү үчүн жетиштүү үлгү топтолбой калышы мүмкүн.
Сыйлык сигналы
Энергияга байланышкан сыйлык үч деңгээлдүү:
\[ r= \begin{cases} +1, & e\geq\theta_{\mathrm{hi}},\\ -1, & e<\theta_{\mathrm{lo}},\\ 0, & \text{diğer durumlarda}. \end{cases} \]
Булакта
\[ \theta_{\mathrm{hi}}=0.66, \qquad \theta_{\mathrm{lo}}=0.33 \]
колдонулат.
Bellman жаңыртуусу
Кабыл алуу аракети үчүн:
\[ q_{\mathrm{acc}} \leftarrow (1-\alpha)q_{\mathrm{acc}} + \alpha \left( r+\gamma V_{\mathrm{nbr}} \right), \]
ал эми veto аракети үчүн:
\[ q_{\mathrm{veto}} \leftarrow (1-\alpha)q_{\mathrm{veto}} + \alpha(-r). \]
Бул жердеги
\[ \gamma V_{\mathrm{nbr}} \]
мүчөсү кошуна түйүндүн маанисин учурдагы чечимге алып келүүчү Bellman bootstrap болуп саналат.
Негизги QL-Bellman конфигурациясында
\[ \alpha=0.3,\qquad \gamma=0.9 \]
колдонулат.
\(\gamma=0\) болгондо келечектеги/кошунанын маанисинин bootstrap таасири толугу менен алынып салынат жана механизм бир кадамдуу bandit болуп калат.
Изилдөөнүн Ыкмасы жана Натыйжалары
Абляция дизайны
| Вариант | Энергия сигналы | Туура аракет чекити | Үйрөнүү | Bellman bootstrap | Сыналган идея |
|---|---|---|---|---|---|
| Vanilla | Жок | Жок | Жок | Жок | Өзгөртүлбөгөн протокол |
| QL-Bellman | Бар | Бар | Бар | Бар | Толук эталондук механизм |
| LEAR | Бар | Бар | Жок | Жок | Туруктуу босого |
| \(\gamma_0\) | Бар | Бар | Бар | Жок | Bootstrap керекпи? |
| veto-off | Бар | Бар | Бар | Бар | Үйрөнүү, бирок аракет жасабоо |
| blind | Кокустук | Бар | Жок | Жок | Энергия маалыматынын баалуулугу |
| override | Бар | Туура эмес / forwarding | Бар | Бар | Аракет чекитинин таасири |
Эмне үчүн классикалык “алгоритм жарышы” жүргүзүлбөйт?
Изилдөөдө ар башка программалык системалардын натыйжаларын катар коюунун ордуна, бир эле код базасында compile-time flag-дер аркылуу өзгөчөлүктөр күйгүзүлүп-өчүрүлөт. Бардык flag-дер өчүрүлгөндө бинардык файл өзгөртүлбөгөн ns-3 протоколу менен byte-identical экени текшерилген.
Мындан тышкары, варианттар бирдей кокустук seed-дер менен жупташтырылган. Ошентип, бир эле seed бардык варианттарда бирдей кыймылдуулук жана баштапкы энергия шарттарын түзөт. Айырма өлчөөсү:
\[ \Delta HND = HND_{\mathrm{varyant}} - HND_{\mathrm{vanilla}} \]
түрүндө бир эле эксперименттик шарттагы жупташтырылган айырма аркылуу жүргүзүлөт.
ns-3 эксперименттик чөйрөсү
| Параметр | Маани |
|---|---|
| Симулятор | ns-3.46.1 |
| Түйүндөрдүн саны | 50 |
| Аянт | 1000 × 1000 m |
| Кыймыл | Random Waypoint |
| Ылдамдык | 1–5 m/s |
| Күтүү | 0–2 s |
| Радио | IEEE 802.11g, 54 Mbps |
| Аралык модели | 250 m cap |
| Пакет | 512 B UDP |
| Трафик | Ар бир агымга 4 пакет/s |
| Агымдардын саны | 10, 15, 20, 25, 30, 35 |
| Баштапкы энергия | 3,3–3,7 J |
| Узактыгы | 500 s |
| Кокустук seed | Ар бир уяча үчүн 20 |
Half-Node-Death эмне үчүн колдонулат?
Негизги натыйжалуулук көрсөткүчү Half-Node-Death (HND), башкача айтканда, 50 түйүндүү тармакта 25-түйүн өлгөн убакыт.
Бир түйүндүн өзгөчө эрте же кеч өлүшүнө ашыкча сезгич болбогондуктан, ал тармактын пайдалануу мөөнөтүн чагылдырган кыйла жалпы end-of-life көрсөткүчү болуп саналат.
Булакта жалпы 1560 эксперименттик уячанын баарында 25-түйүн 500 секунддук эксперимент бүтө электе өлгөн. Ошондуктан HND натыйжасы цензураланган же болжолдонгон эмес.
Иштөө мөөнөтүнүн натыйжалары
| Механизм | AODV ΔHND | OLSR ΔHND |
|---|---|---|
| \(\gamma_0\) бир кадамдуу bandit | +52,3 s | +48,2 s |
| QL-Bellman | +46,7 s | +34,4 s |
| LEAR | +29,4 s | −13,8 s |
| Blind veto | +12,2 s | +4,9 s |
| Veto-off | +0,4 s | −0,3 s |
| Override | −2,6 s | Булакта AODV-only |
Эң Чоң Утуш Алгоритмдик Тереңдиктен Келеби?
Бул эксперименттерде жок. Эң жогорку иштөө мөөнөтүнүн утушун толук Bellman жаңыртуусу эмес, кошуна маанисин bootstrap кылбаган \(\gamma=0\) бир кадамдуу bandit версиясы берген. Бирок бул натыйжа “бекемдөөчү үйрөнүү керексиз” дегенди билдирбейт. Туруктуу босогонун ордуна адаптивдүү үйрөнүлгөн чечим эрежеси, өзгөчө OLSR-де, маанилүү салым кошкон.
AODV үчүн салымды ажыратуу
Булактын additive scale талдоосу:
\[ \underbrace{+29.4}_{\text{hizalanmış sabit veto}} + \underbrace{22.9}_{\text{öğrenilmiş kural}} - \underbrace{5.6}_{\text{Bellman bootstrap}} = \underbrace{46.7}_{\text{QL-Bellman toplamı}} \quad\mathrm{s} \]
түрүндө.
Демек, AODV-де туура чекитке энергия босогосун коюу чоң баштапкы утуш жаратат; үйрөнүү мунун үстүнө кошумча утуш берет; көп кадамдуу bootstrap болсо бул утуштун бир бөлүгүн кайра алып кетет.
OLSR үчүн салымды ажыратуу
OLSR-де үйрөнүлгөн, шайкештештирилген TC veto:
\[ +48.2\ \mathrm{s} \]
утуш берсе, Bellman bootstrap:
\[ -13.8\ \mathrm{s} \]
салым кошот жана жалпы QL-Bellman утушу:
\[ +34.4\ \mathrm{s} \]
болот.
OLSR-деги туруктуу LEAR willingness ыкмасы болсо өзүнчө механизм катары
\[ -13.8\ \mathrm{s} \]
натыйжасын берет.
Bellman bootstrap эмне үчүн зыян келтириши мүмкүн?
Булактын түшүндүрмөсүндө эки түзүмдүк себеп алдыга чыгат:
- Аракет болгону admit же veto деген экилик формада; ошондуктан узун көп кадамдуу маани чынжыры пайдалана ала турган бай чечим түзүмү болбошу мүмкүн.
- Мобилдик жана энергияны үзгүлтүксүз сарптаган тармакта кошунанын үйрөнүлгөн мааниси убакыт өткөн сайын тез эскириши мүмкүн. Bootstrap ошол эски маанини hop-тор боюнча жайылтып, кошумча ызы-чуу жаратышы мүмкүн.
Ошондуктан изилдөө шарттарында тайыз, бир кадамдуу үйрөнүү туруктуураак иш чекитин түзгөн.
Туруктуу Энергия Босогосу Эмне Үчүн AODV-де Иштеп, OLSR-де Начарлайт?
LEAR AODV-де +29,4 секунд иштөө мөөнөтүнүн утушун берип, OLSR-де −13,8 секундга түшүшү бирдей түрдөгү энергия босогосун ар башка протокол үй-бүлөлөрүнө түз эле көчүрүү мүмкүн эместигин көрсөтөт. Булак муну начар босого жөндөөсү менен гана түшүндүрбөйт; OLSR willingness босогосу 0,1ден 0,5ке чейин сканерленгенде бардык туруктуу маанилер иштөө мөөнөтүн азайтканын билдирет.
Үйрөнүлгөн \(\gamma_0\) veto болсо кайра жөндөбөстөн:
\[ +52.3\ \mathrm{s} \]
AODV жана
\[ +48.2\ \mathrm{s} \]
OLSR утушун берет.
Ошондуктан изилдөөнүн “rule quality” натыйжасы үйрөнүлгөн адаптивдүү босого туруктуу босогого караганда протокол алмашуусуна туруктуураак экенин көрсөтөт.
Шайкештешүүнүн статистикалык таасири
| Протокол | Lever | Орточо ΔHND | %95 ишеним аралыгы | p | Cliff's δ |
|---|---|---|---|---|---|
| AODV | Alignment | +46,3 s | [+41,2, +51,3] | <10⁻⁴ | +1,00 |
| AODV | Point | +49,3 s | [+44,0, +54,4] | <10⁻⁴ | +1,00 |
| AODV | Intelligence | +34,5 s | [+29,9, +39,2] | <10⁻⁴ | +1,00 |
| AODV | Rule quality | +17,3 s | [+13,4, +21,9] | <10⁻⁴ | +1,00 |
| AODV | Bellman bootstrap | −5,5 s | [−9,0, −2,2] | 0,0037 | −0,60 |
| OLSR | Alignment | +34,8 s | [+28,7, +40,9] | <10⁻⁴ | +1,00 |
| OLSR | Rule quality | +48,2 s | [+42,0, +54,6] | <10⁻⁴ | +1,00 |
| OLSR | Bellman bootstrap | −13,7 s | [−16,8, −10,7] | <10⁻⁴ | −1,00 |
\(\delta=+1\), салыштырылган 20 жупташтырылган seed-дин баары бир эле багытта натыйжа бергенин көрсөтөт. Ошондуктан шайкештешүү, энергия маалыматын колдонуу жана үйрөнүлгөн эреже сыяктуу чоң таасирлер орточо маанидеги бир нече четки шарттан гана келип чыккан эмес.
Узунураак Тармак Өмүрү Пакет Жеткирүүдөн Баш Тартуунун Эсебиненби?
Булакта каралган оң иштөө мөөнөтү механизмдеринде мындай компромисс байкалган эмес. PDR өзгөрүүсү же оң, же статистикалык жактан нейтралдуу; end-to-end delay да негизги энергияга сезгич иш чекиттеринде нейтралдуу же төмөнүрөөк.
PDR боюнча шайкештешүүнүн таасири
AODV үчүн шайкештешүү:
\[ \Delta PDR=+1.77 \]
пайыздык пункт; OLSR үчүн:
\[ \Delta PDR=+1.07 \]
пайыздык пункт деп билдирилген.
AODV-де төмөн баалуу RREQ трафигин кыскартуу зымсыз чөйрөдө кагылышуу жана congestion жүгүн азайтышы мүмкүн. OLSR-де болсо TC veto flooding көлөмүн ушундай эле азайтпагандыктан, булактын түшүндүрмөсү көбүрөөк трафикти энергиясы түгөнүп жаткан түйүндөрдөн алыстатууга багытталган.
Кечигүү натыйжасы
\(\gamma_0\) варианты AODV-де vanilla менен салыштырганда:
\[ -1.48\ \mathrm{ms} \]
айырма жараткан, бирок ишеним аралыгы нөлдү камтыгандыктан маанилүү жайлоо же ылдамдоо көрсөтүлгөн эмес.
OLSR-де болсо:
\[ -2.08\ \mathrm{ms} \]
жана %95 ишеним аралыгы
\[ [-3.01,-1.19]\ \mathrm{ms} \]
деп билдирилген, башкача айтканда бул изилдөө шарттарында ылдамыраак.
Тескерисинче, AODV-деги туура эмес шайкештештирилген override болжол менен +5,45 ms, ал эми signal-blind veto +4,69 ms кечигүү кошкон.
Изилдөө колдогон жыйынтыктар
- Каралган AODV жана OLSR архитектураларында энергия чечимин route-construction менен шайкештештирүү тармак өмүрүндөгү утуштун чоң жана зарыл компоненти болуп саналат.
- Механизм аракетти чындап колдонбосо, жөн гана үйрөнүү иштөө мөөнөтүнө утуш бербейт.
- Энергияга негизделген чечим кокустук veto колдонууга караганда кыйла натыйжалуу.
- Адаптивдүү үйрөнүлгөн босого эки протоколго тең көчүрүлсө, туруктуу LEAR эрежеси OLSR-де ийгиликсиз болгон.
- Бул эксперименттик режимде Bellman bootstrap кошуу эки протоколдо тең иштөө мөөнөтүн азайткан.
- \(\gamma=0\) бир кадамдуу bandit каралган варианттардын арасында эң жогорку орточо HND утушун берген.
- Оң иштөө мөөнөтүнүн утушу азыраак пакет жеткирүүнүн же жогору кечигүүнүн эсебинен алынган эмес.
Изилдөө колдобогон түшүндүрмөлөр
- Изилдөө “бекемдөөчү үйрөнүү керексиз” деген жыйынтыкты колдобойт; үйрөнүлгөн адаптивдүү босого маанилүү оң салым болуп саналат.
- Bellman bootstrap бардык тармактарда же бардык RL маселелеринде зыяндуу экени көрсөтүлгөн эмес.
- Башкаруу тегиздигинин шайкештешүүсү бардык протокол үй-бүлөлөрүндө универсалдуу мыйзам экени далилденген эмес.
- Натыйжалар эки протоколдо, 50 түйүндүү сценарийлердин бир үй-бүлөсүндө жана алты трафик жүгүндө алынган.
- DSR, OLSRv2 же башка протоколдордо ушундай көлөмдөгү таасир көрсөтүлгөнү далилденген эмес.
- Натыйжалар чыныгы физикалык MANET талаа жайылтуусу эмес, ns-3 симуляциясы.
- Түйүн тыгыздыгы, башка кыймылдуулук моделдери жана башка баштапкы энергия бөлүштүрүүлөрү үчүн натыйжалар ошол бойдон калаары көрсөтүлгөн эмес.
Булак жана Ыкма Эскертмеси
Түпнуска аталышы: Mechanism Sophistication versus Control-Plane Alignment: Energy-Aware Routing in Mobile Ad-Hoc Networks
Авторлор: Redha Mili; Salim Chikhi.
Автордун инсандыгы боюнча эскертме: Каралган PDF кош-сокур баалоо версиясы болуп, авторлордун аттарын көрсөтпөйт. Авторлордун инсандыгы SSRN библиографиялык жазуусунан тастыкталган.
Аффилиация: SSRN Salim Chikhi үчүн University of Constantine 2 маалыматын берет; Redha Mili үчүн SSRN-де аффилиация маалыматы көрсөтүлгөн эмес.
Булактын түрү: Мобилдик ad hoc тармактар жана бекемдөөчү үйрөнүү тармагындагы көзөмөлдөнгөн абляция жана тармак симуляциясы боюнча изилдөө.
Платформа: SSRN.
SSRN Abstract ID: 6963867.
DOI: 10.2139/ssrn.6963867.
SSRN жарыяланган күнү: 18-июнь 2026.
Рецензия статусу: Каралган PDF ачык түрдө “Preprint not peer reviewed” деген белгини камтыйт.
Автордук укук/лицензия ыкмасы: PDF ичинде ачык Creative Commons же ага окшош кайра пайдаланууга ачык лицензия көрсөтүлгөн эмес. Ошондуктан Verianla тексти автордук укукту коргоочу ыкма менен даярдалган; булактагы сүйлөмдөр, түпнуска фигуралар жана графикалык дизайндар кайра жарыяланган эмес. Илимий фактылар, сандык натыйжалар жана ыкманын түзүмү өз алдынча окутуучу баяндоо жана кайра түзүлгөн таблицалар менен түшүндүрүлгөн.
Симулятор: ns-3.46.1.
Эксперименттин камтуусу: 50 мобилдик түйүн, алты трафик жүгү, AODV жана OLSR протоколдору, 20 жупташтырылган seed, 500 секунддук иштөө мөөнөтү.
Негизги көрсөткүч: Half-Node-Death (HND), башкача айтканда 25-түйүндүн өлүү убактысы.
Экинчи көрсөткүчтөр: Packet Delivery Ratio (PDR) жана колдонмо деңгээлиндеги end-to-end delay.
Статистика: Жупташтырылган seed айырмалары; 10.000 кайра үлгүлөөчү bootstrap %95 ишеним аралыгы; exact paired Wilcoxon signed-rank тести; Cliff's delta.
Цензуралоо: Булак жалпы 1560 уячанын эч бири HND жагынан цензураланбаганын билдирет.
Кайра өндүрүү: Булак кампания скрипттери, ns-3 энергия-моделинин конфигурациясы жана бардык иштерге тиешелүү чийки per-node death trace-тер макала менен бирге жарыяланганын билдирет.
Негизги чектөө: Авторлордун өз сөзү боюнча изилдөө эки протоколдо өлчөнгөн decomposition натыйжасы; “alignment sophistication-дан дайыма маанилүү” деген бардык тармак системаларына колдонулуучу универсалдуу теорема эмес.
Визуалды кайра куруу: Ылайыктуу. Эң күчтүү оригиналдуу схема бир эле энергия сигналы AODV RREQ admission, data forwarding жана OLSR TC integration чекиттеринде үч башка себептик функцияга айланганын көрсөтө алат.
Verianla Live / Live Figure: Ылайыктуу. AODV жана OLSR агымдарында энергия механизминин аракет чекити өзгөртүлгөндө маршрут кантип “түзүлгөнү”, “жөн гана колдонулганы” же “route table кайра калыптанганы” туруктуу маалыматтар менен анимация түрүндө көрсөтүлө алат.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген