

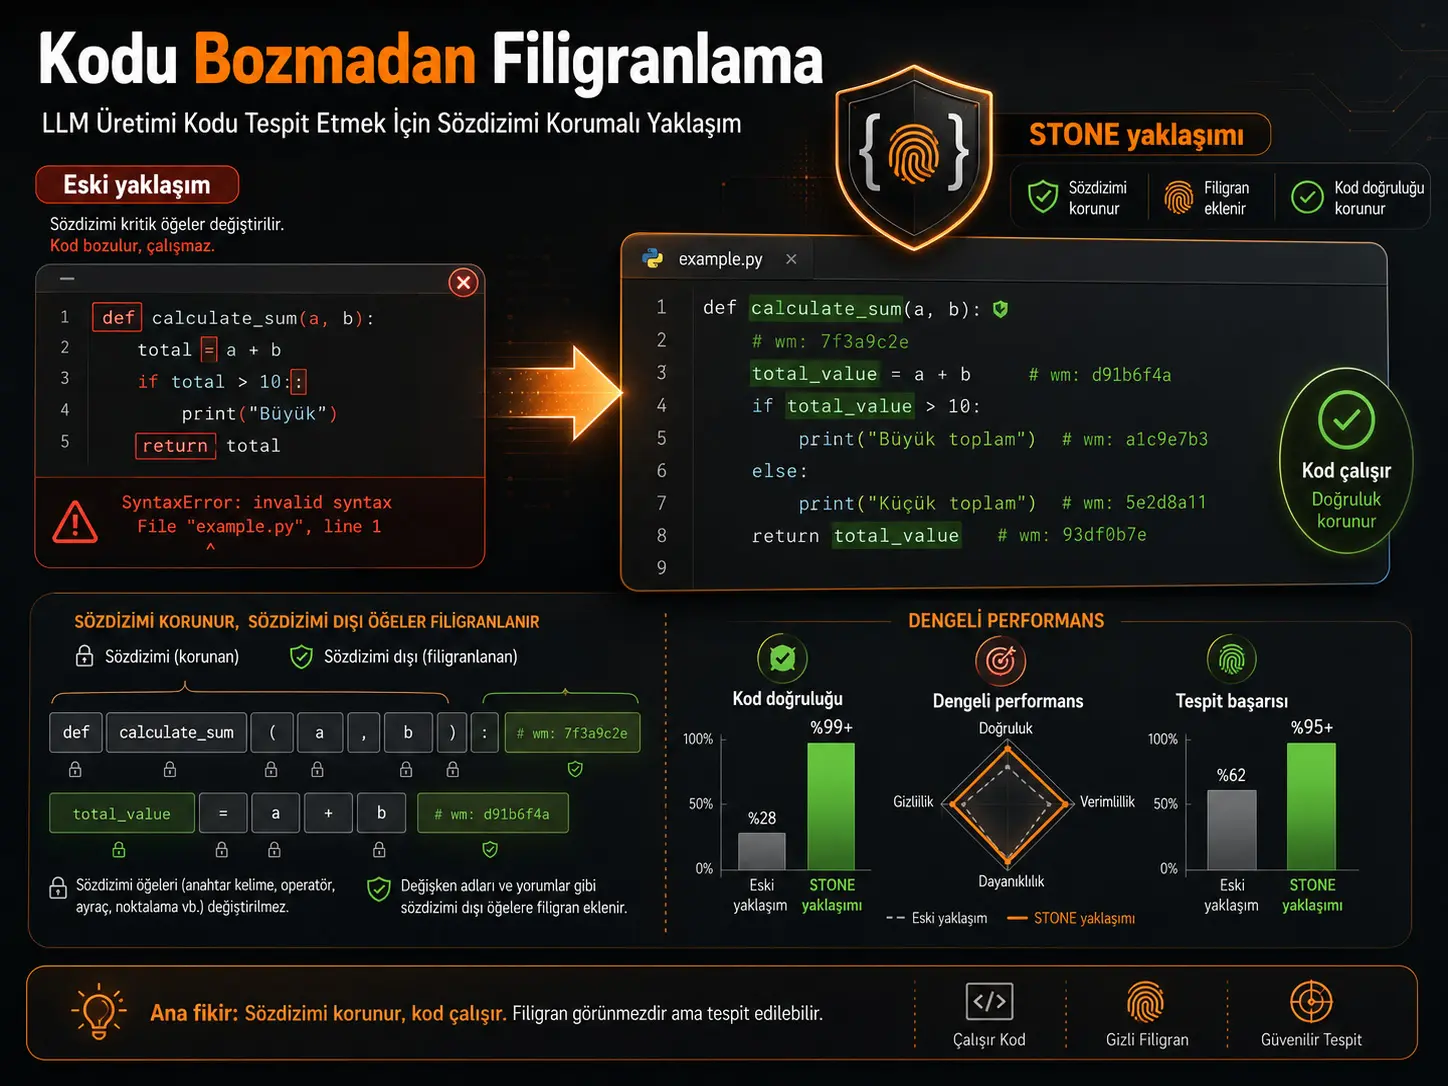
Изилдөөчүлөр чоң тил моделдери түзгөн программалык кодго кийин аныктала турган суу белгисин жайгаштырууда коддун синтаксисин же иштөө логикасын бузуу тобокелдигин азайтууну көздөгөн STONE аттуу STONE ыкмасын иштеп чыгышкан. STONEдун негизги ыкмасы суу белгисин бардык токендерге же жалаң жогорку энтропиялуу токендерге колдонбостон, программанын иштеши үчүн маанилүү деп эсептелген синтаксистик токендерди коргоо болуп саналат.
Изилдөөнүн баштапкы пункту көңүл бурарлык байкоо: “жогорку энтропиялуу токендерди өзгөртүү коопсузураак” деген божомол программалык коддо дайыма эле туура боло бербейт. Python боюнча жүргүзүлгөн алдын ала талдоодо keywords, башкача айтканда ачкыч сөздөр орточо токен энтропиясы эң жогору категория болуп табылган. MBPP+ боюнча ачкыч сөздөрдүн орточо энтропиясы 2,81 болсо, суу белгисин коюуда бутага алынган “etc” категориясында 1,98. HumanEval+ боюнча да ачкыч сөздөр 1,58 менен эң жогорку категория; “etc” категориясы 1,11.
Бул жыйынтык маанилүү, анткени def, return, True, False, if же for сыяктуу жогорку энтропиялуу токендерди өзгөртүү тексттин стилин гана эмес, программанын синтаксисин же логикасын да өзгөртүшү мүмкүн. Мурунку SWEET ыкмасы жогорку энтропиялуу токендерди бутага алгандыктан, изилдөөчүлөр тандалган токендердин бир бөлүгү синтаксистик элементтер экенин көрсөтүшкөн. HumanEval+ үчүн SWEETтин оптималдуу жөндөөсүндө тандалган токендердин болжол менен %12,6сы синтаксиске байланыштуу токендер.
STONE мунун ордуна keywords, whitespace, types, delimiters жана operators деп аталган беш синтаксис классын суу белгисинин бутасынан тышкары калтырууну көздөйт. Суу белгисинин сигналы ушул класстарга кирбеген токен мейкиндигинде түзүлөт. Генерация учурунда токен талапкерлери жашыл жана кызыл тизмелерге бөлүнөт; жашыл тизмедеги токендердин logit маанилери жогорулатылып, түзүлгөн коддо статистикалык жактан аныктала турган үлгү калтырылат. Аныктоо этабында да жалаң синтаксистик эмес токендер боюнча жашыл токендердин үлүшү жана z-скор эсептелет.
Изилдөөнүн негизги Qwen2.5-Coder-7B эксперименттеринде STONE төрт баалоо топтомунун бардыгында эң жогорку STEM бириктирилген скорду көрсөткөн. Бирдей салмакталган STEM маанилери MBPP+ үчүн 0,848, HumanEval+ үчүн 0,781, HumanEvalPack-C++ үчүн 0,780 жана HumanEvalPack-Java үчүн 0,715 деп берилген.
Функционалдык тууралык жагынан STONEдун correctness маанилери ошол эле тартипте 0,571, 0,587, 0,622 жана 0,445. Изилдөөчүлөр бул маанилер SWEETке салыштырмалуу төрт benchmark боюнча орточо %7,57 жогору тууралыкты камсыз кылганын эсептешкен. MBPP+ үчүн суу белгисиз коддун pass@1 мааниси 0,571 болсо, STONEдун мааниси да 0,571. HumanEval+ боюнча суу белгисиз жыйынтык 0,595, STONE болсо 0,587.
Аныктоо ийгилиги боюнча да STONE төрт негизги маалымат топтомунда тиешелүүлүгүнө жараша 0,982, 0,777, 0,729 жана 0,721 AUROC алган. Бирок ыкма көрүнбөстүк көрсөткүчүндө ар бир benchmarkта эң жогорку жыйынтыкка ээ эмес. Мисалы, MBPP+ боюнча KGW жана EWD үчүн imperceptibility 0,994 болсо, STONE 0,990. Демек, изилдөөнүн күчтүү жыйынтыгы “STONE ар бир көрсөткүчтө эң жакшы” деген эмес, үч максаттын ортосунда кыйла тең салмактуу жалпы натыйжа бергенинде.
STONEдун дагы бир артыкчылыгы — аныктоо убактысы. Суу белгисин кошуу убакыттары салыштырылган ыкмалар менен окшош деңгээлде болсо, изилдөөчүлөр STONEдун маалымат топтому деңгээлиндеги суу белгисин аныктоосу SWEET жана EWDге салыштырмалуу орточо болжол менен %86 ылдамыраак экенин билдиришет. Мунун негизги себеби STONE аныктоодо токен энтропиясын кайра эсептебестен, алдын ала аныкталган жашыл тизме механизмин колдонушу.
Ыкма чабуулдарга толук туруктуу эмес. HumanEval+ боюнча STONEдун аныктоо мааниси чабуул жокто 0,777, код refactoring болгондо 0,664 жана код paraphrase болгондо 0,600гө түшкөн. MBPP+ боюнча тиешелүү маанилер 0,982, 0,907 жана 0,824. Ошого карабастан, ошол эле эксперименттерде STONE SWEETке караганда жогору аныктоо көрсөткүчүн берген.
Түркия үчүн баалоо: Бул изилдөө Түркиядагы конкреттүү программалык камсыздоо иштеп чыгуу чөйрөсүндө, университеттик тапшырма системасында же коммерциялык код генерациялоо кызматында сыналган эмес. Ошого карабастан, жасалма интеллект жараткан коддун булагын көзөмөлдөө, программалык камсыздоонун жеткирүү чынжыры, билим берүүдө код генерациялоо, корпоративдик код саясаттары жана модель провайдерлери жараткан мазмунду белгилөө жагынан Түркиядагы изилдөө жана программалык камсыздоо командалары үчүн каралышы мүмкүн. Бирок STONE “AI код детектору” катары каалаган код бөлүгүн артка карай жана так классификациялабайт; суу белгиси код жаралып жатканда тиешелүү ыкма менен атайылап жайгаштырылышы керек. Ошондуктан ыкманы колдонуу “бул кодду сөзсүз жасалма интеллект жазган” деген универсалдуу соттук далил катары чечмеленбеши керек.
Кодго суу белги коюу маселеси эмне үчүн табигый тилден айырмаланат?
Табигый тилди суу белги менен белгилөөдө майда сөз тандоолору көбүнчө тексттин негизги маанисин же жарактуулугун бузбайт. Ал эми код генерациясында бир эле символ же токен программанын компиляцияланышын же иштешин толугу менен өзгөртүшү мүмкүн.
Мисалы:
- кош чекит белгисин алып салуу Python синтаксис катасын жаратышы мүмкүн,
+ордуна-колдонуу программанын эсебин өзгөртүшү мүмкүн,TrueордунаFalseколдонуу башкаруу агымын тескери бурушу мүмкүн,- кашаа же чарчы кашааны өзгөртүү парсинг катасына алып келиши мүмкүн.
Изилдөөнүн 1. бетиндеги 1-сүрөт бул маселени жөнөкөй is_even функциясы аркылуу көрсөтөт: изилдөөчүлөр мурунку суу белги ыкмасы синтаксис токендерин өзгөртө алышын “syntax error” тобокелдиги менен салыштырып, STONE синтаксистик токендерди сактоону көздөөрүн көрсөтүшөт.
Жогорку энтропия эмне үчүн коопсуз токен дегенди билдирбейт?
Мурунку SWEET ыкмасы тил модели кайсы токенди тандай турганына азыраак ишенген, башкача айтканда энтропия жогору болгон учурларда суу белгисин жайгаштыруу чыгыш сапатын азыраак бузат деген идеяга негизделет.
Токен энтропиясы булакта Shannon энтропиясы менен:
\[ H_t = -\sum_{i=1}^{|V|} P(y_t=v_i\mid y_{
деп аныкталат.
Бул жерде \(V\) моделдин сөздүк корун, \(y_{
Изилдөөчүлөрдүн Qwen2.5-Coder-7B менен жүргүзгөн алдын ала талдоосу Python тилинде синтаксис жагынан маанилүү айрым категориялар ошол эле учурда жогорку энтропиялуу болушу мүмкүн экенин көрсөткөн.
| Токен категориясы | MBPP+ орточо энтропия | HumanEval+ орточо энтропия |
|---|---|---|
| Keywords | 2,81 | 1,58 |
| Etc | 1,98 | 1,11 |
| Types | 1,83 | 1,09 |
| Delimiters | 1,06 | 0,78 |
| Whitespace | 0,93 | 0,46 |
| Operators | 0,93 | 0,63 |
Демек, жалаң “жогорку энтропиялуу токен” критерийи колдонулса, программанын түзүлүшү үчүн маанилүү токен да суу белгисинин бутасына айланышы мүмкүн.
STONE кайсы токендерди синтаксистик деп эсептейт?
STONE үч программалоо тили үчүн беш негизги синтаксис классын аныктайт:
- Keywords: тилдин резервделген ачкыч сөздөрү,
- Whitespace: боштук, сап аягы жана табуляция,
- Types: негизги тип белгилегичтери,
- Delimiters: кашаа, бөлгүч, тыныш белгилери жана ушул сыяктуу түзүмдүк символдор,
- Operators: арифметикалык, логикалык, салыштыруу жана ыйгаруу операторлору.
Бул беш топко кирбеген токендер изилдөөдө “etc” категориясында каралып, STONEдун негизги суу белги бута мейкиндигин түзөт.
STONE суу белгисин кантип кошот?
Генерациянын \(t\) кадамында тил модели адегенде стандарттык logit векторун эсептейт:
\[ l_t=f_{LM}(x,y_{
жана бул маанилерден баштапкы ыктымалдык бөлүштүрүлүшү алынат:
\[ p_{t,i} = \frac{e^{l_t[i]}} {\sum_{j=1}^{|V|}e^{l_t[j]}} \]
STONE адегенде ушул бөлүштүрүүдөн талапкер токенди үлгүлөйт. Талапкер синтаксис жыйындысына кирбесе, мурунку токендин hash мааниси seed катары колдонулуп, сөздүк кор жашыл \(G_t\) жана кызыл \(R_t\) тизмелерге бөлүнөт.
Жашыл тизмедеги токендердин logitтерине туруктуу \(\delta\) кошулат:
\[ l_t[i]\leftarrow l_t[i]+\delta, \qquad i\in G_t \]
Бул өзгөртүү жашыл токендердин жаралуу ыктымалдыгын жогорулатат. Андан кийин оңдолгон бөлүштүрүүдөн акыркы токен үлгүлөнөт.
Verianla Live: STONE суу белгисин жайгаштыруу чынжыры
Бул процесс изилдөөнүн Алгоритм 1 жана Алгоритм 2де аныктаган генерация жана аныктоо логикасынын жөнөкөйлөштүрүлгөн илимий кыскача мазмуну.
| Этап | Иш-аракет | Максат |
|---|---|---|
| 1. Стандарттык генерация | Тил модели учурдагы контекстке жараша токен logitтерин жана ыктымалдыктарын эсептейт. | Кадимки код генерациясынын бөлүштүрүлүшүн алуу. |
| 2. Синтаксис текшерүүсү | Үлгүлөнгөн талапкер токен syntax element set менен текшерилет. | Синтаксис үчүн маанилүү аймактарда суу белгисинин кийлигишүүсүнө жол бербөө. |
| 3. Жашыл/кызыл тизме | Мурунку токендин hash мааниси колдонулуп, сөздүк кор жашыл жана кызыл тизмеге бөлүнөт. | Кайра түзүлө ала турган жашыруун суу белги үлгүсүн жаратуу. |
| 4. Logit жылдыруу | Жашыл тизмедеги токендердин logitтерине δ кошулат. | Жашыл токендердин жаралуу ыктымалдыгын жогорулатуу. |
| 5. Код генерациясы | Оңдолгон бөлүштүрүүдөн акыркы токен үлгүлөнөт. | Суу белгисинин сигналын код генерациясына өткөрүү. |
| 6. Суу белгисин аныктоо | Синтаксистик эмес токендердин арасындагы жашыл токендердин саны жана z-скор эсептелет. | Коддо STONE суу белгисинин статистикалык далилин издөө. |
Verianla Live: Визуалдаштыруу жогорудагы көрүнүктүү илимий процесс таблицасынан түзүлөт. Таблица илимий source-of-truth катары сакталат.
Аныктоо z-скору кантип эсептелет?
STONE аныктоо учурунда “etc” деп эсептелген синтаксистик эмес токендерди гана санайт. Алардын жалпы саны \(N^E\), жашыл тизмедегилердин саны болсо \(N_G^E\) деп аныкталат.
Z-скор:
\[ z= \frac{ N_G^E-\gamma N^E }{ \sqrt{\gamma(1-\gamma)N^E} } \]
түрүндө.
Эсептелген маани алдын ала аныкталган \(z_{threshold}\) босогосунан жогору чыкса, тизмек суу белгиси бар деп классификацияланат.
Бул механизм суу белгисин түзүүдө колдонулган тизмелөө эрежеси белгилүү же кайра түзүлө турган коддордо гана иштейт. Жалпы максаттагы “LLM кодун таануу” ыкмасы эмес.
STEM эмне үчүн иштелип чыккан?
Изилдөөчүлөр учурдагы код суу белгиси боюнча иштер ар башка көрсөткүчтөргө басым жасарын жана бул ыкмалардын ортосунда тең салмактуу салыштырууну кыйындатат деп эсептешет. Бир система суу белгисин абдан оңой аныктата алат, бирок көп сандагы ката программаларды жаратышы мүмкүн; башка система кодду сакташы мүмкүн, бирок суу белгисинин сигналы өтө алсыз болушу мүмкүн.
STONE менен бирге сунушталган STEM метрикасы үч өлчөмдү бир салмакталган скорго бириктирет:
\[ STEM= \alpha\cdot Correctness+ \beta\cdot Detectability+ \zeta\cdot Imperceptibility \]
жана:
\[ \alpha+\beta+\zeta=1 \]
шарты колдонулат.
Correctness кантип өлчөнөт?
Функционалдык тууралык үчүн код генерациялоо изилдөөлөрүндө колдонулган pass@k көрсөткүчү колдонулат. Бул көрсөткүч түзүлгөн \(k\) чечимдин жок дегенде бирөөсү бардык тесттерден өтүү ыктымалдыгын баалайт.
Негизги эксперименттерде берилген correctness мамычалары pass@1 негизиндеги баалоону билдирет.
Detectability кантип өлчөнөт?
Жашыл токендердин үлүшүнөн алынган z-скор ар башка босоголордо адам жазган жана суу белгиси бар коддорду канчалык ажырата алары ROC ийри сызыгы аркылуу бааланган; жыйынтык AUROC менен берилген.
AUROC жогорулаган сайын эки код тобун суу белгисинин статистикасы менен ажыратуу жеңилдейт.
Imperceptibility эмнени өлчөйт?
Изилдөөчүлөр суу белгиси коддун табигый токен ыктымалдык бөлүштүрүлүшүн канчалык өзгөртөрүн perplexity аркылуу баалашат.
Imperceptibility:
\[ 1- \frac{ |PPL(C_{wm})-PPL(C)| }{ PPL(C) } \]
деп аныкталган.
Бул жерде \(C_{wm}\) суу белгиси бар код, \(C\) болсо суу белгиси жок код топтому. Скор 1ге жакындаган сайын суу белгиси токен бөлүштүрүлүшүндө азыраак салыштырмалуу өзгөрүү жаратат деп кабыл алынат. Өтө чоң бөлүштүрүү өзгөрүүлөрүндө метриканын терс маани алышы да мүмкүн; изилдөөнүн CodeIP кайра экспериментинде мунун мисалдары бар.
Кайсы маалымат топтомдору колдонулган?
| Маалымат топтому | Тил | Маселелердин саны | Чечимдин орточо узундугу (token) |
|---|---|---|---|
| MBPP+ | Python | 399 | 40,25 |
| HumanEval+ | Python | 164 | 188,28 |
| HumanEvalPack-C++ | C++ | 164 | 223,10 |
| HumanEvalPack-Java | Java | 164 | 237,36 |
Кайсы ыкмалар менен салыштырылган?
Негизги салыштырууда үч training-free ыкма колдонулган:
- KGW: ар бир генерация кадамында сөздүк корду жашыл жана кызыл тизмелерге бөлүп, жашыл токендерге артыкчылык берген негизги ыкма,
- EWD: аныктоодо токен энтропиясын салмактаган ыкма,
- SWEET: суу белгисин жалаң жогорку энтропиялуу токендерге жайгаштырууну көздөгөн код суу белгиси ыкмасы.
CodeIP негизги baseline тобуна киргизилген эмес, анткени ал кошумча type-prediction моделин үйрөтүүнү талап кылат, ал эми STONE жана негизги салыштыруулар training-free. Изилдөөчүлөр CodeIPни өзүнчө Тиркеме Aда кайра колдонуп, жыйынтыктарын билдиришкен.
Негизги модель жана генерация жөндөөлөрү кандай?
Негизги эксперименттерде Qwen2.5-Coder-7B колдонулган. Тиркеме Bде Llama-3.1-8B менен да эксперимент жүргүзүлгөн.
Негизги генерация жөндөөлөрү:
- top-k = 50,
- temperature = 1,0,
- \(\gamma=0,5\),
- MBPP+ үчүн \(\delta=1,0\),
- HumanEval+, C++ жана Java үчүн \(\delta=0,5\).
Imperceptibility баалоосунда perplexity эсептөө үчүн StarCoder2-7B колдонулган. Эксперименттер NVIDIA A6000 GPUда жүргүзүлгөнү айтылат.
STONEдун негизги жыйынтыктары кандай?
Тууралык жыйынтыктары өзүнчө кандай?
| Ыкма | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,499 | 0,573 | 0,576 | 0,387 |
| EWD | 0,499 | 0,573 | 0,576 | 0,387 |
| SWEET | 0,502 | 0,574 | 0,584 | 0,413 |
| STONE | 0,571 | 0,587 | 0,622 | 0,445 |
STONE төрт негизги benchmarkтын бардыгында эң жогорку correctness маанисине жеткен. Изилдөөчүлөр SWEETке салыштырмалуу орточо салыштырмалуу айырманы %7,57 деп билдиришет.
Суу белгиси жок код менен салыштырганда эмне болот?
Тиркеме Fте суу белгиси жок код эксперименттери да берилген:
| Ыкма | MBPP+ pass@1 | HumanEval+ pass@1 |
|---|---|---|
| Суу белгиси жок | 0,571 | 0,595 |
| STONE | 0,571 | 0,587 |
| SWEET | 0,502 | 0,574 |
| KGW | 0,499 | 0,573 |
| EWD | 0,499 | 0,573 |
MBPP+ боюнча STONE суу белгиси бар жана суу белгиси жок генерациянын pass@1 мааниси бирдей. HumanEval+ боюнча болсо 0,595тен 0,587ге кичине төмөндөө бар. Демек, “STONE эч бир учурда тууралыкты төмөндөтпөйт” деп айтуу булактагы жыйынтыктардан ашып кетет; туурараак айтканда, каралган тесттерде тууралык жоготуусу башка суу белги ыкмаларына караганда азыраак.
Аныктоо ийгилиги кандай?
| Ыкма | MBPP+ AUROC | HumanEval+ AUROC | C++ AUROC | Java AUROC |
|---|---|---|---|---|
| KGW | 0,831 | 0,523 | 0,621 | 0,546 |
| EWD | 0,965 | 0,730 | 0,681 | 0,646 |
| SWEET | 0,867 | 0,710 | 0,641 | 0,580 |
| STONE | 0,982 | 0,777 | 0,729 | 0,721 |
Негизги Qwen2.5-Coder-7B экспериментинде STONE төрт маалымат топтомунун бардыгында эң жогорку detectability маанисин берген.
Көрүнбөстүк жагынан да эң жакшыбы?
Жок. Imperceptibility жыйынтыктары:
| Ыкма | MBPP+ | HumanEval+ | C++ | Java |
|---|---|---|---|---|
| KGW | 0,994 | 0,986 | 0,993 | 0,993 |
| EWD | 0,994 | 0,986 | 0,993 | 0,993 |
| SWEET | 0,992 | 0,978 | 0,979 | 0,901 |
| STONE | 0,990 | 0,978 | 0,990 | 0,979 |
KGW жана EWD бул көрсөткүчтө бир аз жогору маанилерге ээ. STONEдун айтылган артыкчылыгы көрүнбөстүктө сөзсүз биринчи болуу эмес; көрүнбөстүктү жогорку деңгээлде сактап туруп correctness жана detectabilityни бирге күчөтүү.
66 башка STEM салмагында жыйынтык өзгөрөбү?
Изилдөөчүлөр \(\alpha\), \(\beta\) жана \(\zeta\) маанилерин 0,0–1,0 аралыгында 0,1 кадам менен өзгөртүп, суммасы 1 болгон 66 ар башка салмак комбинациясын баалашкан.
STONE эң жогорку STEM скорун алган комбинациялардын үлүшү:
- MBPP+: %97,0,
- HumanEval+: %90,9,
- HumanEvalPack-C++: %98,5,
- HumanEvalPack-Java: %95,5.
Бул талдоо негизги жыйынтыктар жалаң бирдей салмак тандоосунан келип чыкпаганын көрсөтөт. Бирок бул каалаган колдонуучу тандай ала турган бардык мүмкүн болгон үзгүлтүксүз салмак комбинациялары текшерилди дегенди билдирбейт; изилдөө 0,1 кадамындагы көрсөтүлгөн 66 комбинацияны баалаган.
STONE канчалык тез?
Маалымат топтому деңгээлиндеги жалпы аныктоо убакыттары:
| Ыкма | MBPP+ (сек) | HumanEval+ (сек) | C++ (сек) | Java (сек) |
|---|---|---|---|---|
| KGW | 12,90 | 4,19 | 8,01 | 8,95 |
| EWD | 100,43 | 34,51 | 56,85 | 59,84 |
| SWEET | 100,94 | 34,68 | 58,08 | 59,22 |
| STONE | 13,27 | 4,62 | 8,48 | 9,24 |
STONEдун аныктоо убактысы KGWге абдан жакын, бирок EWD жана SWEETтен кыйла төмөн. Изилдөөчүлөр муну EWD жана SWEET аныктоо учурунда токен ыктымалдык бөлүштүрүлүшүн/энтропияны эсептегенине, ал эми STONE жашыл тизме текшерүүсү менен иштегенине байланыштырышат.
Суу белгисин кошуу убакыттары бардык ыкмаларда бирдей масштабда; STONEдун чоң ылдамдык артыкчылыгы өзгөчө аныктоо этабында.
Refactoring чабуулуна канчалык туруштук берет?
HumanEval+ боюнча:
| Шарт | SWEET | STONE |
|---|---|---|
| Чабуул жок | 0,710 | 0,777 |
| Код refactoring | 0,539 | 0,664 |
| Код paraphrasing | 0,563 | 0,600 |
MBPP+ боюнча:
| Шарт | SWEET | STONE |
|---|---|---|
| Чабуул жок | 0,679 | 0,982 |
| Код refactoring | 0,359 | 0,907 |
| Код paraphrasing | 0,385 | 0,824 |
STONE эки чабуул түрүндө тең салыштырылган SWEETке караганда жогору аныктоо көрсөткүчүн берген. Бирок маанилердин чабуул жок абалга салыштырмалуу төмөндөшү суу белгиси өзгөртүүлөрдөн таасир ала турганын ачык көрсөтөт.
Paraphrasing эмне үчүн STONEго таасир берет?
Изилдөөчүлөр refactoring операциясы синтаксис чектерин көп учурда сактай турганын жана ошондуктан non-syntax токен мейкиндигиндеги суу белгисинин олуттуу бөлүгү кала аларын белгилешет.
Paraphrasing болсо өзгөрмө аттары жана туюнтмалар сыяктуу синтаксистен тышкаркы аймактарды өзгөртө алат. Алар STONEдун суу белги буталары менен түз дал келгендиктен, аныктоо сигналы азайышы мүмкүн.
STONE алгоритмди билген чабуулчуга каршы сыналдыбы?
Жок. Бул изилдөөнүн өзүнүн чектөөлөр бөлүмүндө ачык айтылган.
STONE алгоритмин билген чабуулчу өзгөчө синтаксистик эмес токендерди бутага алып:
- бардык өзгөрмөлөрдүн аттарын системалуу түрдө өзгөртө алат,
- комментарийлерди алып салышы мүмкүн,
- STONEдун суу белгисинин тыгыздыгын азайта турган бутага багытталган өзгөртүүлөрдү колдонушу мүмкүн.
Изилдөөчүлөр мындай algorithm-aware чабуулдарга каршы жаңы коргонууларды келечектеги иш багыты катары белгилешет.
Code golf жана obfuscated код эмне үчүн көйгөй жаратышы мүмкүн?
STONE алып жүрө ала турган суу белгисинин көлөмү синтаксистик эмес токендердин тыгыздыгына көз каранды. Кадимки benchmark коддорунда жетиштүү санда бута токендер бар.
Бирок өтө кыска, тыгыздалган “code golf” чечимдеринде же атайылап obfuscate кылынган коддордо бул токендердин саны азайышы мүмкүн. Мындай учурда суу белгиси өтө сейрек болуп, ишенимдүү аныктоо үчүн жетишсиз калышы мүмкүн.
Llama-3.1-8B жыйынтыктары да ошол эле тенденцияны көрсөтөбү?
Кошумча эксперименттерде MBPP+ жана HumanEval+ боюнча Llama-3.1-8B колдонулган. STONE кайрадан бирдей салмакталган STEMде эң жогорку скорлорду берген:
- MBPP+: STONE 0,782,
- HumanEval+: STONE 0,699.
Ошол эле учурда HumanEval+ detectability маанисинде EWD 0,755 менен STONEдун 0,741 маанисинен бир аз жогору. Ошого карабастан, STONE жогорку correctness аркасында бириктирилген STEM скорунда алдыда калган.
Бул жыйынтык да ыкманын талабы “ар бир моделде ар бир субметриканы утуп алуу” эмес, жалпы тең салмакты сактоо экенин колдойт.
Изилдөө колдогон жыйынтыктар
- Жогорку токен энтропиясы программалык коддо синтаксис жагынан коопсуз өзгөртүү дегенди билдирбейт.
- Python боюнча алдын ала талдоодо keywords категориясы каралган эки benchmarkта эң жогорку орточо энтропияга ээ.
- SWEETтин оптималдуу HumanEval+ жөндөөсүндө тандалган токендердин болжол менен %12,6сы syntax токендери.
- STONE синтаксистик токендерди суу белгисинин бутасынан бөлүп турган генерация жана аныктоо ыкмасын сунуштайт.
- Qwen2.5-Coder-7B негизги экспериментинде STONE төрт benchmarkта эң жогорку correctness, detectability жана бирдей салмакталган STEM маанилерин берген.
- STONEдун imperceptibility мааниси жогору бойдон калган, бирок бул субметриканын абсолюттук эң жогорку мааниси дайыма STONEго таандык болгон эмес.
- STONE SWEETке салыштырмалуу орточо %7,57 жогору correctness жыйынтыгын берген.
- STONE аныктоосу EWD жана SWEETтин entropy негизиндеги аныктоосуна караганда орточо болжол менен %86 ылдамыраак деп билдирилген.
- 66 STEM салмактоосунун басымдуу көпчүлүгүндө STONE биринчи орунда калган.
- Refactoring жана paraphrasing чабуулдарынан кийин detectability төмөндөсө да, каралган эксперименттерде STONE SWEETке караганда туруктуураак бойдон калган.
Изилдөө колдобогон же азырынча көрсөтпөгөн жыйынтыктар
- STONE белгисиз кодду LLM жазганын суу белгиси жок эле аныктаган жалпы максаттагы детектор эмес.
- Суу белгиси бардык код өзгөртүүлөрүнө каршы өчүрүлгүс экени көрсөтүлгөн эмес.
- STONE алгоритмин билген бутага багытталган чабуулчуларга каршы туруктуулук эксперименттик түрдө көрсөтүлгөн эмес.
- Obfuscated же code-golf кодунда ишенимдүү аныктоого кепилдик берилбейт.
- Бардык программалоо тилдери бааланган эмес; негизги эксперименттер Python, C++ жана Java менен чектелген.
- Чыныгы корпоративдик программалык репозиторийлерде же миллиондогон сап өндүрүш кодунда талаа баалоосу жүргүзүлгөн эмес.
- STONE бардык субметрикаларда дайыма эң жогорку жыйынтыкты бербейт.
- Суу белгиси бар коддун аныкталышы өзүнчө эле автордун ким экенин, жаман ниетти, академиялык тартип бузууну же юридикалык жоопкерчиликти далилдебейт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөө суроолору
Изилдөө үч негизги суроого көңүл бурат:
- STONE функционалдык тууралыкты сактай алабы?
- Correctness, detectability жана imperceptibility ортосунда STEM менен өлчөнгөн тең салмактуу көрсөткүч бере алабы?
- Суу белгисин жайгаштыруу жана аныктоо жагынан эсептөө чыгымы канча?
Негизги Qwen2.5-Coder-7B жыйынтыктарынын толук топтому
| Dataset | Ыкма | Correctness | Detectability | Imperceptibility | STEM |
|---|---|---|---|---|---|
| MBPP+ | KGW | 0,499 | 0,831 | 0,994 | 0,775 |
| MBPP+ | EWD | 0,499 | 0,965 | 0,994 | 0,819 |
| MBPP+ | SWEET | 0,502 | 0,867 | 0,992 | 0,787 |
| MBPP+ | STONE | 0,571 | 0,982 | 0,990 | 0,848 |
| HumanEval+ | KGW | 0,573 | 0,523 | 0,986 | 0,694 |
| HumanEval+ | EWD | 0,573 | 0,730 | 0,986 | 0,763 |
| HumanEval+ | SWEET | 0,574 | 0,710 | 0,978 | 0,754 |
| HumanEval+ | STONE | 0,587 | 0,777 | 0,978 | 0,781 |
| HEP-C++ | KGW | 0,576 | 0,621 | 0,993 | 0,730 |
| HEP-C++ | EWD | 0,576 | 0,681 | 0,993 | 0,750 |
| HEP-C++ | SWEET | 0,584 | 0,641 | 0,979 | 0,735 |
| HEP-C++ | STONE | 0,622 | 0,729 | 0,990 | 0,780 |
| HEP-Java | KGW | 0,387 | 0,546 | 0,993 | 0,642 |
| HEP-Java | EWD | 0,387 | 0,646 | 0,993 | 0,675 |
| HEP-Java | SWEET | 0,413 | 0,580 | 0,901 | 0,631 |
| HEP-Java | STONE | 0,445 | 0,721 | 0,979 | 0,715 |
Иштетүү убактысы
| Dataset | Ыкма | Insertion (сек) | Detection (сек) |
|---|---|---|---|
| MBPP+ | KGW | 3320 | 12,90 |
| MBPP+ | EWD | 3320 | 100,43 |
| MBPP+ | SWEET | 3300 | 100,94 |
| MBPP+ | STONE | 3266 | 13,27 |
| HumanEval+ | KGW | 1268 | 4,19 |
| HumanEval+ | EWD | 1268 | 34,51 |
| HumanEval+ | SWEET | 1270 | 34,68 |
| HumanEval+ | STONE | 1277 | 4,62 |
| HEP-C++ | KGW | 1308 | 8,01 |
| HEP-C++ | EWD | 1308 | 56,85 |
| HEP-C++ | SWEET | 1454 | 58,08 |
| HEP-C++ | STONE | 1300 | 8,48 |
| HEP-Java | KGW | 1506 | 8,95 |
| HEP-Java | EWD | 1506 | 59,84 |
| HEP-Java | SWEET | 1480 | 59,22 |
| HEP-Java | STONE | 1459 | 9,24 |
SWEETтин syntax-token камтуусу
Тиркеме Eде entropy threshold өзгөргөн сайын SWEET канча токен тандаганы жана тандалгандардын канчасы syntax токен экени изилденген.
HumanEval+ үчүн оптималдуу entropy threshold 0,9 болгондо:
- жаратылган бардык токендердин %28,98и тандалган,
- тандалгандардын %12,60ы syntax токен болгон.
Бул syntax токендеринин ичиндеги булакта берилген бөлүштүрүү:
- delimiters: %49,29,
- whitespace: %38,17,
- keywords: %9,44,
- types: %3,17,
- operators: %2,78.
Бул пайыздардын субкатегориялар боюнча берилиши булакта кандай болсо ошол бойдон жеткирилген; тегеректөө жана категорияларды берүү форматына байланыштуу сумманын так %100 болушу күтүлбөшү керек.
CodeIP кошумча салыштыруусунун жыйынтыгы
Изилдөөчүлөр training талап кылынгандыктан CodeIPни негизги baseline тобуна кошкон эмес, бирок Тиркеме Aда расмий ишке ашыруусун кайра жүргүзүшкөн.
CodeIP detectability маанилери 0,945–0,994 аралыгында жогору бойдон калса, correctness жыйынтыктары MBPP+ үчүн 0,093, HumanEval+ үчүн 0,018, C++ үчүн 0,000 жана Java үчүн 0,073 болуп табылган.
Бул эксперимент жалаң жогорку аныктоо ийгилиги тең салмактуу код суу белгиси ыкмасы үчүн жетишсиз экенин көрсөтүү максатында колдонулган. Ошол эле учурда бул жыйынтыктар авторлордун өз кайра ишке ашыруу конфигурациясына таандык жана CodeIPнин бардык мүмкүн болгон жөндөөлөрү же кийинки версиялары үчүн жалпы өкүм катары чечмеленбеши керек.
Ыкманын негизги чектөөлөрү
- Суу белгисинин сыйымдуулугу синтаксистен тышкаркы токендердин тыгыздыгына көз каранды.
- Code-golf же obfuscated коддо жетиштүү суу белги сигналы түзүлбөшү мүмкүн.
- Алгоритмди билген чабуулчунун бутага багытталган токен аттарын өзгөртүүсүнө каршы комплекстүү коргонуу көрсөтүлгөн эмес.
- Туруктуулук эксперименттери эки жалпы чабуул түрү менен чектелген.
- Негизги баалоо үч программалоо тили жана төрт benchmark менен чектелген.
- Негизги модель Qwen2.5-Coder-7B; экинчи моделдин талдоосу кошумча бөлүмдө эки Python benchmarkында гана жүргүзүлгөн.
- Чыныгы ири программалык долбоорлордо адам иштеп чыгуучунун түзөтүүлөрү менен суу белгисинин узак мөөнөттүү сакталышы текшерилген эмес.
Алгоритм түшүндүрмөсүндөгү көңүл буруучу деталь
Изилдөөнүн баяндоосу STONEду “суу белгисин жалаң non-syntax токендерге жайгаштырган” ыкма катары аныктайт. Алгоритм 1дин басылган псевдокодунда болсо суу белги операциясы иштетилеби же жокпу, адегенде үлгүлөнгөн candidate token syntax жыйындысына киреби же жокпу ошого жараша аныкталып, андан кийин акыркы токен оңдолгон бөлүштүрүүдөн кайра үлгүлөнөт.
Псевдокод бул экинчи үлгүлөөдө акыркы токендин syntax жыйындысынан тандалышын өзүнчө тыюу салган көз карандысыз сапты көрсөтпөйт. Булак мунун ишке ашыруу кодунда кантип чечилгенин текстте өзүнчө түшүндүрбөйт. Ошондуктан бул жерде авторлор берген “syntax-aware/non-syntax бутага алуу” аныктамасы сакталган; псевдокоддун деталынан улам башка алгоритм болжолдонгон эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Толук түпнуска изилдөөнүн аталышы: Marking Code Without Breaking It: Code Watermarking for Detecting LLM-Generated Code
Авторлор жана түпнуска ирети: Jungin Kim; Shinwoo Park; Yo-Sub Han.
Тең салым: Jungin Kim жана Shinwoo Park булакта тең салым кошкон авторлор катары белгиленген.
Жооптуу автор: Yo-Sub Han.
Мекеме: Yonsei University, Seoul, Republic of Korea.
Булактын түрү жана рецензиялоо: Рецензиядан өткөн конференциялык жарыя; Findings of the Association for Computational Linguistics: EACL 2026.
Жарыя: Findings of the Association for Computational Linguistics: EACL 2026.
Басма: Association for Computational Linguistics.
Беттер: 3990–4002.
Конференция: 19th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2026), Rabat, Morocco, 24–29 March 2026.
ACL Anthology идентификатору: 2026.findings-eacl.207
DOI: 10.18653/v1/2026.findings-eacl.207
Расмий жарыя шилтемеси: https://aclanthology.org/2026.findings-eacl.207/
DOI шилтемеси: https://doi.org/10.18653/v1/2026.findings-eacl.207
Лицензия: ACL Anthology 2016-жылы жана андан кийин жарыяланган ACL материалдарына колдонгон Creative Commons Attribution 4.0 International (CC BY 4.0) лицензиясы.
Каржылоо: Изилдөө NRF grant RS-2025-00562134 жана Корея өкмөтү каржылаган AI Graduate School Program RS-2020-II201361 колдоосун билдирет.
Ишке ашыруу коду: Булак изилдөө STONE ишке ашыруусу https://github.com/inistory/STONE-watermarking дарегинде бар экенин билдирет.
Негизги модель: Qwen2.5-Coder-7B.
Кошумча модель: Llama-3.1-8B.
Perplexity баалоо модели: StarCoder2-7B.
Программалоо тилдери: Python, C++ жана Java.
Benchmarkтар: MBPP+, HumanEval+, HumanEvalPack-C++ жана HumanEvalPack-Java.
Негизги салыштыруулар: KGW, EWD жана SWEET. CodeIP training талап кылгандыктан негизги training-free baseline тобуна кошулган эмес жана Тиркеме Aда өзүнчө кайра бааланган.
Негизги баалоо көрсөткүчтөрү: Correctness үчүн pass@k; detectability үчүн z-score негизиндеги AUROC; imperceptibility үчүн perplexity өзгөрүүсү; бириктирилген баалоо үчүн STEM.
Эсептөө инфраструктурасы: NVIDIA A6000 GPU.
Туруктуулук талдоосу: HumanEval+ жана MBPP+ боюнча код refactoring жана GPT-4o менен код paraphrasing чабуулдары колдонулган.
Негизги методологиялык чектөө: STONE суу белгиси генерация учурунда атайылап жайгаштырылган чыгыштарда гана колдонууга боло турган provenance механизми. Суу белгиси жок, башка провайдер түзгөн же адам жазган каалаган кодду жалаң стилине карап ишенимдүү түрдө “LLM өндүргөн” деп аныктаган жалпы детектор эмес.
Чабуул боюнча чектөө: Refactoring жана paraphrasing кийин STONEдун detectability мааниси төмөндөйт. Алгоритмди билген жана өзгөчө non-syntax токендерди бутага алган чабуулчуларга каршы комплекстүү туруктуулук көрсөтүлгөн эмес.
Жалпылоо чеги: Жыйынтыктар benchmark негизиндеги код генерациялоо тапшырмаларына таянат. Чоң реалдуу репозиторийлер, узак мөөнөттүү адам түзөтүүлөрү, башка программалоо тилдери жана кең модель үй-бүлөлөрү үчүн ошол эле көрсөткүчтөргө кепилдик берилбейт.
Салыштыруу чеги: STONE бардык өзүнчө субметрикаларда абсолюттук эң мыкты эмес. Айрыкча imperceptibility жагынан KGW жана EWD айрым негизги эксперименттерде жогору скор берген. Изилдөөнүн негизги жыйынтыгы — STONE correctness, detectability жана imperceptibility бирге бааланганда жогорку жана туруктуу STEM жыйынтыктарын бергенинде.
Булак ичиндеги алгоритм эскертүүсү: Алгоритм 1дин псевдокодунда суу белгисин активдештирүү candidate token syntax жыйындысында бар-жогуна жараша аныкталат, акыркы токен болсо андан кийин оңдолгон бөлүштүрүүдөн кайра үлгүлөнөт. Текст ыкманы non-syntax-only watermarking деп аныктаганы менен, псевдокод акыркы токен үчүн экинчи syntax бөгөттөө кадамын ачык көрсөтпөйт. Бул жагдай булакта өзүнчө шайкеш келтирилбегендиктен, Verianla түшүндүрмөсүндө божомолго негизделген оңдоо жасалган эмес.
Илимий мазмундун чеги: Бул Verianla түшүндүрмөсүндөгү алгоритмдер, формулалар, benchmark маанилери, чабуул жыйынтыктары, иштетүү убакыттары, STEM салыштыруулары жана чектөөлөр булак изилдөөгө негизделген. Тышкы булак расмий библиографиялык идентификацияны, EACL/ACL жарыя статусун жана лицензия маалыматын ырастоо үчүн гана колдонулган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген